

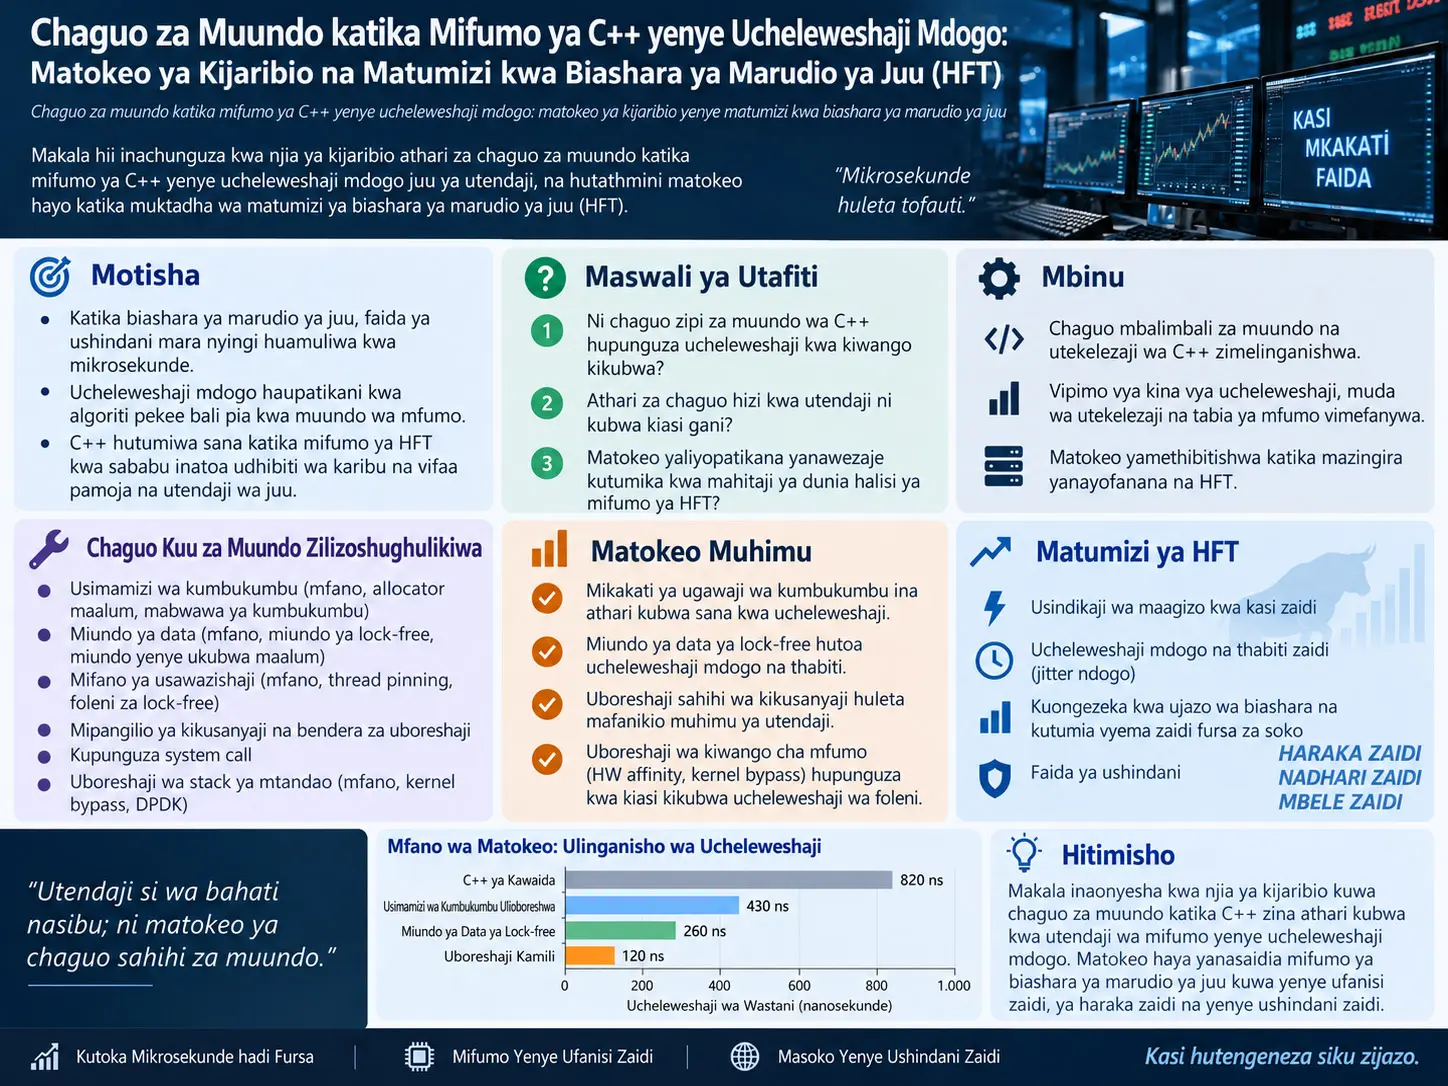
Katika mifumo ya biashara ya marudio ya juu, utendaji hauamuliwi tu na kasi ya algoriti moja. Ucheleweshaji wa tick-to-trade, kuanzia pakiti ya data ya soko inapofika kwenye mfumo hadi agizo linalolingana linapotumwa nje, ni matokeo ya pamoja ya tabaka nyingi: scheduler ya mfumo endeshi, interrupts, kernel housekeeping, page faults, tabia ya TLB, cache locality, mtiririko wa udhibiti wa C++, ugawaji wa kumbukumbu, thread synchronization na rundo la itifaki za mtandao.
Utafiti wa Khalid Mohammad unachunguza tabaka hizi kwa microbenchmarks na kuuliza ni chaguo zipi za muundo hupunguza ucheleweshaji wa kawaida, na zipi huathiri tail latency, yaani miruko ya ucheleweshaji inayotokea mara chache lakini inaweza kuwa mikubwa sana.
Hitimisho kuu ni kwamba hakuna “uboreshaji bora mmoja.” Real-time scheduler hupunguza median wakeup latency, lakini haiwezi kuondoa tail za kina peke yake. CPU isolation katika kiwango cha kernel, kutenganisha RCU/workqueue na interrupt steering hukaza p99.9 na p99.99 kwa nguvu zaidi.
Kwa upande wa kumbukumbu, kupopulate kurasa mapema badala ya kuruhusu page fault katika mguso wa kwanza kulishusha gharama ya first-touch ya karibu 2 µs hadi karibu 20 ns. Explicit 2 MB HugeTLB ilipunguza TLB miss rate kutoka %1,33 hadi %0,09 na cycles/access kutoka takribani 290 hadi 43,12 ikilinganishwa na kurasa za 4 KB.
Katika C++, stateless lambda iko karibu na inline function, lakini std::function ilikuwa karibu 5,68× ghali zaidi. dynamic_cast inayotegemea RTTI ilitumia takribani 3,6× cycles zaidi kuliko explicit tagging. Object pool ilitoa takribani 3,7× kasi dhidi ya new/delete ya jumla, huku tail latency ya heap allocation ikibaki juu zaidi.
Data-oriented design inaonyesha kwamba mpangilio wa data unaweza kuwa muhimu kuliko nguvu ya hesabu ya CPU. Sequential access ni takribani 5,35 cycles/access, lakini random pointer chasing ni takribani 378 cycles/access. False sharing iliongeza muda wa majaribio ya nyuzi mbili kwa takribani 7,5×.
Kwenye mtandao, njia ya kawaida ya Linux UDP ililinganishwa na AF_XDP ndani ya network namespace na veth kwenye mashine ileile. Kernel path ilikuwa na mean takribani 200 µs, AF_XDP takribani 8 µs; p50 ilishuka kutoka takribani 218 µs hadi 6 µs. Hata hivyo p99 ya AF_XDP ilibaki karibu 80 µs; kernel bypass haiondoi tail latency yote.
Ujumbe mkuu wa kihandisi ni huu: ucheleweshaji mdogo hautokani na function moja ya haraka, bali na kuondoa kwa mpangilio vyanzo vya kutotabirika kwenye njia muhimu.
Kipimo kikuu katika mifumo ya ucheleweshaji mdogo ni nini?
Katika programu za kawaida, throughput ya wastani inaweza kutosha. Katika HFT, hata mruko mmoja wa ucheleweshaji unaweza kuwa na maana ya kiuchumi. Kwa hiyo mnyororo mzima wa p50 → p99 → p99.9 → p99.99 → maximum latency unapaswa kupimwa.
Je, scheduler pekee inatosha?
Hapana. Katika cyclictest, SCHED_FIFO ni bora kwa wakeup latency ya kawaida kuliko CFS, lakini tail ya kina inahusishwa pia na kernel interference.
| Percentile | CFS | CFS Tuned | SCHED_FIFO |
|---|---|---|---|
| p50 | 55 µs | 55 µs | 5 µs |
| p99 | 67 µs | 811 µs | 15 µs |
| p99.9 | 1383 µs | 929 µs | 1287 µs |
| p99.99 | 3386 µs | 1916 µs | 2673 µs |
CPU isolation na interrupt steering
Hata thread iliyopin kwenye CPU maalumu inaweza kukatizwa na timer tick, RCU callback, kernel workqueue au hardware interrupt. Utafiti ulitumia isolcpus, nohz_full, rcu_nocbs, cpuset/cgroup na workqueue relocation ili kuitenganisha core muhimu kwa latency na shughuli za housekeeping.
| Percentile | CFS | CFS + Isolation | RT | RT + Isolation |
|---|---|---|---|---|
| p50 | 55 µs | 55 µs | 5 µs | 5 µs |
| p99 | 67 µs | 61 µs | 15 µs | 10 µs |
| p99.9 | 1383 µs | 77 µs | 1287 µs | 33 µs |
| p99.99 | 3386 µs | 201 µs | 2673 µs | 174 µs |
| Kipimo | Bila isolation | Isolation | Isolation + IRQ Steering |
|---|---|---|---|
| p99.9 | 1287 µs | 33 µs | 40 µs |
| p99.99 | 2673 µs | 174 µs | 109 µs |
| Maximum | 4673 µs | 564 µs | 399 µs |
Median hubaki karibu sawa, lakini p99.9 na p99.99 hupungua sana. Hii inaunga mkono tofauti kati ya scheduler kwa latency ya kawaida na isolation kwa ultra-tail.
Page fault, huge pages na VM tuning
Linux hutumia demand paging kwa anonymous memory. Katika jaribio la 512 MB anonymous mapping kulionekana takribani 131.000 minor page faults, na gharama ya mguso wa kwanza ilikuwa takribani 2 µs kwa ukurasa. MAP_POPULATE ilishusha first access katika steady-state hadi karibu 20 ns.
| Muundo wa ukurasa | Cycles / Access | dTLB Miss Rate |
|---|---|---|
| 4 KB | ≈290 | ≈%1,33 |
| Transparent Huge Pages | ≈241 | ≈%0,47 |
| Explicit HugeTLB 2 MB | 43,12 | %0,09 |
Explicit HugeTLB hupunguza cycles/access kwa takribani 6–7×. THP inaweza kuzalisha tail spike za millisecond kwa sababu ya collapse, split na memory compaction.
| Percentile | Default | Baada ya VM tuning |
|---|---|---|
| p50 | 92 µs | 30 µs |
| p99 | 204 µs | 556 µs |
| p99.9 | 4415 µs | 4898 µs |
| p99.99 | 7630 µs | 7076 µs |
| Maximum | 9230 µs | 8013 µs |
Median huboreka, lakini p99 na p99.9 huzorota. Kwa hivyo runtime allocation katika hot path ni hatari; preallocation ni salama zaidi.
Mitigations, C-state na C++
| Kipimo | Mitigations ON | Mitigations OFF |
|---|---|---|
| Raw syscall | 2850 cycles | 306 cycles |
| libc syscall | 2815 cycles | 278 cycles |
| Context switch | 24.301 cycles | 14.829 cycles |
| sched pipe | 7,76 µs/op | 4,76 µs/op |
Kuzima mitigations hupunguza gharama ya syscall na context switch, lakini kunaweza kuongeza hatari za usalama za speculative execution; si pendekezo la jumla kwa mifumo ya kawaida.
| Hali | p99 | p99.9 | p99.99 |
|---|---|---|---|
| C-state ON / Idle | 54 µs | 57 µs | 175 µs |
| C-state OFF / Idle | 54 µs | 55 µs | 58 µs |
| C-state ON / Stress | 77 µs | 144 µs | 182 µs |
| C-state OFF / Stress | 70 µs | 149 µs | 197 µs |
| Dispatch | Aina 1 | Aina 4 | Aina 8 |
|---|---|---|---|
| Static | 1,32 ms | 8,75 ms | 10,02 ms |
| Virtual | 1,94 ms | 9,19 ms | 10,38 ms |
Virtual dispatch ina gharama, lakini si kila virtual function ni mbaya; ABI-stable interfaces, plugins na cold path bado zinaweza kuhitaji dynamic polymorphism.
| Muundo wa move | Wall Time |
|---|---|
| noexcept move | 101,6 s |
| non-noexcept move | 263,4 s |
noexcept haiongezi kasi kila mahali, lakini katika std::vector reallocation inaweza kuzuia fallback ya copy na kutoa tofauti ya takribani 2,6×.
| Callable | Relative Cost |
|---|---|
| Inline function | 1,00× |
| Stateless lambda | 1,03× |
| std::function | 5,68× |
std::function ni ghali kwa sababu ya type erasure na indirect dispatch. dynamic_cast pia ilitumia zaidi kuliko explicit tagging.
PGO, allocation, cache na concurrency
| Kipimo | Baseline | PGO |
|---|---|---|
| Execution Time | 1,791 s | 1,766 s |
| Cycles | 6,20 B | 6,11 B |
| Instructions | 12,77 B | 11,07 B |
| LLC Load Misses | 419 K | 398 K |
PGO ilitoa faida ndogo ya takribani %1,4, lakini maboresho madogo yanaweza kujikusanya katika production hot path.
| Operesheni | Median | p99.9 | Maximum |
|---|---|---|---|
| new | 82 cycles | 8586 cycles | 172.401 cycles |
| Pool allocate | 32 cycles | 246 cycles | 81.756 cycles |
| delete | 60 cycles | 433 cycles | 73.471 cycles |
| Pool deallocate | 34 cycles | 262 cycles | 52.153 cycles |
Object pool inaonyesha faida kubwa hasa katika tail. Sequential array ni ≈5,35 cycles/access, random pointer chasing ni ≈378 cycles/access, tofauti ya karibu 70×.
| Aina ya ufikiaji | Cycles / Access |
|---|---|
| Sequential array | ≈5,35 |
| Random pointer chasing | ≈378 |
Kutenganisha hot/cold data kulishusha muda kutoka 1,08746 s hadi 0,91845 s na cache misses kutoka 7,8×10⁷ hadi 3,5×10⁷. False sharing ilikuwa 4,16 s, cache-line padded 0,55 s.
| Mpangilio | Cycles | Muda |
|---|---|---|
| False sharing | 2,73×10¹⁰ | 4,16 s |
| Cache-line padded | 3,61×10⁹ | 0,55 s |
AoS ilichukua takribani 258 ms, SoA 145 ms. SIMD scalar ilikuwa 406 ms, AVX 370 ms; faida ni karibu %7.
| Operesheni | p50 | p99.9 | p99.99 |
|---|---|---|---|
| Lock Push | 80 | 17.785 | 32.115 cycles |
| Lock-Free Push | 47 | 294 | 378 cycles |
| Lock Pop | 81 | 12.958 | 46.048 cycles |
| Lock-Free Pop | 25 | 226 | 278 cycles |
Lock-free iliboresha tail katika SPSC ring buffer, lakini katika contention kubwa CAS retry inaweza kusababisha cache-line ping-pong na kuwa mbaya kuliko mutex.
AF_XDP
Njia ya kawaida ya Linux ni NIC → Driver → sk_buff → IP/UDP Stack → Socket → System Call → User Space. AF_XDP huondoa sehemu kubwa ya njia hiyo: NIC → XDP → AF_XDP → UMEM → User Space.
| Njia ya mtandao | Mean | p50 | p99 |
|---|---|---|---|
| Kernel Stack | ≈200 µs | ≈218 µs | ≈300 µs |
| AF_XDP | ≈8 µs | ≈6 µs | ≈80 µs |
Jaribio hili lilifanywa katika namespace/veth kwenye mashine moja; halipimi latency halisi ya mwisho-hadi-mwisho ya production HFT network.
Njia na dokezo la chanzo
| Kipengele | Mazingira yaliyotumika |
|---|---|
| CPU | Intel Core i5-6500 @ 3,20 GHz |
| Core | 4 core / 1 thread per core |
| RAM | 3,7 GiB |
| NUMA | Node moja |
| Linux kernel | 6.8.0-90-generic |
| Compiler | GCC 13.3.0 |
| Default build | -O2 |
| CPU governor | performance |
Kichwa asili: Design Choices in Low-Latency C++ Systems: Empirical Insights with Applications to High-Frequency Trading
Mwandishi: Khalid Mohammad. Taasisi: Department of Computer Science, Indian Institute of Technology Kharagpur. Tarehe: 3 Aprili 2026; SSRN upload: 17 Aprili 2026; SSRN ID: 6513601; DOI: 10.2139/ssrn.6513601.
Aina ya uchapishaji: Preprint. Matokeo yanategemea mfumo mmoja wa Intel i5-6500 na matoleo fulani ya Linux/GCC; AF_XDP ilipimwa katika namespace/veth; utafiti haupimi trading alpha, utabiri wa soko au mapato ya mkakati.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *