

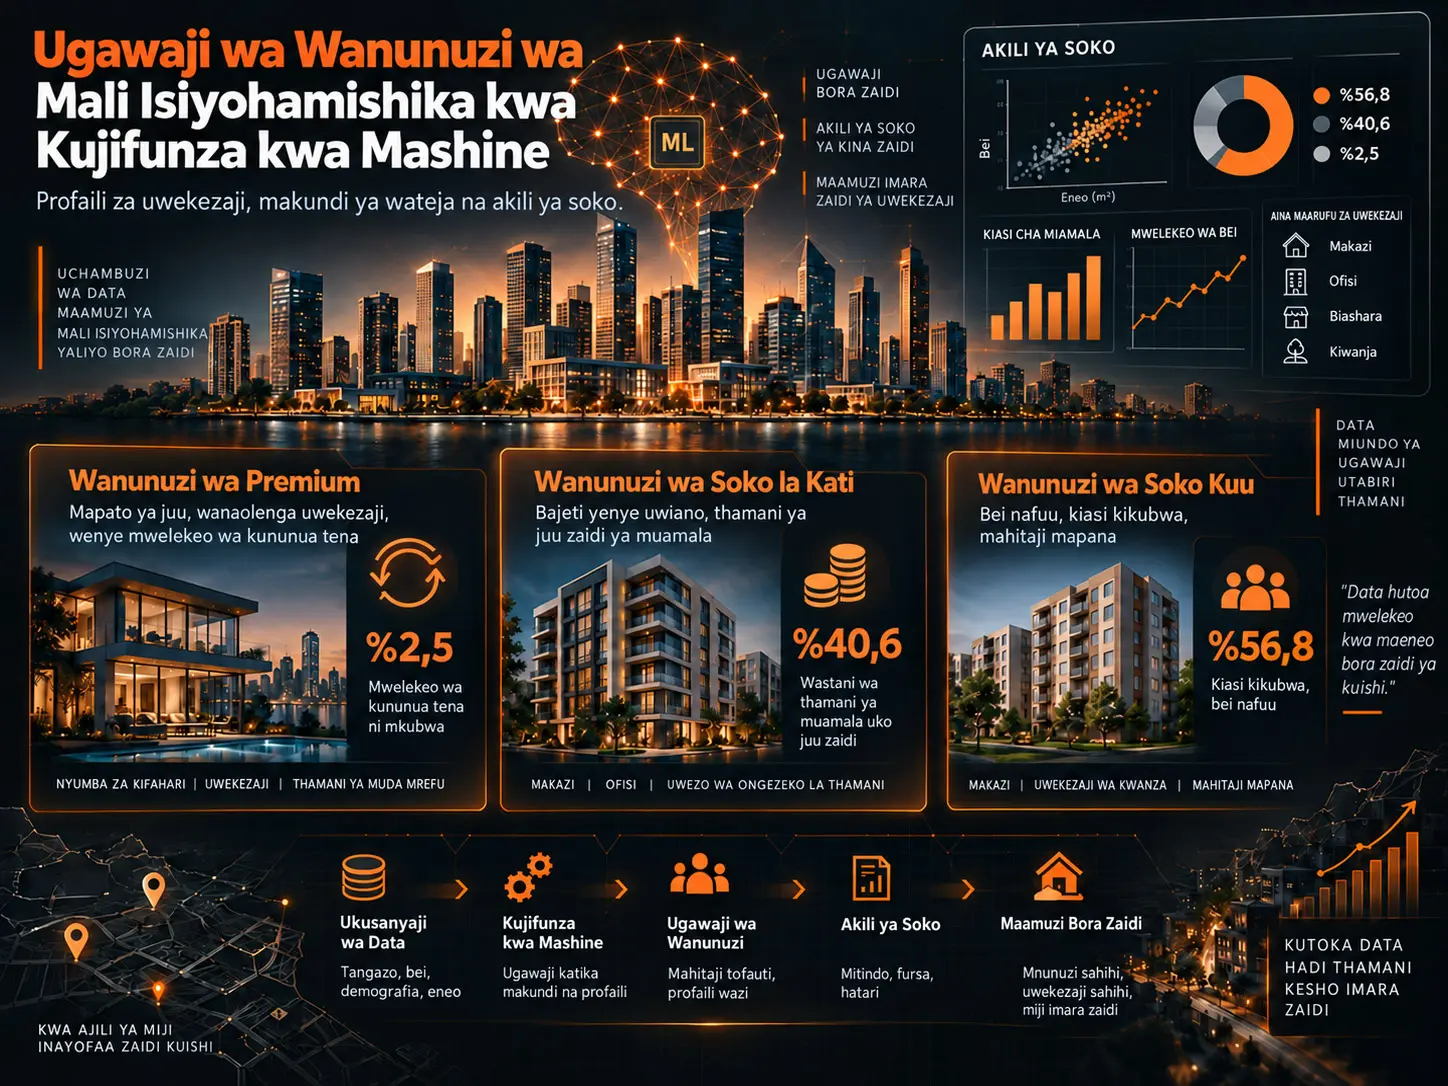
Ugawaji wa wanunuzi katika makundi unalenga kugawanya wateja wanaofanya miamala katika soko lilelile la mali isiyohamishika katika vikundi vinavyofanana kwa kuzingatia sifa za kitabia/kimiamala kama vile mara wanazonunua, thamani ya muamala, bei kwa kitengo cha eneo, umri na kuridhika. Utafiti huu unatumia rekodi 2.000 za wateja pamoja na matangazo 10.000 ya mali isiyohamishika kuunda makundi matatu ya wateja kwa msingi wa K-Means na kuyatafsiri kwa mtazamo wa masoko ya mali isiyohamishika na usimamizi wa wateja.
Kati ya matangazo 10.000 katika mkusanyiko wa data za mali isiyohamishika, 7.305 yameuzwa na 2.695 yako katika hali ya Available. Rekodi zilizouzwa zilioanishwa na wateja; kwa kila mteja, bei ya wastani ya mauzo, bei ya kati ya mauzo, bei ya wastani kwa ft², idadi ya ununuzi na jumla ya miamala/matangazo zilihesabiwa; alama ya kuridhika na umri zikaongezwa ili kuunda jedwali la nambari lenye vipimo saba kwa ajili ya uundaji wa makundi.
Utafiti unalinganisha algoriti ya K-Means kuanzia k=2 hadi k=8. Kuna undani muhimu wa kimetodolojia hapa: thamani za juu zaidi za Silhouette Score na Calinski–Harabasz Index zinatokea katika k=2. k=3 haikuchaguliwa kwa sababu ndiyo optimum ya moja kwa moja ya vipimo; ilichaguliwa kutokana na mgeuko wa kwanza wenye maana katika mkunjo wa Calinski–Harabasz, kiwango cha Silhouette ambacho bado kilionekana kukubalika katika k=3, na hitaji la mradi la kuwa na angalau segmenti tatu zinazoweza kutafsiriwa kibiashara.
Hatimaye, kundi dogo la watu 51 wenye miamala ya mara kwa mara, kundi la watu 813 lenye thamani kubwa ya miamala, na kundi kubwa la watu 1.136 la wateja wa kawaida yaliundwa. Chanzo kinayaita, kwa mpangilio huo, Premium Buyers, Mid-Market Buyers na Mainstream Buyers. Hata hivyo, lebo “Premium” haimaanishi kundi linalonunua mali ghali zaidi; bei ya juu zaidi ya wastani na ya kati ya mauzo inaonekana katika Cluster 1.
Kwa nini wateja wa mali isiyohamishika hawapaswi kuchukuliwa kama kundi moja?
Mtu anayenunua nyumba yake ya kwanza kwenye jukwaa la mali isiyohamishika, mwekezaji anayenunua mali mara kwa mara, akaunti ya kampuni, au mteja anayeelekea kwenye vitengo vya bei ya juu hawana tabia sawa ya ununuzi. Ujumbe mmoja wa masoko hauwezi kulenga mahitaji ya makundi haya yote kwa usahihi uleule.
Lengo la utafiti ni kufichua tofauti hizi kupitia ujifunzaji usiosimamiwa ndani ya mifumo ya data za miamala, badala ya kuzilazimisha kwa lebo za wateja zilizofafanuliwa mapema.
Mkusanyiko wa data za wateja
Katika mkusanyiko wa data wenye wateja 2.000, wateja binafsi ni %94,9 na kampuni ni %5,1. Mgawanyo wa kijinsia uko karibu kuwa sawia. %76,9 ya wateja wako Marekani na California peke yake ndiyo eneo linalotawala kwa sehemu ya %31,7.
Kwa madhumuni ya ununuzi, %69,3 ya wateja wako katika kitengo cha Home na %30,8 katika Investment. Waliotuma maombi ya mkopo ni %36,8; wasiowasilisha ni %63,2. Kwa kipimo cha 5, alama ya wastani ya kuridhika ni 3,03.
Mkusanyiko wa data za mali isiyohamishika
| Kipengele | Muundo ulioripotiwa katika chanzo |
|---|---|
| Jumla ya matangazo | 10.000 |
| Sold | 7.305 (%73,1) |
| Available | 2.695 (%26,9) |
| Eneo | 411–1.957 ft² |
| Bei ya mauzo | Takribani dola za Marekani 100.000–730.000 |
| Bei kwa ft² | Takribani dola za Marekani 220–430 |
| Apartments | %85,5 |
| Office | %14,5 |
Je, data zinazokosekana kweli ni za nasibu?
Katika matangazo yenye hali ya Available hakuna client_ref; kwa sababu mali hiyo bado haijahusishwa na mteja. Chanzo kinafafanua muundo huu kama MNAR.
Jambo muhimu kiutendaji ni kwamba ukosefu huu hauonekani kama hitilafu ya data: thamani za missing zinaoana kwa utaratibu na hali ya Available. Kwa kuwa uundaji wa makundi ulitengenezwa tu kutokana na matangazo yaliyokuwa yameuzwa na kuoanishwa na mteja, sehemu tupu ya client_ref katika rekodi za Available haikujumuishwa moja kwa moja katika modeli ya makundi.
Ni vipengele gani vinavyomwakilisha mteja?
Matangazo yaliyokuwa yameuzwa yaliunganishwa na wateja kupitia client_id = client_ref, na vipengele saba vya nambari vifuatavyo viliandaliwa kwa kila mteja:
| Kipengele | Kazi yake |
|---|---|
| avg_sale_price | Thamani ya wastani ya miamala ya mali alizonunua mteja |
| median_sale_price | Median ya bei za ununuzi |
| avg_price_per_sqft | Bei ya wastani iliyolipwa kwa ft² |
| purchases_count | Mara za ununuzi |
| total_listings | Msongamano wa jumla wa miamala/matangazo yanayohusiana na mteja |
| satisfaction_score | Alama ya kuridhika |
| age | Umri uliotokana na tarehe ya marejeo ya 1 Januari 2025 |
Kwa nini StandardScaler ilitumika?
K-Means hutegemea umbali wa Euclidean kati ya nukta. Bei za mauzo zinaonyeshwa kwa mamia ya maelfu ilhali alama ya kuridhika iko katika kiwango cha 1–5. Ikiwa thamani ghafi zitaingizwa moja kwa moja kwenye modeli, vigezo vya bei vyenye kiwango kikubwa cha nambari vitatawala kipimo cha umbali.
Kwa hiyo, vipengele vyote saba vya nambari vilisanifishwa kwa StandardScaler ili viwe na wastani wa sifuri na mkengeuko sanifu wa moja.
Mbinu na Matokeo ya Utafiti
K-Means hufanyaje kazi?
K-Means hugawanya nukta za data katika makundi k yaliyowekwa mapema na kuhusisha kila uchunguzi na kituo cha kundi kilicho karibu zaidi. Algoriti hujaribu kupunguza jumla ya umbali uliopandishwa mraba ndani ya makundi.
Katika utafiti huu, chaguo za k=2, 3, 4, 5, 6, 7 na 8 zililinganishwa.
Silhouette Score hupima nini?
Silhouette Score huunganisha katika kipimo kimoja jinsi mteja alivyo karibu na wateja wengine katika kundi lake na jinsi alivyo mbali na kundi mbadala lililo karibu zaidi.
Thamani inapokaribia +1, utengano huwa mkubwa; inapokaribia sifuri, makundi huwa yanaingiliana zaidi; ikiwa ni hasi, baadhi ya uchunguzi unaweza kuwa umewekwa katika kundi lisilo sahihi.
Calinski–Harabasz Index hupima nini?
Calinski–Harabasz Index hulinganisha mtawanyiko kati ya makundi na mtawanyiko ndani ya kundi. Thamani ya juu kwa ujumla humaanisha makundi yaliyoshikamana zaidi na yaliyotenganishwa vizuri zaidi.
Je, k=3 kweli ndiyo idadi bora ya makundi?
Kulingana na matokeo ya vipimo vya chanzo chenyewe, si kwa hakika katika maana safi ya kihisabati. Vipimo vyote viwili vya uthibitishaji wa ndani vilipata thamani za juu katika k=2. k=3 ilichaguliwa kama suluhu ya kati kutokana na mgeuko wa kwanza katika mkunjo wa CH, matokeo ya Silhouette yaliyokuwa thabiti kiasi, na hitaji la mradi la kuwa na segmenti tatu za kibiashara.
Calinski–Harabasz Index katika k=2 ni takribani 506, na katika k=8 hupungua mfululizo hadi takribani 347. Thamani za Silhouette hubaki karibu na sifuri katika chaguo zote za k.
Kwa hiyo, segmenti tatu za utafiti zinaweza kuwa rahisi kutafsiri kibiashara; lakini dai kwamba data zinagawanyika kiasili katika makundi matatu yaliyo wazi na yenye nguvu halihimiliwi kwa nguvu na vipimo hivi.
Ukubwa wa makundi
| Kundi | Lebo ya chanzo | Wateja | Sehemu |
|---|---|---|---|
| Cluster 0 | Premium Buyers | 51 | %2,5 |
| Cluster 1 | Mid-Market Buyers | 813 | %40,6 |
| Cluster 2 | Mainstream Buyers | 1.136 | %56,8 |
Mchoro wa PCA unaonyesha nini?
Vipengele vya wateja vilivyosanifishwa vya vipimo saba vilipunguzwa hadi vipengele vikuu viwili kwa madhumuni ya uonyeshaji tu.
Katika grafu ya PCA kwenye kurasa 15–16 za chanzo, Cluster 0 inaonekana imeshikamana zaidi katika eneo la juu-kulia na iko mbali wazi na makundi mengine. Cluster 1 na Cluster 2 zinaingiliana kwa sehemu katika mwelekeo wa ulalo.
Mchoro huu hurahisisha kuelewa muundo wa segmenti; lakini kwa kuwa grafu ya PCA ilitengenezwa baada ya modeli, si jaribio huru la uthibitishaji wa nje.
Matokeo ya ANOVA
| Kipengele | F-statistiki | p-thamani |
|---|---|---|
| median_sale_price | 1609,44 | <0,001 |
| avg_sale_price | 1436,81 | <0,001 |
| purchases_count | 1049,91 | <0,001 |
| avg_price_per_sqft | 83,01 | <0,001 |
| age | 8,49 | 0,0002 |
Matokeo haya yanaonyesha kuwa kuna tofauti kubwa kati ya makundi katika vipengele hivyo.
Hata hivyo, vipengele hivi pia ndiyo vigezo vilivyotumiwa na K-Means kuunda makundi. Kwa hiyo, kupata ANOVA yenye umuhimu si sawa na uthibitishaji uliofanywa katika sampuli huru. Ili kutathmini uthabiti wa segmenti kwa nguvu zaidi, resampling, uchambuzi wa bootstrap/stability, mbinu kama holdout, au kulinganisha na njia mbadala za clustering kungeweza kutoa ushahidi wa ziada wenye nguvu.
Cluster 0: Premium Buyers
Ingawa Cluster 0 ina wateja 51 tu, ina thamani za juu zaidi za kuridhika, umri, purchases_count na total_listings.
Kwa kuzingatia, si kinara katika vipengele vya bei. Kwa hiyo, chanzo kinatafsiri kundi hili si kama wateja wanaonunua mali ghali zaidi katika muamala mmoja, bali kama wateja wa uhusiano wa thamani kubwa, waaminifu na wenye miamala inayojirudia.
Kwa hiyo, lebo “Premium” hapa inapaswa kusomwa kama premia ya uhusiano na mara za miamala.
Cluster 1: Mid-Market Buyers
Kundi la watu 813, Cluster 1, lina bei ya juu zaidi ya wastani na ya kati ya mauzo. Mara za ununuzi ni za wastani zaidi kuliko Cluster 0.
Chanzo kinatafsiri kundi hili kama wateja wanaofanya ununuzi mmoja au wachache lakini wa thamani kubwa, na ambao wanaweza kuelekea kwenye vitengo vikubwa vya apartment au office.
Kwa hiyo jina “Mid-Market” linaweza kupotosha kwa mtazamo wa kwanza; kwa upande wa bei ya muamala, kundi lenyewe liko kwenye upande wa juu kati ya makundi matatu.
Cluster 2: Mainstream Buyers
Ni segmenti kubwa zaidi yenye wateja 1.136. Iko chini ya wastani katika vipengele vingi vilivyosanifishwa na inatafsiriwa na chanzo kama msingi wa wateja wanaojali bei, wa kiwango cha kuingia, au wa kawaida.
Kwa sababu ya ukubwa wa segmenti hii, thamani ndogo kwa kila mteja haimaanishi kuwa umuhimu wake wa jumla wa kibiashara ni mdogo.
Je, ni salama kufanya uamuzi wa moja kwa moja wa masoko kutokana na segmenti?
Segmenti huzalisha dhana zinazoweza kutumiwa kuhusu tabia ya wateja; lakini mapendekezo ya masoko katika ripoti yenyewe hayajajaribiwa kwa majaribio. Hitimisho za kisababishi kama “kampeni hii ikitumika kwa segmenti hii, conversion itaongezeka” zinahitaji A/B tests, kampeni za kutazamia mbele, au uthibitishaji huru.
Mbinu iliyopendekezwa kwa kundi la Premium
Chanzo kinapendekeza premium CRM/msimamizi wa uhusiano, ufikiaji wa mapema wa inventory mpya, mapitio ya portfolio yaliyobinafsishwa na programu za referral kwa wateja wote 51.
Hoja ya mapendekezo haya ni kiwango kikubwa cha miamala inayojirudia na kuridhika; lakini ripoti haijaribu kama motisha ya referral kweli italeta conversion ya juu zaidi.
Mbinu iliyopendekezwa kwa kundi la Mid-Market
Chanzo kinapendekeza upsell kwenda kwenye vitengo vikubwa vya Office, kulenga matangazo ya takribani dola 350.000–500.000 na zaidi ya 1.100 ft², na kufanya kampeni kupitia njia ya Agency.
Hizi ni sheria za ulengaji zilizotokana na wasifu wa kundi; ongezeko la mauzo halijapimwa kwa majaribio.
Mbinu iliyopendekezwa kwa kundi la Mainstream
Inapendekezwa Website/SEO optimization, kuongeza mwonekano wa fursa za mikopo, na kuangazia matangazo ya kiwango cha kuingia yaliyo chini ya 800 ft² na chini ya dola 250.000.
Pia, mifumo ya uaminifu inayohamasisha ununuzi wa pili na kuunda uhamaji wa mteja kutoka Mainstream kwenda Mid-Market inazingatiwa.
Je, lebo ya segmenti ni sawa na persona ya mteja?
Hapana.
K-Means iliunda makundi matatu tu yanayoendeshwa na data. Hata hivyo, brief ya mradi ina persona nne za kibiashara: Global Investors, Luxury Investors, Corporate Buyers na First-Time Buyers.
Chanzo baadaye kinaoanisha makundi matatu na persona hizi nne. Kwa mfano, Cluster 0 inahusishwa na Global Investors na Luxury Investors, ilhali ndani ya Cluster 2 wale wenye loan_applied = Yes wanaweza kugawanywa zaidi kama First-Time Buyers.
Hatua hii ya pili si kundi jipya lililogunduliwa na K-Means; ni uainishaji wa kibiashara unaotegemea sheria.
Streamlit dashboard hutoa nini?
Ripoti inafafanua paneli nne kuu:
| Paneli | Maudhui |
|---|---|
| Buyer Segmentation Overview | Mgawanyo na ukubwa wa makundi |
| Investor Behaviour Dashboard | Mitindo ya bei na mikopo kwa segmenti |
| Geographic Buyer Analysis | Mgawanyo wa kijiografia na ramani ya cluster |
| Segment Insights Panel | Wastani wa vipengele na heatmap iliyosanifishwa |
Inaelezwa kuwa vichujio vya Country, region, acquisition purpose na client type vinaweza kutumika kwa nguvu kwa grafu zote.
Matatizo mawili muhimu ya uthibitishaji katika sehemu ya fasihi
Ripoti inasema Limsombunchai na wenzake walijaribu modeli za hedonic zinazotegemea buyer-segment. Hata hivyo, rekodi huru ya bibliografia inaonyesha kuwa utafiti huo ulikuwa ulinganisho wa hedonic price model na artificial neural network katika nyumba 200 za Christchurch. Kwa hiyo, maelezo ya segmenti katika ripoti ya chanzo hayaonekani kulingana na makala hiyo.
Kuna tatizo linalofanana kwa Antipov na Pokryshevskaya (2012). Ripoti inaielezea kama kutumia ensemble classification kwa buyer segments zilizotokana na K-Means, ilhali utafiti halisi unaangazia mass appraisal ya nyumba kwa Random Forest na uchunguzi wa modeli unaotegemea CART.
Hali hii haiyafanyi moja kwa moja kuwa batili maadili katika uchambuzi mkuu wa K-Means; lakini inaonyesha kwamba baadhi ya hoja za uhalalishaji katika sehemu ya fasihi zinahitaji kuoanishwa tena na vyanzo vyake.
Nguvu za utafiti
Hatua za kusafisha data zimeandikwa kwa uwazi. Vigezo vya kikategoria vimetenganishwa na vigezo vya clustering. Hoja ya usanifishaji imeunganishwa na tatizo sahihi. Ukubwa wa makundi, PCA, ANOVA na wasifu wa segmenti vimewasilishwa pamoja. Dashboard inaweka wazi lengo la kupeleka matokeo ya kiufundi kwa watumiaji wa biashara.
Mapungufu ya utafiti
Kizuizi cha kwanza ni kwamba uamuzi wa k=3 uliathiriwa na hitaji la biashara. Kizuizi cha pili ni kwamba thamani ndogo za Silhouette zinaashiria kuwa mipaka ya segmenti si yenye nguvu.
Kizuizi cha tatu ni “kuthibitisha” kwa ANOVA makundi yaliyojengwa kwa vigezo vilevile kwa kutumia tena vigezo hivyo. Kizuizi cha nne ni kwamba lebo za segmenti — hasa “Premium” na “Mid-Market” — haziendani moja kwa moja na mpangilio wa nambari wa bei.
Kizuizi cha tano ni matumizi ya tabia ya miamala iliyopo pekee. Kipengele cha muda, thamani ya maisha ya mteja, riba ya soko, faharasa ya makazi na mazingira ya uchumi mkuu hayajajumuishwa katika modeli.
Kizuizi cha sita ni kwamba hifadhidata inaegemea sana Marekani na hasa California kijiografia. Kwa hiyo, haijaonyeshwa kama segmenti zinaweza kuhamishwa moja kwa moja kwenda nchi au masoko mengine.
Hitimisho la jumla
Utafiti huu unatoa mtiririko wa kazi wa sayansi ya data unaoweza kutumika unaolenga kuunda profaili tatu za kibiashara kutokana na tabia ya miamala badala ya kuona msingi wa wateja wa mali isiyohamishika kama kundi moja.
Muundo wa makundi matatu unaeleweka kibiashara: wateja wachache lakini waaminifu wenye miamala ya mara nyingi, kundi la ukubwa wa kati linaloelekea kwenye miamala ya bei ya juu, na msingi mkubwa wa wateja wa kawaida.
Hata hivyo, hitimisho kwamba k=3 ndiyo optimum kamili ya kitakwimu halihimiliwi kwa nguvu na data za chanzo. Vipimo vya ndani viliipa k=2 alama ya juu zaidi, na k=3 ilichaguliwa kwa sehemu kutokana na hitaji la biashara.
Kwa hiyo, matumizi yenye nguvu zaidi ya ripoti si dai kwamba “tumegundua kwa hakika madarasa matatu ya asili ya wateja sokoni,” bali kuiangalia kama prototipu ya segmenti ya kiutendaji inayoweza kutafsiriwa kwa ulengaji wa wateja na uundaji wa dashboard.
Dokezo la Chanzo na Mbinu
Utafiti asilia:Machine Learning Based Buyer Segmentation and Investment Profiling for Real Estate Market Intelligence.
Mwandishi: Gokul Mallabathula.
Jukumu katika faili ya chanzo: Data Science Intern, Unified Mentor | Parcl Real Estate Intelligence Project.
Aina ya chanzo: Ripoti ya mradi wa sayansi ya data tumizi / segmenti ya wateja wa mali isiyohamishika.
Tarehe iliyo kwenye faili: Juni 2025.
Metadata ya SSRN: Date Written 31 May 2026; Posted 25 June 2026; SSRN abstract 6881578.
DOI: 10.2139/ssrn.6881578.
Kutolingana kwa tarehe: Juni 2025 kwenye jalada la PDF hailingani na tarehe za 2026 katika metadata ya SSRN. Verianla inaacha tofauti hii ionekane bila kuisahihisha.
Mapitio ya rika: Hakuna ushahidi kwamba kazi hii ni version-of-record ya jarida lililopitiwa na rika; imetathminiwa kama maandishi ya kazi ya mradi/SSRN.
Leseni: Rekodi ya SSRN inaeleza kwamba haki zimehifadhiwa na matumizi tena bila ruhusa hayaruhusiwi. Kwa hiyo, muundo wa grafiki za chanzo haupaswi kunakiliwa moja kwa moja.
Data: Wateja 2.000, matangazo 10.000 ya mali isiyohamishika; kati yake 7.305 yameuzwa na 2.695 yako katika hali ya Available.
Jedwali la clustering: Vipengele saba vya nambari kwa wateja 2.000.
Vipengele: avg_sale_price, median_sale_price, avg_price_per_sqft, purchases_count, total_listings, satisfaction_score na age.
Usawazishaji wa kipimo: StandardScaler.
Algoriti kuu: K-Means.
Wagombea wa k: 2–8.
Vipimo vya uthibitishaji wa ndani: Silhouette Score na Calinski–Harabasz Index.
Kikomo cha uchaguzi wa k: Vipimo vyote viwili vilifikia kilele katika k=2. k=3 ilichaguliwa kwa kuzingatia pamoja mgeuko wa kwanza katika mkunjo wa CH, uwezo wa kutafsiriwa na hitaji la angalau segmenti tatu za biashara.
PCA: Ilitumika baada ya clustering kwa uonyeshaji wa vipengele vya vipimo saba vilivyosanifishwa katika vipimo viwili.
Uchambuzi wa kitakwimu: One-way ANOVA na Tukey HSD. Kwa sababu vipengele vilevile vilitumika katika clustering na baadaye katika jaribio la umuhimu, majaribio haya si uthibitishaji huru wa nje wa makundi.
Segmenti: Cluster 0 — Premium Buyers, n=51; Cluster 1 — Mid-Market Buyers, n=813; Cluster 2 — Mainstream Buyers, n=1.136.
Kikomo cha lebo: Jina “Premium” la Cluster 0 halitegemei bei ya juu zaidi ya ununuzi; avg_sale_price na median_sale_price za juu zaidi ziko katika Cluster 1.
Dashboard: Dashboard yenye tabo nne inayotegemea Streamlit imeripotiwa. Hakuna hifadhi ya msimbo inayoweza kuendeshwa kwa kujitegemea au kiungo cha deployment kilichothibitishwa ndani ya PDF.
Ukaguzi wa fasihi: Maelezo ya vyanzo vya Limsombunchai et al. (2004) na Antipov & Pokryshevskaya (2012) katika ripoti hayalingani kikamilifu na mada za utafiti asilia zinazoweza kuthibitishwa. Kwa hiyo, marejeo hayo hayakutumiwa katika maandishi ya Verianla kama ushahidi wa moja kwa moja wa mbinu ya segmenti.
Kazi ya baadaye: Chanzo kinapendekeza kujaribu suluhu ya k=3 kwa hierarchical clustering, kuunda modeli za lifetime-value kwa data za miamala za muda, kupanua wigo wa kijiografia na kuongeza viashiria vya uchumi mkuu kama viwango vya riba/faharasa za makazi za kikanda.
Mbinu ya maandalizi ya Verianla: Ukubwa wa data, hatua za modeli, matokeo ya segmenti na mapendekezo ya biashara ya chanzo yamehifadhiwa; hata hivyo, nguvu ya uchaguzi wa k=3, asili ya uthibitishaji wa post-clustering ANOVA, maana ya majina ya segmenti na marejeo ya fasihi yamewekwa tofauti kimetodolojia bila kuunda uhakika usiotokana na chanzo. Hakuna ongezeko la mauzo, faida ya uwekezaji au utendaji wa utabiri ambao haupo katika chanzo uliotengenezwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *