

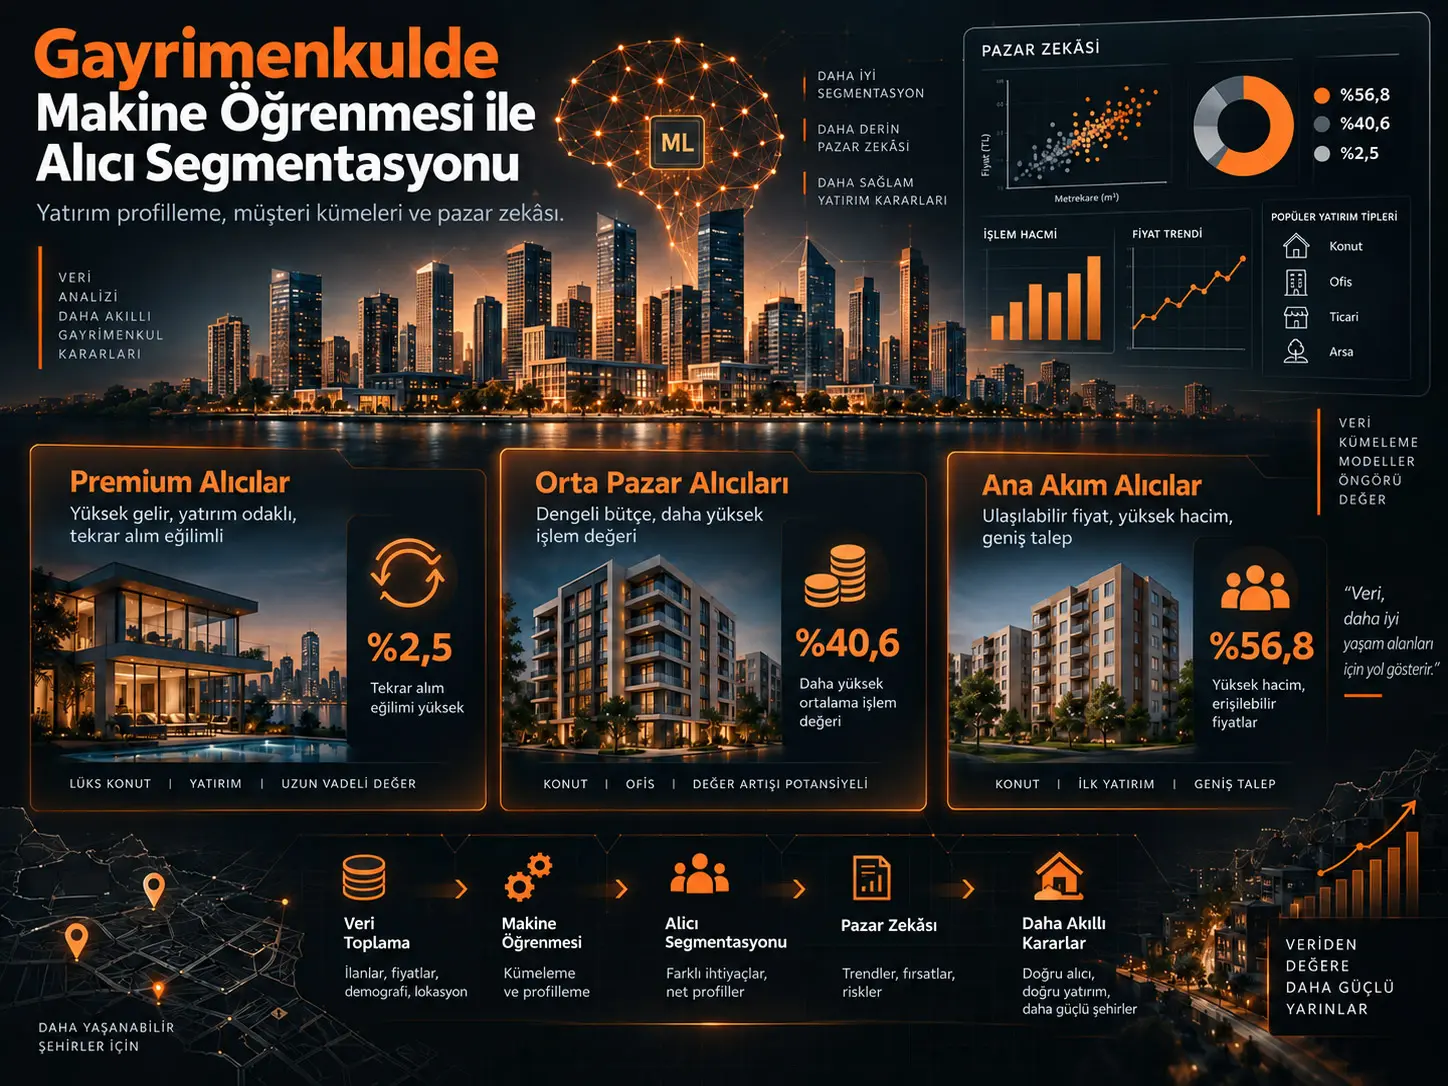
Alıcı segmentasyonu, aynı gayrimenkul pazarında işlem yapan müşterileri satın alma sıklığı, işlem değeri, birim alan fiyatı, yaş ve memnuniyet gibi davranışsal/işlemsel özelliklerine göre benzer gruplara ayırmayı amaçlar. Bu çalışma, 2.000 müşteri kaydı ile 10.000 gayrimenkul ilanını kullanarak K-Means tabanlı üç müşteri segmenti oluşturuyor ve bu segmentleri gayrimenkul pazarlaması ile müşteri yönetimi açısından yorumluyor.
Gayrimenkul veri setindeki 10.000 ilanın 7.305'i satılmış, 2.695'i ise Available durumundadır. Satılmış kayıtlar müşterilerle eşleştirilmiş; her müşteri için ortalama satış fiyatı, medyan satış fiyatı, ortalama ft² başına fiyat, alış sayısı ve toplam işlem/ilan sayısı hesaplanmış; bunlara memnuniyet puanı ve yaş eklenerek yedi boyutlu sayısal kümeleme tablosu oluşturulmuştur.
Çalışma K-Means algoritmasını k=2 ile k=8 arasında karşılaştırmaktadır. Burada önemli bir metodolojik ayrıntı vardır: Silhouette Score ile Calinski–Harabasz Index'in en yüksek değerleri k=2'de ortaya çıkmaktadır. k=3, metriklerin mutlak optimumu olduğu için değil; Calinski–Harabasz eğrisindeki ilk anlamlı kırılma, k=3'te hâlâ kabul edilebilir görülen Silhouette seviyesi ve projenin en az üç iş açısından yorumlanabilir segment istemesi nedeniyle seçilmiştir.
Sonuçta 51 kişilik küçük ve sık işlem yapan bir grup, 813 kişilik yüksek işlem değerine sahip grup ve 1.136 kişilik büyük ana akım grup oluşmuştur. Kaynak bunları sırasıyla Premium Buyers, Mid-Market Buyers ve Mainstream Buyers olarak adlandırmaktadır. Ancak “Premium” etiketi en pahalı gayrimenkulleri alan grup anlamına gelmemektedir; en yüksek ortalama ve medyan satış fiyatı Cluster 1'de görülmektedir.
Gayrimenkul müşterilerini neden tek bir kitle olarak ele almamak gerekiyor?
Gayrimenkul platformunda ilk evini alan birey, tekrar tekrar mülk satın alan yatırımcı, şirket hesabı veya daha yüksek fiyatlı birimlere yönelen müşteri aynı satın alma davranışına sahip değildir. Tek bir pazarlama mesajı bütün bu grupların ihtiyaçlarını aynı doğrulukla hedefleyemez.
Çalışmanın amacı bu farkları önceden tanımlanmış müşteri etiketleriyle dayatmak yerine, işlem verisinin içindeki örüntüleri gözetimsiz öğrenmeyle ortaya çıkarmaktır.
Müşteri veri seti
2.000 müşteriden oluşan veri setinde bireysel müşterilerin oranı %94,9, şirketlerin oranı %5,1'dir. Cinsiyet dağılımı yaklaşık dengelidir. Müşterilerin %76,9'u ABD'dedir ve California tek başına %31,7'lik payla baskın bölgedir.
Satın alma amacı açısından müşterilerin %69,3'ü Home, %30,8'i Investment kategorisindedir. Kredi başvurusu yapanların oranı %36,8; yapmayanların oranı %63,2'dir. Ortalama memnuniyet puanı 5 üzerinden 3,03'tür.
Gayrimenkul veri seti
| Özellik | Kaynakta raporlanan yapı |
|---|---|
| Toplam ilan | 10.000 |
| Sold | 7.305 (%73,1) |
| Available | 2.695 (%26,9) |
| Alan | 411–1.957 ft² |
| Satış fiyatı | Yaklaşık 100.000–730.000 ABD doları |
| Ft² başına fiyat | Yaklaşık 220–430 ABD doları |
| Apartments | %85,5 |
| Office | %14,5 |
Eksik veriler gerçekten rastgele mi?
Available durumundaki ilanlarda client_ref bulunmamaktadır; çünkü bu mülk henüz bir müşteriye bağlanmamıştır. Kaynak bu yapıyı MNAR olarak tanımlamaktadır.
Pratik açıdan önemli nokta, eksikliğin veri hatası gibi görünmemesidir: missing değerler Available statüsüyle sistematik biçimde örtüşmektedir. Kümeleme yalnız müşteriyle eşleşmiş satılmış ilanlardan üretildiği için Available kayıtların boş client_ref alanı doğrudan küme modeline dahil edilmemiştir.
Hangi özellikler müşteriyi temsil ediyor?
Satılmış ilanlar client_id = client_ref üzerinden müşterilerle birleştirilmiş ve her müşteri için aşağıdaki yedi sayısal özellik hazırlanmıştır:
| Özellik | İşlevi |
|---|---|
| avg_sale_price | Müşterinin aldığı mülklerin ortalama işlem değeri |
| median_sale_price | Satın alma fiyatlarının medyanı |
| avg_price_per_sqft | Ortalama ft² başına ödenen fiyat |
| purchases_count | Satın alma sıklığı |
| total_listings | Müşteriyle ilişkili toplam işlem/ilan yoğunluğu |
| satisfaction_score | Memnuniyet puanı |
| age | 1 Ocak 2025 referans tarihinden türetilen yaş |
Neden StandardScaler kullanıldı?
K-Means, noktalar arasındaki Öklid mesafesine dayanır. Satış fiyatları yüz binlerle ifade edilirken memnuniyet puanı 1–5 aralığındadır. Ham değerler doğrudan modele verilirse büyük sayısal ölçeğe sahip fiyat değişkenleri mesafeyi baskılar.
Bu nedenle bütün yedi sayısal özellik sıfır ortalama ve birim standart sapma olacak şekilde StandardScaler ile standartlaştırılmıştır.
Çalışmanın Yöntemi ve Bulguları
K-Means nasıl çalışıyor?
K-Means, veri noktalarını önceden belirlenen k sayıda kümeye dağıtır ve her gözlemi kendisine en yakın küme merkezine atar. Algoritma, kümelerin kendi içindeki toplam kareli mesafeyi küçültmeye çalışır.
Bu çalışmada k=2, 3, 4, 5, 6, 7 ve 8 seçenekleri karşılaştırılmıştır.
Silhouette Score ne ölçüyor?
Silhouette Score, bir müşterinin kendi kümesindeki diğer müşterilere ne kadar yakın olduğunu ve en yakın alternatif kümeye ne kadar uzak olduğunu aynı ölçütte birleştirir.
Değer +1'e yaklaştıkça ayrım güçlü, sıfıra yaklaştıkça kümeler üst üste binen, negatif olduğunda ise bazı gözlemler yanlış kümeye atanmış olabilir.
Calinski–Harabasz Index ne ölçüyor?
Calinski–Harabasz Index, kümeler arasındaki yayılımı küme içi yayılımla karşılaştırır. Daha yüksek değer, genel olarak daha kompakt ve birbirinden ayrılmış kümeler anlamına gelir.
k=3 gerçekten en iyi küme sayısı mı?
Kaynağın kendi metrik sonuçlarına göre salt matematiksel anlamda kesin biçimde değil. Her iki iç doğrulama ölçütü de en yüksek değerini k=2'de almıştır. k=3; CH eğrisindeki ilk kırılma, görece kararlı Silhouette sonucu ve projenin üç iş segmenti istemesi nedeniyle tercih edilen bir uzlaşmadır.
Calinski–Harabasz Index k=2'de yaklaşık 506 iken k=8'de yaklaşık 347'ye kadar sürekli düşmektedir. Silhouette değerleri ise bütün k seçeneklerinde sıfıra yakın kalmaktadır.
Dolayısıyla çalışmanın üçlü segmentasyonu iş açısından yorumlanabilir olabilir; ancak verinin doğal olarak kesin ve güçlü üç kümeye ayrıldığı iddiası bu metriklerle güçlü biçimde desteklenmemektedir.
Küme büyüklükleri
| Küme | Kaynak etiketi | Müşteri | Pay |
|---|---|---|---|
| Cluster 0 | Premium Buyers | 51 | %2,5 |
| Cluster 1 | Mid-Market Buyers | 813 | %40,6 |
| Cluster 2 | Mainstream Buyers | 1.136 | %56,8 |
PCA görseli ne gösteriyor?
Yedi boyutlu standartlaştırılmış müşteri özellikleri, yalnız görselleştirme amacıyla iki ana bileşene indirgenmiştir.
Kaynağın 15–16. sayfalardaki PCA grafiğinde Cluster 0 üst-sağ bölgede daha kompakt ve diğerlerinden belirgin biçimde uzak görünmektedir. Cluster 1 ve Cluster 2 ise diyagonal yönde kısmen üst üste binmektedir.
Bu görsel segment yapısını anlamayı kolaylaştırır; ancak PCA grafiği modelden sonra üretildiği için bağımsız bir dış doğrulama testi değildir.
ANOVA sonuçları
| Özellik | F-istatistiği | p-değeri |
|---|---|---|
| median_sale_price | 1609,44 | <0,001 |
| avg_sale_price | 1436,81 | <0,001 |
| purchases_count | 1049,91 | <0,001 |
| avg_price_per_sqft | 83,01 | <0,001 |
| age | 8,49 | 0,0002 |
Bu sonuçlar kümeler arasında söz konusu özelliklerde büyük farklar bulunduğunu göstermektedir.
Ancak bu özellikler aynı zamanda K-Means'in kümeleri oluştururken kullandığı değişkenlerdir. Dolayısıyla ANOVA'nın anlamlı çıkması bağımsız örneklemde yapılan doğrulamayla eşdeğer değildir. Segmentlerin kararlılığını daha güçlü değerlendirmek için yeniden örnekleme, bootstrap/stability analizi, holdout benzeri yaklaşım veya alternatif kümeleme yöntemleriyle karşılaştırma daha güçlü ek kanıt sağlayabilir.
Cluster 0: Premium Buyers
Cluster 0 yalnız 51 müşteriden oluşmasına rağmen en yüksek memnuniyet, yaş, purchases_count ve total_listings değerlerine sahiptir.
Dikkat çekici biçimde fiyat özelliklerinde lider değildir. Kaynak bu nedenle grubu tek işlemde en pahalı mülkü alan müşterilerden çok, tekrar eden işlemleri bulunan sadık ve yüksek değerli ilişki müşterileri olarak yorumlamaktadır.
Dolayısıyla “Premium” etiketi burada ilişki ve işlem frekansı primi şeklinde okunmalıdır.
Cluster 1: Mid-Market Buyers
813 kişilik Cluster 1, en yüksek ortalama ve medyan satış fiyatına sahiptir. Alış sıklığı Cluster 0'a göre daha ılımlıdır.
Kaynak bu grubu tek veya daha az sayıda fakat yüksek değerli satın alma yapan, daha büyük apartment veya office birimlerine yönelebilen müşteriler şeklinde yorumlamaktadır.
Bu nedenle “Mid-Market” adı ilk bakışta yanıltıcı olabilir; işlem fiyatı bakımından grubun kendisi üç küme içinde üst uçta bulunmaktadır.
Cluster 2: Mainstream Buyers
1.136 müşteriyle en büyük segmenttir. Standardize özelliklerin çoğunda ortalamanın altında kalır ve kaynak tarafından fiyat duyarlı, giriş seviyesi veya ana akım müşteri tabanı olarak yorumlanır.
Bu segmentin büyüklüğü nedeniyle düşük müşteri başına değer, toplam ticari öneminin düşük olduğu anlamına gelmez.
Segmentlerden doğrudan pazarlama kararı çıkarmak güvenli mi?
Segmentler müşteri davranışı hakkında kullanılabilir hipotezler üretir; ancak rapordaki pazarlama önerilerinin kendisi deneysel olarak sınanmamıştır. “Bu segmente şu kampanya uygulanırsa dönüşüm artar” gibi nedensel sonuçlar için A/B testleri, prospektif kampanyalar veya bağımsız doğrulama gerekir.
Premium gruba önerilen yaklaşım
Kaynak bütün 51 müşteri için premium CRM/ilişki yöneticisi, yeni envantere erken erişim, kişiselleştirilmiş portföy incelemeleri ve referral programları önermektedir.
Bu önerilerin mantığı yüksek tekrar işlem ve memnuniyet düzeyidir; fakat rapor referral teşvikinin gerçekten daha yüksek dönüşüm sağlayacağını test etmemektedir.
Mid-Market gruba önerilen yaklaşım
Kaynak daha büyük alanlı ve Office birimlere upsell, yaklaşık 350.000–500.000 dolar ve 1.100 ft² üzeri ilanların hedeflenmesi ve Agency kanalında kampanya yapılmasını önermektedir.
Bunlar küme profilinden türetilmiş hedefleme kurallarıdır; satış artışı deneysel olarak ölçülmemiştir.
Mainstream gruba önerilen yaklaşım
Website/SEO optimizasyonu, kredi olanaklarının görünürlüğü ve 800 ft² altı, 250.000 dolar altı giriş seviyesi ilanların öne çıkarılması önerilmektedir.
Ayrıca ikinci satın almayı teşvik ederek Mainstream'den Mid-Market'e müşteri geçişi oluşturacak sadakat mekanizmaları düşünülmektedir.
Segment etiketi ile müşteri personası aynı şey mi?
Hayır.
K-Means yalnız üç veri güdümlü küme oluşturmuştur. Proje brifinde ise dört iş personası vardır: Global Investors, Luxury Investors, Corporate Buyers ve First-Time Buyers.
Kaynak, üç kümeyi bu dört persona ile sonradan eşleştirmektedir. Örneğin Cluster 0 hem Global Investors hem Luxury Investors ile ilişkilendirilirken Cluster 2 içinde loan_applied = Yes olanlar First-Time Buyers olarak ayrıca bölünebilir.
Bu ikinci aşama K-Means tarafından keşfedilmiş yeni küme değildir; kural tabanlı iş sınıflandırmasıdır.
Streamlit dashboard ne sağlıyor?
Rapor dört temel panel tanımlamaktadır:
| Panel | İçerik |
|---|---|
| Buyer Segmentation Overview | Küme dağılımı ve büyüklüğü |
| Investor Behaviour Dashboard | Segment bazında fiyat ve kredi örüntüleri |
| Geographic Buyer Analysis | Bölgesel dağılım ve cluster haritası |
| Segment Insights Panel | Özellik ortalamaları ve normalize heatmap |
Country, region, acquisition purpose ve client type filtrelerinin bütün grafiklere dinamik olarak uygulanabildiği belirtilmektedir.
Literatür bölümündeki iki önemli doğrulama sorunu
Rapor, Limsombunchai ve arkadaşlarının buyer-segment bazlı hedonic modelleri sınadığını aktarmaktadır. Bağımsız bibliyografik kayıt ise çalışmanın 200 Christchurch evi üzerinde hedonic price model ile artificial neural network karşılaştırması olduğunu göstermektedir. Dolayısıyla kaynak rapordaki segmentasyon tanımı bu makaleyle uyumlu görünmemektedir.
Antipov ve Pokryshevskaya (2012) için de benzer sorun vardır. Rapor bunu K-Means'ten türeyen buyer segmentlerine ensemble classification uygulaması gibi anlatırken özgün çalışma Random Forest ile konut mass appraisal ve CART tabanlı model diagnostiklerine odaklanmaktadır.
Bu durum ana K-Means analizindeki sayıları kendiliğinden geçersiz kılmaz; fakat literatür bölümündeki bazı gerekçelendirmelerin kaynaklarıyla yeniden eşleştirilmesi gerektiğini gösterir.
Çalışmanın güçlü tarafları
Veri temizleme adımları açık biçimde belgelenmiştir. Kategorik değişkenlerle kümeleme değişkenleri birbirinden ayrılmıştır. Standardizasyon gerekçesi doğru problemle bağlantılıdır. Küme büyüklükleri, PCA, ANOVA ve segment profilleri birlikte sunulmuştur. Dashboard, teknik çıktıyı iş kullanıcılarına taşıma amacını açık hale getirmektedir.
Çalışmanın sınırlılıkları
Birinci sınırlılık, k=3 kararının iş gereksiniminden etkilenmesidir. İkinci sınırlılık, düşük Silhouette değerlerinin segment sınırlarının güçlü olmadığını düşündürmesidir.
Üçüncü sınırlılık, aynı değişkenlerle kurulan kümelerin yine aynı değişkenler üzerinden ANOVA ile “doğrulanmasıdır”. Dördüncü sınırlılık, segment etiketlerinin — özellikle “Premium” ve “Mid-Market” — doğrudan sayısal fiyat sırasıyla örtüşmemesidir.
Beşinci sınırlılık, yalnız mevcut işlem davranışının kullanılmasıdır. Zaman boyutu, müşteri yaşam boyu değeri, piyasa faizi, konut endeksi ve makroekonomik rejimler modele dahil değildir.
Altıncı sınırlılık, veri tabanının coğrafi olarak güçlü biçimde ABD ve özellikle California ağırlıklı olmasıdır. Bu nedenle segmentlerin başka ülke veya pazarlara doğrudan taşınabilirliği gösterilmiş değildir.
Genel sonuç
Bu çalışma, gayrimenkul müşteri tabanını tek bir kitle olarak görmek yerine işlem davranışından hareketle üç ticari profil oluşturmayı amaçlayan uygulanabilir bir veri bilimi iş akışı sunmaktadır.
Üçlü yapı iş açısından anlaşılırdır: küçük fakat yüksek sıklıklı sadık müşteriler, daha yüksek fiyatlı işlemlere yönelen orta büyüklükte grup ve büyük hacimli ana akım müşteri tabanı.
Bununla birlikte k=3'ün mutlak istatistiksel optimum olduğu sonucu kaynak veriler tarafından güçlü biçimde desteklenmemektedir. Dahili metrikler k=2'yi daha yüksek puanlamış, k=3 kısmen iş gereksinimi nedeniyle seçilmiştir.
Bu nedenle raporun en güçlü kullanımı, “pazardaki doğal üç müşteri sınıfını kesin olarak keşfettik” iddiasından çok, müşteri hedefleme ve dashboard geliştirme için yorumlanabilir bir operasyonel segmentasyon prototipi olarak görülmesidir.
Kaynak ve Yöntem Notu
Özgün çalışma:Machine Learning Based Buyer Segmentation and Investment Profiling for Real Estate Market Intelligence.
Yazar: Gokul Mallabathula.
Kaynak dosyadaki rol: Data Science Intern, Unified Mentor | Parcl Real Estate Intelligence Project.
Kaynak türü: Uygulamalı veri bilimi / gayrimenkul müşteri segmentasyonu proje raporu.
Dosya üzerindeki tarih: Haziran 2025.
SSRN metadata'sı: Date Written 31 Mayıs 2026; Posted 25 Haziran 2026; SSRN abstract 6881578.
DOI: 10.2139/ssrn.6881578.
Tarih uyuşmazlığı: PDF kapağındaki Haziran 2025 ile SSRN metadata'sındaki 2026 tarihleri uyuşmamaktadır. Verianla bu farkı düzeltmeden görünür tutmaktadır.
Hakemlik: Çalışmanın hakemli dergi version-of-record olduğuna dair kanıt bulunmamaktadır; proje/SSRN çalışma metni olarak değerlendirilmiştir.
Lisans: SSRN kaydı hakların saklı olduğunu ve izin olmadan yeniden kullanıma izin verilmediğini belirtmektedir. Bu nedenle kaynak grafiklerinin tasarımı doğrudan kopyalanmamalıdır.
Veri: 2.000 müşteri, 10.000 gayrimenkul ilanı; bunların 7.305'i satılmış, 2.695'i Available durumundadır.
Kümeleme tablosu: 2.000 müşteri üzerinde yedi sayısal özellik.
Özellikler: avg_sale_price, median_sale_price, avg_price_per_sqft, purchases_count, total_listings, satisfaction_score ve age.
Ölçekleme: StandardScaler.
Ana algoritma: K-Means.
k adayları: 2–8.
İç doğrulama metrikleri: Silhouette Score ve Calinski–Harabasz Index.
k seçimi sınırı: Her iki metrik k=2'de zirve yapmıştır. k=3; CH eğrisindeki ilk kırılma, yorumlanabilirlik ve en az üç iş segmenti gereksinimi birlikte değerlendirilerek seçilmiştir.
PCA: Yedi boyutlu standartlaştırılmış özelliklerin iki boyutlu görselleştirilmesi için kümelemeden sonra uygulanmıştır.
İstatistiksel analiz: One-way ANOVA ve Tukey HSD. Aynı özelliklerin hem kümeleme hem sonradan anlamlılık testinde kullanılması nedeniyle bu testler bağımsız dış küme doğrulaması değildir.
Segmentler: Cluster 0 — Premium Buyers, n=51; Cluster 1 — Mid-Market Buyers, n=813; Cluster 2 — Mainstream Buyers, n=1.136.
Etiket sınırı: Cluster 0'ın “Premium” adı en yüksek satın alma fiyatına dayanmamaktadır; en yüksek avg_sale_price ve median_sale_price Cluster 1'de bulunmaktadır.
Dashboard: Streamlit tabanlı dört sekmeli dashboard raporlanmaktadır. PDF içinde bağımsız olarak çalıştırılabilir kod deposu veya deployment bağlantısı doğrulanmamıştır.
Literatür kontrolü: Limsombunchai et al. (2004) ve Antipov & Pokryshevskaya (2012) kaynaklarının rapordaki açıklaması, doğrulanabilen özgün çalışma konularıyla tam uyuşmamaktadır. Bu nedenle söz konusu atıflar Verianla metninde segmentasyon yönteminin doğrudan kanıtı olarak kullanılmamıştır.
Gelecek çalışma: Kaynak hiyerarşik kümelemeyle k=3 çözümünün sınanmasını, zamansal işlem verisiyle lifetime-value modelleri kurulmasını, coğrafi kapsamın genişletilmesini ve faiz oranları/bölgesel konut endeksleri gibi makroekonomik göstergelerin eklenmesini önermektedir.
Verianla hazırlama yöntemi: Kaynağın veri büyüklükleri, model adımları, segment sonuçları ve iş önerileri korunmuş; fakat k=3 seçiminin gücü, post-clustering ANOVA'nın doğrulama niteliği, segment isimlerinin anlamı ve literatür atıfları kaynak dışı kesinlik üretmeden metodolojik olarak ayrıştırılmıştır. Kaynakta bulunmayan satış artışı, yatırım getirisi veya tahmin performansı üretilmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir