

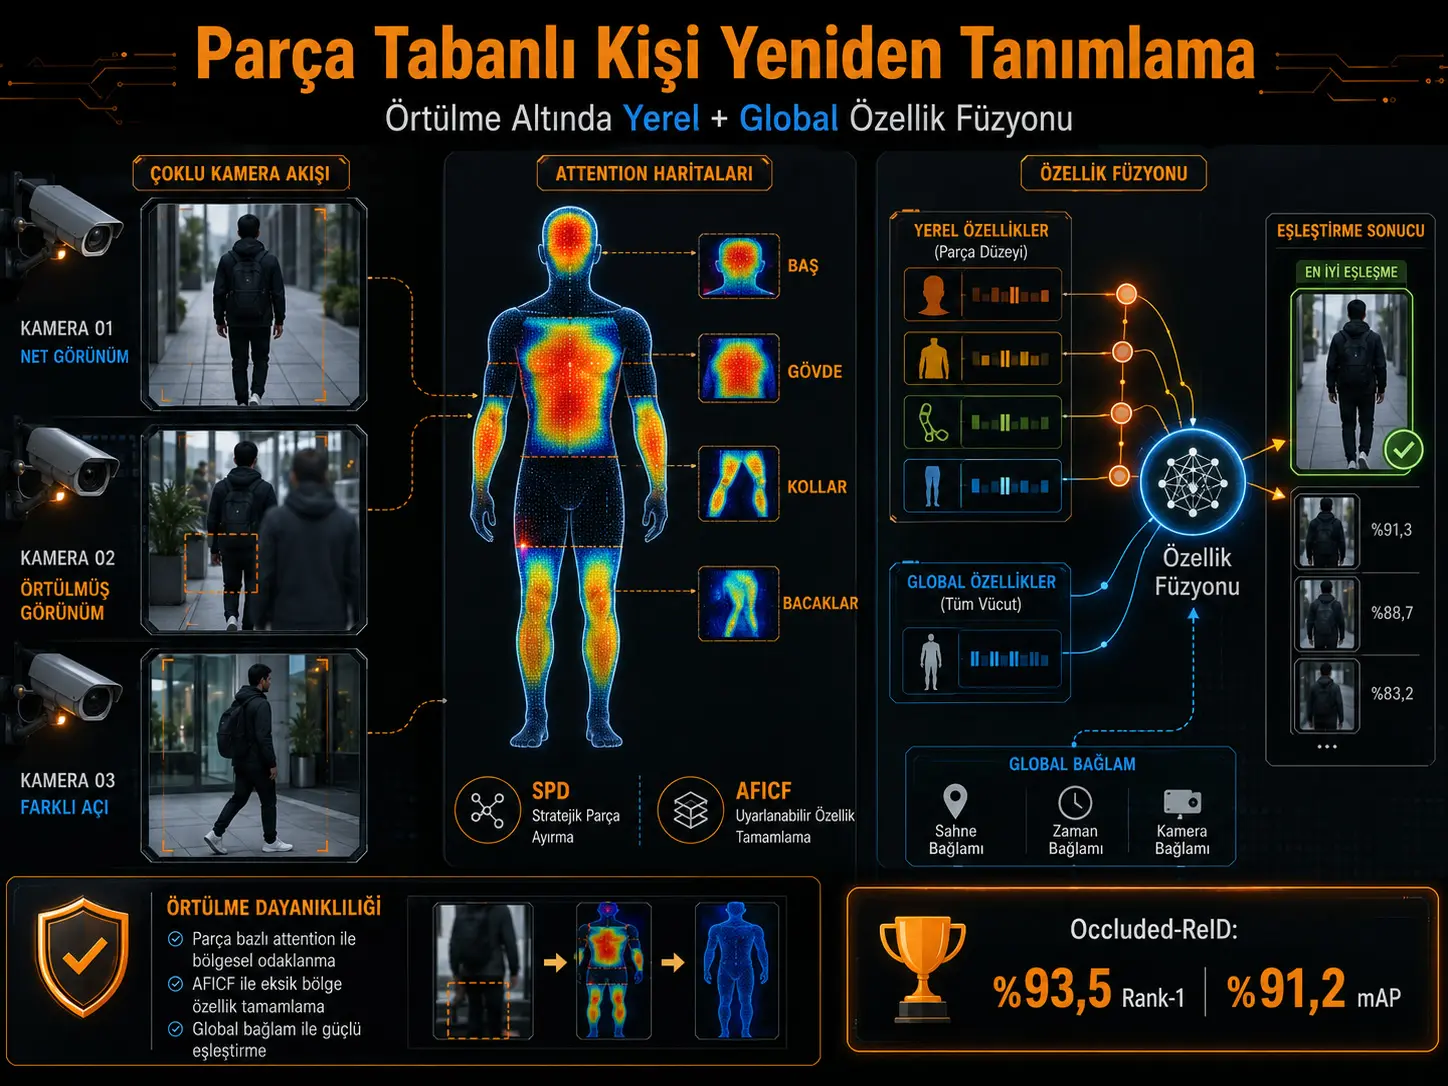
Utafiti huu unalenga tatizo la Person Re-Identification (Person Re-ID; utambuzi upya wa mtu), ambalo linalenga kumpata tena mtu yuleyule aliyeonekana kwenye kamera tofauti au nyakati tofauti, hasa katika picha ambazo sehemu ya mwili imefunikwa na watu wengine au vitu. Badala ya kutegemea vector moja tu ya global feature inayowakilisha picha nzima ya mtu, watafiti wanapendekeza usanifu wa Dynamic Part-Based Fusion (DPBF) unaotumia pamoja taarifa za local kutoka maeneo ya semantic ya mwili kama kichwa, kiwiliwili, mikono na miguu pamoja na taarifa ya global appearance. Mfumo una sehemu kuu mbili: Salient Part Discrimination (SPD) hutumia human parsing na attention maps kusisitiza maeneo ya mwili yenye manufaa zaidi katika kutofautisha utambulisho; Adaptive Feature Integration and Contextual Fusion (AFICF) huchambua correlation kati ya local na global features ili kupunguza taarifa inayojirudia na kuunganisha features zinazokamilishana.
Modeli ilitathminiwa kwenye dataset sita za kawaida za Person Re-ID: Market-1501, DukeMTMC-ReID, CUHK03-Labeled, Occluded-Duke, Occluded-ReID na P-DukeMTMC-ReID. Matokeo yanayoonekana zaidi yalipatikana kwenye Occluded-ReID: DPBF ilifikia %93,5 Rank-1 na %91,2 mAP. Kwa kuwa comparison yenye nguvu iliyo karibu zaidi katika jedwali la chanzo ni BPB Re-ID yenye %82,9 na %75,2 mtawalia, tofauti za kihesabu ni pointi 10,6 za Rank-1 na pointi 16,0 za mAP. Kwenye P-DukeMTMC-ReID, DPBF ilitoa %93,6 Rank-1 na %83,6 mAP, ilhali kwenye Occluded-Duke ilibaki kidogo chini ya BPB Re-ID kwa %74,7 Rank-1 na %60,7 mAP. Kwa hiyo haiwezi kusemwa kuwa modeli ndiyo njia bora bila ubishi kwenye dataset zote; nguvu yake ni uwezo wa kutumia pamoja local na global features hasa katika baadhi ya mazingira ya severe occlusion.
Utafiti pia unaonyesha kwa kiasi limitation muhimu. Chini ya severe occlusion, baadhi ya body-part embeddings binafsi zinaweza kuwa karibu hazitumiki. Kwenye benchmark tatu zinazolenga occlusion, Rank-1 ya embedding dhaifu zaidi iitwayo p7 hushuka hadi takribani %2–3. Kinyume chake, representation ya p0 inayobeba taarifa kutoka mwonekano wa jumla na maeneo yanayoonekana hubaki katika range ya %69,5–92,6 Rank-1. Hivyo mafanikio ya DPBF hayatokani na kutambua kila sehemu ya mwili kwa kutegemewa, bali na kuunganisha taarifa kutoka maeneo yanayoonekana na yanayokamilishana pamoja na global context ili kupunguza utegemezi kwa sehemu moja dhaifu.
Person Re-ID inatatua tatizo gani hasa?
Kazi ya mfumo wa Person Re-ID ni kumpata tena mtu aliyeonekana kwenye kamera moja ndani ya picha ya kamera nyingine au gallery set. Kutoka kwenye query image, modeli hujaribu kujibu:
“Ni picha gani katika gallery inayohusiana na utambulisho sawa na mtu huyu?”
Tatizo hili ni tofauti na image classification ya kawaida. Modeli haijibu tu swali “kuna mtu?”; inajaribu kutofautisha utambulisho uleule miongoni mwa watu wengi wenye mwonekano unaofanana.
Kazi hii huwa ngumu zaidi hasa katika hali zifuatazo:
- mabadiliko ya angle ya kamera,
- mabadiliko ya mwanga,
- mtu kuwa katika pose tofauti,
- kupungua kwa resolution ya picha,
- uwepo wa watu wenye nguo zinazofanana,
- sehemu ya mwili kufunikwa na mtu au kitu kingine.
Jambo la mwisho, yaani occlusion/kufunikwa, ndilo motivation kuu ya utafiti huu.
Kwa nini kutumia global feature pekee kunaweza kutotosha?
CNN inaweza kubana picha nzima ya mtu kuwa vector moja ya feature. Representation hii hubeba taarifa kama rangi ya mavazi kwa ujumla, mwonekano wa mwili na silhouette. Lakini sehemu muhimu ya mtu ikifunikwa, global feature vector pia inaweza kuathiriwa na maeneo yasiyoonekana au yanayopotosha.
Kwa mfano, ikiwa lower body imefunikwa kabisa na kitu kingine, global representation inaweza kushindwa kutumia kwa nguvu ya kutosha maeneo yanayoonekana kama upper body, begi au texture ya mavazi ambayo ndiyo yanaweza kusaidia kutofautisha utambulisho.
Lengo la part-based Re-ID methods ni kugawanya mwili wa binadamu katika semantic regions ndogo ili kushughulikia tatizo hili.
Wazo kuu la DPBF ni nini?
Mfumo uliopendekezwa unaweza kufikiriwa kama:
\[ \text{DPBF} = \text{SPD} + \text{AFICF} + \text{Hybrid Loss} \]
SPD hujaribu kubaini ni maeneo gani ya mwili yanayobeba taarifa inayotofautisha utambulisho.
AFICF huunganisha features kutoka sehemu tofauti za mwili na global feature inayopatikana kutoka picha nzima ya mtu.
Hybrid Loss Function inalenga classification ya utambulisho na pia kuleta karibu embeddings za mtu yuleyule huku ikitenganisha embeddings za watu tofauti.
Kuna distinction muhimu ya kisayansi: watafiti hawadai kwamba walivumbua attention, human parsing, PCC, PCA au triplet loss. Contribution ya makala ni namna structures hizi zinavyotumiwa pamoja kwa coordinated DPBF pipeline kwa occluded Person Re-ID.
Salient Part Discrimination inafanya nini?
Kazi ya SPD si kugawanya tu picha ya mtu katika stripes sawa kijiometri, bali kutengeneza attention maps zinazolingana na maeneo ya maana ya mwili.
Input feature map ya modeli inaonyeshwa kama:
\[ F \]
Feature map hii kwanza hupitishwa kwenye:
\[ 1\times1 \]
convolution layer ili kupata:
\[ F' \]
Kisha CNN nyepesi, global average pooling na fully connected layer hutumika kuzalisha:
\[ K \]
attention weights.
Hizi hubadilishwa kuwa spatial attention maps za sehemu za mwili:
\[ A_1,A_2,\ldots,A_K \]
Grad-CAM inatumikaje hapa?
Utafiti hutumia strategy inayotegemea Grad-CAM kutengeneza attention map kwa kila sehemu ya mwili iliyofafanuliwa mapema.
Lengo ni kutenganisha activations zenye maana kwa utambulisho katika feature map kwa maeneo kama:
- kichwa,
- kiwiliwili,
- mkono wa kushoto/kulia,
- mguu wa kushoto/kulia
Kwenye Figure 1 ya ukurasa wa 6, picha ya mtu yuleyule imegawanywa katika semantic parts tofauti na attention heatmaps zilizotengenezwa kwa kila sehemu zinaonyeshwa. Baadhi ya maps zinaonyesha upper body au maeneo ya miguu yakiwa na activation kubwa.
Kwa nini SCHP inaongezwa kwenye mfumo?
Kugawanya mwili wa binadamu kwa fixed geometric slices pekee kunaweza kuleta tatizo wakati pose inabadilika. Mtu anapotembea au kuinama, eneo lilelile la coordinate haliwezi kuwakilisha anatomical structure ileile katika kila picha.
Kwa hiyo utafiti hutumia human parsing labels zinazotolewa na modeli ya Self-Correction for Human Parsing (SCHP).
Parsing label ya kwanza inaandikwa:
\[ Y_0=P(X) \]
Kisha correction network huoptimishwa kwa:
\[ C = \arg\min_C L \left( C(Y_0),Y_{GT} \right) \]
na corrected label hupatikana kama:
\[ Y_1=C(Y_0) \]
SPD huunganisha parsing information hii na attention mechanism ili kujaribu kutengeneza part representations zenye consistency bora ya anatomy.
Je, human parsing haina makosa?
Hapana. Utafiti wa chanzo unatambua hili wazi kama limitation.
Katika severe occlusion au pose isiyo ya kawaida:
- mguu unaweza kutoweka,
- mkono unaweza kupewa eneo lisilo sahihi,
- parsing mask inaweza kuwa incomplete,
- sehemu ndogo tu ya anatomical part inaweza kuonekana.
Kwa hiyo modeli haitumii attention mechanism kama mbadala wa parsing labels, bali kama structure inayozikamilisha.
Cross-Part Spatial Feature Modulation Map ni nini?
Baada ya attention maps kutengenezwa, kuzionyesha tu hakutoshi. Kila attention map hutumika kwenye original feature map.
Kwa kila sehemu ya mwili:
\[ P_k=A_k\times F \]
element-wise multiplication hutumika.
Kwa hiyo hupatikana part-specific feature maps:
\[ P_1,P_2,\ldots,P_K \]
Kisha zinaunganishwa kwa:
\[ P_{\mathrm{concat}} = \operatorname{Concat} (P_1,P_2,\ldots,P_K) \]
Figure 2 na Figure 3 katika ukurasa wa 8 zinaonyesha mchakato huu wazi: feature map huzidishwa na attention maps nyingi na local feature representations zinazopatikana huhamishwa kwenye common part-based representation.
Kwa nini local features na global features zinaunganishwa tena?
Kutegemea sehemu za mwili pekee pia kunaweza kuleta matatizo.
Kwa mfano:
- mguu ukiwa umefunikwa kabisa, leg embedding inaweza kukosa maana,
- mkono ukionekana mdogo sana, feature inaweza kuwa noisy,
- parsing isiyo sahihi inaweza kuhamisha sehemu kwenda eneo lingine.
Global feature huhifadhi context ya picha nzima.
Kwa hiyo DPBF hutumia:
local body-part features + global contextual feature
kwa pamoja.
Kwa nini AFICF haitumii concatenation rahisi?
Kuongeza local na global feature vectors moja kwa moja pembeni huongeza dimension. Tatizo muhimu zaidi ni kwamba highly correlated features zinazobeba taarifa ileile zinaweza kuingia kwenye mfumo mara nyingi.
Kwa hiyo AFICF kwanza huhesabu Pearson correlation kati ya features.
\[ r_{XY} = \frac{ \sum_{i=1}^{n} (X_i-\bar X)(Y_i-\bar Y) }{ \sqrt{ \sum_{i=1}^{n}(X_i-\bar X)^2 } \sqrt{ \sum_{i=1}^{n}(Y_i-\bar Y)^2 } } \]
\[ |r_{XY}|\approx1 \]
ikiwa, features mbili huchukuliwa kuwa na strong linear relationship na huenda zikabeba redundant information.
AFICF inalenga kupunguza redundant components kutoka kwa groups za features zenye correlation kubwa.
Kwa nini PCA inatumika?
Baada ya Pearson correlation, dimensional redundancy bado inaweza kubaki katika feature space. Kwa hiyo Principal Component Analysis hutumika.
Covariance kati ya features huhesabiwa kwa:
\[ \operatorname{Cov}(X_j,X_k) = \frac{1}{n-1} \sum_{i=1}^{n} (X_{ij}-\bar X_j) (X_{ik}-\bar X_k) \]
Principal components zinazolingana na eigenvalues kubwa zaidi huhifadhiwa na final representation hupunguzwa hadi compact embedding yenye:
\[ 512 \]
dimensions.
Training loss ya DPBF inafanyaje kazi?
Modeli huoptimisha targets mbili tofauti kwa pamoja.
Component ya kwanza ni cross-entropy loss:
\[ L_{\mathrm{CE}} = -\sum_{i=1}^{N} Y_i\log\hat Y_i. \]
Term hii hufundisha modeli global identity discrimination.
Component ya pili ni triplet loss:
\[ L_{\mathrm{triplet}} = \max \left( 0, D_{\mathrm{pos}} - D_{\mathrm{neg}} + m \right). \]
Hapa:
- \(D_{\mathrm{pos}}\): distance kati ya embeddings mbili za mtu yuleyule,
- \(D_{\mathrm{neg}}\): distance kati ya embeddings za watu tofauti,
- \(m\): margin.
Katika utafiti margin imechaguliwa kuwa:
\[ m=0{,}3 \]
Final Hybrid Loss ni:
\[ L_{\mathrm{Hybrid}} = \alpha L_{\mathrm{CE}} + \beta L_{\mathrm{TL}} \]
Components mbili kuu za loss zimepewa equal weight.
Modeli ilifundishwaje?
Backbone mbili zilitumika:
- ResNet-50,
- HRNet-w32.
Kwa ResNet-50 input image ilikuwa:
\[ 256\times128 \]
pixels; kwa HRNet-w32:
\[ 384\times128 \]
pixels.
Modeli ilifundishwa kwa Adam optimizer; initial learning rate:
\[ 3{,}5\times10^{-4} \]
Warm-up initial learning rate:
\[ 3{,}5\times10^{-5} \]
na weight decay:
\[ 0{,}0005 \]
zilitumika.
Learning rate ilipunguzwa kwenye epoch ya 40 na 70; total training ilikuwa:
\[ 150\ \text{epoch} \]
Samples nne kwa kila identity zilitumika ndani ya batch na effective batch size ilibadilika kati ya 16–64 kulingana na dataset na hali ya GPU.
Dataset zipi zilitumika?
Utafiti unatenganisha makundi mawili ya benchmark.
Dataset za full / standard Person Re-ID:
- Market-1501,
- DukeMTMC-ReID,
- CUHK03-Labeled.
Dataset zinazolenga occlusion:
- Occluded-Duke,
- Occluded-ReID,
- P-DukeMTMC-ReID.
Rank-1 Accuracy ina maana gani?
Kwa query image, mfumo hupanga watu katika gallery kulingana na similarity.
Utambulisho sahihi ukiwa nafasi ya kwanza kwenye list, hiyo ni Rank-1 success.
Kwa mfano:
\[ R1=93{,}5\% \]
inamaanisha kwamba chini ya benchmark protocol iliyotumika, takribani %93,5 ya queries zilikuwa na utambulisho sahihi kwenye nafasi ya kwanza.
mAP inapima nini?
Mean Average Precision haiangalii nafasi ya kwanza pekee, bali pia distribution ya all correct matches za identity hiyo kwenye ranking list.
Kwa hiyo:
- Rank-1 ni nyeti zaidi kwa first result,
- mAP ni nyeti zaidi kwa quality ya entire retrieval list
.
Matokeo yakoje kwenye full benchmarks?
| Dataset | DPBF Rank-1 (%) | DPBF mAP (%) | Nafasi katika jedwali la chanzo |
|---|---|---|---|
| Market-1501 | 96,0 | 89,3 | Highest kwa Rank-1; chini ya AaP-ReID kwa mAP |
| DukeMTMC-ReID | 92,0 | 82,8 | Highest kwa Rank-1; chini ya AaP-ReID kwa mAP |
| CUHK03-Labeled | 89,5 | 82,6 | Highest katika metrics zote mbili |
Jedwali hili linaonyesha distinction muhimu. DPBF haikutoa value ya juu zaidi katika kila benchmark na kila metric. Kwenye Market-1501, AaP-ReID ina mAP %93,9 huku DPBF ikiwa %89,3; kwenye DukeMTMC-ReID, AaP-ReID ina %88,6 mAP huku DPBF ikiwa %82,8.
Kwa hiyo strong performance ya modeli haipaswi kujumlishwa kama “bora kuliko methods zote kila mahali”.
Matokeo ya CUHK03-Labeled
DPBF inatoa:
\[ R1=89{,}5\%,\qquad mAP=82{,}6\% \]
Kwa R-1, value ya pili ya juu zaidi kwenye jedwali ni %84,7, hivyo tofauti ni:
\[ 89{,}5-84{,}7 = 4{,}8 \]
pointi.
Kwa mAP, AaP-ReID yenye %82,4 ndiyo value iliyo karibu zaidi na DPBF. Kwa hiyo arithmetic difference ni:
\[ 82{,}6-82{,}4 = 0{,}2 \]
pointi.
Tofauti ya 1,6 mAP points iliyotajwa kwenye source text haipatikani dhidi ya value iliyo karibu zaidi, bali dhidi ya mAP ya %81,0 ya SCSN.
Matokeo kwenye occlusion-focused datasets
| Dataset | DPBF Rank-1 (%) | DPBF mAP (%) | Comparison yenye nguvu iliyo karibu zaidi kwenye chanzo |
|---|---|---|---|
| Occluded-Duke | 74,7 | 60,7 | BPB Re-ID: 75,1 / 62,5 |
| Occluded-ReID | 93,5 | 91,2 | BPB Re-ID: 82,9 / 75,2 |
| P-DukeMTMC-ReID | 93,6 | 83,6 | BPB Re-ID: 93,0 / 83,2 |
Faida iliyo wazi zaidi ya modeli inaonekana kwenye Occluded-ReID.
Rank-1 difference:
\[ 93{,}5-82{,}9 = 10{,}6 \]
pointi;
mAP difference:
\[ 91{,}2-75{,}2 = 16{,}0 \]
pointi.
Chanzo kinaeleza tofauti hizi kama percentage improvement; hata hivyo kutoa values moja kwa moja kutoka kwenye jedwali kunaonyesha kwamba hizi ni percentage-point differences.
Kwa nini Occluded-Duke ni counterexample muhimu?
Kwenye Occluded-Duke, DPBF inatoa:
\[ 74{,}7/60{,}7 \]
huku BPB Re-ID ikitoa:
\[ 75{,}1/62{,}5 \]
Kwa hiyo haiwezi kusemwa kuwa usanifu uliopendekezwa unatoa matokeo bora kwenye kila dataset yenye occlusion.
Performance inabadilikaje idadi ya parts inapoongezeka?
Katika ablation study ya Market-1501, viwango vitatu tofauti vya body-part granularity vilijaribiwa:
- parts 3,
- parts 5,
- parts 8.
Katika supervision strategies zote tatu, kuongeza idadi ya parts kutoka 3 hadi 8 kulihusishwa na performance ya juu zaidi.
Katika configuration ya parts nane, Parsing + PAM setup inayotajwa katika chanzo kama “semi-supervised” ilifikia:
\[ R1=96{,}0\%,\qquad mAP=89{,}3\% \]
Katika parts nane hizo hizo, supervised parsing pekee ilitoa:
\[ 92{,}6/85{,}3 \]
na PAM-based unsupervised setup pekee:
\[ 86{,}7/77{,}8 \]
Jaribio hili linaunga mkono kwamba kutumia parsing information pamoja na attention mechanism, katika benchmark na configuration hii, ni strong kuliko PAM pekee au parsing pekee.
Comparison ya idadi ya parts kati ya DPBF na PCB
Kwenye DukeMTMC-ReID, chanzo kinaripoti matokeo yafuatayo:
| Idadi ya parts | DPBF R-1 (%) | DPBF mAP (%) | PCB R-1 (%) | PCB mAP (%) |
|---|---|---|---|---|
| 3 | 87,4 | 80,2 | 76,4 | 58,3 |
| 5 | 90,5 | 82,7 | 82,4 | 67,5 |
| 6 | 91,0 | 83,8 | 82,6 | 68,8 |
Chanzo kinahusisha matokeo haya na contribution ya pamoja ya parsing-guided attention na correlation-aware integration components za DPBF. Hata hivyo jedwali halipimi causal contribution ya SPD na AFICF moja moja katika isolation kamili.
Nini kinaonekana katika feature integration experiment?
Katika feature integration analysis kwenye Occluded-ReID, global pooled feature, body-part features, Pearson correlation refinement na PCA components ziliondolewa katika combinations tofauti.
Katika full HLF configuration, chanzo kinaripoti:
\[ mAP=73{,}7,\qquad R1=86{,}5 \]
Components zaidi za feature integration zinapoondolewa, performance hushuka hadi mAP levels za:
\[ 68{,}7 \rightarrow 62{,}9 \rightarrow 57{,}5 \rightarrow 55{,}2 \]
Jaribio hili linaunga mkono matumizi ya pamoja ya local + global features na correlation/PCA refinement.
Hata hivyo kuna tofauti kubwa kati ya final HLF result katika jedwali hili na value ya main Occluded-ReID comparison table ya makala:
\[ 93{,}5\ R1,\qquad91{,}2\ mAP \]
Kwa kuwa chanzo hakijaunganisha wazi evaluation configurations hizi mbili kwa explanation ya backbone/protocol, values hizi hazipaswi kuunganishwa kana kwamba ni matokeo ya experiment ileile.
Severe occlusion inaathiri zaidi maeneo gani ya mwili?
Attention heatmaps na part-based tests za utafiti zinaonyesha kwamba lower-body regions ni fragile zaidi.
Katika chanzo p0 imeripotiwa kama embedding yenye nguvu zaidi na p7 kama embedding dhaifu zaidi.
| Dataset | Embedding yenye nguvu zaidi | Embedding dhaifu zaidi | Rank-1 difference | mAP difference |
|---|---|---|---|---|
| Occluded-ReID | p0: 91,5 / 84,8 | p7: 2,5 / 6,9 | 89,0 | 77,9 |
| Occluded-Duke | p0: 69,5 / 56,8 | p7: 2,9 / 1,4 | 66,6 | 55,4 |
| P-DukeMTMC-ReID | p0: 92,6 / 81,8 | p7: 2,4 / 1,5 | 90,2 | 80,3 |
Matokeo haya yanaonyesha wazi limitation muhimu ya DPBF: bado ni vigumu sana kutoa reliable identity information kutoka sehemu ya mwili isiyoonekana au iliyofunikwa karibu kabisa.
Faida ya modeli si “kuboresha” sehemu hiyo dhaifu, bali kujaribu kudumisha overall identity representation kwa msaada wa maeneo mengine yanayoonekana na global context.
Source-internal inconsistency katika Figure 5
Katika caption ya Figure 5 ya makala:
- panel (b) imeelezwa kuwa Occluded-ReID,
- panel (c) imeelezwa kuwa P-DukeMTMC-ReID
Lakini katika graph titles za figure iliyochapishwa, graph ya juu imeandikwa:
p_dukemtmc_reid
na graph ya chini:
Market-1501
Kwa hiyo majina ya graph panels na figure caption hayalingani kikamilifu. Badala ya kudhani chanzo kilikusudia nini na kufanya silent correction, uncertainty hii inapaswa kuhifadhiwa.
Computational cost ikoje?
Chanzo kinatoa batch processing na memory values za methods tatu kama ifuatavyo:
| Model | Processing Time (s/batch) | Memory Usage (MB) |
|---|---|---|
| PCB + RPP | 129,8272 | 20.250 |
| BPB Re-ID | 122,7825 | 19.018 |
| DPBF | 126,2159 | 21.250 |
DPBF si method yenye memory ndogo zaidi wala yenye speed kubwa zaidi. BPB Re-ID ina processing time na memory usage ya chini. Lengo la DPBF si absolute computational minimum, bali competitive balance kati ya occlusion robustness na computational cost.
Modeli inatumia parameters ngapi?
Kwa configurations zinazotegemea dataset, chanzo kinaripoti takribani:
\[ 39{,}5-41{,}3\ \text{milyon} \]
parameters.
FLOP value ni takribani:
\[ 8{,}0\times10^9 \]
.
Je, matokeo yana consistency katika repeats za RTX 4090 na TITAN Xp?
Kwenye Market-1501, run ya TITAN Xp ilitoa:
\[ 96{,}08\ R1,\quad89{,}32\ mAP \]
na run ya RTX 4090:
\[ 95{,}67\ R1,\quad89{,}49\ mAP \]
Kwenye DukeMTMC-ReID:
\[ 91{,}88/82{,}87 \]
na:
\[ 92{,}06/82{,}87 \]
ziliripotiwa.
Kwenye P-DukeMTMC-ReID tofauti ni kubwa kidogo:
\[ 92{,}09/82{,}13 \]
dhidi ya:
\[ 93{,}62/83{,}67. \]
Waandishi wanawasilisha comparison hii kama evidence kwamba performance kwa ujumla imebaki stable katika hardware conditions tofauti.
Hata hivyo “reproducibility” hapa haimaanishi replication na independent research group nyingine; ni additional training/evaluation runs ndani ya utafiti huohuo kwa hardware tofauti.
RTX 4090 inapunguza evaluation time kwa kiasi gani?
Market-1501 evaluation batch time:
\[ 0{,}444\ \text{s} \rightarrow 0{,}126\ \text{s} \]
DukeMTMC-ReID:
\[ 0{,}454 \rightarrow 0{,}130\ \text{s} \]
na P-DukeMTMC-ReID:
\[ 0{,}410 \rightarrow 0{,}128\ \text{s} \]
ziliripotiwa.
Tofauti hii haitokani na change katika model algorithm, bali na computational capacity ya GPU architectures zilizotumika.
Utafiti una maana gani kwa Türkiye?
Utafiti hauna camera data iliyokusanywa Türkiye wala Person Re-ID benchmark maalum kwa Türkiye. Kwa hiyo matokeo kama:
\[ 93{,}5\%, \quad 91{,}2\% \]
hayawezi kutumiwa kama expected success rate kwenye airport, factory, campus au security cameras nchini Türkiye.
Kwa mfumo utakaotumika Türkiye, local evaluation tofauti inahitajika kwa kuzingatia camera resolution, camera height, crowd density, clothing similarity, image compression, night/day conditions na occlusion structure.
Matokeo yanayoungwa mkono na utafiti
- DPBF inayotumia SPD na AFICF kwa coordination imetoa competitive results kwenye Person Re-ID benchmarks sita.
- Kwenye Occluded-ReID, matokeo ya juu kwa pointi 10,6 za Rank-1 na pointi 16,0 za mAP yameripotiwa dhidi ya comparison iliyo karibu zaidi katika jedwali la chanzo.
- Kwenye P-DukeMTMC-ReID, DPBF imetoa highest Rank-1 na mAP values katika source table.
- Kwenye Market-1501 na DukeMTMC-ReID, DPBF ina highest Rank-1 katika jedwali lakini si best method kwa mAP.
- Kwenye Occluded-Duke, DPBF iko chini ya BPB Re-ID result katika source table.
- Katika Market-1501 ablation, 8-part Parsing + PAM configuration imeonyesha performance ya juu kuliko alternatives za 3 na 5 parts.
- Severe occlusion imesababisha performance loss kubwa sana kwenye lower-body embeddings.
- Additional trainings katika GPU environments tofauti zimezalisha R-1 na mAP results zinazofanana kwa ujumla.
Mambo ambayo utafiti haujathibitisha
- Haijathibitishwa kwamba DPBF ni bora kuliko methods zote zilizopo kwenye Person Re-ID datasets zote.
- Benchmark results hazijathibitishwa kama field performance katika real city-scale camera network.
- Part-based attention haiondoi kabisa athari ya severe occlusion.
- Haijaonyeshwa kwamba kila body part inabeba reliable identity information; p7 results zinaonyesha kinyume.
- Baselines hazijaendeshwa upya kikamilifu kwa same code, backbone, input resolution na training pipeline.
- Hakuna confidence interval au formal significance test kwa performance differences katika source tables.
- Haijaonyeshwa kwamba DPBF ni computationally lightest au fastest Re-ID model.
- Hardware repeats si independent third-party replication.
Mbinu na Matokeo ya Utafiti
DPBF processing pipeline
Kulingana na Algorithm 1 ya makala, training inafanyika kwa mpangilio huu:
- CNN backbone feature maps hutolewa kutoka input image.
- Parsing-guided body-part representations hutengenezwa kwa SPD.
- Local body-part embeddings na global contextual embedding hupatikana.
- AFICF hupanga relationship ya local na global features.
- Pearson correlation analysis hupunguza redundant feature components.
- PCA hutengeneza compact discriminative embedding.
- Local na global representations huunganishwa.
- Modeli huoptimishwa kwa Hybrid Loss.
Katika inference:
- normalized embeddings hutolewa kutoka query na gallery images,
- Euclidean distance huhesabiwa kati ya embedding pairs,
- gallery images hupangwa kutoka distance ndogo hadi kubwa,
- identity match hurudishwa kama retrieval list.
Muhtasari mfupi wa kihisabati wa architectural flow
Picha:
\[ X \]
ikiingia kwenye backbone:
\[ X \rightarrow F \]
feature map hutokea.
SPD:
\[ F \rightarrow \{A_1,\ldots,A_K\} \]
hutengeneza attention maps.
Kisha:
\[ P_k=A_k\odot F \]
hutengeneza kila body-part representation.
Hizi huunganishwa kama:
\[ P_{\mathrm{concat}} = [P_1;\ldots;P_K] \]
AFICF hutengeneza final embedding kupitia:
\[ (P_{\mathrm{concat}},G) \rightarrow \text{PCC refinement} \rightarrow \text{PCA} \rightarrow E \]
Katika inference, kadiri Euclidean distance kati ya embeddings mbili inavyopungua, mfumo huweka juu zaidi katika ranking uwezekano kwamba picha ni za identity ileile.
Matokeo makuu ya Market-1501Final DPBF imetoa:\[ 96{,}0\% \ R1 \]na:\[ 89{,}3\% \ mAP \]
Rank-1 ndiyo highest katika source table, lakini AaP-ReID ina mAP ya juu zaidi ya %93,9.
Matokeo makuu ya DukeMTMC-ReID
DPBF imetoa:
\[ 92{,}0\% \ R1 \]na:\[ 82{,}8\% \ mAP \]Rank-1 ndiyo highest katika source table. Kwa mAP, AaP-ReID ina value ya juu zaidi ya %88,6.Matokeo makuu ya CUHK03-LabeledDPBF imetoa:
\[ 89{,}5\% \ R1 \]
na:
\[ 82{,}6\% \ mAP \]
ambazo ni highest metrics zote mbili katika source table.
Matokeo makuu ya Occluded-ReID
Strongest benchmark result ya DPBF inaonekana hapa:
\[ 93{,}5\% \ R1, \qquad 91{,}2\% \ mAP. \]
Next highest R-1 katika source table ni BPB Re-ID yenye:
\[ 82{,}9\% \]
Kwa mAP, modeli hiyo hiyo ina:
\[ 75{,}2\% \]
Matokeo ya P-DukeMTMC-ReID
DPBF imefikia:
\[ 93{,}6\% \ R1, \qquad 83{,}6\% \ mAP \]
BPB Re-ID ina:
\[ 93{,}0/83{,}2 \]
hivyo differences ni pointi 0,6 na 0,4 mtawalia.
Matokeo ya Occluded-Duke
DPBF imetoa:
\[ 74{,}7/60{,}7 \]
BPB Re-ID imepata:
\[ 75{,}1/62{,}5 \]
ambazo ni slightly higher kwa metrics zote mbili.
Occlusion analysis inaonyesha nini?
Katika heatmaps za Figure 6, mipaka ya kijani inaonyesha successful feature localization examples na mipaka nyekundu inaonyesha weak au incorrect representations.
Katika mild occlusion, attention activation inaweza kubaki kwenye upper body na visible clothing regions, lakini katika severe occlusion hasa:
- foot,
- lower leg,
- limbs ambazo hazionekani kabisa
huzalisha very weak features.
Table 8 inathibitisha quantitative observation hii ya visual.
DPBF inapunguza severe occlusion vipi?
Kulingana na source results, suluhisho si “kurejesha” taarifa kutoka kwa sehemu iliyofunikwa.
Badala yake:
- visible body regions zinawakilishwa kila moja,
- strong local features zinaunganishwa na global appearance information,
- redundant features zinapunguzwa kwa PCC/PCA,
- dependency kwa local part moja inapunguzwa.
Kwa hiyo faida kuu ya DPBF inaweza kufasiriwa kama adaptive local–global compensation.
Practical limitations za modeli
Future-work areas zilizosisitizwa na waandishi katika conclusion ni:
- parsing iliyo stable zaidi katika severe occlusion,
- adaptive part weighting,
- occlusion-aware feature reconstruction,
- representation yenye nguvu zaidi katika low resolution,
- kutofautisha watu wanaofanana sana,
- transformer-based global–local interaction.
Mapendekezo haya ya future work pia yanaonyesha kwamba DPBF ya sasa haijatatua matatizo haya kikamilifu.
Methodological limit ya comparisons
Utafiti umechukua scores nyingi za baseline models kutoka original papers zao. Kwa hiyo kati ya models:
- backbone,
- input resolution,
- augmentation,
- optimizer settings,
- auxiliary training techniques
si sawa kikamilifu.
Waandishi wamejaribu kupunguza comparison bias kwa kuchagua reported results chini ya standard benchmark protocols pekee.
Kwa hiyo tables zinatoa comparison dhidi ya published performance levels za field; si unified benchmark iliyofanywa katika laboratory moja chini ya conditions sawa kabisa.
Statistical significance limit
Makala inaripoti Rank-1 na mAP differences lakini haitoi kwa benchmark differences kati ya models:
- confidence interval,
- bootstrap uncertainty,
- paired significance test
.
Kwa hiyo, kwa mfano, differences za pointi 10,6 na 16,0 katika Occluded-ReID ni large numerical differences; lakini kauli ya “statistically significant superiority” haijaungwa mkono na formal hypothesis test.
Maelezo ya Chanzo na Mbinu
Jina kamili la kazi asilia: Strategic Feature Integration for Superior Person Re-ID: A Part-Based Approach
Waandishi: Ghaith Hussein; Jeremy S. Smith; Waleed Al-Nuaimy.
Equal first/equal contribution: Hakuna equal first author au equal contribution statement katika chanzo.
Corresponding author: Ghaith Hussein.
Taasisi: Department of Electrical Engineering and Electronics, University of Liverpool, Brownlow Hill, Liverpool L69 3GJ, United Kingdom.
Aina ya chanzo: Peer-reviewed original research article; Person Re-Identification study inayotegemea computer vision na deep learning.
Jarida: AI.
Mchapishaji: MDPI, Basel, Switzerland.
Bibliographic record: AI, 2026, Volume 7, Issue 6, Article 210.
DOI: 10.3390/ai7060210.
Received / revised / accepted / published: 30 Machi 2026 / 1 Juni 2026 / 2 Juni 2026 / 9 Juni 2026.
Peer-review status: Peer-reviewed journal publication.
License: Creative Commons Attribution (CC BY).
Academic Editor: Miguel Angel Cazorla.
Keywords katika chanzo: Salient Part Discrimination; Adaptive Feature Integration and Contextual Fusion; Person Re-ID; attention mechanism; feature fusion.
Modeli iliyopendekezwa: Dynamic Part-Based Fusion (DPBF).
Main model component 1: Salient Part Discrimination (SPD).
Main model component 2: Adaptive Feature Integration and Contextual Fusion (AFICF).
Parsing model: Self-Correction for Human Parsing (SCHP).
Attention approach: Grad-CAM-based part-specific attention maps na Cross-Part Spatial Feature Modulation Map.
Feature redundancy analysis: Pearson Correlation Coefficient.
Dimension reduction: Principal Component Analysis; final compact representation 512 dimensions.
Loss: Hybrid Loss Function ya Cross-entropy + triplet loss. Triplet margin 0,3; main loss components mbili zina equal weight.
Additional part-supervision loss: Pixel-level cross-entropy weight 0,35.
Backbones: ResNet-50 na HRNet-w32.
ResNet-50 input size: 256 × 128 pixels.
HRNet-w32 input size: 384 × 128 pixels.
Optimizer: Adam.
Main learning rate: \(3,5\times10^{-4}\).
Warm-up learning rate: \(3,5\times10^{-5}\).
Weight decay: 0,0005.
Training: 150 epoch; learning rate reduction kwenye epoch 40 na 70.
Sampling: RandomIdentitySampler; instances nne kwa kila identity.
Batch size: 16–64 kulingana na experimental configuration.
Data augmentation: Random cropping, normalization na random erasing.
Benchmark datasets: Market-1501, DukeMTMC-ReID, CUHK03-Labeled, Occluded-Duke, Occluded-ReID na P-DukeMTMC-ReID.
Main evaluation metrics: Rank-1 Accuracy na mean Average Precision (mAP).
Occluded-ReID final result: %93,5 Rank-1 na %91,2 mAP.
P-DukeMTMC-ReID final result: %93,6 Rank-1 na %83,6 mAP.
Occluded-Duke final result: %74,7 Rank-1 na %60,7 mAP.
Market-1501 final result: %96,0 Rank-1 na %89,3 mAP.
DukeMTMC-ReID final result: %92,0 Rank-1 na %82,8 mAP.
CUHK03-Labeled final result: %89,5 Rank-1 na %82,6 mAP.
Model complexity: Takribani parameters milioni 39,5–41,3 na takribani FLOP bilioni 8,0 zimeripotiwa kulingana na configuration.
Main training GPU: NVIDIA GeForce RTX 4090, 24 GB.
Additional experimental hardware: 2 × NVIDIA GeForce TITAN Xp.
Re-ranking: Kulingana na chanzo, re-ranking haikutumika katika comparative results isipokuwa ilipoelezwa vinginevyo.
Funding: Utafiti haukupokea external funding.
Ethics review: Kwa kuwa hakukuwa na new human participants wala new data collection na public benchmark datasets pekee zilitumika, ethics review/approval iliripotiwa kuwa waived.
Informed consent: Iliripotiwa kuwa waived kwa kuwa watafiti hawakukusanya new human data; images zilizotumiwa zilitoka katika datasets zilizokuwa zimechapishwa awali na original benchmark providers.
Data availability: Benchmark zote sita zimeripotiwa kuwa public na data sources zimetolewa katika makala.
Author contributions: Conceptualization G.H.; methodology na software G.H.; validation G.H. na J.S.S.; formal analysis G.H.; investigation G.H. na J.S.S.; original draft G.H.; review/editing J.S.S. na W.A.-N.; supervision W.A.-N.
Conflict of interest: Waandishi hawakuripoti conflict of interest.
Source-internal inconsistency na reporting notes
Katika final benchmark ya Occluded-ReID, Table 2 inatoa %93,5 R-1 na %91,2 mAP kwa DPBF, ilhali feature-integration analysis kwenye dataset hiyo hiyo, HLF row ya Table 3, inatoa %86,5 R-1 na %73,7 mAP. Makala haihusishi tofauti hii na explicit backbone/protocol explanation. Kwa hiyo value sets hizi mbili zimehifadhiwa kama experimental contexts tofauti.
Comparison ya Occluded-ReID katika source text imeelezwa kama “%10,6 R-1 increase na %16 mAP improvement”. Differences zinazohesabiwa kutoka table values ni 10,6 na 16,0 percentage points. Verianla text hii imetumia “point difference” ili kutotoa maana ya relative percentage improvement.
Kwa CUHK03-Labeled, source narrative inadai advantage ya 4,8 R-1 na 1,6 mAP dhidi ya competitor iliyo karibu zaidi. Table 1 inathibitisha pointi 4,8 kwa R-1, lakini value iliyo karibu zaidi na %82,6 mAP ya DPBF ni %82,4 ya AaP-ReID; difference ni pointi 0,2. Difference ya pointi 1,6 hupatikana dhidi ya %81,0 ya SCSN.
Caption ya Figure 5 inaandika (b) Occluded-ReID na (c) P-DukeMTMC-ReID, lakini graph titles za figure iliyochapishwa zinaonyesha `p_dukemtmc_reid` na `Market-1501`. Chanzo hakibainishi ni label ipi ilikuwa intended final version katika figure-caption mismatch hii.
Interpretation limit ya comparative results
Baseline results nyingi za makala zimetolewa kutoka original publications za methods husika. Chanzo kinasema hili wazi na kinakubali kwamba backbone, input resolution, data augmentation, optimization na auxiliary training techniques zinaweza kuwa tofauti.
Kwa hiyo comparison tables zinapaswa kusomwa kama:
“empirical positioning dhidi ya reported results katika standard benchmark literature”
.
Hazipaswi kufasiriwa kama controlled benchmark ambapo methods zote zimeendeshwa tena kwa codebase moja, seed moja, backbone moja na GPU moja.
Scientific interpretation limit
DPBF ina strong results hasa kwenye Occluded-ReID na P-DukeMTMC-ReID; lakini si best system katika source table kwenye Occluded-Duke na si leader katika kila mAP metric kwenye full benchmarks.
Heavy occlusion analysis inaonyesha wazi kwamba feature reliability katika lower body au maeneo yasiyoonekana kabisa inaweza kushuka sana. Kwa hiyo mfumo si “person recognition isiyoathiriwa na occlusion”.
Zaidi ya hapo, metrics zilizotumika ni za academic retrieval benchmarks. Matokeo hayamaanishi identity verification guarantee katika real camera network, security guarantee, au guarantee ya kupata accuracy hiyo hiyo katika field deployment.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *