

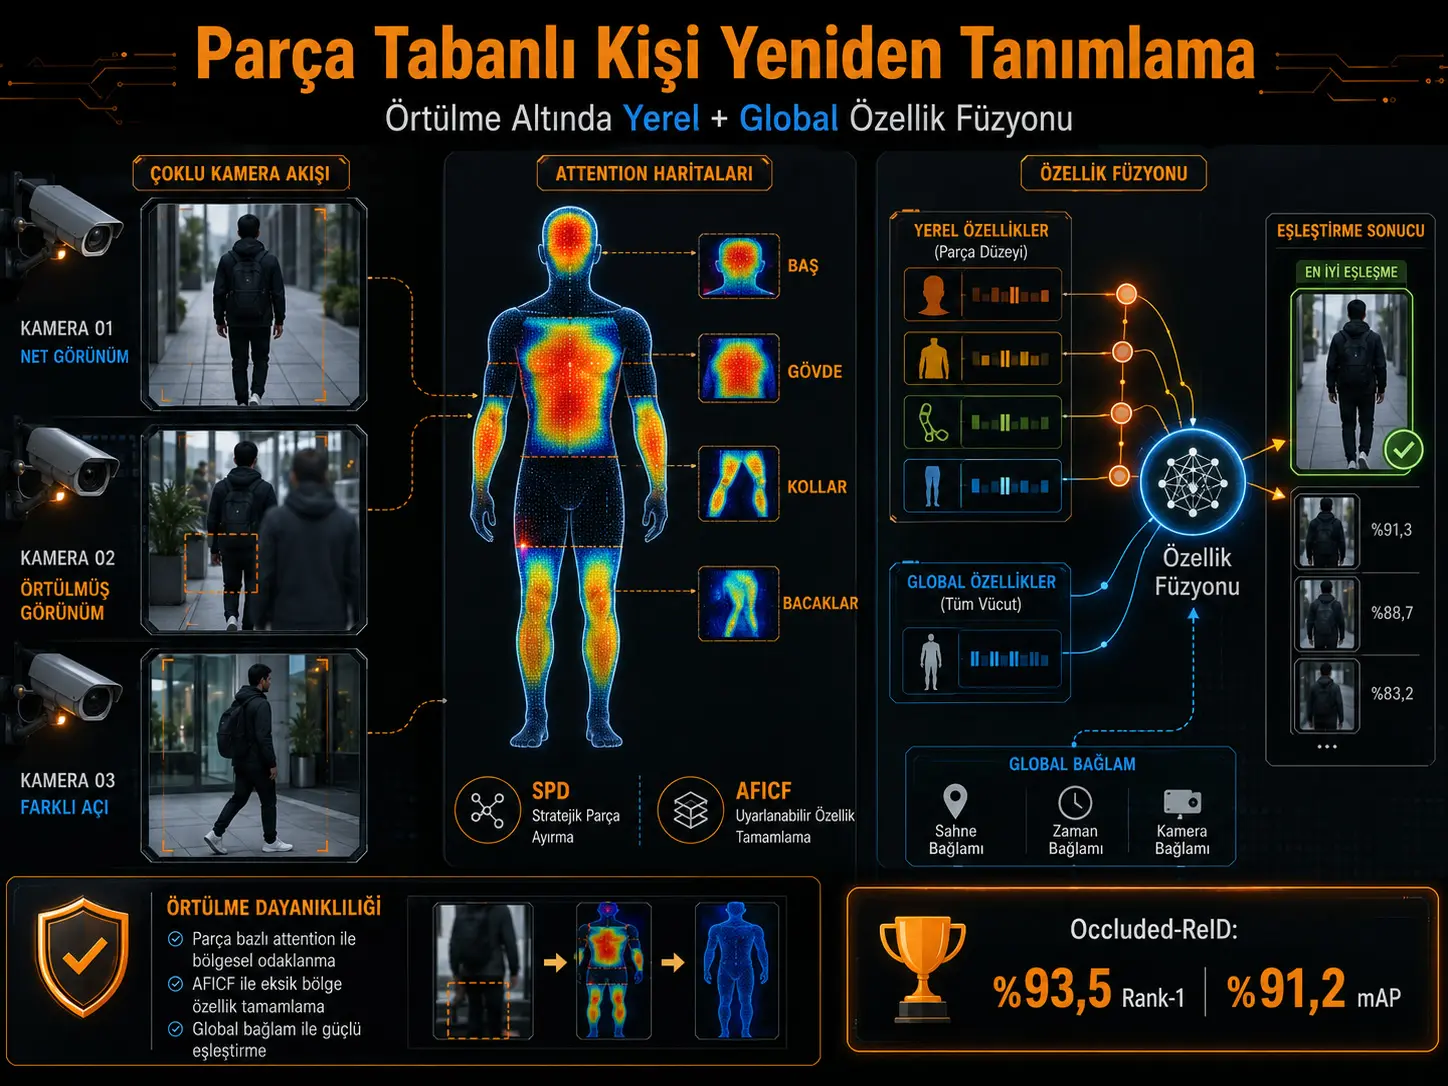
Bu çalışma, farklı kameralarda veya farklı zamanlarda görüntülenen aynı kişiyi yeniden bulmayı amaçlayan Person Re-Identification (Person Re-ID; kişi yeniden tanımlama) probleminde, özellikle vücudun bir bölümünün başka insanlar veya nesneler tarafından kapatıldığı görüntülere odaklanıyor. Araştırmacılar, yalnızca bütün insan görüntüsünü temsil eden tek bir global özellik vektörüne dayanmak yerine baş, gövde, kollar ve bacaklar gibi semantik vücut bölgelerinden gelen yerel bilgiyi global görünüm bilgisiyle birlikte kullanan Dynamic Part-Based Fusion (DPBF) mimarisini öneriyor. Sistem iki ana bileşenden oluşuyor: Salient Part Discrimination (SPD), insan ayrıştırma ve attention haritaları yardımıyla kimliği ayırt etmede daha yararlı vücut bölgelerini vurguluyor; Adaptive Feature Integration and Contextual Fusion (AFICF) ise yerel ve global özellikler arasındaki korelasyonu analiz ederek tekrarlayan bilgiyi azaltıyor ve tamamlayıcı özellikleri birleştiriyor.
Model Market-1501, DukeMTMC-ReID, CUHK03-Labeled, Occluded-Duke, Occluded-ReID ve P-DukeMTMC-ReID olmak üzere altı standart Person Re-ID veri setinde değerlendirildi. Çalışmanın en dikkat çekici sonucu Occluded-ReID üzerinde elde edildi: DPBF %93,5 Rank-1 ve %91,2 mAP değerine ulaştı. Kaynak tablodaki en yakın güçlü karşılaştırma BPB Re-ID için sırasıyla %82,9 ve %75,2 olduğundan aritmetik farklar 10,6 Rank-1 puanı ve 16,0 mAP puanıdır. P-DukeMTMC-ReID'de DPBF %93,6 Rank-1 ve %83,6 mAP verirken Occluded-Duke'ta %74,7 Rank-1 ve %60,7 mAP ile BPB Re-ID'nin biraz altında kalmıştır. Bu nedenle modelin bütün veri setlerinde tartışmasız en iyi yöntem olduğu söylenemez; güçlü tarafı özellikle bazı ağır örtülme senaryolarında yerel ve global özellikleri birlikte kullanabilmesidir.
Çalışma ayrıca önemli bir sınırlılığı nicel olarak gösteriyor. Ağır örtülme altında bazı tekil gövde-parçası embedding'leri neredeyse kullanılamaz hâle gelebiliyor. Üç örtülme odaklı benchmark'ta p7 olarak adlandırılan en zayıf embedding'in Rank-1 değeri yaklaşık %2–3 seviyesine kadar düşüyor. Buna karşılık bütünsel ve görünür bölgelerden bilgi taşıyan p0 temsili %69,5–92,6 Rank-1 aralığında kalıyor. Dolayısıyla DPBF'nin başarısı her vücut parçasını güvenilir biçimde tanımasından değil, görünür ve tamamlayıcı bölgelerden gelen bilgiyi global bağlamla birleştirerek tek bir zayıf parçaya bağımlılığı azaltmasından kaynaklanmaktadır.
Person Re-ID tam olarak hangi problemi çözüyor?
Person Re-ID sisteminin görevi, bir kameradaki kişinin başka bir kamera görüntüsü veya galeri kümesi içinde yeniden bulunmasıdır. Model bir sorgu görüntüsünden:
“Bu kişi galerideki hangi görüntüyle aynı kimliğe ait?”
sorusuna yanıt vermeye çalışır.
Problem klasik görüntü sınıflandırmadan farklıdır. Model yalnız “insan var mı?” sorusunu cevaplamaz; çok sayıda benzer görünümlü insan arasından aynı kimliği ayırt etmeye çalışır.
Bu görev özellikle şu koşullarda zorlaşır:
- kamera açısının değişmesi,
- aydınlatmanın değişmesi,
- kişinin farklı pozlarda bulunması,
- görüntü çözünürlüğünün düşmesi,
- benzer giysilere sahip insanların bulunması,
- vücudun bir bölümünün başka kişi veya nesneler tarafından kapanması.
Son madde, yani occlusion/örtülme, bu çalışmanın temel motivasyonudur.
Neden yalnız global özellik kullanmak yeterli olmayabilir?
Bir CNN bütün insan görüntüsünü tek bir özellik vektörüne sıkıştırabilir. Bu temsil kişinin genel kıyafet rengi, vücut görünümü ve silueti gibi bilgileri taşır. Ancak kişinin önemli bir kısmı kapanırsa global özellik vektörü görünmeyen veya yanıltıcı bölgelerin etkisini de içerir.
Örneğin insanın alt gövdesi başka bir nesne tarafından tamamen kapatılmışsa global temsil, kimliği ayırt etmek için aslında görünür olan üst gövde, çanta veya giysi dokusu gibi bölgeleri yeterince güçlü biçimde kullanamayabilir.
Parça tabanlı Re-ID yöntemlerinin amacı bu sorunu çözmek için insan bedenini daha küçük semantik bölgelere ayırmaktır.
DPBF'nin temel fikri nedir?
Önerilen sistem:
\[ \text{DPBF} = \text{SPD} + \text{AFICF} + \text{Hybrid Loss} \]
şeklinde düşünülebilir.
SPD, hangi vücut bölgelerinin kimlik açısından ayırt edici bilgi taşıdığını belirlemeye çalışır.
AFICF, farklı vücut parçalarından gelen özelliklerle bütün insan görüntüsünden elde edilen global özelliği birleştirir.
Hybrid Loss Function ise hem kimlik sınıflandırmasını hem de aynı kişiye ait embedding'lerin birbirine yaklaşmasını, farklı kişilerin ise uzaklaşmasını hedefler.
Önemli bir bilimsel ayrım vardır: araştırmacılar attention, human parsing, PCC, PCA veya triplet loss'u yeni icat ettiklerini öne sürmemektedir. Makalenin katkısı bu yapıların occluded Person Re-ID için koordineli bir DPBF pipeline'ında birlikte kullanılma biçimidir.
Salient Part Discrimination ne yapıyor?
SPD'nin görevi insan görüntüsünü yalnız geometrik olarak eşit şeritlere bölmek değil, anlamlı vücut bölgelerine karşılık gelen dikkat haritaları üretmektir.
Modelin giriş özellik haritası:
\[ F \]
olarak gösterilir. Bu özellik haritası önce:
\[ 1\times1 \]
convolution katmanından geçirilerek:
\[ F' \]
elde edilir.
Daha sonra hafif bir CNN, global average pooling ve fully connected katman kullanılarak:
\[ K \]
adet attention ağırlığı üretilir.
Bunlar:
\[ A_1,A_2,\ldots,A_K \]
şeklinde vücut parçalarına ait spatial attention haritalarına dönüştürülür.
Grad-CAM burada nasıl kullanılıyor?
Çalışma her önceden tanımlanan vücut parçası için attention haritası oluştururken Grad-CAM tabanlı bir strateji kullanmaktadır.
Amaç örneğin:
- baş,
- gövde,
- sol/sağ kol,
- sol/sağ bacak
gibi bölgelerin feature map üzerindeki kimlik açısından anlamlı aktivasyonlarını ayırmaktır.
Makalenin 6. sayfasındaki Şekil 1'de aynı kişinin görüntüsü farklı semantik parçalara ayrılarak her bölüm için oluşturulan attention heatmap'leri gösterilmektedir. Bazı haritalarda üst gövde veya bacak bölgelerinin belirgin biçimde yüksek aktivasyon aldığı görülmektedir.
SCHP neden sisteme ekleniyor?
İnsan vücudunu yalnız sabit geometrik dilimlere bölmek poz değişimlerinde sorun oluşturabilir. İnsan yürürken veya eğilirken aynı koordinat bölgesi her görüntüde aynı anatomik yapıya karşılık gelmeyebilir.
Bu nedenle çalışma Self-Correction for Human Parsing (SCHP) modelinden üretilen human parsing etiketlerini kullanıyor.
İlk parsing etiketi:
\[ Y_0=P(X) \]
şeklinde ifade edilmektedir.
Daha sonra correction network:
\[ C = \arg\min_C L \left( C(Y_0),Y_{GT} \right) \]
ile optimize edilir ve düzeltilmiş etiket:
\[ Y_1=C(Y_0) \]
olarak elde edilir.
SPD bu parsing bilgisini attention mekanizmasıyla birleştirerek anatomik olarak daha tutarlı parça temsilleri üretmeye çalışmaktadır.
Human parsing hatasız mı?
Hayır. Kaynak çalışma bu noktayı özellikle sınırlılık olarak kabul etmektedir.
Ağır örtülme veya sıra dışı poz durumunda:
- bacak kaybolabilir,
- kol yanlış bölgeye atanabilir,
- parsing maskesi eksik üretilebilir,
- anatomik parçanın yalnız küçük bölümü görünebilir.
Bu nedenle model attention mekanizmasını parsing etiketlerinin tek başına kullanımına alternatif değil, onları tamamlayan bir yapı olarak kullanmaktadır.
Cross-Part Spatial Feature Modulation Map nedir?
Attention haritaları üretildikten sonra bunların yalnız görselleştirilmesi yeterli değildir. Her attention map asıl özellik haritasına uygulanır.
Her vücut parçası için:
\[ P_k=A_k\times F \]
element-wise multiplication işlemi kullanılır.
Böylece:
\[ P_1,P_2,\ldots,P_K \]
şeklinde parça-özel özellik haritaları elde edilir.
Ardından bunlar:
\[ P_{\mathrm{concat}} = \operatorname{Concat} (P_1,P_2,\ldots,P_K) \]
ile birleştirilir.
Makalenin 8. sayfasındaki Şekil 2 ve Şekil 3 bu işlemi açıkça göstermektedir: feature map, birden fazla attention map ile çarpılmakta ve ortaya çıkan yerel özellik temsilleri ortak bir parça tabanlı representation'a taşınmaktadır.
Neden yerel özelliklerle global özellikler yeniden birleştiriliyor?
Yalnız vücut parçalarına güvenmek de sorun yaratabilir.
Örneğin:
- bacak tamamen kapalıysa bacak embedding'i anlamsızlaşabilir,
- kol çok küçük görünüyorsa özellik gürültülü olabilir,
- yanlış parsing bir parçayı başka bölgeye taşıyabilir.
Global özellik ise bütün görüntünün bağlamını korur.
DPBF bu nedenle:
local body-part features + global contextual feature
birleşimini kullanmaktadır.
AFICF neden basit concatenation kullanmıyor?
Yerel ve global feature vektörlerini doğrudan yan yana eklemek boyutu artırır. Daha önemli sorun ise aynı bilgiyi taşıyan yüksek korelasyonlu özelliklerin birden fazla kez sisteme girmesidir.
AFICF bu nedenle önce özellikler arasındaki Pearson korelasyonunu hesaplamaktadır.
\[ r_{XY} = \frac{ \sum_{i=1}^{n} (X_i-\bar X)(Y_i-\bar Y) }{ \sqrt{ \sum_{i=1}^{n}(X_i-\bar X)^2 } \sqrt{ \sum_{i=1}^{n}(Y_i-\bar Y)^2 } } \]
\[ |r_{XY}|\approx1 \]
olduğunda iki özelliğin güçlü doğrusal ilişki taşıdığı ve potansiyel olarak tekrarlı bilgi içerdiği kabul edilir.
AFICF yüksek korelasyonlu feature gruplarından tekrarlı bileşenleri azaltmayı amaçlamaktadır.
PCA neden uygulanıyor?
Pearson korelasyonundan sonra kalan feature uzayında hâlâ boyutsal tekrar bulunabilir. Bu nedenle Principal Component Analysis uygulanmaktadır.
Özellikler arasındaki covariance:
\[ \operatorname{Cov}(X_j,X_k) = \frac{1}{n-1} \sum_{i=1}^{n} (X_{ij}-\bar X_j) (X_{ik}-\bar X_k) \]
ile hesaplanır.
En yüksek eigenvalue'lara karşılık gelen principal component'lar korunarak final temsil:
\[ 512 \]
boyutlu kompakt bir embedding'e indirilmektedir.
DPBF'nin eğitim kaybı nasıl çalışıyor?
Model iki farklı hedefi birlikte optimize etmektedir.
Birinci bileşen cross-entropy loss'tur:
\[ L_{\mathrm{CE}} = -\sum_{i=1}^{N} Y_i\log\hat Y_i. \]
Bu terim modelin global kimlik ayrımını öğrenmesini sağlar.
İkinci bileşen triplet loss'tur:
\[ L_{\mathrm{triplet}} = \max \left( 0, D_{\mathrm{pos}} - D_{\mathrm{neg}} + m \right). \]
Burada:
- \(D_{\mathrm{pos}}\): aynı kişiye ait iki embedding arasındaki mesafe,
- \(D_{\mathrm{neg}}\): farklı kişilere ait embedding arasındaki mesafe,
- \(m\): margin.
Çalışmada margin:
\[ m=0{,}3 \]
olarak seçilmiştir.
Nihai Hybrid Loss:
\[ L_{\mathrm{Hybrid}} = \alpha L_{\mathrm{CE}} + \beta L_{\mathrm{TL}} \]
şeklindedir.
İki ana loss bileşeni eşit ağırlıklandırılmıştır.
Model nasıl eğitildi?
Çalışmada iki backbone kullanılmıştır:
- ResNet-50,
- HRNet-w32.
ResNet-50 için giriş görüntüsü:
\[ 256\times128 \]
piksel; HRNet-w32 için:
\[ 384\times128 \]
piksel olarak kullanılmıştır.
Model Adam optimizer ile eğitilmiş; başlangıç learning rate:
\[ 3{,}5\times10^{-4} \]
olarak verilmiştir.
Warm-up başlangıç learning rate:
\[ 3{,}5\times10^{-5} \]
ve weight decay:
\[ 0{,}0005 \]
olarak belirlenmiştir.
Learning rate 40. ve 70. epoch'ta azaltılmış; toplam eğitim:
\[ 150\ \text{epoch} \]
sürmüştür.
Her kimlik için batch içinde dört örnek kullanılmış ve effective batch size veri seti ve GPU koşullarına bağlı olarak 16–64 arasında değişmiştir.
Hangi veri setleri kullanıldı?
Çalışma iki farklı benchmark grubunu ayırmaktadır.
Bütünsel / standart Person Re-ID veri setleri:
- Market-1501,
- DukeMTMC-ReID,
- CUHK03-Labeled.
Örtülme odaklı veri setleri:
- Occluded-Duke,
- Occluded-ReID,
- P-DukeMTMC-ReID.
Rank-1 Accuracy ne anlama geliyor?
Bir sorgu görüntüsü için sistem galerideki kişileri benzerliğe göre sıralar.
Doğru kimliğin listenin ilk sırasında bulunması Rank-1 başarısıdır.
Örneğin:
\[ R1=93{,}5\% \]
sonucu, kullanılan benchmark protokolü altında sorguların yaklaşık %93,5'inde doğru kimliğin birinci sırada bulunduğunu ifade eder.
mAP neyi ölçüyor?
Mean Average Precision yalnız ilk sırayı değil, aynı kimliğe ait bütün doğru eşleşmelerin sıralama listesindeki dağılımını hesaba katar.
Bu nedenle:
- Rank-1 ilk sonuca,
- mAP bütün retrieval listesinin kalitesine
daha fazla duyarlıdır.
Bütünsel benchmark'larda sonuçlar nasıl?
| Veri seti | DPBF Rank-1 (%) | DPBF mAP (%) | Kaynak tablodaki konumu |
|---|---|---|---|
| Market-1501 | 96,0 | 89,3 | Rank-1'de en yüksek; mAP'te AaP-ReID'in altında |
| DukeMTMC-ReID | 92,0 | 82,8 | Rank-1'de en yüksek; mAP'te AaP-ReID'in altında |
| CUHK03-Labeled | 89,5 | 82,6 | Her iki metrikte de tablodaki en yüksek değer |
Bu tablo önemli bir ayrımı gösterir. DPBF bütün benchmark ve bütün metriklerde en yüksek değeri üretmemiştir. Market-1501'de AaP-ReID'in mAP değeri %93,9 iken DPBF %89,3; DukeMTMC-ReID'de AaP-ReID %88,6 mAP iken DPBF %82,8'dir.
Dolayısıyla modelin güçlü performansı, “bütün mevcut yöntemlerden her yerde daha iyi” biçiminde genellenmemelidir.
CUHK03-Labeled sonucu
DPBF:
\[ R1=89{,}5\%,\qquad mAP=82{,}6\% \]
değerlerini üretmektedir.
R-1 açısından tabloda bir sonraki en yüksek değer %84,7 olduğundan fark:
\[ 89{,}5-84{,}7 = 4{,}8 \]
puan olarak hesaplanmaktadır.
mAP açısından ise AaP-ReID %82,4 ile DPBF'ye en yakın değerdir. Bu nedenle aritmetik fark:
\[ 82{,}6-82{,}4 = 0{,}2 \]
puandır.
Kaynak metinde belirtilen 1,6 puanlık mAP farkı en yakın değerle değil, SCSN'nin %81,0 mAP değeriyle karşılaştırıldığında elde edilmektedir.
Örtülme odaklı veri setlerinde sonuçlar
| Veri seti | DPBF Rank-1 (%) | DPBF mAP (%) | Kaynak tablodaki en yakın güçlü karşılaştırma |
|---|---|---|---|
| Occluded-Duke | 74,7 | 60,7 | BPB Re-ID: 75,1 / 62,5 |
| Occluded-ReID | 93,5 | 91,2 | BPB Re-ID: 82,9 / 75,2 |
| P-DukeMTMC-ReID | 93,6 | 83,6 | BPB Re-ID: 93,0 / 83,2 |
Modelin en belirgin üstünlüğü Occluded-ReID'de ortaya çıkmaktadır.
Rank-1 farkı:
\[ 93{,}5-82{,}9 = 10{,}6 \]
puan;
mAP farkı:
\[ 91{,}2-75{,}2 = 16{,}0 \]
puandır.
Kaynak bu farkları yüzde iyileşme olarak ifade etmektedir; ancak tablodaki değerlerin doğrudan çıkarımı bunların yüzde puanı farkı olduğunu gösterir.
Occluded-Duke neden önemli bir karşı örnek?
Occluded-Duke'ta DPBF:
\[ 74{,}7/60{,}7 \]
sonucunu verirken BPB Re-ID:
\[ 75{,}1/62{,}5 \]
üretmektedir.
Bu nedenle önerilen mimarinin örtülme içeren bütün veri setlerinde en iyi sonucu verdiği söylenemez.
Parça sayısı arttığında performans nasıl değişiyor?
Market-1501 ablation çalışmasında üç farklı gövde-parçası ayrıntısı denenmiştir:
- 3 parça,
- 5 parça,
- 8 parça.
Her üç supervision stratejisinde de parça sayısının 3'ten 8'e çıkarılması daha yüksek performansla ilişkilidir.
Sekiz parçalı konfigürasyonda kaynakta “semi-supervised” olarak adlandırılan Parsing + PAM düzeni:
\[ R1=96{,}0\%,\qquad mAP=89{,}3\% \]
sonucuna ulaşmıştır.
Aynı sekiz parçada yalnız supervised parsing:
\[ 92{,}6/85{,}3 \]
ve yalnız PAM tabanlı unsupervised düzen:
\[ 86{,}7/77{,}8 \]
sonucunu vermiştir.
Bu deney, parsing bilgisinin attention mekanizmasıyla birlikte kullanılmasının bu benchmark ve konfigürasyon altında yalnız PAM veya yalnız parsing yaklaşımından daha güçlü olduğunu desteklemektedir.
DPBF ile PCB'nin parça sayısı karşılaştırması
DukeMTMC-ReID üzerinde kaynak şu sonuçları raporlamaktadır:
| Parça sayısı | DPBF R-1 (%) | DPBF mAP (%) | PCB R-1 (%) | PCB mAP (%) |
|---|---|---|---|---|
| 3 | 87,4 | 80,2 | 76,4 | 58,3 |
| 5 | 90,5 | 82,7 | 82,4 | 67,5 |
| 6 | 91,0 | 83,8 | 82,6 | 68,8 |
Kaynak bu sonuçları DPBF'nin parsing-guided attention ile correlation-aware integration bileşenlerinin birlikte katkısına bağlamaktadır. Bununla birlikte tablo tek tek SPD ve AFICF bileşenlerinin tamamen izole edilmiş nedensel katkısını ölçmemektedir.
Özellik entegrasyonu deneyinde ne görülüyor?
Occluded-ReID üzerindeki özellik entegrasyonu analizinde global pooled feature, body-part features, Pearson correlation refinement ve PCA bileşenleri farklı kombinasyonlarda çıkarılmıştır.
Tam HLF konfigürasyonunda kaynak:
\[ mAP=73{,}7,\qquad R1=86{,}5 \]
raporlamaktadır.
Daha fazla feature-integration bileşeni kaldırıldıkça performans:
\[ 68{,}7 \rightarrow 62{,}9 \rightarrow 57{,}5 \rightarrow 55{,}2 \]
mAP seviyelerine kadar gerilemektedir.
Bu deney yerel + global özelliklerin ve correlation/PCA refinement'ın birlikte kullanımını desteklemektedir.
Ancak bu tablodaki final HLF sonucu ile makalenin ana Occluded-ReID karşılaştırma tablosundaki:
\[ 93{,}5\ R1,\qquad91{,}2\ mAP \]
değeri arasında büyük fark vardır. Kaynak bu iki değerlendirme konfigürasyonunun neden bu ölçüde farklı sonuç verdiğini açık biçimde eşleştirmediği için değerler aynı deney sonucuymuş gibi birleştirilmemelidir.
Ağır örtülme hangi vücut bölgelerini en çok etkiliyor?
Çalışmanın attention heatmap'leri ve parça bazlı testleri özellikle alt gövde bölgelerinin daha kırılgan olduğunu göstermektedir.
Kaynakta p0 en güçlü, p7 ise en zayıf embedding olarak raporlanmıştır.
| Veri seti | En güçlü embedding | En zayıf embedding | Rank-1 farkı | mAP farkı |
|---|---|---|---|---|
| Occluded-ReID | p0: 91,5 / 84,8 | p7: 2,5 / 6,9 | 89,0 | 77,9 |
| Occluded-Duke | p0: 69,5 / 56,8 | p7: 2,9 / 1,4 | 66,6 | 55,4 |
| P-DukeMTMC-ReID | p0: 92,6 / 81,8 | p7: 2,4 / 1,5 | 90,2 | 80,3 |
Bu sonuç DPBF'nin önemli bir sınırını açık biçimde ortaya koymaktadır: görünmeyen veya neredeyse tamamen örtülmüş bir vücut parçasından güvenilir kimlik bilgisi üretmek hâlâ son derece zordur.
Modelin avantajı bu zayıf parçayı “iyileştirmekten” çok diğer görünür bölgeler ve global bağlam sayesinde toplam kimlik temsilini ayakta tutmaya çalışmasıdır.
Şekil 5'teki kaynak-içi tutarsızlık
Makalenin Şekil 5 açıklamasında:
- (b) paneli Occluded-ReID,
- (c) paneli P-DukeMTMC-ReID
olarak tanımlanmaktadır.
Ancak yayımlanmış görselin grafik başlıklarında üst grafik:
p_dukemtmc_reid
ve alt grafik:
Market-1501
olarak etiketlenmiştir.
Bu nedenle grafik panel isimleri ile figure caption tam olarak uyuşmamaktadır. Kaynağın hangisini amaçladığını varsayarak sessiz düzeltme yapmak yerine bu belirsizlik korunmalıdır.
Hesaplama maliyeti nasıl?
Kaynakta üç yöntemin batch processing ve bellek değerleri şöyledir:
| Model | Processing Time (s/batch) | Memory Usage (MB) |
|---|---|---|
| PCB + RPP | 129,8272 | 20.250 |
| BPB Re-ID | 122,7825 | 19.018 |
| DPBF | 126,2159 | 21.250 |
DPBF en düşük bellek veya en hızlı yöntem değildir. BPB Re-ID daha düşük processing time ve bellek kullanımı göstermektedir. DPBF'nin amacı hesaplama açısından mutlak minimum değil, örtülme dayanıklılığı ile hesaplama maliyeti arasında rekabetçi bir denge kurmaktır.
Model kaç parametre kullanıyor?
Kaynakta veri setine bağlı yapılandırmalar için yaklaşık:
\[ 39{,}5-41{,}3\ \text{milyon} \]
parametre raporlanmıştır.
FLOP değeri yaklaşık:
\[ 8{,}0\times10^9 \]
düzeyindedir.
RTX 4090 ve TITAN Xp tekrarlarında sonuçlar tutarlı mı?
Market-1501 üzerinde TITAN Xp çalışması:
\[ 96{,}08\ R1,\quad89{,}32\ mAP \]
ve RTX 4090 çalışması:
\[ 95{,}67\ R1,\quad89{,}49\ mAP \]
vermiştir.
DukeMTMC-ReID'de:
\[ 91{,}88/82{,}87 \]
ve:
\[ 92{,}06/82{,}87 \]
sonuçları raporlanmıştır.
P-DukeMTMC-ReID'de fark biraz daha büyüktür:
\[ 92{,}09/82{,}13 \]
ile:
\[ 93{,}62/83{,}67. \]
Yazarlar bu karşılaştırmayı farklı donanım koşullarında performansın genel olarak istikrarlı kaldığına kanıt olarak sunmaktadır.
Ancak “reproducibility” burada bağımsız başka bir araştırma grubunun replikasyonu anlamına gelmez; aynı çalışma içinde farklı donanımlarda yapılan ek eğitim/evaluation çalışmalarıdır.
RTX 4090 değerlendirme süresini ne kadar azaltıyor?
Market-1501 evaluation batch time:
\[ 0{,}444\ \text{s} \rightarrow 0{,}126\ \text{s} \]
DukeMTMC-ReID:
\[ 0{,}454 \rightarrow 0{,}130\ \text{s} \]
ve P-DukeMTMC-ReID:
\[ 0{,}410 \rightarrow 0{,}128\ \text{s} \]
olarak raporlanmıştır.
Bu fark model algoritmasındaki değişiklikten değil kullanılan GPU mimarilerinin hesaplama kapasitesinden kaynaklanmaktadır.
Türkiye açısından çalışma ne ifade ediyor?
Çalışmada Türkiye'den toplanmış kamera verisi veya Türkiye'ye özgü Person Re-ID benchmark'ı bulunmamaktadır. Dolayısıyla raporlanan:
\[ 93{,}5\%, \quad 91{,}2\% \]
gibi sonuçlar Türkiye'deki havaalanı, fabrika, kampüs veya güvenlik kameralarında beklenen başarı oranları olarak kullanılamaz.
Türkiye'de uygulanacak bir sistem için kamera çözünürlüğü, kamera yüksekliği, kalabalık yoğunluğu, kıyafet benzerliği, görüntü sıkıştırması, gece/gündüz koşulları ve örtülme yapısı gibi faktörlerle ayrıca yerel değerlendirme yapılması gerekir.
Çalışmanın desteklediği sonuçlar
- SPD ve AFICF'nin koordineli kullanıldığı DPBF, altı Person Re-ID benchmark'ında rekabetçi sonuçlar üretmiştir.
- Occluded-ReID üzerinde kaynak tablodaki en yakın karşılaştırmaya göre 10,6 Rank-1 puanı ve 16,0 mAP puanı daha yüksek sonuç raporlanmıştır.
- P-DukeMTMC-ReID'de DPBF kaynak tablodaki en yüksek Rank-1 ve mAP değerini üretmiştir.
- Market-1501 ve DukeMTMC-ReID'de DPBF Rank-1 açısından tablodaki en yüksek sonucu verirken mAP açısından en iyi yöntem değildir.
- Occluded-Duke'ta DPBF kaynak tablodaki BPB Re-ID sonucunun altında kalmıştır.
- Market-1501 ablation'ında 8 parçalı Parsing + PAM konfigürasyonu 3 ve 5 parçalı alternatiflerden daha yüksek performans göstermiştir.
- Ağır örtülme alt gövde embedding'lerinde çok büyük performans kaybına yol açmıştır.
- Farklı GPU ortamlarındaki ek eğitimler genel olarak benzer R-1 ve mAP sonuçları üretmiştir.
Çalışmanın kanıtlamadığı şeyler
- DPBF'nin bütün Person Re-ID veri setlerinde mevcut bütün yöntemlerden üstün olduğu kanıtlanmamıştır.
- Benchmark sonuçları gerçek bir şehir çapındaki kamera ağında saha başarısı olarak doğrulanmamıştır.
- Parça tabanlı attention ağır örtülmenin etkisini tamamen ortadan kaldırmamaktadır.
- Her vücut parçasının güvenilir kimlik bilgisi taşıdığı gösterilmemiştir; p7 sonuçları bunun tersini göstermektedir.
- Baselines aynı kod, backbone, input resolution ve eğitim pipeline'ıyla bütünüyle yeniden çalıştırılmış değildir.
- Kaynak tablolarındaki performans farkları için confidence interval veya formal significance testi verilmemiştir.
- DPBF'nin computationally en hafif veya en hızlı Re-ID modeli olduğu gösterilmemiştir.
- Donanımlar arası tekrarlar bağımsız üçüncü taraf replikasyonu değildir.
Çalışmanın Yöntemi ve Bulguları
DPBF işlem hattı
Makaledeki Algorithm 1'e göre eğitim şu sırayla yürütülmektedir:
- Giriş görüntüsünden CNN backbone feature map'leri çıkarılır.
- SPD ile parsing-guided body-part representations oluşturulur.
- Yerel body-part embedding'leri ve global contextual embedding elde edilir.
- AFICF ile yerel ve global özelliklerin ilişkisi düzenlenir.
- Pearson korelasyon analiziyle tekrarlı feature bileşenleri azaltılır.
- PCA ile kompakt discriminative embedding oluşturulur.
- Yerel ve global temsiller birleştirilir.
- Model Hybrid Loss ile optimize edilir.
Inference aşamasında ise:
- query ve gallery görüntülerinden normalize embedding'ler çıkarılır,
- embedding çiftleri arasında Euclidean distance hesaplanır,
- gallery görüntüleri küçükten büyüğe mesafeye göre sıralanır,
- kimlik eşleşmesi retrieval listesi olarak döndürülür.
Mimari akışın kısa matematiksel özeti
Bir görüntü:
\[ X \]
backbone'a girdiğinde:
\[ X \rightarrow F \]
özellik haritası oluşur.
SPD:
\[ F \rightarrow \{A_1,\ldots,A_K\} \]
attention haritalarını oluşturur.
Daha sonra:
\[ P_k=A_k\odot F \]
ile her body-part representation üretilir.
Bunlar:
\[ P_{\mathrm{concat}} = [P_1;\ldots;P_K] \]
olarak birleştirilir.
AFICF:
\[ (P_{\mathrm{concat}},G) \rightarrow \text{PCC refinement} \rightarrow \text{PCA} \rightarrow E \]
işlemiyle final embedding'i üretir.
Inference sırasında iki embedding arasındaki Euclidean mesafe küçüldükçe sistem görüntülerin aynı kimliğe ait olma olasılığını sıralamada daha yüksek kabul eder.
Market-1501 ana sonucu
Final DPBF:
\[ 96{,}0\% \ R1 \]
ve:
\[ 89{,}3\% \ mAP \]
üretmiştir.
Rank-1 kaynaktaki tabloda en yüksek değerken mAP'te AaP-ReID %93,9 ile daha yüksektir.
DukeMTMC-ReID ana sonucu
DPBF:
\[ 92{,}0\% \ R1 \]
ve:
\[ 82{,}8\% \ mAP \]
vermiştir.
Rank-1 kaynak tablodaki en yüksek sonuçtur. mAP'te AaP-ReID %88,6 ile daha yüksek değere sahiptir.
CUHK03-Labeled ana sonucu
DPBF:
\[ 89{,}5\% \ R1 \]
ve:
\[ 82{,}6\% \ mAP \]
ile kaynak tablodaki en yüksek iki metriği üretmiştir.
Occluded-ReID ana sonucu
DPBF'nin en güçlü benchmark sonucu burada görülmektedir:
\[ 93{,}5\% \ R1, \qquad 91{,}2\% \ mAP. \]
Kaynak tablodaki bir sonraki yüksek R-1 BPB Re-ID'in:
\[ 82{,}9\% \]
değeridir.
mAP için aynı model:
\[ 75{,}2\% \]
vermektedir.
P-DukeMTMC-ReID sonucu
DPBF:
\[ 93{,}6\% \ R1, \qquad 83{,}6\% \ mAP \]
sonucuna ulaşmıştır.
BPB Re-ID:
\[ 93{,}0/83{,}2 \]
olduğundan farklar sırasıyla 0,6 ve 0,4 puandır.
Occluded-Duke sonucu
DPBF:
\[ 74{,}7/60{,}7 \]
üretmiştir.
BPB Re-ID ise:
\[ 75{,}1/62{,}5 \]
ile her iki metriği de biraz daha yüksek elde etmiştir.
Örtülme analizi ne anlatıyor?
Çalışmanın Şekil 6'sındaki heatmap'lerde yeşil sınırlar daha başarılı feature localization örneklerini, kırmızı sınırlar ise zayıf veya hatalı representation'ları göstermektedir.
Hafif örtülmede üst gövde ve görünür giysi bölgelerindeki attention aktivasyonu korunabilirken ağır örtülmede özellikle:
- ayak,
- alt bacak,
- tamamen görünmeyen uzuvlar
çok zayıf feature üretmektedir.
Tablo 8 bu görsel gözlemi nicel olarak doğrulamaktadır.
DPBF ağır örtülmeyi nasıl hafifletiyor?
Kaynak sonuçlara göre çözüm, örtülmüş parçadan bilgi “geri yaratmak” değildir.
Bunun yerine:
- görünür vücut bölgeleri ayrı ayrı temsil edilir,
- güçlü yerel özellikler global görünüm bilgisiyle birleştirilir,
- tekrarlı özellikler PCC/PCA ile azaltılır,
- tek bir lokal parçaya bağımlılık azaltılır.
Bu nedenle DPBF'nin temel avantajı adaptive local–global compensation biçiminde yorumlanabilir.
Modelin pratik sınırlılıkları
Yazarların sonuç bölümünde vurguladığı gelecek çalışma alanları şunlardır:
- ağır örtülmede daha kararlı parsing,
- adaptive part weighting,
- occlusion-aware feature reconstruction,
- düşük çözünürlükte daha güçlü representation,
- birbirine çok benzeyen insanların ayrılması,
- transformer tabanlı global–local interaction.
Bu gelecek çalışma önerileri, mevcut DPBF'nin bu sorunları tamamen çözmediğini de göstermektedir.
Karşılaştırmaların metodolojik sınırı
Çalışma baseline modellerin büyük bölümünün skorlarını kendi özgün makalelerinden almıştır. Dolayısıyla modeller arasında:
- backbone,
- giriş çözünürlüğü,
- augmentation,
- optimizer ayarları,
- yardımcı eğitim teknikleri
tamamen aynı değildir.
Yazarlar yalnız standart benchmark protokolleri altında raporlanmış sonuçları seçerek karşılaştırma yanlılığını azaltmaya çalışmıştır.
Bu nedenle tablolar alanın yayınlanmış performans düzeyleriyle karşılaştırma sağlar; fakat tek laboratuvarda tamamen eşit koşullarda yürütülen birleşik benchmark değildir.
İstatistiksel anlamlılık sınırı
Makale Rank-1 ve mAP farklarını raporlamaktadır ancak farklı modeller arasındaki benchmark farkları için:
- confidence interval,
- bootstrap uncertainty,
- paired significance test
sunmamaktadır.
Bu nedenle örneğin Occluded-ReID'deki 10,6 ve 16,0 puanlık farklar büyük sayısal farklardır; fakat “istatistiksel olarak anlamlı üstünlük” ifadesi formal hipotez testiyle desteklenmiş değildir.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: Strategic Feature Integration for Superior Person Re-ID: A Part-Based Approach
Yazarlar: Ghaith Hussein; Jeremy S. Smith; Waleed Al-Nuaimy.
Eş birinci/eş katkı: Kaynakta eş birinci yazar veya eş katkı beyanı bulunmamaktadır.
Sorumlu yazar: Ghaith Hussein.
Kurum: Department of Electrical Engineering and Electronics, University of Liverpool, Brownlow Hill, Liverpool L69 3GJ, United Kingdom.
Kaynak türü: Hakemli özgün araştırma makalesi; bilgisayarlı görü ve deep-learning tabanlı Person Re-Identification çalışması.
Dergi: AI.
Yayınevi: MDPI, Basel, Switzerland.
Bibliyografik kayıt: AI, 2026, Cilt 7, Sayı 6, Makale 210.
DOI: 10.3390/ai7060210.
Alınma / revizyon / kabul / yayın: 30 Mart 2026 / 1 Haziran 2026 / 2 Haziran 2026 / 9 Haziran 2026.
Hakemlik durumu: Hakemli dergi yayınıdır.
Lisans: Creative Commons Attribution (CC BY).
Academic Editor: Miguel Angel Cazorla.
Kaynakta verilen anahtar kelimeler: Salient Part Discrimination; Adaptive Feature Integration and Contextual Fusion; Person Re-ID; attention mechanism; feature fusion.
Önerilen model: Dynamic Part-Based Fusion (DPBF).
Ana model bileşeni 1: Salient Part Discrimination (SPD).
Ana model bileşeni 2: Adaptive Feature Integration and Contextual Fusion (AFICF).
Parsing modeli: Self-Correction for Human Parsing (SCHP).
Attention yaklaşımı: Grad-CAM tabanlı parça-özel attention haritaları ve Cross-Part Spatial Feature Modulation Map.
Feature redundancy analizi: Pearson Correlation Coefficient.
Boyut azaltımı: Principal Component Analysis; final kompakt representation 512 boyut.
Loss: Cross-entropy + triplet loss'tan oluşan Hybrid Loss Function. Triplet margin 0,3; iki ana loss eşit ağırlıklıdır.
Ek parça-supervision loss: Pixel-level cross-entropy weight 0,35.
Backbone'lar: ResNet-50 ve HRNet-w32.
ResNet-50 giriş boyutu: 256 × 128 piksel.
HRNet-w32 giriş boyutu: 384 × 128 piksel.
Optimizer: Adam.
Ana learning rate: \(3,5\times10^{-4}\).
Warm-up learning rate: \(3,5\times10^{-5}\).
Weight decay: 0,0005.
Eğitim: 150 epoch; learning rate azaltımı 40. ve 70. epoch.
Sampling: RandomIdentitySampler; kimlik başına dört instance.
Batch size: Deney konfigürasyonuna göre 16–64.
Veri artırma: Random cropping, normalization ve random erasing.
Benchmark veri setleri: Market-1501, DukeMTMC-ReID, CUHK03-Labeled, Occluded-Duke, Occluded-ReID ve P-DukeMTMC-ReID.
Ana değerlendirme metrikleri: Rank-1 Accuracy ve mean Average Precision (mAP).
Occluded-ReID final sonucu: %93,5 Rank-1 ve %91,2 mAP.
P-DukeMTMC-ReID final sonucu: %93,6 Rank-1 ve %83,6 mAP.
Occluded-Duke final sonucu: %74,7 Rank-1 ve %60,7 mAP.
Market-1501 final sonucu: %96,0 Rank-1 ve %89,3 mAP.
DukeMTMC-ReID final sonucu: %92,0 Rank-1 ve %82,8 mAP.
CUHK03-Labeled final sonucu: %89,5 Rank-1 ve %82,6 mAP.
Model karmaşıklığı: Kullanılan konfigürasyona göre yaklaşık 39,5–41,3 milyon parametre ve yaklaşık 8,0 milyar FLOP raporlanmıştır.
Ana eğitim GPU'su: NVIDIA GeForce RTX 4090, 24 GB.
Ek deney donanımı: 2 × NVIDIA GeForce TITAN Xp.
Re-ranking: Kaynağa göre aksi belirtilmedikçe karşılaştırmalı sonuçlarda re-ranking kullanılmamıştır.
Finansman: Çalışma dış finansman almamıştır.
Etik kurul: Yeni insan katılımcısı veya yeni veri toplama olmadığı ve yalnız açık benchmark veri setleri kullanıldığı için etik değerlendirme/approval waived olarak bildirilmiştir.
Bilgilendirilmiş onam: Araştırmacılar yeni insan verisi toplamadığı için waived olarak bildirilmiştir; kullanılan görüntüler özgün benchmark sağlayıcılarının daha önce yayımladığı veri setlerinden gelmektedir.
Veri erişilebilirliği: Kullanılan altı benchmark'ın kamuya açık olduğu belirtilmiş ve veri kaynakları makalede verilmiştir.
Yazar katkıları: Kavramsallaştırma G.H.; metodoloji ve yazılım G.H.; doğrulama G.H. ve J.S.S.; formal analiz G.H.; araştırma G.H. ve J.S.S.; ilk taslak G.H.; gözden geçirme/düzenleme J.S.S. ve W.A.-N.; danışmanlık W.A.-N.
Çıkar çatışması: Yazarlar çıkar çatışması bildirmemiştir.
Kaynak içi tutarsızlık ve raporlama notları
Occluded-ReID üzerindeki final benchmark Tablo 2'de DPBF için %93,5 R-1 ve %91,2 mAP verilirken, aynı veri setindeki feature-integration analysis Tablo 3'ün HLF satırı %86,5 R-1 ve %73,7 mAP vermektedir. Makale bu farkı açık bir backbone/protokol açıklamasıyla bağlamamaktadır. Bu nedenle iki değer seti ayrı deney bağlamları olarak korunmuştur.
Kaynak metindeki Occluded-ReID karşılaştırması “%10,6 R-1 artışı ve %16 mAP iyileşmesi” olarak ifade edilmektedir. Tablo değerlerinden hesaplanan farklar 10,6 ve 16,0 yüzde puanıdır. Bu Verianla metni göreli yüzde iyileşme anlamı oluşturmayacak biçimde “puan farkı” ifadesini kullanmıştır.
CUHK03-Labeled için kaynak anlatımı en yakın rakibe karşı 4,8 R-1 ve 1,6 mAP üstünlüğü iddia etmektedir. Tablo 1 R-1 için 4,8 puanı doğrularken, DPBF'nin %82,6 mAP değerine en yakın değer AaP-ReID'in %82,4 değeridir; fark 0,2 puandır. 1,6 puanlık fark SCSN'nin %81,0 değeriyle karşılaştırıldığında elde edilmektedir.
Şekil 5'in açıklamasında (b) Occluded-ReID ve (c) P-DukeMTMC-ReID olarak yazılırken yayımlanmış şeklin grafik başlıklarında `p_dukemtmc_reid` ve `Market-1501` ifadeleri görünmektedir. Bu figure-caption uyuşmazlığının hangi etiketinin yazarların amaçladığı nihai sürüm olduğunu kaynak kesinleştirmemektedir.
Karşılaştırmalı sonuçların yorum sınırı
Makalenin baseline sonuçları çoğunlukla ilgili yöntemlerin özgün yayınlarından alınmıştır. Kaynak bunu açıkça belirtmekte ve backbone, input resolution, data augmentation, optimization ve auxiliary training tekniklerinin farklı olabileceğini kabul etmektedir.
Bu nedenle karşılaştırma tabloları:
“standart benchmark literatüründeki raporlanmış sonuçlara karşı ampirik konumlandırma”
olarak okunmalıdır.
Bütün yöntemlerin aynı kod tabanı, aynı seed, aynı backbone ve aynı GPU altında yeniden çalıştırıldığı kontrollü benchmark olarak yorumlanmamalıdır.
Bilimsel yorum sınırı
DPBF özellikle Occluded-ReID ve P-DukeMTMC-ReID üzerinde güçlü sonuçlar göstermektedir; ancak Occluded-Duke'ta kaynak tablodaki en iyi sistem değildir ve bütünsel benchmark'larda da her mAP metriğinde lider değildir.
Çalışmanın ağır örtülme analizi, alt vücut veya tamamen görünmeyen bölgelerin feature reliability'sinin çok ciddi biçimde düşebildiğini açıkça göstermektedir. Dolayısıyla sistem “örtülmeden etkilenmeyen kişi tanıma” çözümü değildir.
Ayrıca kullanılan metrikler akademik retrieval benchmark'larına aittir. Sonuçlar gerçek bir kamera ağında kimlik doğrulama garantisi, güvenlik garantisi veya saha uygulamasında aynı doğruluk oranının elde edileceği anlamına gelmez.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir