

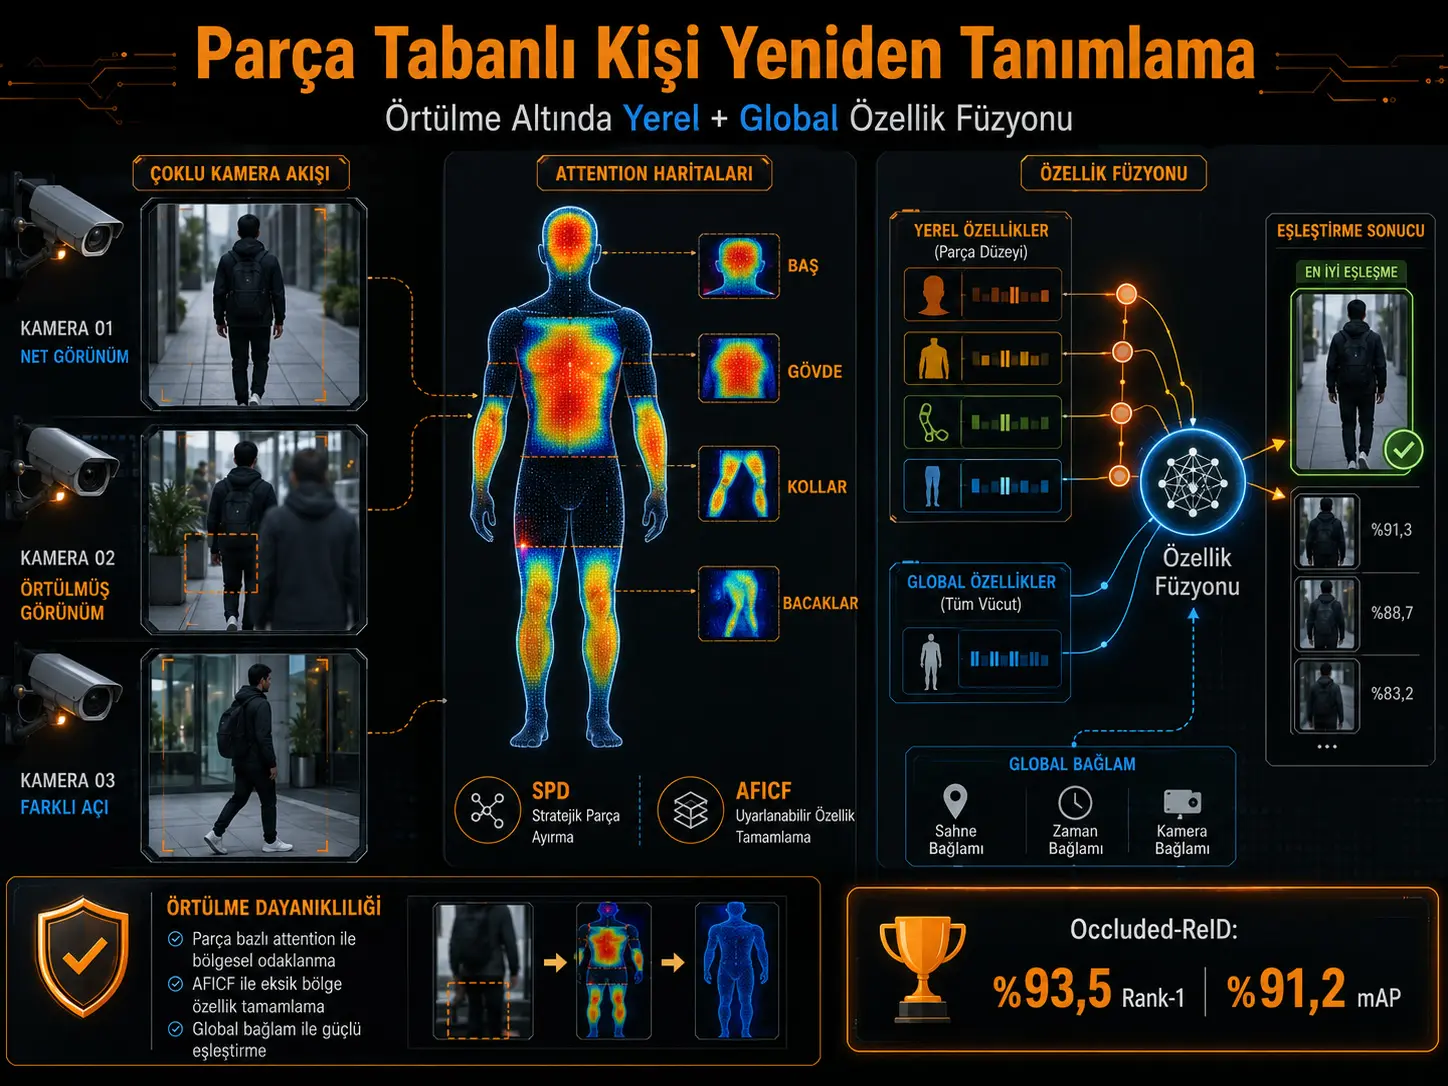
Ushbu tadqiqot turli kameralarda yoki turli vaqtlarda tasvirlangan ayni shaxsni qayta topishni maqsad qilgan Person Re-Identification (Person Re-ID; shaxsni qayta identifikatsiya qilish) muammosida, ayniqsa tananing bir qismi boshqa odamlar yoki obyektlar bilan yopilib qolgan tasvirlarga e’tibor qaratadi. Tadqiqotchilar faqat butun inson tasvirini ifodalovchi bitta global xususiyat vektoriga tayanish o‘rniga bosh, gavda, qo‘llar va oyoqlar kabi semantik tana hududlaridan keladigan lokal ma’lumotni global ko‘rinish ma’lumoti bilan birga ishlatadigan Dynamic Part-Based Fusion (DPBF) arxitekturasini taklif qiladilar. Tizim ikki asosiy komponentdan iborat: Salient Part Discrimination (SPD) human parsing va attention xaritalari yordamida identifikatsiyani farqlashda foydaliroq bo‘lgan tana hududlarini ajratib ko‘rsatadi; Adaptive Feature Integration and Contextual Fusion (AFICF) esa lokal va global xususiyatlar o‘rtasidagi korrelyatsiyani tahlil qilib, takroriy ma’lumotni kamaytiradi va bir-birini to‘ldiruvchi xususiyatlarni birlashtiradi.
Model Market-1501, DukeMTMC-ReID, CUHK03-Labeled, Occluded-Duke, Occluded-ReID va P-DukeMTMC-ReID nomli oltita standart Person Re-ID ma’lumotlar to‘plamida baholandi. Tadqiqotning eng diqqatga sazovor natijasi Occluded-ReID da olindi: DPBF %93,5 Rank-1 va %91,2 mAP ga erishdi. Manba jadvalidagi eng yaqin kuchli taqqoslash BPB Re-ID uchun mos ravishda %82,9 va %75,2 bo‘lgani sababli arifmetik farqlar 10,6 Rank-1 punkti va 16,0 mAP punktidir. P-DukeMTMC-ReID da DPBF %93,6 Rank-1 va %83,6 mAP bergan bo‘lsa, Occluded-Duke da %74,7 Rank-1 va %60,7 mAP bilan BPB Re-ID dan biroz past qolgan. Shu sababli model barcha ma’lumotlar to‘plamida bahssiz eng yaxshi usul deb aytib bo‘lmaydi; uning kuchli tomoni, ayniqsa ayrim kuchli occlusion ssenariylarida lokal va global xususiyatlardan birgalikda foydalana olishidir.
Tadqiqot yana muhim bir cheklovni miqdoriy ko‘rsatadi. Kuchli occlusion ostida ayrim alohida tana-qismi embeddinglari deyarli foydasiz holga kelishi mumkin. Uchta occlusion yo‘naltirilgan benchmarkda p7 deb atalgan eng zaif embeddingning Rank-1 qiymati taxminan %2–3 darajasigacha tushadi. Bunga qarshi butun va ko‘rinadigan hududlardan ma’lumot olib keluvchi p0 representation %69,5–92,6 Rank-1 oralig‘ida qoladi. Demak, DPBF muvaffaqiyati har bir tana qismini ishonchli tanishidan emas, balki ko‘rinadigan va bir-birini to‘ldiruvchi hududlardan kelgan ma’lumotni global kontekst bilan birlashtirib, bitta zaif qismga qaramlikni kamaytirishidan kelib chiqadi.
Person Re-ID aynan qaysi muammoni hal qiladi?
Person Re-ID tizimining vazifasi bir kameradagi shaxsni boshqa kamera tasviri yoki gallery to‘plami ichidan qayta topishdir. Model query tasviridan:
“Bu shaxs gallery dagi qaysi tasvir bilan ayni identifikatsiyaga tegishli?”
savoliga javob topishga harakat qiladi.
Muammo klassik tasvir klassifikatsiyasidan farq qiladi. Model faqat “inson bormi?” degan savolga javob bermaydi; ko‘plab o‘xshash ko‘rinishdagi odamlar orasidan ayni identifikatsiyani ajratishga harakat qiladi.
Bu vazifa ayniqsa quyidagi sharoitlarda qiyinlashadi:
- kamera burchagining o‘zgarishi,
- yoritishning o‘zgarishi,
- shaxsning turli pozalarda bo‘lishi,
- tasvir aniqligining pasayishi,
- o‘xshash kiyimdagi odamlarning mavjudligi,
- tananing bir qismi boshqa odam yoki obyektlar bilan yopilishi.
Oxirgi holat, ya’ni occlusion/yopilish, ushbu tadqiqotning asosiy motivatsiyasidir.
Nega faqat global xususiyatdan foydalanish yetarli bo‘lmasligi mumkin?
Bir CNN butun inson tasvirini bitta xususiyat vektoriga siqishi mumkin. Bu representation shaxsning umumiy kiyim rangi, tana ko‘rinishi va silueti kabi ma’lumotlarni olib yuradi. Biroq shaxsning muhim qismi yopilsa, global xususiyat vektori ko‘rinmaydigan yoki chalg‘ituvchi hududlarning ta’sirini ham o‘z ichiga oladi.
Masalan, insonning pastki gavdasi boshqa obyekt bilan to‘liq yopilsa, global representation identifikatsiyani ajratishda aslida ko‘rinib turgan yuqori gavda, sumka yoki kiyim teksturasi kabi hududlardan yetarli darajada kuchli foydalana olmasligi mumkin.
Qismga asoslangan Re-ID usullarining maqsadi bu muammoni hal qilish uchun inson tanasini kichikroq semantik hududlarga ajratishdir.
DPBF ning asosiy g‘oyasi nima?
Taklif qilingan tizim:
\[ \text{DPBF} = \text{SPD} + \text{AFICF} + \text{Hybrid Loss} \]
ko‘rinishida tasavvur qilinishi mumkin.
SPD qaysi tana hududlari identifikatsiya nuqtai nazaridan farqlovchi ma’lumot olib kelishini aniqlashga harakat qiladi.
AFICF turli tana qismlaridan keladigan xususiyatlar bilan butun inson tasviridan olingan global xususiyatni birlashtiradi.
Hybrid Loss Function esa ham identifikatsiya klassifikatsiyasini, ham ayni shaxsga tegishli embeddinglarni bir-biriga yaqinlashtirishni, turli shaxslarnikini esa uzoqlashtirishni maqsad qiladi.
Muhim ilmiy farq mavjud: tadqiqotchilar attention, human parsing, PCC, PCA yoki triplet loss ni yangi ixtiro qilganlarini da’vo qilmaydilar. Maqolaning hissasi bu tuzilmalarni occluded Person Re-ID uchun muvofiqlashtirilgan DPBF pipeline ichida birga ishlatish usulidir.
Salient Part Discrimination nima qiladi?
SPD vazifasi inson tasvirini faqat geometrik teng chiziqlarga bo‘lish emas, balki mazmunli tana hududlariga mos attention xaritalarini yaratishdir.
Modelning kirish xususiyat xaritasi:
\[ F \]
deb ko‘rsatiladi. Bu xususiyat xaritasi avval:
\[ 1\times1 \]
convolution qatlamidan o‘tkazilib:
\[ F' \]
olinadi.
So‘ng yengil CNN, global average pooling va fully connected qatlamdan foydalanib:
\[ K \]
ta attention weight ishlab chiqiladi.
Ular:
\[ A_1,A_2,\ldots,A_K \]
ko‘rinishida tana qismlariga tegishli spatial attention xaritalariga aylantiriladi.
Grad-CAM bu yerda qanday ishlatiladi?
Tadqiqot oldindan belgilangan har bir tana qismi uchun attention xaritasi yaratishda Grad-CAM asosidagi strategiyadan foydalanadi.
Maqsad, masalan:
- bosh,
- gavda,
- chap/o‘ng qo‘l,
- chap/o‘ng oyoq
kabi hududlarning feature map ustidagi identifikatsiya jihatidan mazmunli aktivatsiyalarini ajratishdir.
Maqolaning 6-betidagi 1-shaklda ayni shaxs tasviri turli semantik qismlarga ajratilib, har bo‘lim uchun yaratilgan attention heatmaplar ko‘rsatilgan. Ayrim xaritalarda yuqori gavda yoki oyoq hududlarining aniq ravishda yuqori aktivatsiya olgani ko‘rinadi.
SCHP nega tizimga qo‘shiladi?
Inson tanasini faqat qat’iy geometrik bo‘laklarga ajratish poza o‘zgarishlarida muammo tug‘dirishi mumkin. Inson yurganda yoki egilganda ayni koordinata hududi har bir tasvirda ayni anatomik tuzilishga mos kelmasligi mumkin.
Shu sababli tadqiqot Self-Correction for Human Parsing (SCHP) modelidan hosil qilingan human parsing label lardan foydalanadi.
Birinchi parsing label:
\[ Y_0=P(X) \]
ko‘rinishida ifodalanadi.
Keyin correction network:
\[ C = \arg\min_C L \left( C(Y_0),Y_{GT} \right) \]
bilan optimallashtiriladi va tuzatilgan label:
\[ Y_1=C(Y_0) \]
ko‘rinishida olinadi.
SPD bu parsing ma’lumotini attention mexanizmi bilan birlashtirib, anatomik jihatdan barqarorroq qism representationlar yaratishga harakat qiladi.
Human parsing xatosizmi?
Yo‘q. Manba tadqiqot buni alohida cheklov sifatida qabul qiladi.
Kuchli occlusion yoki noodatiy poza holatida:
- oyoq yo‘qolishi mumkin,
- qo‘l noto‘g‘ri hududga biriktirilishi mumkin,
- parsing mask to‘liq bo‘lmasligi mumkin,
- anatomik qismning faqat kichik bo‘lagi ko‘rinishi mumkin.
Shu sababli model attention mexanizmini parsing label larini yolg‘iz ishlatishga alternativ sifatida emas, ularni to‘ldiruvchi tuzilma sifatida qo‘llaydi.
Cross-Part Spatial Feature Modulation Map nima?
Attention xaritalari yaratilgach, ularni faqat vizualizatsiya qilish yetarli emas. Har bir attention map asl xususiyat xaritasiga qo‘llanadi.
Har bir tana qismi uchun:
\[ P_k=A_k\times F \]
element-wise multiplication amali ishlatiladi.
Shu tariqa:
\[ P_1,P_2,\ldots,P_K \]
ko‘rinishidagi qismga xos xususiyat xaritalari olinadi.
Keyin ular:
\[ P_{\mathrm{concat}} = \operatorname{Concat} (P_1,P_2,\ldots,P_K) \]
bilan birlashtiriladi.
Maqolaning 8-betidagi 2-shakl va 3-shakl bu amalni aniq ko‘rsatadi: feature map bir nechta attention map bilan ko‘paytiriladi va hosil bo‘lgan lokal feature representationlar umumiy qismga asoslangan representationga olib boriladi.
Nega lokal va global xususiyatlar qayta birlashtiriladi?
Faqat tana qismlariga tayanish ham muammo tug‘dirishi mumkin.
Masalan:
- oyoq butunlay yopilgan bo‘lsa, oyoq embeddingi ma’nosizlashishi mumkin,
- qo‘l juda kichik ko‘rinsa, xususiyat shovqinli bo‘lishi mumkin,
- noto‘g‘ri parsing bir qismni boshqa hududga ko‘chirishi mumkin.
Global xususiyat esa butun tasvir kontekstini saqlaydi.
DPBF shu sababli:
local body-part features + global contextual feature
birikmasidan foydalanadi.
AFICF nega oddiy concatenation ishlatmaydi?
Lokal va global feature vektorlarni bevosita yonma-yon qo‘shish o‘lchamni oshiradi. Muhimroq muammo esa bir xil ma’lumotni olib yuruvchi yuqori korrelyatsiyali xususiyatlarning tizimga bir necha marta kirishidir.
AFICF shu sababli avval xususiyatlar orasidagi Pearson korrelyatsiyasini hisoblaydi.
\[ r_{XY} = \frac{ \sum_{i=1}^{n} (X_i-\bar X)(Y_i-\bar Y) }{ \sqrt{ \sum_{i=1}^{n}(X_i-\bar X)^2 } \sqrt{ \sum_{i=1}^{n}(Y_i-\bar Y)^2 } } \]
\[ |r_{XY}|\approx1 \]
bo‘lsa, ikki xususiyat kuchli chiziqli bog‘lanishga ega va ehtimol takroriy ma’lumot olib yuradi deb qabul qilinadi.
AFICF yuqori korrelyatsiyali feature guruhlardan takroriy komponentlarni kamaytirishni maqsad qiladi.
PCA nega qo‘llanadi?
Pearson korrelyatsiyasidan keyin qolgan feature fazosida ham o‘lchoviy takroriylik bo‘lishi mumkin. Shu sababli Principal Component Analysis qo‘llanadi.
Xususiyatlar o‘rtasidagi covariance:
\[ \operatorname{Cov}(X_j,X_k) = \frac{1}{n-1} \sum_{i=1}^{n} (X_{ij}-\bar X_j) (X_{ik}-\bar X_k) \]
bilan hisoblanadi.
Eng yuqori eigenvalue larga mos principal component lar saqlanib, yakuniy representation:
\[ 512 \]
o‘lchamli ixcham embeddingga tushiriladi.
DPBF ning training loss i qanday ishlaydi?
Model ikki xil maqsadni birga optimallashtiradi.
Birinchi komponent cross-entropy loss:
\[ L_{\mathrm{CE}} = -\sum_{i=1}^{N} Y_i\log\hat Y_i. \]
Bu term modelga global identifikatsiya ajratishini o‘rganishga yordam beradi.
Ikkinchi komponent triplet loss:
\[ L_{\mathrm{triplet}} = \max \left( 0, D_{\mathrm{pos}} - D_{\mathrm{neg}} + m \right). \]
Bu yerda:
- \(D_{\mathrm{pos}}\): ayni shaxsga tegishli ikki embedding orasidagi masofa,
- \(D_{\mathrm{neg}}\): turli shaxslarga tegishli embedding orasidagi masofa,
- \(m\): margin.
Tadqiqotda margin:
\[ m=0{,}3 \]
deb tanlangan.
Yakuniy Hybrid Loss:
\[ L_{\mathrm{Hybrid}} = \alpha L_{\mathrm{CE}} + \beta L_{\mathrm{TL}} \]
ko‘rinishida.
Ikki asosiy loss komponent teng vaznlangan.
Model qanday o‘qitildi?
Tadqiqotda ikki backbone ishlatilgan:
- ResNet-50,
- HRNet-w32.
ResNet-50 uchun kirish tasviri:
\[ 256\times128 \]
piksel; HRNet-w32 uchun:
\[ 384\times128 \]
piksel ishlatilgan.
Model Adam optimizer bilan o‘qitilgan; boshlang‘ich learning rate:
\[ 3{,}5\times10^{-4} \]
deb berilgan.
Warm-up boshlang‘ich learning rate:
\[ 3{,}5\times10^{-5} \]
va weight decay:
\[ 0{,}0005 \]
deb belgilangan.
Learning rate 40- va 70-epochda kamaytirilgan; jami training:
\[ 150\ \text{epoch} \]
davom etgan.
Har bir identifikatsiya uchun batch ichida to‘rtta sample ishlatilgan va effective batch size ma’lumotlar to‘plami hamda GPU sharoitiga qarab 16–64 oralig‘ida o‘zgargan.
Qaysi ma’lumotlar to‘plamlari ishlatilgan?
Tadqiqot ikki xil benchmark guruhini ajratadi.
Butun / standart Person Re-ID ma’lumotlar to‘plamlari:
- Market-1501,
- DukeMTMC-ReID,
- CUHK03-Labeled.
Occlusion yo‘naltirilgan ma’lumotlar to‘plamlari:
- Occluded-Duke,
- Occluded-ReID,
- P-DukeMTMC-ReID.
Rank-1 Accuracy nimani anglatadi?
Query tasviri uchun tizim gallery dagi shaxslarni o‘xshashligiga ko‘ra tartiblaydi.
To‘g‘ri identifikatsiya ro‘yxatning birinchi o‘rnida chiqishi Rank-1 muvaffaqiyatidir.
Masalan:
\[ R1=93{,}5\% \]
natijasi, foydalanilgan benchmark protokoli ostida query larning taxminan %93,5 ida to‘g‘ri identifikatsiya birinchi o‘rinda bo‘lganini anglatadi.
mAP nimani o‘lchaydi?
Mean Average Precision faqat birinchi o‘rinni emas, ayni identifikatsiyaga tegishli barcha to‘g‘ri mosliklarning ranking ro‘yxatidagi tarqalishini hisobga oladi.
Shu sababli:
- Rank-1 birinchi natijaga,
- mAP butun retrieval ro‘yxati sifatiga
ko‘proq sezgir.
Butun benchmarklarda natijalar qanday?
| Ma’lumotlar to‘plami | DPBF Rank-1 (%) | DPBF mAP (%) | Manba jadvalidagi o‘rni |
|---|---|---|---|
| Market-1501 | 96,0 | 89,3 | Rank-1 bo‘yicha eng yuqori; mAP bo‘yicha AaP-ReID dan past |
| DukeMTMC-ReID | 92,0 | 82,8 | Rank-1 bo‘yicha eng yuqori; mAP bo‘yicha AaP-ReID dan past |
| CUHK03-Labeled | 89,5 | 82,6 | Har ikki metrik bo‘yicha jadvaldagi eng yuqori qiymat |
Bu jadval muhim farqni ko‘rsatadi. DPBF barcha benchmark va barcha metriklarda eng yuqori qiymatni bermagan. Market-1501 da AaP-ReID mAP %93,9 bo‘lsa, DPBF %89,3; DukeMTMC-ReID da AaP-ReID %88,6 mAP bo‘lsa, DPBF %82,8.
Shu sababli modelning kuchli ishlashi “barcha mavjud usullardan hamma joyda yaxshiroq” tarzida umumlashtirilmasligi kerak.
CUHK03-Labeled natijasi
DPBF:
\[ R1=89{,}5\%,\qquad mAP=82{,}6\% \]
qiymatlarini beradi.
R-1 bo‘yicha jadvaldagi keyingi eng yuqori qiymat %84,7 bo‘lgani uchun farq:
\[ 89{,}5-84{,}7 = 4{,}8 \]
punkt.
mAP bo‘yicha esa AaP-ReID %82,4 bilan DPBF ga eng yaqin qiymatdir. Shuning uchun arifmetik farq:
\[ 82{,}6-82{,}4 = 0{,}2 \]
punkt.
Manba matnidagi 1,6 punktlik mAP farqi eng yaqin qiymat bilan emas, SCSN ning %81,0 mAP qiymati bilan solishtirganda olinadi.
Occlusion yo‘naltirilgan ma’lumotlar to‘plamlaridagi natijalar
| Ma’lumotlar to‘plami | DPBF Rank-1 (%) | DPBF mAP (%) | Manba jadvalidagi eng yaqin kuchli taqqoslash |
|---|---|---|---|
| Occluded-Duke | 74,7 | 60,7 | BPB Re-ID: 75,1 / 62,5 |
| Occluded-ReID | 93,5 | 91,2 | BPB Re-ID: 82,9 / 75,2 |
| P-DukeMTMC-ReID | 93,6 | 83,6 | BPB Re-ID: 93,0 / 83,2 |
Modelning eng aniq ustunligi Occluded-ReID da ko‘rinadi.
Rank-1 farqi:
\[ 93{,}5-82{,}9 = 10{,}6 \]
punkt;
mAP farqi:
\[ 91{,}2-75{,}2 = 16{,}0 \]
punkt.
Manba bu farqlarni foizli yaxshilanish deb ifodalaydi; biroq jadval qiymatlarini bevosita ayirish bular foiz punkti farqi ekanini ko‘rsatadi.
Occluded-Duke nega muhim qarshi misol?
Occluded-Duke da DPBF:
\[ 74{,}7/60{,}7 \]
natija berganda BPB Re-ID:
\[ 75{,}1/62{,}5 \]
beradi.
Shu sababli taklif etilgan arxitektura occlusion mavjud bo‘lgan barcha ma’lumotlar to‘plamlarida eng yaxshi natija beradi, deb bo‘lmaydi.
Qismlar soni oshganda unumdorlik qanday o‘zgaradi?
Market-1501 ablation tadqiqotida uch xil tana-qismi aniqligi sinovdan o‘tkazilgan:
- 3 qism,
- 5 qism,
- 8 qism.
Har uch supervision strategiyasida ham qismlar sonini 3 tadan 8 tagacha oshirish yuqoriroq unumdorlik bilan bog‘liq.
Sakkiz qismli konfiguratsiyada manbada “semi-supervised” deb atalgan Parsing + PAM tizimi:
\[ R1=96{,}0\%,\qquad mAP=89{,}3\% \]
natijasiga erishgan.
Ayni sakkiz qismda faqat supervised parsing:
\[ 92{,}6/85{,}3 \]
va faqat PAM asosidagi unsupervised tizim:
\[ 86{,}7/77{,}8 \]
natijani bergan.
Bu tajriba parsing ma’lumotini attention mexanizmi bilan birga ishlatish ushbu benchmark va konfiguratsiyada faqat PAM yoki faqat parsing yondashuvidan kuchliroq ekanini qo‘llab-quvvatlaydi.
DPBF va PCB ning qismlar soni bo‘yicha taqqoslanishi
DukeMTMC-ReID da manba quyidagi natijalarni bildiradi:
| Qismlar soni | DPBF R-1 (%) | DPBF mAP (%) | PCB R-1 (%) | PCB mAP (%) |
|---|---|---|---|---|
| 3 | 87,4 | 80,2 | 76,4 | 58,3 |
| 5 | 90,5 | 82,7 | 82,4 | 67,5 |
| 6 | 91,0 | 83,8 | 82,6 | 68,8 |
Manba bu natijalarni DPBF ning parsing-guided attention va correlation-aware integration komponentlarining birgalikdagi hissasi bilan izohlaydi. Biroq jadval SPD va AFICF komponentlarining alohida-alohida to‘liq izolyatsiya qilingan sababiy hissasini o‘lchamaydi.
Xususiyat integratsiyasi tajribasida nima ko‘rinadi?
Occluded-ReID dagi xususiyat integratsiyasi tahlilida global pooled feature, body-part features, Pearson correlation refinement va PCA komponentlari turli kombinatsiyalarda olib tashlangan.
To‘liq HLF konfiguratsiyasida manba:
\[ mAP=73{,}7,\qquad R1=86{,}5 \]
deb bildiradi.
Ko‘proq feature-integration komponentlari olib tashlangan sari unumdorlik:
\[ 68{,}7 \rightarrow 62{,}9 \rightarrow 57{,}5 \rightarrow 55{,}2 \]
mAP darajalarigacha tushadi.
Bu tajriba lokal + global xususiyatlar va correlation/PCA refinement ni birgalikda ishlatishni qo‘llab-quvvatlaydi.
Biroq ushbu jadvaldagi yakuniy HLF natijasi bilan maqolaning asosiy Occluded-ReID taqqoslash jadvalidagi:
\[ 93{,}5\ R1,\qquad91{,}2\ mAP \]
qiymati o‘rtasida katta farq bor. Manba bu ikki baholash konfiguratsiyasi nima sababdan shunchalik farqli natija berganini aniq protokol bilan bog‘lamaganligi uchun bu qiymatlar ayni tajriba natijasi sifatida birlashtirilmasligi kerak.
Kuchli occlusion qaysi tana hududlariga eng ko‘p ta’sir qiladi?
Tadqiqotning attention heatmaplari va qismga asoslangan testlari ayniqsa pastki tana hududlari ko‘proq zaif ekanini ko‘rsatadi.
Manbada p0 eng kuchli, p7 esa eng zaif embedding deb qayd etilgan.
| Ma’lumotlar to‘plami | Eng kuchli embedding | Eng zaif embedding | Rank-1 farqi | mAP farqi |
|---|---|---|---|---|
| Occluded-ReID | p0: 91,5 / 84,8 | p7: 2,5 / 6,9 | 89,0 | 77,9 |
| Occluded-Duke | p0: 69,5 / 56,8 | p7: 2,9 / 1,4 | 66,6 | 55,4 |
| P-DukeMTMC-ReID | p0: 92,6 / 81,8 | p7: 2,4 / 1,5 | 90,2 | 80,3 |
Bu natija DPBF ning muhim cheklovini ochiq ko‘rsatadi: ko‘rinmaydigan yoki deyarli to‘liq yopilgan tana qismidan ishonchli identifikatsiya ma’lumotini olish hanuz nihoyatda qiyin.
Modelning ustunligi bu zaif qismni “yaxshilash”dan ko‘ra, boshqa ko‘rinadigan hududlar va global kontekst hisobiga umumiy identifikatsiya representationini saqlab turishga harakat qilishidir.
5-shakldagi manba ichki nomuvofiqlik
Maqolaning 5-shakl izohida:
- (b) panel Occluded-ReID,
- (c) panel P-DukeMTMC-ReID
deb ta’riflangan.
Biroq chop etilgan tasvirdagi grafik sarlavhalarida yuqori grafik:
p_dukemtmc_reid
va pastki grafik:
Market-1501
deb belgilangan.
Shu sababli grafik panel nomlari bilan figure caption to‘liq mos emas. Manba qaysi birini nazarda tutganini taxmin qilib jim tuzatish o‘rniga ushbu noaniqlik saqlanishi kerak.
Hisoblash xarajati qanday?
Manbada uch usulning batch processing va xotira qiymatlari quyidagicha:
| Model | Processing Time (s/batch) | Memory Usage (MB) |
|---|---|---|
| PCB + RPP | 129,8272 | 20.250 |
| BPB Re-ID | 122,7825 | 19.018 |
| DPBF | 126,2159 | 21.250 |
DPBF eng kam xotira sarflaydigan yoki eng tez usul emas. BPB Re-ID pastroq processing time va xotira sarfini ko‘rsatadi. DPBF maqsadi hisoblash bo‘yicha mutlaq minimum emas, balki occlusion chidamliligi va hisoblash xarajati o‘rtasida raqobatbardosh muvozanat qurishdir.
Model nechta parametrdan foydalanadi?
Manbada ma’lumotlar to‘plamiga bog‘liq konfiguratsiyalar uchun taxminan:
\[ 39{,}5-41{,}3\ \text{milyon} \]
parametr qayd etilgan.
FLOP qiymati taxminan:
\[ 8{,}0\times10^9 \]
darajasida.
RTX 4090 va TITAN Xp takrorlarida natijalar izchilmi?
Market-1501 da TITAN Xp ishlashi:
\[ 96{,}08\ R1,\quad89{,}32\ mAP \]
va RTX 4090 ishlashi:
\[ 95{,}67\ R1,\quad89{,}49\ mAP \]
bergan.
DukeMTMC-ReID da:
\[ 91{,}88/82{,}87 \]
va:
\[ 92{,}06/82{,}87 \]
natijalari berilgan.
P-DukeMTMC-ReID da farq biroz kattaroq:
\[ 92{,}09/82{,}13 \]
bilan:
\[ 93{,}62/83{,}67. \]
Mualliflar bu taqqoslashni turli hardware sharoitlarida unumdorlik umuman olganda barqaror qolganining dalili sifatida taqdim etadilar.
Biroq “reproducibility” bu yerda mustaqil boshqa tadqiqot guruhining replikatsiyasi degani emas; ayni tadqiqot ichida turli hardwarelarda qilingan qo‘shimcha training/evaluation ishlaridir.
RTX 4090 baholash vaqtini qancha kamaytiradi?
Market-1501 evaluation batch time:
\[ 0{,}444\ \text{s} \rightarrow 0{,}126\ \text{s} \]
DukeMTMC-ReID:
\[ 0{,}454 \rightarrow 0{,}130\ \text{s} \]
va P-DukeMTMC-ReID:
\[ 0{,}410 \rightarrow 0{,}128\ \text{s} \]
deb berilgan.
Bu farq model algoritmidagi o‘zgarishdan emas, ishlatilgan GPU arxitekturalarining hisoblash quvvatidan kelib chiqadi.
Turkiya nuqtai nazaridan tadqiqot nimani anglatadi?
Tadqiqotda Turkiyadan yig‘ilgan kamera ma’lumotlari yoki Turkiyaga xos Person Re-ID benchmark yo‘q. Shuning uchun xabar qilingan:
\[ 93{,}5\%, \quad 91{,}2\% \]
kabi natijalarni Turkiyadagi aeroport, zavod, kampus yoki xavfsizlik kameralarida kutiladigan muvaffaqiyat darajasi sifatida ishlatib bo‘lmaydi.
Turkiyada qo‘llanadigan tizim uchun kamera rezolyutsiyasi, kamera balandligi, olomon zichligi, kiyim o‘xshashligi, tasvir siqilishi, tun/kun sharoiti va occlusion tuzilishi kabi omillar bilan alohida mahalliy baholash talab qilinadi.
Tadqiqot qo‘llab-quvvatlaydigan natijalar
- SPD va AFICF muvofiqlashtirilgan holda ishlatiladigan DPBF oltita Person Re-ID benchmarkda raqobatbardosh natijalar bergan.
- Occluded-ReID da manba jadvalidagi eng yaqin taqqoslashga nisbatan 10,6 Rank-1 punkti va 16,0 mAP punkti yuqori natija xabar qilingan.
- P-DukeMTMC-ReID da DPBF manba jadvalidagi eng yuqori Rank-1 va mAP qiymatini bergan.
- Market-1501 va DukeMTMC-ReID da DPBF Rank-1 bo‘yicha jadvaldagi eng yuqori natijani beradi, ammo mAP bo‘yicha eng yaxshi usul emas.
- Occluded-Duke da DPBF manba jadvalidagi BPB Re-ID natijasidan past qolgan.
- Market-1501 ablationida 8 qismli Parsing + PAM konfiguratsiyasi 3 va 5 qismli alternativlardan yuqori unumdorlik ko‘rsatgan.
- Kuchli occlusion pastki tana embeddinglarida juda katta unumdorlik yo‘qotishiga olib kelgan.
- Turli GPU muhitlaridagi qo‘shimcha traininglar umuman olganda o‘xshash R-1 va mAP natijalarini bergan.
Tadqiqot isbotlamaydigan narsalar
- DPBF barcha Person Re-ID ma’lumotlar to‘plamida mavjud barcha usullardan ustun ekani isbotlanmagan.
- Benchmark natijalari real shahar miqyosidagi kamera tarmog‘ida dala muvaffaqiyati sifatida tasdiqlanmagan.
- Qismga asoslangan attention kuchli occlusion ta’sirini butunlay yo‘q qilmaydi.
- Har bir tana qismi ishonchli identifikatsiya ma’lumotini olib yurishi ko‘rsatilmagan; p7 natijalari buning aksini ko‘rsatadi.
- Baselinelar ayni kod, backbone, input resolution va training pipeline bilan to‘liq qayta ishlatilmagan.
- Manba jadvallaridagi unumdorlik farqlari uchun confidence interval yoki formal significance test berilmagan.
- DPBF computationally eng yengil yoki eng tez Re-ID model ekani ko‘rsatilmagan.
- Hardwarelar orasidagi takrorlar mustaqil uchinchi tomon replikatsiyasi emas.
Tadqiqotning Usuli va Natijalari
DPBF processing pipeline
Maqoladagi Algorithm 1 ga ko‘ra training quyidagi tartibda amalga oshiriladi:
- Kirish tasviridan CNN backbone feature maplar olinadi.
- SPD orqali parsing-guided body-part representations yaratiladi.
- Lokal body-part embeddinglar va global contextual embedding olinadi.
- AFICF orqali lokal va global xususiyatlarning munosabati tartibga solinadi.
- Pearson korrelyatsiya tahlili bilan takroriy feature komponentlari kamaytiriladi.
- PCA bilan ixcham discriminative embedding yaratiladi.
- Lokal va global representationlar birlashtiriladi.
- Model Hybrid Loss bilan optimallashtiriladi.
Inference bosqichida esa:
- query va gallery tasvirlardan normallashtirilgan embeddinglar olinadi,
- embedding juftlari orasida Euclidean distance hisoblanadi,
- gallery tasvirlari masofaga ko‘ra kichikdan kattaga tartiblanadi,
- identifikatsiya mosligi retrieval ro‘yxati sifatida qaytariladi.
Arxitektura oqimining qisqa matematik xulosasi
Bir tasvir:
\[ X \]
backbone ga kirganda:
\[ X \rightarrow F \]
xususiyat xaritasi hosil bo‘ladi.
SPD:
\[ F \rightarrow \{A_1,\ldots,A_K\} \]
attention xaritalarni yaratadi.
Keyin:
\[ P_k=A_k\odot F \]
bilan har bir body-part representation hosil qilinadi.
Ular:
\[ P_{\mathrm{concat}} = [P_1;\ldots;P_K] \]
ko‘rinishida birlashtiriladi.
AFICF:
\[ (P_{\mathrm{concat}},G) \rightarrow \text{PCC refinement} \rightarrow \text{PCA} \rightarrow E \]
jarayoni bilan final embeddingni hosil qiladi.
Inference vaqtida ikki embedding orasidagi Euclidean masofa kamaygan sari tizim tasvirlar ayni identifikatsiyaga tegishli bo‘lish ehtimolini rankingda yuqoriroq qabul qiladi.
Market-1501 asosiy natijasi
Yakuniy DPBF:
\[ 96{,}0\% \ R1 \]
va:
\[ 89{,}3\% \ mAP \]
bergan.
Rank-1 manba jadvalidagi eng yuqori qiymat bo‘lsa, mAP bo‘yicha AaP-ReID %93,9 bilan yuqoriroq.
DukeMTMC-ReID asosiy natijasi
DPBF:
\[ 92{,}0\% \ R1 \]
va:
\[ 82{,}8\% \ mAP \]
bergan.
Rank-1 manba jadvalidagi eng yuqori natijadir. mAP bo‘yicha AaP-ReID %88,6 bilan yuqoriroq qiymatga ega.
CUHK03-Labeled asosiy natijasi
DPBF:
\[ 89{,}5\% \ R1 \]
va:
\[ 82{,}6\% \ mAP \]
bilan manba jadvalidagi eng yuqori ikki metrikani hosil qilgan.
Occluded-ReID asosiy natijasi
DPBF ning eng kuchli benchmark natijasi shu yerda ko‘rinadi:
\[ 93{,}5\% \ R1, \qquad 91{,}2\% \ mAP. \]
Manba jadvalidagi keyingi yuqori R-1 BPB Re-ID ning:
\[ 82{,}9\% \]
qiymatidir.
mAP uchun ayni model:
\[ 75{,}2\% \]
beradi.
P-DukeMTMC-ReID natijasi
DPBF:
\[ 93{,}6\% \ R1, \qquad 83{,}6\% \ mAP \]
natijasiga erishgan.
BPB Re-ID:
\[ 93{,}0/83{,}2 \]
bo‘lgani uchun farqlar mos ravishda 0,6 va 0,4 punkt.
Occluded-Duke natijasi
DPBF:
\[ 74{,}7/60{,}7 \]
bergan.
BPB Re-ID esa:
\[ 75{,}1/62{,}5 \]
bilan har ikki metrikda biroz yuqori natijaga erishgan.
Occlusion tahlili nimani ko‘rsatadi?
Tadqiqotning 6-shakldagi heatmaplarida yashil chegaralar muvaffaqiyatliroq feature localization misollarini, qizil chegaralar esa zaif yoki noto‘g‘ri representationlarni ko‘rsatadi.
Yengil occlusionda yuqori gavda va ko‘rinadigan kiyim hududlaridagi attention aktivatsiyasi saqlanishi mumkin, kuchli occlusionda esa ayniqsa:
- oyoq panjasi,
- pastki oyoq,
- butunlay ko‘rinmaydigan tana a’zolari
juda zaif feature hosil qiladi.
8-jadval bu vizual kuzatuvni miqdoriy tasdiqlaydi.
DPBF kuchli occlusionni qanday yumshatadi?
Manba natijalariga ko‘ra yechim yopilgan qismdan ma’lumotni “qayta yaratish” emas.
Buning o‘rniga:
- ko‘rinadigan tana hududlari alohida representation qilinadi,
- kuchli lokal xususiyatlar global ko‘rinish ma’lumoti bilan birlashtiriladi,
- takroriy xususiyatlar PCC/PCA bilan kamaytiriladi,
- bitta lokal qismga qaramlik kamaytiriladi.
Shu sababli DPBF ning asosiy ustunligi adaptive local–global compensation tarzida talqin qilinishi mumkin.
Modelning amaliy cheklovlari
Mualliflar xulosa bo‘limida ta’kidlagan kelajakdagi tadqiqot yo‘nalishlari:
- kuchli occlusionda barqarorroq parsing,
- adaptive part weighting,
- occlusion-aware feature reconstruction,
- past rezolyutsiyada kuchliroq representation,
- bir-biriga juda o‘xshash odamlarni farqlash,
- transformer asosidagi global–local interaction.
Bu kelajakdagi ish takliflari mavjud DPBF ushbu muammolarni to‘liq hal qilmaganini ham ko‘rsatadi.
Taqqoslashlarning metodologik chegarasi
Tadqiqot baseline modellarning katta qismi ballarini ularning original maqolalaridan olgan. Shu sababli modellar o‘rtasida:
- backbone,
- kirish rezolyutsiyasi,
- augmentation,
- optimizer sozlamalari,
- yordamchi training texnikalari
to‘liq bir xil emas.
Mualliflar faqat standart benchmark protokollari ostida xabar qilingan natijalarni tanlab, taqqoslashdagi tarafkashlikni kamaytirishga harakat qilgan.
Shuning uchun jadvallar sohaning chop etilgan unumdorlik darajalariga nisbatan taqqoslash beradi; ammo bitta laboratoriyada to‘liq teng sharoitlarda o‘tkazilgan yagona benchmark emas.
Statistik ahamiyat chegarasi
Maqola Rank-1 va mAP farqlarini beradi, ammo turli modellar orasidagi benchmark farqlari uchun:
- confidence interval,
- bootstrap uncertainty,
- paired significance test
taqdim etmaydi.
Shu sababli, masalan, Occluded-ReID dagi 10,6 va 16,0 punktlik farqlar katta sonli farqlardir; biroq “statistik jihatdan ahamiyatli ustunlik” ifodasi formal hypothesis test bilan qo‘llab-quvvatlanmagan.
Manba va Usul Qaydi
To‘liq original ish nomi: Strategic Feature Integration for Superior Person Re-ID: A Part-Based Approach
Mualliflar: Ghaith Hussein; Jeremy S. Smith; Waleed Al-Nuaimy.
Teng birinchi/teng hissa: Manbada teng birinchi muallif yoki teng hissa bayonoti yo‘q.
Mas’ul muallif: Ghaith Hussein.
Muassasa: Department of Electrical Engineering and Electronics, University of Liverpool, Brownlow Hill, Liverpool L69 3GJ, United Kingdom.
Manba turi: Hakemli original tadqiqot maqolasi; computer vision va deep-learning asosidagi Person Re-Identification tadqiqoti.
Jurnal: AI.
Nashriyot: MDPI, Basel, Switzerland.
Bibliografik qayd: AI, 2026, Jild 7, Son 6, Maqola 210.
DOI: 10.3390/ai7060210.
Qabul qilish / reviziya / qabul / nashr: 30 mart 2026 / 1 iyun 2026 / 2 iyun 2026 / 9 iyun 2026.
Hakemlik holati: Hakemli jurnal nashri.
Litsenziya: Creative Commons Attribution (CC BY).
Academic Editor: Miguel Angel Cazorla.
Manbada berilgan kalit so‘zlar: Salient Part Discrimination; Adaptive Feature Integration and Contextual Fusion; Person Re-ID; attention mechanism; feature fusion.
Taklif qilingan model: Dynamic Part-Based Fusion (DPBF).
Asosiy model komponenti 1: Salient Part Discrimination (SPD).
Asosiy model komponenti 2: Adaptive Feature Integration and Contextual Fusion (AFICF).
Parsing modeli: Self-Correction for Human Parsing (SCHP).
Attention yondashuvi: Grad-CAM asosidagi qismga xos attention xaritalari va Cross-Part Spatial Feature Modulation Map.
Feature redundancy tahlili: Pearson Correlation Coefficient.
O‘lchamni kamaytirish: Principal Component Analysis; yakuniy ixcham representation 512 o‘lcham.
Loss: Cross-entropy + triplet loss dan tashkil topgan Hybrid Loss Function. Triplet margin 0,3; ikki asosiy loss teng vaznli.
Qo‘shimcha qism-supervision loss: Pixel-level cross-entropy weight 0,35.
Backbone lar: ResNet-50 va HRNet-w32.
ResNet-50 kirish o‘lchami: 256 × 128 piksel.
HRNet-w32 kirish o‘lchami: 384 × 128 piksel.
Optimizer: Adam.
Asosiy learning rate: \(3,5\times10^{-4}\).
Warm-up learning rate: \(3,5\times10^{-5}\).
Weight decay: 0,0005.
Training: 150 epoch; learning rate 40- va 70-epochda kamaytirilgan.
Sampling: RandomIdentitySampler; har bir identifikatsiya uchun to‘rtta instance.
Batch size: Tajriba konfiguratsiyasiga qarab 16–64.
Data augmentation: Random cropping, normalization va random erasing.
Benchmark ma’lumotlar to‘plamlari: Market-1501, DukeMTMC-ReID, CUHK03-Labeled, Occluded-Duke, Occluded-ReID va P-DukeMTMC-ReID.
Asosiy baholash metrikalari: Rank-1 Accuracy va mean Average Precision (mAP).
Occluded-ReID yakuniy natijasi: %93,5 Rank-1 va %91,2 mAP.
P-DukeMTMC-ReID yakuniy natijasi: %93,6 Rank-1 va %83,6 mAP.
Occluded-Duke yakuniy natijasi: %74,7 Rank-1 va %60,7 mAP.
Market-1501 yakuniy natijasi: %96,0 Rank-1 va %89,3 mAP.
DukeMTMC-ReID yakuniy natijasi: %92,0 Rank-1 va %82,8 mAP.
CUHK03-Labeled yakuniy natijasi: %89,5 Rank-1 va %82,6 mAP.
Model murakkabligi: Ishlatilgan konfiguratsiyaga qarab taxminan 39,5–41,3 million parametr va taxminan 8,0 milliard FLOP qayd etilgan.
Asosiy training GPU: NVIDIA GeForce RTX 4090, 24 GB.
Qo‘shimcha tajriba hardware: 2 × NVIDIA GeForce TITAN Xp.
Re-ranking: Manbaga ko‘ra boshqacha aytilmagan bo‘lsa, taqqoslash natijalarida re-ranking ishlatilmagan.
Moliyalashtirish: Tadqiqot tashqi moliyalashtirish olmagan.
Etik komissiya: Yangi inson ishtirokchisi yoki yangi data yig‘ilmagani va faqat ochiq benchmark ma’lumotlar to‘plamlari ishlatilgani uchun etik baholash/approval waived deb berilgan.
Axborotli rozilik: Tadqiqotchilar yangi inson data yig‘magani sabab waived deb berilgan; ishlatilgan tasvirlar original benchmark provayderlari ilgari e’lon qilgan ma’lumotlar to‘plamlaridan kelgan.
Data mavjudligi: Ishlatilgan oltita benchmark ochiq ekani aytilgan va data manbalari maqolada ko‘rsatilgan.
Muallif hissalari: Konseptualizatsiya G.H.; metodologiya va dasturiy ta’minot G.H.; validatsiya G.H. va J.S.S.; formal tahlil G.H.; tadqiqot G.H. va J.S.S.; birinchi draft G.H.; review/editing J.S.S. va W.A.-N.; supervision W.A.-N.
Manfaatlar to‘qnashuvi: Mualliflar manfaatlar to‘qnashuvi bildirmagan.
Manba ichki nomuvofiqlik va hisobot qaydlari
Occluded-ReID bo‘yicha final benchmark 2-jadvalda DPBF uchun %93,5 R-1 va %91,2 mAP berilgan bo‘lsa, ayni ma’lumotlar to‘plamidagi feature-integration analysis 3-jadval HLF satrida %86,5 R-1 va %73,7 mAP berilgan. Maqola bu farqni aniq backbone/protokol izohi bilan bog‘lamaydi. Shu sababli ikki qiymat to‘plami alohida tajriba kontekstlari sifatida saqlangan.
Manba matnidagi Occluded-ReID taqqoslanishi “%10,6 R-1 oshishi va %16 mAP yaxshilanishi” deb ifodalangan. Jadval qiymatlaridan hisoblangan farqlar 10,6 va 16,0 foiz punktidir. Ushbu Verianla matni nisbiy foiz yaxshilanishi ma’nosini bermaslik uchun “punkt farqi” iborasidan foydalangan.
CUHK03-Labeled uchun manba bayoni eng yaqin raqibga nisbatan 4,8 R-1 va 1,6 mAP ustunligini da’vo qiladi. 1-jadval R-1 uchun 4,8 punktni tasdiqlaydi, lekin DPBF ning %82,6 mAP qiymatiga eng yaqin qiymat AaP-ReID ning %82,4 natijasi bo‘lib, farq 0,2 punktdir. 1,6 punkt farq SCSN ning %81,0 qiymati bilan taqqoslanganda olinadi.
5-shakl izohida (b) Occluded-ReID va (c) P-DukeMTMC-ReID deb yozilgan bo‘lsa, chop etilgan shakl grafik sarlavhalarida `p_dukemtmc_reid` va `Market-1501` yozuvlari ko‘rinadi. Ushbu figure-caption nomuvofiqligida qaysi label mualliflarning ko‘zlagan yakuniy versiyasi ekanini manba aniqlashtirmaydi.
Taqqoslash natijalarini talqin qilish chegarasi
Maqolaning baseline natijalari asosan tegishli usullarning original nashrlaridan olingan. Manba buni aniq aytadi va backbone, input resolution, data augmentation, optimization va auxiliary training texnikalari farq qilishi mumkinligini tan oladi.
Shu sababli taqqoslash jadvallari:
“standart benchmark adabiyotida xabar qilingan natijalarga nisbatan empirik pozitsiyalash”
sifatida o‘qilishi kerak.
Barcha usullar ayni codebase, ayni seed, ayni backbone va ayni GPU da qayta ishlatilgan nazoratli benchmark sifatida talqin qilinmasligi kerak.
Ilmiy talqin chegarasi
DPBF ayniqsa Occluded-ReID va P-DukeMTMC-ReID da kuchli natijalar ko‘rsatadi; lekin Occluded-Duke da manba jadvalidagi eng yaxshi tizim emas va butun benchmarklarda ham har bir mAP metrikasida yetakchi emas.
Tadqiqotning kuchli occlusion tahlili pastki tana yoki butunlay ko‘rinmaydigan hududlarda feature reliability juda keskin pasayishi mumkinligini aniq ko‘rsatadi. Demak, tizim “occlusiondan ta’sirlanmaydigan shaxsni tanish” yechimi emas.
Shuningdek, ishlatilgan metrikalar akademik retrieval benchmarklariga tegishli. Natijalar real kamera tarmog‘ida identifikatsiyani tasdiqlash kafolati, xavfsizlik kafolati yoki dala ilovasida ayni aniqlik darajasi olinadi degani emas.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan