

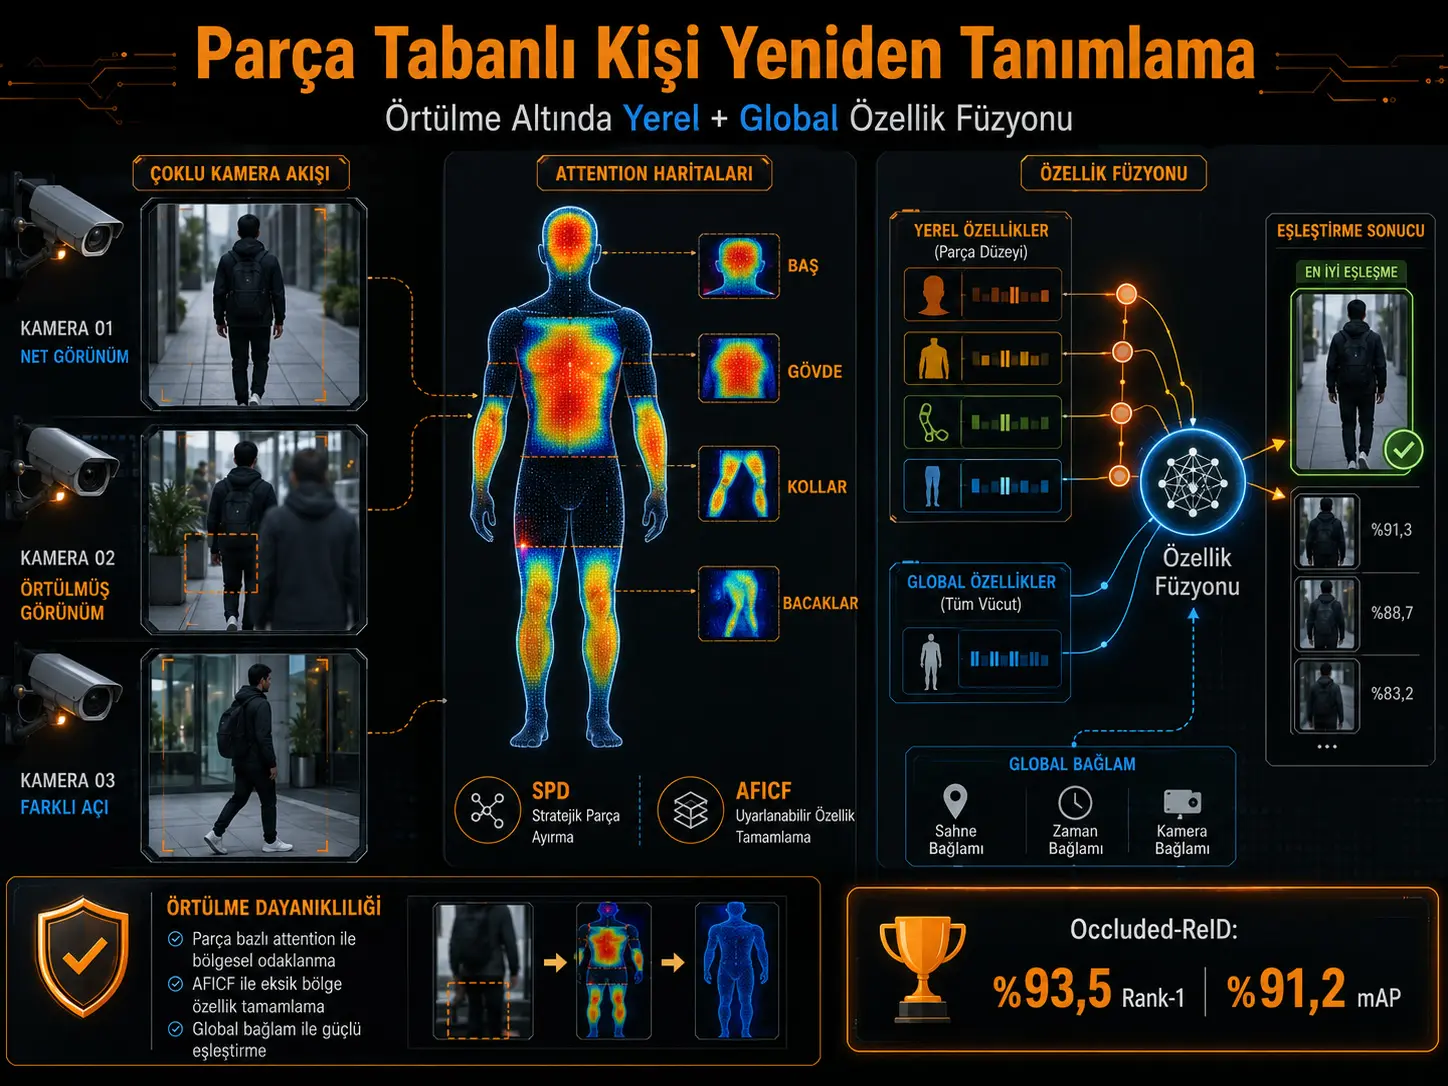
Bu tədqiqat müxtəlif kameralarda və ya müxtəlif zamanlarda görüntülənən eyni şəxsi yenidən tapmağı hədəfləyən Person Re-Identification (Person Re-ID; şəxsin yenidən identifikasiyası) problemində xüsusilə bədənin bir hissəsinin başqa insanlar və ya obyektlər tərəfindən örtüldüyü görüntülərə fokuslanır. Tədqiqatçılar yalnız bütün insan görüntüsünü təmsil edən tək qlobal xüsusiyyət vektoruna əsaslanmaq əvəzinə baş, gövdə, qollar və ayaqlar kimi semantik bədən bölgələrindən gələn lokal məlumatı qlobal görünüş məlumatı ilə birlikdə istifadə edən Dynamic Part-Based Fusion (DPBF) arxitekturasını təklif edirlər. Sistem iki əsas komponentdən ibarətdir: Salient Part Discrimination (SPD) insan parsing-i və attention xəritələrinin köməyi ilə kimliyi fərqləndirməkdə daha yararlı bədən bölgələrini vurğulayır; Adaptive Feature Integration and Contextual Fusion (AFICF) isə lokal və qlobal xüsusiyyətlər arasındakı korrelyasiyanı təhlil edərək təkrarlanan məlumatı azaldır və tamamlayıcı xüsusiyyətləri birləşdirir.
Model Market-1501, DukeMTMC-ReID, CUHK03-Labeled, Occluded-Duke, Occluded-ReID və P-DukeMTMC-ReID olmaqla altı standart Person Re-ID verilənlər dəstində qiymətləndirildi. Tədqiqatın ən diqqətçəkən nəticəsi Occluded-ReID üzərində əldə edildi: DPBF %93,5 Rank-1 və %91,2 mAP göstəricisinə çatdı. Mənbə cədvəlində ən yaxın güclü müqayisə BPB Re-ID üçün müvafiq olaraq %82,9 və %75,2 olduğundan arifmetik fərqlər 10,6 Rank-1 balı və 16,0 mAP balıdır. P-DukeMTMC-ReID-də DPBF %93,6 Rank-1 və %83,6 mAP göstərdiyi halda Occluded-Duke-da %74,7 Rank-1 və %60,7 mAP ilə BPB Re-ID-dən bir qədər aşağı qalmışdır. Buna görə modelin bütün verilənlər dəstlərində mübahisəsiz ən yaxşı üsul olduğu deyilə bilməz; güclü tərəfi xüsusilə bəzi ağır örtülmə ssenarilərində lokal və qlobal xüsusiyyətləri birlikdə istifadə edə bilməsidir.
Tədqiqat həmçinin mühüm bir məhdudiyyəti kəmiyyətcə göstərir. Ağır örtülmə altında bəzi ayrı-ayrı bədən-hissəsi embedding-ləri demək olar ki, yararsız hala gələ bilir. Üç örtülmə yönümlü benchmark-da p7 adlandırılan ən zəif embedding-in Rank-1 göstəricisi təxminən %2–3 səviyyəsinə qədər düşür. Buna qarşılıq bütöv və görünən bölgələrdən məlumat daşıyan p0 təmsili %69,5–92,6 Rank-1 intervalında qalır. Deməli, DPBF-nin uğuru hər bədən hissəsini etibarlı şəkildə tanımasından deyil, görünən və tamamlayıcı bölgələrdən gələn məlumatı qlobal kontekstlə birləşdirərək tək zəif bir hissədən asılılığı azaltmasından qaynaqlanır.
Person Re-ID dəqiq hansı problemi həll edir?
Person Re-ID sisteminin vəzifəsi bir kameradakı şəxsi başqa kamera görüntüsündə və ya qalereya dəstində yenidən tapmaqdır. Model sorğu görüntüsündən:
“Bu şəxs qalereyadakı hansı görüntü ilə eyni kimliyə aiddir?”
sualına cavab verməyə çalışır.
Problem klassik görüntü təsnifatından fərqlidir. Model yalnız “insan varmı?” sualına cavab vermir; çox sayda oxşar görünüşlü insanlar arasından eyni kimliyi ayırmağa çalışır.
Bu vəzifə xüsusilə aşağıdakı şəraitdə çətinləşir:
- kamera bucağının dəyişməsi,
- işıqlandırmanın dəyişməsi,
- şəxsin müxtəlif pozalarda olması,
- görüntü ayırdetməsinin azalması,
- oxşar geyimlərə sahib insanların olması,
- bədənin bir hissəsinin başqa şəxs və ya obyektlər tərəfindən örtülməsi.
Sonuncu maddə, yəni occlusion/örtülmə, bu tədqiqatın əsas motivasiyasıdır.
Niyə yalnız qlobal xüsusiyyətdən istifadə kifayət etməyə bilər?
Bir CNN bütün insan görüntüsünü tək bir xüsusiyyət vektoruna sıxa bilər. Bu təmsil şəxsin ümumi geyim rəngi, bədən görünüşü və silueti kimi məlumatları daşıyır. Lakin şəxsin mühüm hissəsi örtülərsə qlobal xüsusiyyət vektoru görünməyən və ya yanıltıcı bölgələrin təsirini də ehtiva edir.
Məsələn, insanın aşağı gövdəsi başqa obyekt tərəfindən tam örtülərsə qlobal təmsil kimliyi ayırmaq üçün əslində görünən üst gövdə, çanta və ya geyim teksturası kimi bölgələri kifayət qədər güclü istifadə etməyə bilər.
Hissə əsaslı Re-ID üsullarının məqsədi bu problemi həll etmək üçün insan bədənini daha kiçik semantik bölgələrə ayırmaqdır.
DPBF-nin əsas ideyası nədir?
Təklif olunan sistem:
\[ \text{DPBF} = \text{SPD} + \text{AFICF} + \text{Hybrid Loss} \]
kimi düşünülə bilər.
SPD hansı bədən bölgələrinin kimlik baxımından fərqləndirici məlumat daşıdığını müəyyən etməyə çalışır.
AFICF müxtəlif bədən hissələrindən gələn xüsusiyyətlərlə bütün insan görüntüsündən əldə olunan qlobal xüsusiyyəti birləşdirir.
Hybrid Loss Function isə həm kimlik təsnifatını, həm də eyni şəxsə aid embedding-lərin bir-birinə yaxınlaşmasını, müxtəlif şəxslərin isə uzaqlaşmasını hədəfləyir.
Mühüm elmi fərq var: tədqiqatçılar attention, human parsing, PCC, PCA və ya triplet loss-u yeni icad etdiklərini iddia etmirlər. Məqalənin töhfəsi bu strukturların occluded Person Re-ID üçün koordinasiyalı bir DPBF pipeline-da birlikdə istifadə olunma üsuludur.
Salient Part Discrimination nə edir?
SPD-nin vəzifəsi insan görüntüsünü yalnız həndəsi olaraq bərabər zolaqlara bölmək deyil, mənalı bədən bölgələrinə uyğun attention xəritələri yaratmaqdır.
Modelin giriş xüsusiyyət xəritəsi:
\[ F \]
kimi göstərilir. Bu xüsusiyyət xəritəsi əvvəlcə:
\[ 1\times1 \]
convolution qatından keçirilərək:
\[ F' \]
əldə edilir.
Daha sonra yüngül CNN, global average pooling və fully connected qat istifadə edilərək:
\[ K \]
ədəd attention çəkisi yaradılır.
Bunlar:
\[ A_1,A_2,\ldots,A_K \]
şəklində bədən hissələrinə aid spatial attention xəritələrinə çevrilir.
Grad-CAM burada necə istifadə olunur?
Tədqiqat əvvəlcədən müəyyən edilmiş hər bədən hissəsi üçün attention xəritəsi yaradarkən Grad-CAM əsaslı strategiyadan istifadə edir.
Məqsəd, məsələn:
- baş,
- gövdə,
- sol/sağ qol,
- sol/sağ ayaq
kimi bölgələrin feature map üzərində kimlik baxımından mənalı aktivasiyalarını ayırmaqdır.
Məqalənin 6-cı səhifəsindəki Şəkil 1-də eyni şəxsin görüntüsü müxtəlif semantik hissələrə ayrılaraq hər bölmə üçün yaradılmış attention heatmap-ləri göstərilir. Bəzi xəritələrdə üst gövdə və ya ayaq bölgələrinin aydın şəkildə yüksək aktivasiya aldığı görünür.
SCHP niyə sistemə əlavə olunur?
İnsan bədənini yalnız sabit həndəsi dilimlərə bölmək poza dəyişikliklərində problem yarada bilər. İnsan yeriyəndə və ya əyiləndə eyni koordinat bölgəsi hər görüntüdə eyni anatomik quruluşa uyğun gəlməyə bilər.
Bu səbəbdən tədqiqat Self-Correction for Human Parsing (SCHP) modelindən çıxarılan human parsing etiketlərindən istifadə edir.
İlk parsing etiketi:
\[ Y_0=P(X) \]
şəklində ifadə olunur.
Daha sonra correction network:
\[ C = \arg\min_C L \left( C(Y_0),Y_{GT} \right) \]
ilə optimallaşdırılır və düzəldilmiş etiket:
\[ Y_1=C(Y_0) \]
kimi əldə olunur.
SPD bu parsing məlumatını attention mexanizmi ilə birləşdirərək anatomik baxımdan daha ardıcıl hissə təmsilləri yaratmağa çalışır.
Human parsing səhvsizdirmi?
Xeyr. Mənbə tədqiqat bunu xüsusi olaraq məhdudiyyət kimi qəbul edir.
Ağır örtülmə və ya qeyri-adi poza halında:
- ayaq yox ola bilər,
- qol səhv bölgəyə təyin oluna bilər,
- parsing maskası natamam yaradıla bilər,
- anatomik hissənin yalnız kiçik bölümü görünə bilər.
Buna görə model attention mexanizmini parsing etiketlərinin tək istifadəsinə alternativ deyil, onları tamamlayan quruluş kimi istifadə edir.
Cross-Part Spatial Feature Modulation Map nədir?
Attention xəritələri yaradıldıqdan sonra onların yalnız vizuallaşdırılması kifayət deyil. Hər attention map əsas xüsusiyyət xəritəsinə tətbiq edilir.
Hər bədən hissəsi üçün:
\[ P_k=A_k\times F \]
element-wise multiplication əməliyyatı istifadə olunur.
Beləliklə:
\[ P_1,P_2,\ldots,P_K \]
şəklində hissəyə-xas xüsusiyyət xəritələri alınır.
Sonra bunlar:
\[ P_{\mathrm{concat}} = \operatorname{Concat} (P_1,P_2,\ldots,P_K) \]
ilə birləşdirilir.
Məqalənin 8-ci səhifəsindəki Şəkil 2 və Şəkil 3 bu əməliyyatı aydın göstərir: feature map bir neçə attention map ilə vurulur və ortaya çıxan lokal xüsusiyyət təmsilləri ortaq hissə əsaslı representation-a daşınır.
Niyə lokal xüsusiyyətlərlə qlobal xüsusiyyətlər yenidən birləşdirilir?
Yalnız bədən hissələrinə güvənmək də problem yarada bilər.
Məsələn:
- ayaq tam örtülüdürsə ayaq embedding-i mənasızlaşa bilər,
- qol çox kiçik görünürsə xüsusiyyət səs-küylü ola bilər,
- səhv parsing bir hissəni başqa bölgəyə daşıya bilər.
Qlobal xüsusiyyət isə bütün görüntünün kontekstini qoruyur.
DPBF buna görə:
local body-part features + global contextual feature
birləşməsindən istifadə edir.
AFICF niyə sadə concatenation istifadə etmir?
Lokal və qlobal feature vektorlarını birbaşa yan-yana əlavə etmək ölçünü artırır. Daha mühüm problem isə eyni məlumatı daşıyan yüksək korrelyasiyalı xüsusiyyətlərin sistemə bir neçə dəfə daxil olmasıdır.
AFICF buna görə əvvəlcə xüsusiyyətlər arasındakı Pearson korrelyasiyasını hesablayır.
\[ r_{XY} = \frac{ \sum_{i=1}^{n} (X_i-\bar X)(Y_i-\bar Y) }{ \sqrt{ \sum_{i=1}^{n}(X_i-\bar X)^2 } \sqrt{ \sum_{i=1}^{n}(Y_i-\bar Y)^2 } } \]
\[ |r_{XY}|\approx1 \]
olduqda iki xüsusiyyətin güclü xətti əlaqə daşıdığı və potensial olaraq təkrarlanan məlumat ehtiva etdiyi qəbul olunur.
AFICF yüksək korrelyasiyalı feature qruplarından təkrarlanan komponentləri azaltmağı hədəfləyir.
PCA niyə tətbiq olunur?
Pearson korrelyasiyasından sonra qalan feature fəzasında hələ də ölçü təkrarı ola bilər. Buna görə Principal Component Analysis tətbiq olunur.
Xüsusiyyətlər arasındakı covariance:
\[ \operatorname{Cov}(X_j,X_k) = \frac{1}{n-1} \sum_{i=1}^{n} (X_{ij}-\bar X_j) (X_{ik}-\bar X_k) \]
ilə hesablanır.
Ən yüksək eigenvalue-lara uyğun principal component-lar saxlanaraq final təmsil:
\[ 512 \]
ölçülü kompakt embedding-ə endirilir.
DPBF-nin təlim itkisi necə işləyir?
Model iki fərqli hədəfi birlikdə optimallaşdırır.
Birinci komponent cross-entropy loss-dur:
\[ L_{\mathrm{CE}} = -\sum_{i=1}^{N} Y_i\log\hat Y_i. \]
Bu termin modelin qlobal kimlik ayrımını öyrənməsini təmin edir.
İkinci komponent triplet loss-dur:
\[ L_{\mathrm{triplet}} = \max \left( 0, D_{\mathrm{pos}} - D_{\mathrm{neg}} + m \right). \]
Burada:
- \(D_{\mathrm{pos}}\): eyni şəxsə aid iki embedding arasındakı məsafə,
- \(D_{\mathrm{neg}}\): fərqli şəxslərə aid embedding arasındakı məsafə,
- \(m\): margin.
Tədqiqatda margin:
\[ m=0{,}3 \]
kimi seçilib.
Final Hybrid Loss:
\[ L_{\mathrm{Hybrid}} = \alpha L_{\mathrm{CE}} + \beta L_{\mathrm{TL}} \]
şəklindədir.
İki əsas loss komponenti bərabər çəkiləndirilib.
Model necə öyrədildi?
Tədqiqatda iki backbone istifadə edilib:
- ResNet-50,
- HRNet-w32.
ResNet-50 üçün giriş görüntüsü:
\[ 256\times128 \]
piksel; HRNet-w32 üçün:
\[ 384\times128 \]
piksel kimi istifadə olunub.
Model Adam optimizer ilə öyrədilib; başlanğıc learning rate:
\[ 3{,}5\times10^{-4} \]
kimi verilib.
Warm-up başlanğıc learning rate:
\[ 3{,}5\times10^{-5} \]
və weight decay:
\[ 0{,}0005 \]
kimi müəyyənləşdirilib.
Learning rate 40-cı və 70-ci epoch-da azaldılıb; ümumi təlim:
\[ 150\ \text{epoch} \]
davam edib.
Hər kimlik üçün batch daxilində dörd nümunə istifadə olunub və effective batch size verilənlər dəsti və GPU şərtlərinə görə 16–64 arasında dəyişib.
Hansı verilənlər dəstləri istifadə olundu?
Tədqiqat iki fərqli benchmark qrupunu ayırır.
Bütöv / standart Person Re-ID verilənlər dəstləri:
- Market-1501,
- DukeMTMC-ReID,
- CUHK03-Labeled.
Örtülmə yönümlü verilənlər dəstləri:
- Occluded-Duke,
- Occluded-ReID,
- P-DukeMTMC-ReID.
Rank-1 Accuracy nə deməkdir?
Bir sorğu görüntüsü üçün sistem qalereyadakı şəxsləri oxşarlığa görə sıralayır.
Doğru kimliyin siyahının birinci sırasında olması Rank-1 uğurudur.
Məsələn:
\[ R1=93{,}5\% \]
nəticəsi istifadə olunan benchmark protokolu altında sorğuların təxminən %93,5-ində doğru kimliyin birinci sırada olduğunu ifadə edir.
mAP nəyi ölçür?
Mean Average Precision yalnız ilk sıranı deyil, eyni kimliyə aid bütün doğru uyğunlaşmaların sıralama siyahısındakı paylanmasını nəzərə alır.
Buna görə:
- Rank-1 ilk nəticəyə,
- mAP bütün retrieval siyahısının keyfiyyətinə
daha həssasdır.
Bütöv benchmark-larda nəticələr necədir?
| Verilənlər dəsti | DPBF Rank-1 (%) | DPBF mAP (%) | Mənbə cədvəlində mövqeyi |
|---|---|---|---|
| Market-1501 | 96,0 | 89,3 | Rank-1-də ən yüksək; mAP-də AaP-ReID-dən aşağı |
| DukeMTMC-ReID | 92,0 | 82,8 | Rank-1-də ən yüksək; mAP-də AaP-ReID-dən aşağı |
| CUHK03-Labeled | 89,5 | 82,6 | Hər iki metrikdə də cədvəldəki ən yüksək dəyər |
Bu cədvəl mühüm fərqi göstərir. DPBF bütün benchmark və bütün metriklərdə ən yüksək dəyəri yaratmayıb. Market-1501-də AaP-ReID-in mAP dəyəri %93,9 olduğu halda DPBF %89,3; DukeMTMC-ReID-də AaP-ReID %88,6 mAP olduğu halda DPBF %82,8-dir.
Buna görə modelin güclü performansı “bütün mövcud üsullardan hər yerdə daha yaxşı” kimi ümumiləşdirilməməlidir.
CUHK03-Labeled nəticəsi
DPBF:
\[ R1=89{,}5\%,\qquad mAP=82{,}6\% \]
dəyərlərini yaradır.
R-1 baxımından cədvəldə növbəti ən yüksək dəyər %84,7 olduğuna görə fərq:
\[ 89{,}5-84{,}7 = 4{,}8 \]
bal kimi hesablanır.
mAP baxımından isə AaP-ReID %82,4 ilə DPBF-yə ən yaxın dəyərdir. Buna görə arifmetik fərq:
\[ 82{,}6-82{,}4 = 0{,}2 \]
baldır.
Mənbə mətndə qeyd olunan 1,6 ballıq mAP fərqi ən yaxın dəyərlə deyil, SCSN-nin %81,0 mAP dəyəri ilə müqayisədə alınır.
Örtülmə yönümlü verilənlər dəstlərində nəticələr
| Verilənlər dəsti | DPBF Rank-1 (%) | DPBF mAP (%) | Mənbə cədvəlində ən yaxın güclü müqayisə |
|---|---|---|---|
| Occluded-Duke | 74,7 | 60,7 | BPB Re-ID: 75,1 / 62,5 |
| Occluded-ReID | 93,5 | 91,2 | BPB Re-ID: 82,9 / 75,2 |
| P-DukeMTMC-ReID | 93,6 | 83,6 | BPB Re-ID: 93,0 / 83,2 |
Modelin ən aydın üstünlüyü Occluded-ReID-də ortaya çıxır.
Rank-1 fərqi:
\[ 93{,}5-82{,}9 = 10{,}6 \]
bal;
mAP fərqi:
\[ 91{,}2-75{,}2 = 16{,}0 \]
baldır.
Mənbə bu fərqləri faiz yaxşılaşması kimi ifadə edir; lakin cədvəl dəyərlərinin birbaşa çıxılması bunların faiz balı fərqi olduğunu göstərir.
Occluded-Duke niyə mühüm əks nümunədir?
Occluded-Duke-da DPBF:
\[ 74{,}7/60{,}7 \]
nəticəsini verdiyi halda BPB Re-ID:
\[ 75{,}1/62{,}5 \]
yaradır.
Buna görə təklif olunan arxitekturanın örtülmə olan bütün verilənlər dəstlərində ən yaxşı nəticəni verdiyi deyilə bilməz.
Hissə sayı artdıqda performans necə dəyişir?
Market-1501 ablation tədqiqatında üç fərqli bədən-hissəsi detallılığı sınaqdan keçirilib:
- 3 hissə,
- 5 hissə,
- 8 hissə.
Hər üç supervision strategiyasında hissə sayının 3-dən 8-ə artırılması daha yüksək performansla əlaqəlidir.
Səkkiz hissəli konfiqurasiyada mənbədə “semi-supervised” adlandırılan Parsing + PAM quruluşu:
\[ R1=96{,}0\%,\qquad mAP=89{,}3\% \]
nəticəsinə çatıb.
Eyni səkkiz hissədə yalnız supervised parsing:
\[ 92{,}6/85{,}3 \]
və yalnız PAM əsaslı unsupervised quruluş:
\[ 86{,}7/77{,}8 \]
nəticəsini verib.
Bu təcrübə parsing məlumatının attention mexanizmi ilə birlikdə istifadəsinin bu benchmark və konfiqurasiya altında yalnız PAM və ya yalnız parsing yanaşmasından daha güclü olduğunu dəstəkləyir.
DPBF ilə PCB-nin hissə sayı müqayisəsi
DukeMTMC-ReID üzərində mənbə aşağıdakı nəticələri bildirir:
| Hissə sayı | DPBF R-1 (%) | DPBF mAP (%) | PCB R-1 (%) | PCB mAP (%) |
|---|---|---|---|---|
| 3 | 87,4 | 80,2 | 76,4 | 58,3 |
| 5 | 90,5 | 82,7 | 82,4 | 67,5 |
| 6 | 91,0 | 83,8 | 82,6 | 68,8 |
Mənbə bu nəticələri DPBF-nin parsing-guided attention ilə correlation-aware integration komponentlərinin birlikdə töhfəsinə bağlayır. Bununla belə cədvəl SPD və AFICF komponentlərinin ayrı-ayrılıqda tam izolə edilmiş səbəb-nəticə töhfəsini ölçmür.
Xüsusiyyət inteqrasiyası təcrübəsində nə görünür?
Occluded-ReID üzərindəki xüsusiyyət inteqrasiyası analizində global pooled feature, body-part features, Pearson correlation refinement və PCA komponentləri müxtəlif kombinasiyalarda çıxarılıb.
Tam HLF konfiqurasiyasında mənbə:
\[ mAP=73{,}7,\qquad R1=86{,}5 \]
bildirir.
Daha çox feature-integration komponenti çıxarıldıqca performans:
\[ 68{,}7 \rightarrow 62{,}9 \rightarrow 57{,}5 \rightarrow 55{,}2 \]
mAP səviyyələrinə qədər geriləyir.
Bu təcrübə lokal + qlobal xüsusiyyətlərin və correlation/PCA refinement-ın birlikdə istifadəsini dəstəkləyir.
Lakin bu cədvəldəki final HLF nəticəsi ilə məqalənin əsas Occluded-ReID müqayisə cədvəlindəki:
\[ 93{,}5\ R1,\qquad91{,}2\ mAP \]
dəyəri arasında böyük fərq var. Mənbə bu iki qiymətləndirmə konfiqurasiyasının niyə bu qədər fərqli nəticə verdiyini açıq şəkildə uyğunlaşdırmadığından dəyərlər eyni təcrübə nəticəsi kimi birləşdirilməməlidir.
Ağır örtülmə hansı bədən bölgələrinə ən çox təsir edir?
Tədqiqatın attention heatmap-ləri və hissə əsaslı testləri xüsusilə aşağı gövdə bölgələrinin daha kövrək olduğunu göstərir.
Mənbədə p0 ən güclü, p7 isə ən zəif embedding kimi bildirilib.
| Verilənlər dəsti | Ən güclü embedding | Ən zəif embedding | Rank-1 fərqi | mAP fərqi |
|---|---|---|---|---|
| Occluded-ReID | p0: 91,5 / 84,8 | p7: 2,5 / 6,9 | 89,0 | 77,9 |
| Occluded-Duke | p0: 69,5 / 56,8 | p7: 2,9 / 1,4 | 66,6 | 55,4 |
| P-DukeMTMC-ReID | p0: 92,6 / 81,8 | p7: 2,4 / 1,5 | 90,2 | 80,3 |
Bu nəticə DPBF-nin mühüm məhdudiyyətini aydın göstərir: görünməyən və ya demək olar tam örtülmüş bədən hissəsindən etibarlı kimlik məlumatı çıxarmaq hələ də son dərəcə çətindir.
Modelin üstünlüyü bu zəif hissəni “yaxşılaşdırmaqdan” daha çox digər görünən bölgələr və qlobal kontekst sayəsində ümumi kimlik təmsilini qorumağa çalışmasıdır.
Şəkil 5-dəki mənbə-daxili uyğunsuzluq
Məqalənin Şəkil 5 açıqlamasında:
- (b) paneli Occluded-ReID,
- (c) paneli P-DukeMTMC-ReID
kimi müəyyən edilir.
Lakin yayımlanmış vizualın qrafik başlıqlarında üst qrafik:
p_dukemtmc_reid
və alt qrafik:
Market-1501
kimi etiketlənib.
Buna görə qrafik panel adları ilə figure caption tam uyğun gəlmir. Mənbənin hansını nəzərdə tutduğunu fərz edib səssiz düzəliş etmək əvəzinə bu qeyri-müəyyənlik qorunmalıdır.
Hesablama xərci necədir?
Mənbədə üç üsulun batch processing və yaddaş dəyərləri belədir:
| Model | Processing Time (s/batch) | Memory Usage (MB) |
|---|---|---|
| PCB + RPP | 129,8272 | 20.250 |
| BPB Re-ID | 122,7825 | 19.018 |
| DPBF | 126,2159 | 21.250 |
DPBF ən aşağı yaddaş və ya ən sürətli üsul deyil. BPB Re-ID daha aşağı processing time və yaddaş istifadəsi göstərir. DPBF-nin məqsədi hesablama baxımından mütləq minimum deyil, örtülmə dayanıqlığı ilə hesablama xərci arasında rəqabətli tarazlıq qurmaqdır.
Model neçə parametr istifadə edir?
Mənbədə verilənlər dəstinə bağlı konfiqurasiyalar üçün təxminən:
\[ 39{,}5-41{,}3\ \text{milyon} \]
parametr bildirilib.
FLOP dəyəri təxminən:
\[ 8{,}0\times10^9 \]
səviyyəsindədir.
RTX 4090 və TITAN Xp təkrarlarında nəticələr ardıcıldırmı?
Market-1501 üzərində TITAN Xp işi:
\[ 96{,}08\ R1,\quad89{,}32\ mAP \]
və RTX 4090 işi:
\[ 95{,}67\ R1,\quad89{,}49\ mAP \]
verib.
DukeMTMC-ReID-də:
\[ 91{,}88/82{,}87 \]
və:
\[ 92{,}06/82{,}87 \]
nəticələri bildirilib.
P-DukeMTMC-ReID-də fərq bir qədər böyükdür:
\[ 92{,}09/82{,}13 \]
ilə:
\[ 93{,}62/83{,}67. \]
Müəlliflər bu müqayisəni müxtəlif hardware şərtlərində performansın ümumilikdə sabit qaldığına dəlil kimi təqdim edirlər.
Lakin “reproducibility” burada müstəqil başqa tədqiqat qrupunun replikasiyası demək deyil; eyni tədqiqat daxilində müxtəlif hardware-lərdə aparılan əlavə training/evaluation işləridir.
RTX 4090 qiymətləndirmə müddətini nə qədər azaldır?
Market-1501 evaluation batch time:
\[ 0{,}444\ \text{s} \rightarrow 0{,}126\ \text{s} \]
DukeMTMC-ReID:
\[ 0{,}454 \rightarrow 0{,}130\ \text{s} \]
və P-DukeMTMC-ReID:
\[ 0{,}410 \rightarrow 0{,}128\ \text{s} \]
kimi bildirilib.
Bu fərq model alqoritmindəki dəyişiklikdən deyil, istifadə olunan GPU arxitekturalarının hesablama gücündən qaynaqlanır.
Türkiyə baxımından tədqiqat nə ifadə edir?
Tədqiqatda Türkiyədən toplanmış kamera məlumatı və ya Türkiyəyə xas Person Re-ID benchmark-ı yoxdur. Buna görə bildirilən:
\[ 93{,}5\%, \quad 91{,}2\% \]
kimi nəticələr Türkiyədəki hava limanı, zavod, kampus və ya təhlükəsizlik kameralarında gözlənən uğur faizi kimi istifadə edilə bilməz.
Türkiyədə tətbiq olunacaq sistem üçün kamera ayırdetməsi, kamera hündürlüyü, izdiham sıxlığı, geyim oxşarlığı, görüntü sıxılması, gecə/gündüz şəraiti və örtülmə quruluşu kimi amillərlə ayrıca yerli qiymətləndirmə aparılmalıdır.
Tədqiqatın dəstəklədiyi nəticələr
- SPD və AFICF-nin koordinasiyalı istifadə olunduğu DPBF altı Person Re-ID benchmark-da rəqabətli nəticələr yaradıb.
- Occluded-ReID üzərində mənbə cədvəlindəki ən yaxın müqayisəyə görə 10,6 Rank-1 balı və 16,0 mAP balı daha yüksək nəticə bildirilib.
- P-DukeMTMC-ReID-də DPBF mənbə cədvəlindəki ən yüksək Rank-1 və mAP dəyərini yaradıb.
- Market-1501 və DukeMTMC-ReID-də DPBF Rank-1 baxımından cədvəldə ən yüksək nəticəni verir, lakin mAP baxımından ən yaxşı üsul deyil.
- Occluded-Duke-da DPBF mənbə cədvəlindəki BPB Re-ID nəticəsindən aşağı qalıb.
- Market-1501 ablation-da 8 hissəli Parsing + PAM konfiqurasiyası 3 və 5 hissəli alternativlərdən daha yüksək performans göstərib.
- Ağır örtülmə aşağı bədən embedding-lərində çox böyük performans itkisinə səbəb olub.
- Müxtəlif GPU mühitlərindəki əlavə təlimlər ümumilikdə oxşar R-1 və mAP nəticələri yaradıb.
Tədqiqatın sübut etmədiyi şeylər
- DPBF-nin bütün Person Re-ID verilənlər dəstlərində mövcud bütün üsullardan üstün olduğu sübut edilməyib.
- Benchmark nəticələri real şəhər miqyaslı kamera şəbəkəsində sahə uğuru kimi doğrulanmayıb.
- Hissə əsaslı attention ağır örtülmənin təsirini tam aradan qaldırmır.
- Hər bədən hissəsinin etibarlı kimlik məlumatı daşıdığı göstərilməyib; p7 nəticələri bunun əksini göstərir.
- Baseline-lər eyni kod, backbone, input resolution və training pipeline ilə tam şəkildə yenidən işlədilməyib.
- Mənbə cədvəllərindəki performans fərqləri üçün confidence interval və ya formal significance testi verilməyib.
- DPBF-nin computationally ən yüngül və ya ən sürətli Re-ID modeli olduğu göstərilməyib.
- Hardware-lər arası təkrarlar müstəqil üçüncü tərəf replikasiyası deyil.
Tədqiqatın Metodu və Nəticələri
DPBF emal xətti
Məqalədəki Algorithm 1-ə görə təlim bu ardıcıllıqla aparılır:
- Giriş görüntüsündən CNN backbone feature map-ləri çıxarılır.
- SPD ilə parsing-guided body-part representations yaradılır.
- Lokal body-part embedding-ləri və global contextual embedding əldə edilir.
- AFICF ilə lokal və qlobal xüsusiyyətlərin əlaqəsi tənzimlənir.
- Pearson korrelyasiya analizi ilə təkrarlanan feature komponentləri azaldılır.
- PCA ilə kompakt discriminative embedding yaradılır.
- Lokal və qlobal təmsillər birləşdirilir.
- Model Hybrid Loss ilə optimallaşdırılır.
Inference mərhələsində isə:
- query və gallery görüntülərindən normallaşdırılmış embedding-lər çıxarılır,
- embedding cütləri arasında Euclidean distance hesablanır,
- gallery görüntüləri məsafəyə görə kiçikdən böyüyə sıralanır,
- kimlik uyğunluğu retrieval siyahısı kimi qaytarılır.
Arxitektura axınının qısa riyazi xülasəsi
Bir görüntü:
\[ X \]
backbone-a daxil olduqda:
\[ X \rightarrow F \]
xüsusiyyət xəritəsi yaranır.
SPD:
\[ F \rightarrow \{A_1,\ldots,A_K\} \]
attention xəritələrini yaradır.
Daha sonra:
\[ P_k=A_k\odot F \]
ilə hər body-part representation yaradılır.
Bunlar:
\[ P_{\mathrm{concat}} = [P_1;\ldots;P_K] \]
kimi birləşdirilir.
AFICF:
\[ (P_{\mathrm{concat}},G) \rightarrow \text{PCC refinement} \rightarrow \text{PCA} \rightarrow E \]
əməliyyatı ilə final embedding-i yaradır.
Inference zamanı iki embedding arasındakı Euclidean məsafə azaldıqca sistem görüntülərin eyni kimliyə aid olma ehtimalını sıralamada daha yüksək qəbul edir.
Market-1501 əsas nəticəsi
Final DPBF:
\[ 96{,}0\% \ R1 \]
və:
\[ 89{,}3\% \ mAP \]
yaradıb.
Rank-1 mənbə cədvəlində ən yüksək dəyər olduğu halda mAP-də AaP-ReID %93,9 ilə daha yüksəkdir.
DukeMTMC-ReID əsas nəticəsi
DPBF:
\[ 92{,}0\% \ R1 \]
və:
\[ 82{,}8\% \ mAP \]
verib.
Rank-1 mənbə cədvəlində ən yüksək nəticədir. mAP-də AaP-ReID %88,6 ilə daha yüksək dəyərə malikdir.
CUHK03-Labeled əsas nəticəsi
DPBF:
\[ 89{,}5\% \ R1 \]
və:
\[ 82{,}6\% \ mAP \]
ilə mənbə cədvəlindəki ən yüksək iki metriyi yaradıb.
Occluded-ReID əsas nəticəsi
DPBF-nin ən güclü benchmark nəticəsi burada görünür:
\[ 93{,}5\% \ R1, \qquad 91{,}2\% \ mAP. \]
Mənbə cədvəlində növbəti yüksək R-1 BPB Re-ID-in:
\[ 82{,}9\% \]
dəyəridir.
mAP üçün eyni model:
\[ 75{,}2\% \]
verir.
P-DukeMTMC-ReID nəticəsi
DPBF:
\[ 93{,}6\% \ R1, \qquad 83{,}6\% \ mAP \]
nəticəsinə çatıb.
BPB Re-ID:
\[ 93{,}0/83{,}2 \]
olduğuna görə fərqlər müvafiq olaraq 0,6 və 0,4 baldır.
Occluded-Duke nəticəsi
DPBF:
\[ 74{,}7/60{,}7 \]
yaradıb.
BPB Re-ID isə:
\[ 75{,}1/62{,}5 \]
ilə hər iki metriyi də bir qədər yüksək əldə edib.
Örtülmə analizi nə göstərir?
Tədqiqatın Şəkil 6-dakı heatmap-lərində yaşıl sərhədlər daha uğurlu feature localization nümunələrini, qırmızı sərhədlər isə zəif və ya səhv representation-ları göstərir.
Yüngül örtülmədə üst gövdə və görünən geyim bölgələrində attention aktivliyi qoruna bildiyi halda ağır örtülmədə xüsusilə:
- ayaq,
- aşağı ayaq,
- tamamilə görünməyən ətraflar
çox zəif feature yaradır.
Cədvəl 8 bu vizual müşahidəni kəmiyyətcə təsdiqləyir.
DPBF ağır örtülməni necə azaldır?
Mənbə nəticələrinə görə həll örtülmüş hissədən məlumatı “yenidən yaratmaq” deyil.
Bunun əvəzinə:
- görünən bədən bölgələri ayrı-ayrılıqda təmsil edilir,
- güclü lokal xüsusiyyətlər qlobal görünüş məlumatı ilə birləşdirilir,
- təkrarlanan xüsusiyyətlər PCC/PCA ilə azaldılır,
- tək lokal hissədən asılılıq azaldılır.
Buna görə DPBF-nin əsas üstünlüyü adaptive local–global compensation kimi şərh oluna bilər.
Modelin praktik məhdudiyyətləri
Müəlliflərin nəticə bölməsində vurğuladığı gələcək iş sahələri bunlardır:
- ağır örtülmədə daha sabit parsing,
- adaptive part weighting,
- occlusion-aware feature reconstruction,
- aşağı ayırdetmədə daha güclü representation,
- bir-birinə çox oxşayan insanların fərqləndirilməsi,
- transformer əsaslı global–local interaction.
Bu gələcək iş təklifləri mövcud DPBF-nin bu problemləri tam həll etmədiyini də göstərir.
Müqayisələrin metodoloji həddi
Tədqiqat baseline modellərin böyük hissəsinin skorlarını onların öz orijinal məqalələrindən götürüb. Buna görə modellər arasında:
- backbone,
- giriş ayırdetməsi,
- augmentation,
- optimizer parametrləri,
- yardımçı training texnikaları
tamamilə eyni deyil.
Müəlliflər yalnız standart benchmark protokolları altında bildirilən nəticələri seçərək müqayisə qərəzini azaltmağa çalışıblar.
Buna görə cədvəllər sahənin yayımlanmış performans səviyyələri ilə müqayisə verir; lakin tək laboratoriyada tam bərabər şərtlərdə aparılmış vahid benchmark deyil.
Statistik əhəmiyyət həddi
Məqalə Rank-1 və mAP fərqlərini bildirir, lakin müxtəlif modellər arasındakı benchmark fərqləri üçün:
- confidence interval,
- bootstrap uncertainty,
- paired significance test
təqdim etmir.
Buna görə məsələn Occluded-ReID-dəki 10,6 və 16,0 ballıq fərqlər böyük ədədi fərqlərdir; lakin “statistik olaraq əhəmiyyətli üstünlük” ifadəsi formal hipotez testi ilə dəstəklənməyib.
Mənbə və Metod Qeydi
Tam orijinal işin adı: Strategic Feature Integration for Superior Person Re-ID: A Part-Based Approach
Müəlliflər: Ghaith Hussein; Jeremy S. Smith; Waleed Al-Nuaimy.
Bərabər birinci/bərabər töhfə: Mənbədə bərabər birinci müəllif və ya bərabər töhfə bəyanatı yoxdur.
Məsul müəllif: Ghaith Hussein.
Qurum: Department of Electrical Engineering and Electronics, University of Liverpool, Brownlow Hill, Liverpool L69 3GJ, United Kingdom.
Mənbə növü: Hakemli orijinal tədqiqat məqaləsi; kompüter görməsi və deep-learning əsaslı Person Re-Identification işi.
Jurnal: AI.
Nəşriyyat: MDPI, Basel, Switzerland.
Biblioqrafik qeyd: AI, 2026, Cild 7, Sayı 6, Məqalə 210.
DOI: 10.3390/ai7060210.
Alınma / reviziya / qəbul / nəşr: 30 mart 2026 / 1 iyun 2026 / 2 iyun 2026 / 9 iyun 2026.
Hakemlik statusu: Hakemli jurnal nəşridir.
Lisenziya: Creative Commons Attribution (CC BY).
Academic Editor: Miguel Angel Cazorla.
Mənbədə verilən açar sözlər: Salient Part Discrimination; Adaptive Feature Integration and Contextual Fusion; Person Re-ID; attention mechanism; feature fusion.
Təklif olunan model: Dynamic Part-Based Fusion (DPBF).
Əsas model komponenti 1: Salient Part Discrimination (SPD).
Əsas model komponenti 2: Adaptive Feature Integration and Contextual Fusion (AFICF).
Parsing modeli: Self-Correction for Human Parsing (SCHP).
Attention yanaşması: Grad-CAM əsaslı hissəyə-xas attention xəritələri və Cross-Part Spatial Feature Modulation Map.
Feature redundancy analizi: Pearson Correlation Coefficient.
Ölçü azaltma: Principal Component Analysis; final kompakt representation 512 ölçü.
Loss: Cross-entropy + triplet loss-dan ibarət Hybrid Loss Function. Triplet margin 0,3; iki əsas loss bərabər çəkilidir.
Əlavə hissə-supervision loss: Pixel-level cross-entropy weight 0,35.
Backbone-lar: ResNet-50 və HRNet-w32.
ResNet-50 giriş ölçüsü: 256 × 128 piksel.
HRNet-w32 giriş ölçüsü: 384 × 128 piksel.
Optimizer: Adam.
Əsas learning rate: \(3,5\times10^{-4}\).
Warm-up learning rate: \(3,5\times10^{-5}\).
Weight decay: 0,0005.
Təlim: 150 epoch; learning rate azalması 40-cı və 70-ci epoch.
Sampling: RandomIdentitySampler; hər kimlik üçün dörd instance.
Batch size: Təcrübə konfiqurasiyasına görə 16–64.
Veri artırma: Random cropping, normalization və random erasing.
Benchmark verilənlər dəstləri: Market-1501, DukeMTMC-ReID, CUHK03-Labeled, Occluded-Duke, Occluded-ReID və P-DukeMTMC-ReID.
Əsas qiymətləndirmə metrikləri: Rank-1 Accuracy və mean Average Precision (mAP).
Occluded-ReID final nəticəsi: %93,5 Rank-1 və %91,2 mAP.
P-DukeMTMC-ReID final nəticəsi: %93,6 Rank-1 və %83,6 mAP.
Occluded-Duke final nəticəsi: %74,7 Rank-1 və %60,7 mAP.
Market-1501 final nəticəsi: %96,0 Rank-1 və %89,3 mAP.
DukeMTMC-ReID final nəticəsi: %92,0 Rank-1 və %82,8 mAP.
CUHK03-Labeled final nəticəsi: %89,5 Rank-1 və %82,6 mAP.
Model mürəkkəbliyi: İstifadə olunan konfiqurasiyaya görə təxminən 39,5–41,3 milyon parametr və təxminən 8,0 milyard FLOP bildirilib.
Əsas training GPU: NVIDIA GeForce RTX 4090, 24 GB.
Əlavə təcrübə hardware: 2 × NVIDIA GeForce TITAN Xp.
Re-ranking: Mənbəyə görə başqa cür göstərilmədikcə müqayisəli nəticələrdə re-ranking istifadə olunmayıb.
Maliyyələşdirmə: Tədqiqat xarici maliyyələşdirmə almayıb.
Etik komitə: Yeni insan iştirakçısı və yeni məlumat toplanması olmadığı və yalnız açıq benchmark verilənlər dəstləri istifadə edildiyi üçün etik qiymətləndirmə/approval waived kimi bildirilib.
Məlumatlandırılmış razılıq: Tədqiqatçılar yeni insan məlumatı toplamadığı üçün waived kimi bildirilib; istifadə olunan görüntülər orijinal benchmark təminatçılarının daha əvvəl yayımladığı verilənlər dəstlərindən gəlir.
Veri əlçatanlığı: İstifadə olunan altı benchmark-ın açıq olduğu bildirilib və məlumat mənbələri məqalədə verilib.
Müəllif töhfələri: Konseptuallaşdırma G.H.; metodologiya və proqram təminatı G.H.; doğrulama G.H. və J.S.S.; formal analiz G.H.; tədqiqat G.H. və J.S.S.; ilkin layihə G.H.; nəzərdən keçirmə/redaktə J.S.S. və W.A.-N.; məsləhət W.A.-N.
Maraqlar toqquşması: Müəlliflər maraqlar toqquşması bildirməyiblər.
Mənbə daxilində uyğunsuzluq və hesabat qeydləri
Occluded-ReID üzərində final benchmark Cədvəl 2-də DPBF üçün %93,5 R-1 və %91,2 mAP verildiyi halda, eyni verilənlər dəstində feature-integration analysis Cədvəl 3-ün HLF sətri %86,5 R-1 və %73,7 mAP verir. Məqalə bu fərqi açıq backbone/protokol izahı ilə əlaqələndirmir. Buna görə iki dəyər dəsti ayrı təcrübə kontekstləri kimi qorunub.
Mənbə mətndəki Occluded-ReID müqayisəsi “%10,6 R-1 artımı və %16 mAP yaxşılaşması” kimi ifadə olunur. Cədvəl dəyərlərindən hesablanan fərqlər 10,6 və 16,0 faiz balıdır. Bu Verianla mətni nisbi faiz yaxşılaşması mənası yaratmamaq üçün “bal fərqi” ifadəsindən istifadə edib.
CUHK03-Labeled üçün mənbə izahı ən yaxın rəqibə qarşı 4,8 R-1 və 1,6 mAP üstünlüyü iddia edir. Cədvəl 1 R-1 üçün 4,8 balı təsdiqləyir, lakin DPBF-nin %82,6 mAP dəyərinə ən yaxın dəyər AaP-ReID-in %82,4 dəyəridir; fərq 0,2 baldır. 1,6 ballıq fərq SCSN-nin %81,0 dəyəri ilə müqayisədə alınır.
Şəkil 5-in açıqlamasında (b) Occluded-ReID və (c) P-DukeMTMC-ReID kimi yazıldığı halda yayımlanmış şəklin qrafik başlıqlarında `p_dukemtmc_reid` və `Market-1501` ifadələri görünür. Bu figure-caption uyğunsuzluğunda hansı etiketin müəlliflərin nəzərdə tutduğu final versiya olduğunu mənbə dəqiqləşdirmir.
Müqayisəli nəticələrin şərh həddi
Məqalənin baseline nəticələri əsasən müvafiq üsulların orijinal nəşrlərindən götürülüb. Mənbə bunu açıq bildirir və backbone, input resolution, data augmentation, optimization və auxiliary training texnikalarının fərqli ola biləcəyini qəbul edir.
Buna görə müqayisə cədvəlləri:
“standart benchmark ədəbiyyatında bildirilmiş nəticələrə qarşı empirik mövqeləndirmə”
kimi oxunmalıdır.
Bütün üsulların eyni kod bazası, eyni seed, eyni backbone və eyni GPU altında yenidən işlədildiyi nəzarətli benchmark kimi şərh edilməməlidir.
Elmi şərh həddi
DPBF xüsusilə Occluded-ReID və P-DukeMTMC-ReID üzərində güclü nəticələr göstərir; lakin Occluded-Duke-da mənbə cədvəlindəki ən yaxşı sistem deyil və bütöv benchmark-larda da hər mAP metrikində lider deyil.
Tədqiqatın ağır örtülmə analizi aşağı bədən və ya tamamilə görünməyən bölgələrin feature reliability-sinin çox ciddi dərəcədə azala bildiyini açıq göstərir. Buna görə sistem “örtülmədən təsirlənməyən şəxs tanıma” həlli deyil.
Bundan əlavə istifadə olunan metriklər akademik retrieval benchmark-larına aiddir. Nəticələr real kamera şəbəkəsində kimlik doğrulama zəmanəti, təhlükəsizlik zəmanəti və ya sahə tətbiqində eyni dəqiqlik faizinin əldə ediləcəyi mənasını vermir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib