

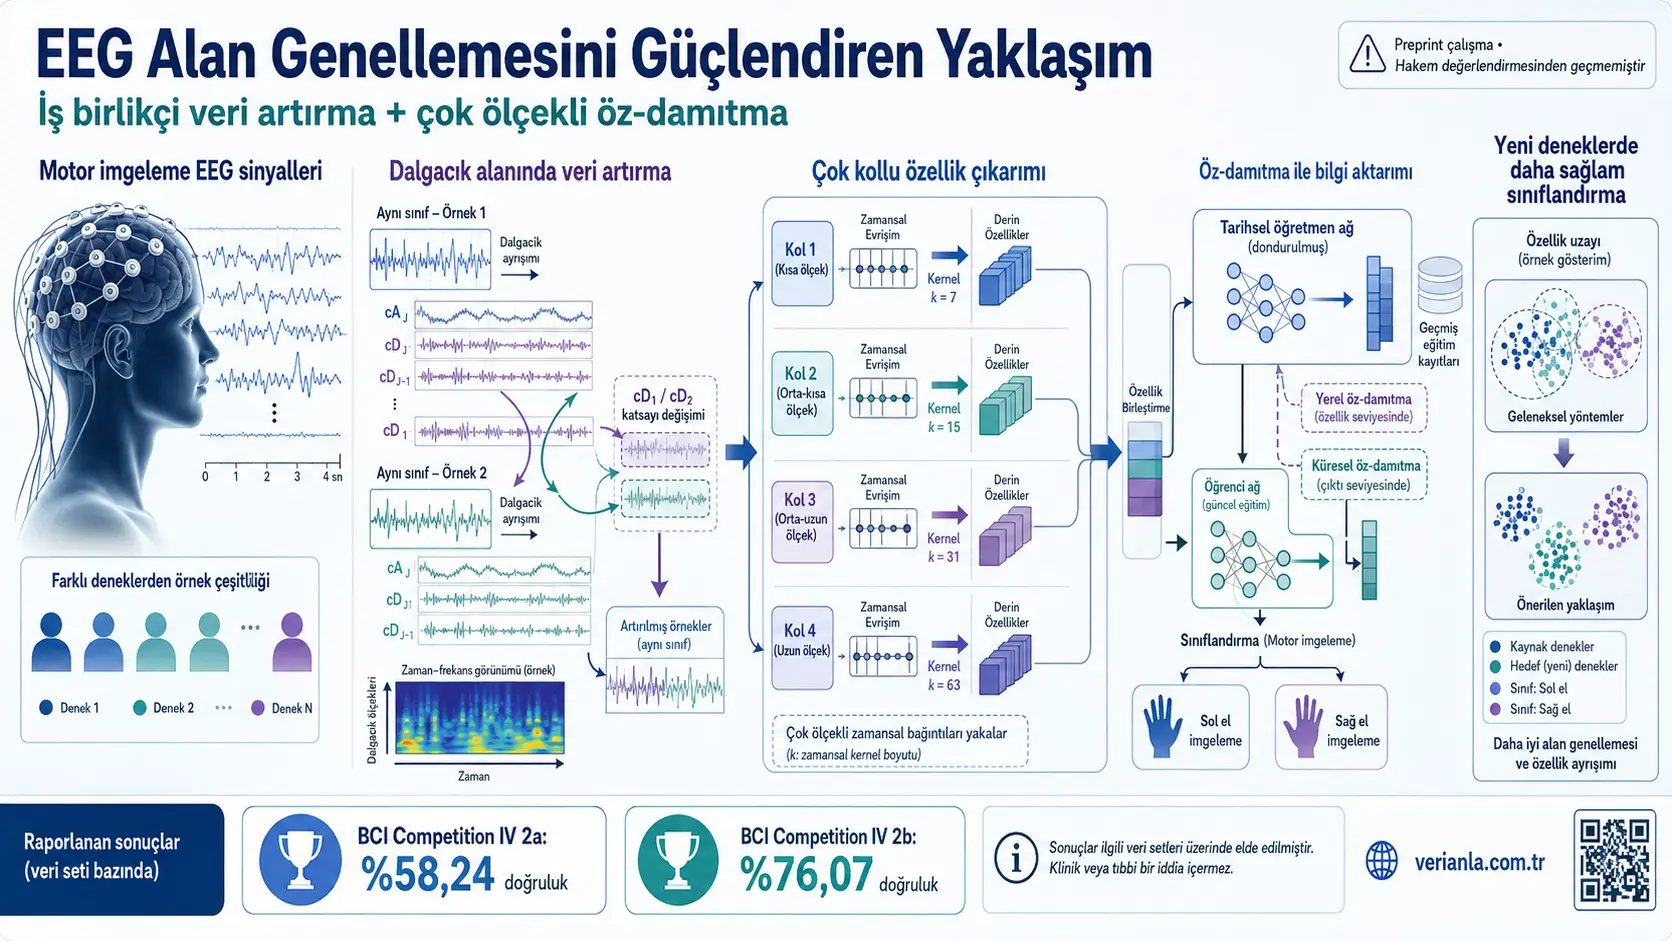
Utafiti huu umetathmini modeli ya MGLSDNet inayounganisha data augmentation katika wavelet domain, convolutional neural network yenye matawi manne, na global-local self-distillation ili kuboresha uainishaji wa kuaminika wa motor imagery electroencephalography signals kati ya watu tofauti. Modeli ilijaribiwa kwenye datasets za BCI Competition IV 2a na 2b, kila moja ikiwa na washiriki tisa, kwa tathmini ya leave-one-subject-out. Mean classification accuracy iliripotiwa kuwa %58,24 kwenye four-class 2a dataset na %76,07 kwenye two-class 2b dataset. Hata hivyo, utafiti ni preprint ambayo haijapitiwa na peer review; unategemea datasets mbili tu za wazi na hautoi validation kwenye real-time system, clinical patient group, new participants au field application.
Multi-scale Global-Local Self-Distillation Network (MGLSDNet) iliyopendekezwa inashughulikia kwa pamoja matatizo mawili katika data level na model level. Katika data level, baadhi ya wavelet detail coefficients za EEG samples za motor imagery class ileile zinabadilishwa ili kuunda training samples mpya. Katika model level, matawi manne parallel yanayotazama temporal scales tofauti yanatumika; kila branch na uamuzi uliounganishwa wa matawi unaongozwa na historical versions za network zilizohifadhiwa hapo awali.
Kwenye BCI Competition IV 2a, accuracy ya MGLSDNet ya %58,24 ni 1,08 percentage points juu ya %57,16 ya MSVTNet, modeli ya karibu zaidi ya kulinganisha. Hata hivyo, tofauti kati ya modeli hizi mbili si statistically significant; paired t-test iliripoti p=0,6507. Kwenye BCI Competition IV 2b, MGLSDNet ilifikia %76,07 na kuzidi %73,24 ya TIDNet, njia yenye mean ya juu zaidi miongoni mwa comparators, kwa 2,83 percentage points. Tofauti hii iliripotiwa chini ya statistical significance threshold kwa p=0,0308.
Tathmini kwa Türkiye: Utafiti unatoa methodological framework inayoweza kupimwa na timu zinazofanya brain-computer interface, assistive technology na neurorehabilitation research nchini Türkiye kwa cross-subject EEG classification. Lengo la kupunguza hitaji la kukusanya calibration data nyingi kutoka kwa user mpya ni muhimu kivitendo. Hata hivyo, njia hii inahitaji revalidation kwa washiriki wa Türkiye, EEG devices tofauti, local laboratory conditions na clinical target groups. Preprint hii haitoi ushahidi wa patient improvement, field success katika prosthesis control, measured reduction ya calibration time au clinical effectiveness.
Swali kuu la utafiti ni lipi?
Swali kuu ni kama modeli iliyofunzwa kwa motor imagery EEG data kutoka source subjects pekee inaweza kuainisha kwa uaminifu zaidi signal za target subject mpya ambayo haikuonekana kabisa wakati wa training. Lengo hili linaitwa domain generalization katika utafiti. Katika domain generalization, data za target subject hazitumiki wakati wa training; lengo ni kujifunza task-related patterns zinazoshirikiwa na source subjects kadhaa na kuunda modeli inayoweza kutumika moja kwa moja kwa subject mpya.
Motor imagery ni hali ambapo mtu anawazia movement ya hand, foot au tongue bila kufanya movement halisi. Utafiti unaainisha EEG patterns zinazoonekana wakati wa mental tasks hizi. BCI Competition IV 2a ina four motor imagery classes, wakati 2b ina two classes: left hand na right hand.
Kwa nini utafiti ni muhimu?
Utafiti unaeleza changamoto tatu kuu za motor imagery EEG classification: low signal-to-noise ratio ya EEG, temporal variability ya signals, na distribution differences kubwa kati ya brain signals za watu tofauti. Deep learning models zikifunzwa kwa participants wachache na samples chache zinaweza kujifunza noise au personal patterns za subjects fulani badala ya common task-related features.
Hali hii inaweza kuhitaji long calibration sessions na person-specific model training kabla ya user mpya kuingizwa kwenye mfumo. Lengo la utafiti si kupima calibration need moja kwa moja, bali kuunda modeli inayoweza kufanya classification bora bila kutumia target-subject training data.
Ni pengo gani la literature lililengwa?
Kulingana na utafiti, methods za awali mara nyingi hushughulikia data augmentation na model regularization tofauti. Time-domain operations kama noise injection, time shifting au amplitude scaling zinaweza kuvuruga time-frequency structure ya motor imagery signals. Generative models kama GAN na VAE zinaweza kukumbana na training instability na changamoto za kuthibitisha physiological meaning ya generated samples.
Multi-branch networks zinaweza kutoa complementary features kutoka temporal au frequency scales tofauti, lakini independent optimization ya kila branch inaweza kufanya common decision isiwe regularized vya kutosha. MGLSDNet inaunganisha maeneo haya mawili: kwanza kupanua training distribution kwa kubadilisha wavelet coefficients, kisha kurekebisha multi-scale features kwa self-distillation inayotumia historical states za network kama teacher.
Wavelet-domain data augmentation inafanyaje kazi?
Wavelet transform ilitumika kugawanya EEG signal katika time-frequency components tofauti. Approximation coefficients zimeonyeshwa kwa cA, detail coefficients kwa cD. Samples mbili za class ileile huchaguliwa, coefficients za detail level fulani pekee hubadilishana, na EEG samples mbili mpya hujengwa upya kutoka modified components. Class label haibadiliki.
- cD1: First-level detail coefficients zinazohusishwa katika utafiti na 20–40 Hz.
- cD2: Second-level detail coefficients zinazohusishwa na 10–20 Hz.
- Inter-subject exchange: Samples za class ileile huchaguliwa kutoka source subjects tofauti.
- Intra-subject exchange: Samples za class ileile huchaguliwa kutoka source subject yuleyule.
Kielelezo 2 kinaonyesha signal mbili zikigawanywa katika wavelet components, cD1 au cD2 zikibadilishwa, na signal mpya zikijengwa upya. Approximation coefficients na detail level ambayo haijabadilishwa huhifadhiwa. Lengo la waandishi ni kuiga rhythmic amplitude na phase differences kati ya watu huku class meaning ya signal ikihifadhiwa.
Majaribio yalitumia Daubechies 4 (db4) wavelet basis, data augmentation multiplier ya mara tatu, na low-noise level ya 0,02. Hata hivyo, utafiti hauonyeshi physiological validity ya generated samples kwa independent spectral similarity metric, expert review au separate biological validation test. Dai kwamba “physiological meaning is preserved” ni methodological rationale linaloungwa mkono kwa njia isiyo ya moja kwa moja na classification results, si biological outcome iliyothibitishwa moja kwa moja.
Multi-branch feature extractor imeundwaje?
MGLSDNet ina matawi manne parallel yenye same three-layer structure. Tofauti kuu ni size ya first temporal convolution kernel. Kernel sizes zimefafanuliwa kupitia sampling frequency \(F_s\) kama \(F_s/16\), \(F_s/8\), \(F_s/4\) na \(F_s/2\). Kernels kubwa hulenga rhythmic patterns za muda mrefu zaidi, na ndogo hulenga short-term variations.
Kila branch hufanya operations tatu kuu:
- Temporal convolution: Hutoa branch-specific temporal patterns kwa kernel ya \(1 \times L_k\).
- Spatial depthwise separable convolution: Hu-model relationships kati ya EEG electrodes kwa kernel ya \(C \times 1\), ambapo \(C\) ni idadi ya EEG channels.
- Separable temporal convolution: Huunganisha features kutoka layers mbili za kwanza ili kutoa temporal contexts zilizo complex zaidi.
Intermediate features za branches hazifuse mapema. Kila branch hutoa classification output yake, na final decision hutumia element-wise average ya raw output scores, yaani logits. Kielelezo 1 kinaonyesha branches nne za student network, historical teacher network iliyocopy kutoka student, local loss links za branch level, na global loss kati ya combined decisions za networks hizo mbili.
Global-local self-distillation inatekelezwaje?
Self-distillation haitumii external pre-trained teacher model. Parameters za student network zinacopywa kwa intervals fulani, copied version inafreeze, na kutumika kama historical teacher. Teacher update interval imewekwa 10 epoch. Hivyo current student model hujifunza kutoka true class labels na probability distributions zilizozalishwa na version yake ya awali.
Local self-distillation hulinganisha kila student branch na historical teacher branch yake. Global self-distillation hualign combined final output ya student branches na common output ya teacher branches. Kutumia levels hizi mbili pamoja kunalenga regularization ndani ya kila scale na consistency ya common decision ya branches nne.
Loss functions zinakokotoa nini?
Equation ya kwanza inakokotoa Kullback-Leibler divergence kati ya softened output distribution ya student branch \(k\) na historical teacher branch inayolingana:
\[ L_{\mathrm{soft}}^{k} = \tau^{2} \cdot KL\left(\operatorname{softmax}(z_k/\tau)\,\|\,\operatorname{softmax}(z_k^{\mathrm{teacher}}/\tau)\right) \]
Hapa \(z_k\) ni raw output scores za student branch kabla ya classification, \(z_k^{\mathrm{teacher}}\) ni historical teacher output ya branch hiyo, na \(\tau\) ni temperature parameter. Utafiti ulitumia \(\tau=2{,}0\). Quantities hizi hazina physical unit. Temperature inalenga kusoften probability differences kati ya classes na kuhamisha taarifa kuhusu classes ambazo teacher anaona kuwa karibu zaidi.
Equation ya pili inaunganisha hard-label loss kutoka true class label na soft-label loss kutoka teacher output:
\[ L_{\mathrm{local}}^{k} = \alpha L_{\mathrm{hard}}^{k} + (1-\alpha)L_{\mathrm{soft}}^{k} \]
\(L_{\mathrm{hard}}^{k}\) ni cross-entropy loss ya branch \(k\) kwa true labels; \(L_{\mathrm{soft}}^{k}\) ni self-distillation loss. \(\alpha\) huamua weight ya supervision sources mbili na ilitumika 0,5. Hivyo true label na historical teacher zina equal weight katika local branch loss.
Equation ya tatu inakokotoa average ya raw output scores za historical teacher branches nne:
\[ z_{\mathrm{final}}^{\mathrm{teacher}} = \frac{1}{K}\sum_{k=1}^{K}z_k^{\mathrm{teacher}} \]
Hapa \(K\) ni idadi ya branches na kwa MGLSDNet \(K=4\). Equation inawakilisha common decision ya teacher branches nne.
Equation ya nne inakokotoa global distillation loss kati ya combined student output na common historical teacher output:
\[ L_{\mathrm{global}} = \tau^{2} \cdot KL\left(\operatorname{softmax}(z_{\mathrm{final}}/\tau)\,\|\,\operatorname{softmax}(z_{\mathrm{final}}^{\mathrm{teacher}}/\tau)\right) \]
\(z_{\mathrm{final}}\) ni combined output ya student branches nne na \(z_{\mathrm{final}}^{\mathrm{teacher}}\) ni average output ya teacher branches nne.
Equation ya tano inafafanua total training objective:
\[ L_{\mathrm{total}} = \sum_{k=1}^{K}L_{\mathrm{local}}^{k} + L_{\mathrm{global}} + L_{\mathrm{hard}}^{\mathrm{final}} \]
Total loss inajumuisha local losses za branches nne, global self-distillation loss, na cross-entropy loss ya combined final decision dhidi ya true labels. Loss terms hizi ni dimensionless. Utafiti unadai mchanganyiko huu huongeza branch-level robustness na network-level decision consistency kwa wakati mmoja.
Feature visualizations zinaonyesha nini?
Kielelezo 3 na Kielelezo 4 vinaonyesha two-dimensional t-SNE projections za features kutoka branches nne za subject wa kwanza mwenye code B01 katika BCI Competition IV 2b. Axes za t-SNE si physical EEG quantities wala frequencies; ni coordinates zilizopunguzwa hadi dimensions mbili kwa visual inspection ya high-dimensional features.
Kabla ya training, points za classes mbili zimechanganyika sana katika branches zote nne. Baada ya training, left-hand na right-hand classes zinaonekana kuunda clusters zilizo wazi zaidi. Kulingana na utafiti, branches 1 na 3 zimezalisha separation zaidi kwa horizontal direction, na branches 2 na 4 kwa vertical direction. Muonekano huu unaunga mkono tafsiri kwamba branches zimejifunza complementary features badala ya kurudia decision boundary ileile.
Scope ya visualization ni limited. Subject B01 pekee kutoka 2b dataset imeonyeshwa na separation haijaripotiwa kwa quantitative clustering metric. Kwa hiyo t-SNE figures haziwezi kuthibitisha model success peke yake; zinapaswa kusomwa kama qualitative inspection inayounga mkono classification tables.
Ni matokeo gani yanayoungwa mkono na utafiti?
- MGLSDNet ilitoa highest mean accuracy katika datasets zote mbili chini ya comparison setup ya utafiti.
- Chaguo zote nne za data augmentation zinazotegemea wavelet coefficient exchange zilitoa higher mean accuracy kuliko version isiyo na augmentation.
- Inter-subject coefficient exchange ilitoa best augmentation results katika datasets zote mbili.
- Local na global self-distillation kila moja ilitoa small accuracy gains, na kutumia zote pamoja kulitoa gain kubwa zaidi.
- Kwenye 2b dataset, differences kati ya MGLSDNet na methods zote zilizolinganishwa ziliripotiwa p<0,05.
- Kwenye 2a dataset, differences dhidi ya comparison methods isipokuwa MSVTNet ziliripotiwa p<0,01.
Utafiti hauthibitishi nini?
- Hauonyeshi kwamba MGLSDNet inaboresha patient outcomes katika clinical rehabilitation.
- Hakuna measured reduction ya calibration time kwa new users iliyojaripotiwa.
- Real-time control ya prosthesis, wheelchair au assistive device haijajaribiwa.
- Physiological reality ya generated EEG samples haijathibitishwa kwa independent biological metrics.
- Generalization kati ya EEG devices tofauti, laboratories tofauti au datasets tofauti haijaonyeshwa.
- Generalization dhidi ya signal shift kati ya sessions za mtu yuleyule haijathibitishwa.
- Superiority ya MGLSDNet dhidi ya MSVTNet kwenye 2a haijaonyeshwa statistically.
- Long-term use, safety, user comfort au commercial applicability haijatathminiwa.
Ni nguvu gani za utafiti?
- Unaunganisha data augmentation na model regularization katika methodological framework moja.
- Datasets mbili za wazi na zinazotumika sana kwa comparison zimetumika.
- Cross-subject evaluation bila training data kutoka target test subject imetekelezwa.
- Data augmentation options na self-distillation components zimechunguzwa kwa experiments tofauti.
- Mbali na accuracy, standard deviation, Kappa na paired t-test results zimeripotiwa.
- Model architecture, loss functions na main training hyperparameters zimeelezwa.
Ni vikwazo na uncertainties gani ndani ya source?
Utafiti wenyewe unakubali limitations tatu kuu: wavelet coefficient selection inategemea predefined physiological assumptions, historical teachers huongeza training computational load, na inter-session generalization haijathibitishwa.
Zaidi ya hayo, evaluation inategemea datasets mbili tu zenye subjects tisa kila moja. Paired t-tests haziripoti effect size, confidence interval, normality check au multiple-comparison correction. Hakuna comparison table ya training time, inference latency, memory use, parameter count au computational cost. Code repository au executable application link pia haijaelezwa katika maandishi.
Kuna internal consistency issues katika source. Data augmentation pseudocode inagroup samples kwa “action class + subject ID” na kuelezea selection kutoka subject yuleyule, huku best experimental results zikiwa za inter-subject exchange. Pseudocode inaonyesha cD2 exchange pekee, wakati experiments zinatumia cD1 na cD2. Main text inasema decisions zinafused kwa equal averaging, lakini inference pseudocode inatumia \(w_k\) weights ambazo hazijafafanuliwa. Pia beta rhythm ya 2b dataset imetolewa 18–25 Hz katika methods section na 13–30 Hz katika augmentation interpretation. Makala hii haijaunganisha au kusahihisha ranges hizi kimya kimya.
Umuhimu wake kwa zamani, sasa na baadaye ni upi?
Utafiti unaunganisha wavelet-based data augmentation, multi-branch EEG networks na self-distillation ambazo zilitumika tofauti hapo awali katika cross-subject generalization system moja. Mchango wa sasa ni kutoa comparative na component-wise experiments zinazojaribu kwa pamoja kupanua data distribution na kuregularize network kwa historical knowledge yake mwenyewe.
Katika siku zijazo, method inahitaji kujaribiwa kwa dynamic wavelet coefficient selection, lighter teacher-update methods, datasets tofauti, inter-session signal shift na real-time BCI setups. Thamani ya utafiti haitokani na kuonyesha clinically ready system, bali kupendekeza testable method ya kuboresha EEG classification bila target-subject training data.
Mbinu na Matokeo ya Utafiti
Datasets zilizotumika na sample characteristics
Jedwali lifuatalo linalinganisha main characteristics za open motor imagery EEG datasets mbili zilizotumika katika utafiti.
| Feature | BCI Competition IV 2a | BCI Competition IV 2b |
|---|---|---|
| Idadi ya washiriki | Subjects 9 | Healthy subjects 9 |
| Task | Four-class motor imagery | Two-class motor imagery: left hand na right hand |
| Session structure | Sessions mbili; runs 6 kwa kila session na trials 48 kwa kila run | Experimental sessions tano; first three bila visual feedback, last two na real-time neurofeedback |
| Task duration | Kila motor imagery task ni sekunde 4 | Single-trial duration haijaelezwa tofauti katika maandishi |
| EEG channels | 22 EEG channels zimetumika kama model input | 3 EEG channels: C3, C4 na Cz |
| EOG use | Recorded 3 EOG channels zimetolewa kwenye analysis | Maelezo hayajatolewa |
| Sampling frequency | 250 Hz | 250 Hz |
| Filtering | 0,5–40 Hz band-pass filter | Same filtering parameters as 2a |
| Highlighted rhythms | Motor-imagery-related μ na β rhythms | μ rhythm 8–12 Hz; β rhythm imetolewa 18–25 Hz katika methods section |
Evaluation na training setup
| Methodological element | Applied value au setup |
|---|---|
| Evaluation | Leave-one-subject-out cross-validation; katika kila fold subjects 7 training, 1 independent validation na 1 test |
| Software | PyTorch 2.0 |
| Hardware | NVIDIA RTX 4060 Ti GPU na Intel Core i5-12490F CPU |
| Optimization | Adam; initial learning rate \(5 \times 10^{-4}\) |
| Maximum training | 400 epoch |
| Early stopping | Training husimamishwa ikiwa validation accuracy haiboreki kwa 50 consecutive epochs |
| Batch size | 64 kwa 2a; 96 kwa 2b |
| Regularization | Dropout na batch normalization |
| Teacher update interval | 10 epoch |
| Distillation temperature | \(\tau=2{,}0\) |
| Local loss weight | \(\alpha=0{,}5\) |
| Wavelet basis | Daubechies 4 (db4) |
| Data augmentation multiplier | 3 |
| Added low-noise level | 0,02 |
Models zilizolinganishwa
MGLSDNet ililinganishwa na EEGNet, DeepConvNet, EEGConformer, TIDNet, FBCNet, MSVTNet na MTMBCNN. Comparison group inajumuisha compact convolutional networks, deep convolutional networks, Transformer-based structures, multi-branch models zinazotumia filter banks, na multi-task EEG classification methods.
Main classification results
| Dataset | Task | MGLSDNet accuracy | Kappa | Comparator yenye highest mean | Accuracy difference | Statistical comparison |
|---|---|---|---|---|---|---|
| BCI Competition IV 2a | Four-class | %58,24 ± 6,67 | 0,4451 | MSVTNet: %57,16 ± 11,51 | +1,08 percentage points | p=0,6507; difference si statistically significant |
| BCI Competition IV 2b | Two-class | %76,07 ± 6,10 | 0,5215 | TIDNet: %73,24 ± 6,37 | +2,83 percentage points | p=0,0308; imetathminiwa kuwa significant |
Kwenye 2a dataset, MGLSDNet ilitoa highest accuracy katika subjects watano kati ya tisa. Highest subject results ziliripotiwa A01 %62,18, A02 %48,81, A04 %50,46, A06 %54,19 na A07 %67,02.
Kwenye 2b dataset, model ilifikia highest accuracy katika subjects nane kati ya tisa. Exception pekee ni B04, ambapo MTMBCNN ilikuwa %82,99 na MGLSDNet %78,41. Highest MGLSDNet subject result ni %84,55 kwa B07. Kwa B03, aliyeelezwa kuwa difficult-to-classify, accuracy ilikuwa %62,33.
Paired t-test results
P values zifuatazo zimetokana na paired t-tests za subject-level accuracies kati ya MGLSDNet na kila comparison method.
| Comparison method | 2a dataset p value | 2b dataset p value |
|---|---|---|
| EEGNet | 0,0015 | 0,0003 |
| DeepConvNet | 0,0022 | 0,0001 |
| EEGConformer | 0,0025 | 0,0014 |
| TIDNet | 0,0010 | 0,0308 |
| FBCNet | 0,0071 | 0,0014 |
| MSVTNet | 0,6507 | 0,0002 |
| MTMBCNN | 0,0001 | 0,0324 |
Kwenye 2a dataset, p values zote isipokuwa MSVTNet comparison ziko chini ya 0,01. Kwenye 2b dataset, comparisons zote ziko chini ya 0,05. Hata hivyo, kwa kuwa utafiti hauripoti multiple-comparison correction au effect size, p values pekee hazionyeshi magnitude ya superiority.
Comparison ya wavelet data augmentation methods
| Dataset | No augmentation | Inter-subject + cD1 | Inter-subject + cD2 | Intra-subject + cD1 | Intra-subject + cD2 |
|---|---|---|---|---|---|
| BCI Competition IV 2a | %56,56 ± 6,26 | %58,24 ± 6,67 | %58,16 ± 6,44 | %57,63 ± 6,69 | %57,81 ± 6,52 |
| BCI Competition IV 2b | %74,50 ± 6,35 | %75,88 ± 6,27 | %76,07 ± 6,10 | %75,74 ± 5,72 | %75,36 ± 6,14 |
Hakuna augmentation option iliyokuwa chini ya no-augmentation version. Kwenye 2a, highest result ilipatikana kwa inter-subject cD1 exchange na gain ya 1,68 percentage points. Kwenye 2b, highest result ilipatikana kwa inter-subject cD2 exchange na gain ya 1,57 percentage points.
Better result ya inter-subject exchange inaunga mkono interpretation ya watafiti kwamba kuchanganya same-class signals kutoka watu tofauti huongeza diversity katika training distribution. Hata hivyo, utafiti haujapima kwa mechanism experiment tofauti ni spectral au morphological characteristics zipi za generated samples zilihusika na performance gain.
Ablation results za self-distillation components
| Local self-distillation | Global self-distillation | 2a accuracy | 2b accuracy |
|---|---|---|---|
| No | No | %57,21 ± 7,04 | %75,23 ± 6,51 |
| Yes | No | %57,86 ± 6,87 | %75,76 ± 6,16 |
| No | Yes | %57,79 ± 6,74 | %75,63 ± 6,22 |
| Yes | Yes | %58,24 ± 6,67 | %76,07 ± 6,10 |
Local-only self-distillation ilitoa gain ya 0,65 percentage points kwenye 2a na 0,53 kwenye 2b. Global-only gains zilikuwa 0,58 na 0,40. Kutumia components zote mbili pamoja kulifikia gain ya 1,03 kwenye 2a na 0,84 kwenye 2b. Matokeo yanaonyesha supervision levels zote mbili pamoja zilitoa higher mean accuracy kuliko kila moja peke yake.
General interpretation ya findings
Performance superiority ya MGLSDNet iliyo wazi zaidi inaonekana kwenye two-class 2b dataset. Kwenye four-class 2a, ingawa ina highest mean accuracy, difference dhidi ya MSVTNet si significant. Kwa hiyo utafiti hauonyeshi kwamba MGLSDNet ni definitely superior kwa strong methods zote kwenye 2a.
Experiments zinaonyesha data augmentation na self-distillation components zinachangia mean accuracy tofauti. Hata hivyo, gains nyingi ni percentage points chache au chini ya one percentage point. Matokeo yanaweza kutathminiwa kama promising methodological improvement; hayamaanishi error-free classification, clinical adequacy au real-world-ready BCI system.
Maelezo ya Chanzo na Mbinu
Jina kamili la asili la utafiti: Enhancing EEG Domain Generalization via Collaborative Data Augmentation and Multi-Scale Self-Distillation
Waandishi na mpangilio sahihi: Xiaoyu Li; Qingshan She; Zhipeng Zhou; Yunyuan Gao; Xugang Xi.
Equal first author: Hakuna taarifa ya equal contribution au equal first authorship iliyotolewa.
Corresponding author: Qingshan She. Contact address: qsshe@hdu.edu.cn.
Institutions:
- School of Automation, Hangzhou Dianzi University, Hangzhou, Zhejiang 310018, China.
- Zhejiang Provincial Key Laboratory of Brain Computer Collaborative Intelligence Technology and Applications, Hangzhou, Zhejiang 310018, China.
Journal: Hakuna peer-reviewed journal information kwa utafiti huu.
Original publisher: Hakuna peer-reviewed journal publisher; utafiti umechapishwa kama preprint.
Publication platform: SSRN.
Publication year: 2026.
SSRN publication date: 29 Julai 2026.
Source type: Preprint research article yenye experimental computational method na data analysis.
Peer-review status: Utafiti huu ni preprint na haujapitiwa na peer review. Results zinapaswa kusomwa kwa kikomo hiki.
Official source link:https://ssrn.com/abstract=7201285
Peer-reviewed version status: Katika bibliographic check ya 5 Agosti 2026, peer-reviewed journal version yenye title ileile haikuthibitishwa.
Funding: Zhejiang Provincial Natural Science Foundation of China LZ26F010007 na National Natural Science Foundation of China 62371172 na 62371171 zimetajwa. Hangzhou Dianzi University Supercomputing Center ilitoa computational resources.
Conflict of interest: Waandishi wametangaza hakuna conflict of interest inayohusiana na publication.
Makala hii ya Kiswahili imeandaliwa kwa kupitia text, formulas, tables, figures, pseudocode, discussion na conclusion ya utafiti uliopakiwa. Hakuna external scientific findings ambazo hazipo katika study zilizoongezwa; external checks zilitumika tu kwa bibliographic identity kama DOI, platform, publication date na peer-reviewed-version status.
Main limitations ni evaluation kwenye datasets mbili tu, subjects tisa kwa kila dataset, kutokuwepo clinical au real-time application, kutothibitishwa kwa inter-session generalization, wavelet coefficient selection kutegemea predefined bands, na training cost ya self-distillation kutoripotiwa quantitatively. Pia source ina broken cross-reference, ambiguity kati ya augmentation pseudocode na inter-subject experiment setup, inconsistency katika beta frequency ranges, na undefined inference weights.
Results zinaonyesha MGLSDNet inaweza kutoa comparative performance improvement katika cross-subject motor imagery EEG classification kwenye open datasets mbili zilizochunguzwa. Utafiti hauthibitishi clinical benefit, safe real-time use, industrial-scale success au kwamba calibration need imeondolewa kwa new users.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *