

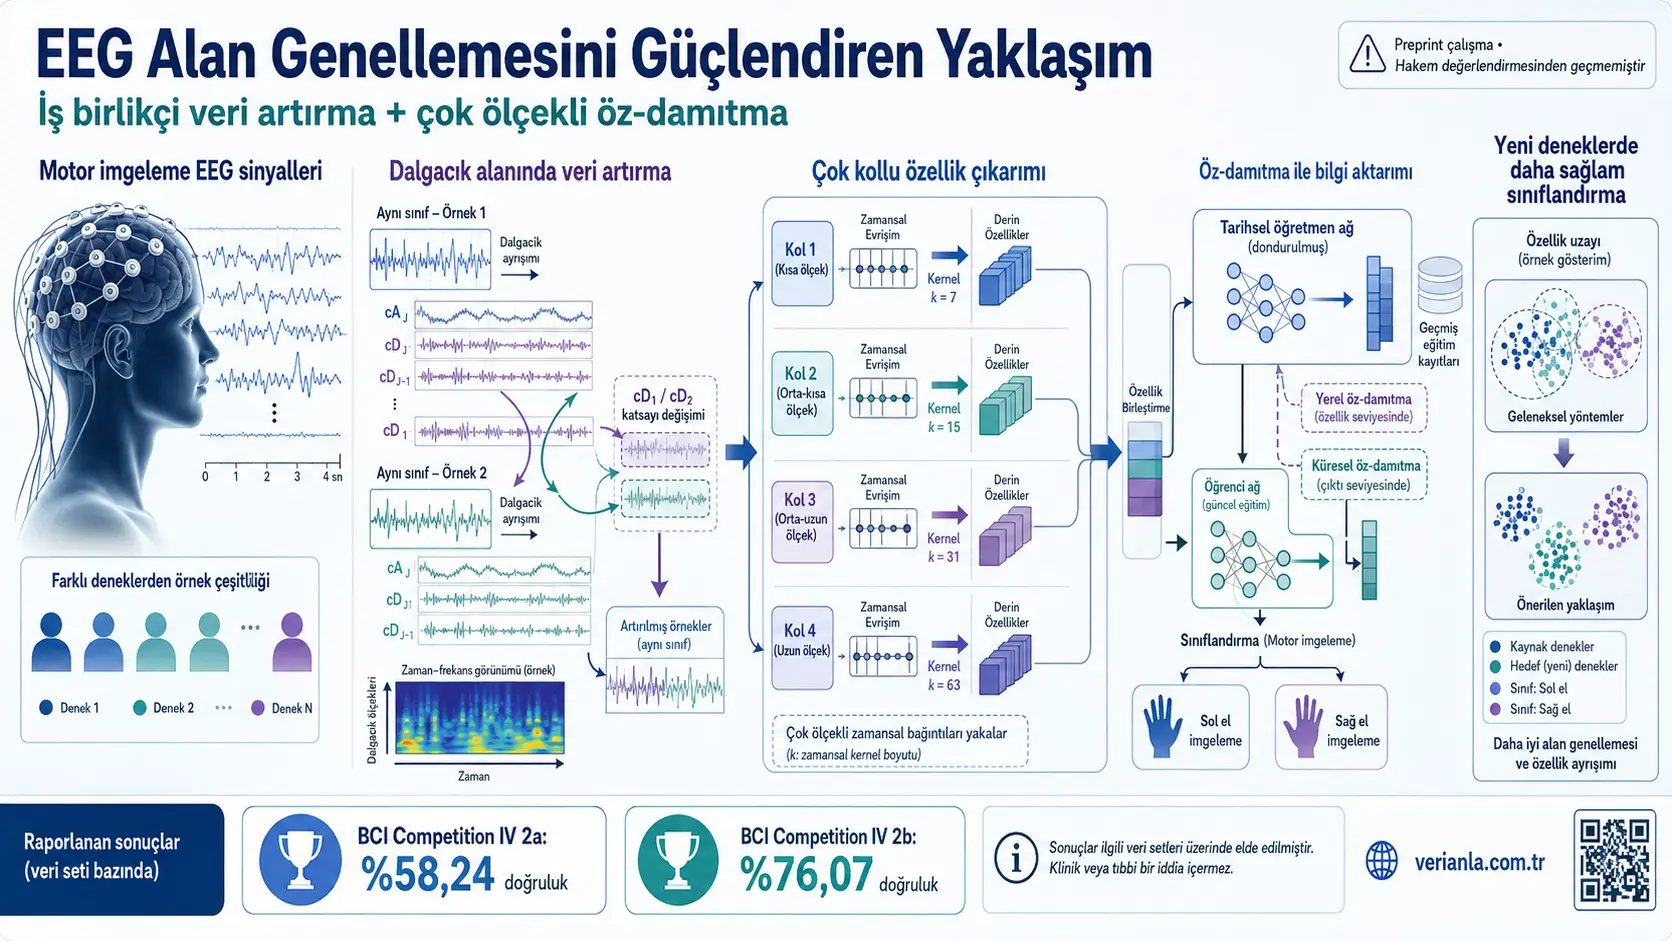
Bu çalışma, motor imgeleme elektroensefalografi sinyallerinin farklı kişiler arasında güvenilir biçimde sınıflandırılmasını geliştirmek amacıyla dalgacık alanında veri artırma, dört kollu bir evrişimsel sinir ağı ve küresel-yerel öz-damıtmayı birleştiren MGLSDNet modelini değerlendirmiştir. Model, dokuzar katılımcı içeren BCI Competition IV 2a ve 2b veri kümelerinde denek dışarıda bırakmalı değerlendirmeyle test edilmiştir. Ortalama sınıflandırma doğruluğu dört sınıflı 2a veri kümesinde %58,24, iki sınıflı 2b veri kümesinde %76,07 olarak bildirilmiştir. Bununla birlikte çalışma hakem değerlendirmesinden geçmemiş bir preprinttir; yalnızca iki açık veri kümesine dayanmakta, gerçek zamanlı sistem, klinik hasta grubu, yeni katılımcılar veya saha uygulaması üzerinde doğrulama sunmamaktadır.
Araştırmada önerilen Çok Ölçekli Küresel-Yerel Öz-Damıtma Ağı (Multi-scale Global-Local Self-Distillation Network, MGLSDNet), veri ve model düzeyindeki iki sorunu birlikte ele almaktadır. Veri düzeyinde aynı motor imgeleme sınıfına ait EEG örneklerinin belirli dalgacık ayrıntı katsayıları değiştirilerek yeni eğitim örnekleri oluşturulmuştur. Model düzeyinde ise farklı zaman ölçeklerini inceleyen dört paralel ağ kolu kullanılmış; her kol ve kolların birleştirilmiş kararı, ağın daha önce kaydedilmiş tarihsel sürümleri tarafından yönlendirilmiştir.
BCI Competition IV 2a veri kümesinde MGLSDNet’in %58,24 doğruluğu, en yakın karşılaştırma modeli olan MSVTNet’in %57,16 doğruluğundan 1,08 yüzde puanı yüksektir. Ancak bu iki model arasındaki fark istatistiksel olarak anlamlı değildir; eşleştirilmiş t-testinde p=0,6507 bildirilmiştir. BCI Competition IV 2b veri kümesinde MGLSDNet %76,07 doğruluğa ulaşmış, en yüksek ortalamaya sahip karşılaştırma yöntemi TIDNet’in %73,24 sonucunu 2,83 yüzde puanı aşmıştır. Bu karşılaştırmadaki fark p=0,0308 ile istatistiksel anlamlılık eşiğinin altında bildirilmiştir.
Türkiye açısından değerlendirme: Çalışma, Türkiye’de beyin-bilgisayar arayüzü, yardımcı teknoloji ve nörorehabilitasyon araştırmaları yürüten ekipler için denekler arası EEG sınıflandırmasında sınanabilecek bir yöntem çerçevesi sunmaktadır. Özellikle yeni kullanıcıdan yoğun kalibrasyon verisi toplama ihtiyacını azaltma hedefi uygulama bakımından önemlidir. Ancak yöntemin Türkiye’deki katılımcılarla, farklı EEG cihazlarıyla, yerel laboratuvar koşullarında ve klinik hedef gruplarda yeniden doğrulanması gerekir. Bu preprint, hastalarda iyileşme, protez kontrolünde saha başarısı, kalibrasyon süresinde ölçülmüş azalma veya klinik etkinlik kanıtı sunmamaktadır.
Araştırmanın temel sorusu nedir?
Araştırmanın temel sorusu, yalnızca kaynak deneklerden alınan motor imgeleme EEG verileriyle eğitilen bir modelin, eğitim sırasında hiç görmediği yeni bir deneğin sinyallerini daha güvenilir biçimde sınıflandırıp sınıflandıramayacağıdır. Bu hedef çalışmada alan genellemesi (domain generalization) olarak adlandırılmıştır. Alan genellemesinde hedef deneğin verileri model eğitimi sırasında kullanılmaz; amaç, birden fazla kaynak denekte ortak olan görevle ilişkili örüntüleri öğrenerek yeni deneğe doğrudan uygulanabilen bir model oluşturmaktır.
Motor imgeleme (motor imagery), kişinin gerçek bir hareket üretmeden el, ayak veya dil hareketini zihninde canlandırmasıdır. Çalışma, bu zihinsel görevler sırasında ortaya çıkan EEG örüntülerini sınıflandırmaktadır. BCI Competition IV 2a veri kümesinde dört motor imgeleme sınıfı, 2b veri kümesinde ise sol el ve sağ el olmak üzere iki sınıf bulunmaktadır.
Çalışma neden önemlidir?
Çalışmada motor imgeleme EEG sınıflandırmasının üç temel güçlükle karşılaştığı belirtilmektedir: EEG sinyallerinin düşük sinyal-gürültü oranı, sinyallerin zaman içinde değişken olması ve farklı kişilerin beyin sinyalleri arasında belirgin dağılım farkları bulunması. Derin öğrenme modelleri az sayıda katılımcı ve sınırlı örnekle eğitildiğinde, motor imgeleme görevine ait ortak özellikler yerine belirli deneklerin gürültüsünü veya kişisel örüntülerini öğrenebilir.
Bu durum, yeni bir kullanıcının sisteme dâhil edilmesinden önce uzun kalibrasyon oturumları ve kişiye özel model eğitimi gerektirebilir. Araştırmanın hedefi kalibrasyon ihtiyacını doğrudan ölçmek değil, hedef denekten eğitim verisi kullanmadan daha iyi sınıflandırma yapabilecek bir model geliştirmektir.
Literatürde hangi boşluk hedeflenmiştir?
Çalışmaya göre önceki yöntemler çoğunlukla veri artırma ile model düzenlileştirmesini ayrı ayrı ele almaktadır. Zaman alanında gürültü ekleme, zaman kaydırma veya genlik ölçekleme gibi işlemler motor imgeleme sinyallerinin zaman-frekans yapısını bozabilir. GAN ve VAE gibi üretici modeller ise eğitim kararsızlığı ve oluşturulan örneklerin fizyolojik anlamının doğrulanması konusunda sorunlarla karşılaşabilir.
Çok kollu ağlar farklı zaman veya frekans ölçeklerinden tamamlayıcı özellikler çıkarabilse de her kolun bağımsız biçimde optimize edilmesi, ortak kararın yeterince düzenlenmemesine yol açabilir. MGLSDNet bu iki alanı bir araya getirmektedir: önce dalgacık katsayılarını değiştirerek eğitim dağılımını genişletmekte, ardından ağın tarihsel durumlarını öğretmen olarak kullanan öz-damıtmayla çok ölçekli özellikleri düzenlemektedir.
Dalgacık alanındaki veri artırma nasıl çalışmaktadır?
Dalgacık dönüşümü, EEG sinyalini farklı zaman-frekans bileşenlerine ayırmak için kullanılmıştır. Çalışmada yaklaşım katsayıları cA, ayrıntı katsayıları ise cD ile gösterilmiştir. İki aynı sınıf örneği seçilmekte, örneklerden yalnızca belirli bir ayrıntı düzeyindeki katsayılar karşılıklı olarak değiştirilmekte ve değiştirilmiş bileşenlerden iki yeni EEG örneği yeniden oluşturulmaktadır. Sınıf etiketi değişmemektedir.
- cD1: Çalışmada 20–40 Hz aralığıyla ilişkilendirilen birinci düzey ayrıntı katsayılarıdır.
- cD2: Çalışmada 10–20 Hz aralığıyla ilişkilendirilen ikinci düzey ayrıntı katsayılarıdır.
- Denekler arası değişim: Aynı sınıftaki örnekler farklı kaynak deneklerden seçilir.
- Denek içi değişim: Aynı sınıftaki örnekler aynı kaynak denekten seçilir.
Şekil 2’de iki sinyalin dalgacık bileşenlerine ayrıldığı, cD1 veya cD2 katsayılarının karşılıklı değiştirildiği ve yeni sinyallerin yeniden oluşturulduğu gösterilmektedir. Yaklaşım katsayıları ile değiştirilmeyen ayrıntı düzeyi korunmaktadır. Yazarların amacı, sinyalin sınıf anlamını korurken kişiler arasındaki ritmik genlik ve faz farklılıklarını taklit etmektir.
Deneylerde Daubechies 4 (db4) dalgacık tabanı, üç kat veri artırma çarpanı ve 0,02 düzeyinde düşük gürültü kullanılmıştır. Bununla birlikte çalışma, üretilen örneklerin fizyolojik geçerliliğini bağımsız bir spektral benzerlik ölçütü, uzman incelemesi veya ayrı bir biyolojik doğrulama testiyle göstermemektedir. “Fizyolojik anlamın korunduğu” yönündeki ifade, yazarların yöntemsel gerekçesi ve sınıflandırma sonuçlarıyla dolaylı olarak desteklenen bir iddiadır; doğrudan kanıtlanmış bir biyolojik sonuç değildir.
Çok kollu özellik çıkarıcı nasıl yapılandırılmıştır?
MGLSDNet, aynı üç katmanlı yapıya sahip dört paralel koldan oluşmaktadır. Kolların temel farkı ilk zamansal evrişim çekirdeğinin büyüklüğüdür. Çekirdek büyüklükleri örnekleme frekansı \(F_s\) üzerinden \(F_s/16\), \(F_s/8\), \(F_s/4\) ve \(F_s/2\) olarak tanımlanmıştır. Büyük çekirdekler daha uzun süreli ritmik örüntülere, küçük çekirdekler ise daha kısa süreli değişimlere odaklanmaktadır.
Her kol üç temel işlem uygular:
- Zamansal evrişim: \(1 \times L_k\) çekirdeğiyle kola özgü zaman örüntülerini çıkarır.
- Uzamsal derinlik ayrılabilir evrişim: \(C \times 1\) çekirdeğiyle EEG elektrotları arasındaki ilişkileri modeller. Burada \(C\), kullanılan EEG kanalı sayısıdır.
- Ayrılabilir zamansal evrişim: İlk iki katmandan gelen özellikleri birleştirerek daha karmaşık zaman bağlamlarını çıkarmayı amaçlar.
Kolların ara özellikleri erken aşamada birleştirilmemektedir. Her kol kendi sınıflandırma çıktısını üretmekte ve nihai karar için bu ham çıktı skorlarının, yani logit değerlerinin eleman bazında ortalaması alınmaktadır. Şekil 1’de öğrenci ağının dört kolu, öğrenci ağından kopyalanan tarihsel öğretmen ağı, kol düzeyindeki yerel kayıp bağlantıları ve iki ağın birleştirilmiş kararları arasındaki küresel kayıp gösterilmektedir.
Küresel-yerel öz-damıtma nasıl uygulanmaktadır?
Öz-damıtma, haricî ve önceden eğitilmiş bir öğretmen model kullanmamaktadır. Öğrenci ağın parametreleri belirli aralıklarla kopyalanmakta, kopyalanan sürüm dondurulmakta ve tarihsel öğretmen olarak kullanılmaktadır. Çalışmada öğretmen güncelleme aralığı 10 epoch olarak belirlenmiştir. Böylece güncel öğrenci modeli hem gerçek sınıf etiketlerinden hem de kendisinin daha önceki sürümünün ürettiği olasılık dağılımlarından öğrenmektedir.
Yerel öz-damıtma, her öğrenci kolunu kendi tarihsel öğretmen koluyla karşılaştırmaktadır. Küresel öz-damıtma ise öğrenci kollarının birleştirilmiş nihai çıktısını öğretmen kollarının ortak çıktısıyla hizalamaktadır. Bu iki düzeyin birlikte kullanılması, hem her ölçeğin kendi içinde düzenlenmesini hem de dört kolun ortak kararının tutarlı hâle gelmesini amaçlamaktadır.
Kayıp fonksiyonları neyi hesaplamaktadır?
Birinci denklem, \(k\) numaralı öğrenci kolunun yumuşatılmış çıktı dağılımı ile karşılık gelen tarihsel öğretmen kolunun dağılımı arasındaki Kullback-Leibler ayrışmasını hesaplamaktadır:
\[ L_{\mathrm{soft}}^{k} = \tau^{2} \cdot KL\left(\operatorname{softmax}(z_k/\tau)\,\|\,\operatorname{softmax}(z_k^{\mathrm{teacher}}/\tau)\right) \]
Burada \(z_k\), öğrenci kolunun sınıflandırma öncesi ham çıktı skorlarını; \(z_k^{\mathrm{teacher}}\), aynı kolun tarihsel öğretmen çıktısını; \(\tau\), sıcaklık parametresini göstermektedir. Çalışmada \(\tau=2{,}0\) kullanılmıştır. Bu büyüklüklerin fiziksel birimi yoktur. Sıcaklık, sınıflar arasındaki olasılık farklarını yumuşatarak öğretmenin hangi sınıfları birbirine daha yakın değerlendirdiğine ilişkin bilgiyi aktarmayı amaçlar.
İkinci denklem, gerçek sınıf etiketiyle hesaplanan sert etiket kaybını öğretmen çıktısından gelen yumuşak etiket kaybıyla birleştirmektedir:
\[ L_{\mathrm{local}}^{k} = \alpha L_{\mathrm{hard}}^{k} + (1-\alpha)L_{\mathrm{soft}}^{k} \]
\(L_{\mathrm{hard}}^{k}\), \(k\) numaralı kolun gerçek etiketlerle hesaplanan çapraz entropi kaybıdır. \(L_{\mathrm{soft}}^{k}\), öz-damıtma kaybıdır. \(\alpha\), iki denetim kaynağının ağırlığını belirler ve çalışmada 0,5 olarak kullanılmıştır. Böylece gerçek etiket ve tarihsel öğretmen eşit ağırlıkla yerel kol kaybına katılmaktadır.
Üçüncü denklem, dört tarihsel öğretmen kolunun ham çıktı skorlarını ortalamaktadır:
\[ z_{\mathrm{final}}^{\mathrm{teacher}} = \frac{1}{K}\sum_{k=1}^{K}z_k^{\mathrm{teacher}} \]
Burada \(K\), kol sayısıdır ve MGLSDNet için \(K=4\)’tür. Denklem, tek bir kolun kararını değil, dört tarihsel öğretmen kolunun ortak kararını temsil eder.
Dördüncü denklem, güncel öğrenci ağın birleştirilmiş çıktısıyla tarihsel öğretmen ağın ortak çıktısı arasındaki küresel damıtma kaybını hesaplamaktadır:
\[ L_{\mathrm{global}} = \tau^{2} \cdot KL\left(\operatorname{softmax}(z_{\mathrm{final}}/\tau)\,\|\,\operatorname{softmax}(z_{\mathrm{final}}^{\mathrm{teacher}}/\tau)\right) \]
\(z_{\mathrm{final}}\), dört öğrenci kolunun birleştirilmiş çıktısıdır. \(z_{\mathrm{final}}^{\mathrm{teacher}}\), dört öğretmen kolunun ortalama çıktısıdır. Bu kayıp, güncel modelin ortak kararını ağın tarihsel ortak kararıyla uyumlu hâle getirmeyi amaçlar.
Beşinci denklem toplam eğitim hedefini tanımlamaktadır:
\[ L_{\mathrm{total}} = \sum_{k=1}^{K}L_{\mathrm{local}}^{k} + L_{\mathrm{global}} + L_{\mathrm{hard}}^{\mathrm{final}} \]
Toplam kayıp; dört kolun yerel kayıplarını, küresel öz-damıtma kaybını ve birleştirilmiş nihai kararın gerçek etiketlerle hesaplanan çapraz entropi kaybını birlikte içerir. Bu kayıp terimleri boyutsuzdur. Çalışma, bu bileşimin kol düzeyinde sağlamlığı ve ağ düzeyinde karar tutarlılığını aynı anda artırdığını öne sürmektedir.
Özellik görselleştirmeleri ne göstermektedir?
Şekil 3 ve Şekil 4, BCI Competition IV 2b veri kümesindeki B01 kodlu birinci deneğin dört ağ kolundan elde edilen özelliklerin iki boyutlu t-SNE izdüşümlerini göstermektedir. t-SNE eksenleri fiziksel EEG büyüklükleri veya frekanslar değildir; yüksek boyutlu özelliklerin görsel inceleme amacıyla iki boyuta indirgenmiş koordinatlarıdır.
Eğitimden önce iki sınıfa ait noktalar dört kolda da büyük ölçüde birbirine karışmaktadır. Eğitimden sonra sol ve sağ el sınıflarının daha belirgin kümeler oluşturduğu görülmektedir. Çalışmaya göre 1. ve 3. kollar daha çok yatay yönde, 2. ve 4. kollar ise daha çok dikey yönde ayrım üretmiştir. Bu görünüm, kolların aynı karar sınırını tekrarlamak yerine tamamlayıcı özellikler öğrendiği yorumunu desteklemektedir.
Görselleştirmenin kapsamı sınırlıdır. Yalnızca 2b veri kümesindeki B01 deneği gösterilmiş ve ayrışma nicel bir kümeleme ölçütüyle raporlanmamıştır. Bu nedenle t-SNE şekilleri modelin başarısını tek başına kanıtlamaz; sınıflandırma tablolarını destekleyen nitel bir inceleme olarak okunmalıdır.
Çalışmanın desteklediği sonuçlar nelerdir?
- MGLSDNet, araştırmada kullanılan karşılaştırma düzeninde iki veri kümesinde de en yüksek ortalama doğruluğu vermiştir.
- Dalgacık katsayısı değişimine dayalı dört veri artırma seçeneğinin tamamı, veri artırmasız sürümden daha yüksek ortalama doğruluk üretmiştir.
- Denekler arası katsayı değişimi, her iki veri kümesinde de en iyi veri artırma sonuçlarını vermiştir.
- Yerel ve küresel öz-damıtma ayrı ayrı küçük doğruluk artışları sağlamış, birlikte kullanıldığında daha yüksek artış elde edilmiştir.
- 2b veri kümesinde MGLSDNet ile karşılaştırılan bütün yöntemler arasındaki farklar p<0,05 olarak bildirilmiştir.
- 2a veri kümesinde MSVTNet dışındaki karşılaştırma yöntemleriyle farklar p<0,01 olarak bildirilmiştir.
Çalışma neyi kanıtlamamaktadır?
- Çalışma, MGLSDNet’in klinik rehabilitasyonda hasta sonuçlarını iyileştirdiğini göstermemektedir.
- Yeni kullanıcıların kalibrasyon süresinde ölçülmüş bir azalma raporlanmamıştır.
- Gerçek zamanlı protez, tekerlekli sandalye veya yardımcı cihaz kontrolü test edilmemiştir.
- Üretilen EEG örneklerinin fizyolojik gerçekliği bağımsız biyolojik ölçütlerle doğrulanmamıştır.
- Farklı EEG cihazları, farklı laboratuvarlar veya farklı veri kümeleri arasında genelleme gösterilmemiştir.
- Aynı kişide farklı oturumlar arasında oluşan sinyal kaymasına karşı genelleme doğrulanmamıştır.
- 2a veri kümesinde MGLSDNet’in MSVTNet’e üstünlüğü istatistiksel olarak gösterilmemiştir.
- Uzun dönem kullanım, güvenlik, kullanıcı konforu veya ticari uygulanabilirlik değerlendirilmemiştir.
Çalışmanın güçlü yönleri nelerdir?
- Veri artırma ile model düzenlileştirmesini tek bir yöntemsel çerçevede birleştirmektedir.
- İki açık ve yaygın karşılaştırma veri kümesi kullanılmıştır.
- Hedef test deneğinden eğitim verisi kullanmayan denekler arası değerlendirme düzeni uygulanmıştır.
- Veri artırma seçenekleri ve öz-damıtma bileşenleri ayrı deneylerle incelenmiştir.
- Doğruluğa ek olarak standart sapma, Kappa değeri ve eşleştirilmiş t-testi sonuçları verilmiştir.
- Model mimarisi, kayıp fonksiyonları ve temel eğitim hiperparametreleri açıklanmıştır.
Çalışmanın sınırlılıkları ve kaynak içi belirsizlikler nelerdir?
Çalışmanın kendisi üç temel sınırlılığı kabul etmektedir: dalgacık katsayısı seçimi önceden tanımlanmış fizyolojik kabullere bağlıdır, tarihsel öğretmenlerin kullanılması eğitim hesaplama yükünü artırmaktadır ve oturumlar arası genelleme doğrulanmamıştır.
Bunlara ek olarak değerlendirme yalnızca dokuzar denek içeren iki veri kümesine dayanmaktadır. Eşleştirilmiş t-testlerinde etki büyüklüğü, güven aralığı, normal dağılım kontrolü veya çoklu karşılaştırma düzeltmesi raporlanmamıştır. Eğitim süresi, çıkarım gecikmesi, bellek kullanımı, parametre sayısı ve hesaplama maliyeti karşılaştırma tablosu verilmemiştir. Kod deposu veya çalıştırılabilir uygulama bağlantısı da metinde belirtilmemiştir.
Kaynakta bazı iç tutarlılık sorunları vardır. Veri artırma sözde kodu örnekleri “eylem sınıfı + denek kimliği” ile gruplandırarak aynı denek içinden seçim tarif ederken en iyi deney sonuçları farklı deneklerden örnek seçen denekler arası değişime aittir. Sözde kod yalnızca cD2 değişimini göstermekte, deneylerde ise cD1 ve cD2 seçenekleri kullanılmaktadır. Ana metin kararların eşit ortalamayla birleştirildiğini söylerken çıkarım sözde kodu tanımlanmayan \(w_k\) ağırlıklarını kullanmaktadır. Ayrıca 2b veri kümesinin beta ritmi yöntem bölümünde 18–25 Hz, veri artırma yorumunda 13–30 Hz olarak verilmiştir. Bu makalede söz konusu aralıklar birleştirilmemiş veya sessizce düzeltilmemiştir.
Geçmiş, bugün ve gelecek açısından önemi nedir?
Çalışma geçmişte ayrı ayrı kullanılan dalgacık tabanlı veri artırma, çok kollu EEG ağları ve öz-damıtma yaklaşımlarını tek bir denekler arası genelleme sistemi içinde birleştirmektedir. Bugünkü katkısı, veri dağılımını genişletme ile ağın kendi tarihsel bilgisini kullanarak düzenlenmesini birlikte sınayan karşılaştırmalı ve bileşen bazlı deneyler sunmasıdır.
Gelecekte yöntemin dinamik dalgacık katsayısı seçimi, daha hafif öğretmen güncelleme yöntemleri, farklı veri kümeleri, oturumlar arası sinyal kayması ve gerçek zamanlı BCI düzenekleri üzerinde sınanması gerekmektedir. Çalışmanın değeri, uygulamaya hazır bir klinik sistem göstermesinden değil, hedef denekten eğitim verisi almadan EEG sınıflandırmasını geliştirmeye yönelik sınanabilir bir yöntem önermesinden kaynaklanmaktadır.
Çalışmanın Yöntemi ve Bulguları
Kullanılan veri kümeleri ve örnek özellikleri
Aşağıdaki tablo, iki açık motor imgeleme EEG veri kümesinin araştırmada kullanılan temel özelliklerini karşılaştırmaktadır.
| Özellik | BCI Competition IV 2a | BCI Competition IV 2b |
|---|---|---|
| Katılımcı sayısı | 9 denek | 9 sağlıklı denek |
| Görev | Dört sınıflı motor imgeleme | Sol el ve sağ el olmak üzere iki sınıflı motor imgeleme |
| Oturum yapısı | İki oturum; her oturumda 6 koşu ve her koşuda 48 deneme | Beş deney oturumu; ilk üçünde görsel geri bildirim yok, son ikisinde gerçek zamanlı nörogeribildirim var |
| Görev süresi | Her motor imgeleme görevi 4 saniye | Metinde tek deneme süresi ayrıca belirtilmemiştir |
| EEG kanalları | 22 EEG kanalı model girdisi olarak kullanılmıştır | C3, C4 ve Cz olmak üzere 3 EEG kanalı |
| EOG kullanımı | Kaydedilen 3 EOG kanalı analiz dışı bırakılmıştır | EOG kullanımına ilişkin ayrıntı verilmemiştir |
| Örnekleme frekansı | 250 Hz | 250 Hz |
| Filtreleme | 0,5–40 Hz bant geçiren filtre | 2a ile aynı filtreleme parametreleri |
| Öne çıkarılan ritimler | Motor imgeleme ile ilişkili μ ve β ritimleri | μ ritmi 8–12 Hz; β ritmi yöntem bölümünde 18–25 Hz olarak verilmiştir |
Değerlendirme ve eğitim düzeni
| Yöntemsel unsur | Uygulanan değer veya düzen |
|---|---|
| Değerlendirme | Denek dışarıda bırakmalı çapraz doğrulama; her koşuda 7 denek eğitim, 1 denek bağımsız doğrulama ve 1 denek test için kullanılmıştır |
| Yazılım | PyTorch 2.0 |
| Donanım | NVIDIA RTX 4060 Ti GPU ve Intel Core i5-12490F CPU |
| Optimizasyon | Adam; başlangıç öğrenme oranı \(5 \times 10^{-4}\) |
| Azami eğitim | 400 epoch |
| Erken durdurma | Doğrulama doğruluğu 50 ardışık epoch boyunca iyileşmezse eğitim durdurulmuştur |
| Toplu örnek büyüklüğü | 2a için 64; 2b için 96 |
| Düzenlileştirme | Dropout ve toplu normalizasyon |
| Öğretmen güncelleme aralığı | 10 epoch |
| Damıtma sıcaklığı | \(\tau=2{,}0\) |
| Yerel kayıp ağırlığı | \(\alpha=0{,}5\) |
| Dalgacık tabanı | Daubechies 4 (db4) |
| Veri artırma çarpanı | 3 |
| Eklenen düşük gürültü düzeyi | 0,02 |
Karşılaştırılan modeller
MGLSDNet; EEGNet, DeepConvNet, EEGConformer, TIDNet, FBCNet, MSVTNet ve MTMBCNN ile karşılaştırılmıştır. Karşılaştırma grubu kompakt evrişimsel ağları, derin evrişimsel ağları, Transformer tabanlı yapıları, filtre bankası kullanan çok kollu modelleri ve çok görevli EEG sınıflandırma yöntemlerini içermektedir.
Ana sınıflandırma sonuçları
| Veri kümesi | Görev | MGLSDNet doğruluğu | Kappa | En yüksek ortalamalı karşılaştırma modeli | Doğruluk farkı | İstatistiksel karşılaştırma |
|---|---|---|---|---|---|---|
| BCI Competition IV 2a | Dört sınıflı | %58,24 ± 6,67 | 0,4451 | MSVTNet: %57,16 ± 11,51 | +1,08 yüzde puanı | p=0,6507; fark istatistiksel olarak anlamlı değildir |
| BCI Competition IV 2b | İki sınıflı | %76,07 ± 6,10 | 0,5215 | TIDNet: %73,24 ± 6,37 | +2,83 yüzde puanı | p=0,0308; çalışma tarafından anlamlı olarak değerlendirilmiştir |
2a veri kümesinde MGLSDNet, dokuz deneğin beşinde karşılaştırılan yöntemler arasındaki en yüksek doğruluğu vermiştir. En yüksek denek sonuçları A01’de %62,18, A02’de %48,81, A04’te %50,46, A06’da %54,19 ve A07’de %67,02 olarak bildirilmiştir.
2b veri kümesinde model dokuz deneğin sekizinde en yüksek doğruluğa ulaşmıştır. Tek istisna B04 deneğidir; bu denekte MTMBCNN %82,99, MGLSDNet ise %78,41 doğruluk vermiştir. MGLSDNet’in en yüksek denek sonucu B07’de %84,55’tir. Sınıflandırılması zor olarak tanımlanan B03 deneğinde doğruluk %62,33 olarak bildirilmiştir.
Eşleştirilmiş t-testi sonuçları
Aşağıdaki p değerleri, MGLSDNet ile her karşılaştırma yönteminin denek düzeyindeki doğrulukları arasında yapılan eşleştirilmiş t-testlerinden alınmıştır.
| Karşılaştırma yöntemi | 2a veri kümesi p değeri | 2b veri kümesi p değeri |
|---|---|---|
| EEGNet | 0,0015 | 0,0003 |
| DeepConvNet | 0,0022 | 0,0001 |
| EEGConformer | 0,0025 | 0,0014 |
| TIDNet | 0,0010 | 0,0308 |
| FBCNet | 0,0071 | 0,0014 |
| MSVTNet | 0,6507 | 0,0002 |
| MTMBCNN | 0,0001 | 0,0324 |
2a veri kümesinde MSVTNet karşılaştırması dışındaki bütün p değerleri 0,01’in altındadır. 2b veri kümesinde bütün karşılaştırmalar 0,05’in altındadır. Bununla birlikte çalışma çoklu karşılaştırma düzeltmesi veya etki büyüklüğü raporlamadığı için p değerleri tek başına üstünlüğün büyüklüğünü göstermemektedir.
Dalgacık veri artırma yöntemlerinin karşılaştırılması
| Veri kümesi | Veri artırma yok | Denekler arası + cD1 | Denekler arası + cD2 | Denek içi + cD1 | Denek içi + cD2 |
|---|---|---|---|---|---|
| BCI Competition IV 2a | %56,56 ± 6,26 | %58,24 ± 6,67 | %58,16 ± 6,44 | %57,63 ± 6,69 | %57,81 ± 6,52 |
| BCI Competition IV 2b | %74,50 ± 6,35 | %75,88 ± 6,27 | %76,07 ± 6,10 | %75,74 ± 5,72 | %75,36 ± 6,14 |
Veri artırma seçeneklerinin hiçbiri veri artırmasız sürümün altında kalmamıştır. 2a veri kümesinde en yüksek sonuç denekler arası cD1 değişimiyle elde edilmiş ve veri artırmasız modele göre 1,68 yüzde puanı artış sağlanmıştır. 2b veri kümesinde en yüksek sonuç denekler arası cD2 değişimiyle elde edilmiş ve artış 1,57 yüzde puanı olmuştur.
Denekler arası değişimin daha iyi sonuç vermesi, farklı kişilere ait aynı sınıf sinyallerinin birleştirilmesinin eğitim dağılımına daha fazla çeşitlilik kattığı yönündeki araştırmacı yorumunu desteklemektedir. Ancak çalışma, üretilen örneklerin hangi spektral veya morfolojik özelliklerinin başarı artışından sorumlu olduğunu ayrı bir mekanizma deneyiyle ölçmemiştir.
Öz-damıtma bileşenlerinin ablasyon sonuçları
| Yerel öz-damıtma | Küresel öz-damıtma | 2a doğruluğu | 2b doğruluğu |
|---|---|---|---|
| Yok | Yok | %57,21 ± 7,04 | %75,23 ± 6,51 |
| Var | Yok | %57,86 ± 6,87 | %75,76 ± 6,16 |
| Yok | Var | %57,79 ± 6,74 | %75,63 ± 6,22 |
| Var | Var | %58,24 ± 6,67 | %76,07 ± 6,10 |
Yalnızca yerel öz-damıtma, damıtmasız modele göre 2a’da 0,65 ve 2b’de 0,53 yüzde puanı artış sağlamıştır. Yalnızca küresel öz-damıtmanın artışı sırasıyla 0,58 ve 0,40 yüzde puanıdır. İki bileşen birlikte kullanıldığında artış 2a’da 1,03, 2b’de 0,84 yüzde puanına ulaşmıştır. Sonuçlar iki denetim düzeyinin birlikte kullanılmasının tek tek kullanılmalarından daha yüksek ortalama doğruluk verdiğini göstermektedir.
Bulguların genel yorumu
MGLSDNet’in en açık performans üstünlüğü iki sınıflı 2b veri kümesinde görülmektedir. Dört sınıflı 2a veri kümesinde en yüksek ortalama doğruluğu vermesine rağmen MSVTNet ile arasındaki fark anlamlı değildir. Dolayısıyla çalışma, 2a için MGLSDNet’in bütün güçlü yöntemlerden kesin biçimde üstün olduğunu göstermemektedir.
Deneyler veri artırma ve öz-damıtma bileşenlerinin ortalama doğruluğa ayrı ayrı katkıda bulunduğunu göstermektedir. Bununla birlikte kazanımlar çoğunlukla birkaç yüzde puanlık veya bir yüzde puanından düşük değişimlerdir. Sonuçlar umut verici bir yöntemsel iyileştirme olarak değerlendirilebilir; hatasız sınıflandırma, klinik yeterlilik veya gerçek dünya kullanımına hazır bir BCI sistemi anlamına gelmez.
Kaynak ve Yöntem Notu
Çalışmanın tam özgün adı: Enhancing EEG Domain Generalization via Collaborative Data Augmentation and Multi-Scale Self-Distillation
Yazarlar ve doğru sıralama: Xiaoyu Li; Qingshan She; Zhipeng Zhou; Yunyuan Gao; Xugang Xi.
Eş birinci yazar: Çalışmada eş katkı veya eş birinci yazarlık bilgisi belirtilmemiştir.
Sorumlu yazar: Qingshan She. Çalışmada verilen iletişim adresi: qsshe@hdu.edu.cn.
Kurumlar:
- School of Automation, Hangzhou Dianzi University, Hangzhou, Zhejiang 310018, China.
- Zhejiang Provincial Key Laboratory of Brain Computer Collaborative Intelligence Technology and Applications, Hangzhou, Zhejiang 310018, China.
Dergi: Çalışma için hakemli bir dergi bilgisi bulunmamaktadır.
Özgün yayınevi: Hakemli dergi yayınevi bulunmamaktadır; çalışma preprint olarak yayımlanmıştır.
Yayın platformu: SSRN.
Yayın yılı: 2026.
SSRN’de yayımlanma tarihi: 29 Temmuz 2026.
Kaynak türü: Deneysel hesaplamalı yöntem ve veri analizi içeren preprint araştırma makalesi.
Hakemlik durumu: Bu çalışma bir preprinttir ve hakem değerlendirmesinden geçmemiştir. Sonuçları bu sınırlılık dikkate alınarak okunmalıdır.
Resmî kaynak bağlantısı:https://ssrn.com/abstract=7201285
Hakemli sürüm durumu: 5 Ağustos 2026 tarihli bibliyografik kontrolde aynı başlıkla yayımlanmış hakemli bir dergi sürümü doğrulanamamıştır.
Finansman: Çalışmada Zhejiang Provincial Natural Science Foundation of China LZ26F010007 numaralı destek ile National Natural Science Foundation of China 62371172 ve 62371171 numaralı destekler belirtilmiştir. Hangzhou Dianzi Üniversitesi Süper Hesaplama Merkezinin hesaplama kaynağı sağladığı ifade edilmiştir.
Çıkar çatışması: Yazarlar yayınla ilgili çıkar çatışması bulunmadığını beyan etmiştir.
Bu Türkçe makale yüklenen çalışmanın metni, formülleri, tabloları, şekilleri, sözde kodu, tartışması ve sonuç bölümü incelenerek hazırlanmıştır. Çalışmada bulunmayan haricî bilimsel bulgular makaleye eklenmemiş; dış kaynak kontrolü yalnızca DOI, platform, yayın tarihi ve hakemli sürüm durumu gibi bibliyografik kimlik bilgileri için kullanılmıştır.
Temel sınırlılıklar; iki veri kümesiyle sınırlı değerlendirme, veri kümesi başına dokuz denek, klinik veya gerçek zamanlı uygulama bulunmaması, oturumlar arası genellemenin doğrulanmaması, dalgacık katsayısı seçiminin önceden belirlenmiş bantlara dayanması ve öz-damıtmanın eğitim maliyetinin nicel olarak raporlanmamasıdır. Ayrıca kaynakta kırık çapraz başvuru, veri artırma sözde kodu ile denekler arası deney düzeni arasında açıklık sorunu, beta frekans aralıklarında tutarsızlık ve tanımlanmayan çıkarım ağırlıkları bulunmaktadır.
Çalışmanın sonuçları, MGLSDNet’in incelenen iki açık veri kümesindeki denekler arası motor imgeleme EEG sınıflandırmasında karşılaştırmalı performans artışı sağlayabildiğini göstermektedir. Çalışma klinik fayda, güvenli gerçek zamanlı kullanım, endüstriyel ölçek başarısı veya yeni kullanıcılarda kalibrasyon ihtiyacının ortadan kalktığını kanıtlamamaktadır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir