

Katika miradi ya uchakataji wa lugha asilia, mara nyingi umakini huelekezwa kwenye usanifu wa modeli, miundo mikubwa ya lugha au algoriti mpya. Hata hivyo, katika msingi wa mfumo wa AI uliofanikiwa mara nyingi kuna kazi inayoonekana kuchosha zaidi lakini yenye kuamua zaidi: kuzalisha data iliyopewa lebo kwa ubora. Named Entity Recognition, yaani utambuzi wa huluki zilizopewa majina, hulenga kutafuta na kuainisha ndani ya maandishi misemo muhimu ya watu, taasisi, mahali, dawa, sehemu za kiufundi, dhana za kisheria au dhana maalumu za nyanja fulani.
Utafiti huu unazingatia changamoto za vitendo za kuandaa seti ya data ya NER. Mtafiti au mtaalamu wa nyanja fulani hulazimika kuweka lebo kwa kila token ndani ya maandishi. Huluki moja inaweza kujirudia mamia ya mara katika maandishi. Usemi uliochaguliwa kwa mouse huenda usilingane kikamilifu na mipaka ya token inayotumiwa na modeli. Kila token isiyo huluki pia inapaswa kupata lebo ya “O”, yaani Outside. Kazi hizi zinazoonekana ndogo zinaweza kugeuka kuwa mtiririko wa kazi unaochosha unaochukua wiki au miezi katika seti kubwa za data.
AutoLabel-NER inapendekeza suluhisho jepesi, la nje ya mtandao na la chanzo wazi la mezani kwa tatizo hili. Zana haitoi data nje ya kompyuta ya mtumiaji; haihitaji seva, akaunti ya wingu au leseni ya kulipia. Wakati wa kuweka lebo, inaweza kueneza huluki ileile kiotomatiki katika hati nzima, kulinganisha maandishi yaliyochaguliwa na mipaka ya token, kukamilisha token zote zilizobaki kwa lebo ya Outside kwa kubofya mara moja, na kusafirisha matokeo katika format za BIO, JSON, XLSX na CSV.
Tatizo Ni Nini?
Uchakataji wa kisasa wa lugha asilia kwa kiasi kikubwa hutegemea kujifunza kunakosimamiwa. Kujifunza kunakosimamiwa kunahitaji data sahihi na thabiti iliyopewa lebo. Ubora wa seti ya data mara nyingi huamua modeli itatambua huluki gani, itatofautisha dhana gani na itajumlisha kutoka kwa mifano ipi. Kwa sababu hiyo, maandalizi ya data ni hatua muhimu inayokuja kabla ya mafunzo ya modeli.
Katika kazi ya NER, uwekaji lebo ni wa kuchosha zaidi. Kwa sababu haitoshi kuipa sentensi lebo ya jumla; nafasi ya kila token katika maandishi lazima ibainishwe. Token ya kwanza ya usemi wa huluki hupata lebo ya “B”, token zinazoendelea hupata “I”, na token zilizo nje ya huluki hupata lebo ya “O”. Muundo huu hujulikana kama BIO tagging.
Kwa mfano, katika maandishi ya kiufundi, usemi “double-acting cylinder” unaweza kuwa actuator. Katika hali hii “double-acting” huwekewa B-ACTUATOR, na “cylinder” huwekewa I-ACTUATOR. Katika maandishi yaleyale “5/2-way solenoid valve” inaweza kuwa pre-actuator, na “FL limit switch” inaweza kuwa sensor. Maneno yote yaliyobaki lazima pia yapate lebo ya O. Mchakato huu unapofanywa kwa mkono hupungua kasi na huwa rahisi kuzalisha makosa.
Utafiti unasisitiza matatizo matatu ya msingi. La kwanza ni tatizo la kujirudia. Huluki ileile inaweza kuonekana mara nyingi katika hati ileile, na kila mara lazima ipewe lebo ileile. La pili ni tatizo la alignment. Ikiwa kipande cha maandishi kilichochaguliwa na mtumiaji kwa mouse hakilingani kikamilifu na mipaka ya token inayotumiwa na modeli, mpangilio wa BIO unaweza kuwa batili au kuharibika. La tatu ni tatizo la lebo ya Outside. Token zisizo huluki pia zinapaswa kupewa lebo; lakini katika zana nyingi mchakato huu haukamilishwi kiotomatiki na kwa usalama.
Zana zilizopo huenda zisitatue matatizo haya yote kwa wakati mmoja. Zana za wingu zinaweza kutoa kiolesura cha kisasa, lakini zinaweza kuhitaji data nyeti kupakiwa kwenye huduma ya nje. Zana zenye nguvu za wavuti zinaweza kutaka usanidi na usimamizi wa seva. Zana za kibiashara zinaweza kuzuiliwa na leseni ya kulipia. Suluhisho rahisi za spreadsheet au notebook nazo zinaweza kuwa hatari upande wa uonyeshaji, uthabiti na ulinganifu wa BIO.
Mbinu Inapendekeza Nini?
AutoLabel-NER inapendekeza kutatua uzalishaji wa seti za data za NER kwa programu ya mezani inayofanya kazi kwenye kompyuta moja, yenye usakinishaji mwepesi na rafiki kwa faragha. Zana imejengwa juu ya usanifu wa tabaka nne: tabaka la uwasilishaji, tabaka la uchakataji wa kiisimu, injini ya uwekaji lebo, na tabaka la uhifadhi/usafirishaji.
Tabaka la uwasilishaji ni kiolesura cha picha ambacho mtumiaji hutumia kuweka lebo. Limeandaliwa kwa CustomTkinter. Kiolesurani kuna eneo la maandishi, vifungo vya lebo, orodha ya huluki, upau wa hali, kiashiria cha maendeleo, chaguo za mandhari na zoom. Mtumiaji anaweza kufafanua lebo kulingana na nyanja yake; kwa mfano katika sheria “MAHAKAMA”, “SHERIA”, “WAHUSIKA”; katika afya “DAWA”, “UGONJWA”, “TIBA”; katika viwanda “SENSA”, “AKTUA”, “KIPENGELE” kama lebo maalumu.
Tabaka la uchakataji wa kiisimu hutumia tokenization ya sentensi na maneno inayotegemea NLTK. Mojawapo ya kazi muhimu zaidi ni kuunganisha eneo la maandishi lililochaguliwa kwenye skrini na mipaka ya token katika maandishi ya chanzo. Bila alignment hii, hata kama mtumiaji anadhani amechagua neno sahihi, faili ya BIO inayosafirishwa inaweza kuwa na makosa kwa mafunzo ya modeli.
Injini ya uwekaji lebo ndiyo kituo cha tija cha zana. Huzuia mwingiliano wa huluki zilizochaguliwa, husafisha nafasi zilizoachwa kimakosa, huweka lebo kiotomatiki kwa marudio ya huluki ileile katika hati nzima, hukamilisha token zilizobaki kwa Outside katika operesheni moja, na husimamia historia ya undo/redo. Muundo huu unalenga kutoa kasi na uthabiti kwa wakati mmoja.
Tabaka la uhifadhi na usafirishaji huhifadhi hali yote ya mradi katika faili ya ndani ya JSON. Maandishi ya chanzo, skima ya lebo, rangi na spans zilizowekwa alama huhifadhiwa katika faili ileile ya mradi. Uwekaji lebo unapokamilika, zana huzalisha matokeo katika format za BIO, JSON, XLSX na CSV. Matokeo ya BIO yanaendana moja kwa moja na maktaba maarufu za mafunzo ya NER kama Hugging Face Transformers, spaCy na Flair.
Formule Zinasema Nini?
Katika utafiti hakuna fomula ya hisabati kwa maana ya modeli ya kawaida. Makala hii ni utafiti wa zana ya programu na mtiririko wa kazi. Hata hivyo, mantiki ya uwekaji lebo wa NER, skima ya BIO na mchakato wa kuzalisha seti ya data vinaweza kuelezwa kwa vielelezo rahisi.
Kazi ya NER kwa jumla inaweza kufikiriwa hivi:
Skima ya uwekaji lebo ya BIO ina hali tatu za msingi:
Hapa \(B\) huwakilisha mwanzo wa usemi wa huluki; \(I\) huwakilisha mwendelezo wa huluki ileile; \(O\) huwakilisha token isiyokuwa sehemu ya huluki yoyote.
Kwa usemi wa huluki wenye maneno mengi, muundo unaweza kuonyeshwa hivi:
Hapa \(X\) huwakilisha darasa la lebo. Kwa mfano ikiwa \(X=\text{ACTUATOR}\), token ya kwanza hupata lebo ya \(B\text{-ACTUATOR}\), na token zinazofuata hupata lebo ya \(I\text{-ACTUATOR}\).
Mantiki ya usambazaji wa marudio kiotomatiki ya AutoLabel-NER inaweza kufupishwa kwa urahisi hivi:
Kukamilisha token zilizobaki kunaweza kufikiriwa hivi:
Kauli hizi hazikutolewa katika utafiti kama fomula za hisabati za neno kwa neno; ni vielelezo vya kihariri vinavyorahisisha mantiki ya uwekaji lebo wa data ya AutoLabel-NER kwa msomaji wa Verianla.
Ujumbe Mkuu wa Grafu, Jedwali na Skima
Jedwali la metadata ya msimbo linaonyesha kuwa AutoLabel-NER imewekwa kama programu ya utafiti ya vitendo. Zana imetolewa katika toleo la v1.0.0; inashirikiwa kupitia GitHub, ina leseni ya MIT, hufanya kazi na Python 3.8 na zaidi, na hutumia CustomTkinter, NLTK, pandas, openpyxl na PyInstaller. Kutolewa kwa faili tekelezi huru kwa Windows hurahisisha hata watumiaji wasio wa kiufundi kuifungua na kuitumia zana.
Ujumbe mkuu wa jedwali la ulinganisho ni kwamba AutoLabel-NER inalenga pengo lililopo kati ya zana zilizopo. Zana kama Doccano na Label Studio zinaweza kutoa kiolesura chenye nguvu; zana kama BRAT na INCEpTION zina ufanisi kwa uwekaji lebo wa kitaaluma; zana za kibiashara kama Prodigy zimesanifiwa vizuri. Hata hivyo, dai la AutoLabel-NER ni kuunganisha katika zana moja jepesi ya mezani vipengele vya kufanya kazi kikamilifu nje ya mtandao, kutohitaji seva, kuhifadhi data ndani, tokenization ya NLTK, usambazaji wa lebo kiotomatiki, kusafisha nafasi, kukamilisha lebo ya Outside kwa mbofyo mmoja na usafirishaji wa BIO wa asili.
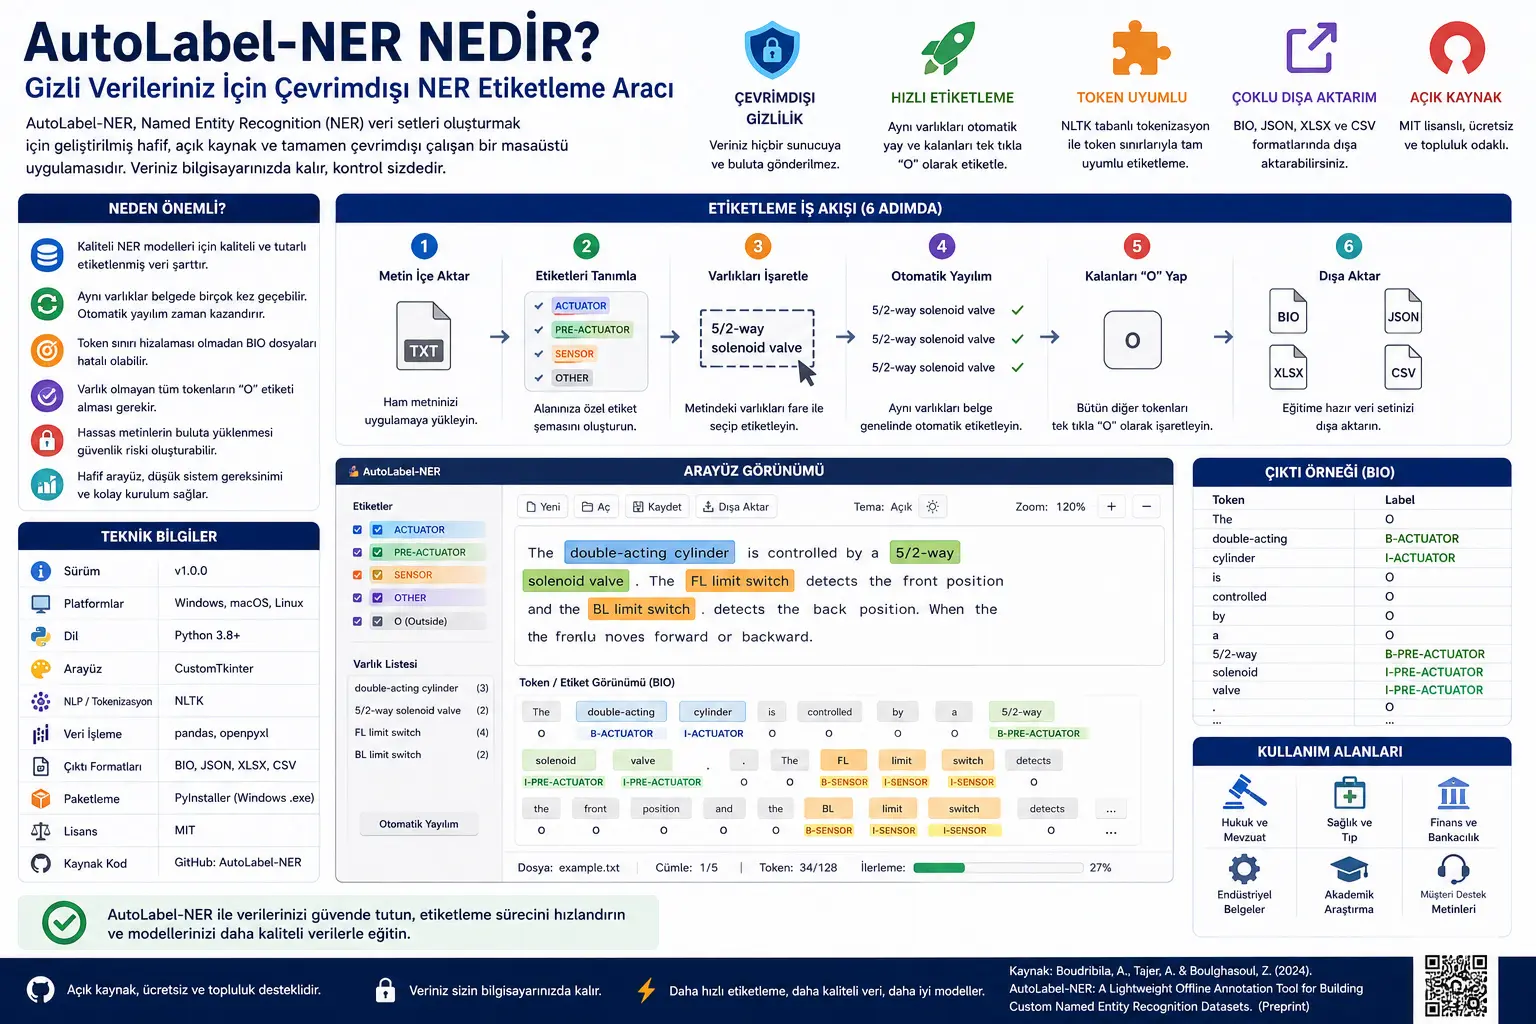
Skima ya usanifu wa tabaka nne inaonyesha wazi mtiririko wa kazi wa zana. Maandishi ghafi kwanza huingia kwenye kiolesura cha mtumiaji. Kisha tabaka la uchakataji wa kiisimu linalotegemea NLTK hufanya sentensi, maneno na ulinganishaji wa nafasi za herufi. Injini ya uwekaji lebo huendesha auto-tagging, kukamilisha Outside, udhibiti wa mwingiliano na operesheni za undo/redo. Tabaka la mwisho husafirisha data katika format za JSON, XLSX, CSV na BIO.
Skima ya mtiririko wa kazi ya hatua sita inaonyesha jinsi mtumiaji hutoka kwenye maandishi ghafi hadi data ya mafunzo: maandishi huingizwa, lebo hufafanuliwa, huluki huwekewa alama kwa mkono, lebo zilezile huenezwa kwa mifano inayofanana, token zilizobaki huwekwa kama O na seti ya data husafirishwa. Jambo muhimu katika mtiririko huu ni kuunganisha hatua zinazohitaji uamuzi wa binadamu na hatua za tija ya kiotomatiki.
Picha ya kiolesura inaonyesha kuwa programu si backend ya kiufundi tu; inalenga mtiririko halisi wa kazi wa mtumiaji kwa vifungo vya lebo, vivutio vya rangi, orodha ya huluki na kiashiria cha maendeleo. Picha ya matokeo ya BIO nayo inaonyesha kuwa zana haifanyi tu uwekaji alama wa kuona, bali huzalisha matokeo ya kiwango cha token yanayoweza kuingia moja kwa moja katika mafunzo ya modeli.
Majaribio Yalifanywaje?
Utafiti hautoi jaribio la kawaida la kujifunza kwa mashine; zaidi ni utambulisho wa zana ya programu, onyesho la mtiririko wa kazi na tathmini ya athari ya matumizi. Kwa hiyo badala ya ulinganisho wa usahihi wa modeli, mchango wa vitendo wa zana katika mchakato wa kuzalisha seti ya data ya NER unaelezwa.
Kwanza, uwekaji lebo wa mfano hufanywa kupitia sentensi fupi ya masharti ya kiufundi. Katika sentensi hiyo, misemo maalumu ya nyanja kama “double-acting cylinder”, “5/2-way solenoid valve”, “FL limit switch” na “BL limit switch” huwekewa lebo. Lengo ni kuonyesha jinsi huluki za kiufundi kama actuator, pre-actuator na sensor zinavyowekwa alama.
Mtumiaji huingiza maandishi, hufafanua lebo, huchagua mifano ya kwanza ya huluki na kutoa lebo zinazofaa. Kipengele cha Auto-tagging kinapowashwa, marudio ya huluki ileile ndani ya hati huwekewa lebo kiotomatiki. Kisha operesheni ya “Label Rest as O” hukamilisha token zote zisizopewa lebo kwa lebo ya Outside. Katika hatua ya mwisho, zana huzalisha matokeo ya BIO, JSON, XLSX na CSV.
Utafiti pia unataja mfano wa matumizi kwa kiwango kikubwa zaidi. AutoLabel-NER ilitumika kuzalisha korpasi ya NER maalumu kwa nyanja iliyotokana na specifications za mahitaji ya viwandani. Korpasi hii ina specifications elfu kadhaa, makumi ya maelfu ya sentensi na mamia ya maelfu ya token. Katika sehemu ndogo ya uthibitishaji iliyoshirikiwa, inter-annotator agreement yenye nguvu iliripotiwa; yaani wawekaji lebo tofauti waliweza kutoa lebo zinazolingana kwa kiasi kikubwa.
Inaelezwa kuwa matokeo ya BIO yaliyotokana na seti hii ya data yalitumiwa fine-tune miundo ya NER inayotegemea transformer bila hitaji la ubadilishaji wa kati, na modeli bora ilifikia skor ya F1 ya 0.9721 kwenye test set iliyotengwa. Matokeo haya yanaonyesha kuwa zana haitoi urahisi wa kiolesura pekee; pia inachangia kuzalisha data thabiti na inayotumika kwa mafunzo ya modeli.
Matokeo Yanaonyesha Nini?
Matokeo ya kwanza ni kwamba katika miradi ya NER, uwekaji lebo wa data si jambo lisilo muhimu kuliko usanifu wa modeli. Bila mipaka sahihi ya token, mpangilio thabiti wa BIO na lebo kamili za O, hata modeli yenye nguvu zaidi ya transformer inaweza kufundishwa kwa data yenye makosa au isiyo thabiti.
Matokeo ya pili ni kwamba kufanya kazi nje ya mtandao kuna thamani muhimu katika baadhi ya nyanja. Maandishi kama noti za kliniki, hati za kisheria, ripoti za ndani za kampuni, nyaraka za kifedha au specifications za viwandani huenda yasiwezi kupakiwa kwenye wingu la umma. AutoLabel-NER hurahisisha utafiti katika hali kama hizi kwa kuweka data kwenye kompyuta ya ndani.
Matokeo ya tatu ni kwamba usambazaji wa lebo kiotomatiki unaweza kupunguza kwa kiasi kikubwa mzigo wa marudio. Ikiwa huluki ileile inaonekana katika sehemu nyingi za hati, kuiweka alama moja moja kwa mkono huleta upotevu wa muda na hatari ya kutokuwa thabiti. Exact-string label propagation hupunguza marudio haya kwa kiasi kikubwa.
Matokeo ya nne ni kwamba alignment ya token ni suala lisiloonekana lakini la msingi la ubora. Chaguo linaloonekana sahihi katika kiolesura cha mtumiaji linaweza kuharibu faili ya BIO ikiwa halilingani na tokenization ya modeli. Tokenization ya NLTK na alignment ya nafasi za herufi katika AutoLabel-NER inalenga kupunguza hatari hii.
Matokeo ya tano ni kwamba usafirishaji wa kiwango sanifu huharakisha mtiririko wa utafiti. Kupata matokeo ya BIO, JSON, XLSX na CSV kutoka zana moja hurahisisha mpito kwenda maktaba kama Hugging Face Transformers, spaCy na Flair. Hivyo makosa ya kimya yanayoweza kutokea wakati watafiti wanaandika scripts za kubadilisha data yanaweza kupungua.
Kwa Nini Hili Ni Muhimu?
Utafiti huu unaonyesha jambo ambalo mara nyingi husahauliwa katika miradi ya AI: ikiwa miundombinu ya kuweka lebo kwenye data si imara, mafanikio ya modeli pia huwa dhaifu. Hasa katika nyanja maalumu, mara nyingi hakuna seti ya data iliyo tayari. Watafiti wanaotaka kufundisha modeli kwenye maandishi ya tiba, sheria, fedha au viwanda mara nyingi hulazimika kuunda seti yao ya data.
Umuhimu wa zana kama AutoLabel-NER hujitokeza hapa. Zana haipendekezi modeli kubwa; lakini hurahisisha kuzalisha data safi ambayo modeli inaweza kujifunza. Hili ni muhimu kwa mtazamo wa AI inayozingatia data. Kwa sababu utendaji wa modeli unapaswa kuboreshwa si kwa usanifu pekee, bali pia kwa ubora wa data.
Kipengele cha faragha pia ni muhimu. Taasisi ya afya huenda isiweze kupakia noti za wagonjwa, kampuni nyaraka zake za kiufundi, timu ya sheria mafaili ya kesi au taasisi ya fedha ripoti zake kwenye huduma ya wingu ya nje. Zana ya kuweka lebo inayofanya kazi nje ya mtandao na ndani ya kompyuta hufungua mlango wa vitendo kwa utafiti na uundaji wa modeli katika nyanja hizi.
Thamani ya kihandisi ya utafiti pia haipaswi kudharauliwa. Programu nzuri ya utafiti si kuzalisha algoriti ngumu pekee; wakati mwingine ni kutoa otomatiki ndogo sahihi katika sehemu sahihi. Kukamilisha lebo ya O kwa mbofyo mmoja, kusafisha nafasi, alignment ya mipaka ya token na kusambaza huluki ileile ni vipengele vinavyoweza kuleta tofauti kubwa ya muda na ubora katika miradi mikubwa ya uwekaji lebo wa data.
Hoja za Kuzingatia
Hoja ya kwanza ya kuzingatia ni kwamba utafiti ni preprint. Kwa sababu haujapitia tathmini ya rika, madai ya programu, wigo na matokeo ya tathmini yanaweza kubadilika baadaye. Kwa hiyo utafiti unapaswa kusomwa kama utambulisho wa programu ya utafiti yenye matumaini.
Hoja ya pili ni kwamba mkakati wa uwekaji lebo kiotomatiki wa zana unategemea exact-string matching. Kunasa mfululizo uleule wa maneno huharakisha marudio; lakini udhibiti wa mtumiaji unahitajika katika matching zinazobeba maana tofauti kulingana na muktadha. Kila usambazaji wa kiotomatiki haupaswi kukubaliwa kama sahihi.
Hoja ya tatu ni kwamba ubora wa uwekaji lebo wa NER hautegemei zana pekee. Mwongozo wa lebo, mafunzo ya wawekaji lebo, utaalamu wa nyanja, utatuzi wa migongano na itifaki ya udhibiti wa ubora bado vinahitajika. Zana inaweza kuwa nzuri; lakini skima ya lebo iliyofafanuliwa vibaya bado inaweza kuzalisha data isiyo thabiti.
Hoja ya nne ni kwamba tokenization ya NLTK huenda isiwe bora kwa kila lugha na kila nyanja. Inaweza kutoa matokeo mazuri katika maandishi ya kiufundi ya Kiingereza; lakini katika Kituruki, Kiarabu, maandishi yaliyochanganya msimbo, vifupisho vya kitabibu au nyanja zenye alama maalumu, tokenization inapaswa kujaribiwa tofauti.
Hoja ya tano ni kwamba kufanya kazi nje ya mtandao ni muhimu kwa faragha lakini peke yake haimaanishi usalama kamili. Ruhusa za faili kwenye kompyuta ya ndani, usimbaji wa diski, kuhifadhi nakala, udhibiti wa ufikiaji na kushiriki salama mafaili ya mradi lazima vifikiwe pia.
Hitimisho
Utafiti huu unatukumbusha jinsi maandalizi ya data yalivyo ya msingi katika miradi ya uchakataji wa lugha asilia. AutoLabel-NER inapendekeza zana ya mezani ya nje ya mtandao, chanzo wazi na nyepesi kwa watafiti wanaotaka kuunda seti za data za NER katika nyanja maalumu.
Upande imara wa zana ni kwamba inajaribu kutatua matatizo matatu ya vitendo ndani ya mtiririko mmoja wa kazi: kuweka lebo tena na tena kwa huluki zinazojirudia, kutolingana kati ya chaguo la mtumiaji na mipaka ya token, na kukamilisha token zilizo nje ya huluki kwa lebo ya O. Inapoongezwa msaada wa usafirishaji wa BIO, JSON, XLSX na CSV, mpito kutoka maandishi ghafi hadi mafunzo ya modeli unakuwa wa mpangilio zaidi.
Kwa mtazamo wa Verianla, ujumbe mkuu wa utafiti ni huu: mafanikio katika AI hayatokani tu na modeli kubwa. Hasa katika nyanja maalumu, kuzalisha seti ya data inayoaminika ni kazi ya kimkakati kama uundaji wa modeli. AutoLabel-NER ni zana ya vitendo ya utafiti inayolenga kufanya “kazi hii ya data” iwe ya haraka zaidi, salama zaidi na inayorudiwa kwa urahisi zaidi.
Chanzo na Dokezo la Mbinu
Maudhui haya yameandaliwa kwa msingi wa utafiti wa preprint ulioandikwa na Abderrahmane Boudribila, Abdelouahed Tajer na Zakaria Boulghasoul wenye kichwa “AutoLabel-NER: A Lightweight Offline Annotation Tool for Building Custom Named Entity Recognition Datasets”. Utafiti unaitambulisha zana ya AutoLabel-NER yenye vipengele vya kuweka lebo za NER nje ya mtandao, BIO tagging, alignment ya token inayotegemea NLTK, usambazaji wa lebo kiotomatiki, kukamilisha lebo ya Outside, uhifadhi wa mradi ndani na usafirishaji wa data katika viwango sanifu.
Maudhui haya si tafsiri ya neno kwa neno; wazo kuu la utafiti limerahisishwa na kugeuzwa kuwa makala ya kihariri ya Kiswahili kulingana na mstari wa uchapishaji wa Verianla.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *