

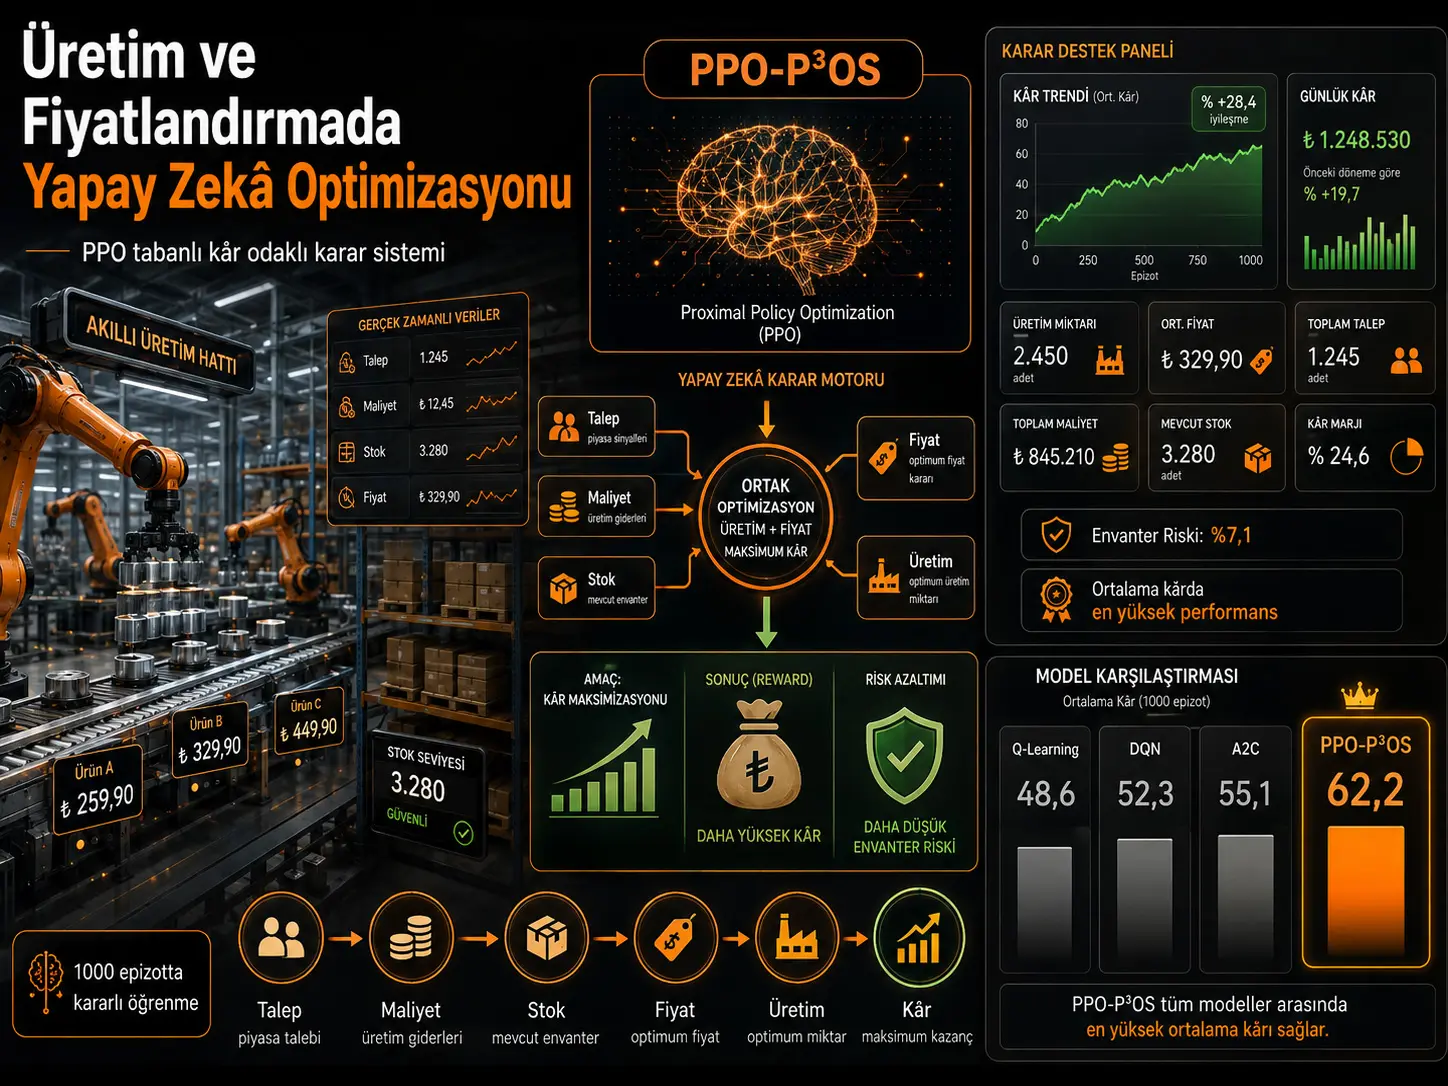
Mtengenezaji anapaswa kuzalisha vitengo vingapi leo na kuuza bidhaa kwa bei gani? Ikiwa mahitaji, gharama za malighafi na kiwango cha hisa hubadilika kila mara, maamuzi haya mawili hayawezi kufanywa kwa kujitegemea. Utafiti huu unapendekeza mfumo wa kujifunza kwa kuimarisha unaoweza kurekebisha kiasi cha uzalishaji na bei ya mauzo kwa wakati mmoja, huku ukiwa na lengo la kuongeza faida ya muda mrefu na kupunguza hatari ya hisa. Mfumo ambao watafiti wameuita PPO-P³OS unatumia algoriti ya Proximal Policy Optimization (PPO). Wakala wa akili bandia katika kila hatua ya uamuzi huangalia gharama ya uzalishaji, mahitaji ya soko, kiwango cha hisa kilichopo na bei ya bidhaa; kisha hutoa maamuzi yenye thamani endelevu kuhusu bei mpya na kiasi cha uzalishaji.
Mfano unafafanua tatizo la uzalishaji na uwekaji bei kama Mchakato wa Uamuzi wa Markov (MDP). Kazi ya zawadi hujaribu kuongeza marja inayopatikana kutokana na bidhaa zilizouzwa huku ikipunguza kutolingana kati ya mahitaji na uzalishaji/hisa kwa adhabu ya mraba. Katika masimulizi yaliyofanywa kwa mchanganyiko wa data halisi na sintetiki unaoripotiwa kuwa na takriban sampuli 36.000, PPO-P³OS inalinganishwa na Q-Learning, Deep Q-Network (DQN) na Advantage Actor-Critic (A2C). Kulingana na Jedwali la 1, faida ya wastani imeripotiwa kuwa 62,2×10³ USD kwa PPO-P³OS, 55,1×10³ USD kwa A2C, 52,3×10³ USD kwa DQN na 48,6×10³ USD kwa Q-Learning.
Hata hivyo, utafiti haujathibitishwa kama mfumo wa moja kwa moja wa kufanya maamuzi katika kiwanda halisi. Sehemu halisi ya seti ya data inategemea rekodi za ERP na MES kutoka kwa mtengenezaji wa bidhaa za matumizi wa ukubwa wa kati katika kipindi cha 2021–2023, huku seti nzima ya data ikiwa imepanuliwa kwa data za simulizi za sintetiki. Kwa kuwa uwiano wa data halisi na sintetiki pamoja na mbinu ya kuzalisha data sintetiki haujaelezwa kwa kina cha kutosha, matokeo yanapaswa kutazamwa kama mafanikio ya simulizi/benchmark; haiwezi kuhitimishwa moja kwa moja kwamba ongezeko hilo hilo la faida litapatikana katika viwanda halisi.
Kwa nini kiasi cha uzalishaji na bei vinapaswa kuzingatiwa pamoja?
Katika biashara ya uzalishaji, bei si uamuzi huru wa idara ya masoko pekee, wala kiasi cha uzalishaji si uamuzi huru wa kiwanda pekee. Bei huathiri mahitaji; mahitaji hubadilisha hitaji la uzalishaji; kiasi cha uzalishaji huathiri hisa na gharama; na gharama zinapobadilika, kiwango cha bei kinachokubalika hubadilika tena.
Kwa mfano, wakati mahitaji yako chini kuliko ilivyotarajiwa, kuweka uzalishaji katika kiwango cha juu kunaweza kusababisha mkusanyiko wa hisa. Ikiwa gharama ya uzalishaji inaongezeka huku bei ya mauzo haibadiliki, marja ya faida kwa kila kitengo inaweza kupungua. Bei ikiwekwa juu kupita kiasi, mahitaji yanaweza kupungua. Bei ikiwekwa chini kupita kiasi, faida inaweza kuathirika hata kama kiasi cha mauzo kinaongezeka.
Msingi wa utafiti ni kwamba uhusiano kati ya vigezo hivi si wa mstari wala wa kudumu. Kwa hiyo, badala ya kutumia mbinu tuli inayotafuta tu optimum ya kihisabati katika wakati fulani, watafiti wanatumia wakala wa kujifunza kwa kuimarisha anayepokea mrejesho kutoka kwenye mazingira na kujifunza sera kadiri muda unavyopita.
PPO-P³OS ni nini?
PPO-P³OS ni kifupi cha Profit-Oriented Production and Pricing Optimization System kinachotumiwa katika utafiti. Mfumo unabadilisha algoriti ya Proximal Policy Optimization kwa tatizo la uchumi wa uzalishaji.
Katika Kielelezo cha 1, mfano unaonyeshwa kwa vizuizi vinne vya msingi:
- Hali (State): gharama ya uzalishaji, kiwango cha hisa, mahitaji ya soko na bei ya sasa,
- Sera ya PPO: sera iliyojifunza inayotathmini hali ya sasa na kutoa uamuzi,
- Kitendo (Action): bei iliyorekebishwa na kiasi cha uzalishaji,
- Zawadi (Reward): mrejesho unaotathmini faida na hatari ya hisa kwa pamoja.
Wakala hujifunza kutokana na zawadi anazopokea na kuelekea kwenye mchanganyiko wa bei–uzalishaji utakaoleta jumla ya zawadi ya juu zaidi kwa muda mrefu.
Ni taarifa gani zimo katika nafasi ya hali?
Katika hatua ya t ya muda, vekta ya hali inafafanuliwa katika utafiti kama ifuatavyo:
\[ s_t=[C_t,D_t,I_t,P_t] \]
Hapa:
- Ct: gharama ya uzalishaji kwa kila kitengo,
- Dt: mahitaji ya soko,
- It: kiwango cha hisa kilichopo,
- Pt: bei ya sasa ya bidhaa.
Vigezo hivi vinne vinaunda muhtasari wa mazingira ya kiuchumi ya wakati huo kwa wakala.
Akili bandia hufanya maamuzi gani?
Vekta ya kitendo:
\[ a_t=[p_t,q_t] \]
iko katika umbo hili. Katika chanzo, pt inawakilisha marekebisho ya bei, huku qt ikiwakilisha marekebisho ya uzalishaji.
Tofauti muhimu ya kiufundi hapa ni kwamba maamuzi hayalazimiki kuchagua tu mojawapo ya chaguo chache zilizofafanuliwa mapema kama ilivyo kwa DQN. Kwa kuwa PPO inaweza kufanya kazi katika nafasi za vitendo endelevu, inaweza kuiga bei na kiasi cha uzalishaji kama vigezo endelevu.
Kazi ya zawadi ya mfano inaoptimiza nini?
Katika utafiti, zawadi inafafanuliwa kama ifuatavyo:
\[ r_t=(p_t-C_t)\cdot \min(q_t,D_t)-\lambda(I_t+q_t-D_t)^2 \]
Kipengele cha kwanza kinawakilisha mapato ya kiuchumi yanayotokana na mauzo. min(qt,Dt) ni muundo uliorahisishwa ambapo kiasi kinachoweza kuuzwa kinawekewa kikomo na thamani ndogo kati ya uzalishaji na mahitaji.
Kipengele cha pili:
\[ \lambda(I_t+q_t-D_t)^2 \]
kinaadhibu kutolingana kwa hisa. λ inapoongezeka, wakala huwa nyeti zaidi kwa kutolingana kwa hisa.
Kwa sababu ya adhabu ya mraba, kadiri tofauti kati ya mahitaji na hisa iliyopo pamoja na uzalishaji inavyoongezeka, ndivyo adhabu inavyoongezeka haraka. Hivyo mfumo haujaribu tu kuongeza marja ya muda mfupi ya mauzo, bali pia unajumuisha usimamizi wa hisa katika kazi ya zawadi.
Lengo la muda mrefu ni nini?
Lengo la wakala wa PPO ni kuongeza hadi kiwango cha juu jumla ya zawadi iliyopunguzwa kwa discount:
\[ J(\theta)=E_t\left[\sum_{t=0}^{T}\gamma^t r_t\right] \]
Hapa γ ni mgawo wa discount. Katika majaribio, γ = 0,99 ilitumika. Thamani hii ya juu inaonyesha kwamba mfano umewekwa ili kuzingatia si uamuzi unaofuata tu, bali pia matokeo ya kiuchumi ya baadaye.
Kwa nini PPO ilichaguliwa?
PPO ni algoriti ya gradient ya sera. Lengo kuu ni kufanya ujifunzaji uwe thabiti zaidi kwa kuzuia sera kufanya mabadiliko makubwa kupita kiasi katika kila hatua ya mafunzo.
Kazi ya lengo ya PPO iliyokatwa iliyotumiwa katika utafiti:
\[ L^{CLIP}(\theta) = E_t \left[ \min \left( r_t(\theta)\hat{A}_t, \operatorname{clip}(r_t(\theta),1-\epsilon,1+\epsilon)\hat{A}_t \right) \right] \]
imetolewa kwa namna hiyo.
Uwiano wa uwezekano hapa:
\[ r_t(\theta)= \frac{\pi_\theta(a_t|s_t)} {\pi_{\theta_{old}}(a_t|s_t)} \]
unalinganisha msongamano wa uwezekano unaotolewa kwa kitendo kilekile na sera mpya na sera ya zamani. ε = 0,2 kigezo cha kukata husaidia kuzuia sasisho kuwa kubwa kupita kiasi.
Generalized Advantage Estimation hufanya nini?
Mfano hutumia Generalized Advantage Estimation (GAE) katika kukadiria thamani ya advantage. Katika chanzo:
\[ \hat A_t= \delta_t+ (\gamma\lambda)\delta_{t+1} +\ldots+ (\gamma\lambda)^{T-t+1}\delta_{T-1} \]
na:
\[ \delta_t=r_t+\gamma V(s_{t+1})-V(s_t) \]
misemo hiyo imetolewa.
Katika majaribio, λ = 0,95 ilichaguliwa kwa GAE. Lengo ni kuweka uwiano unaofaa kati ya upendeleo na variance katika ukadiriaji wa advantage.
Actor na Critic hufanya nini?
PPO-P³OS ina vipengele viwili vya mtandao wa neva.
Actor, huwakilisha sera inayotoa maamuzi ya bei na uzalishaji kutoka katika hali ya sasa. Vitendo endelevu vinaigwa kupitia mgawanyo wa Gaussian.
Critic kwa upande mwingine hujifunza kazi ya thamani inayokadiria zawadi inayoweza kutarajiwa siku zijazo kuanzia katika hali fulani.
Katika usanidi wa majaribio, imeelezwa kuwa tabaka mbili zilizofichwa zina neva 256 na 128 na kwamba uamilishaji wa ReLU umetumiwa. Katika sehemu ya mbinu, mitandao pia inaelezwa kama “tabaka tatu zilizounganishwa kikamilifu”; chanzo hakibainishi wazi iwapo kinahesabu tabaka la matokeo.
Mfano ulifundishwaje?
| Kigezo | Thamani iliyotolewa katika chanzo |
|---|---|
| Programu | PyTorch 2.2 |
| Vipindi vya mafunzo | 1000 |
| Hatua za muda kwa kila kipindi | 200 |
| Tabaka zilizofichwa | neva 256 na 128 |
| Uamilishaji | ReLU |
| Kiwango cha ujifunzaji | 3 × 10⁻⁴ |
| Mgawo wa discount γ | 0,99 |
| Uwiano wa PPO clip ε | 0,2 |
| Ukubwa wa batch | 128 |
| GAE λ | 0,95 |
| Idadi ya kurudia majaribio | 5 |
Kwa vifaa, ilitumika prosesa ya Intel Core i9-13900K, 64 GB RAM na NVIDIA RTX 4090 GPU.
Je, seti ya data kweli ni data ya kiwanda?
Kwa sehemu. Utafiti unaielezea seti ya data kama mchanganyiko wa data halisi za biashara na data sintetiki za simulizi.
Inaelezwa kuwa sehemu ya data halisi ilitoka kwenye rekodi za ERP na Manufacturing Execution System (MES) za biashara ya uzalishaji wa bidhaa za matumizi ya ukubwa wa kati katika kipindi cha 2021–2023.
Hata hivyo, jina la kampuni, nchi ilipo, maelezo ya bidhaa na uwiano wa rekodi halisi ndani ya jumla ya sampuli 36.000 havijatolewa. Licha ya kipindi cha karibu miaka mitatu cha data halisi, imeandikwa kuwa seti nzima ya data ina takriban sampuli 36.000 na kwamba kila sampuli inawakilisha “hali ya operesheni ya siku moja”. Kwa hiyo ukubwa na mbinu ya upanuzi wa sintetiki katika seti ya data ni jambo muhimu kwa uzalishaji upya wa matokeo, lakini halijaelezwa vya kutosha.
Ni vigezo gani vimo katika data?
Watafiti wanaripoti vipengele 12 vya kiasi na viwili vya kikategoria.
Vigezo vya uzalishaji:
- kiasi cha uzalishaji wa kila siku,
- kiwango cha matumizi ya mashine,
- upatikanaji wa malighafi.
Vigezo vya soko:
- mahitaji ya soko,
- bei ya wastani ya washindani,
- kiashiria cha msimu.
Vigezo vya gharama:
- gharama ya uzalishaji kwa kila kitengo,
- gharama ya nishati,
- gharama ya usafirishaji.
Vigezo vya faida:
- bei halisi ya mauzo,
- faida ya kila siku,
- kiwango cha hisa.
Vigezo vya kikategoria ni aina ya bidhaa na eneo la soko. Imeelezwa kwamba vipengele vilinormalishwa kwa mbinu ya min–max scaling.
Tabaka la uchanganuzi wa biashara linaongeza nini?
Utafiti haulengi tu sera ya PPO kutoa vitendo, bali pia kutafsiri maamuzi yaliyojifunzwa kwa dhana za kiuchumi kama elasticity ya mahitaji na gharama ya ukingo.
Hata hivyo, chanzo hakitoi jedwali tofauti la uthibitishaji, kipimo cha explainability au utafiti wa watumiaji uliofanywa na mameneja kuhusu tabaka hili la “business analytics”. Kwa hiyo sehemu ya usaidizi wa maamuzi unaoweza kuelezeka ni mojawapo ya malengo ya muundo wa mfano; si moduli tofauti iliyotathminiwa kwa kina kwa majaribio.
Matokeo muhimu zaidi ya nambari katika makala ni yapi?
Jedwali la 1 linalinganisha mbinu nne:
| Mfano | Faida ya wastani (×10³ USD) | Variance ya faida (%) | Hatari ya hisa (%) | Hasara ya mwisho | Tathmini ya convergence |
|---|---|---|---|---|---|
| Q-Learning | 48,6 | 12,5 | 10,7 | 0,61 | Wastani |
| DQN | 52,3 | 9,8 | 9,3 | 0,47 | Wastani |
| A2C | 55,1 | 7,0 | 8,5 | 0,36 | Thabiti |
| PPO-P³OS | 62,2 | 6,0 | 7,1 | 0,23 | Thabiti sana |
Ongezeko la faida la %12,8 linahesabiwa dhidi ya nini hasa?
Kuna kutolingana katika maandishi ya makala yenyewe hapa.
Kwa kutumia Jedwali la 1, tofauti ya faida kati ya PPO-P³OS na mshindani bora A2C ni:
\[ \frac{62.2-55.1}{55.1}\times100 \approx 12.9\% \]
Hii inaendana na kauli katika sehemu ya matokeo kwamba ni “takriban %12,8 dhidi ya baseline bora A2C”.
Lakini DQN ikitumika kama baseline:
\[ \frac{62.2-52.3}{52.3}\times100 \approx 18.9\% \]
hupatikana.
Kwa hiyo, kuwasilisha thamani ya %12,8 dhidi ya DQN katika muhtasari na sehemu za matokeo hakuendani na Jedwali la 1.
Je, tatizo hilo hilo lipo katika hatari ya hisa?
Ndiyo. Hatari ya hisa ya A2C ni %8,5 na ya PPO-P³OS ni %7,1:
\[ \frac{8.5-7.1}{8.5}\times100 \approx 16.5\% \]
Thamani hii inaendana na dai la %16,4 katika makala na inaonyesha kuwa baseline ni A2C.
Ikiwa thamani ya DQN ya %9,3 itatumika, upungufu wa PPO-P³OS huwa takriban %23,7. Kwa hiyo %16,4 si ulinganisho dhidi ya DQN.
Hali ikoje kwa hasara ya mwisho?
Hasara ya mwisho katika DQN ni 0,47, na katika PPO-P³OS ni 0,23. Kutokana na thamani ghafi za jedwali:
\[ \frac{0.47-0.23}{0.47}\times100 \approx 51.1\% \]
upungufu unahesabiwa. Thamani hii iko karibu na upungufu wa takriban %50,9 wa hasara ya mwisho uliotajwa katika makala, na safari hii inaonekana wazi kuwa ulinganisho ulifanywa dhidi ya DQN.
Kwa hiyo chanzo kinaonekana kuchanganya baseline tofauti kwa viashiria tofauti vya utendaji ndani ya sentensi moja ya muhtasari.
Kielelezo cha 2 kinatuonyesha nini?
Kielelezo cha 2 kina mikunjo miwili ya mafunzo. Katika grafu ya kwanza, faida ya wastani huanza karibu na 50×10³ USD, huongezeka kwa kasi katika mamia machache ya kwanza ya vipindi na kufikia plateau karibu na 62×10³ USD inapokaribia kipindi cha 1000.
Katika grafu ya pili, hasara ya mafunzo hupungua kwa kuendelea kutoka karibu 1,05 hadi takriban 0,22–0,23 katika kipindi cha 1000.
Mikunjo hii miwili inaunga mkono kwamba mchakato wa ujifunzaji wa mfano ulitulia katika mazingira yaliyotolewa ya mafunzo. Hata hivyo, kupungua kwa hasara ya mafunzo na kuongezeka kwa faida katika simulizi hakuwezi peke yake kuthibitisha kwamba mfano utaonyesha utendaji huo huo wa kiuchumi katika viwanda halisi.
Je, PPO-P³OS kweli ilipata sera “optimum”?
Utafiti unasema kwamba mfano ulijifunza sera “optimal” au “near-optimal”. Hata hivyo, majaribio hayatoi uchanganuzi wa optimality-gap ambapo optimum halisi ya kihisabati ya kimataifa inajulikana na matokeo ya PPO yanalinganishwa nayo.
Kwa hiyo ni salama zaidi kuelezea matokeo kwa uangalifu kama sera iliyojifunza iliyotoa utendaji ulioripotiwa kuwa wa juu kuliko mbinu za baseline zilizojaribiwa katika mazingira ya simulizi yaliyochunguzwa.
Utafiti unaunga mkono nini?
- Bei na kiasi cha uzalishaji vinaweza kuigwa pamoja ndani ya tatizo moja la udhibiti endelevu.
- PPO ilitoa faida ya wastani iliyoripotiwa kuwa ya juu kuliko Q-Learning, DQN na A2C katika mazingira ya simulizi ya utafiti huu.
- PPO-P³OS ina variance ya faida na hatari ya hisa ya chini zaidi kati ya mifano iliyolinganishwa katika Jedwali la 1.
- Katika vipindi 1000 vya mafunzo, mkunjo wa faida uliongezeka na mkunjo wa hasara ulipungua.
- Kuongeza kutolingana kwa hisa kama adhabu kwenye kazi ya zawadi hufanya mfumo ulengie si marja ya muda mfupi tu, bali pia uwiano wa kiutendaji.
- Kurekebisha bei na kiasi cha uzalishaji pamoja katika nafasi za vitendo endelevu kunaweza kuwa eneo la matumizi la kawaida kwa PPO.
Utafiti hauthibitishi nini?
- Hauthibitishi kwamba PPO-P³OS itatoa faida ya %12,8 zaidi katika kiwanda halisi.
- Mfano haujawekwa moja kwa moja katika operesheni ya kiwanda ya wakati halisi.
- Si sampuli zote 36.000 ni uchunguzi halisi wa kiwanda.
- Haijaonyeshwa kuwa data sintetiki inawakilisha kikamilifu mabadiliko halisi ya soko.
- Hakuna confidence interval au jaribio la umuhimu wa kitakwimu lililotolewa kwa tofauti za kiuchumi kati ya mifano.
- Haijaonyeshwa kuwa sera ya PPO imefikia optimum ya kihisabati ya kimataifa.
- Haijathibitishwa kuwa sehemu ya data halisi kutoka kwa biashara moja inaweza kujumlishwa kwa sekta zote za uzalishaji.
- Tabaka la uchanganuzi wa biashara halijajaribiwa kwa utafiti wa mtumiaji au wa uga ili kuthibitisha kwamba linaongeza ubora wa maamuzi halisi ya mameneja.
Mbinu na Matokeo ya Utafiti
Muundo wa data za majaribio
Sehemu ya data halisi ya utafiti ilitokana na rekodi za ERP na MES za biashara ya uzalishaji wa bidhaa za matumizi ya ukubwa wa kati katika kipindi cha 2021–2023. Imeelezwa kwamba data sintetiki za simulizi ziliongezwa na kuunda seti ya data yenye takriban sampuli 36.000.
Waandishi wanafafanua kila sampuli kama hali ya operesheni ya siku moja. Hata hivyo, kutotolewa tofauti kwa idadi ya sampuli halisi na sintetiki na kutofafanuliwa kwa kina kwa mchakato wa kutengeneza data sintetiki ni mojawapo ya vikwazo vikuu vya reproducibility ya utafiti.
Algoriti zilizolinganishwa
PPO-P³OS ililinganishwa na baseline tatu:
- Q-Learning,
- Deep Q-Network (DQN),
- Advantage Actor-Critic (A2C).
Vigezo vya tathmini ni faida ya wastani, variance ya faida, hatari ya hisa, hasara ya mwisho na uthabiti wa convergence.
Matokeo ghafi ya majaribio
| Kipimo | Q-Learning | DQN | A2C | PPO-P³OS |
|---|---|---|---|---|
| Faida ya wastani (×10³ USD) | 48,6 | 52,3 | 55,1 | 62,2 |
| Variance ya faida (%) | 12,5 | 9,8 | 7,0 | 6,0 |
| Hatari ya hisa (%) | 10,7 | 9,3 | 8,5 | 7,1 |
| Hasara ya mwisho | 0,61 | 0,47 | 0,36 | 0,23 |
Jedwali ghafi linaonyesha kuwa PPO-P³OS ilitoa thamani bora za nambari kuliko mifano ya baseline iliyolinganishwa katika vipimo vyote vinne.
Taarifa zinazokosekana kwa reproducibility
Ingawa utafiti unatoa hyperparameters za mafunzo kwa maelezo kiasi, taarifa muhimu kadhaa zinakosekana ili jaribio lote liweze kurudiwa kikamilifu:
- ukubwa kamili wa seti halisi ya data,
- idadi ya sampuli sintetiki,
- milinganyo au mgawanyo wa kuzalisha data sintetiki,
- muktadha wa kina wa biashara na soko,
- mbinu ya mgawanyo wa train/validation/test,
- random seeds,
- hyperparameters za kina za algoriti za baseline,
- standard deviation au confidence intervals kwa marudio matano,
- source code au seti ya wazi ya data za majaribio.
Kwa hiyo, uwezo wa timu huru kurudia matokeo katika mazingira yale yale unabaki umewekewa kikomo na taarifa zilizotolewa katika chanzo.
Matatizo ya uadilifu wa marejeo
Katika sehemu ya fasihi ya makala, baadhi ya ulinganifu kati ya maandishi na marejeo unaonekana kuwa na tatizo. Katika utangulizi, [1] imetumiwa kuunga mkono matumizi ya causal inference inayotegemea machine learning; hata hivyo, rejeo [1] ni utafiti wa mwaka 2012 kuhusu kuongeza faida ya mchanganyiko wa bidhaa kwa linear programming.
Katika Sehemu ya 2.1, rejeo [5] limetolewa kwa utafiti wa utabiri wa mahitaji ya vipuri unaotegemea regression, ANN na SVR unaodaiwa kufanywa na “Aktepe et al.”. Hata hivyo, rejeo [5] ni kazi ya arXiv ya Zhuang na wenzake yenye jina “Behavior Proximal Policy Optimization”.
Hali hii haifanyi matokeo makuu ya majaribio ya PPO kuwa batili kiotomatiki; lakini inaonyesha kwamba baadhi ya kauli za kuunga mkono katika mapitio ya fasihi hazipaswi kurudiwa bila uhakiki wa chanzo.
Ni nini kinachohitajika ili kuhamia matumizi ya viwandani?
Ili kuhamisha mbinu hii kwenda kwenye kiwanda halisi, uthibitishaji wa ziada unahitajika zaidi ya mafanikio ya simulizi. Angalau, uwezo halisi wa uzalishaji, hitilafu za mashine, muda wa utoaji, maisha ya bidhaa kwenye rafu, kiwango cha chini cha oda, vikwazo vya zamu, lead times, elasticity ya bei, majibu ya bei za washindani na mauzo yaliyopotea vinaweza kuhitaji kuingizwa kwenye mfano.
Pia, katika mfumo ambao akili bandia huweka bei moja kwa moja, lazima kuwe na mipaka ya usimamizi, sheria za bei ya chini–juu, idhini ya binadamu, tabaka za usalama na sera za kurejea nyuma katika hali za soko zisizotarajiwa. Mambo haya hayajajaribiwa kwa majaribio katika utafiti wa chanzo.
Inapaswa kutathminiwaje kwa muktadha wa Türkiye?
Chanzo hakina data za kiwanda au soko kutoka Türkiye. Kwa hiyo, thamani za utendaji wa faida na hisa katika utafiti haziwezi kuhamishwa moja kwa moja kwa biashara za uzalishaji nchini Türkiye.
Hata hivyo, mbinu inaweza kutoa mfumo wa utafiti kwa jaribio la majaribio katika biashara za uzalishaji nchini Türkiye zinazohifadhi kwa pamoja ERP, MES, gharama za uzalishaji, hisa, mahitaji na historia ya bei. Katika utekelezaji wa ndani, mfano unahitaji kufundishwa upya kwa uwezo, gharama, oda, kiwango cha ubadilishaji, nishati na mienendo ya ugavi ya kampuni yenyewe, na kuthibitishwa katika shadow mode kabla ya operesheni halisi.
Dokezo la Chanzo na Mbinu
Jina kamili la utafiti asilia: Profit-Oriented Production and Pricing Optimization for Manufacturing Enterprises Using Proximal Policy Optimization
Waandishi: Pingmei Fan, Hanwu Li, Mengdie Hu.
Mpangilio wa waandishi: Mpangilio katika utafiti wa chanzo umehifadhiwa kama ulivyo.
Mwandishi anayewasiliana: Pingmei Fan.
Uandishi mwenza wa kwanza/mchango sawa: Hakuna tamko la uandishi mwenza wa kwanza au mchango sawa katika chanzo.
Taasisi 1: Guangxi Vocational Normal University, Nanning, Guangxi, China.
Taasisi 2: Amazon.com Services LLC, Bellevue, Washington, USA.
Taasisi 3: Systems Engineering, University of Pennsylvania, Philadelphia, Pennsylvania, USA.
Aina ya chanzo: Utafiti wa kihesabu/uundaji modeli na simulizi unaotegemea kujifunza kwa kuimarisha.
Jarida: Economics and Management Innovation.
Juzuu / toleo: Vol. 3, No. 2 (2026).
Kurasa: 8–17.
DOI: 10.71222/zsm3tb33
Tarehe ya kuwasilishwa: 1 Januari 2026.
Tarehe ya marekebisho: 25 Februari 2026.
Tarehe ya kukubaliwa: 12 Machi 2026.
Tarehe ya kuchapishwa: 18 Machi 2026.
Kiungo rasmi cha makala: https://doi.org/10.71222/zsm3tb33
Hali ya mapitio ya rika/uchapishaji: Ukurasa wa mchapishaji wa Economics and Management Innovation unaelezea jarida kuwa la mapitio ya rika na kutumia mapitio ya rika ya upofu mara mbili; sera ya waandishi ya GBP inasema kuwa angalau ripoti mbili za wakaguzi huru zinatarajiwa kwa kazi zilizochapishwa. Ripoti za mapitio ya rika katika kiwango cha makala hazikuthibitishwa kuwa wazi kwa umma wakati wa ukaguzi huu.
Leseni: PDF ya chanzo inaeleza kuwa kazi iliwasilishwa kwa uwezekano wa uchapishaji wa ufikiaji wazi chini ya leseni ya Creative Commons Attribution. Sera ya sasa ya jumla ya uchapishaji ya GBP inasema kwamba makala zilizochapishwa ziko chini ya CC BY 4.0.
Ufadhili: Hakuna tamko tofauti la ufadhili maalum kwa utafiti huu katika maandishi ya makala iliyokaguliwa.
Upatikanaji wa data: Makala iliyokaguliwa haina Data Availability Statement tofauti. Utambulisho wa data halisi za biashara haujawekwa wazi na hakuna kiungo cha hazina ya wazi kilichotolewa kwa seti ya data.
Mgongano wa maslahi: Makala iliyokaguliwa haina tamko tofauti la mgongano wa maslahi wa waandishi linalohusu utafiti huu.
Kamati ya maadili: Maandishi yaliyokaguliwa hayana tamko la kamati ya maadili maalum kwa utafiti huu.
CRediT/michango ya waandishi: Chanzo hakina sehemu tofauti ya CRediT au michango ya waandishi.
Wigo wa data: Makala inaripoti seti ya data yenye takriban sampuli 36.000, ikichanganya data halisi za biashara na data sintetiki za simulizi. Sehemu halisi inatokana na rekodi za ERP na MES za mtengenezaji wa bidhaa za matumizi wa ukubwa wa kati katika kipindi cha 2021–2023. Idadi tofauti za sampuli halisi na sintetiki hazijaelezwa.
Kikomo kikuu cha kimethodolojia: Utafiti si utekelezaji wa kiwanda wa wakati halisi. Matokeo ni utendaji wa benchmark uliopatikana katika mazingira ya majaribio yaliyoundwa. Kwa kuwa uzalishaji wa data sintetiki, mbinu ya kugawanya data, hyperparameters za baseline na vipimo vya kutokuwa na uhakika kati ya marudio havijaripotiwa kwa maelezo ya kutosha, reproducibility huru ni ndogo.
Kutolingana kwa utendaji ndani ya chanzo: Kulingana na Jedwali la 1, faida ya wastani ya PPO-P³OS ya 62,2×10³ USD ni takriban %12,9 juu kuliko 55,1×10³ USD ya A2C, na hatari ya hisa hushuka kutoka %8,5 ya A2C hadi %7,1 kwa PPO-P³OS, upungufu wa takriban %16,5. DQN ikitumiwa kama baseline, tofauti hizo hizo ni takriban %18,9 na %23,7 mtawalia. Hata hivyo, muhtasari na sehemu ya matokeo hutaja ongezeko la faida la %12,8 na upungufu wa hisa wa %16,4 pamoja na DQN. Upungufu wa takriban %50,9 wa hasara ya mwisho, kwa upande mwingine, unaendana na ulinganisho dhidi ya DQN. Katika maudhui haya ya Verianla, thamani ghafi za jedwali zimechukuliwa kama msingi.
Dokezo la istilahi: Katika muhtasari na sehemu ya matokeo ya chanzo, ongezeko la utendaji linaitwa “cumulative profit”, huku kipimo kinachotumiwa katika Jedwali la 1 na Kielelezo cha 2 kikiwa “Average Profit”. Maneno haya mawili hayakuchukuliwa kuwa sawa.
Dokezo la uadilifu wa marejeo: Baadhi ya marejeo ya ndani ya maandishi katika makala hayaendani na orodha ya marejeo. Hasa, kuna kutolingana wazi kwa mada/mwandishi kati ya tafiti ambazo marejeo [1] na [5] yameunganishwa nazo katika maandishi na kazi zilizoorodheshwa katika bibliografia.
Kikomo cha maudhui ya kisayansi: Muundo wa mfano, milinganyo, sifa za data, hyperparameters, mikunjo ya mafunzo na matokeo ya utendaji katika makala hii ya Verianla yanategemea utafiti asilia. Vyanzo vya nje vimetumiwa tu kuthibitisha utambulisho wa kibibliografia, DOI, jarida na sera za mchapishaji kuhusu mapitio ya rika/leseni.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *