

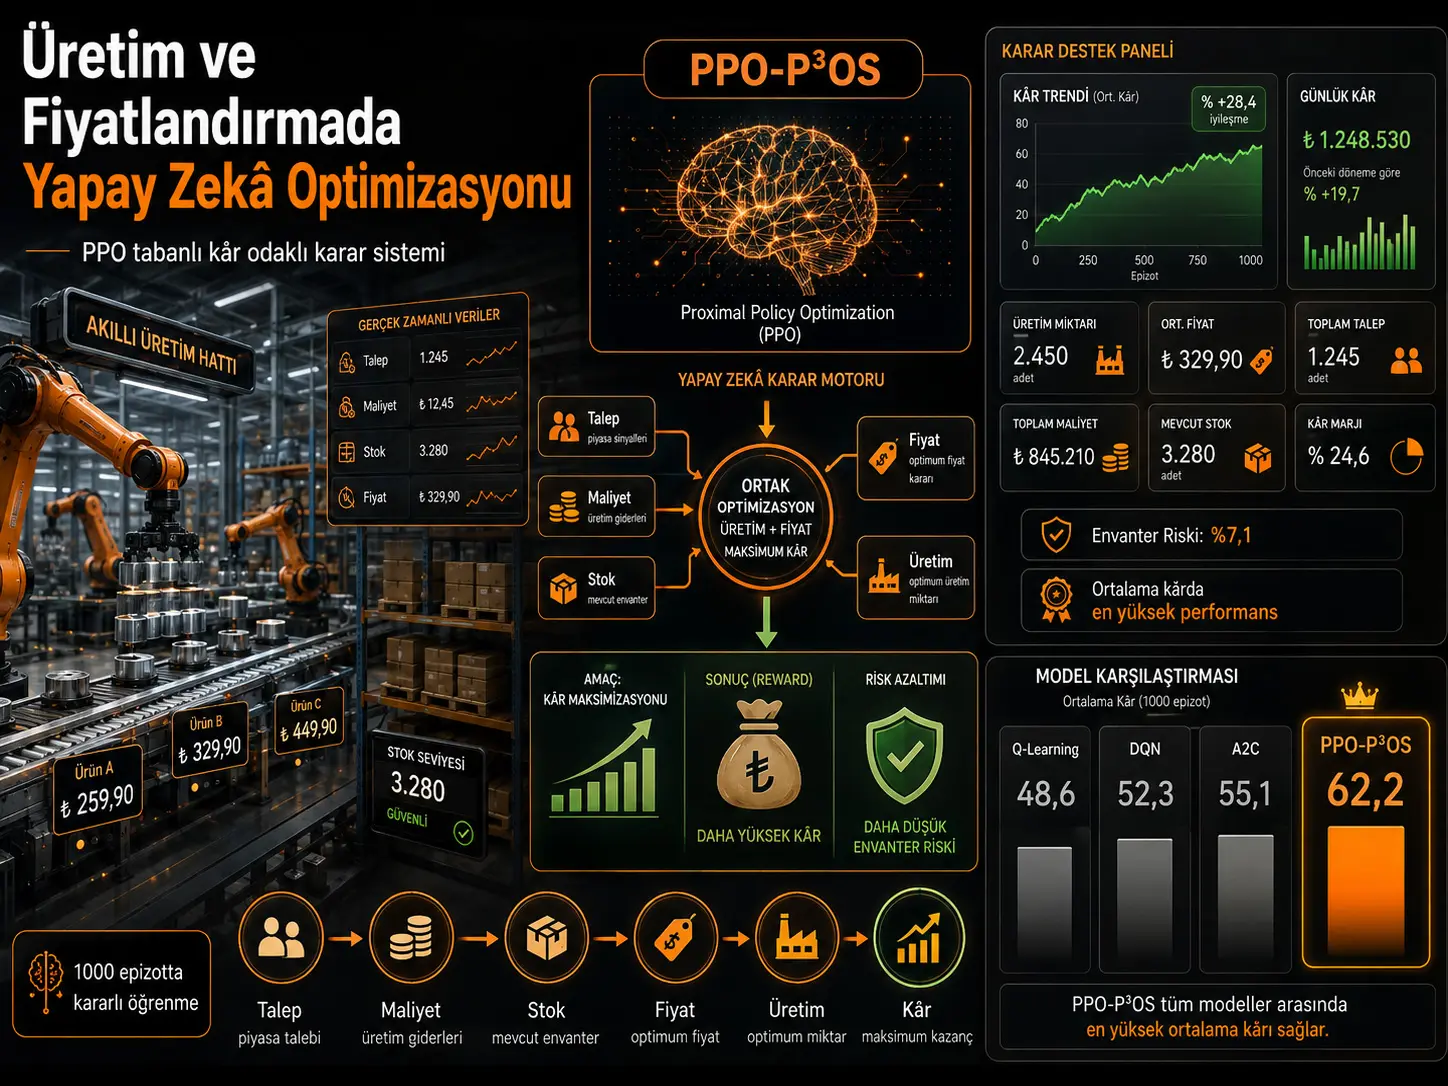
Ishlab chiqaruvchi bugun nechta mahsulot ishlab chiqarishi va uni qanday narxda sotishi kerak? Talab, xomashyo xarajatlari va zaxira miqdori doimiy ravishda o‘zgarib tursa, bu ikki qarorni bir-biridan mustaqil qabul qilib bo‘lmaydi. Ushbu tadqiqot ishlab chiqarish miqdori bilan sotuv narxini bir vaqtda sozlay oladigan, uzoq muddatli foydani oshirish bilan birga zaxira xavfini cheklashni maqsad qilgan mustahkamlovchi o‘rganish tizimini taklif qiladi. Tadqiqotchilar PPO-P³OS deb atagan tizim Proximal Policy Optimization (PPO) algoritmidan foydalanadi. Sun’iy intellekt agenti har bir qaror bosqichida ishlab chiqarish xarajati, bozor talabi, mavjud zaxira darajasi va mahsulot narxini kuzatadi; so‘ng yangi narx va ishlab chiqarish miqdori bo‘yicha uzluksiz qiymatli qarorlar ishlab chiqadi.
Model ishlab chiqarish va narxlash muammosini Markov Qaror Jarayoni (MDP) sifatida belgilaydi. Mukofot funksiyasi sotilgan mahsulotlardan olinadigan marjani oshirishga intilar ekan, talab bilan ishlab chiqarish/zaxira o‘rtasidagi nomutanosiblikni kvadratik jarima orqali kamaytiradi. Taxminan 36.000 namunadan iborat ekani bildirilgan haqiqiy va sintetik ma’lumotlar birikmasida o‘tkazilgan simulyatsiyalarda PPO-P³OS; Q-Learning, Deep Q-Network (DQN) va Advantage Actor-Critic (A2C) bilan taqqoslanadi. 1-jadvalga ko‘ra, o‘rtacha foyda PPO-P³OS’da 62,2×10³ USD bo‘lsa, A2C’da 55,1×10³ USD, DQN’da 52,3×10³ USD va Q-Learning’da 48,6×10³ USD deb hisobot berilgan.
Biroq tadqiqot haqiqiy ishlab chiqarish korxonasida jonli qaror qabul qilish tizimi sifatida tasdiqlanmagan. Ma’lumotlar to‘plamining haqiqiy qismi 2021–2023 yillardagi o‘rta hajmli iste’mol tovarlari ishlab chiqaruvchisidan olingan ERP va MES yozuvlariga asoslangan, umumiy to‘plam esa sintetik simulyatsiya ma’lumotlari bilan kengaytirilgan. Haqiqiy va sintetik ma’lumotlar nisbati hamda sintetik ma’lumotlarni yaratish usuli yetarlicha batafsil tushuntirilmagani sababli natijalar simulyatsiya/benchmark muvaffaqiyati sifatida baholanishi kerak; haqiqiy zavodlarda aynan shunday foyda o‘sishi ta’minlanadi degan xulosaga bevosita kelib bo‘lmaydi.
Nega ishlab chiqarish miqdori bilan narx birgalikda ko‘rib chiqilishi kerak?
Ishlab chiqarish korxonasida narx faqat marketing bo‘limining, ishlab chiqarish miqdori esa faqat zavodning mustaqil qarori emas. Narx talabga ta’sir qiladi; talab ishlab chiqarish ehtiyojini o‘zgartiradi; ishlab chiqarish miqdori zaxiralar va xarajatlarga ta’sir qiladi; xarajat o‘zgargani sari maqbul narx darajasi ham qayta o‘zgaradi.
Masalan, talab kutilganidan past bo‘lsa-yu, ishlab chiqarish yuqori darajada saqlansa, zaxira to‘planishi mumkin. Ishlab chiqarish xarajati oshib, sotuv narxi o‘zgarmasa, bir birlik foyda marjasi qisqarishi mumkin. Narx haddan tashqari ko‘tarilsa talab pasayishi mumkin. Narx juda past saqlansa, sotuv hajmi oshgan taqdirda ham rentabellik zarar ko‘rishi mumkin.
Tadqiqotning boshlang‘ich nuqtasi shuki, bu o‘zgaruvchilar o‘rtasidagi bog‘lanish chiziqli va doimiy emas. Shu sababli tadqiqotchilar faqat muayyan bir paytda matematik optimumni izlaydigan statik yondashuv o‘rniga, muhitdan qayta aloqa olib vaqt davomida siyosatni o‘rganadigan mustahkamlovchi o‘rganish agentidan foydalanadilar.
PPO-P³OS nima?
PPO-P³OS tadqiqotda ishlatilgan Profit-Oriented Production and Pricing Optimization System iborasining qisqartmasidir. Tizim Proximal Policy Optimization algoritmini ishlab chiqarish iqtisodiyoti muammosiga moslashtiradi.
1-rasmda model to‘rtta asosiy blok bilan ko‘rsatilgan:
- Holat (State): ishlab chiqarish xarajati, zaxira darajasi, bozor talabi va joriy narx,
- PPO siyosati: joriy holatni baholab qaror chiqaradigan o‘rganilgan siyosat,
- Harakat (Action): sozlangan narx va ishlab chiqarish miqdori,
- Mukofot (Reward): foyda bilan zaxira xavfini birgalikda baholaydigan qayta aloqa.
Agent olgan mukofotlaridan o‘rganib, uzoq muddatda yuqoriroq jami mukofot beradigan narx–ishlab chiqarish kombinatsiyalariga yo‘naladi.
Holat fazosida qanday ma’lumotlar bor?
Vaqtning t bosqichidagi holat vektori tadqiqotda quyidagicha ta’riflanadi:
\[ s_t=[C_t,D_t,I_t,P_t] \]
Bu yerda:
- Ct: bir birlik ishlab chiqarish xarajati,
- Dt: bozor talabi,
- It: mavjud zaxira darajasi,
- Pt: joriy mahsulot narxi.
Bu to‘rtta o‘zgaruvchi agent uchun iqtisodiy muhitning ayni paytdagi qisqacha tavsifini tashkil qiladi.
Sun’iy intellekt qanday qarorlarni qabul qiladi?
Harakat vektori:
\[ a_t=[p_t,q_t] \]
ko‘rinishidadir. Manbada pt narxni sozlashni, qt esa ishlab chiqarishni sozlashni anglatadi.
Bu yerdagi muhim texnik farq shundaki, qarorlar DQN kabi faqat oldindan belgilangan bir nechta variantdan birini tanlashga majbur emas. PPO uzluksiz harakat fazolarida ishlay olgani uchun narx va ishlab chiqarish miqdorini uzluksiz o‘zgaruvchi sifatida modellashtirishi mumkin.
Modelning mukofot funksiyasi nimani optimallashtiradi?
Tadqiqotda mukofot quyidagicha ta’riflanadi:
\[ r_t=(p_t-C_t)\cdot \min(q_t,D_t)-\lambda(I_t+q_t-D_t)^2 \]
Birinchi had sotuvlardan olinadigan iqtisodiy daromadni anglatadi. min(qt,Dt) ifodasi sotilishi mumkin bo‘lgan miqdor ishlab chiqarish bilan talabning kichigiga cheklanadigan soddalashtirilgan tuzilmani bildiradi.
Ikkinchi had:
\[ \lambda(I_t+q_t-D_t)^2 \]
zaxira nomutanosibligini jarimaga tortadi. λ kattalashgan sari agent zaxira nomutanosibligiga nisbatan sezgirroq bo‘ladi.
Kvadratik jarima tufayli talab bilan mavjud zaxira ustiga ishlab chiqarish o‘rtasidagi farq kattalashgan sari jarima tez oshadi. Shunday qilib, tizim faqat qisqa muddatli sotuv marjasini ko‘paytirish o‘rniga zaxira boshqaruvini ham mukofot funksiyasiga kiritadi.
Uzoq muddatli maqsad nima?
PPO agentining maqsadi diskontlangan jami mukofotni maksimal qilishdir:
\[ J(\theta)=E_t\left[\sum_{t=0}^{T}\gamma^t r_t\right] \]
Bu yerda γ diskont koeffitsiyentidir. Tajribalarda γ = 0,99 ishlatilgan. Bu yuqori qiymat model nafaqat keyingi qarorni, balki undan keyingi iqtisodiy natijalarni ham muhim deb hisoblaydigan tarzda sozlanganini ko‘rsatadi.
Nega PPO tanlangan?
PPO siyosat gradienti algoritmidir. Asosiy maqsad siyosatning har bir o‘qitish qadamida haddan tashqari katta o‘zgarishlar qilishiga yo‘l qo‘ymasdan o‘rganishni barqarorroq qilishdir.
Tadqiqotda ishlatilgan qirqilgan PPO maqsad funksiyasi:
\[ L^{CLIP}(\theta) = E_t \left[ \min \left( r_t(\theta)\hat{A}_t, \operatorname{clip}(r_t(\theta),1-\epsilon,1+\epsilon)\hat{A}_t \right) \right] \]
ko‘rinishida berilgan.
Bu yerdagi ehtimollik nisbati:
\[ r_t(\theta)= \frac{\pi_\theta(a_t|s_t)} {\pi_{\theta_{old}}(a_t|s_t)} \]
yangi siyosat bilan eski siyosat bir xil harakatga bergan ehtimollik zichliklarini taqqoslaydi. ε = 0,2 qirqish parametri yangilanishning haddan tashqari kattalashib ketishiga yo‘l qo‘ymaslikka yordam beradi.
Generalized Advantage Estimation nima vazifa bajaradi?
Model ustunlik qiymatini baholashda Generalized Advantage Estimation (GAE) dan foydalanadi. Manbada:
\[ \hat A_t= \delta_t+ (\gamma\lambda)\delta_{t+1} +\ldots+ (\gamma\lambda)^{T-t+1}\delta_{T-1} \]
va:
\[ \delta_t=r_t+\gamma V(s_{t+1})-V(s_t) \]
ifodalari berilgan.
Tajribalarda GAE uchun λ = 0,95 tanlangan. Maqsad ustunlikni baholashda og‘ish bilan dispersiya o‘rtasida mos muvozanat yaratishdir.
Actor va Critic nima qiladi?
PPO-P³OS ikki neyron tarmoq komponentidan iborat.
Actor, joriy holatdan narx va ishlab chiqarish qarorlarini ishlab chiqaradigan siyosatni ifodalaydi. Uzluksiz harakatlar Gauss taqsimoti orqali modellashtiriladi.
Critic esa muayyan holatdan boshlab kelajakda kutiladigan mukofotni baholaydigan qiymat funksiyasini o‘rganadi.
Tajriba sozlamasida ikki yashirin qatlam 256 va 128 neyrondan iborat ekani va ReLU aktivatsiyalari ishlatilgani bildirilgan. Usul bo‘limida tarmoqlar yana “uchta to‘liq bog‘langan qatlam” deb ta’riflanadi; manba chiqish qatlamini sanaydimi-yo‘qmi, aniq ko‘rsatmaydi.
Model qanday o‘qitildi?
| Parametr | Manbada berilgan qiymat |
|---|---|
| Dasturiy ta’minot | PyTorch 2.2 |
| O‘qitish epizodi | 1000 |
| Har epizoddagi vaqt qadami | 200 |
| Yashirin qatlamlar | 256 va 128 neyron |
| Aktivatsiya | ReLU |
| O‘rganish tezligi | 3 × 10⁻⁴ |
| Diskont koeffitsiyenti γ | 0,99 |
| PPO clip nisbati ε | 0,2 |
| Batch hajmi | 128 |
| GAE λ | 0,95 |
| Tajriba takrorlari soni | 5 |
Uskuna sifatida Intel Core i9-13900K protsessori, 64 GB RAM va NVIDIA RTX 4090 GPU ishlatilgan.
Ma’lumotlar to‘plami haqiqatan ham zavod ma’lumotimi?
Qisman. Tadqiqot ma’lumotlar to‘plamini haqiqiy korxona ma’lumotlari bilan sintetik simulyatsiya ma’lumotlarining birikmasi sifatida ta’riflaydi.
Haqiqiy ma’lumot komponenti iste’mol tovarlari sohasida faoliyat yuritadigan o‘rta hajmli ishlab chiqarish korxonasining 2021–2023 yillardagi ERP va Manufacturing Execution System (MES) yozuvlaridan olingani bildiriladi.
Biroq kompaniya nomi, joylashgan davlati, mahsulotlar tafsilotlari va haqiqiy yozuvlarning jami 36.000 namuna ichidagi ulushi berilmagan. Taxminan uch yillik haqiqiy ma’lumot davriga qaramay, umumiy ma’lumotlar to‘plami taxminan 36.000 namunadan iborat ekani va har bir namuna “bir kunlik operatsion holat”ni ifodalashi yozilgan. Shu sababli to‘plamdagi sintetik kengaytirish ko‘lami va usuli natijalarni qayta ishlab chiqish nuqtai nazaridan muhim, ammo yetarlicha tushuntirilmagan masaladir.
Ma’lumotlarda qanday o‘zgaruvchilar bor?
Tadqiqotchilar 12 ta miqdoriy va ikkita kategorik xususiyatni bildiradilar.
Ishlab chiqarish o‘zgaruvchilari:
- kunlik ishlab chiqarish miqdori,
- mashina foydalanish koeffitsiyenti,
- xomashyo mavjudligi.
Bozor o‘zgaruvchilari:
- bozor talabi,
- raqobatchilarning o‘rtacha narxi,
- mavsumiylik indeksi.
Xarajat o‘zgaruvchilari:
- bir birlik ishlab chiqarish xarajati,
- energiya xarajati,
- logistika xarajati.
Rentabellik o‘zgaruvchilari:
- haqiqiy sotuv narxi,
- kunlik foyda,
- zaxira darajasi.
Kategorik o‘zgaruvchilar mahsulot turi va bozor hududidir. Xususiyatlar min–max masshtablash usuli bilan normallashtirilgani bildirilgan.
Biznes analitikasi qatlami nimani qo‘shadi?
Tadqiqot faqat PPO siyosatining harakat ishlab chiqarishini emas, balki o‘rganilgan qarorlarni talab elastikligi va chegaraviy xarajat kabi iqtisodiy tushunchalar bilan izohlashni ham maqsad qiladi.
Biroq manbada ushbu “business analytics” qatlamiga oid alohida tasdiqlash jadvali, tushuntiriluvchanlik metrikasi yoki menejerlar bilan o‘tkazilgan foydalanuvchi tadqiqoti berilmagan. Shu bois tushuntiriladigan qarorlarni qo‘llab-quvvatlash qismi model dizayni maqsadlaridan biridir; u eksperimental ravishda batafsil baholangan alohida modul emas.
Maqolaning eng muhim sonli natijasi nima?
1-jadval to‘rtta usulni taqqoslaydi:
| Model | O‘rtacha foyda (×10³ USD) | Foyda dispersiyasi (%) | Zaxira xavfi (%) | Yakuniy yo‘qotish | Yaqinlashish bahosi |
|---|---|---|---|---|---|
| Q-Learning | 48,6 | 12,5 | 10,7 | 0,61 | O‘rtacha |
| DQN | 52,3 | 9,8 | 9,3 | 0,47 | O‘rtacha |
| A2C | 55,1 | 7,0 | 8,5 | 0,36 | Barqaror |
| PPO-P³OS | 62,2 | 6,0 | 7,1 | 0,23 | Juda barqaror |
%12,8 foyda o‘sishi aynan nimaga nisbatan?
Maqolaning o‘z matnida bu yerda nomuvofiqlik mavjud.
1-jadvaldan foydalanilganda PPO-P³OS bilan eng kuchli raqib A2C o‘rtasidagi foyda farqi:
\[ \frac{62.2-55.1}{55.1}\times100 \approx 12.9\% \]
bo‘ladi. Bu natijalar bo‘limidagi “eng yaxshi baseline A2C ga nisbatan taxminan %12,8” iborasi bilan mos keladi.
Ammo DQN bazaviy sifatida olinsa:
\[ \frac{62.2-52.3}{52.3}\times100 \approx 18.9\% \]
hosil bo‘ladi.
Shu sababli xulosa va natijalar bo‘limlarida %12,8 qiymatining DQN ga nisbatan berilishi 1-jadvalga mos kelmaydi.
Zaxira xavfida ham xuddi shu muammo bormi?
Ha. A2C ning zaxira xavfi %8,5, PPO-P³OS niki esa %7,1:
\[ \frac{8.5-7.1}{8.5}\times100 \approx 16.5\% \]
Bu qiymat maqoladagi %16,4 da’vosi bilan mos keladi va bazaviy chiziq A2C ekanini ko‘rsatadi.
DQN ning %9,3 qiymati ishlatilsa, PPO-P³OS kamayishi taxminan %23,7 bo‘ladi. Demak, %16,4 qiymati DQN bilan taqqoslash emas.
Yakuniy yo‘qotish bo‘yicha holat qanday?
DQN dagi yakuniy yo‘qotish 0,47, PPO-P³OS da 0,23. Xom jadval qiymatlaridan:
\[ \frac{0.47-0.23}{0.47}\times100 \approx 51.1\% \]
kamayish hisoblanadi. Bu qiymat maqoladagi taxminan %50,9 yakuniy yo‘qotish kamayishiga yaqin va bu safar taqqoslash haqiqatan ham DQN ga nisbatan qilinganini ko‘rsatadi.
Demak, manba bir xil xulosa jumlasida turli samaradorlik ko‘rsatkichlari uchun turli bazaviy chiziqlarni aralashtirib yuborgandek ko‘rinadi.
2-rasm bizga nimani ko‘rsatadi?
2-rasmda ikkita o‘qitish egri chizig‘i bor. Birinchi grafikda o‘rtacha foyda taxminan 50×10³ USD darajasidan boshlanadi, dastlabki bir necha yuz epizodda tez ko‘tariladi va 1000-epizodga yaqinlashganda taxminan 62×10³ USD atrofida platoga chiqadi.
Ikkinchi grafikda o‘qitish yo‘qotishi taxminan 1,05 darajasidan uzluksiz pasayib, 1000-epizodda taxminan 0,22–0,23 darajasiga yetadi.
Bu ikki egri chiziq modelning berilgan o‘qitish muhitida o‘rganish jarayoni barqarorlashganini qo‘llab-quvvatlaydi. Biroq o‘qitish yo‘qotishining kamayishi va simulyatsiya foydasining oshishi model haqiqiy dunyo ishlab chiqarish korxonalarida ham xuddi shunday iqtisodiy samaradorlik ko‘rsatishini o‘z-o‘zidan isbotlamaydi.
PPO-P³OS haqiqatan ham “optimal” siyosatni topdimi?
Tadqiqot model “optimal” yoki “near-optimal” siyosatni o‘rganganini aytadi. Biroq tajribalarda haqiqiy matematik global optimum ma’lum bo‘lgani va PPO natijasi shu optimum bilan taqqoslangan optimality-gap tahlili berilmagan.
Shu sababli natijalarni ehtiyotkorroq tarzda, o‘rganilgan simulyatsiya muhitida sinovdan o‘tgan baseline usullardan yuqoriroq hisobot qilingan samaradorlikni ta’minlagan o‘rganilgan siyosat deb ta’riflash xavfsizroq.
Tadqiqot nimani qo‘llab-quvvatlaydi?
- Narx va ishlab chiqarish miqdori bitta uzluksiz boshqaruv muammosi doirasida birgalikda modellashtirilishi mumkin.
- PPO ushbu tadqiqotning simulyatsiya muhitida Q-Learning, DQN va A2C ga qaraganda yuqoriroq hisobot qilingan o‘rtacha foyda yaratgan.
- PPO-P³OS 1-jadvalda taqqoslangan modellar orasida eng past foyda dispersiyasi va zaxira xavfiga ega.
- 1000 epizodlik o‘qitish davomida foyda egri chizig‘i ko‘tarilgan, yo‘qotish egri chizig‘i esa pasaygan.
- Zaxira nomutanosibligini mukofot funksiyasiga jarima sifatida qo‘shish faqat qisqa muddatli marjani emas, operatsion muvozanatni ham nishonga olish imkonini beradi.
- Uzluksiz harakat fazolarida narx va ishlab chiqarish miqdorini birgalikda sozlash PPO uchun tabiiy qo‘llanish sohasi bo‘lishi mumkin.
Tadqiqot nimani isbotlamaydi?
- PPO-P³OS haqiqiy ishlab chiqarish korxonasida %12,8 ko‘proq foyda keltirishini isbotlamaydi.
- Model haqiqiy vaqt rejimidagi zavod operatsiyasida jonli ravishda ishga tushirilmagan.
- 36.000 namunaning barchasi haqiqiy zavod kuzatuvi emas.
- Sintetik ma’lumotlar haqiqiy bozor tebranishlarini to‘liq ifodalashi ko‘rsatilmagan.
- Modellar o‘rtasidagi iqtisodiy farqlar uchun ishonch oralig‘i yoki statistik ahamiyat testi berilmagan.
- PPO siyosati global matematik optimumga erishgani ko‘rsatilmagan.
- Bitta korxonadan olingan haqiqiy ma’lumot komponentini barcha ishlab chiqarish tarmoqlariga umumlashtirish mumkinligi isbotlanmagan.
- Biznes analitikasi qatlami menejerlarning haqiqiy qaror sifatini oshirishi foydalanuvchi yoki dala tadqiqoti bilan sinovdan o‘tkazilmagan.
Tadqiqotning Usuli va Natijalari
Tajriba ma’lumotlari tuzilmasi
Tadqiqotning haqiqiy ma’lumot komponenti iste’mol tovarlari sohasidagi o‘rta hajmli ishlab chiqarish korxonasining 2021–2023 yillardagi ERP va MES yozuvlaridan olingan. Ularga sintetik simulyatsiya ma’lumotlari qo‘shilib, taxminan 36.000 namunali ma’lumotlar to‘plami yaratilgani bildirilgan.
Mualliflar har bir namunani bir kunlik operatsion holat sifatida ta’riflaydilar. Biroq haqiqiy/sintetik namuna sonlari alohida berilmagani va sintetik ma’lumotlarni yaratish jarayoni batafsil ta’riflanmagani tadqiqotning eng muhim qayta ishlab chiqish cheklovlaridan biridir.
Taqqoslangan algoritmlar
PPO-P³OS uchta baseline bilan taqqoslangan:
- Q-Learning,
- Deep Q-Network (DQN),
- Advantage Actor-Critic (A2C).
Baholash mezonlari o‘rtacha foyda, foyda dispersiyasi, zaxira xavfi, yakuniy yo‘qotish va yaqinlashish barqarorligidir.
Xom tajriba natijalari
| Mezon | Q-Learning | DQN | A2C | PPO-P³OS |
|---|---|---|---|---|
| O‘rtacha foyda (×10³ USD) | 48,6 | 52,3 | 55,1 | 62,2 |
| Foyda dispersiyasi (%) | 12,5 | 9,8 | 7,0 | 6,0 |
| Zaxira xavfi (%) | 10,7 | 9,3 | 8,5 | 7,1 |
| Yakuniy yo‘qotish | 0,61 | 0,47 | 0,36 | 0,23 |
Xom jadval PPO-P³OS to‘rtta mezonning barchasida taqqoslangan baseline modellarga nisbatan yaxshiroq sonli qiymatlar berganini ko‘rsatadi.
Takrorlanuvchanlik nuqtai nazaridan yetishmayotgan ma’lumotlar
Tadqiqot o‘qitish giperparametrlarini nisbatan batafsil bergan bo‘lsa-da, tajribani to‘liq qayta yaratish uchun ayrim muhim ma’lumotlar yetishmaydi:
- haqiqiy ma’lumotlar to‘plamining aniq hajmi,
- sintetik namunalar soni,
- sintetik ma’lumot yaratish tenglamalari yoki taqsimotlari,
- korxona va bozorning batafsil konteksti,
- train/validation/test bo‘lish usuli,
- tasodifiy urug‘lar,
- baseline algoritmlarining batafsil giperparametrlari,
- beshta takror uchun standart og‘ish yoki ishonch oraliqlari,
- manba kodi yoki ochiq tajriba ma’lumotlar to‘plami.
Shu sababli natijalarni mustaqil guruh tomonidan xuddi shu sharoitda qayta ishlab chiqish manbada berilgan ma’lumotlar bilan cheklanadi.
Manbalar yaxlitligidagi muammolar
Maqolaning adabiyot bo‘limida ayrim matn–manba mosliklari muammoli ko‘rinadi. Kirishda mashina o‘rganishiga asoslangan sababiy xulosa chiqarish qo‘llanmasini qo‘llab-quvvatlash uchun [1] ishlatilgan; biroq adabiyotlar ro‘yxatidagi [1] chiziqli dasturlash orqali mahsulot aralashmasi foydasini maksimal qilishga bag‘ishlangan 2012 yilgi tadqiqotdir.
2.1-bo‘limda “Aktepe et al.” tomonidan bajarilgani aytilgan regressiya, ANN va SVR asosidagi ehtiyot qismlar talabi prognozi tadqiqotiga [5] havola berilgan. Adabiyotlar ro‘yxatidagi [5] esa Zhuang va hamkorlarining “Behavior Proximal Policy Optimization” nomli arXiv ishidir.
Bu holat asosiy PPO tajriba natijalarini avtomatik ravishda bekor qilmaydi; biroq adabiyot sharhidagi ayrim qo‘llab-quvvatlovchi fikrlar manba tekshiruvidan o‘tkazilmasdan takrorlanmasligi kerakligini ko‘rsatadi.
Sanoat amaliyotiga o‘tish uchun nima kerak?
Ushbu yondashuvni haqiqiy ishlab chiqarish korxonasiga ko‘chirish uchun simulyatsiya muvaffaqiyatidan tashqari qo‘shimcha tasdiqlash talab etiladi. Hech bo‘lmaganda haqiqiy ishlab chiqarish quvvati, mashina nosozliklari, yetkazib berish muddatlari, mahsulot saqlash muddati, minimal buyurtma miqdorlari, smena cheklovlari, ta’minot muddatlari, narx elastikligi, raqobatchilarning narx reaksiyalari va yo‘qotilgan sotuvlar kabi jarayonlarni modelga kiritish talab qilinishi mumkin.
Shuningdek, sun’iy intellekt narxni bevosita belgilaydigan tizimda boshqaruv chegaralari, minimal–maksimal narx qoidalari, inson tasdig‘i, xavfsizlik qatlamlari va kutilmagan bozor sharoitlarida qaytish siyosatlari bo‘lishi kerak. Bular manba tadqiqotda eksperimental ravishda sinovdan o‘tkazilmagan.
Turkiya nuqtai nazaridan qanday baholanishi kerak?
Manbada Turkiyadan zavod yoki bozor ma’lumotlari yo‘q. Shu sababli tadqiqotdagi foyda va zaxira samaradorligi qiymatlarini Turkiya ishlab chiqarish korxonalariga bevosita ko‘chirish mumkin emas.
Biroq yondashuv ERP, MES, ishlab chiqarish xarajatlari, zaxira, talab va narx tarixini birgalikda saqlaydigan Turkiyadagi ishlab chiqarish korxonalarida alohida pilot tadqiqot uchun tadqiqot doirasini berishi mumkin. Mahalliy amaliyotda model firmaning o‘z quvvati, xarajati, buyurtmasi, valyuta kursi, energiyasi va ta’minot zanjiri dinamikalari bilan qayta o‘qitilishi hamda haqiqiy operatsiyadan oldin soya rejimida tasdiqlanishi kerak.
Manba va Usul Qaydi
Asl tadqiqotning to‘liq nomi: Profit-Oriented Production and Pricing Optimization for Manufacturing Enterprises Using Proximal Policy Optimization
Mualliflar: Pingmei Fan, Hanwu Li, Mengdie Hu.
Mualliflar tartibi: Manba tadqiqotdagi tartib aynan saqlangan.
Mas’ul muallif: Pingmei Fan.
Hammualliflik/birgalikdagi birinchi mualliflik: Manbada birgalikdagi birinchi mualliflik yoki teng hissa bayonoti yo‘q.
Muassasa 1: Guangxi Vocational Normal University, Nanning, Guangxi, China.
Muassasa 2: Amazon.com Services LLC, Bellevue, Washington, USA.
Muassasa 3: Systems Engineering, University of Pennsylvania, Philadelphia, Pennsylvania, USA.
Manba turi: Mustahkamlovchi o‘rganishga asoslangan hisoblash/modellashtirish va simulyatsiya tadqiqoti.
Jurnal: Economics and Management Innovation.
Jild / son: Vol. 3, No. 2 (2026).
Sahifalar: 8–17.
DOI: 10.71222/zsm3tb33
Yuborilgan sana: 1 yanvar 2026.
Qayta ko‘rib chiqilgan sana: 25 fevral 2026.
Qabul qilingan sana: 12 mart 2026.
Nashr sanasi: 18 mart 2026.
Rasmiy maqola havolasi: https://doi.org/10.71222/zsm3tb33
Taqriz/nashr holati: Economics and Management Innovation nashriyot sahifasi jurnalni taqrizli va ikki tomonlama ko‘r taqriz jarayoniga ega deb ta’riflaydi; GBP mualliflik siyosati nashr etilgan ishlar uchun kamida ikki mustaqil taqrizchi hisobotini ko‘zda tutishini bildiradi. Maqola darajasidagi taqriz hisobotlari ushbu ko‘rib chiqish vaqtida ochiq tarzda tasdiqlanmagan.
Litsenziya: Manba PDF’da ish Creative Commons Attribution litsenziyasi ostida ehtimoliy ochiq kirish nashriga taqdim etilgani aytiladi. GBP’ning amaldagi umumiy nashr siyosati nashr etilgan maqolalar CC BY 4.0 ostida ekanini bildiradi.
Moliyalashtirish: Ko‘rib chiqilgan maqola matnida tadqiqotga xos alohida moliyalashtirish bayonoti yo‘q.
Ma’lumotlardan foydalanish imkoniyati: Ko‘rib chiqilgan maqolada alohida Data Availability Statement yo‘q. Haqiqiy korxona ma’lumotlarining kimligi oshkor etilmagan va ma’lumotlar to‘plami uchun ochiq repozitoriy havolasi berilmagan.
Manfaatlar to‘qnashuvi: Ko‘rib chiqilgan maqolada mualliflarning tadqiqotga xos alohida manfaatlar to‘qnashuvi bayonoti yo‘q.
Etika qo‘mitasi: Ko‘rib chiqilgan matnda tadqiqotga xos etika qo‘mitasi bayonoti yo‘q.
CRediT/muallif hissalari: Manbada alohida CRediT yoki muallif hissalari bo‘limi yo‘q.
Ma’lumot qamrovi: Maqola taxminan 36.000 namunadan iborat, haqiqiy korxona ma’lumotlari bilan sintetik simulyatsiya ma’lumotlari birlashtirilgan ma’lumotlar to‘plamini bildiradi. Haqiqiy komponent 2021–2023 yillardagi o‘rta hajmli iste’mol tovarlari ishlab chiqaruvchisining ERP va MES yozuvlaridan keladi. Haqiqiy va sintetik namunalar miqdori alohida ko‘rsatilmagan.
Asosiy uslubiy chegara: Tadqiqot haqiqiy vaqt rejimida zavodga joriy etish emas. Natijalar yaratilgan tajriba muhitida olingan benchmark samaradorligidir. Sintetik ma’lumotlar yaratish, ma’lumotlarni bo‘lish usuli, baseline giperparametrlari va takrorlar o‘rtasidagi noaniqlik o‘lchovlari yetarlicha batafsil hisobot qilinmagani sababli mustaqil qayta ishlab chiqish imkoniyati cheklangan.
Manba ichidagi samaradorlik nomuvofiqligi: 1-jadvalga ko‘ra PPO-P³OS’ning 62,2×10³ USD o‘rtacha foydasi A2C’ning 55,1×10³ USD qiymatidan taxminan %12,9 yuqori, zaxira xavfi esa A2C’ning %8,5 qiymatidan PPO-P³OS’da %7,1 gacha tushib, taxminan %16,5 kamayadi. DQN bazaviy sifatida olinganda shu farqlar mos ravishda taxminan %18,9 va %23,7 ni tashkil etadi. Shunga qaramay, xulosa va natijalar bo‘limida %12,8 foyda o‘sishi va %16,4 zaxira kamayishi DQN bilan birga tilga olinadi. Taxminan %50,9 yakuniy yo‘qotish kamayishi esa DQN taqqoslashi bilan mos keladi. Ushbu Verianla mazmunida xom jadval qiymatlari asos qilib olingan.
Terminologiya qaydi: Manbaning xulosa va natijalar bo‘limlarida samaradorlik o‘sishi “cumulative profit” deb ataladi, 1-jadval va 2-rasmda esa ishlatilgan o‘lchov “Average Profit”dir. Bu ikki ibora bir-biriga teng deb qabul qilinmagan.
Manbalar ro‘yxati yaxlitligi qaydi: Maqolaning ayrim matn ichidagi havolalari adabiyotlar ro‘yxati bilan mos kelmaydi. Xususan, [1] va [5] raqamli manbalarning matnda bog‘langan tadqiqotlari bilan adabiyotlar ro‘yxatida ko‘rsatilgan ishlar o‘rtasida aniq mavzu/muallif nomuvofiqligi mavjud.
Ilmiy mazmun chegarasi: Ushbu Verianla maqolasidagi model tuzilmasi, tenglamalar, ma’lumot xususiyatlari, giperparametrlar, o‘qitish egri chiziqlari va samaradorlik natijalari asl tadqiqotga asoslangan. Tashqi manbalar faqat bibliografik identifikatsiya, DOI, jurnal va nashriyotning taqriz/litsenziya siyosatlarini tasdiqlash uchun ishlatilgan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan