

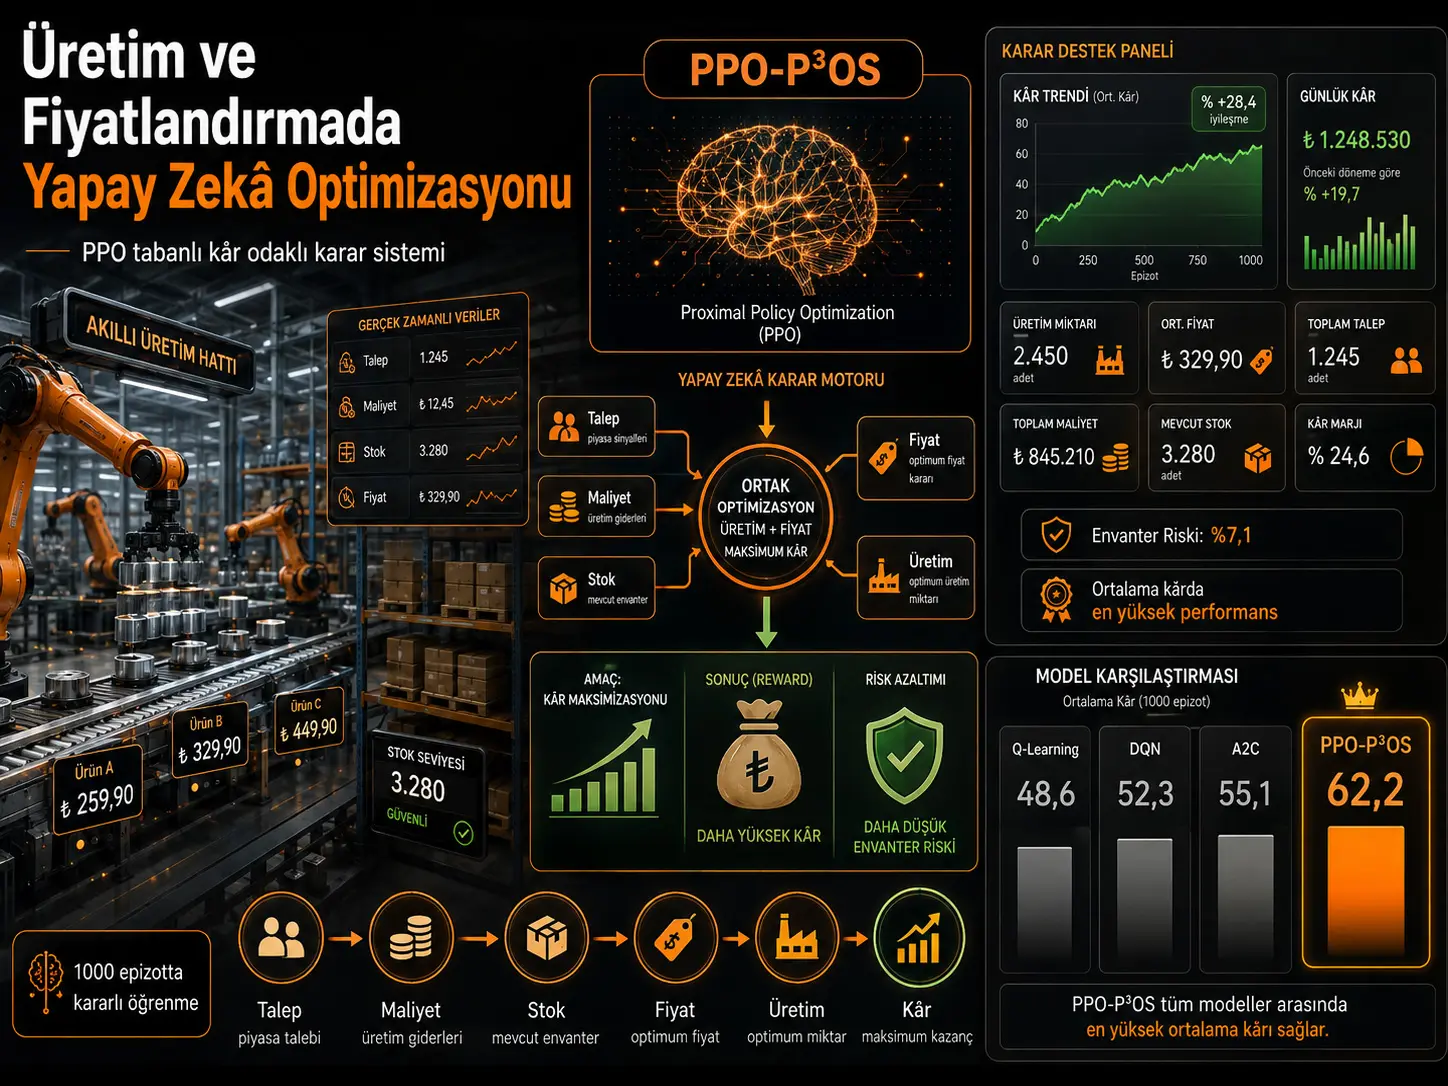
İstehsalçı bu gün neçə ədəd məhsul istehsal etməli və məhsulu hansı qiymətə satmalıdır? Tələb, xammal xərcləri və ehtiyat miqdarı daim dəyişirsə, bu iki qərar bir-birindən müstəqil verilə bilməz. Bu tədqiqat istehsal miqdarı ilə satış qiymətini eyni vaxtda tənzimləyə bilən və məqsədi uzunmüddətli mənfəəti artırarkən ehtiyat riskini məhdudlaşdırmaq olan gücləndirici öyrənmə sistemi təklif edir. Tədqiqatçıların PPO-P³OS adlandırdığı sistem Proximal Policy Optimization (PPO) alqoritmindən istifadə edir. Süni intellekt agenti hər qərar addımında istehsal xərcini, bazar tələbini, mövcud ehtiyat səviyyəsini və məhsul qiymətini müşahidə edir; sonra yeni qiymət və istehsal miqdarı ilə bağlı davamlı qiymətli qərarlar yaradır.
Model istehsal və qiymətqoyma problemini Markov Qərar Prosesi (MDP) kimi müəyyənləşdirir. Mükafat funksiyası satılan məhsullardan əldə olunan marjanı artırmağa çalışarkən tələb ilə istehsal/ehtiyat arasındakı tarazsızlığı kvadratik cəza ilə azaldır. Təxminən 36.000 nümunədən ibarət olduğu bildirilən real və sintetik məlumatların birləşməsi üzərində aparılan simulyasiyalarda PPO-P³OS; Q-Learning, Deep Q-Network (DQN) və Advantage Actor-Critic (A2C) ilə müqayisə edilir. Cədvəl 1-ə görə orta mənfəət PPO-P³OS-da 62,2×10³ USD olduğu halda A2C-də 55,1×10³ USD, DQN-da 52,3×10³ USD və Q-Learning-də 48,6×10³ USD kimi hesabatlandırılır.
Bununla belə, tədqiqat real istehsal müəssisəsində canlı qərarvermə sistemi kimi təsdiqlənməyib. Məlumat dəstinin real hissəsi 2021–2023 dövründə orta ölçülü istehlak malları istehsalçısından alınmış ERP və MES qeydlərinə əsaslanır, ümumi məlumat dəsti isə sintetik simulyasiya məlumatları ilə genişləndirilib. Real və sintetik məlumatların nisbəti və sintetik məlumatların yaradılma üsulu kifayət qədər ətraflı açıqlanmadığı üçün nəticələr simulyasiya/benchmark uğuru kimi qiymətləndirilməlidir; real zavodlarda eyni mənfəət artımının təmin ediləcəyi nəticəsinə birbaşa gəlmək olmaz.
Niyə istehsal miqdarı ilə qiymət birlikdə nəzərdən keçirilməlidir?
İstehsal müəssisəsində qiymət yalnız marketinq şöbəsinin, istehsal miqdarı da yalnız fabrikin müstəqil qərarı deyil. Qiymət tələbə təsir edir; tələb istehsal ehtiyacını dəyişir; istehsal miqdarı ehtiyatlara və xərclərə təsir edir; xərc dəyişdikcə məqbul qiymət səviyyəsi də yenidən dəyişir.
Məsələn, tələb gözləniləndən aşağı olduqda istehsalın yüksək saxlanması ehtiyat yığılmasına səbəb ola bilər. İstehsal xərci artarkən satış qiyməti dəyişməzsə, vahid üzrə mənfəət marjası kiçilə bilər. Qiymət həddən artıq artırılarsa tələb düşə bilər. Qiymət həddən artıq aşağı saxlanarsa satış miqdarı artsa belə, gəlirlilik zərər görə bilər.
Tədqiqatın çıxış nöqtəsi bu dəyişənlər arasındakı əlaqənin xətti və sabit olmamasıdır. Buna görə tədqiqatçılar yalnız müəyyən anda riyazi optimum axtaran statik yanaşma əvəzinə, mühitdən əks əlaqə alaraq zamanla siyasət öyrənən gücləndirici öyrənmə agentindən istifadə edirlər.
PPO-P³OS nədir?
PPO-P³OS, tədqiqatda istifadə olunan Profit-Oriented Production and Pricing Optimization System ifadəsinin qısaltmasıdır. Sistem Proximal Policy Optimization alqoritmini istehsal iqtisadiyyatı probleminə uyğunlaşdırır.
Şəkil 1-də model dörd əsas blokla göstərilir:
- Vəziyyət (State): istehsal xərci, ehtiyat səviyyəsi, bazar tələbi və mövcud qiymət,
- PPO siyasəti: mövcud vəziyyəti qiymətləndirərək qərar yaradan öyrənilmiş siyasət,
- Hərəkət (Action): tənzimlənmiş qiymət və istehsal miqdarı,
- Mükafat (Reward): mənfəət ilə ehtiyat riskini birlikdə qiymətləndirən əks əlaqə.
Agent aldığı mükafatlardan öyrənərək uzun müddətdə daha yüksək ümumi mükafat təmin edəcək qiymət–istehsal kombinasiyalarına yönəlir.
Vəziyyət fəzasında hansı məlumatlar var?
Zamanın t addımındakı vəziyyət vektoru tədqiqatda belə müəyyənləşdirilir:
\[ s_t=[C_t,D_t,I_t,P_t] \]
Burada:
- Ct: vahid istehsal xərci,
- Dt: bazar tələbi,
- It: mövcud ehtiyat səviyyəsi,
- Pt: mövcud məhsul qiymətidir.
Bu dörd dəyişən agent üçün iqtisadi mühitin həmin andakı xülasəsini təşkil edir.
Süni intellekt hansı qərarları verir?
Hərəkət vektoru:
\[ a_t=[p_t,q_t] \]
şəklindədir. Mənbədə pt qiymət tənzimlənməsini, qt isə istehsal tənzimlənməsini təmsil edir.
Buradakı mühüm texniki fərq odur ki, qərarlar DQN kimi yalnız əvvəlcədən müəyyən edilmiş bir neçə seçimdən birini seçməyə məcbur deyil. PPO davamlı hərəkət fəzalarında işləyə bildiyi üçün qiyməti və istehsal miqdarını davamlı dəyişən kimi modelləşdirə bilər.
Modelin mükafat funksiyası nəyi optimallaşdırır?
Tədqiqatda mükafat belə müəyyənləşdirilir:
\[ r_t=(p_t-C_t)\cdot \min(q_t,D_t)-\lambda(I_t+q_t-D_t)^2 \]
Birinci hədd satışlardan əldə olunan iqtisadi gəliri təmsil edir. min(qt,Dt) ifadəsi satıla bilən miqdarın istehsal ilə tələbin kiçik olanı ilə məhdudlaşdırıldığı sadələşdirilmiş quruluşdur.
İkinci hədd:
\[ \lambda(I_t+q_t-D_t)^2 \]
ehtiyat tarazsızlığını cəzalandırır. λ böyüdükcə agent ehtiyat tarazsızlığına qarşı daha həssas olur.
Kvadratik cəza səbəbindən tələb ilə mövcud ehtiyat üstəgəl istehsal arasındakı fərq böyüdükcə cəza sürətlə artır. Beləliklə sistem yalnız qısamüddətli satış marjasını yüksəltmək əvəzinə ehtiyat idarəetməsini də mükafat funksiyasına daxil edir.
Uzunmüddətli məqsəd nədir?
PPO agentinin məqsədi diskontlaşdırılmış ümumi mükafatı maksimumlaşdırmaqdır:
\[ J(\theta)=E_t\left[\sum_{t=0}^{T}\gamma^t r_t\right] \]
Burada γ diskont əmsalıdır. Təcrübələrdə γ = 0,99 istifadə olunub. Bu yüksək dəyər modelin yalnız növbəti qərarı deyil, daha sonrakı iqtisadi nəticələri də əhəmiyyətli sayacaq şəkildə qurulduğunu göstərir.
PPO niyə seçildi?
PPO siyasət qradiyenti alqoritmidir. Əsas məqsəd siyasətin hər təlim addımında həddən artıq böyük dəyişikliklər etməsinin qarşısını alaraq öyrənməni daha sabit etməkdir.
Tədqiqatda istifadə olunan kəsilmiş PPO məqsəd funksiyası:
\[ L^{CLIP}(\theta) = E_t \left[ \min \left( r_t(\theta)\hat{A}_t, \operatorname{clip}(r_t(\theta),1-\epsilon,1+\epsilon)\hat{A}_t \right) \right] \]
şəklində verilir.
Buradakı ehtimal nisbəti:
\[ r_t(\theta)= \frac{\pi_\theta(a_t|s_t)} {\pi_{\theta_{old}}(a_t|s_t)} \]
yeni siyasətlə köhnə siyasətin eyni hərəkətə verdiyi ehtimal sıxlıqlarını müqayisə edir. ε = 0,2 kəsmə parametri yeniləmənin həddən artıq böyüməsinin qarşısını almağa kömək edir.
Generalized Advantage Estimation nə iş görür?
Model üstünlük dəyərinin qiymətləndirilməsində Generalized Advantage Estimation (GAE) istifadə edir. Mənbədə:
\[ \hat A_t= \delta_t+ (\gamma\lambda)\delta_{t+1} +\ldots+ (\gamma\lambda)^{T-t+1}\delta_{T-1} \]
və:
\[ \delta_t=r_t+\gamma V(s_{t+1})-V(s_t) \]
ifadələri verilir.
Təcrübələrdə GAE üçün λ = 0,95 seçilib. Məqsəd üstünlük qiymətləndirilməsində qərəz ilə variasiya arasında uyğun tarazlıq yaratmaqdır.
Actor və Critic nə iş görür?
PPO-P³OS iki neyron şəbəkə komponentindən ibarətdir.
Actor, mövcud vəziyyətdən qiymət və istehsal qərarlarını yaradan siyasəti təmsil edir. Davamlı hərəkətlər Qauss paylanması üzərindən modelləşdirilir.
Critic isə müəyyən vəziyyətdən başlayaraq gələcəkdə gözlənilə bilən mükafatı təxmin edən dəyər funksiyasını öyrənir.
Təcrübə quruluşunda iki gizli qatın 256 və 128 neyrondan ibarət olduğu və ReLU aktivləşdirmələrindən istifadə edildiyi bildirilir. Metod bölməsində şəbəkələr ayrıca “üç tam bağlı qat” kimi təsvir olunur; mənbə çıxış qatını sayıb-saymadığını açıq şəkildə göstərmir.
Model necə təlimləndirildi?
| Parametr | Mənbədə verilən dəyər |
|---|---|
| Proqram təminatı | PyTorch 2.2 |
| Təlim epizodu | 1000 |
| Epizod başına zaman addımı | 200 |
| Gizli qatlar | 256 və 128 neyron |
| Aktivləşdirmə | ReLU |
| Öyrənmə sürəti | 3 × 10⁻⁴ |
| Diskont əmsalı γ | 0,99 |
| PPO clip nisbəti ε | 0,2 |
| Batch ölçüsü | 128 |
| GAE λ | 0,95 |
| Təcrübənin təkrar sayı | 5 |
Avadanlıq kimi Intel Core i9-13900K prosessoru, 64 GB RAM və NVIDIA RTX 4090 GPU istifadə olunub.
Məlumat dəsti həqiqətən zavod məlumatıdırmı?
Qismən. Tədqiqat məlumat dəstini real müəssisə məlumatları ilə sintetik simulyasiya məlumatlarının birləşməsi kimi müəyyənləşdirir.
Real məlumat komponentinin istehlak malları sektorunda fəaliyyət göstərən orta ölçülü istehsal müəssisəsinin 2021–2023 dövrünə aid ERP və Manufacturing Execution System (MES) qeydlərindən gəldiyi bildirilir.
Lakin şirkətin adı, yerləşdiyi ölkə, məhsulların təfərrüatları və real qeydlərin ümumi 36.000 nümunə içindəki payı verilmir. Təxminən üç illik real məlumat dövrünə baxmayaraq, ümumi məlumat dəstinin təxminən 36.000 nümunədən ibarət olduğu və hər nümunənin “bir günlük əməliyyat vəziyyətini” təmsil etdiyi yazılır. Buna görə məlumat dəstindəki sintetik genişlənmənin miqyası və üsulu nəticələrin təkrar istehsalı baxımından mühüm, lakin kifayət qədər açıqlanmamış məsələdir.
Məlumatlarda hansı dəyişənlər var?
Tədqiqatçılar 12 kəmiyyət və iki kateqorik xüsusiyyət bildirirlər.
İstehsal dəyişənləri:
- gündəlik istehsal miqdarı,
- maşından istifadə nisbəti,
- xammalın mövcudluğu.
Bazar dəyişənləri:
- bazar tələbi,
- rəqiblərin orta qiyməti,
- mövsümilik indeksi.
Xərc dəyişənləri:
- vahid istehsal xərci,
- enerji xərci,
- logistika xərci.
Mənfəətlilik dəyişənləri:
- faktiki satış qiyməti,
- gündəlik mənfəət,
- ehtiyat səviyyəsi.
Kateqorik dəyişənlər məhsul növü və bazar regionudur. Xüsusiyyətlərin min–max miqyaslama üsulu ilə normallaşdırıldığı bildirilir.
Biznes analitikası qatı nə əlavə edir?
Tədqiqat yalnız PPO siyasətinin hərəkət yaratmasını deyil, öyrənilmiş qərarların tələb elastikliyi və marjinal xərc kimi iqtisadi anlayışlarla şərh edilməsini də hədəfləyir.
Lakin mənbədə bu “business analytics” qatına aid ayrıca təsdiqləmə cədvəli, izaholunma metriyi və ya menecerlərlə aparılmış istifadəçi tədqiqatı verilmir. Buna görə izah edilə bilən qərar dəstəyi bölməsi modelin dizayn məqsədlərindən biridir; eksperimental olaraq ayrıca və ətraflı qiymətləndirilmiş modul deyil.
Məqalənin ən mühüm ədədi nəticəsi nədir?
Cədvəl 1 dörd üsulu müqayisə edir:
| Model | Orta mənfəət (×10³ USD) | Mənfəət variasiyası (%) | Ehtiyat riski (%) | Son itki | Yaxınlaşmanın qiymətləndirilməsi |
|---|---|---|---|---|---|
| Q-Learning | 48,6 | 12,5 | 10,7 | 0,61 | Orta |
| DQN | 52,3 | 9,8 | 9,3 | 0,47 | Orta |
| A2C | 55,1 | 7,0 | 8,5 | 0,36 | Sabit |
| PPO-P³OS | 62,2 | 6,0 | 7,1 | 0,23 | Çox sabit |
%12,8-lik mənfəət artımı dəqiq olaraq nəyə görədir?
Məqalənin öz mətnində burada uyğunsuzluq var.
Cədvəl 1 istifadə edildikdə PPO-P³OS ilə ən güclü rəqib A2C arasındakı mənfəət fərqi:
\[ \frac{62.2-55.1}{55.1}\times100 \approx 12.9\% \]
olur. Bu, nəticə bölməsindəki “ən yaxşı baseline A2C-yə görə təxminən %12,8” ifadəsi ilə uyğundur.
Lakin DQN baza götürülsə:
\[ \frac{62.2-52.3}{52.3}\times100 \approx 18.9\% \]
alınır.
Buna görə xülasə və nəticə bölmələrində %12,8 dəyərinin DQN-a qarşı təqdim edilməsi Cədvəl 1 ilə uyğun gəlmir.
Ehtiyat riskində də eyni problem varmı?
Bəli. A2C-nin ehtiyat riski %8,5, PPO-P³OS-un isə %7,1-dir:
\[ \frac{8.5-7.1}{8.5}\times100 \approx 16.5\% \]
Bu dəyər məqalədəki %16,4 iddiası ilə uyğundur və baza xəttinin A2C olduğunu göstərir.
DQN-un %9,3-lük dəyəri istifadə edilərsə PPO-P³OS-un azalması təxminən %23,7 olur. Deməli, %16,4-lük dəyər DQN müqayisəsi deyil.
Son itki üçün vəziyyət necədir?
DQN-da son itki 0,47, PPO-P³OS-da 0,23-dür. Xam cədvəl dəyərlərindən:
\[ \frac{0.47-0.23}{0.47}\times100 \approx 51.1\% \]
azalma hesablanır. Bu dəyər məqalədəki təxminən %50,9-luq son itki azalmasına yaxındır və bu dəfə müqayisənin həqiqətən DQN-a görə aparıldığı anlaşılır.
Beləliklə, mənbə eyni xülasə cümləsində müxtəlif performans göstəriciləri üçün fərqli baza xətlərini bir-birinə qarışdırmış görünür.
Şəkil 2 bizə nə göstərir?
Şəkil 2-də iki təlim əyrisi var. Birinci qrafikdə orta mənfəət təxminən 50×10³ USD səviyyəsindən başlayır, ilk bir neçə yüz epizodda sürətlə yüksəlir və 1000-ci epizoda yaxın təxminən 62×10³ USD ətrafında plato yaradır.
İkinci qrafikdə təlim itkisi təxminən 1,05 səviyyəsindən davamlı azalaraq 1000-ci epizodda təxminən 0,22–0,23 səviyyəsinə gəlir.
Bu iki əyri modelin verilmiş təlim mühitində öyrənmə prosesinin sabitləşdiyini dəstəkləyir. Lakin təlim itkisinin azalması və simulyasiya mənfəətinin yüksəlməsi modelin real dünya istehsal müəssisələrində eyni iqtisadi performansı göstərəcəyini təkbaşına sübut etmir.
PPO-P³OS həqiqətən “optimal” siyasəti tapdı?
Tədqiqat modelin “optimal” və ya “near-optimal” siyasət öyrəndiyini bildirir. Bununla belə, təcrübələrdə real riyazi qlobal optimumun məlum olduğu və PPO nəticəsinin həmin optimumla müqayisə edildiyi optimality-gap analizi təqdim edilmir.
Buna görə nəticələri daha ehtiyatlı şəkildə, araşdırılan simulyasiya mühitində sınaqdan keçirilmiş baseline üsullardan daha yüksək hesabatlandırılmış performans təmin edən öyrənilmiş siyasət kimi müəyyənləşdirmək daha təhlükəsizdir.
Tədqiqat nəyi dəstəkləyir?
- Qiymət və istehsal miqdarı vahid davamlı nəzarət problemi daxilində birlikdə modelləşdirilə bilər.
- PPO bu tədqiqatın simulyasiya mühitində Q-Learning, DQN və A2C-dən daha yüksək hesabatlandırılmış orta mənfəət yaradıb.
- PPO-P³OS Cədvəl 1-də müqayisə edilən modellər arasında ən aşağı mənfəət variasiyasına və ehtiyat riskinə malikdir.
- 1000 epizodlu təlim zamanı mənfəət əyrisi yüksəlib, itki əyrisi isə azalıb.
- Ehtiyat tarazsızlığının mükafat funksiyasına cəza kimi əlavə edilməsi yalnız qısamüddətli marjanı deyil, əməliyyat tarazlığını da hədəfləməyə imkan verir.
- Davamlı hərəkət fəzalarında qiymət və istehsal miqdarının birlikdə tənzimlənməsi PPO üçün təbii tətbiq sahəsi yarada bilər.
Tədqiqat nəyi sübut etmir?
- PPO-P³OS-un real istehsal müəssisəsində %12,8 daha çox mənfəət təmin edəcəyini sübut etmir.
- Model real vaxtlı zavod əməliyyatında canlı şəkildə tətbiq edilməyib.
- 36.000 nümunənin hamısı real zavod müşahidəsi deyil.
- Sintetik məlumatların real bazar dalğalanmalarını tam təmsil etdiyi göstərilməyib.
- Modellər arasındakı iqtisadi fərqlər üçün etibar intervalı və ya statistik əhəmiyyət testi verilmir.
- PPO siyasətinin qlobal riyazi optimuma çatdığı göstərilmir.
- Tək müəssisədən gələn real məlumat komponentinin bütün istehsal sektorlarına ümumiləşdirilə biləcəyi sübut edilmir.
- Biznes analitikası qatının menecerlərin real qərar keyfiyyətini artırdığı istifadəçi və ya sahə tədqiqatı ilə sınanmayıb.
Tədqiqatın Metodu və Nəticələri
Eksperimental məlumat quruluşu
Tədqiqatın real məlumat komponenti istehlak malları sektorundakı orta ölçülü istehsal müəssisəsinin 2021–2023 dövrünə aid ERP və MES qeydlərindən əldə edilib. Bunlara sintetik simulyasiya məlumatları əlavə edilərək təxminən 36.000 nümunəlik məlumat dəstinin yaradıldığı bildirilir.
Müəlliflər hər nümunəni bir günlük əməliyyat vəziyyəti kimi müəyyənləşdirirlər. Lakin real/sintetik nümunə saylarının ayrıca verilməməsi və sintetik məlumatların yaradılma prosesinin ətraflı təsvir edilməməsi tədqiqatın ən mühüm təkrar istehsal məhdudiyyətlərindən biridir.
Müqayisə edilən alqoritmlər
PPO-P³OS üç baseline ilə müqayisə edilib:
- Q-Learning,
- Deep Q-Network (DQN),
- Advantage Actor-Critic (A2C).
Qiymətləndirmə meyarları orta mənfəət, mənfəət variasiyası, ehtiyat riski, son itki və yaxınlaşma sabitliyidir.
Xam eksperimental nəticələr
| Meyar | Q-Learning | DQN | A2C | PPO-P³OS |
|---|---|---|---|---|
| Orta mənfəət (×10³ USD) | 48,6 | 52,3 | 55,1 | 62,2 |
| Mənfəət variasiyası (%) | 12,5 | 9,8 | 7,0 | 6,0 |
| Ehtiyat riski (%) | 10,7 | 9,3 | 8,5 | 7,1 |
| Son itki | 0,61 | 0,47 | 0,36 | 0,23 |
Xam cədvəl PPO-P³OS-un dörd meyarın hamısında müqayisə edilən baseline modellərdən daha yaxşı ədədi dəyərlər verdiyini göstərir.
Təkrarlana bilmə baxımından çatışmayan məlumatlar
Tədqiqat təlim hiperparametrlərini nisbətən ətraflı versə də, təcrübənin tam yenidən istehsalı üçün bəzi mühüm məlumatlar çatışmır:
- real məlumat dəstinin tam ölçüsü,
- sintetik nümunələrin sayı,
- sintetik məlumat yaratma tənlikləri və ya paylanmaları,
- müəssisə və bazarın ətraflı konteksti,
- train/validation/test bölünmə üsulu,
- təsadüfi toxumlar,
- baseline alqoritmlərinin ətraflı hiperparametrləri,
- beş təkrar üçün standart sapma və ya etibar intervalları,
- mənbə kodu və ya açıq eksperimental məlumat dəsti.
Buna görə nəticələrin müstəqil komanda tərəfindən eyni şərtlərdə təkrar istehsalı mənbədə verilən məlumatlarla məhdud qalır.
İstinad bütövlüyündəki problemlər
Məqalənin ədəbiyyat bölməsində bəzi mətn–mənbə uyğunluqları problemli görünür. Girişdə maşın öyrənməsi əsaslı səbəbiyyət çıxarışı tətbiqini dəstəkləmək üçün [1] istifadə olunub; lakin ədəbiyyat siyahısındakı [1] xətti proqramlaşdırma ilə məhsul qarışığı mənfəətinin maksimumlaşdırılmasına dair 2012-ci il tədqiqatıdır.
Bölmə 2.1-də “Aktepe et al.” tərəfindən aparıldığı deyilən regressiya, ANN və SVR əsaslı ehtiyat hissə tələb proqnozlaşdırılması tədqiqatına [5] istinadı verilib. Ədəbiyyat siyahısındakı [5] isə Zhuang və həmkarlarının “Behavior Proximal Policy Optimization” adlı arXiv işidir.
Bu vəziyyət əsas PPO eksperimental nəticələrini avtomatik olaraq etibarsız etmir; lakin ədəbiyyat icmalındakı bəzi dəstəkləyici ifadələrin mənbə yoxlaması aparılmadan təkrarlanmamalı olduğunu göstərir.
Sənaye tətbiqinə keçid üçün nə lazımdır?
Bu yanaşmanın real istehsal müəssisəsinə köçürülməsi üçün simulyasiya uğurundan əlavə təsdiqləmə tələb olunur. Ən azı real istehsal gücü, maşın nasazlıqları, çatdırılma müddətləri, məhsulun rəf ömrü, minimum sifariş miqdarları, növbə məhdudiyyətləri, təchizat müddətləri, qiymət elastikliyi, rəqabətçi qiymət reaksiyaları və itirilmiş satışlar kimi proseslərin modelə daxil edilməsi lazım gələ bilər.
Bundan əlavə, süni intellektin birbaşa qiymət müəyyən etdiyi sistemdə idarəetmə sərhədləri, minimum–maksimum qiymət qaydaları, insan təsdiqi, təhlükəsizlik qatları və gözlənilməz bazar şəraitində geri dönüş siyasətləri olmalıdır. Bunlar mənbə tədqiqatda eksperimental olaraq sınanmayıb.
Türkiyə baxımından necə qiymətləndirilməlidir?
Mənbədə Türkiyədən zavod və ya bazar məlumatı yoxdur. Buna görə tədqiqatdakı mənfəət və ehtiyat performansı dəyərləri Türkiyə istehsal müəssisələrinə birbaşa köçürülə bilməz.
Bununla belə, yanaşma ERP, MES, istehsal xərcləri, ehtiyat, tələb və qiymət tarixçəsini birlikdə saxlayan Türkiyədəki istehsal müəssisələrində ayrıca pilot tədqiqat üçün araşdırma çərçivəsi təmin edə bilər. Yerli tətbiqdə model firmanın öz güc, xərc, sifariş, məzənnə, enerji və təchizat zənciri dinamikaları ilə yenidən təlimləndirilməli və real əməliyyatdan əvvəl kölgə rejimində təsdiqlənməlidir.
Mənbə və Metod Qeydi
Tam orijinal tədqiqatın adı: Profit-Oriented Production and Pricing Optimization for Manufacturing Enterprises Using Proximal Policy Optimization
Müəlliflər: Pingmei Fan, Hanwu Li, Mengdie Hu.
Müəllif sırası: Mənbə tədqiqatındakı sıra olduğu kimi qorunub.
Məsul müəllif: Pingmei Fan.
Birgə birinci/bərabər töhfə: Mənbədə birgə birinci müəlliflik və ya bərabər töhfə bəyanı yoxdur.
Qurum 1: Guangxi Vocational Normal University, Nanning, Guangxi, China.
Qurum 2: Amazon.com Services LLC, Bellevue, Washington, USA.
Qurum 3: Systems Engineering, University of Pennsylvania, Philadelphia, Pennsylvania, USA.
Mənbə növü: Gücləndirici öyrənmə əsaslı hesablama/modelləşdirmə və simulyasiya tədqiqatı.
Jurnal: Economics and Management Innovation.
Cild / say: Vol. 3, No. 2 (2026).
Səhifələr: 8–17.
DOI: 10.71222/zsm3tb33
Göndərilmə tarixi: 1 yanvar 2026.
Reviziya tarixi: 25 fevral 2026.
Qəbul tarixi: 12 mart 2026.
Nəşr tarixi: 18 mart 2026.
Rəsmi məqalə bağlantısı: https://doi.org/10.71222/zsm3tb33
Rəyçilik/nəşr vəziyyəti: Economics and Management Innovation jurnalının nəşriyyat səhifəsi jurnalı rəyli və ikiqat-kor rəy prosesli kimi təsvir edir; GBP müəllif siyasəti nəşr olunan işlər üçün ən azı iki müstəqil rəyçi hesabatını nəzərdə tutduğunu bildirir. Məqalə səviyyəsində rəyçi hesabatları bu araşdırma zamanı ictimai olaraq təsdiqlənməyib.
Lisenziya: Mənbə PDF-də işin Creative Commons Attribution lisenziyası altında mümkün açıq girişli nəşrə təqdim olunduğu ifadə edilir. GBP-nin cari ümumi nəşr siyasəti nəşr olunan məqalələrin CC BY 4.0 altında olduğunu bildirir.
Maliyyələşdirmə: Araşdırılan məqalə mətnində tədqiqata xüsusi ayrıca maliyyələşdirmə bəyanı yoxdur.
Məlumatların əlçatanlığı: Araşdırılan məqalədə ayrıca Data Availability Statement yoxdur. Real müəssisə məlumatlarının kimliyi açıqlanmır və məlumat dəsti üçün açıq repozitoriya bağlantısı verilmir.
Maraqlar toqquşması: Araşdırılan məqalədə müəlliflərin tədqiqata xüsusi ayrıca maraqlar toqquşması bəyanı yoxdur.
Etik komitə: Araşdırılan mətndə tədqiqata xüsusi etik komitə bəyanı yoxdur.
CRediT/müəllif töhfələri: Mənbədə ayrıca CRediT və ya müəllif töhfələri bölməsi yoxdur.
Məlumat əhatəsi: Məqalə təxminən 36.000 nümunədən ibarət, real müəssisə məlumatları ilə sintetik simulyasiya məlumatlarının birləşdirildiyi məlumat dəsti bildirir. Real komponent 2021–2023 dövründə orta ölçülü istehlak malları istehsalçısının ERP və MES qeydlərindən gəlir. Real və sintetik nümunələrin ayrıca miqdarları açıqlanmır.
Əsas metodoloji sərhəd: Tədqiqat real vaxtlı zavod yerləşdirilməsi deyil. Nəticələr qurulmuş eksperimental mühitdə əldə edilən benchmark performansıdır. Sintetik məlumatların yaradılması, məlumatların bölünmə üsulu, baseline hiperparametrləri və təkrarlar arasındakı qeyri-müəyyənlik ölçüləri kifayət qədər ətraflı hesabatlandırılmadığı üçün müstəqil təkrar istehsal imkanı məhduddur.
Mənbədaxili performans uyğunsuzluğu: Cədvəl 1-ə görə PPO-P³OS-un 62,2×10³ USD orta mənfəəti A2C-nin 55,1×10³ USD dəyərindən təxminən %12,9 yüksəkdir və ehtiyat riski A2C-nin %8,5 dəyərindən PPO-P³OS-da %7,1-ə düşərək təxminən %16,5 azalır. DQN baza götürüldükdə eyni fərqlər müvafiq olaraq təxminən %18,9 və %23,7-dir. Buna baxmayaraq, xülasə və nəticə bölməsində %12,8 mənfəət artımı və %16,4 ehtiyat azalması DQN ilə birlikdə qeyd olunur. Təxminən %50,9 son itki azalması isə DQN müqayisəsi ilə uyğundur. Bu Verianla məzmununda xam cədvəl dəyərləri əsas götürülüb.
Terminologiya qeydi: Mənbənin xülasə və nəticə bölmələrində performans artımı “cumulative profit” adlandırıldığı halda Cədvəl 1 və Şəkil 2-də istifadə olunan meyar “Average Profit”dir. Bu iki ifadə bir-birinə bərabər qəbul edilməyib.
Ədəbiyyat siyahısının bütövlüyü qeydi: Məqalənin bəzi mətn daxili istinadları ədəbiyyat siyahısı ilə uyğun gəlmir. Xüsusilə [1] və [5] nömrəli mənbələrin mətndə bağlandığı tədqiqatlarla ədəbiyyat siyahısında göstərilən işlər arasında açıq mövzu/müəllif uyğunsuzluğu var.
Elmi məzmun sərhədi: Bu Verianla yazısındakı model quruluşu, tənliklər, məlumat xüsusiyyətləri, hiperparametrlər, təlim əyriləri və performans nəticələri orijinal tədqiqata əsaslanır. Xarici mənbələr yalnız biblioqrafik kimliyin, DOI-nin, jurnalın və nəşriyyatın rəyçilik/lisenziya siyasətlərinin doğrulanması üçün istifadə olunub.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib