

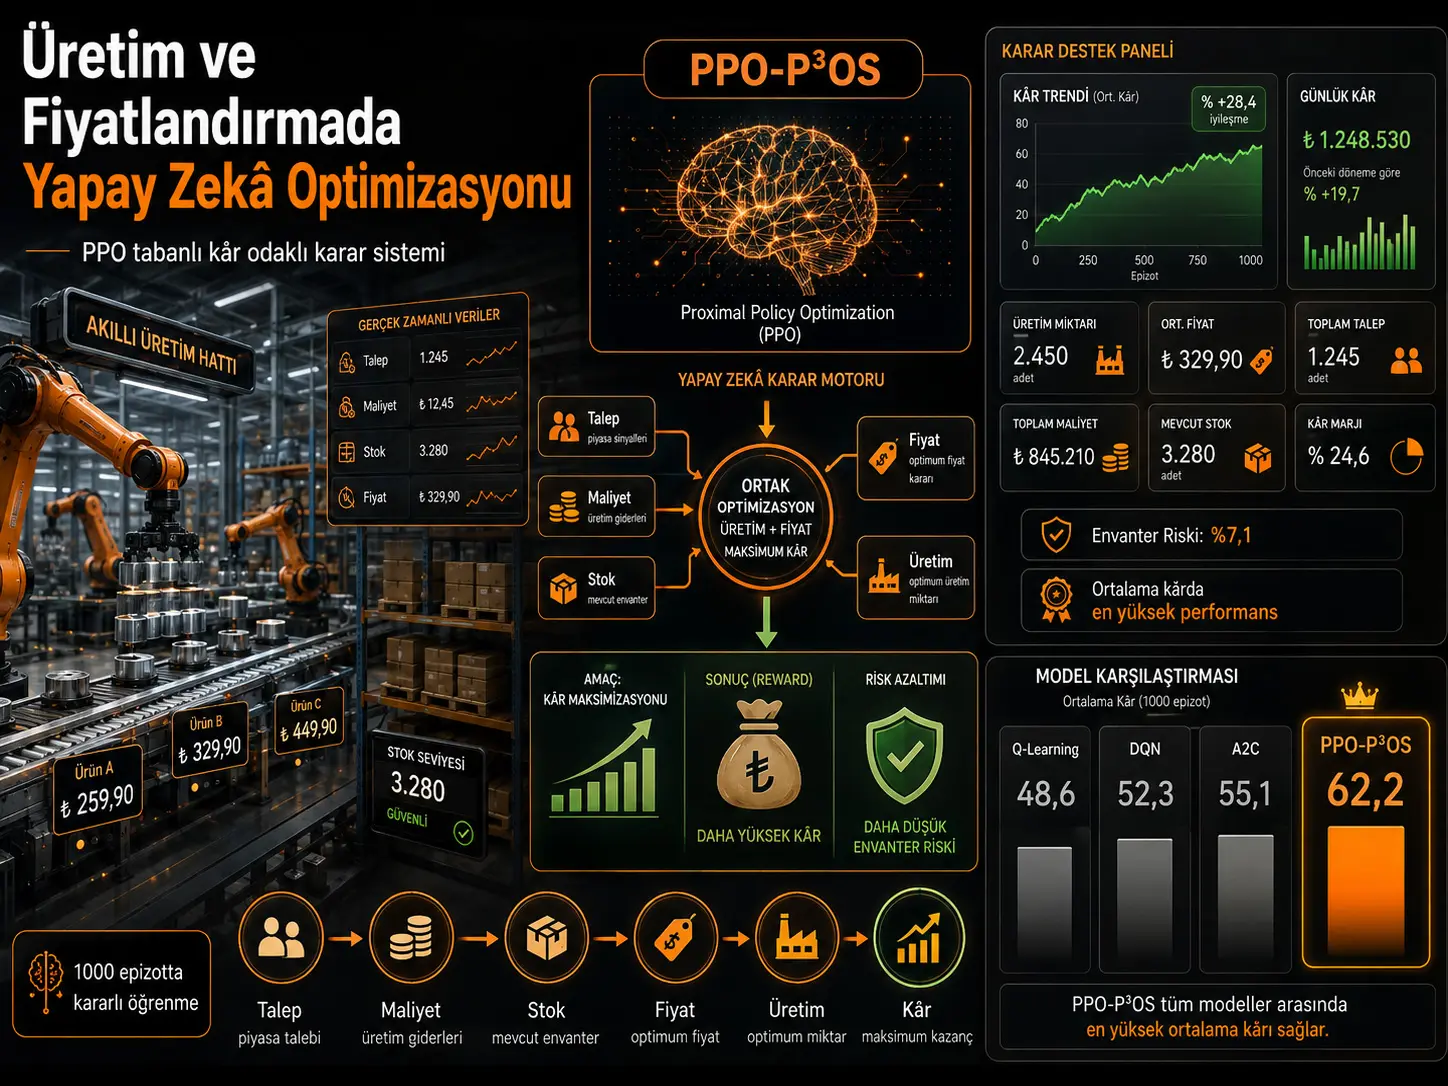
Bir üretici bugün kaç adet ürün üretmeli ve ürünü hangi fiyattan satmalı? Talep, ham madde maliyetleri ve stok miktarı sürekli değişiyorsa bu iki karar birbirinden bağımsız verilemez. Bu çalışma, üretim miktarı ile satış fiyatını aynı anda ayarlayabilen ve amacı uzun dönemli kârı artırırken stok riskini sınırlamak olan bir pekiştirmeli öğrenme sistemi öneriyor. Araştırmacıların PPO-P³OS adını verdiği sistem, Proximal Policy Optimization (PPO) algoritmasını kullanıyor. Yapay zekâ ajanı her karar adımında üretim maliyetini, piyasa talebini, mevcut stok seviyesini ve ürün fiyatını gözlemliyor; ardından yeni fiyat ile üretim miktarına ilişkin sürekli değerli kararlar üretiyor.
Model, üretim ve fiyatlandırma problemini bir Markov Karar Süreci (MDP) olarak tanımlıyor. Ödül fonksiyonu satılan ürünlerden elde edilen marjı artırmaya çalışırken talep ile üretim/stok arasındaki dengesizliği karesel bir ceza ile azaltıyor. Yaklaşık 36.000 örnekten oluştuğu bildirilen gerçek ve sentetik verilerin birleşimi üzerinde yapılan simülasyonlarda PPO-P³OS; Q-Learning, Deep Q-Network (DQN) ve Advantage Actor-Critic (A2C) ile karşılaştırılıyor. Tablo 1'e göre ortalama kâr PPO-P³OS'ta 62,2×10³ USD iken A2C'de 55,1×10³ USD, DQN'da 52,3×10³ USD ve Q-Learning'de 48,6×10³ USD olarak raporlanıyor.
Bununla birlikte çalışma gerçek bir üretim tesisinde canlı karar verme sistemi olarak doğrulanmış değildir. Veri setinin gerçek kısmı 2021–2023 dönemindeki bir orta ölçekli tüketim malları üreticisinden alınmış ERP ve MES kayıtlarına dayandırılırken, toplam veri seti sentetik simülasyon verileriyle genişletilmiştir. Gerçek ve sentetik verinin oranı ile sentetik veri üretim yöntemi yeterince ayrıntılı açıklanmadığından sonuçlar simülasyon/benchmark başarısı olarak değerlendirilmelidir; gerçek fabrikalarda aynı kâr artışının sağlanacağı sonucuna doğrudan ulaşılamaz.
Neden üretim miktarı ile fiyat birlikte düşünülmeli?
Bir üretim işletmesinde fiyat yalnız pazarlama departmanının, üretim miktarı da yalnız fabrikanın vereceği bağımsız kararlar değildir. Fiyat talebi etkiler; talep üretim ihtiyacını değiştirir; üretim miktarı stokları ve maliyetleri etkiler; maliyet değiştikçe kabul edilebilir fiyat seviyesi yeniden değişir.
Örneğin talep beklenenden düşükken üretimin yüksek tutulması stok birikimine yol açabilir. Üretim maliyeti yükselirken satış fiyatı değişmezse birim kâr marjı küçülebilir. Fiyat aşırı yükseltilirse talep düşebilir. Fiyat fazla düşük tutulursa satış miktarı artsa bile kârlılık zarar görebilir.
Çalışmanın çıkış noktası, bu değişkenler arasındaki ilişkinin doğrusal ve sabit olmamasıdır. Araştırmacılar bu nedenle yalnız belirli bir anda matematiksel optimum arayan statik bir yaklaşım yerine, çevreden geri bildirim alarak zaman içinde politika öğrenen bir pekiştirmeli öğrenme ajanı kullanıyor.
PPO-P³OS nedir?
PPO-P³OS, çalışmada kullanılan Profit-Oriented Production and Pricing Optimization System ifadesinin kısaltmasıdır. Sistem Proximal Policy Optimization algoritmasını üretim ekonomisi problemine uyarlamaktadır.
Şekil 1'de model dört temel blokla gösterilir:
- Durum (State): üretim maliyeti, stok seviyesi, piyasa talebi ve mevcut fiyat,
- PPO politikası: mevcut durumu değerlendirerek karar üreten öğrenilmiş politika,
- Eylem (Action): ayarlanmış fiyat ve üretim miktarı,
- Ödül (Reward): kâr ile stok riskini birlikte değerlendiren geri bildirim.
Ajan aldığı ödüllerden öğrenerek uzun dönemde daha yüksek toplam ödül sağlayacak fiyat–üretim kombinasyonlarına yönelmektedir.
Durum uzayında hangi bilgiler var?
Zamanın t adımındaki durum vektörü çalışmada şöyle tanımlanıyor:
\[ s_t=[C_t,D_t,I_t,P_t] \]
Burada:
- Ct: birim üretim maliyeti,
- Dt: piyasa talebi,
- It: mevcut stok seviyesi,
- Pt: mevcut ürün fiyatıdır.
Bu dört değişken ajan için ekonomik ortamın o andaki özetini oluşturuyor.
Yapay zekâ hangi kararları veriyor?
Eylem vektörü:
\[ a_t=[p_t,q_t] \]
biçimindedir. Kaynakta pt fiyat ayarlamasını, qt ise üretim ayarlamasını temsil eder.
Buradaki önemli teknik fark, kararların DQN gibi yalnız önceden tanımlanmış birkaç seçenekten birini seçmek zorunda olmamasıdır. PPO sürekli eylem uzaylarında çalışabildiği için fiyat ve üretim miktarını sürekli değişken olarak modelleyebilir.
Modelin ödül fonksiyonu neyi optimize ediyor?
Araştırmada ödül şu biçimde tanımlanıyor:
\[ r_t=(p_t-C_t)\cdot \min(q_t,D_t)-\lambda(I_t+q_t-D_t)^2 \]
İlk terim satışlardan elde edilen ekonomik getiriyi temsil ediyor. min(qt,Dt) ifadesi, satılabilecek miktarın üretim ile talebin küçük olanıyla sınırlandığı basitleştirilmiş bir yapıdır.
İkinci terim:
\[ \lambda(I_t+q_t-D_t)^2 \]
stok dengesizliğini cezalandırıyor. λ büyüdükçe ajan stok dengesizliğine karşı daha hassas hâle geliyor.
Karesel ceza nedeniyle talep ile mevcut stok artı üretim arasındaki fark büyüdükçe ceza hızla artıyor. Böylece sistem yalnız kısa vadeli satış marjını yükseltmek yerine stok yönetimini de ödül fonksiyonuna dahil ediyor.
Uzun vadeli hedef nedir?
PPO ajanının amacı iskonto edilmiş toplam ödülü maksimize etmektir:
\[ J(\theta)=E_t\left[\sum_{t=0}^{T}\gamma^t r_t\right] \]
Burada γ iskonto katsayısıdır. Deneylerde γ = 0,99 kullanılmıştır. Bu yüksek değer, modelin yalnız bir sonraki kararın değil daha sonraki ekonomik sonuçların da önemli olmasını sağlayacak biçimde ayarlandığını gösterir.
PPO neden seçildi?
PPO bir politika gradyanı algoritmasıdır. Temel amaç, politikanın her eğitim adımında aşırı büyük değişiklikler yapmasını engelleyerek öğrenmeyi daha kararlı hâle getirmektir.
Çalışmada kullanılan kırpılmış PPO amaç fonksiyonu:
\[ L^{CLIP}(\theta) = E_t \left[ \min \left( r_t(\theta)\hat{A}_t, \operatorname{clip}(r_t(\theta),1-\epsilon,1+\epsilon)\hat{A}_t \right) \right] \]
olarak veriliyor.
Buradaki olasılık oranı:
\[ r_t(\theta)= \frac{\pi_\theta(a_t|s_t)} {\pi_{\theta_{old}}(a_t|s_t)} \]
yeni politika ile eski politikanın aynı eyleme verdiği olasılık yoğunluklarını karşılaştırıyor. ε = 0,2 kırpma parametresi, güncellemenin aşırı büyümesini engellemeye yardımcı oluyor.
Generalized Advantage Estimation ne işe yarıyor?
Model, avantaj değerinin tahmininde Generalized Advantage Estimation (GAE) kullanıyor. Kaynakta:
\[ \hat A_t= \delta_t+ (\gamma\lambda)\delta_{t+1} +\ldots+ (\gamma\lambda)^{T-t+1}\delta_{T-1} \]
ve:
\[ \delta_t=r_t+\gamma V(s_{t+1})-V(s_t) \]
ifadeleri veriliyor.
Deneylerde GAE için λ = 0,95 seçilmiştir. Amaç avantaj tahmininde yanlılık ile varyans arasında uygun bir denge kurmaktır.
Actor ve Critic ne yapıyor?
PPO-P³OS iki sinir ağı bileşeninden oluşmaktadır.
Actor, mevcut durumdan fiyat ve üretim kararlarını üreten politikayı temsil eder. Sürekli eylemler Gauss dağılımı üzerinden modellenmektedir.
Critic ise belirli bir durumdan başlayarak gelecekte beklenebilecek ödülü tahmin eden değer fonksiyonunu öğrenmektedir.
Deney kurulumunda iki gizli katmanın 256 ve 128 nörondan oluştuğu ve ReLU aktivasyonlarının kullanıldığı belirtilmiştir. Yöntem bölümünde ağlar ayrıca “üç tam bağlı katman” olarak tanımlanmaktadır; kaynak çıkış katmanını sayıp saymadığını açıkça belirtmemektedir.
Model nasıl eğitildi?
| Parametre | Kaynakta verilen değer |
|---|---|
| Yazılım | PyTorch 2.2 |
| Eğitim epizodu | 1000 |
| Epizot başına zaman adımı | 200 |
| Gizli katmanlar | 256 ve 128 nöron |
| Aktivasyon | ReLU |
| Öğrenme oranı | 3 × 10⁻⁴ |
| İskonto katsayısı γ | 0,99 |
| PPO clip oranı ε | 0,2 |
| Batch boyutu | 128 |
| GAE λ | 0,95 |
| Deney tekrar sayısı | 5 |
Donanım olarak Intel Core i9-13900K işlemci, 64 GB RAM ve NVIDIA RTX 4090 GPU kullanılmıştır.
Veri seti gerçekten fabrika verisi mi?
Kısmen. Çalışma veri setini gerçek işletme verileri ile sentetik simülasyon verilerinin birleşimi olarak tanımlamaktadır.
Gerçek veri bileşeninin tüketim malları sektöründe faaliyet gösteren orta ölçekli bir üretim işletmesinin 2021–2023 dönemindeki ERP ve Manufacturing Execution System (MES) kayıtlarından geldiği belirtilmektedir.
Ancak şirketin adı, bulunduğu ülke, ürünlerin ayrıntıları ve gerçek kayıtların toplam 36.000 örnek içindeki oranı verilmemektedir. Yaklaşık üç yıllık gerçek veri dönemine karşın toplam veri setinin yaklaşık 36.000 örnekten oluştuğu ve her örneğin “bir günlük operasyonel durumu” temsil ettiği yazılmaktadır. Bu nedenle veri setindeki sentetik genişletmenin ölçeği ve yöntemi, sonuçların yeniden üretilmesi açısından önemli ancak yeterince açıklanmamış bir noktadır.
Veride hangi değişkenler var?
Araştırmacılar 12 nicel ve iki kategorik özellik bildirmektedir.
Üretim değişkenleri:
- günlük üretim miktarı,
- makine kullanım oranı,
- ham madde kullanılabilirliği.
Piyasa değişkenleri:
- piyasa talebi,
- rakiplerin ortalama fiyatı,
- mevsimsellik endeksi.
Maliyet değişkenleri:
- birim üretim maliyeti,
- enerji maliyeti,
- lojistik maliyeti.
Kârlılık değişkenleri:
- gerçek satış fiyatı,
- günlük kâr,
- stok seviyesi.
Kategorik değişkenler ürün türü ve pazar bölgesidir. Özelliklerin min–max ölçekleme yöntemiyle normalize edildiği belirtilmiştir.
İş analitiği katmanı ne ekliyor?
Çalışma yalnız PPO politikasının eylem üretmesini değil, öğrenilen kararların talep esnekliği ve marjinal maliyet gibi ekonomik kavramlarla yorumlanmasını da hedeflemektedir.
Ancak kaynakta bu “business analytics” katmanına ait ayrı bir doğrulama tablosu, açıklanabilirlik metriği veya yöneticilerle yapılmış kullanıcı çalışması verilmemektedir. Dolayısıyla açıklanabilir karar desteği bölümü, modelin tasarım hedeflerinden biridir; deneysel olarak ayrıntılı biçimde değerlendirilmiş ayrı bir modül değildir.
Makalenin en önemli sayısal sonucu nedir?
Tablo 1 dört yöntemi karşılaştırmaktadır:
| Model | Ortalama kâr (×10³ USD) | Kâr varyansı (%) | Envanter riski (%) | Son kayıp | Yakınsama değerlendirmesi |
|---|---|---|---|---|---|
| Q-Learning | 48,6 | 12,5 | 10,7 | 0,61 | Orta |
| DQN | 52,3 | 9,8 | 9,3 | 0,47 | Orta |
| A2C | 55,1 | 7,0 | 8,5 | 0,36 | Kararlı |
| PPO-P³OS | 62,2 | 6,0 | 7,1 | 0,23 | Çok kararlı |
%12,8'lik kâr artışı tam olarak neye göre?
Makalenin kendi metninde burada bir tutarsızlık vardır.
Tablo 1 kullanıldığında PPO-P³OS ile en güçlü rakip A2C arasındaki kâr farkı:
\[ \frac{62.2-55.1}{55.1}\times100 \approx 12.9\% \]
olmaktadır. Bu, sonuç bölümündeki “en iyi baseline A2C'ye göre yaklaşık %12,8” ifadesiyle uyumludur.
Ancak DQN baz alınırsa:
\[ \frac{62.2-52.3}{52.3}\times100 \approx 18.9\% \]
elde edilir.
Bu nedenle özet ve sonuç bölümlerinde %12,8 değerinin DQN'a karşı sunulması Tablo 1 ile uyuşmamaktadır.
Envanter riskinde de aynı sorun var mı?
Evet. A2C'nin envanter riski %8,5, PPO-P³OS'un %7,1'dir:
\[ \frac{8.5-7.1}{8.5}\times100 \approx 16.5\% \]
Bu değer makaledeki %16,4 iddiasıyla uyumludur ve baz çizginin A2C olduğunu göstermektedir.
DQN'un %9,3'lük değeri kullanılırsa PPO-P³OS'un azalması yaklaşık %23,7 olur. Dolayısıyla %16,4'lük değer DQN karşılaştırması değildir.
Son kayıp için durum nasıl?
DQN'daki son kayıp 0,47, PPO-P³OS'ta 0,23'tür. Ham tablo değerlerinden:
\[ \frac{0.47-0.23}{0.47}\times100 \approx 51.1\% \]
azalma hesaplanır. Bu değer makaledeki yaklaşık %50,9'luk son kayıp azalmasına yakındır ve bu kez karşılaştırmanın gerçekten DQN'a göre yapıldığı anlaşılmaktadır.
Dolayısıyla kaynak, aynı özet cümlesinde farklı performans göstergeleri için farklı baz çizgilerini birbirine karıştırmış görünmektedir.
Şekil 2 bize ne gösteriyor?
Şekil 2'de iki eğitim eğrisi bulunuyor. İlk grafikte ortalama kâr yaklaşık 50×10³ USD düzeyinden başlıyor, ilk birkaç yüz epizotta hızlı biçimde yükseliyor ve 1000'inci epizoda yaklaşırken yaklaşık 62×10³ USD çevresinde plato yapıyor.
İkinci grafikte eğitim kaybı yaklaşık 1,05 düzeyinden sürekli azalarak 1000'inci epizotta yaklaşık 0,22–0,23 seviyesine geliyor.
Bu iki eğri modelin verilen eğitim ortamında öğrenme sürecinin kararlı hâle geldiğini desteklemektedir. Ancak eğitim kaybının düşmesi ve simülasyon kârının yükselmesi, modelin gerçek dünya üretim tesislerinde aynı ekonomik performansı göstereceğini tek başına kanıtlamaz.
PPO-P³OS gerçekten “optimum” politikayı buldu mu?
Çalışma modelin “optimal” veya “near-optimal” politika öğrendiğini ifade etmektedir. Bununla birlikte deneylerde gerçek matematiksel global optimumun bilindiği ve PPO sonucunun bu optimumla karşılaştırıldığı bir optimality-gap analizi sunulmamaktadır.
Bu nedenle sonuçları daha dikkatli biçimde, incelenen simülasyon ortamında test edilen baseline yöntemlerden daha yüksek raporlanan performans sağlayan öğrenilmiş politika olarak tanımlamak daha güvenlidir.
Çalışma neyi destekliyor?
- Fiyat ve üretim miktarı tek bir sürekli kontrol problemi içinde birlikte modellenebilir.
- PPO, bu çalışmanın simülasyon ortamında Q-Learning, DQN ve A2C'den daha yüksek raporlanan ortalama kâr üretmiştir.
- PPO-P³OS Tablo 1'de karşılaştırılan modeller arasında en düşük kâr varyansına ve envanter riskine sahiptir.
- 1000 epizotluk eğitim sırasında kâr eğrisi yükselmiş ve kayıp eğrisi azalmıştır.
- Stok dengesizliğinin ödül fonksiyonuna ceza olarak eklenmesi, yalnız kısa vadeli marj yerine operasyonel dengeyi de hedeflemeyi sağlar.
- Sürekli eylem uzaylarında fiyat ve üretim miktarının birlikte ayarlanması PPO için doğal bir uygulama alanı oluşturabilir.
Çalışma neyi kanıtlamıyor?
- PPO-P³OS'un gerçek bir üretim tesisinde %12,8 daha fazla kâr sağlayacağını kanıtlamıyor.
- Model gerçek zamanlı fabrika operasyonunda canlı olarak devreye alınmış değildir.
- 36.000 örneğin tamamı gerçek fabrika gözlemi değildir.
- Sentetik verinin gerçek piyasa dalgalanmalarını eksiksiz temsil ettiği gösterilmemektedir.
- Modeller arasındaki ekonomik farklar için güven aralığı veya istatistiksel anlamlılık testi verilmemektedir.
- PPO politikasının küresel matematiksel optimuma ulaştığı gösterilmemektedir.
- Tek işletmeden gelen gerçek veri bileşeninin bütün imalat sektörlerine genellenebileceği kanıtlanmamaktadır.
- İş analitiği katmanının yöneticilerin gerçek karar kalitesini artırdığı kullanıcı veya saha çalışmasıyla sınanmamıştır.
Çalışmanın Yöntemi ve Bulguları
Deney veri yapısı
Çalışmanın gerçek veri bileşeni, tüketim malları sektöründeki orta ölçekli bir üretim işletmesinin 2021–2023 dönemine ait ERP ve MES kayıtlarından elde edilmiştir. Bunlara sentetik simülasyon verileri eklenerek yaklaşık 36.000 örneklik veri seti oluşturulduğu belirtilmiştir.
Yazarlar her örneği bir günlük operasyonel durum olarak tanımlamaktadır. Ancak gerçek/sentetik örnek sayılarının ayrı ayrı verilmemesi ve sentetik veri üretim sürecinin ayrıntılı olarak tarif edilmemesi, çalışmanın en önemli yeniden üretilebilirlik sınırlılıklarından biridir.
Karşılaştırılan algoritmalar
PPO-P³OS üç baseline ile karşılaştırılmıştır:
- Q-Learning,
- Deep Q-Network (DQN),
- Advantage Actor-Critic (A2C).
Değerlendirme ölçütleri ortalama kâr, kâr varyansı, envanter riski, son kayıp ve yakınsama kararlılığıdır.
Ham deney sonuçları
| Ölçüt | Q-Learning | DQN | A2C | PPO-P³OS |
|---|---|---|---|---|
| Ortalama kâr (×10³ USD) | 48,6 | 52,3 | 55,1 | 62,2 |
| Kâr varyansı (%) | 12,5 | 9,8 | 7,0 | 6,0 |
| Envanter riski (%) | 10,7 | 9,3 | 8,5 | 7,1 |
| Son kayıp | 0,61 | 0,47 | 0,36 | 0,23 |
Ham tablo, PPO-P³OS'un dört ölçütün tamamında karşılaştırılan baseline modellerden daha iyi sayısal değerler verdiğini göstermektedir.
Tekrarlanabilirlik açısından eksik bilgiler
Çalışma eğitim hiperparametrelerini görece ayrıntılı biçimde vermesine rağmen deneyin bütünüyle yeniden üretilmesi için bazı önemli bilgiler eksiktir:
- gerçek veri setinin tam büyüklüğü,
- sentetik örneklerin sayısı,
- sentetik veri üretim denklemleri veya dağılımları,
- işletmenin ve pazarın ayrıntılı bağlamı,
- train/validation/test ayrım yöntemi,
- rastgele tohumlar,
- baseline algoritmalarının ayrıntılı hiperparametreleri,
- beş tekrar için standart sapma veya güven aralıkları,
- kaynak kodu veya halka açık deney veri seti.
Bu nedenle sonuçların bağımsız bir ekip tarafından aynı koşullarda yeniden üretilmesi kaynakta verilen bilgilerle sınırlı kalmaktadır.
Referans bütünlüğündeki sorunlar
Makalenin literatür bölümünde bazı metin–kaynak eşleşmeleri problemli görünmektedir. Girişte makine öğrenmesi tabanlı nedensel çıkarım uygulamasını desteklemek üzere [1] kullanılmıştır; ancak kaynakça [1] doğrusal programlama ile ürün karması kâr maksimizasyonuna ilişkin 2012 tarihli bir çalışmadır.
Bölüm 2.1'de “Aktepe et al.” tarafından yapıldığı söylenen regresyon, ANN ve SVR tabanlı yedek parça talep tahmini çalışmasına [5] atfı verilmiştir. Kaynakça [5] ise Zhuang ve arkadaşlarının “Behavior Proximal Policy Optimization” adlı arXiv çalışmasıdır.
Bu durum ana PPO deney sonuçlarını otomatik olarak geçersiz kılmaz; ancak literatür taramasındaki bazı destekleyici ifadelerin kaynak kontrolünden geçirilmeden tekrar edilmemesi gerektiğini gösterir.
Endüstriyel uygulamaya geçişte ne gerekir?
Bu yaklaşımın gerçek bir üretim tesisine aktarılması için simülasyon başarısının ötesinde ek doğrulama gerekir. En azından gerçek üretim kapasitesi, makine arızaları, teslim süreleri, ürün raf ömrü, minimum sipariş miktarları, vardiya kısıtları, tedarik süreleri, fiyat esnekliği, rekabetçi fiyat tepkileri ve satış kaybı gibi süreçlerin modele dahil edilmesi gerekebilir.
Ayrıca yapay zekânın doğrudan fiyat belirlediği bir sistemde yönetsel sınırlar, minimum–maksimum fiyat kuralları, insan onayı, güvenlik katmanları ve beklenmeyen pazar koşullarında geri dönüş politikalarının bulunması gerekir. Bunlar kaynak çalışmada deneysel olarak sınanmamıştır.
Türkiye açısından nasıl değerlendirilmelidir?
Kaynak Türkiye'den fabrika veya pazar verisi içermemektedir. Bu nedenle çalışma içindeki kâr ve stok performans değerleri Türk imalat işletmelerine doğrudan aktarılamaz.
Bununla birlikte yaklaşım; ERP, MES, üretim maliyetleri, stok, talep ve fiyat geçmişini birlikte tutan Türkiye'deki imalat işletmelerinde ayrı bir pilot çalışma için araştırma çerçevesi sağlayabilir. Yerel uygulamada modelin firmanın kendi kapasite, maliyet, sipariş, kur, enerji ve tedarik zinciri dinamikleriyle yeniden eğitilmesi ve gerçek operasyon öncesinde gölge modda doğrulanması gerekir.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: Profit-Oriented Production and Pricing Optimization for Manufacturing Enterprises Using Proximal Policy Optimization
Yazarlar: Pingmei Fan, Hanwu Li, Mengdie Hu.
Yazar sırası: Kaynak çalışmadaki sıra aynen korunmuştur.
Sorumlu yazar: Pingmei Fan.
Eş birinci/eş katkı: Kaynakta eş birinci veya eş katkı beyanı bulunmamaktadır.
Kurum 1: Guangxi Vocational Normal University, Nanning, Guangxi, China.
Kurum 2: Amazon.com Services LLC, Bellevue, Washington, USA.
Kurum 3: Systems Engineering, University of Pennsylvania, Philadelphia, Pennsylvania, USA.
Kaynak türü: Pekiştirmeli öğrenme tabanlı hesaplamalı/modelleme ve simülasyon araştırması.
Dergi: Economics and Management Innovation.
Cilt / sayı: Vol. 3, No. 2 (2026).
Sayfalar: 8–17.
DOI: 10.71222/zsm3tb33
Gönderim tarihi: 1 Ocak 2026.
Revizyon tarihi: 25 Şubat 2026.
Kabul tarihi: 12 Mart 2026.
Yayın tarihi: 18 Mart 2026.
Resmî makale bağlantısı: https://doi.org/10.71222/zsm3tb33
Hakemlik/yayın durumu: Economics and Management Innovation'ın yayıncı sayfası dergiyi hakemli ve çift-kör hakem değerlendirmeli olarak tanımlamakta; GBP yazar politikası yayımlanan çalışmalar için en az iki bağımsız hakem raporu öngördüğünü belirtmektedir. Makale düzeyindeki hakem raporları bu inceleme sırasında kamuya açık olarak doğrulanmamıştır.
Lisans: Kaynak PDF'de çalışma Creative Commons Attribution lisansı altında olası açık erişim yayınına sunulmuş olarak ifade edilmektedir. GBP'nin güncel genel yayın politikası yayımlanan makalelerin CC BY 4.0 altında olduğunu belirtmektedir.
Finansman: İncelenen makale metninde çalışma özelinde ayrı bir finansman beyanı bulunmamaktadır.
Veri erişilebilirliği: İncelenen makalede ayrı bir Data Availability Statement bulunmamaktadır. Gerçek işletme verisinin kimliği açıklanmamakta ve veri seti için açık depo bağlantısı verilmemektedir.
Çıkar çatışması: İncelenen makalede yazarların çalışma özelinde ayrı bir çıkar çatışması beyanı bulunmamaktadır.
Etik kurul: İncelenen metinde çalışma özelinde etik kurul beyanı bulunmamaktadır.
CRediT/yazar katkıları: Kaynakta ayrı bir CRediT veya yazar katkısı bölümü bulunmamaktadır.
Veri kapsamı: Makale yaklaşık 36.000 örnekten oluşan, gerçek işletme verileri ile sentetik simülasyon verilerinin birleştirildiği bir veri seti bildirmektedir. Gerçek bileşen 2021–2023 dönemindeki orta ölçekli bir tüketim malları üreticisinin ERP ve MES kayıtlarından gelmektedir. Gerçek ve sentetik örneklerin ayrı miktarları açıklanmamıştır.
Temel yöntemsel sınır: Çalışma gerçek zamanlı fabrika konuşlandırması değildir. Sonuçlar oluşturulmuş deney ortamında elde edilen benchmark performansıdır. Sentetik veri üretimi, veri bölme yöntemi, baseline hiperparametreleri ve tekrarlar arasındaki belirsizlik ölçüleri yeterince ayrıntılı raporlanmadığından bağımsız yeniden üretilebilirlik sınırlıdır.
Kaynak içi performans tutarsızlığı: Tablo 1'e göre PPO-P³OS'un 62,2×10³ USD ortalama kârı A2C'nin 55,1×10³ USD değerinden yaklaşık %12,9 yüksektir ve envanter riski A2C'nin %8,5 değerinden PPO-P³OS'ta %7,1'e düşerek yaklaşık %16,5 azalır. DQN baz alındığında aynı farklar sırasıyla yaklaşık %18,9 ve %23,7'dir. Buna rağmen özet ve sonuç bölümünde %12,8 kâr artışı ve %16,4 envanter azalması DQN ile birlikte anılmaktadır. Yaklaşık %50,9 son kayıp azalması ise DQN karşılaştırmasıyla uyumludur. Bu Verianla içeriğinde ham tablo değerleri esas alınmıştır.
Terminoloji notu: Kaynağın özet ve sonuç bölümlerinde performans artışı “cumulative profit” olarak adlandırılırken Tablo 1 ve Şekil 2'de kullanılan ölçüt “Average Profit”tir. Bu iki ifade birbirine eşit kabul edilmemiştir.
Kaynakça bütünlüğü notu: Makalenin bazı metin içi atıfları kaynakça ile uyuşmamaktadır. Özellikle [1] ve [5] numaralı kaynakların metinde bağlandığı çalışmalar ile kaynakçada listelenen çalışmalar arasında açık konu/yazar uyuşmazlığı bulunmaktadır.
Bilimsel içerik sınırı: Bu Verianla yazısındaki model yapısı, denklemler, veri özellikleri, hiperparametreler, eğitim eğrileri ve performans sonuçları özgün çalışmaya dayanmaktadır. Dış kaynaklar yalnız bibliyografik kimlik, DOI, dergi ve yayıncı hakemlik/lisans politikalarının doğrulanması için kullanılmıştır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir