

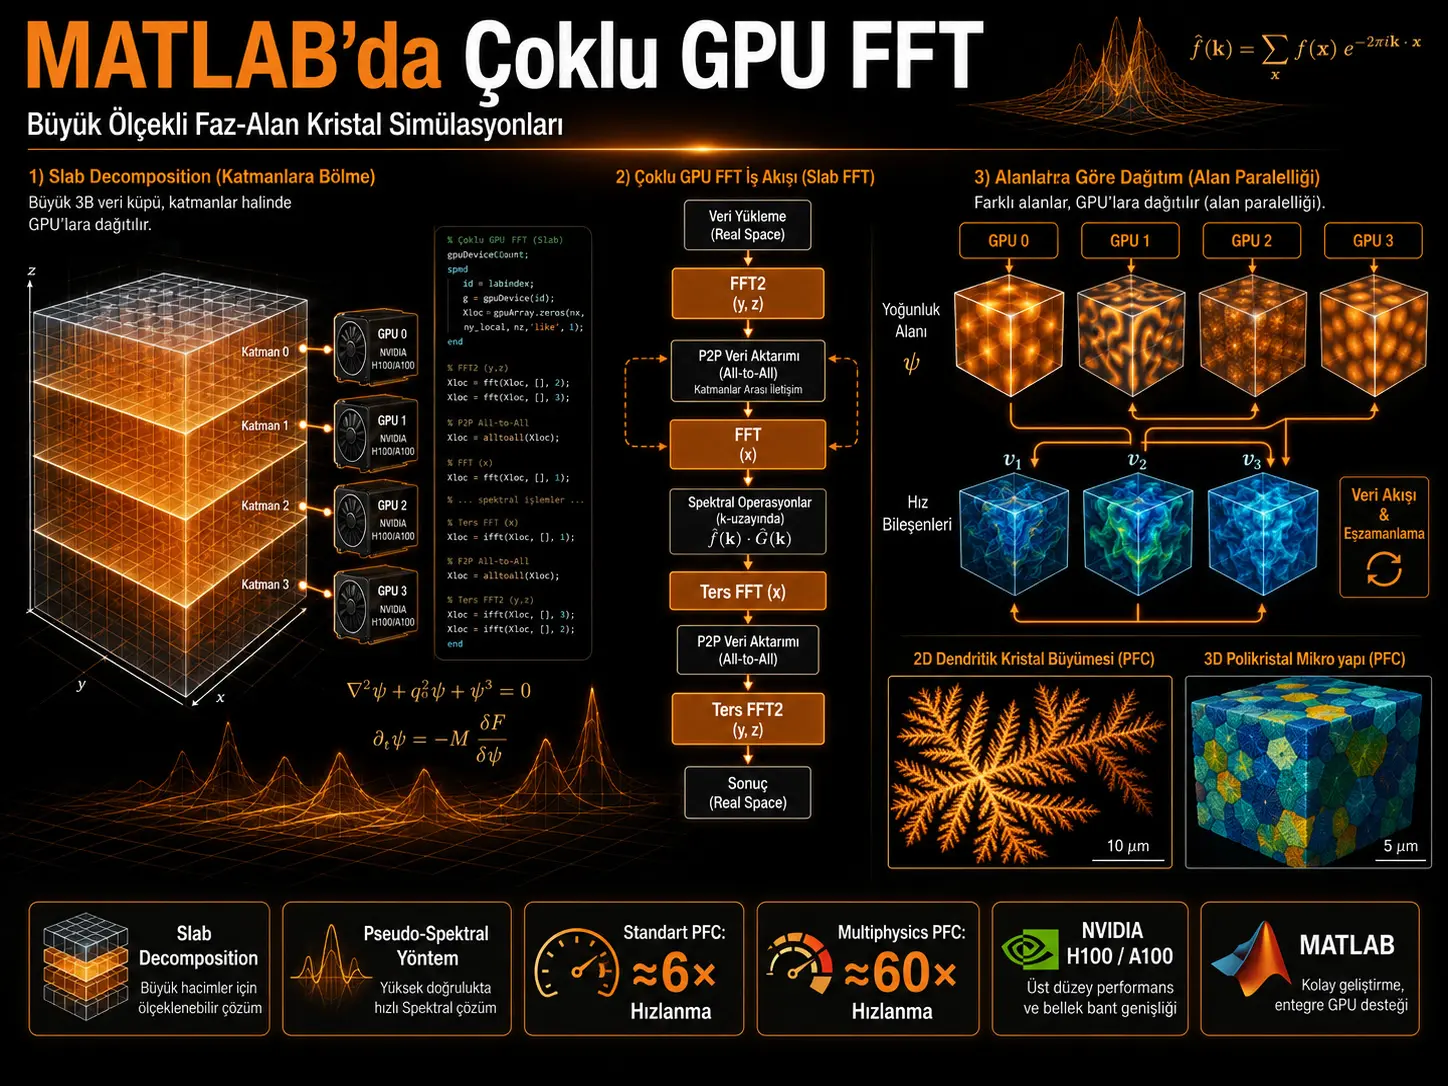
Utafiti huu unatengeneza mikakati miwili inayokamilishana ya ukuzaji sambamba inalenga kuendesha uigaji wa pseudo-spectral wa kiwango kikubwa, unaozuiwa na kumbukumbu ya GPU moja, kwa kusambaza mabadiliko ya haraka ya Fourier (Fast Fourier Transform, FFT) ya pande mbili na tatu kwa GPU nyingi katika mazingira ya MATLAB. Katika mbinu ya kwanza, FFT moja kubwa ya pande tatu inakokotolewa kwa kugawa eneo la anga kwenye GPU kwa kutumia mbinu ya slab decomposition, kutekeleza FFT ya pande mbili za ndani kwenye kila GPU, usambazaji upya wa data kwa njia ya peer-to-peer, na kufanya FFT ya upande mmoja kando ya mhimili uliobaki. Katika mbinu ya pili, vigezo tofauti katika miundo ya fizikia ya nyanja nyingi (multiphysics) hugawiwa kwenye GPU tofauti na uhamishaji wa data uliooanishwa unafanywa kati ya GPU katika kila hatua ya muda.
Mbinu hizi zimejaribiwa kwenye miundo ya Phase-Field Crystal (PFC). Katika uigaji wa kawaida wa pande tatu wa PFC kwa matatizo yaliyo katika safu ya 750³–1400³, ukokotozi wa GPU ulitekelezwa kwa kutumia GPU nne za NVIDIA H100 au nane za NVIDIA A100; na ongezeko la kasi la takriban mara sita limeripotiwa ikilinganishwa na marejeleo ya 100-core Intel Xeon Platinum 8470 CPU. Mpangilio wa 1400³ ulitosha kwenye kumbukumbu tu kwenye GPU nne za H100, na chanzo katika Kielelezo 1(a) kinataja kuwa muda wa uendeshaji ulishuka hadi takriban 17% ya muda wa CPU. Katika mbinu ya hydrodynamic PFC ambapo nyanja nne za kimwili zilisambazwa kwenye GPU nne za H100, chanzo kinaripoti ongezeko la kasi la hadi mara 60 ikilinganishwa na utekelezaji wa CPU.
Kikomo kikuu cha ukalimani cha matokeo ni kwamba ongezeko la kasi lililoripotiwa limepimwa kwa vifaa maalum vya HPC, kumbukumbu ya GPU, muundo wa mawasiliano wa GPU–GPU, utekelezaji wa MATLAB, na kanuni za PFC. Utafiti hauonyeshi kuwa GPU nyingi zitakuwa na kasi zaidi katika kila tatizo la FFT; kinyume chake, kwenye tatizo dogo la 750³, GPU moja ya H100 hutoa matokeo bora zaidi huku gharama ya mawasiliano ya GPU za ziada ikipunguza faida ya utendaji. Kwa hivyo, mchango mkuu wa utafiti sio tu kuongeza kasi ya uchakataji, bali ni kuwezesha matatizo ya spectral ya ubora wa juu yasiyotoshea kwenye kumbukumbu ya GPU moja kuendeshwa ndani ya MATLAB.
Kwa nini GPU moja inaunda kikwazo katika uigaji wa kiwango kikubwa wa FFT?
Katika mbinu za pseudo-spectral Fourier, vinyambulisho vya anga vya daraja la juu vinaweza kukokotolewa kwa ufanisi katika nafasi ya Fourier; hata hivyo, kwa kuwa sehemu isiyo na mlingano (nonlinear) inatathminiwa katika nafasi halisi, michakato ya FFT ya mbele na nyuma inaendeshwa mara kwa mara katika kila hatua ya muda. Kadiri vipimo vya mpangilio (array) vinavyoongezeka, gharama ya ukokotozi wa FFT na kiasi cha data ya pande nyingi inayopaswa kuwekwa kwenye kumbukumbu ya GPU hupanda kwa kasi.
Miundo ya Phase-Field Crystal hufanya tatizo hili kuwa dhahiri. Mbinu ya PFC inajaribu kutatua utaratibu wa fuwele katika kiwango cha urefu wa atomi huku ikifuatilia maendeleo ya muundo mdogo (microstructure) katika viwango vikubwa zaidi vya anga na muda wa mtawanyiko (diffusive). Kwa sababu hiyo, ubora mzuri wa anga unahitajika upande mmoja, na eneo pana la ukokotozi linahitajika upande mwingine.
Kwenye miundo ya multiphysics inayojumuisha nyanja nyingi za msongamano, muundo, kasi, au joto, hitaji la kuhifadhi nyanja kadhaa kubwa za pande tatu kwa wakati mmoja linafanya kumbukumbu ya GPU moja kuwa kikomo kikubwa zaidi.
Mlinganyo mkuu wa mbinu ya Fourier pseudo-spectral ni upi?
Chanzo kinatumia mlinganyo wa jumla wa mageuzi wa upande mmoja kufafanua mbinu kwanza:
\[ partial_t u=mathcal{L}u+mathcal{N}(u), qquad xin[0,2pi),;tgeq0 \]
Hapa opereta ya mlinganyo ya diferensiali (mathcal L), na (mathcal N(u)) inawakilisha sehemu isiyo na mlingano (nonlinear) ya (u) katika mfumo wa polinomiali.
Kwenye kikoa cha mara kwa mara, suluhisho linakadiriwa na mfululizo wa Fourier ulio na kikomo:
\[ u(x,t)approx u_N(x,t) = sum_{k=-K}^{K} widehat{u}_k e^{ikx} \]
ambayo inaonyeshwa kama na:
[ N=2K+1 ]
Modi ya Fourier inatumika.
Pointi za ushirikiano (collocation points) zenye nafasi sawa:
\[ x_j=frac{2pi j}{N}, qquad j=0,ldots,N-1 \]
zinafafanuliwa hivyo.
Mlinganyo wa diferensiali unabadilikaje katika nafasi ya Fourier?
Mabadiliko ya Fourier yanapotumika, kwa kila modi ya Fourier:
\[ partial_twidehat{u}_k = widehat{mathcal L}_kwidehat{u}_k+ widehat{[mathcal N(u)]}_k \]
mlinganyo wa diferensiali wa kawaida (ODE) unapatikana kwa namna hii.
Vinyambulisho vya anga vinageuka kuwa bidhaa rahisi (simple products) katika nafasi ya Fourier:
\[ widehat{[partial_x^n u]}_k = (ik)^nwidehat{u}_k. \]
Kipengele hiki kina thamani hasa katika PDE za daraja la juu. Hata hivyo, kwa kuwa kipengele kisicho na mlingano (mathcal N(u)) kinakokotolewa kwa msingi wa pointi katika nafasi ya kimwili, algoriti hubadilishana mfululizo kati ya nafasi ya Fourier na nafasi ya kimwili.
Mtiririko wa msingi wa hatua ya muda ni kama ifuatavyo:
- Nyanja inabadilishwa kwenda kwenye nafasi ya Fourier na FFT.
- Kipengele kisicho na mlingano kinakokotolewa katika nafasi halisi na kubadilishwa tena na FFT.
- Maendeleo ya muda ya vizidishio vya Fourier (Fourier coefficients) yanakokotolewa.
- Nyanja mpya ya kimwili inapatikana kwa kutumia FFT ya kinyume (inverse FFT).
Kwenye ukokotozi wa kiwango kikubwa, FFT hizi za pande nyingi zinazojirudiarudia huwa mojawapo ya vipengele vikuu vya muda wote wa uendeshaji.
Mkakati wa kwanza: FFT moja ya 3D inasambazwa vipi kwa GPU nyingi?
Mkakati wa kwanza wa utafiti ni kugawanya mpangilio (array) mmoja wa vipimo:
\[ N_ximes N_yimes N_z \]
katika GPU (G) kwa kutekeleza FFT moja ya pande nyingi kwenye GPU nyingi.
Data inagawanywa kwa kutumia slab decomposition katika uelekeo wa z. Kila GPU kwanza inashikilia slab yake ya ndani tu ya mpangilio mzima.
FFT ya mbele inaendeshwa katika hatua tatu kuu:
- Kila GPU inaendesha
fft2kando ya pande mbili za kwanza katika sehemu yake ya ndani ya data. - GPU zinasambaza tena vipande vya data kwa mawasiliano ya peer-to-peer.
- Kwenye data iliyopangwa upya,
fft(...,3)inaendeshwa kando ya upande wa tatu.
Ingawa mabadiliko ya Fourier ya kiulimwengu (global Fourier transform) yanakamilika mwishoni mwa mchakato huu, mabadiliko yote hayapatikani kwenye GPU moja; kila GPU inabeba sehemu ya matokeo katika nafasi ya Fourier.
Kwa nini mawasiliano ya P2P yanahitajika?
Michakato ya fft2 ya ndani inaweza kubadilisha mhimili miwili pekee kwenye slab inayomilikiwa na GPU. Kwa FFT kwenye mhimili wa tatu, vipengele vya data vya uelekeo sawa wa mabadiliko vinahitaji kuletwa pamoja kwenye GPU inayofaa.
Kwa sababu hii, data inapangwa upya kati ya GPU baada ya FFT za ndani. Chanzo kinaonyesha hatua hii katika utekelezaji wa MATLAB kupitia kikao sambamba cha spmd na michakato ya kuunganisha data inayotegemea spmdCat.
Kwenye FFT ya kinyume (inverse FFT), mfuatano unabadilishwa: ifft katika upande wa tatu, usambazaji upya wa P2P, na ifft2 katika pande mbili za kwanza.
Verianla Live: Utekelezaji wa FFT moja ya 3D kwenye GPU nyingi
| Hatua | Mchakato | Ulinganisho wa MATLAB / GPU |
|---|---|---|
| 1. Slab decomposition | Mpangilio wa 3D unagawanywa kati ya GPU G katika uelekeo wa z. | Kila GPU inashikilia tu slab ya ndani ya mpangilio mzima. |
| 2. FFT ya 2D ya ndani | Pande mbili za kwanza za kila slab zinabadilishwa kwa kujitegemea. | fft2 |
| 3. Usambazaji upya wa P2P | Ili kufanya FFT kwenye mhimili wa tatu, vipande vya data vinapangwa upya kati ya GPU. | spmd / spmdCat |
| 4. FFT ya 1D iliyosalia | Upande wa tatu wa anga unabadilishwa kuwa nafasi ya Fourier. | fft(...,3) |
| 5. Hatua ya muda ya spectral | Vizidishio vya Fourier vya nyanja ya PFC vinasasishwa kwa mbinu ya semi-implicit. | Mchakato wa nafasi ya Fourier kulingana na kipengele |
| 6. FFT ya kinyume ya 1D | Kubadilisha kurudi kwenye nafasi ya kimwili kunaanza kwenye upande wa tatu. | ifft(...,3) |
| 7. Usambazaji wa kinyume wa P2P | Data inarejeshwa kwenye mpangilio wa slab ya ndani. | spmdCat |
| 8. FFT ya kinyume ya 2D | Nyanja ya kimwili inapatikana tena katika pande mbili za kwanza. | ifft2 |
Verianla Live: Mchakato huu unategemea Kielelezo 1(a) cha utafiti chanzo na utekelezaji wa MATLAB katika Listing 1. Jedwali linaloonekana linahifadhiwa kama ukweli wa kisayansi (source-of-truth).
Muundo wa Phase-Field Crystal unawakilisha tatizo gani la kimwili?
Muundo wa PFC unawakilisha maendeleo ya anga na ya muda ya utaratibu wa msongamano wa fuwele kupitia nyanja moja inayoendelea ya msongamano (psi(mathbf{x},t)). Kwa mfano, chanzo kinatoa kazi ya nishati huru (free energy functional) kwa ulinganifu wa face-centered cubic (FCC) kama ifuatavyo:
\[ F[psi] = int_{Omega} left[ frac{psi}{2} (varepsilon+mathcal L)psi+ frac{psi^4}{4} ight]dmathbf r \]
Hapa:
\[ mathcal L= (1+abla^2)^2 left(frac{4}{3}+abla^2ight)^2 \]
ni opereta inayoainisha uwiano wa anga, na (varepsilon) ni kigezo cha undercooling.
Mienendo ya kawaida ya PFC inawakilishwa na:
\[ partial_tpsi = abla^2 frac{delta F[psi]}{deltapsi} = (varepsilon+mathcal L)abla^2psi+ abla^2psi^3 \]
Kutokana na uwepo wa opereta za Laplace zinazofuatana ndani ya (mathcal L) na uwekaji wa (abla^2) ya ziada kwa nje, mlinganyo wa PFC unaainishwa kwenye chanzo kama PDE ya daraja la kumi.
MATLAB inasasishaje hatua ya muda?
Katika Listing 1, nyanja ya msongamano katika nafasi ya Fourier inaendelezwa kwa mfumo wa semi-implicit, kupitia usasishaji unaotegemea vipengele:
psiF = (psiF + dt*lap.*psi)./(1 - dt*lin);
Katika mnyororo wa msingi wa ukokotozi hapa:
psiinawakilisha nyanja halisi ya msongamano,psiFinawakilisha msongamano uliyobadilishwa kwa Fourier,lapinawakilisha opereta ya Laplace iliyotenganishwa (discrete Laplace operator),lininawakilisha opereta ya mstari iliyotenganishwa (discrete linear operator),dtinawakilisha hatua ya muda.
Orodha za chanzo (listings) sio kifurushi kamili cha programu, bali ni vipande vya utekelezaji (implementation snippets) vinavyoonyesha mantiki ya utendaji wa mbinu. Ufafanuzi kamili wa vigezo muhimu vya mwanzo na fahirisi (indices) za kugawanya data haujatolewa kwenye block ya nambari (code block) ya makala; utekelezaji kamili unaoweza kuendeshwa unapatikana kwenye hifadhi tofauti ya kanuni chanzo.
Benchmark ya kwanza ilifanywa kwenye vifaa gani?
| Chanzo cha ukokotozi | Vifaa vilivyotolewa kwenye chanzo | Jukumu la benchmark |
|---|---|---|
| Mfumo wa GPU 1 | 4 × NVIDIA H100 SXM5, 94 GiB HBM2e kwa GPU | Kundi la HPC la Capella |
| Mfumo wa GPU 2 | 8 × NVIDIA A100 SXM4, 40 GiB HBM2 kwa GPU | Kundi la HPC la Alpha Centauri |
| Marejeleo ya CPU | Intel Xeon Platinum 8470, jumla ya cores 100, 2.00 GHz | Kundi la HPC la Barnard |
Kwa hivyo, ongezeko la kasi la GPU/CPU lililoripotiwa halijumuishi tu ukuzaji sambamba wa msimbo (code parallelization), bali pia utendaji wa usanifu tofauti wa ukokotozi. Matokeo hayapaswi kufasiriwa kama microbenchmark inayodhibitiwa ambayo inabadilisha tu hali ya CPU/GPU kwenye vifaa sawa.
Kwa nini GPU zaidi sio za haraka zaidi kwenye tatizo la 750³?
Kielelezo 1(a) cha utafiti kinaonyesha kikomo muhimu cha uwezo wa kuongezeka (scalability): kwa tatizo la ukubwa wa 750³, utendaji bora unapatikana kwa GPU moja kwenye H100.
Wakati tatizo linapotoshea vizuri kwenye kumbukumbu ya GPU moja, hata ikiwa GPU za ziada zinashiriki mzigo wa ukokotozi, mwendo wa data wa P2P na gharama ya maingiliano hujitokeza. Kwa tatizo dogo au la kati, gharama hii ya mawasiliano inaweza kuwa kubwa kuliko faida ya ukuzaji sambamba.
Kwa hivyo, hitimisho la utafiti sio 'kadiri unavyoongeza GPU, FFT itaongeza kasi mfululizo'. Thamani ya mbinu ya GPU nyingi hudhihirika wakati ukubwa wa tatizo unapoanza kuzidi kikomo cha GPU moja.
Nini kinatokea katika tatizo la 1400³?
Kulingana na chanzo, mpangilio wa ukubwa wa (1400^3) uliweza kutoshea kwenye kumbukumbu tu ulipotumia GPU nne za H100.
Kwenye maelezo ya Kielelezo 1(a), muda wa uendeshaji wa muundo huu unatolewa kuwa takriban:
[ 0.17 ]
mara, yaani takriban 17% ya marejeleo ya CPU yenye cores 100.
Uwiano huu unalingana na takriban ongezeko la kasi la mara sita na unaunda msingi wa matokeo ya 'up to sixfold' ambayo makala inaripoti kwa PFC ya kawaida.
Hata hivyo, sio sahihi kujumulisha matokeo haya kwa vipimo vyote vya PFC. Kama vile kielelezo kinavyoonyesha pia, idadi mwafaka ya GPU inatofautiana kulingana na ukubwa wa tatizo na familia ya GPU inayotumika.
Kwa nini mkakati wa pili ni tofauti?
Badala ya kugawanya FFT moja kwenye GPU, mkakati wa pili unasambaza nyanja tofauti za kimwili za muundo wa multiphysics kwa GPU tofauti.
Chanzo kinatumia muundo wa hydrodynamic PFC kama mfano. Nyanja ya kasi ya mesoscopic (mesoscopic velocity field) yenye vipengele vitatu inaongezwa kwenye nyanja ya msongamano:
\[ mathbf v= (v_1,v_2,v_3). \]
Muundo:
\[ partial_tpsi = abla^2 left( frac{delta F[psi]}{deltapsi} ight) - mathbf vcdotablapsi \]
na:
\[ hopartial_tmathbf v = Gammaabla^2mathbf v - leftlangle psiabla frac{delta F[psi]}{deltapsi} ightangle \]
unafafanuliwa na milinganyo hii.
Nyanja zipi zinagawiwa kwenye GPU nne?
Kielelezo 1(b) na Listing 2 za utafiti zinaonyesha usambazaji waziwazi:
| GPU | Nyanja kuu ya kimwili |
|---|---|
| GPU 1 | Nyanja ya msongamano (psi) |
| GPU 2 | Kipengele cha kasi (v_1) |
| GPU 3 | Kipengele cha kasi (v_2) |
| GPU 4 | Kipengele cha kasi (v_3) |
Baada ya GPU 1 kusasisha nyanja ya msongamano, inatuma (psi) mpya kwenye GPU zile tatu nyingine. GPU 2–4 zinasasisha vipengele vyao vya kasi na kurudisha matokeo kwa GPU 1.
Kwenye nambari ya MATLAB, ubadilishanaji huu wa data unafanywa na spmdSend na spmdReceive.
Kwa nini Gaussian convolution inafaa kwa mbinu ya Fourier?
Wastani wa ndani katika muundo wa hydrodynamic PFC:
\[ langlecdotangle(mathbf r) = int_{Omega} frac{ (cdot)(mathbf r') }{ (2pi a_0^2)^{3/2} } exp left[ -frac{ (mathbf r-mathbf r')^2 }{ 2a_0^2 } ight] dmathbf r' \]
inafafanuliwa na Gaussian convolution kwa namna hii.
Kutokana na sifa ya mabadiliko ya Fourier kwenye convolution, kiungo (integral) hiki kinabadilika na kuwa bidhaa katika nafasi ya Fourier. Hivyo, kama ilivyo katika opereta za diferensiali za daraja la juu za PFC, mchakato wa convolution pia unalingana kiasili na muundo wa ukokotozi wa mbinu ya pseudo-spectral.
Ongezeko la kasi la mara 60 linamaanisha nini kwenye muundo wa multiphysics?
Chanzo kinaripoti ongezeko la kasi la hadi mara 60 kwa kitatuzi (solver) cha hydrodynamic PFC kinachoendeshwa kwenye GPU nne za NVIDIA H100 ikilinganishwa na utekelezaji wa CPU ya cores 100.
Thamani hii sio mazingira sawa ya ukuzaji sambamba moja kwa moja na ongezeko la kasi la takriban mara sita katika PFC ya kawaida. Katika benchmark ya PFC ya kawaida, FFT moja kubwa inasambazwa kwa GPU nyingi na slab decomposition, wakati katika mbinu ya hydrodynamic PFC, nyanja nne tofauti za kimwili zinasambazwa kwenye GPU nne.
Kwa hivyo, thamani za 6× na 60× zimepatikana kutokana na kutumia mikakati miwili tofauti ya GPU nyingi kwenye miundo tofauti ya matatizo.
Verianla Live: Ulinganisho wa mikakati miwili ya GPU nyingi
| Kipengele | Kugawanya FFT Moja kwenye GPU Nyingi | Kusambaza Nyanja za Multiphysics kwenye GPU |
|---|---|---|
| Lengo kuu | FFT moja kubwa ya 3D kuvuka kumbukumbu ya GPU moja | Uchakataji sawia wa nyanja nyingi kubwa za kimwili |
| Mtindo wa ukuzaji sambamba | Slab decomposition katika uelekeo wa z + usambazaji upya wa P2P | Kila nyanja ya kimwili inakuwa kwenye GPU tofauti |
| Muundo mkuu wa mawasiliano wa MATLAB | spmd / spmdCat | spmdSend / spmdReceive |
| Mifumo ya GPU | 4× H100 au 8× A100 | 4× H100 |
| Upeo wa tatizo lililopangwa muda katika chanzo | 750³–1400³ | 750³–900³ kwenye Kielelezo 1(b) |
| Ongezeko kubwa zaidi la kasi lililoripotiwa | Takriban 6× | Takriban 60× |
| Picha ya ziada ya chanzo | Ukaushaji wa dendriti ya 2D (2D dendritic solidification) | Mfano wa ukuzaji wa polycrystal wa 3D kwa ukubwa wa 1400³ |
Verianla Live: Taarifa inategemea Kielelezo 1, Kielelezo 2 na maelezo ya mbinu ya utafiti. Kwa kuwa kikomo cha benchmark cha 900³ katika Kielelezo 1(b) na mfano wa kiwakilishi wa hydrodynamic PFC wa 1400³ katika Kielelezo 2(b) yametolewa kando katika chanzo, hayajaunganishwa hapa.
Kielelezo 1(a) kinasema nini kuhusu utendaji?
Kidirisha cha juu cha Kielelezo 1(a) kwenye ukurasa wa 11 kinaonyesha kugawanywa kwa mpangilio wa pande tatu kwenye slabs, hesabu za ndani za fft2, ubadilishanaji wa data wa P2P, na hatua ya mwisho ya fft.
Kwenye kidirisha cha chini, muda wa uendeshaji umesawazishwa kuwa kawaida kulingana na muda uliotumika kwenye cores 100 za CPU. Mwelekeo muhimu zaidi ni huu:
- Katika tatizo dogo kama la 750³, GPU moja inafaa zaidi.
- Kadiri tatizo linavyokua, kumbukumbu kubwa zaidi ya GPU inahitajika.
- Mpangilio wa 1400³ uliweza kuendeshwa tu kwa kutumia GPU nne za H100.
- Usanidi huu mkubwa ulifikia takriban 17% ya muda wa uendeshaji wa CPU.
Kwa hivyo, kielelezo kinaonyesha ongezeko la kasi na faida ya upanaji wa kumbukumbu (memory scaling advantage).
Kwa nini Kielelezo 1(b) kinaonyesha ongezeko kubwa zaidi la kasi?
Katika Kielelezo 1(b), nyanja ya msongamano (psi) inagawiwa kwa GPU 1, na vipengele vya kasi (v_1), (v_2) na (v_3) kwa GPU 2–4. Kwa njia hii, mizigo mikubwa ya kazi ya FFT tofauti inaweza kuendeshwa kwenye vifaa tofauti kwa wakati mmoja.
Kwenye grafu ya chanzo, muda wa uendeshaji wa GPU nne za H100 ni takriban asilimia chache za marejeleo ya CPU, na katika hali bora zaidi, ongezeko la kasi la takriban mara 60 lilipatikana.
Faida hii ya utendaji ni tofauti na kugawanya FFT moja: utengano wa asili wa nyanja tofauti unaweza kutoa ukuzaji sambamba wa kiwango cha juu (higher parallelism).
Mfano wa ukaushaji wa dendriti ya 2D ni mkubwa kiasi gani?
Kielelezo 2(a) kwenye ukurasa wa 12 kinaonyesha mfano wa ukaushaji wa dendriti (dendritic solidification) chini ya ulinganifu wa fuwele ya pembetatu.
Eneo la ukokotozi lipo kwenye kipimo cha gridi ya:
\[ 5imes10^4 imes 5imes10^4 \]
Chanzo kinaeleza kuwa, ikichukuliwa constant ya gridi ya 4 Å kwa alumini, hii inalingana na eneo la kimwili la takriban:
\[ 2.5,muext{m}imes2.5,muext{m} \]
Kielelezo kinaonyesha nyanja ya msongamano (psi) na eneo lililokuzwa. Mistari myeupe kwenye picha sio mipaka ya chembe za kimwili (physical grain boundaries); chanzo kinabainisha wazi kwamba inaonyesha mipaka ya vipande vya picha vilivyotumika kwa sababu mpangilio ni mkubwa mno kutolewa kama grafu moja.
Mfano wa polycrystal wa 3D unaonyesha nini?
Kielelezo 2(b) kinaonyesha ukuzaji wa polycrystal na hydrodynamic PFC katika muundo wa fuwele wa FCC.
Vigezo vilivyoonyeshwa vimetolewa kama:
- nyanja ya msongamano (psi),
- kipengele cha kasi (v_1),
- kipengele cha kasi (v_2),
- kipengele cha kasi (v_3)
Gridi iliyotumika katika maelezo ya kielelezo:
[ 1400imes1400imes1400 ]
na ukubwa wa kisanduku cha kimwili umetajwa kuwa takriban:
\[ 40,ext{nm}imes40,ext{nm}imes40,ext{nm} \]
Thamani hii ni kubwa kuliko kikomo cha juu cha 900³ katika benchmark ya hydrodynamic iliyopangwa muda kwenye Kielelezo 1(b). Chanzo hakielezi kama onyesho la 1400³ linaendana na masharti sawa na jaribio kwenye grafu ya benchmark; hivyo, matokeo haya mawili hayapaswi kutathminiwa kama pointi sawa ya benchmark.
Upekee uliodaiwa na utafiti huu ni upi?
Waandishi wanakubali kwamba mbinu za jumla za FFT za GPU nyingi zilizosambazwa zilikuwepo hapo awali katika ukokotozi wa kiwango cha juu wa HPC. Madai ya upekee wa utafiti yako tofauti: chanzo kinaeleza kwamba hakuna miundombinu ya jumla ya FFT ya GPU nyingi isiyotegemea programu fulani (application-independent) inayopatikana ndani ya MATLAB, na kwamba mbinu iliyowasilishwa inaunda utekelezaji wa kwanza wa FFT ya GPU nyingi katika MATLAB.
Hili ni dai la upekee ambalo linategemea tathmini ya waandishi ya machapisho na mfumo wa ikolojia wa programu (software ecosystem). Utafiti haufanyi orodha huru ya programu (software inventory) inayojumuisha misimbo yote maalum au isiyochapishwa ya MATLAB.
GPU zaidi inaleta faida wakati gani?
Kulingana na matokeo ya chanzo, matumizi ya GPU nyingi huwa na maana hasa katika hali mbili:
- Wakati mpangilio mmoja wa FFT hautoshei kwenye kumbukumbu ya GPU moja.
- Wakati nyanja nyingi kubwa za kimwili katika muundo wa multiphysics zinasasishwa kwa wakati mmoja.
Kinyume chake, kwenye matatizo madogo yanayotoshea vizuri kwenye GPU moja, matumizi ya GPU ya ziada yanaweza kuwa polepole kwa sababu ya mawasiliano ya data.
Kwa hiyo, idadi ya GPU sio kigezo huru cha utendaji; ukubwa wa tatizo, kumbukumbu ya GPU, upanaji (bandwidth) wa P2P, mgawanyo wa mzigo wa kazi, na uwiano wa ukokotozi/mawasiliano lazima vitathminiwe pamoja.
Hii inamaanisha nini kwa Afrika Mashariki?
Utafiti ulifanywa kwenye miundombinu ya HPC ya TU Dresden na NHR Center; hakuna vipimo vya benchmark vilivyofanywa kwenye mfumo wa HPC au kituo cha utafiti katika Afrika Mashariki.
Mbinu hii inaweza kutumiwa kimfumo na vikundi vya utafiti nchini Afrika Mashariki vinavyofanya uigaji wa nyenzo wa ubora wa juu unaotegemea MATLAB, utatuzi wa PDE wa spectral, au uigaji wa fizikia wa nyanja nyingi. Hata hivyo, thamani za 6× au 60× kwenye utafiti hazipaswi kuhamishiwa moja kwa moja kwenye miundo tofauti ya GPU, topolojia za PCIe/NVLink, miundo ya CPU, au matoleo ya MATLAB.
Ili kujua utendaji halisi kwenye mfumo wa ndani, benchmark tofauti za strong-scaling, memory-scaling, na mawasiliano ya GPU lazima zifanywe kwa kutumia ukubwa sawa wa tatizo.
Matokeo yanayoungwa mkono na utafiti
- Ukokotozi wa pseudo-spectral unaotegemea FFT wa pande mbili na tatu umeweza kufanywa ndani ya MATLAB kwa kutumia GPU nyingi.
- FFT moja kubwa ya 3D imesambazwa kwa GPU nyingi kwa kutumia slab decomposition na mawasiliano ya data ya GPU–GPU.
- Ongezeko la kasi la GPU/CPU la hadi takriban mara sita limeripotiwa kwenye benchmark za PFC za ukubwa wa 750³–1400³.
- Mpangilio wa kawaida wa PFC wa ukubwa wa 1400³ ulitoshea kwenye kumbukumbu tu kwenye GPU nne za H100 katika vifaa vya chanzo.
- Matokeo ya H100 kwa ukubwa wa 1400³ yameripotiwa kuwa takriban 17% ya muda wa marejeleo ya CPU.
- Kwenye tatizo dogo la 750³, GPU moja ya H100 ilionyesha utendaji bora kuliko matumizi ya GPU zaidi za H100.
- Kwenye hydrodynamic PFC, nyanja za (psi,v_1,v_2,v_3) zimesambazwa kwa GPU nne tofauti.
- Katika mkakati huu wa pili, ongezeko la kasi la hadi mara 60 limeripotiwa ikilinganishwa na utekelezaji wa CPU yenye cores 100.
- Utafiti umeonyesha matumizi ya mbinu kwenye uigaji wa PFC kwa kutoa mifano ya ukaushaji wa dendriti ya 2D na ukuzaji wa polycrystal wa 3D.
- Nambari chanzo (source code) imeshirikiwa kwenye hifadhi ya programu chini ya leseni ya MIT.
Matokeo ambayo hayaungwi mkono au hayajajaribiwa na utafiti
- Hauonyeshi kuwa GPU zaidi zinakuwa na kasi zaidi katika kila tatizo.
- Ongezeko la kasi la 6× na 60× sio thamani za ulimwengu wote (universal values) kwa mifumo yote ya GPU/CPU.
- Utafiti hauonyeshi kuwa utekelezaji wote wa FFT kwenye MATLAB utafikia uwezo sawa wa kuongezeka (scalability).
- Utafiti hautoi benchmark ya utendaji ya kina kwa GPU zingine isipokuwa H100 na A100.
- Muda wa mawasiliano ya GPU–GPU haujatenganishwa kwa upimaji kiasi kama kipengele tofauti.
- Ufanisi wa strong-scaling na weak-scaling haujaripotiwa kama majedwali tofauti yanayotumia vipimo vya kawaida vya HPC.
- Jedwali tofauti la usahihi la FFT kwa ajili ya kosa la nambari kati ya suluhisho la GPU na suluhisho la CPU halijatolewa.
- Matokeo ya benchmark yaliyoripotiwa hayamaanishi uthibitisho wa kiidadi kwa muundo halisi wa majaribio wa muundo mdogo wa nyenzo; hizi ni uigaji wa nambari za PFC.
- Kwa hydrodynamic PFC, haijaelezwa waziwazi na chanzo kama taswira ya 1400³ kwenye Kielelezo 2(b) ni sehemu ya benchmark ya muda iliyopo kwenye Kielelezo 1(b).
- Utafiti hautathmini ufanisi wa gharama/nishati wa kuongeza idadi ya GPU.
- Dai la waandishi la 'utekelezaji wa kwanza wa FFT ya GPU nyingi katika MATLAB' halijathibitishwa kama matokeo ya ukaguzi wa programu wa kimataifa unaojitegemea na kamilifu.
Mbinu na Matokeo ya Utafiti
Muhtasari wa kiufundi wa mikakati miwili ya ukuzaji sambamba
| Kigezo | Mkakati 1 | Mkakati 2 |
|---|---|---|
| Tatizo | FFT moja kubwa | Multiphysics PFC |
| Ukuzaji sambamba | Domain/slab decomposition | Field decomposition |
| Ukokotozi wa ndani | 2D FFT + 1D FFT | Kila GPU inaendesha FFT za 3D za nyanja yake |
| Mawasiliano | P2P data redistribution | Uoanishaji wa nyanja mwishoni mwa hatua ya muda |
| Muundo wa MATLAB | spmd, spmdCat | spmd, spmdSend, spmdReceive |
| Faida kuu | FFT kuvuka kumbukumbu ya GPU moja | Utekelezaji sawia wa nyanja nyingi za kimwili |
Upeo wa benchmark ya PFC ya kawaida
| Kiashiria | Thamani ya chanzo |
|---|---|
| Upeo wa ukubwa wa tatizo | 750³–1400³ |
| Muda wa benchmark | Hatua 1000 za muda kwenye Kielelezo 1 |
| Mfumo wa H100 | 4 × NVIDIA H100 SXM5, 94 GiB HBM2e/GPU |
| Mfumo wa A100 | 8 × NVIDIA A100 SXM4, 40 GiB HBM2/GPU |
| Marejeleo ya CPU | Cores 100 za Intel Xeon Platinum 8470, 2.00 GHz |
| Ongezeko kubwa zaidi la kasi lililoripotiwa | Takriban 6× |
| Hitaji la kumbukumbu kwa 1400³ | Iliweza kuendeshwa tu kwa H100 4 kwenye mfumo wa chanzo |
| Muda husika wa uendeshaji kwa 1400³ | Takriban 17% ya muda wa CPU |
Upeo wa benchmark ya Multiphysics
| Kiashiria | Thamani ya chanzo |
|---|---|
| Muundo | 3D hydrodynamic PFC |
| Nyanja za kimwili | ψ, v₁, v₂, v₃ |
| Idadi ya GPU | 4 × NVIDIA H100 |
| Nyanja kwa kila GPU | Nyanja moja kuu ya kimwili |
| Vipimo vya benchmark vya Kielelezo 1(b) | 750³–900³ |
| Ongezeko kubwa zaidi la kasi lililoripotiwa | Takriban 60× ikilinganishwa na CPU |
| Gridi ya mfano tofauti kwenye Kielelezo 2(b) | 1400³ |
Kwa nini matokeo ya H100 na A100 hayapaswi kusomwa moja kwa moja kwa idadi ya GPU?
Mifumo ya H100 na A100 haitofautiani tu kwa idadi ya GPU. Chanzo kinatumia kumbukumbu ya 94 GiB HBM2e kwa kila GPU ya H100, na 40 GiB HBM2 kwa kila GPU ya A100. Kwa hiyo, kwa tatizo sawa, neno 'GPU nne' au 'GPU nane' pekee halifafanui rasilimali sawa ya ukokotozi.
Kwenye Kielelezo 1(a), familia tofauti za GPU zinaonyeshwa kwa mikunjo (curves) tofauti. Matokeo yanapaswa kufasiriwa pamoja na usanifu wa GPU, uwezo wa kumbukumbu, na sifa za mawasiliano, mbali na idadi ya GPU.
Kiwango cha kimwili cha eneo la ukokotozi
| Mfano | Gridi | Kiwango cha kimwili kilichotolewa kwenye chanzo |
|---|---|---|
| Ukaushaji wa dendriti ya 2D | 50,000 × 50,000 | 2.5 µm × 2.5 µm; ikichukuliwa 4 Å Al lattice constant |
| Ukuzaji wa polycrystal wa 3D | 1400 × 1400 × 1400 | 40 nm × 40 nm × 40 nm |
Mifano hii inafanya ugumu mkuu wa ukokotozi wa mbinu ya PFC uonekane wazi: hata kama nyanja ya kimwili iko kwenye kiwango cha mikromita au makumi ya nanomita, mabilioni ya pointi za gridi yanaweza kuhitajika ili kutatua muundo wa kiwango cha atomi cha lattice ya fuwele.
Muundo wa dendriti katika Kielelezo 2(a) unathibitisha nini?
Kielelezo 2(a) kinaonyesha kwamba utekelezaji wa multi-GPU single-FFT unaweza kutumika katika tatizo kubwa la ukaushaji la PFC lenye pande mbili. Kielelezo hiki sio picha ya majaribio ya dendriti iliyopimwa kwenye nyenzo halisi ya kimwili.
Kwa hivyo, haiwezi kuhitimishwa kutokana na taswira hiyo kwamba morpholojia halisi ya dendriti ya alumini inathibitishwa kiidadi. Chanzo kinatumia mfano huu kuonyesha utekelezaji wa ukokotozi wa GPU nyingi katika eneo kubwa la PFC.
Kuna maana gani katika kuonyesha nyanja za kasi katika Kielelezo 2(b)?
Hydrodynamic PFC haisuluhishi tu kigezo cha msongamano bali pia nyanja ya kasi yenye vipengele vitatu. Katika Kielelezo 2(b), kutolewa kwa taswira tofauti za ujazo za (v_1), (v_2) na (v_3) pamoja na (psi) kunaonyesha kwamba mgawanyo wa nyanja nne za kimwili katika mkakati wa pili wa GPU unalingana moja kwa moja na vigezo vya muundo.
Kwa neno lingine, matumizi ya GPU nne si tu kugawanya mpangilio katika vipande nne kiufundi; kila GPU inabeba mzigo wa ukokotozi wa nyanja maalum ya kimwili ya muundo.
Lengo la uwezo wa kuongezeka (scalability) wa mbinu katika siku zijazo ni lipi?
Waandishi wanaeleza kuwa mkakati wa pili unaweza kupanuka kiasili kwenye miundo ya coarse-grained PFC inayotumia complex amplitude kwa modi kuu za Fourier. Miundo ya aina hii inaweza kujumuisha makumi ya coupled complex-valued fields.
Chanzo kinatarajia miundo hii kuwa inafaa hasa kwa ukuzaji sambamba wa GPU katika kiwango cha nyanja (field-level GPU parallelization); hata hivyo, hakuna benchmark mpya inayotumia makumi ya nyanja tata ambayo imetolewa katika utafiti huu. Kwa hiyo, faida hiyo inatajwa kama matarajio ya matumizi ya baadaye, na sio matokeo ya nambari yaliyopo sasa.
Ukalimani wa msingi wa matokeo ya utendaji
Matokeo ya pamoja yanayotokana na mikakati miwili ya utafiti ni kwamba matumizi ya GPU nyingi hayapaswi kutathminiwa tu kama kuongeza vitengo vingi vya ukokotozi.
Kwenye mkakati wa FFT moja, GPU moja inaweza kuwa ya haraka zaidi kwenye matatizo madogo kutokana na gharama ya mawasiliano; lakini kwenye matatizo makubwa, GPU nyingi huwa zinawezesha uigaji kwanza kwa kuvuka kikomo cha kumbukumbu.
Kwenye mkakati wa multiphysics, utengano wa kiasili wa nyanja huru za kimwili unaruhusu kwa kiasi kikubwa utendaji kazi sawia wa GPU tofauti, na hivyo kufikia ongezeko la kasi la juu zaidi kwenye benchmark ya chanzo.
Vigezo gani ni muhimu wakati wa kujumlisha matokeo ya benchmark?
- Modeli ya GPU na uwezo wa kumbukumbu kwa kila GPU,
- Topolojia ya mawasiliano na upanaji (bandwidth) kati ya GPU,
- Ukubwa wa tatizo,
- Vipimo vya FFT,
- Uwiano wa ukokotozi wa ndani/mawasiliano kwa kila GPU,
- Idadi ya nyanja za kimwili,
- Mbinu ya ujumuishaji wa muda (time integration method),
- Usanifu wa marejeleo wa CPU,
- Maelezo ya utekelezaji ya MATLAB na mazingira ya ukokotozi sambamba.
Utafiti hautoi uchambuzi tofauti wa unyeti (sensitivity analysis) kwa mambo haya yote. Kwa hivyo, thamani za 6× na 60× zinapaswa kuhifadhiwa kama matokeo ya mipangilio ya HPC iliyoripotiwa.
Nguvu za utafiti
- Badala ya benchmark ndogo ya FFT (FFT microbenchmark) tu, mfano wa matumizi halisi wa PDE wa daraja la juu umetolewa.
- Mbinu zote mbili za domain decomposition na field decomposition zimeonyeshwa katika mfumo huo wa MATLAB.
- Mifumo mingi ya GPU inayotegemea H100 na A100 imetumika.
- Marejeleo ya CPU yametolewa pamoja na maelezo wazi ya maunzi (hardware).
- Vipimo vya matatizo visivyotoshea kwenye kumbukumbu ya GPU moja vimejaribiwa moja kwa moja.
- Vipande vya utekelezaji (implementation snippets) vya MATLAB vimeshirikiwa.
- Hifadhi kamili ya nambari chanzo (source code repository) na rekodi ya Zenodo zimetolewa.
- Mifano ya matumizi ya PFC ya 2D na 3D imewasilishwa kwa taswira.
Vizuizi Vikuu
- Kipimo kikuu cha matokeo ni muda wa uendeshaji; benchmark tofauti ya usahihi wa nambari ni mdogo.
- Gharama ya mawasiliano ya GPU–GPU haijagawanywa katika vipengele tofauti vya muda.
- Matumizi ya nishati na utendaji/wati hazijapimwa.
- Watengenezaji tofauti wa GPU au vizazi tofauti vya NVIDIA havijajaribiwa kikamilifu.
- Benchmark imeundwa kuzunguka kundi moja la tatizo la PFC.
- Utafiti haulengi uthibitisho wa kiidadi wa muundo kwa kutumia muundo mdogo wa nyenzo wa majaribio halisi.
- Katika chanzo, kuna tofauti ya ukubwa isiyofafanuliwa kati ya kikomo cha benchmark cha 900³ kwa hydrodynamic PFC na taswira ya kiwakilishi ya 1400³.
- Orodha za programu (software listings) zinaonyesha mbinu lakini peke yake sio programu zinazojitegemea na zinazoweza kutekelezwa zilizo na vigezo vyote vya kuanzisha na kuendesha.
Maelezo ya Chanzo na Mbinu
Jina kamili la asili la utafiti: Multi-GPU fast Fourier transforms in MATLAB for large-scale phase-field crystal simulations
Ujumbe wa kichwa cha bibliografia: Kichwa cha PDF kilichopakiwa kiko katika umbo lisilo na mabano hapo juu. Rekodi ya metadata ya arXiv inaonyesha kichwa kama “Multi-GPU fast Fourier transforms in MATLAB (for large-scale phase-field crystal simulations)”, ikionyesha sehemu ya pili ndani ya mabano. Kichwa asili cha PDF hakijabadilishwa kimyakimya.
Waandishi na mpangilio asili: Maik Punke; Marco Salvalaglio.
Taasisi: Institute of Scientific Computing, TU Dresden, 01062 Dresden, Germany.
Taasisi ya pili: Dresden Center for Computational Materials Science, TU Dresden, 01062 Dresden, Germany; hii inaonyeshwa kwenye chanzo kama ushirika wa pili kwa Marco Salvalaglio.
Mwandishi anayehusika: Hakuna lebo tofauti ya “corresponding author” iliyopo kwenye PDF iliyopakiwa. Majina ya waandishi wote yana alama za ushirika, na alama ya barua pepe/mwandishi-anayehusika haijaonyeshwa wazi.
Mchangiaji mwenza wa kwanza: Hakuna tamko la mchango sawa (equal contribution) katika toleo lililopakiwa.
Aina ya chanzo: Utafiti wa ukokotozi wa utendaji wa juu unaotegemea MATLAB, programu ya kisayansi, na uigaji wa nambari.
Hali ya uchapishaji: Utafiti uliopakiwa ni chapisho la awali (preprint) ambalo limechapishwa kwenye arXiv na toleo tofauti la jarida lililopitiwa na wenza (peer-reviewed) halijathibitishwa. Matokeo yanapaswa kutathminiwa kwa kuzingatia hatua hii ya uchapishaji.
Jukwaa: arXiv.
Kitambulisho cha arXiv: 2603.26818v1 [cs.MS].
Kitengo cha msingi: Mathematical Software (cs.MS).
Vitengo vya ziada: Materials Science (cond-mat.mtrl-sci) na Computational Physics (physics.comp-ph).
Tarehe ya uwasilishaji wa kwanza wa arXiv: Machi 26, 2026.
Tarehe iliyoandikwa kwenye PDF: Machi 31, 2026.
DOI ya arXiv: 10.48550/arXiv.2603.26818.
Mbinu ya kisayansi: Ufumbuzi wa pseudo-spectral wa Fourier; domain decomposition ya GPU nyingi; slab decomposition; usambazaji upya wa data wa peer-to-peer; field-level multiphysics parallelization; semi-implicit na visasisho vya muda (implicit time updates) vilivyobainishwa kwenye orodha za nambari chanzo.
Matumizi makuu: Uigaji wa phase-field crystal wa pande mbili na tatu.
GPU za benchmark: 4 × NVIDIA H100 SXM5 (94 GiB HBM2e/GPU) na 8 × NVIDIA A100 SXM4 (40 GiB HBM2/GPU).
Marejeleo ya CPU: Intel Xeon Platinum 8470, jumla ya cores 100, 2.00 GHz.
Miundombinu ya HPC: Mifumo ya Capella, Alpha Centauri na Barnard ndani ya TU Dresden NHR Center.
Hifadhi ya nambari chanzo: https://github.com/mpunke/MATLABmultiGPUFFT/
Leseni ya programu: MIT License.
DOI ya Zenodo: 10.5281/zenodo.18670913.
Matokeo ya msingi ya benchmark: Ongezeko la kasi limeripotiwa kuwa hadi takriban 6× ikilinganishwa na marejeleo ya CPU kwa PFC ya kawaida, na hadi takriban 60× kwa hydrodynamic multiphysics PFC.
Ukalimani wa benchmark: Thamani hizi sio vizidishio safi vya algoriti (algorithmic scaling factors) kulinganisha rasilimali sawa za uchakataji kwenye tatizo lile lile. Pande za GPU na CPU zina usanifu tofauti na mifumo tofauti ya kumbukumbu.
Ujumbe wa taarifa ndani ya chanzo — Cores za CPU: Wakati sehemu ya Muhtasari wa utafiti inafafanua utekelezaji wa CPU na neno “hundreds of cores”, maelezo ya kina ya benchmark na Kielelezo 1 kwa uwazi hurejelea cores 100 za CPU. Taarifa ya cores 100 katika benchmark ya kina imetumika katika ulinganisho wa nambari.
Ujumbe wa upeo ndani ya chanzo — ukubwa wa hydrodynamic PFC: Kwenye maelezo ya Kielelezo 1(b), inaelezwa kuwa benchmark inafikia ukubwa wa tatizo la 900³ kwa kutumia GPU nyingi. Kielelezo 2(b) kinaonyesha mfano tofauti wa ukuzaji wa polycrystal kinachotumia gridi ya 1400³ kwa hydrodynamic PFC. Kwa kuwa chanzo hakielezi tofauti kati ya hali za uendeshaji za visa hivi viwili, thamani ya 1400³ haijafasiriwa kama data pointi ya ziada ya moja kwa moja ya grafu ya benchmark.
Kikomo cha orodha ya nambari (Code listing limit): Listing 1 na Listing 2 zinaonyesha mtiririko msingi sambamba wa data wa algoriti; sio programu huru na kamili zenye ufafanuzi kamili wa mipangilio ya mwanzo, fahirisi za uchanganuzi na vigezo vyote vya kusaidia. Utekelezaji unaoweza kuendeshwa unahitaji kurejelewa kwenye hifadhi ya chanzo tofauti.
Kikomo cha dai la upekee: Waandishi wanafafanua utafiti kama utekelezaji wa kwanza wa FFT wa GPU nyingi katika MATLAB. Taarifa hii inategemea tathmini ya waandishi wa chanzo ya fasihi/programu zilizopo na haijathibitishwa kama orodha kamili na huru ya programu ulimwenguni.
Ufadhili: Utafiti uliungwa mkono na Deutsche Forschungsgemeinschaft (DFG) chini ya nambari za mradi 447241406 na 493401063.
Chanzo cha ukokotozi: Waandishi wanataja utumizi wa mifumo ya ukokotozi ya utendaji wa juu ya TU Dresden NHR Center katika sehemu ya shukrani.
Mgongano wa maslahi: Hakuna tamko tofauti la competing-interest au conflict-of-interest katika maandishi yaliyopakiwa; haijahitimishwa kutoka kwa hili kwamba hakuna mgongano wa maslahi.
Michango ya CRediT/waandishi: Hakuna tamko tofauti la CRediT authorship contribution statement katika toleo lililopakiwa.
Kikomo cha uthibitisho wa kisayansi: Uthibitisho kuu wa utafiti ni utendaji wa ukokotozi na uwezo wa uendeshaji wa vipimo vikubwa vya tatizo. Uthibitisho wa muundo mdogo kupitia majaribio halisi ya nyenzo, benchmark ya kosa la nambari la FFT, ufanisi wa nishati, au uchambuzi wa kina wa strong/weak scaling havijaripotiwa kwenye seti kuu ya tathmini ya utafiti.
Kikomo cha maudhui ya kisayansi: Milinganyo ya PFC, algoriti za FFT, mikakati ya GPU nyingi, taarifa za maunzi, matokeo ya benchmark, na ukalimani wa Kielelezo 1–2 katika makala hii ya Verianla zinategemea utafiti uliopakiwa. Udhibiti wa nje wa bibliografia ulitumika tu kuthibitisha kitambulisho cha arXiv, DOI, hali ya sasa ya uchapishaji, na rekodi ya usambazaji wa programu; hakuna matokeo mapya ya uigaji ambayo hayapatikani kwenye chanzo yameongezwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *