

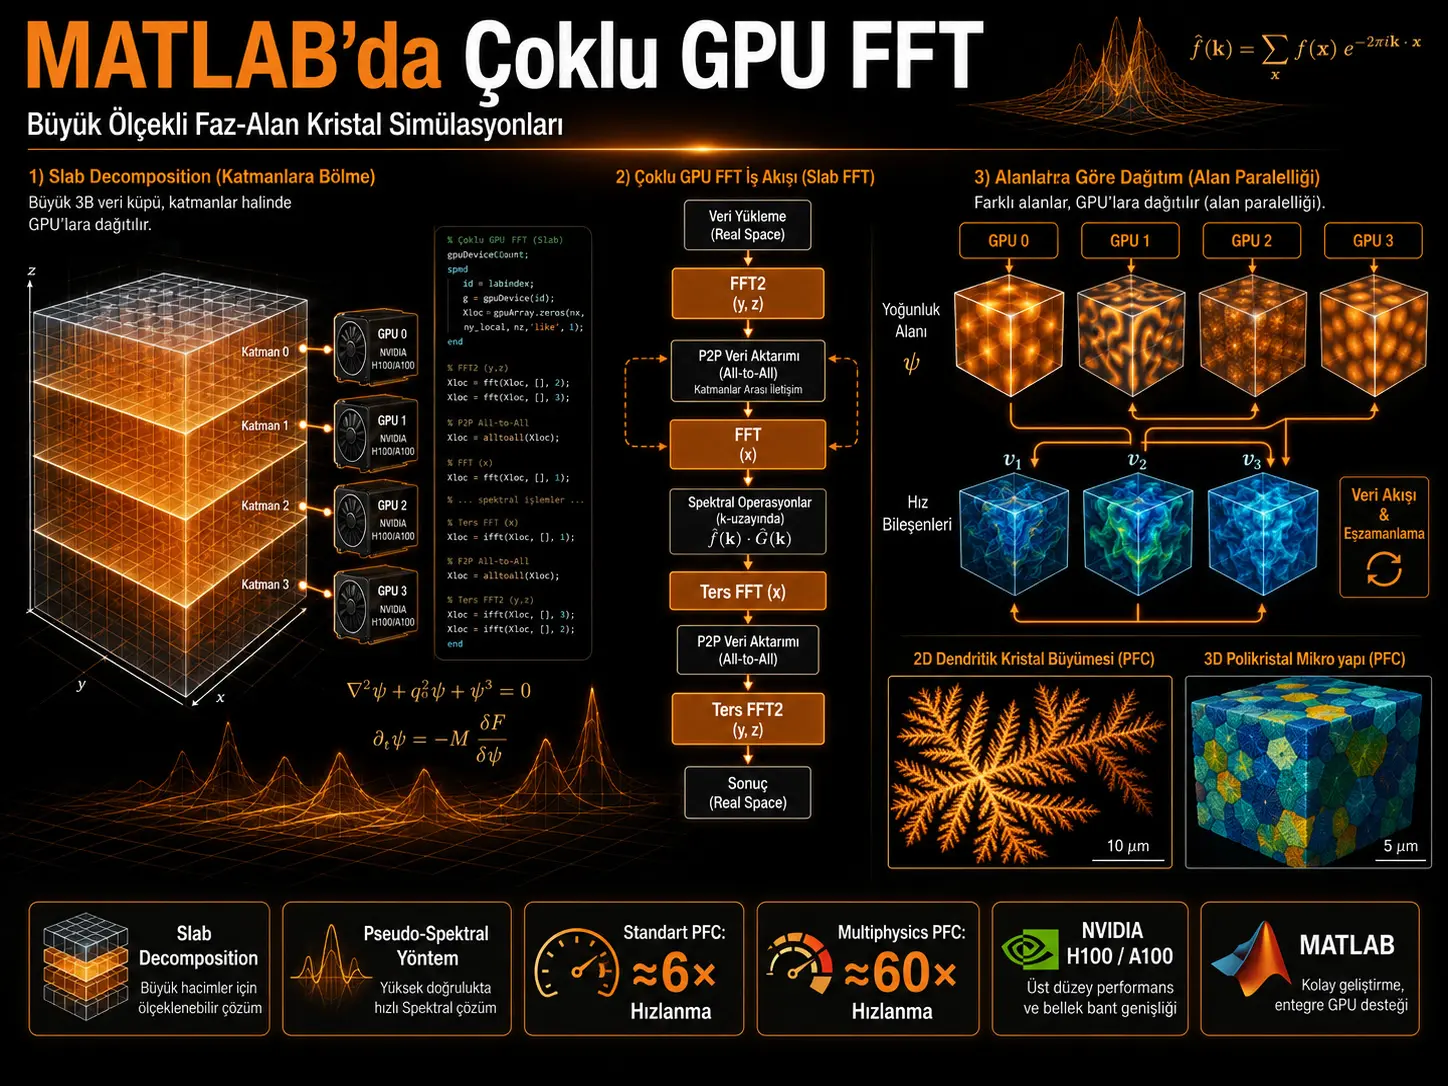
Bu çalışma, MATLAB ortamında iki ve üç boyutlu hızlı Fourier dönüşümlerini (Fast Fourier Transform, FFT) birden fazla GPU'ya dağıtarak tek GPU belleğinin sınırladığı büyük ölçekli pseudo-spektral simülasyonları çalıştırmayı amaçlayan iki tamamlayıcı paralelleştirme stratejisi geliştirmektedir. Birinci yaklaşımda tek bir büyük üç boyutlu FFT, uzaysal alanın slab decomposition yöntemiyle GPU'lara bölünmesi, her GPU'da yerel iki boyutlu FFT uygulanması, peer-to-peer veri yeniden dağıtımı ve kalan eksen boyunca bir boyutlu FFT gerçekleştirilmesiyle hesaplanmaktadır. İkinci yaklaşımda ise çok alanlı fizik modellerindeki farklı değişkenler ayrı GPU'lara atanmakta ve her zaman adımında GPU'lar arasında senkronize veri aktarımı yapılmaktadır.
Yöntemler faz-alan kristal (Phase-Field Crystal, PFC) modelleri üzerinde test edilmiştir. Standart üç boyutlu PFC simülasyonlarında 750³–1400³ aralığındaki problemler için GPU hesaplamaları dört NVIDIA H100 veya sekiz NVIDIA A100 GPU ile yürütülmüş; 100 çekirdekli Intel Xeon Platinum 8470 CPU referansına göre yaklaşık altı kata kadar hızlanma bildirilmiştir. 1400³ dizi yalnız dört H100 GPU üzerinde belleğe sığmış ve kaynak Şekil 1(a)'da çalışma süresinin CPU süresinin yaklaşık %17'sine düştüğünü belirtmiştir. Dört fiziksel alanın dört H100 GPU'ya dağıtıldığı hidrodinamik PFC yaklaşımında ise kaynak, CPU uygulamasına göre 60 kata kadar hızlanma raporlamaktadır.
Sonuçların en önemli yorumsal sınırı, bildirilen hızlanmaların belirli HPC donanımı, GPU belleği, GPU–GPU iletişim yapısı, MATLAB uygulaması ve PFC algoritmaları için ölçülmüş olmasıdır. Çalışma, her FFT probleminde daha fazla GPU'nun daha hızlı olacağını göstermemektedir; aksine küçük 750³ probleminde tek H100 GPU en iyi sonucu verirken ek GPU'ların iletişim maliyeti performans avantajını azaltmaktadır. Çalışmanın temel katkısı bu nedenle yalnız işlem hızını artırmak değil, tek GPU belleğine sığmayan yüksek çözünürlüklü spektral problemlerin MATLAB içinde çalıştırılabilmesini sağlamaktır.
Tek GPU neden büyük ölçekli FFT simülasyonlarında darboğaz oluşturuyor?
Pseudo-spektral Fourier yöntemlerinde yüksek mertebeli uzaysal türevler Fourier uzayında verimli biçimde hesaplanabilmektedir; ancak doğrusal olmayan kısım fiziksel uzayda değerlendirildiğinden her zaman adımında ileri ve ters FFT işlemleri tekrar tekrar çalıştırılır. Dizi boyutları büyüdükçe hem FFT hesaplama maliyeti hem de GPU belleğinde tutulması gereken çok boyutlu verinin hacmi hızla yükselir.
Faz-alan kristal modelleri bu problemi belirgin hâle getirir. PFC yaklaşımı kristal düzenini atomik uzunluk ölçeğinde çözmeye çalışırken mikroyapının çok daha büyük uzaysal ve difüzif zaman ölçeklerinde gelişimini takip eder. Sonuç olarak bir yandan ince uzaysal çözünürlük, diğer yandan geniş hesaplama alanı gerekir.
Birden fazla yoğunluk, bileşim, hız veya sıcaklık alanı içeren multiphysics modellerinde aynı anda birkaç büyük üç boyutlu alanın tutulması gerektiğinden tek GPU belleği daha da kritik bir sınırlama hâline gelir.
Fourier pseudo-spektral yönteminin temel denklemi nedir?
Kaynak yöntemi açıklamak için önce tek boyutlu genel bir evrim denklemi kullanmaktadır:
\[ \partial_t u=\mathcal{L}u+\mathcal{N}(u), \qquad x\in[0,2\pi),\;t\geq0 \]
Burada \(\mathcal L\) doğrusal diferansiyel operatörü, \(\mathcal N(u)\) ise \(u\)'nun polinom biçimindeki doğrusal olmayan kısmını temsil eder.
Periyodik alanda çözüm sonlu Fourier serisiyle yaklaşık olarak:
\[ u(x,t)\approx u_N(x,t) = \sum_{k=-K}^{K} \widehat{u}_k e^{ikx} \]
şeklinde ifade edilir ve:
\[ N=2K+1 \]
Fourier modu kullanılır.
Eşit aralıklı collocation noktaları:
\[ x_j=\frac{2\pi j}{N}, \qquad j=0,\ldots,N-1 \]
olarak tanımlanmaktadır.
Diferansiyel denklem Fourier uzayında nasıl değişiyor?
Fourier dönüşümü uygulandığında her Fourier modu için:
\[ \partial_t\widehat{u}_k = \widehat{\mathcal L}_k\widehat{u}_k+ \widehat{[\mathcal N(u)]}_k \]
biçiminde bir adi diferansiyel denklem elde edilir.
Uzaysal türevler Fourier uzayında basit çarpımlara dönüşür:
\[ \widehat{[\partial_x^n u]}_k = (ik)^n\widehat{u}_k. \]
Bu özellik yüksek mertebeli PDE'lerde özellikle değerlidir. Ancak doğrusal olmayan \(\mathcal N(u)\) terimi fiziksel uzayda noktasal olarak hesaplandığından algoritma sürekli olarak Fourier uzayı ile fiziksel uzay arasında gidip gelir.
Bir zaman adımının temel akışı şöyledir:
- Alan FFT ile Fourier uzayına dönüştürilir.
- Doğrusal olmayan terim fiziksel uzayda hesaplanıp yeniden FFT ile dönüştürülür.
- Fourier katsayılarının zaman gelişimi hesaplanır.
- Ters FFT ile yeni fiziksel alan elde edilir.
Büyük ölçekli hesaplamalarda bu tekrarlı çok boyutlu FFT'ler toplam çalışma süresinin ana bileşenlerinden biri hâline gelir.
Birinci strateji: Tek bir 3B FFT birden fazla GPU'ya nasıl dağıtılıyor?
Çalışmanın ilk stratejisi, tek bir:
\[ N_x\times N_y\times N_z \]
boyutlu diziyi \(G\) GPU'ya bölerek tek bir yüksek boyutlu FFT'nin çoklu GPU üzerinde gerçekleştirilmesidir.
Veri z yönünde slab decomposition kullanılarak bölünür. Her GPU başlangıçta global dizinin yalnız kendi slab'ını tutar.
İleri FFT üç ana aşamada yürütülür:
- Her GPU, kendi yerel veri parçasında ilk iki boyut boyunca
fft2çalıştırır. - GPU'lar peer-to-peer iletişimle veri parçalarını yeniden dağıtır.
- Yeniden düzenlenen veri üzerinde üçüncü boyut boyunca
fft(...,3)çalıştırılır.
Bu işlem sonunda global Fourier dönüşümü tamamlanmış olsa da bütün dönüşüm tek GPU'da bulunmaz; her GPU Fourier uzayındaki sonucun bir bölümünü taşır.
P2P iletişimi neden gerekiyor?
Yerel fft2 işlemleri yalnız GPU'nun sahip olduğu slab üzerindeki iki ekseni dönüştürebilir. Üçüncü eksendeki FFT için aynı dönüşüm doğrultusuna ait veri elemanlarının uygun GPU üzerinde bir araya getirilmesi gerekir.
Bu nedenle yerel FFT'lerden sonra veri GPU'lar arasında yeniden düzenlenmektedir. Kaynak MATLAB uygulamasında bu aşamayı spmd paralel oturumu ve spmdCat tabanlı veri birleştirme işlemleriyle göstermektedir.
Ters FFT'de sıra tersine çevrilir: üçüncü boyutta ifft, P2P yeniden dağıtım ve ilk iki boyutta ifft2.
| field | value |
|---|---|
| title | Tek 3B FFT'nin çoklu GPU üzerinde yürütülmesi |
| subtitle | Slab decomposition, yerel FFT, GPU’lar arası yeniden dağıtım, spektral zaman adımı ve ters dönüşüm katmanlarıyla ilerleyen 3B PFC hesaplama zinciri |
- 1. Slab decomposition aşamasında 3B dizi z doğrultusunda G GPU arasında bölünür ve her GPU yalnız kendi yerel slab’ını tutar
- 2. Yerel 2B FFT katmanında her slab’ın ilk iki boyutu bağımsız biçimde
fft2ile dönüştürülür - 3. P2P yeniden dağıtım aşamasında üçüncü eksendeki FFT için veri parçaları GPU’lar arasında
spmdvespmdCatdüzeniyle yeniden yerleştirilir - 4. Kalan 1B FFT aşamasında üçüncü uzaysal boyut
fft(...,3)ile Fourier uzayına dönüştürülür - 5. Spektral zaman adımında PFC alanının Fourier katsayıları semi-implicit yöntemle eleman bazlı olarak güncellenir
- 6. Ters 1B FFT aşamasında üçüncü boyuttan fiziksel uzaya dönüş
ifft(...,3)ile başlatılır - 7. Ters P2P dağıtımda veri tekrar yerel slab düzenine getirilir ve
spmdCatile eşlenir - 8. Ters 2B FFT katmanında ilk iki boyutta
ifft2uygulanarak fiziksel alan yeniden elde edilir
fidelity: source-faithful
source: Süreç, kaynak çalışmanın Şekil 1(a) ve Listing 1 MATLAB uygulamasına dayanır.
Phase-Field Crystal modeli hangi fiziksel problemi temsil ediyor?
PFC modeli kristal yoğunluk düzeninin uzaysal ve zamansal gelişimini tek bir sürekli yoğunluk alanı \(\psi(\mathbf{x},t)\) üzerinden temsil etmektedir. Kaynak, örnek olarak yüzey merkezli kübik (face-centered cubic, FCC) simetri için serbest enerji fonksiyonelini:
\[ F[\psi] = \int_{\Omega} \left[ \frac{\psi}{2} (\varepsilon+\mathcal L)\psi+ \frac{\psi^4}{4} \right]d\mathbf r \]
şeklinde vermektedir.
Burada:
\[ \mathcal L= (1+\nabla^2)^2 \left(\frac{4}{3}+\nabla^2\right)^2 \]
uzaysal korelasyonları tanımlayan operatördür ve \(\varepsilon\) undercooling parametresidir.
Klasik PFC dinamiği:
\[ \partial_t\psi = \nabla^2 \frac{\delta F[\psi]}{\delta\psi} = (\varepsilon+\mathcal L)\nabla^2\psi+ \nabla^2\psi^3 \]
ile ifade edilmektedir.
\(\mathcal L\) içerisinde ardışık Laplace operatörleri bulunması ve dışarıda ek \(\nabla^2\) uygulanması nedeniyle PFC denklemi kaynakta onuncu mertebeden PDE sınıfında tanımlanmaktadır.
MATLAB zaman adımını nasıl güncelliyor?
Listing 1'de Fourier uzayındaki yoğunluk alanı semi-implicit olarak:
psiF = (psiF + dt*lap.*psi)./(1 - dt*lin);
biçimindeki eleman bazlı güncellemeyle ilerletilmektedir.
Buradaki temel hesaplama zincirinde:
psifiziksel yoğunluk alanını,psiFFourier dönüşümlü yoğunluğu,lapayrık Laplace operatörünü,linayrık doğrusal operatörü,dtzaman adımını
temsil etmektedir.
Kaynak listing'leri tam yazılım paketinin tamamı değil, yöntemin çalışma mantığını gösteren implementation snippet'lerdir. Gerekli başlangıç değişkenlerinin ve veri bölme indekslerinin tam tanımları makale kod bloğunda verilmemektedir; çalıştırılabilir tam uygulama ayrı kaynak kod deposunda sunulmaktadır.
İlk benchmark hangi donanımlarda yapıldı?
| Hesaplama kaynağı | Kaynakta verilen donanım | Benchmark rolü |
|---|---|---|
| GPU sistemi 1 | 4 × NVIDIA H100 SXM5, GPU başına 94 GiB HBM2e | Capella HPC kümesi |
| GPU sistemi 2 | 8 × NVIDIA A100 SXM4, GPU başına 40 GiB HBM2 | Alpha Centauri HPC kümesi |
| CPU referansı | Intel Xeon Platinum 8470, toplam 100 çekirdek, 2,00 GHz | Barnard HPC kümesi |
Bu nedenle raporlanan GPU/CPU hızlanması yalnız kod paralelleştirmesini değil, birbirinden farklı hesaplama mimarilerinin performansını da içerir. Sonuçlar aynı donanım üzerinde yalnız CPU/GPU modunu değiştiren kontrollü mikrobenchmark olarak yorumlanmamalıdır.
750³ probleminde neden daha fazla GPU daha hızlı değil?
Çalışmanın Şekil 1(a)'sı önemli bir ölçeklenebilirlik sınırı gösteriyor: 750³ boyutundaki problem için H100 üzerinde en iyi performans tek GPU ile elde ediliyor.
Problem tek GPU belleğine rahatça sığdığında ilave GPU'lar hesaplama yükünü paylaşsa bile P2P veri hareketi ve senkronizasyon maliyeti ortaya çıkmaktadır. Küçük veya orta ölçekli problemde bu iletişim maliyeti paralelleştirme kazancından daha büyük olabilir.
Dolayısıyla çalışmanın sonucu “GPU sayısını artırdıkça FFT sürekli hızlanır” değildir. Çoklu GPU yaklaşımının değeri, problem boyutu tek GPU sınırını aşmaya başladığında belirginleşmektedir.
1400³ probleminde ne oluyor?
Kaynağa göre \(1400^3\) boyutundaki dizi yalnız dört H100 GPU kullanıldığında belleğe sığabilmiştir.
Şekil 1(a)'nın açıklamasında bu konfigürasyonun çalışma süresi 100 çekirdekli CPU referansının yaklaşık:
\[ 0.17 \]
katı, yani yaklaşık %17'si olarak verilmektedir.
Bu oran yaklaşık altı katlık hızlanmaya karşılık gelir ve makalenin standart PFC için raporladığı “up to sixfold” sonucunun temelini oluşturur.
Ancak bu sonucu bütün PFC boyutlarına genellemek doğru değildir. Şeklin aynı zamanda gösterdiği gibi optimal GPU sayısı problem büyüklüğüne ve kullanılan GPU ailesine göre değişmektedir.
İkinci strateji neden farklı?
İkinci strateji tek bir FFT'yi GPU'lara bölmek yerine, multiphysics modelindeki farklı fiziksel alanları ayrı GPU'lara dağıtmaktadır.
Kaynak hidrodinamik PFC modelini örnek almaktadır. Yoğunluk alanına üç bileşenli mezoskopik hız alanı eklenir:
\[ \mathbf v= (v_1,v_2,v_3). \]
Model:
\[ \partial_t\psi = \nabla^2 \left( \frac{\delta F[\psi]}{\delta\psi} \right) - \mathbf v\cdot\nabla\psi \]
ve:
\[ \rho\partial_t\mathbf v = \Gamma\nabla^2\mathbf v - \left\langle \psi\nabla \frac{\delta F[\psi]}{\delta\psi} \right\rangle \]
denklemleriyle tanımlanmaktadır.
Dört GPU'ya hangi alanlar atanıyor?
Çalışmanın Şekil 1(b)'si ve Listing 2'si dağılımı açık biçimde göstermektedir:
| GPU | Ana fiziksel alan |
|---|---|
| GPU 1 | Yoğunluk alanı \(\psi\) |
| GPU 2 | Hız bileşeni \(v_1\) |
| GPU 3 | Hız bileşeni \(v_2\) |
| GPU 4 | Hız bileşeni \(v_3\) |
GPU 1 yoğunluk alanını güncelledikten sonra yeni \(\psi\)'yi diğer üç GPU'ya gönderir. GPU 2–4 kendi hız bileşenlerini günceller ve sonuçları GPU 1'e geri gönderir.
MATLAB kodunda bu veri değişimi spmdSend ve spmdReceive ile gerçekleştirilmektedir.
Gaussian convolution neden Fourier yöntemine uygun?
Hidrodinamik PFC modelindeki yerel ortalama:
\[ \langle\cdot\rangle(\mathbf r) = \int_{\Omega} \frac{ (\cdot)(\mathbf r') }{ (2\pi a_0^2)^{3/2} } \exp \left[ -\frac{ (\mathbf r-\mathbf r')^2 }{ 2a_0^2 } \right] d\mathbf r' \]
biçimindeki Gaussian convolution ile tanımlanmaktadır.
Fourier dönüşümünün convolution özelliği sayesinde bu integral Fourier uzayında çarpıma dönüşmektedir. Böylece PFC'nin yüksek mertebeli diferansiyel operatörlerinde olduğu gibi convolution işlemi de pseudo-spektral yöntemin hesaplama yapısına doğal biçimde uyum sağlamaktadır.
Multiphysics modelinde 60 kat hızlanma ne anlama geliyor?
Kaynak, dört NVIDIA H100 GPU üzerinde çalıştırılan hydrodynamic PFC solver için 100 çekirdekli CPU uygulamasına kıyasla 60 kata kadar hızlanma bildirmektedir.
Bu değer standart PFC'deki yaklaşık altı katlık hızlanmayla doğrudan aynı paralelleştirme senaryosu değildir. Standart PFC benchmark'ında tek büyük FFT slab decomposition ile birden fazla GPU'ya yayılırken hydrodynamic PFC yaklaşımında dört ayrı fiziksel alan dört GPU'ya dağıtılmaktadır.
Dolayısıyla 6× ve 60× değerleri iki ayrı çoklu-GPU stratejisinin farklı problem yapılarına uygulanmasından elde edilmiştir.
Verianla Live: İki çoklu-GPU stratejisinin karşılaştırılması
| Özellik | Tek FFT'yi Çoklu GPU'ya Bölme | Multiphysics Alanlarını GPU'lara Dağıtma |
|---|---|---|
| Temel amaç | Tek büyük 3B FFT'nin tek GPU belleğini aşabilmesi | Birden fazla büyük fiziksel alanın eşzamanlı işlenmesi |
| Paralelleştirme biçimi | z yönünde slab decomposition + P2P redistribution | Her fiziksel alan ayrı GPU'da |
| Ana MATLAB iletişim yapısı | spmd / spmdCat | spmdSend / spmdReceive |
| GPU sistemleri | 4× H100 veya 8× A100 | 4× H100 |
| Kaynakta zamanlanan problem kapsamı | 750³–1400³ | Şekil 1(b)'de 750³–900³ |
| En yüksek bildirilen hızlanma | Yaklaşık 6× | Yaklaşık 60× |
| Ek kaynak görseli | 2B dendritik katılaşma | 1400³ 3B polikristal kabalaşma örneği |
Verianla Live: Bilgiler çalışmanın Şekil 1, Şekil 2 ve yöntem açıklamalarına dayanır. Şekil 1(b)'deki 900³ benchmark sınırı ile Şekil 2(b)'deki 1400³ temsilî hydrodynamic PFC örneği kaynakta ayrı ayrı verildiğinden burada birleştirilmemiştir.
Şekil 1(a) performans açısından ne söylüyor?
11. sayfadaki Şekil 1(a)'nın üst paneli üç boyutlu dizinin slab'lara ayrılmasını, yerel fft2 hesaplarını, P2P veri değişimini ve son fft aşamasını göstermektedir.
Alt panelde çalışma süresi 100 CPU çekirdeğindeki süreye normalize edilmiştir. En önemli eğilim şudur:
- 750³ gibi küçük problemde tek GPU en etkilidir.
- Problem büyüdükçe daha fazla GPU belleği gerekli hâle gelir.
- 1400³ dizi yalnız dört H100 GPU ile çalıştırılabilmiştir.
- Bu büyük konfigürasyon CPU çalışma süresinin yaklaşık %17'sine ulaşmıştır.
Şekil dolayısıyla hem hızlanmayı hem de bellek ölçekleme avantajını göstermektedir.
Şekil 1(b) neden daha büyük hızlanma gösteriyor?
Şekil 1(b)'de yoğunluk alanı \(\psi\) GPU 1'e, hız bileşenleri \(v_1\), \(v_2\) ve \(v_3\) ise GPU 2–4'e atanmıştır. Böylece birbirinden ayrı büyük FFT iş yükleri aynı anda farklı cihazlarda yürütülebilmektedir.
Kaynak grafiğinde dört H100 GPU'lu çalışma süresi CPU referansının yaklaşık birkaç yüzde biri düzeyindedir ve en iyi durumda yaklaşık 60× hızlanma elde edilmiştir.
Bu performans avantajı tek FFT'nin bölünmesinden farklıdır: farklı alanların doğal olarak birbirinden ayrılabilmesi daha yüksek paralellik sağlayabilmektedir.
2B dendritik katılaşma örneği ne kadar büyük?
12. sayfadaki Şekil 2(a), triangular crystal symmetry altında dendritik katılaşma örneğini göstermektedir.
Hesaplama alanı:
\[ 5\times10^4 \times 5\times10^4 \]
grid boyutundadır. Kaynak, alüminyum için 4 Å kafes sabiti varsayıldığında bunun yaklaşık:
\[ 2.5\,\mu\text{m}\times2.5\,\mu\text{m} \]
fiziksel alana karşılık geldiğini belirtmektedir.
Şekilde yoğunluk alanı \(\psi\) ve büyütülmüş bir bölge gösterilmektedir. Görsel üzerindeki beyaz çizgiler fiziksel tane sınırları değildir; kaynak bunların dizi tek bir grafik olarak çizilemeyecek kadar büyük olduğu için kullanılan görselleştirme parçalarının sınırlarını gösterdiğini açıkça belirtmektedir.
3B polikristal örnek ne gösteriyor?
Şekil 2(b), FCC kristal yapısında hydrodynamic PFC ile polikristal kabalaşmayı göstermektedir.
Görselleştirilen değişkenler:
- yoğunluk alanı \(\psi\),
- hız bileşeni \(v_1\),
- hız bileşeni \(v_2\),
- hız bileşeni \(v_3\)
olarak verilmiştir.
Şekil açıklamasında kullanılan grid:
\[ 1400\times1400\times1400 \]
ve fiziksel kutu boyutu yaklaşık:
\[ 40\,\text{nm}\times40\,\text{nm}\times40\,\text{nm} \]
olarak belirtilmektedir.
Bu değer Şekil 1(b)'deki zamanlanmış hydrodynamic benchmark'ın 900³ üst sınırından büyüktür. Kaynak 1400³ görselleştirmesinin benchmark grafiğindeki deneyle aynı koşullarda olup olmadığını açıklamamaktadır; dolayısıyla iki sonuç aynı benchmark noktası olarak değerlendirilmemelidir.
Çalışmanın iddia ettiği özgünlük nedir?
Yazarlar, genel dağıtık çoklu-GPU FFT yöntemlerinin yüksek başarımlı hesaplamada daha önce bulunduğunu kabul etmektedir. Çalışmanın özgünlük iddiası bunlardan farklıdır: kaynak, MATLAB içinde uygulamadan bağımsız genel bir multi-GPU FFT altyapısının mevcut olmadığını ve sunulan yaklaşımın MATLAB'daki ilk multi-GPU FFT implementasyonunu oluşturduğunu ifade etmektedir.
Bu, yazarların literatür ve yazılım ekosistemi değerlendirmesine dayanan bir özgünlük iddiasıdır. Çalışma bütün özel veya yayımlanmamış MATLAB kodlarını kapsayan bağımsız bir yazılım envanteri gerçekleştirmemektedir.
Daha fazla GPU ne zaman fayda sağlıyor?
Kaynak sonuçlarına göre çoklu GPU özellikle iki durumda anlamlı hâle gelmektedir:
- Tek bir FFT dizisi tek GPU belleğine sığmadığında.
- Multiphysics modelinde birden fazla büyük fiziksel alan eşzamanlı olarak güncellendiğinde.
Buna karşılık tek GPU'ya rahatça sığan küçük problemlerde veri iletişimi nedeniyle ek GPU kullanımı daha yavaş olabilir.
Dolayısıyla GPU sayısı bağımsız bir performans parametresi değildir; problem boyutu, GPU belleği, P2P bant genişliği, iş yükünün bölünebilirliği ve hesaplama/iletişim oranı birlikte değerlendirilmelidir.
Türkiye açısından ne ifade ediyor?
Çalışma TU Dresden ve NHR Center HPC altyapısı üzerinde gerçekleştirilmiştir; Türkiye'deki bir HPC sistemi veya araştırma merkezinde benchmark yapılmamıştır.
Yöntem, MATLAB tabanlı yüksek çözünürlüklü malzeme modelleme, spektral PDE çözümü veya çok alanlı fizik simülasyonu yapan Türkiye'deki araştırma grupları açısından metodolojik olarak uyarlanabilir. Ancak çalışmadaki 6× veya 60× değerleri farklı GPU modellerine, PCIe/NVLink topolojilerine, CPU yapılarına veya MATLAB sürümlerine doğrudan aktarılmamalıdır.
Yerel bir sistemde gerçek performansın belirlenebilmesi için aynı problem boyutlarıyla ayrı strong-scaling, memory-scaling ve GPU iletişim benchmark'ları yapılması gerekir.
Çalışmanın desteklediği sonuçlar
- MATLAB içinde çoklu GPU kullanılarak iki ve üç boyutlu FFT tabanlı pseudo-spektral hesaplamalar gerçekleştirilebilmiştir.
- Tek bir büyük 3B FFT slab decomposition ve GPU–GPU veri iletişimi kullanılarak birden fazla GPU'ya dağıtılabilmiştir.
- 750³–1400³ PFC benchmark'larında yaklaşık altı kata kadar GPU/CPU hızlanması raporlanmıştır.
- 1400³ standart PFC dizisi kaynak donanımında yalnız dört H100 GPU üzerinde belleğe sığmıştır.
- 1400³ H100 sonucu CPU referans zamanının yaklaşık %17'si olarak bildirilmiştir.
- Küçük 750³ probleminde tek H100 GPU, daha fazla H100 GPU kullanımından daha iyi performans göstermiştir.
- Hydrodynamic PFC'de \(\psi,v_1,v_2,v_3\) alanları dört GPU'ya ayrı ayrı dağıtılabilmiştir.
- Bu ikinci stratejide 100 çekirdekli CPU uygulamasına göre 60 kata kadar hızlanma raporlanmıştır.
- Çalışma 2B dendritik katılaşma ve 3B polikristal kabalaşma örnekleriyle yöntemin PFC simülasyonlarına uygulanmasını göstermiştir.
- Kaynak kod MIT lisansıyla bir yazılım deposunda paylaşılmıştır.
Çalışmanın desteklemediği veya test etmediği sonuçlar
- Daha fazla GPU'nun her problemde daha hızlı olduğu gösterilmemektedir.
- 6× ve 60× hızlanmalar bütün GPU/CPU sistemleri için evrensel değerler değildir.
- Çalışma bütün MATLAB FFT uygulamalarının aynı ölçeklenebilirliğe ulaşacağını göstermemektedir.
- Çalışma H100 ve A100 dışındaki GPU'larda ayrıntılı performans benchmark'ı sunmamaktadır.
- GPU–GPU iletişim süresi ayrı bileşen olarak nicel biçimde parçalanmamıştır.
- Strong-scaling ve weak-scaling verimliliği klasik HPC metrikleriyle ayrı tablolar hâlinde raporlanmamıştır.
- GPU çözümü ile CPU çözümü arasındaki sayısal hata için ayrı bir FFT doğruluk tablosu sunulmamıştır.
- Raporlanan benchmark sonuçları gerçek deneysel malzeme mikroyapısıyla nicel doğrulama anlamına gelmez; bunlar PFC sayısal simülasyonlarıdır.
- Hydrodynamic PFC için Şekil 2(b)'deki 1400³ görselinin Şekil 1(b)'deki zamanlama benchmark'ının bir parçası olduğu kaynak tarafından açıkça belirtilmemiştir.
- Çalışma GPU sayısını artırmanın maliyet/enerji verimliliğini değerlendirmemektedir.
- Yazarların “MATLAB'daki ilk multi-GPU FFT” ifadesi bağımsız ve eksiksiz bir küresel yazılım taramasının sonucu olarak doğrulanmamıştır.
Çalışmanın Yöntemi ve Bulguları
İki paralelleştirme stratejisinin teknik özeti
| Parametre | Strateji 1 | Strateji 2 |
|---|---|---|
| Problem | Tek büyük FFT | Multiphysics PFC |
| Paralelleştirme | Domain/slab decomposition | Field decomposition |
| Yerel hesaplama | 2B FFT + 1B FFT | Her GPU kendi alanının 3B FFT'lerini yürütür |
| İletişim | P2P data redistribution | Alanların zaman adımı sonunda senkronizasyonu |
| MATLAB yapısı | spmd, spmdCat | spmd, spmdSend, spmdReceive |
| Ana avantaj | Tek GPU belleğini aşan FFT | Birden fazla fiziksel alanın eşzamanlı yürütülmesi |
Standart PFC benchmark kapsamı
| Gösterge | Kaynak değeri |
|---|---|
| Problem boyutu aralığı | 750³–1400³ |
| Benchmark süresi | Şekil 1'de 1000 zaman adımı |
| H100 sistemi | 4 × NVIDIA H100 SXM5, 94 GiB HBM2e/GPU |
| A100 sistemi | 8 × NVIDIA A100 SXM4, 40 GiB HBM2/GPU |
| CPU referansı | 100 × Intel Xeon Platinum 8470 çekirdeği, 2,00 GHz |
| Maksimum bildirilen hızlanma | Yaklaşık 6× |
| 1400³ bellek gereksinimi | Kaynak sistemde yalnız 4 H100 ile çalıştırılabilmiş |
| 1400³ göreli çalışma süresi | CPU zamanının yaklaşık %17'si |
Multiphysics benchmark kapsamı
| Gösterge | Kaynak değeri |
|---|---|
| Model | 3B hydrodynamic PFC |
| Fiziksel alanlar | ψ, v₁, v₂, v₃ |
| GPU sayısı | 4 × NVIDIA H100 |
| GPU başına alan | Bir ana fiziksel alan |
| Şekil 1(b) benchmark boyutları | 750³–900³ |
| Maksimum bildirilen hızlanma | Yaklaşık 60× CPU referansına göre |
| Şekil 2(b) ayrı örnek grid | 1400³ |
Neden H100 ile A100 sonuçları doğrudan GPU sayısıyla okunmamalı?
H100 ve A100 sistemleri yalnız GPU sayısı bakımından farklı değildir. Kaynakta H100 GPU başına 94 GiB HBM2e, A100 GPU başına 40 GiB HBM2 bellek kullanmaktadır. Dolayısıyla aynı problem için “dört GPU” veya “sekiz GPU” ifadesi tek başına eşdeğer hesaplama kaynağını tanımlamaz.
Şekil 1(a)'da farklı GPU aileleri farklı eğrilerle gösterilmiştir. Sonuçlar GPU sayısının yanı sıra GPU mimarisi, bellek kapasitesi ve interconnect özellikleriyle birlikte yorumlanmalıdır.
Hesaplama alanının fiziksel ölçeği
| Örnek | Grid | Kaynakta verilen fiziksel ölçek |
|---|---|---|
| 2B dendritik katılaşma | 50.000 × 50.000 | 2,5 µm × 2,5 µm; 4 Å Al kafes sabiti varsayımıyla |
| 3B polikristal kabalaşma | 1400 × 1400 × 1400 | 40 nm × 40 nm × 40 nm |
Bu örnekler PFC yaklaşımının temel hesaplama zorluğunu görünür kılar: fiziksel alan mikrometre veya onlarca nanometre düzeyinde olsa bile kristal örgünün atomik ölçekli yapısını çözmek için milyarlarca grid noktası gerekebilmektedir.
Şekil 2(a)'daki dendritik desen neyi kanıtlıyor?
Şekil 2(a), multi-GPU single-FFT uygulamasının büyük bir iki boyutlu PFC katılaşma probleminde kullanılabildiğini göstermektedir. Şekil, yöntemlerin fiziksel malzemede ölçülmüş bir dendritin deneysel görüntüsü değildir.
Dolayısıyla görselden gerçek alüminyum dendrit morfolojisinin nicel olarak doğrulandığı sonucu çıkarılamaz. Kaynak örneği multi-GPU hesaplamanın büyük PFC alanındaki uygulamasını göstermek amacıyla kullanmaktadır.
Şekil 2(b)'de hız alanlarının gösterilmesinin anlamı nedir?
Hidrodinamik PFC yalnız yoğunluk değişkenini değil üç bileşenli hız alanını da çözmektedir. Şekil 2(b)'de \(\psi\)'nin yanında \(v_1\), \(v_2\) ve \(v_3\)'ün ayrı hacimsel görselleştirmelerinin verilmesi, ikinci GPU stratejisindeki dört fiziksel alan ayrımının doğrudan model değişkenlerine karşılık geldiğini göstermektedir.
Başka bir ifadeyle dört GPU kullanımı yalnız teknik olarak diziyi dört parçaya ayırmak değildir; her GPU modelin belirli bir fiziksel alanının hesaplama yükünü taşımaktadır.
Yöntemin gelecekteki ölçeklenme hedefi ne?
Yazarlar ikinci stratejinin principal Fourier modes için complex amplitude kullanan coarse-grained PFC modellerine doğal biçimde genişleyebileceğini belirtmektedir. Bu tür modeller onlarca coupled complex-valued field içerebilir.
Kaynak, bu yapıların field-level GPU parallelization için özellikle uygun olmasını beklemektedir; ancak çalışmada onlarca kompleks alan kullanan yeni bir benchmark sunulmamıştır. Bu nedenle söz konusu avantaj bir gelecek kullanım beklentisidir, mevcut sayısal sonuç değildir.
Performans sonuçlarının temel yorumu
Çalışmanın iki stratejisinden çıkan ortak sonuç, çoklu GPU kullanımının yalnız daha fazla hesaplama birimi eklemek olarak değerlendirilmemesi gerektiğidir.
Tek FFT stratejisinde iletişim maliyeti nedeniyle küçük problemlerde tek GPU daha hızlı olabilir; büyük problemlerde ise çoklu GPU öncelikle bellek sınırını aşarak simülasyonu mümkün kılar.
Multiphysics stratejisinde bağımsız fiziksel alanların doğal ayrımı, farklı GPU'ların eşzamanlı çalışmasına daha fazla olanak tanımakta ve kaynak benchmark'ında çok daha yüksek hızlanmaya ulaşmaktadır.
Benchmark sonuçlarını genellerken hangi değişkenler önemlidir?
- GPU modeli ve GPU başına bellek kapasitesi,
- GPU'lar arasındaki iletişim topolojisi ve bant genişliği,
- Problem boyutu,
- FFT boyutları,
- GPU başına yerel hesaplama/iletişim oranı,
- Fiziksel alan sayısı,
- Zaman integrasyon yöntemi,
- CPU referans mimarisi,
- MATLAB ve paralel hesaplama ortamının uygulama ayrıntıları.
Çalışma bu faktörlerin tamamı için ayrı duyarlılık analizi sunmamaktadır. Bu nedenle 6× ve 60× değerleri raporlanan HPC konfigürasyonlarının sonuçları olarak korunmalıdır.
Çalışmanın güçlü yönleri
- Yalnız FFT mikrobenchmark'ı yerine gerçek yüksek mertebeli PDE kullanım senaryosu verilmiştir.
- Hem domain decomposition hem field decomposition yaklaşımı aynı MATLAB çerçevesinde gösterilmiştir.
- H100 ve A100 tabanlı birden fazla GPU sistemi kullanılmıştır.
- CPU referansı açık donanım bilgisiyle verilmiştir.
- Tek GPU belleğine sığmayan problem boyutları doğrudan test edilmiştir.
- MATLAB implementation snippet'leri paylaşılmıştır.
- Tam kaynak kod deposu ve Zenodo kaydı verilmiştir.
- 2B ve 3B PFC kullanım örnekleri görsel olarak sunulmuştur.
Temel sınırlılıklar
- Hakim sonuç metriği çalışma süresidir; ayrı sayısal doğruluk benchmark'ı sınırlıdır.
- GPU–GPU iletişim maliyeti ayrı zaman bileşenlerine ayrılmamıştır.
- Enerji tüketimi ve performans/watt ölçülmemiştir.
- Farklı GPU üreticileri veya farklı NVIDIA nesilleri kapsamlı biçimde test edilmemiştir.
- Benchmark tek bir PFC problem ailesi etrafında yapılandırılmıştır.
- Çalışma gerçek deneysel malzeme mikroyapısıyla nicel model validasyonu amacı taşımamaktadır.
- Kaynakta hydrodynamic PFC için 900³ benchmark sınırı ile 1400³ temsilî görsel arasında açıklanmamış bir boyut farkı bulunmaktadır.
- Yazılım listeleri yöntemi göstermektedir ancak tek başlarına bütün başlangıç ve çalışma parametrelerini içeren bağımsız executable programlar değildir.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: Multi-GPU fast Fourier transforms in MATLAB for large-scale phase-field crystal simulations
Bibliyografik başlık notu: Yüklenen PDF başlığı yukarıdaki parantezsiz biçimdedir. arXiv metadata kaydı başlığı “Multi-GPU fast Fourier transforms in MATLAB (for large-scale phase-field crystal simulations)” biçiminde, ikinci bölümü parantez içinde göstermektedir. Özgün PDF başlığı sessizce değiştirilmemiştir.
Yazarlar ve özgün sıralama: Maik Punke; Marco Salvalaglio.
Kurum: Institute of Scientific Computing, TU Dresden, 01062 Dresden, Germany.
İkinci kurum: Dresden Center for Computational Materials Science, TU Dresden, 01062 Dresden, Germany; Marco Salvalaglio için kaynakta ikinci afiliyasyon olarak gösterilmektedir.
Sorumlu yazar: Yüklenen PDF'de ayrı bir “corresponding author” etiketi bulunmamaktadır. Her iki yazarın isminde afiliyasyon işaretleri bulunmakta, e-posta/sorumlu-yazar işareti açıkça belirtilmemektedir.
Eş birinci/eş katkı: Yüklenen sürümde eş katkı beyanı bulunmamaktadır.
Kaynak türü: MATLAB tabanlı yüksek başarımlı hesaplama, bilimsel yazılım ve sayısal simülasyon çalışması.
Yayın durumu: Yüklenen çalışma arXiv üzerinde yayımlanmış ve hakem değerlendirmesinden geçmiş ayrı bir dergi sürümü doğrulanmamış bir preprinttir. Bulgular bu yayın aşaması dikkate alınarak değerlendirilmelidir.
Platform: arXiv.
arXiv kimliği: 2603.26818v1 [cs.MS].
Birincil kategori: Mathematical Software (cs.MS).
Ek kategoriler: Materials Science (cond-mat.mtrl-sci) ve Computational Physics (physics.comp-ph).
arXiv ilk gönderim tarihi: 26 Mart 2026.
PDF üzerinde yazılı tarih: 31 Mart 2026.
arXiv DOI: 10.48550/arXiv.2603.26818.
Bilimsel yöntem: Fourier pseudo-spektral çözüm; çoklu GPU domain decomposition; slab decomposition; peer-to-peer veri yeniden dağıtımı; field-level multiphysics parallelization; semi-implicit ve kaynak kod listing'lerinde belirtilen implicit zaman güncellemeleri.
Ana uygulama: İki ve üç boyutlu phase-field crystal simülasyonları.
Benchmark GPU'ları: 4 × NVIDIA H100 SXM5 (94 GiB HBM2e/GPU) ve 8 × NVIDIA A100 SXM4 (40 GiB HBM2/GPU).
CPU referansı: Intel Xeon Platinum 8470, toplam 100 çekirdek, 2,00 GHz.
HPC altyapısı: TU Dresden NHR Center bünyesindeki Capella, Alpha Centauri ve Barnard sistemleri.
Kaynak kod deposu: https://github.com/mpunke/MATLABmultiGPUFFT/
Yazılım lisansı: MIT License.
Zenodo DOI: 10.5281/zenodo.18670913.
Temel benchmark sonucu: Standart PFC için CPU referansına göre yaklaşık 6×'e kadar, hydrodynamic multiphysics PFC için yaklaşık 60×'e kadar hızlanma bildirilmiştir.
Benchmark yorumu: Bu değerler aynı problem üzerinde özdeş işlemci kaynaklarını karşılaştıran saf algoritmik scaling katsayıları değildir. GPU ve CPU tarafları farklı mimarilere ve bellek sistemlerine sahiptir.
Kaynak-içi ifade notu — CPU çekirdeği: Çalışmanın Summary bölümü CPU uygulamasını “hundreds of cores” ifadesiyle tanımlarken ayrıntılı benchmark açıklaması ve Şekil 1 açıkça 100 CPU çekirdeğini referans almaktadır. Sayısal karşılaştırmalarda ayrıntılı benchmark'taki 100 çekirdek bilgisi kullanılmıştır.
Kaynak-içi kapsam notu — hydrodynamic PFC boyutu: Şekil 1(b) açıklamasında benchmark'ın çoklu GPU ile 900³ problem boyutuna kadar ulaştığı belirtilmektedir. Şekil 2(b) ise hydrodynamic PFC için 1400³ grid kullanan ayrı bir polikristal kabalaşma örneği göstermektedir. Kaynak bu iki durumun çalışma koşulları arasındaki farkı açıklamadığından 1400³ değer benchmark grafiğinin doğrudan ek veri noktası olarak yorumlanmamıştır.
Kod listing sınırı: Listing 1 ve Listing 2 algoritmanın temel paralel veri akışını göstermektedir; başlangıç dizilerinin, ayrıştırma indekslerinin ve bütün yardımcı değişkenlerin eksiksiz tanımlarını içeren bağımsız tam program değildir. Çalıştırılabilir uygulamanın kaynak deposuna ayrıca başvurulması gerekir.
Özgünlük iddiası sınırı: Yazarlar çalışmayı MATLAB'daki ilk multi-GPU FFT implementasyonu olarak tanımlamaktadır. Bu ifade kaynak yazarlarının mevcut literatür/yazılım değerlendirmesine dayanır ve bağımsız kapsamlı küresel yazılım envanteri olarak doğrulanmamıştır.
Finansman: Çalışma Deutsche Forschungsgemeinschaft (DFG) tarafından 447241406 ve 493401063 proje numaralarıyla desteklenmiştir.
Hesaplama kaynağı: Yazarlar TU Dresden NHR Center yüksek başarımlı hesaplama sistemlerinin kullanımını ayrıca teşekkür bölümünde belirtmektedir.
Çıkar çatışması: Yüklenen metinde ayrı bir competing-interest veya conflict-of-interest beyanı bulunmamaktadır; bundan çıkar çatışması olmadığı sonucu çıkarılmamıştır.
CRediT/yazar katkıları: Yüklenen sürümde ayrı bir CRediT authorship contribution statement bulunmamaktadır.
Bilimsel doğrulama sınırı: Çalışmanın ana doğrulaması hesaplama performansı ve büyük problem boyutlarının çalıştırılabilirliğidir. Gerçek malzeme deneyleriyle mikroyapı validasyonu, FFT sayısal hata benchmark'ı, enerji verimliliği veya kapsamlı strong/weak scaling analizi çalışmanın ana değerlendirme setinde raporlanmamıştır.
Bilimsel içerik sınırı: Bu Verianla makalesindeki PFC denklemleri, FFT algoritmaları, çoklu-GPU stratejileri, donanım bilgileri, benchmark sonuçları ve Şekil 1–2 yorumları yüklenen çalışmaya dayanmaktadır. Dış bibliyografik kontrol yalnız arXiv kimliği, DOI, güncel yayın durumu ve yazılım dağıtım kaydını doğrulamak amacıyla kullanılmış; kaynakta bulunmayan yeni simülasyon sonucu eklenmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir