

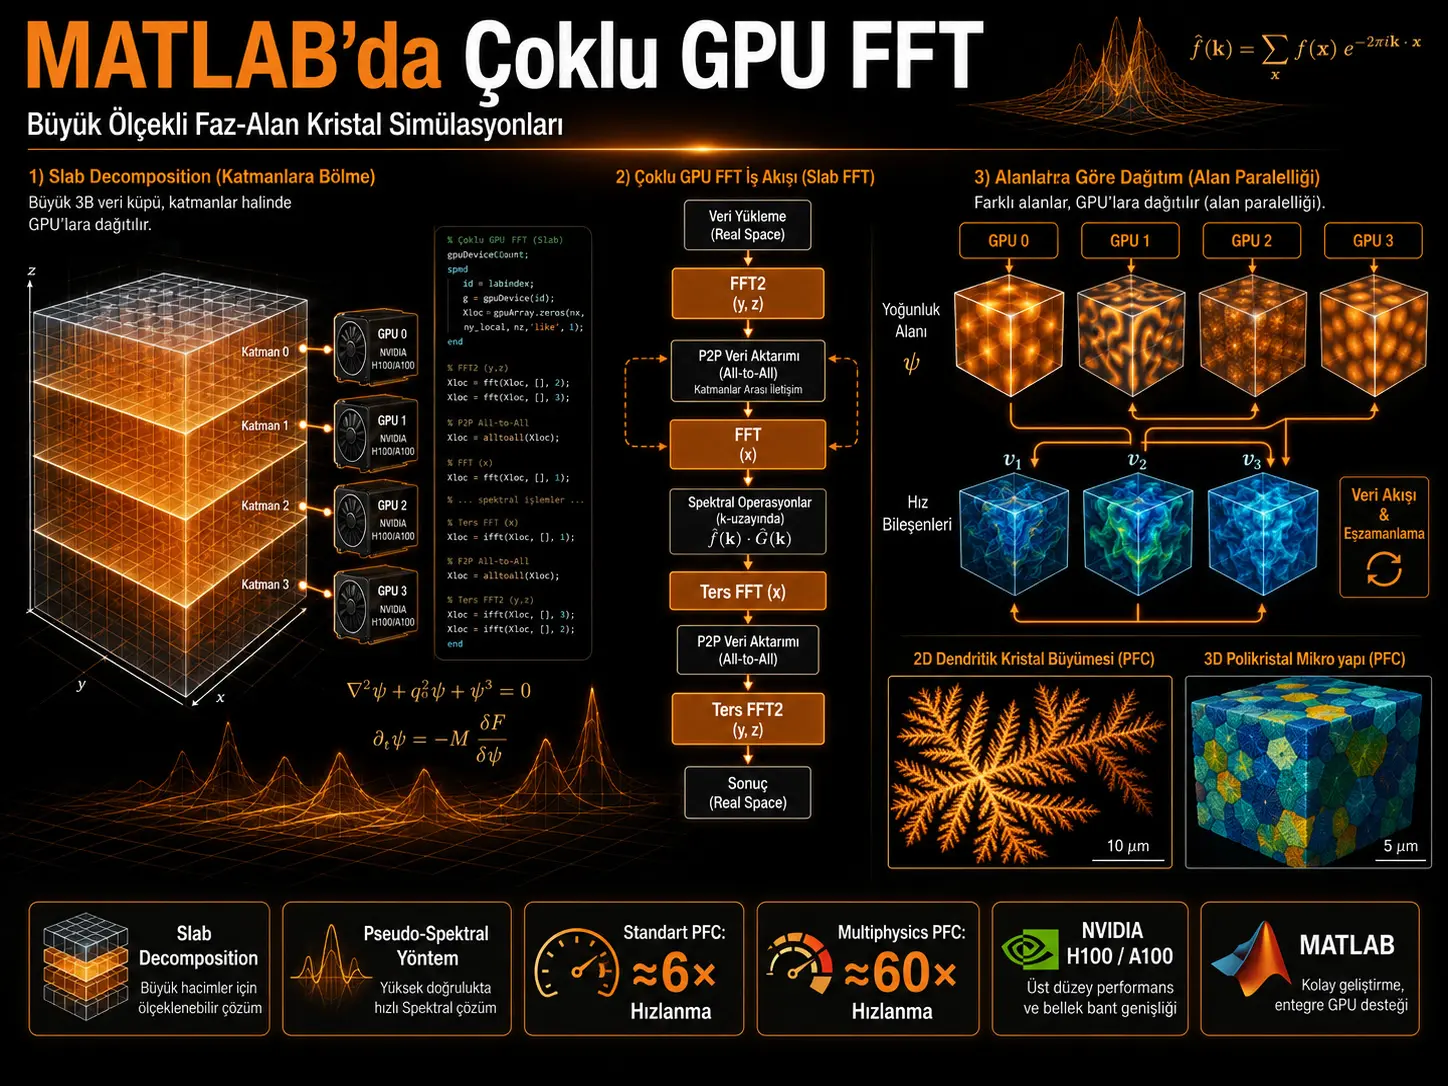
Bu tədqiqat, MATLAB mühitində iki və üçölçülü sürətli Furye çevirmələrini (Fast Fourier Transform, FFT) bir neçə GPU arasında paylayaraq, tək GPU yaddaşının məhdudlaşdırdığı böyükmiqyaslı pseudo-spektral simulyasiyaları işlətmək məqsədilə iki tamamlayıcı paralelləşdirmə strategiyası hazırlayır. Birinci yanaşmada tək böyük üçölçülü FFT, məkan sahəsinin slab decomposition metodu ilə GPU-lara bölünməsi, hər GPU-da lokal ikiölçülü FFT tətbiq olunması, peer-to-peer məlumatın yenidən paylanması və qalan ox boyunca birölçülü FFT-nin icrası ilə hesablanır. İkinci yanaşmada isə çoxsahəli fizika modellərindəki müxtəlif dəyişənlər ayrı-ayrı GPU-lara təyin olunur və hər zaman addımında GPU-lar arasında sinxron məlumat ötürülməsi aparılır.
Metodlar faza-sahəsi kristalı (Phase-Field Crystal, PFC) modelləri üzərində sınaqdan keçirilmişdir. Standart üçölçülü PFC simulyasiyalarında 750³–1400³ aralığındakı problemlər üçün GPU hesablamaları dörd NVIDIA H100 və ya səkkiz NVIDIA A100 GPU ilə yerinə yetirilmiş; 100 nüvəli Intel Xeon Platinum 8470 CPU istinadına nisbətən təxminən altı dəfəyədək sürətlənmə bildirilmışdir. 1400³ massiv yalnız dörd H100 GPU üzərində yaddaşa sığmış və mənbə Şəkil 1(a)-da icra müddətinin CPU müddətinin təxminən %17-sinə düşdüyünü qeyd etmişdir. Dörd fiziki sahənin dörd H100 GPU-ya paylandığı hidrodinamik PFC yanaşmasında isə mənbə CPU tətbiqinə nisbətən 60 dəfəyədək sürətlənmə hesabatlandırır.
Nəticələrin ən vacib şərh məhdudiyyəti ondan ibarətdir ki, bildirilən sürətlənmələr konkret HPC avadanlığı, GPU yaddaşı, GPU–GPU rabitə quruluşu, MATLAB tətbiqi və PFC alqoritmləri üçün ölçülmüşdür. Tədqiqat hər bir FFT problemində daha çox GPU-nun daha sürətli olacağını göstərmir; əksinə, kiçik 750³ problemində tək H100 GPU ən yaxşı nəticəni verdiyi halda əlavə GPU-ların rabitə xərci performans üstünlüyünü azaldır. Buna görə tədqiqatın əsas töhfəsi yalnız emal sürətini artırmaq deyil, tək GPU yaddaşına sığmayan yüksək ayırdetməli spektral problemlərin MATLAB daxilində işlədilə bilməsini təmin etməkdir.
Tək GPU niyə böyükmiqyaslı FFT simulyasiyalarında darboğaz yaradır?
Pseudo-spektral Furye metodlarında yüksək dərəcəli məkan törəmələri Furye fəzasında səmərəli şəkildə hesablana bilir; lakin qeyri-xətti hissə fiziki fəzada qiymətləndirildiyi üçün hər zaman addımında irəli və tərs FFT əməliyyatları dəfələrlə icra olunur. Massiv ölçüləri böyüdükcə həm FFT hesablama xərci, həm də GPU yaddaşında saxlanmalı olan çoxölçülü məlumatın həcmi sürətlə artır.
Faza-sahəsi kristalı modelləri bu problemi daha qabarıq göstərir. PFC yanaşması kristal düzənini atomik uzunluq miqyasında həll etməyə çalışarkən, mikroquruluşun daha böyük məkan və diffuziv zaman miqyasında təkamülünü izləyir. Nəticədə bir tərəfdən incə məkan ayırdetməsi, digər tərəfdən isə geniş hesablama sahəsi tələb olunur.
Sıxlıq, tərkib, sürət və ya temperatur kimi bir neçə sahəni eyni vaxtda ehtiva edən multiphysics modellərində bir neçə böyük üçölçülü sahə eyni anda saxlanmalı olduğundan tək GPU yaddaşı daha da kritik məhdudiyyətə çevrilir.
Furye pseudo-spektral metodunun əsas tənliyi nədir?
Mənbə metodu izah etmək üçün əvvəlcə birölçülü ümumi təkamül tənliyindən istifadə edir:
\[ \partial_t u=\mathcal{L}u+\mathcal{N}(u), \qquad x\in[0,2\pi),\;t\geq0 \]
Burada \(\mathcal L\) xətti diferensial operatoru, \(\mathcal N(u)\) isə \(u\)-nun polinom formalı qeyri-xətti hissəsini təmsil edir.
Periodik sahədə həll sonlu Furye sırası ilə təxmini olaraq:
\[ u(x,t)\approx u_N(x,t) = \sum_{k=-K}^{K} \widehat{u}_k e^{ikx} \]
şəklində ifadə olunur və:
\[ N=2K+1 \]
Furye modu istifadə edilir.
Bərabər aralı kollokasiya nöqtələri:
\[ x_j=\frac{2\pi j}{N}, \qquad j=0,\ldots,N-1 \]
olaraq tərif edilir.
Diferensial tənlik Furye fəzasında necə dəyişir?
Furye çevirməsi tətbiq edildikdə hər Furye modu üçün:
\[ \partial_t\widehat{u}_k = \widehat{\mathcal L}_k\widehat{u}_k+ \widehat{[\mathcal N(u)]}_k \]
şəklində adi diferensial tənlik alınır.
Məkan törəmələri Furye fəzasında sadə vurmalara çevrilir:
\[ \widehat{[\partial_x^n u]}_k = (ik)^n\widehat{u}_k. \]
Bu xüsusiyyət yüksək dərəcəli PDE-lərdə xüsusilə qiymətlidir. Lakin qeyri-xətti \(\mathcal N(u)\) hadi fiziki fəzada nöqtəvi şəkildə hesablandığından alqoritm davamlı olaraq Furye fəzasi ilə fiziki fəza arasında irəli-geri hərəkət edir.
Bir zaman addımının əsas axını aşağıdakı kimidir:
- Sahə FFT ilə Furye fəzasına çevrilir.
- Qeyri-xətti termin fiziki fəzada hesablanır və yenidən FFT ilə çevrilir.
- Furye əmsallarının zaman üzrə inkişafı hesablanır.
- Tərs FFT ilə yeni fiziki sahə əldə edilir.
Böyükmiqyaslı hesablamalarda bu təkrarlanan çoxölçülü FFT-lər ümumi icra müddətinin əsas tərkib hissələrindən birinə çevrilir.
Birinci strategiya: Tək bir 3B FFT bir neçə GPU-ya necə paylanır?
Tədqiqatın birinci strategiyası tək bir:
\[ N_x\times N_y\times N_z \]
ölçülü massivi \(G\) GPU-ya bölərək tək yüksəkölçülü FFT-ni çoxlu GPU üzərində reallaşdırmaqdır.
Məlumat z istiqamətində slab decomposition istifadə olunaraq bölünür. Hər GPU başlanğıcda qlobal massivdən yalnız öz slab hissəsini saxlayır.
İrəli FFT üç əsas mərhələdə yerinə yetirilir:
- Hər GPU öz lokal məlumat parçasında ilk iki ölçü boyunca fft2 icra edir.
- GPU-lar peer-to-peer rabitə ilə məlumat hissələrini yenidən paylayır.
- Yenidən düzülmüş məlumat üzərində üçüncü ölçü boyunca fft(...,3) icra olunur.
Bu prosesin sonunda qlobal Furye çevirməsi tamamlanmış olur, lakin bütün çevirmə tək GPU-da saxlanmır; hər GPU Furye fəzasındakı nəticənin bir hissəsini daşıyır.
P2P rabitəsi niyə tələb olunur?
Lokal fft2 əməliyyatları yalnız GPU-nun sahib olduğu slab üzərindəki iki oxu çevirə bilir. Üçüncü ox üzrə FFT üçün eyni çevirmə istiqamətinə aid məlumat elementləri uyğun GPU üzərində bir araya gətirilməlidir.
Buna görə lokal FFT-lərdən sonra məlumat GPU-lar arasında yenidən təşkil olunur. Mənbə MATLAB tətbiqində bu mərhələni spmd paralel sessiyası və spmdCat əsaslı məlumat birləşdirmə əməliyyatları ilə göstərir.
Tərs FFT-də sıra əksinə çevrilir: üçüncü ölçüdə ifft, P2P yenidən paylanma və ilk iki ölçüdə ifft2.
- 1. Slab decomposition mərhələsində 3B massiv z istiqamətində G GPU arasında bölünür və hər GPU yalnız öz lokal slab hissəsini saxlayır
- 2. Lokal 2B FFT qatında hər slabın ilk iki ölçüsü müstəqil şəkildə fft2 ilə çevrilir
- 3. P2P yenidən paylanma mərhələsində üçüncü ox üzrə FFT üçün məlumat parçaları GPU-lar arasında spmd və spmdCat düzəni ilə yenidən yerləşdirilir
- 4. Qalan 1B FFT mərhələsində üçüncü məkan ölçüsü fft(...,3) ilə Furye fəzasına çevrilir
- 5. Spektral zaman addımında PFC sahəsinin Furye əmsalları semi-implicit üsulla element-bazalı olaraq yenilənir
- 6. Tərs 1B FFT mərhələsində üçüncü ölçüdən fiziki fəzaya dönüş ifft(...,3) ilə başlanır
- 7. Tərs P2P paylanmasında məlumat yenidən lokal slab düzəninə gətirilir və spmdCat ilə uyğunlaşdırılır
- 8. Tərs 2B FFT qatında ilk iki ölçüdə ifft2 tətbiq edilərək fiziki sahə yenidən əldə olunur
fidelity : source-faithful
mənbə : Proses, mənbə tədqiqatın Şəkil 1(a) və Listing 1 MATLAB tətbiqinə əsaslanır.
Phase-Field Crystal modeli hansı fiziki problemi təmsil edir?
PFC modeli kristal sıxlıq düzəninin məkan və zaman üzrə inkişafını tək bir davamlı sıxlıq sahəsi \(\psi(\mathbf{x},t)\) vasitəsilə təmsil edir. Mənbə, nümunə olaraq üz mərkəzli kubik (face-centered cubic, FCC) simmetriya üçün sərbəst enerji funksionalını:
\[ F[\psi] = \int_{\Omega} \left[ \frac{\psi}{2} (\varepsilon+\mathcal L)\psi+ \frac{\psi^4}{4} \right]d\mathbf r \]
şəklində verir.
Burada:
\[ \mathcal L= (1+\nabla^2)^2 \left(\frac{4}{3}+\nabla^2\right)^2 \]
məkan korrelyasiyalarını təyin edən operatordur və \(\varepsilon\) undercooling parametridir.
Klassik PFC dinamikası:
\[ \partial_t\psi = \nabla^2 \frac{\delta F[\psi]}{\delta\psi} = (\varepsilon+\mathcal L)\nabla^2\psi+ \nabla^2\psi^3 \]
ilə ifadə olunur.
\(\mathcal L\) daxilində ardıcıl Laplas operatorlarının olması və xaricdə əlavə \(\nabla^2\) tətbiq edilməsi səbəbilə PFC tənliyi mənbədə onuncu dərəcəli PDE sinfində təsvir edilir.
MATLAB zaman addımını necə yeniləyir?
Listing 1-də Furye fəzasındakı sıxlıq sahəsi semi-implicit olaraq:
psiF = (psiF + dt*lap.*psi)./(1 - dt*lin);
şəklindəki element-bazalı yeniləmə ilə irələdilir.
Buradakı əsas hesablama zəncirində:
- psi fiziki sıxlıq sahəsini,
- psiF Furye çevrilmiş sıxlığı,
- lap diskret Laplas operatorunu,
- lin diskret xətti operatoru,
- dt zaman addımını
təmsil edir.
Mənbə listing-ləri tam proqram paketinin bütöv hissəsi deyil, metodun iş məntiqini göstərən implementation snippet-ləridir. Lazımi başlanğıc dəyişənlərinin və məlumat bölüşdürmə indekslərinin tam tərifləri məqalənin kod blokunda verilməmişdir; işə düşən tam tətbiq ayrıca mənbə kod deposunda təqdim olunur.
İlk benchmark hansı avadanlıqlarda aparıldı?
Buna görə hesabatlandırılan GPU/CPU sürətlənməsi yalnız kodun paralelləşdirilməsini deyil, bir-birindən fərqli hesablama arxitekturalarının performansını da ehtiva edir. Nəticələr eyni avadanlıq üzərində yalnız CPU/GPU rejiminin dəyişdirildiyi nəzarətli mikrobenchmark kimi şərh olunmamalıdır.
750³ problemində niyə daha çox GPU daha sürətli deyil?
Tədqiqatın Şəkil 1(a)-sı mühüm miqyaslana bilmə sərhədini göstərir: 750³ ölçülü problem üçün H100 üzərində ən yaxşı performans tək GPU ilə əldə edilir.
Problem tək GPU yaddaşına rahatlıqla sığdıqda əlavə GPU-lar hesablama yükünü paylaşsa da, P2P məlumat hərəkəti və sinxronizasiya xərci yaranır. Kiçik və ya ortaölçülü problemdə bu rabitə xərci paralelləşdirmə qazancından daha böyük ola bilər.
Beləliklə, tədqiqatın nəticəsi “GPU sayını artırdıqca FFT davamlı sürətlənir” deyil. Çoxlu GPU yanaşmasının dəyəri problem ölçüsü tək GPU sərhədini aşmağa başladıqda daha aydın görünür.
1400³ problemində nə baş verir?
Mənbəyə görə \(1400^3\) ölçülü massiv yalnız dörd H100 GPU istifadə edildikdə yaddaşa sığa bilmişdir.
Şəkil 1(a)-nın izahında bu konfiqurasiyanın icra müddəti 100 nüvəli CPU istinadının təxminən:
\[ 0.17 \]
qatı, yəni təxminən %17-si kimi verilir.
Bu nisbət təxminən altı dəfə sürətlənməyə uyğun gəlir və məqalənin standart PFC üçün hesabatlandırdığı “up to sixfold” nəticəsinin əsasını təşkil edir.
Lakin bu nəticəni bütün PFC ölçülərinə ümumiləşdirmək düzgün deyil. Şəklin də göstərdiyi kimi optimal GPU sayı problem böyüklüyünə və istifadə olunan GPU ailəsinə görə dəyişir.
İkinci strategiya niyə fərqlidir?
İkinci strategiya tək bir FFT-ni GPU-lara bölmək əvəzinə, multiphysics modelindəki müxtəlif fiziki sahələri ayrı GPU-lara paylayır.
Mənbə hidrodinamik PFC modelini nümunə götürür. Sıxlıq sahəsinə üçkomponentli mezoskopik sürət sahəsi əlavə olunur:
\[ \mathbf v= (v_1,v_2,v_3). \]
Model:
\[ \partial_t\psi = \nabla^2 \left( \frac{\delta F[\psi]}{\delta\psi} \right) - \mathbf v\cdot\nabla\psi \]
və:
\[ \rho\partial_t\mathbf v = \Gamma\nabla^2\mathbf v - \left\langle \psi\nabla \frac{\delta F[\psi]}{\delta\psi} \right\rangle \]
tənlikləri ilə müəyyən edilir.
Dörd GPU-ya hansı sahələr təyin olunur?
Tədqiqatın Şəkil 1(b)-si və Listing 2-si bu paylanmanı aydın şəkildə göstərir:
GPU 1 sıxlıq sahəsini yenilədikdən sonra yeni \(\psi\)-ni digər üç GPU-ya göndərir. GPU 2–4 öz sürət komponentlərini yeniləyir və nəticələri yenidən GPU 1-ə qaytarır.
MATLAB kodunda bu məlumat mübadiləsi spmdSend və spmdReceive ilə həyata keçirilir.
Gaussian convolution niyə Furye metoduna uyğundur?
Hidrodinamik PFC modelində lokal orta qiymət:
\[ \langle\cdot\rangle(\mathbf r) = \int_{\Omega} \frac{ (\cdot)(\mathbf r') }{ (2\pi a_0^2)^{3/2} } \exp \left[ -\frac{ (\mathbf r-\mathbf r')^2 }{ 2a_0^2 } \right] d\mathbf r' \]
şəklindəki Gaussian convolution ilə müəyyən edilir.
Furye çevirməsinin convolution xassəsi sayəsində bu inteqral Furye fəzasında vurmağa çevrilir. Beləliklə, PFC-nin yüksək dərəcəli diferensial operatorlarında olduğu kimi convolution əməliyyatı da pseudo-spektral metodun hesablama quruluşuna təbii şəkildə uyğunlaşır.
Multiphysics modelində 60 dəfə sürətlənmə nə deməkdir?
Mənbə dörd NVIDIA H100 GPU üzərində işlədilən hidrodinamik PFC həlledicisi üçün 100 nüvəli CPU tətbiqi ilə müqayisədə 60 dəfəyədək sürətlənmə bildirir.
Bu dəyər standart PFC-dəki təxminən altı dəfəlik sürətlənmə ilə birbaşa eyni paralelləşdirmə ssenarisi deyil. Standart PFC benchmark-ında tək böyük FFT slab decomposition ilə bir neçə GPU-ya yayılırkən, hidrodinamik PFC yanaşmasında dörd ayrı fiziki sahə dörd GPU-ya paylanır.
Beləliklə, 6× və 60× dəyərləri iki ayrı çoxlu-GPU strategiyasının fərqli problem strukturlarına tətbiqindən əldə edilmişdir.
Verianla Live: İki çoxlu-GPU strategiyasının müqayisəsi
Verianla Live: Məlumatlar tədqiqatın Şəkil 1, Şəkil 2 və metod izahlarına əsaslanır. Şəkil 1(b)-dəki 900³ benchmark sərhədi ilə Şəkil 2(b)-dəki 1400³ təmsili hidrodinamik PFC nümunəsi mənbədə ayrıca verildiyi üçün burada birləşdirilməmişdir.
Şəkil 1(a) performans baxımından nə deyir?
11-ci səhifədəki Şəkil 1(a)-nın yuxarı paneli üçölçülü massivin slab-lara bölünməsini, lokal fft2 hesablamalarını, P2P məlumat mübadiləsini və son fft mərhələsini göstərir.
Aşağı paneldə icra müddəti 100 CPU nüvəsindəki müddətə normallaşdırılmışdır. Ən vacib meyl budur:
- 750³ kimi kiçik problemdə tək GPU ən effektlidir.
- Problem böyüdükcə daha çox GPU yaddaşı tələb olunur.
- 1400³ massiv yalnız dörd H100 GPU ilə işlədilə bilmişdir.
- Bu böyük konfiqurasiya CPU icra müddətinin təxminən %17-sinə çatmışdır.
Beləliklə, şəkil həm sürətlənməni, həm də yaddaş miqyaslanması üstünlüyünü göstərir.
Şəkil 1(b) niyə daha böyük sürətlənmə göstərir?
Şəkil 1(b)-də sıxlıq sahəsi \(\psi\) GPU 1-ə, sürət komponentləri \(v_1\), \(v_2\) və \(v_3\) isə GPU 2–4-ə təyin edilmişdir. Beləliklə, bir-birindən ayrı böyük FFT iş yükləri eyni anda müxtəlif cihazlarda icra oluna bilir.
Mənbə qrafikində dörd H100 GPU-lu icra müddəti CPU istinadının təxminən bir neçə faiz səviyyəsindədir və ən yaxşı halda təxminən 60× sürətlənmə əldə edilmişdir.
Bu performans üstünlüyü tək FFT-nin bölünməsindən fərqlidir: müxtəlif sahələrin təbii olaraq bir-birindən ayrılması daha yüksək paralellik yarada bilir.
2B dendritik bərkimə nümunəsi nə qədər böyükdür?
12-ci səhifədəki Şəkil 2(a) triangular crystal symmetry altında dendritik bərkimə nümunəsini göstərir.
Hesablama sahəsi:
\[ 5\times10^4 \times 5\times10^4 \]
grid ölçüsündədir. Mənbə, alüminium üçün 4 Å qəfəs sabiti götürüldükdə bunun təxminən:
\[ 2.5\,\mu\text{m}\times2.5\,\mu\text{m} \]
fiziki sahəyə uyğun gəldiyini bildirir.
Şəkildə sıxlıq sahəsi \(\psi\) və böyüdülmüş bir sahə göstərilir. Vizualdakı ağ xətlər fiziki dənə sərhədləri deyil; mənbə bunların massiv tək qrafik kimi çəkilə bilməyəcək qədər böyük olduğundan istifadə olunan vizuallaşdırma hissələrinin sərhədlərini göstərdiyini açıq şəkildə qeyd edir.
3B polikristal nümunə nəyi göstərir?
Şəkil 2(b), FCC kristal quruluşunda hidrodinamik PFC ilə polikristal kobudlaşmanı göstərir.
Vizuallaşdırılan dəyişənlər:
- sıxlıq sahəsi \(\psi\),
- sürət komponenti \(v_1\),
- sürət komponenti \(v_2\),
- sürət komponenti \(v_3\)
olaraq verilir.
Şəklin izahında istifadə olunan grid:
\[ 1400\times1400\times1400 \]
və fiziki qutu ölçüsü təxminən:
\[ 40\,\text{nm}\times40\,\text{nm}\times40\,\text{nm} \]
olaraq göstərilir.
Bu dəyər Şəkil 1(b)-də zamanlanmış hidrodinamik benchmark-ın 900³ yuxarı sərhədindən daha böyükdür. Mənbə 1400³ vizuallaşdırmanın benchmark qrafikindəki eksperimentlə eyni şərtlərdə olub-olmadığını izah etmir; buna görə iki nəticə eyni benchmark nöqtəsi kimi qiymətləndirilməməlidir.
Tədqiqatın iddia etdiyi özgünlük nədir?
Müəlliflər ümumi paylanmış çoxlu-GPU FFT metodlarının yüksək məhsuldarlıqlı hesablamada daha əvvəl mövcud olduğunu qəbul edirlər. Tədqiqatın özgünlük iddiası bunlardan fərqlidir: mənbə MATLAB daxilində tətbiqdən asılı olmayan ümumi bir multi-GPU FFT infrastrukturunun mövcud olmadığını və təqdim edilən yanaşmanın MATLAB-dakı ilk multi-GPU FFT implementasiyasını təşkil etdiyini bildirir.
Bu, müəlliflərin ədəbiyyat və proqram ekosistemi qiymətləndirməsinə əsaslanan özgünlük iddiasıdır. Tədqiqat bütün xüsusi və ya nəşr olunmamış MATLAB kodlarını əhatə edən müstəqil proqram təminatı inventarı aparmır.
Daha çox GPU nə vaxt fayda verir?
Mənbə nəticələrinə görə çoxlu GPU xüsusilə iki vəziyyətdə mənalı olur:
- Tək bir FFT massivi tək GPU yaddaşına sığmadıqda.
- Multiphysics modelində bir neçə böyük fiziki sahə eyni anda yeniləndikdə.
Buna qarşılıq tək GPU-ya rahatlıqla sığan kiçik problemlərdə məlumat rabitəsi səbəbilə əlavə GPU istifadəsi daha yavaş ola bilər.
Beləliklə GPU sayı müstəqil performans parametri deyil; problem ölçüsü, GPU yaddaşı, P2P bant genişliyi, iş yükünün bölünə bilməsi və hesablama/rabitə nisbəti birlikdə qiymətləndirilməlidir.
Türkiyə baxımından bu nə ifadə edir?
Tədqiqat TU Dresden və NHR Center HPC infrastrukturu üzərində həyata keçirilmişdir; Türkiyədəki hər hansı HPC sistemi və ya tədqiqat mərkəzində benchmark aparılmamışdır.
Metod MATLAB əsaslı yüksək ayırdetməli material modelləşdirməsi, spektral PDE həlli və ya çoxsahəli fizika simulyasiyası aparan Türkiyədəki tədqiqat qrupları üçün metodoloji baxımdan uyğunlaşdırıla bilər. Lakin tədqiqatdakı 6× və ya 60× dəyərləri fərqli GPU modellərinə, PCIe/NVLink topologiyalarına, CPU quruluşlarına və ya MATLAB versiyalarına birbaşa köçürülməməlidir.
Yerli sistemdə real performansın müəyyən edilməsi üçün eyni problem ölçüləri ilə ayrıca strong-scaling, memory-scaling və GPU rabitə benchmark-ları aparılmalıdır.
Tədqiqatın dəstəklədiyi nəticələr
- MATLAB daxilində çoxlu GPU istifadə olunaraq iki və üçölçülü FFT əsaslı pseudo-spektral hesablamalar həyata keçirilə bilmişdir.
- Tək böyük 3B FFT slab decomposition və GPU–GPU məlumat rabitəsi istifadə olunaraq bir neçə GPU-ya paylana bilmişdir.
- 750³–1400³ PFC benchmark-larında təxminən altı dəfəyədək GPU/CPU sürətlənməsi hesabatlandırılmışdır.
- 1400³ standart PFC massivi mənbə avadanlığında yalnız dörd H100 GPU üzərində yaddaşa sığmışdır.
- 1400³ H100 nəticəsi CPU istinad vaxtının təxminən %17-si kimi bildirilmişdir.
- Kiçik 750³ problemində tək H100 GPU, daha çox H100 GPU istifadəsindən daha yaxşı performans göstərmişdir.
- Hydrodynamic PFC-də \(\psi,v_1,v_2,v_3\) sahələri dörd GPU-ya ayrıca paylana bilmişdir.
- Bu ikinci strategiyada 100 nüvəli CPU tətbiqinə görə 60 dəfəyədək sürətlənmə hesabatlandırılmışdır.
- Tədqiqat 2B dendritik bərkimə və 3B polikristal kobudlaşma nümunələri ilə metodun PFC simulyasiyalarına tətbiqini göstərmişdir.
- Mənbə kodu MIT lisenziyası ilə proqram deposunda paylaşılmışdır.
Tədqiqatın dəstəkləmədiyi və ya sınaqdan keçirmədiyi nəticələr
- Daha çox GPU-nun hər problemdə daha sürətli olduğu göstərilmir.
- 6× və 60× sürətlənmələr bütün GPU/CPU sistemləri üçün universal dəyərlər deyil.
- Tədqiqat bütün MATLAB FFT tətbiqlərinin eyni miqyaslana bilməyə çatacağını göstərmir.
- Tədqiqat H100 və A100-dən başqa GPU-larda detallı performans benchmark-ı təqdim etmir.
- GPU–GPU rabitə müddəti ayrıca komponent kimi kəmiyyətcə parçalanmamışdır.
- Strong-scaling və weak-scaling səmərəliliyi klassik HPC metrikləri ilə ayrıca cədvəllər şəklində hesabatlandırılmamışdır.
- GPU həlli ilə CPU həlli arasındakı ədədi xəta üçün ayrıca FFT doğruluq cədvəli təqdim edilməmişdir.
- Hesabatlandırılan benchmark nəticələri real eksperimental material mikroquruluşu ilə kəmiyyətcə doğrulama anlamına gəlmir; bunlar PFC ədədi simulyasiyalarıdır.
- Hydrodynamic PFC üçün Şəkil 2(b)-dəki 1400³ vizualın Şəkil 1(b)-dəki zamanlama benchmark-ının bir hissəsi olduğu mənbə tərəfindən açıq şəkildə bildirilməmişdir.
- Tədqiqat GPU sayını artırmağın xərc/enerji səmərəliliyini qiymətləndirmir.
- Müəlliflərin “MATLAB-dakı ilk multi-GPU FFT” ifadəsi müstəqil və tam qlobal proqram təminatı taramasının nəticəsi kimi doğrulanmamışdır.
Tədqiqatın Metodu və Nəticələri
İki paralelləşdirmə strategiyasının texniki xülasəsi
Standart PFC benchmark əhatəsi
Multiphysics benchmark əhatəsi
Niyə H100 ilə A100 nəticələri birbaşa GPU sayı ilə oxunmamalıdır?
H100 və A100 sistemləri yalnız GPU sayı baxımından fərqlənmir. Mənbədə H100 üçün hər GPU başına 94 GiB HBM2e, A100 üçün isə hər GPU başına 40 GiB HBM2 yaddaş istifadə olunur. Buna görə eyni problem üçün “dörd GPU” və ya “səkkiz GPU” ifadəsi təkbaşına ekvivalent hesablama resursunu müəyyən etmir.
Şəkil 1(a)-da müxtəlif GPU ailələri müxtəlif əyrilərlə göstərilmişdir. Nəticələr yalnız GPU sayına görə deyil, GPU arxitekturası, yaddaş tutumu və interconnect xüsusiyyətləri ilə birlikdə şərh edilməlidir.
Hesablama sahəsinin fiziki miqyası
Bu nümunələr PFC yanaşmasının əsas hesablama çətinliyini görünən edir: fiziki sahə mikrometr və ya onlarla nanometr səviyyəsində olsa belə, kristal qəfəsinin atomik miqyaslı quruluşunu həll etmək üçün milyardlarla grid nöqtəsi tələb oluna bilər.
Şəkil 2(a)-dakı dendritik naxış nəyi sübut edir?
Şəkil 2(a), multi-GPU single-FFT tətbiqinin böyük bir ikiölçülü PFC bərkimə problemində istifadə oluna bildiyini göstərir. Şəkil, metodların fiziki materialda ölçülmüş bir dendritin eksperimental təsviri deyil.
Beləliklə, bu vizualdan real alüminium dendrit morfologiyasının kəmiyyətcə doğrulandığı nəticəsi çıxarıla bilməz. Mənbə bu nümunəni çoxlu-GPU hesablamanın böyük PFC sahəsində tətbiqini göstərmək məqsədilə istifadə edir.
Şəkil 2(b)-də sürət sahələrinin göstərilməsinin mənası nədir?
Hidrodinamik PFC yalnız sıxlıq dəyişənini deyil, üçkomponentli sürət sahəsini də həll edir. Şəkil 2(b)-də \(\psi\) ilə yanaşı \(v_1\), \(v_2\) və \(v_3\)-ün ayrıca həcmli vizuallaşdırmalarının verilməsi ikinci GPU strategiyasındakı dörd fiziki sahə ayrımının birbaşa model dəyişənlərinə uyğun gəldiyini göstərir.
Başqa sözlə, dörd GPU istifadəsi yalnız texniki olaraq massivi dörd hissəyə bölmək deyil; hər GPU modelin müəyyən fiziki sahəsinin hesablama yükünü daşıyır.
Metodun gələcək miqyaslanma hədəfi nədir?
Müəlliflər ikinci strategiyanın principal Fourier modes üçün complex amplitude istifadə edən coarse-grained PFC modellərinə təbii şəkildə genişlənə biləcəyini bildirirlər. Bu tip modellər onlarca coupled complex-valued field ehtiva edə bilər.
Mənbə bu strukturların field-level GPU parallelization üçün xüsusilə uyğun olacağını gözləyir; lakin tədqiqatda onlarca kompleks sahə istifadə edən yeni benchmark təqdim olunmamışdır. Buna görə bu üstünlük gələcək istifadə gözləntisidir, mövcud sayısal nəticə deyil.
Performans nəticələrinin əsas şərhi
Tədqiqatın iki strategiyasından çıxan ümumi nəticə odur ki, çoxlu GPU istifadəsi yalnız daha çox hesablama vahidi əlavə etmək kimi qiymətləndirilməməlidir.
Tək FFT strategiyasında rabitə xərci səbəbilə kiçik problemlərdə tək GPU daha sürətli ola bilər; böyük problemlərdə isə çoxlu GPU ilk növbədə yaddaş sərhədini aşaraq simulyasiyanı mümkün edir.
Multiphysics strategiyasında müstəqil fiziki sahələrin təbii ayrımı müxtəlif GPU-ların eyni vaxtda işləməsinə daha çox imkan yaradır və mənbə benchmark-ında xeyli yüksək sürətlənməyə çatır.
Benchmark nəticələrini ümumiləşdirərkən hansı dəyişənlər vacibdir?
- GPU modeli və hər GPU üçün yaddaş tutumu,
- GPU-lar arasındakı rabitə topologiyası və bant genişliyi,
- Problem ölçüsü,
- FFT ölçüləri,
- Hər GPU üçün lokal hesablama/rabitə nisbəti,
- Fiziki sahələrin sayı,
- Zaman inteqrasiyası metodu,
- CPU istinad arxitekturası,
- MATLAB və paralel hesablama mühitinin tətbiq detalları.
Tədqiqat bu amillərin hamısı üçün ayrıca həssaslıq analizi təqdim etmir. Buna görə 6× və 60× dəyərləri hesabatlandırılan HPC konfiqurasiyalarının nəticələri kimi saxlanmalıdır.
Tədqiqatın güclü tərəfləri
- Yalnız FFT mikrobenchmark-ı deyil, real yüksək dərəcəli PDE istifadə ssenarisi təqdim olunmuşdur.
- Həm domain decomposition, həm də field decomposition yanaşması eyni MATLAB çərçivəsində göstərilmişdir.
- H100 və A100 əsaslı bir neçə GPU sistemi istifadə olunmuşdur.
- CPU istinadı açıq avadanlıq məlumatı ilə verilmişdir.
- Tək GPU yaddaşına sığmayan problem ölçüləri birbaşa sınaqdan keçirilmişdir.
- MATLAB implementation snippet-ləri paylaşılmışdır.
- Tam mənbə kod deposu və Zenodo qeydi verilmişdir.
- 2B və 3B PFC istifadə nümunələri vizual olaraq təqdim olunmuşdur.
Əsas məhdudiyyətlər
- Əsas nəticə metriyi icra müddətidir; ayrıca sayısal doğruluq benchmark-ı məhduddur.
- GPU–GPU rabitə xərci ayrıca zaman komponentlərinə ayrılmamışdır.
- Enerji sərfiyyatı və performans/vatt ölçülməmişdir.
- Müxtəlif GPU istehsalçıları və ya fərqli NVIDIA nəsilləri geniş şəkildə sınaqdan keçirilməmişdir.
- Benchmark tək bir PFC problem ailəsi ətrafında qurulmuşdur.
- Tədqiqat real eksperimental material mikroquruluşu ilə kəmiyyətli model validasiyası məqsədi daşımır.
- Mənbədə hydrodynamic PFC üçün 900³ benchmark sərhədi ilə 1400³ təmsili vizual arasında açıqlanmamış ölçü fərqi mövcuddur.
- Proqram listing-ləri metodu göstərir, lakin təkbaşına bütün başlanğıc və icra parametrlərini ehtiva edən müstəqil executable proqramlar deyildir.
Mənbə və Metod Qeydi
Tam özgün tədqiqat adı: Multi-GPU fast Fourier transforms in MATLAB for large-scale phase-field crystal simulations
Biblioqrafik başlıq qeydi: Yüklənmiş PDF başlığı yuxarıdakı mötərizəsiz formadadır. arXiv metadata qeydi isə başlığı “Multi-GPU fast Fourier transforms in MATLAB (for large-scale phase-field crystal simulations)” formasında, ikinci hissəni mötərizə daxilində göstərir. Özgün PDF başlığı səssizcə dəyişdirilməmişdir.
Müəlliflər və özgün sıralama: Maik Punke; Marco Salvalaglio.
Qurum: Institute of Scientific Computing, TU Dresden, 01062 Dresden, Germany.
İkinci qurum: Dresden Center for Computational Materials Science, TU Dresden, 01062 Dresden, Germany; mənbədə Marco Salvalaglio üçün ikinci afiliyasiya kimi göstərilir.
Məsul müəllif: Yüklənmiş PDF-də ayrıca “corresponding author” etiketi yoxdur. Hər iki müəllifin adında afiliyasiya işarələri mövcuddur, e-poçt/məsul-müəllif işarəsi açıq şəkildə göstərilmir.
Birgə birinci müəllif/bərabər töhfə: Yüklənmiş versiyada bərabər töhfə bəyanatı yoxdur.
Mənbə növü: MATLAB əsaslı yüksək məhsuldarlıqlı hesablama, elmi proqram təminatı və sayısal simulyasiya işi.
Nəşr statusu: Yüklənmiş tədqiqat arXiv-də yayımlanmış və ayrıca jurnal versiyasının rəydən keçdiyi təsdiqlənməmiş preprintdir. Nəticələr bu nəşr mərhələsi nəzərə alınaraq qiymətləndirilməlidir.
Platforma: arXiv.
arXiv kimliyi: 2603.26818v1 [cs.MS].
Əsas kateqoriya: Mathematical Software (cs.MS).
Əlavə kateqoriyalar: Materials Science (cond-mat.mtrl-sci) və Computational Physics (physics.comp-ph).
arXiv ilk göndəriş tarixi: 26 mart 2026.
PDF üzərində yazılan tarix: 31 mart 2026.
arXiv DOI: 10.48550/arXiv.2603.26818.
Elmi metod: Furye pseudo-spektral həll; çoxlu GPU domain decomposition; slab decomposition; peer-to-peer məlumatın yenidən paylanması; field-level multiphysics parallelization; semi-implicit və mənbə kod listing-lərində göstərilən implicit zaman yeniləmələri.
Əsas tətbiq: İki və üçölçülü phase-field crystal simulyasiyaları.
Benchmark GPU-ları: 4 × NVIDIA H100 SXM5 (94 GiB HBM2e/GPU) və 8 × NVIDIA A100 SXM4 (40 GiB HBM2/GPU).
CPU istinadı: Intel Xeon Platinum 8470, ümumilikdə 100 nüvə, 2,00 GHz.
HPC infrastrukturu: TU Dresden NHR Center tərkibindəki Capella, Alpha Centauri və Barnard sistemləri.
Mənbə kod deposu: https://github.com/mpunke/MATLABmultiGPUFFT/
Proqram təminatı lisenziyası: MIT License.
Zenodo DOI: 10.5281/zenodo.18670913.
Əsas benchmark nəticəsi: Standart PFC üçün CPU istinadına görə təxminən 6×-ədək, hidrodinamik multiphysics PFC üçün isə təxminən 60×-ədək sürətlənmə bildirilmişdir.
Benchmark şərhi: Bu dəyərlər eyni problem üzərində eyni emal resurslarını müqayisə edən saf alqoritmik scaling əmsalları deyil. GPU və CPU tərəfləri fərqli arxitekturalara və yaddaş sistemlərinə malikdir.
Mənbədaxili ifadə qeydi — CPU nüvəsi: Tədqiqatın Summary bölməsi CPU tətbiqini “hundreds of cores” ifadəsi ilə təsvir etdiyi halda, detallı benchmark izahı və Şəkil 1 açıq şəkildə 100 CPU nüvəsini istinad götürür. Sayısal müqayisələrdə detallı benchmark-dakı 100 nüvə məlumatı istifadə edilmişdir.
Mənbədaxili əhatə qeydi — hydrodynamic PFC ölçüsü: Şəkil 1(b)-nin izahında benchmark-ın çoxlu GPU ilə 900³ problem ölçüsünə qədər çatdığı bildirilir. Şəkil 2(b) isə hydrodynamic PFC üçün 1400³ grid istifadə edən ayrıca polikristal kobudlaşma nümunəsi göstərir. Mənbə bu iki vəziyyətin benchmark şərtləri baxımından eyni olub-olmadığını aydınlaşdırmır.
Kod listing sərhədi: Listing 1 və Listing 2 alqoritmin əsas paralel məlumat axınını göstərir; başlanğıc massivlərinin, ayrıştırma indekslərinin və bütün köməkçi dəyişənlərin tam təriflərini ehtiva edən müstəqil tam proqramlar deyildir. İşlədilə bilən tətbiq üçün əlavə olaraq mənbə deposuna müraciət edilməlidir.
Özgünlük iddiasının sərhədi: Müəlliflər tədqiqatı MATLAB-dakı ilk multi-GPU FFT implementasiyası kimi təsvir edirlər. Bu ifadə mənbə müəlliflərinin mövcud ədəbiyyat/proqram qiymətləndirməsinə əsaslanır və müstəqil, genişmiqyaslı qlobal proqram inventarı kimi doğrulanmamışdır.
Maliyyələşdirmə: Tədqiqat Deutsche Forschungsgemeinschaft (DFG) tərəfindən 447241406 və 493401063 layihə nömrələri ilə dəstəklənmişdir.
Hesablama resursu: Müəlliflər TU Dresden NHR Center yüksək məhsuldarlıqlı hesablama sistemlərindən istifadəyə təşəkkür bölməsində ayrıca yer verirlər.
Maraqlar toqquşması: Yüklənmiş mətndə ayrıca competing-interest və ya conflict-of-interest bəyanatı yoxdur; buradan maraqlar toqquşmasının olmadığı nəticəsi çıxarılmamışdır.
CRediT/müəllif töhfələri: Yüklənmiş versiyada ayrıca CRediT authorship contribution statement yoxdur.
Elmi doğrulama sərhədi: Tədqiqatın əsas doğrulaması hesablama performansı və böyük problem ölçülərinin işlədilə bilməsidir. Real material təcrübələri ilə mikroquruluş validasiyası, FFT sayısal xəta benchmark-ı, enerji səmərəliliyi və ya geniş strong/weak scaling analizi tədqiqatın əsas qiymətləndirmə mövzusu deyil.
Elmi məzmun sərhədi: Bu Verianla məqaləsindəki PFC tənlikləri, FFT alqoritmləri, çoxlu-GPU strategiyaları, avadanlıq məlumatları, benchmark nəticələri və Şəkil 1–2 şərhləri yüklənmiş tədqiqata əsaslanır. Xarici biblioqrafik yoxlama yalnız arXiv kimliyi, DOI, cari nəşr statusu və proqram paylama kanalları ilə məhdud saxlanılmışdır.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib