

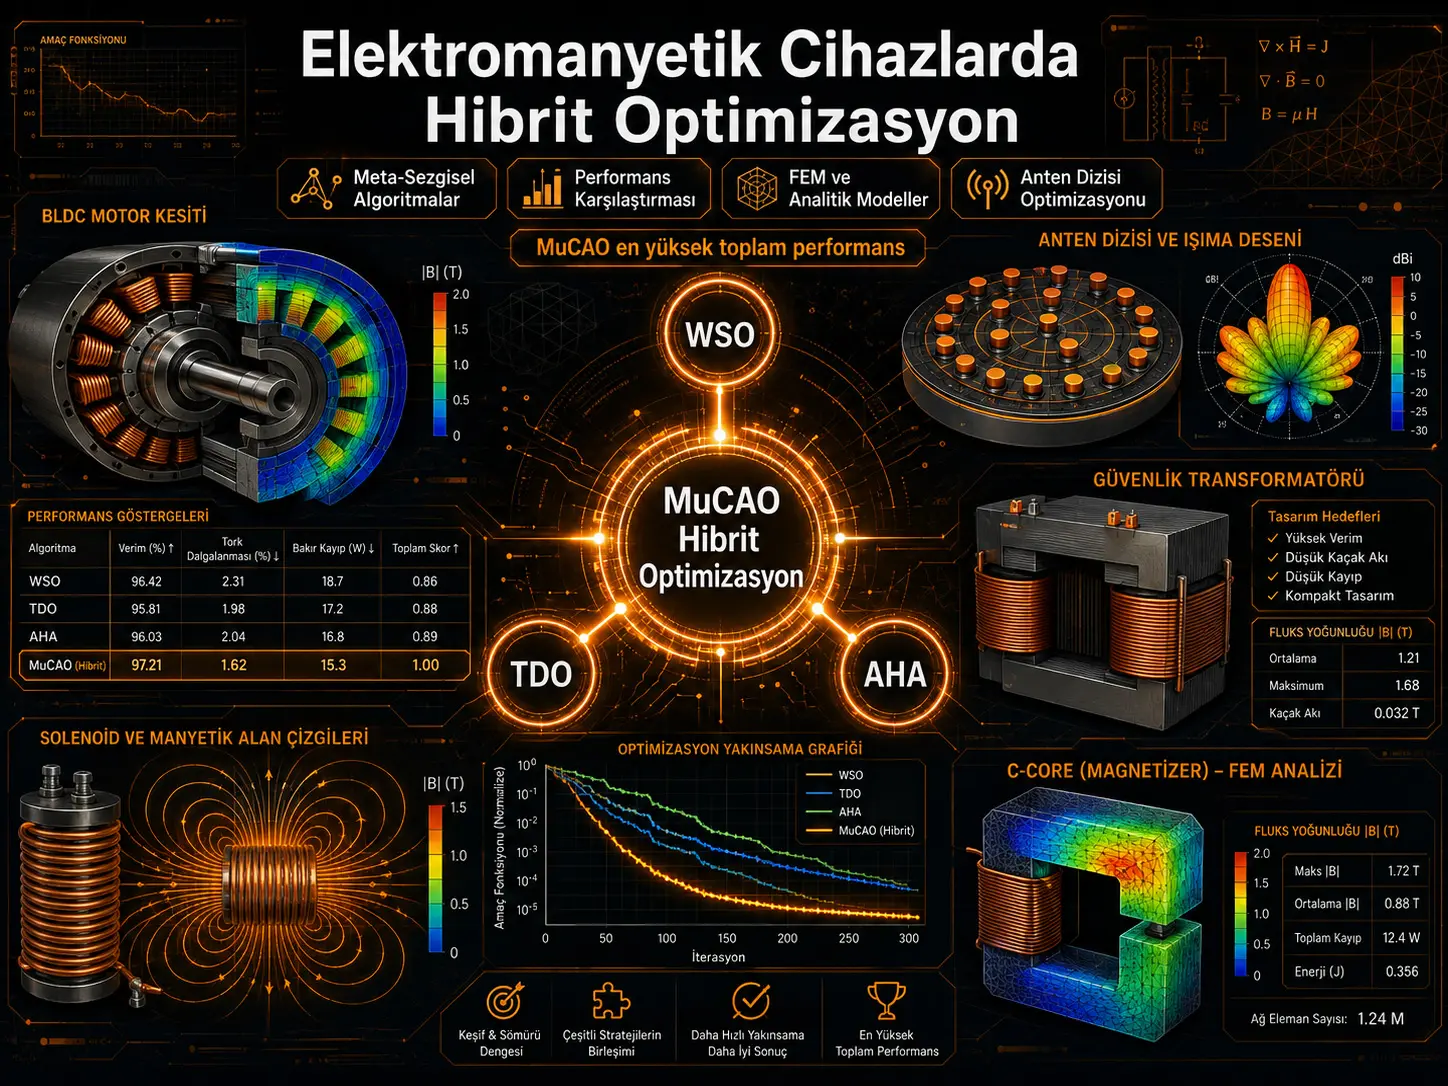
Utafiti unalinganisha algoriti kumi za kisasa za metaheuristic na algoriti saba za marejeo zilizozoeleka katika usanifu bora wa vifaa vya sumakuumeme, na unapendekeza mfumo mpya wa uboreshaji mseto unaoitwa Multiple Combined Algorithms for Optimization (MuCAO) ili kutumia kwa njia inayobadilika sifa zinazokamilishana za mbinu zenye nguvu zaidi. Kwa jumla, mbinu 18 zikiwemo MuCAO zilitathminiwa katika benchmark sita za sumakuumeme zinazotumia miundo ya uchanganuzi na Finite Element Method (FEM). Katika ulinganisho mkuu, MuCAO ilishika nafasi ya kwanza kwa alama ya jumla ya utendaji 50.534,5; WSO ikafuata kwa 48.408,5, TDO kwa 48.075,5 na AHA kwa 43.353,5. Mbinu bora zaidi ya marejeo ya kawaida, Differential Evolution (DE), ilikuwa ya tano kwa alama 41.166. Ingawa MuCAO haikuwa ya kwanza katika benchmark yoyote moja, ilibaki kati ya nafasi ya 2 na 6 katika matatizo yote sita na hivyo kuonyesha tofauti ndogo zaidi ya nafasi katika utafiti.
Jambo muhimu la utafiti ni kwamba hauangalii tu swali la “ni algoriti ipi iko nafasi ya kwanza?”. Watafiti walichunguza ubora wa suluhisho pamoja na upangaji wa kitakwimu, usambazaji wa utendaji katika majaribio 25 huru, muda wa kompyuta, mwenendo wa muunganiko, uzito wa uchaguzi wa MuCAO na athari ya idadi ya algoriti katika mfumo mseto. MuCAO pia ilijaribiwa katika tatizo la kupunguza kiwango cha side-lobe katika circular antenna array yenye vipengele 12 na vigezo 24 vya usanifu, na ikashika nafasi ya kwanza pia katika ulinganisho huu wa ziada kwa alama ya jumla 9516.
Hoja ya msingi ya MuCAO inategemea dhana kwamba mbinu moja ya metaheuristic haiwezi kuwa bora katika matatizo yote ya uboreshaji. Muundo mkuu hutumia WSO, TDO na AHA ndani ya kundi la algoriti wagombea. Mwanzoni uwezekano wa kuchaguliwa kwa mbinu ni sawa; kadiri majaribio huru ya uboreshaji yanavyoendelea, utendaji wa wastani wa kihistoria wa kila algoriti na utendaji wake bora zaidi hadi wakati huo huhesabiwa. Vipimo hivi viwili vinaunganishwa kwa uzito sawa na uwezekano wa kuchagua algoriti katika jaribio linalofuata unasasishwa.
Upeo wa matokeo ni muhimu. Utafiti unafanya tathmini ya kihesabu katika benchmark sita zinazojulikana za usanifu wa sumakuumeme na mfano mmoja wa uboreshaji wa antenna array. Matatizo ya C-Core na Magnetizer yanayotegemea FEM si majaribio ya prototipu halisi. Vivyo hivyo, matumizi ya circular antenna array yametathminiwa kupitia mfano wa kihisabati wa array-factor. Kwa hiyo utafiti hauonyeshi kwa majaribio kwamba MuCAO itatoa usanifu bora katika vifaa halisi vya sumakuumeme vilivyotengenezwa katika kila hali.
Tathmini kwa mtazamo wa Uturuki: Mbinu ya utafiti inaweza kuwa na thamani ya kimetodolojia kwa timu za uhandisi nchini Uturuki zinazofanya kazi katika mashine za umeme, mizunguko ya sumaku, transfoma, aktueta, antenna arrays na usanifu wa sumakuumeme unaosaidiwa na FEM. Hasa katika matatizo ambayo uchanganuzi wa FEM wenye gharama kubwa unaingia kwenye mzunguko wa uboreshaji, ni muhimu kuangalia si suluhisho moja bora pekee bali pia uthabiti wa algoriti na gharama ya kompyuta kwa pamoja. Hata hivyo, matokeo ya benchmark katika utafiti yanahusiana na ufafanuzi maalum wa matatizo na mipangilio ya algoriti; haiwezi kuhitimishwa kwamba nafasi hiyo hiyo itahamishwa moja kwa moja hadi jiometria tofauti za motor, antena au vifaa vya sumakuumeme.
Tatizo kuu la utafiti ni nini?
Usanifu wa vifaa vya sumakuumeme mara nyingi hugeuka kuwa matatizo ya uboreshaji yasiyo ya mstari, yenye vikwazo na vigezo vingi, na katika baadhi ya hali kila mgombea wa usanifu huhitaji kutatuliwa kwa FEM, jambo linalofanya hesabu kuwa ghali. Kubadilisha kwa pamoja vigezo kama jiometria ya motor, vipimo vya koili, umbo la ncha ya sumaku au msongamano wa mkondo kunaweza kuunda nafasi kubwa sana ya utafutaji.
Algoriti za metaheuristic zinaweza kutafuta suluhisho katika nafasi hizi tata bila kuhitaji taarifa ya derivative. Hata hivyo, kwa kuwa algoriti tofauti huweka mizani tofauti kati ya exploration na exploitation, kuwa na nguvu kwa mbinu katika tatizo moja hakumaanishi itatoa matokeo hayo hayo katika tatizo jingine.
Watafiti wanaeleza kuwa ingawa algoriti nyingi zimetumika kwa vifaa vya sumakuumeme katika fasihi, tafiti zinazolinganisha mbinu mpya za metaheuristic katika hali sawa za majaribio kwenye seti pana ya benchmark bado ni chache.
Algoriti ngapi zililinganishwa?
Utafiti unatenganisha makundi matatu ya algoriti.
Mbinu kumi za kisasa za metaheuristic:
- Ali Baba and the Forty Thieves Optimization (AFT),
- Golden Eagle Optimizer (GEO),
- Hunger Games Search (HGS),
- Rat Swarm Optimizer (RSO),
- Tiki-Taka Algorithm (TTA),
- Pelican Optimization Algorithm (POA),
- Tasmanian Devil Optimization (TDO),
- White Shark Optimizer (WSO),
- Zebra Optimization Algorithm (ZOA),
- Artificial Hummingbird Algorithm (AHA).
Mbinu saba za marejeo za metaheuristic:
- Biogeography-Based Optimization (BBO),
- Differential Evolution (DE),
- Grey Wolf Optimizer (GWO),
- Particle Swarm Optimization (PSO),
- Salp Swarm Algorithm (SSA),
- Teaching–Learning-Based Optimization (TLBO),
- Most Valuable Player Algorithm (MVPA).
MuCAO iliyotengenezwa na watafiti inapoongezwa kwenye hizi, ulinganisho mkuu wa utendaji unakuwa na mbinu 18 kwa jumla.
MuCAO ni nini?
MuCAO ni mfumo unaobadilika wa algoriti nyingi unaochagua kwa uwezekano kati ya algoriti kadhaa za uboreshaji kulingana na utendaji wao wa zamani. Msukumo wa mbinu unatokana na mtazamo wa No Free Lunch: haitarajiwi algoriti moja ya uboreshaji kuwa bora daima katika madarasa yote ya matatizo.
Seti ya algoriti wagombea:
\[ A=\{A_1,A_2,\ldots,A_N\} \]
inafafanuliwa kwa namna hii. Mwanzoni algoriti zote zina uwezekano sawa wa kuchaguliwa:
\[ p_i^{(0)}=\frac{1}{N} \]
Kwa kila algoriti, vipimo viwili vya utendaji wa kihistoria huhifadhiwa:
- thamani ya wastani ya objective function katika majaribio yaliyofanywa hadi wakati huo \(\bar{f}_i\),
- thamani bora zaidi ya objective function iliyopatikana hadi wakati huo \(f_i^{best}\).
Alama ya uchaguzi wa algoriti huhesabiwaje?
Kwa tatizo la minimization, utafiti unafafanua alama ya utendaji wa wastani kama:
\[ S_i^{avg}= \max_j(\bar{f}_j)-\bar{f}_i+\delta \]
na alama ya utendaji bora zaidi kama:
\[ S_i^{best}= \max_j(f_j^{best})-f_i^{best}+\delta \]
Hapa \(\delta\) ni thamani ndogo chanya inayotumika kuzuia algoriti yoyote kufikia uwezekano wa kuchaguliwa wa sifuri.
Vipengele viwili:
\[ S_i=w_1S_i^{avg}+w_2S_i^{best} \]
vinaunganishwa.
Katika majaribio makuu:
\[ w_1=w_2=0.5 \]
ilitumika. Uwezekano wa mwisho wa uchaguzi unasasishwa kama:
\[ p_i= \frac{S_i} {\sum_{j=1}^{N}S_j} \]
Ikiwa jumla ya alama ni sifuri, algoriti zote zinarudishwa tena kwenye uwezekano sawa.
Je, MuCAO huchanganya algoriti ndani ya jaribio moja la uboreshaji?
Hapana; kulingana na Algorithm 1, uchaguzi mkuu unafanyika katika kiwango cha jaribio huru. Mwanzoni mwa kila jaribio, algoriti moja kati ya wagombea huchaguliwa kulingana na usambazaji wa sasa wa uwezekano na algoriti hiyo ndiyo inayotekeleza jaribio lote. Matokeo huongezwa baadaye kwenye historia ya utendaji wa algoriti husika na uwezekano wa uchaguzi wa baadaye unasasishwa.
Kwa hiyo si sahihi kufasiri MuCAO kama search operator moja mpya inayochanganya moja kwa moja equations za mwendo za WSO, TDO na AHA ndani ya population moja katika kila iteration. Ubunifu upo katika mekanizimu ya adaptive selection inayotegemea utendaji kati ya algoriti tofauti.
Ni benchmark zipi sita za sumakuumeme zilizotumika?
| Benchmark | Modeli | Idadi ya vigezo iliyotolewa katika utafiti | Lengo la uboreshaji |
|---|---|---|---|
| Loney solenoid | Analytical | 2 | Msongamano wa magnetic flux ulio sawa katika eneo la udhibiti |
| BLDC wheel motor | Analytical | 5 | Kuongeza ufanisi wa motor |
| TEAM22 | Analytical | 8 | Kupunguza weighted sum ya tofauti ya nishati na stray field |
| Safety Transformer | Analytical / multiphysics | 9 | Kupunguza jumla ya uzito wa chuma na shaba |
| C-Core | FEM | Jedwali 1: 7; Sehemu 3.5: 6 | Usambazaji ulio sawa wa magnetic field katika air gap |
| Magnetizer | FEM | 4 | Usambazaji ulio sawa wa magnetic flux katika mstari AB |
Idadi iliyo kwenye mstari wa C-Core inaonyesha kutokulingana muhimu ndani ya chanzo. Jedwali 1 linasema vigezo saba, ilhali ufafanuzi wa kina wa kihisabati wa C-Core una vigezo sita \(x_1\)–\(x_6\).
Ni nini kinachoboreshwa katika tatizo la BLDC motor?
Benchmark ya BLDC inategemea modeli ya in-wheel motor iliyotengenezwa kwa gari la mashindano ya nishati ya jua. Vigezo vitano vya uamuzi ni tooth magnetic induction \(B_d\), air-gap induction \(B_e\), stator back-iron induction \(B_{cs}\), current density ya conductor \(\delta\), na inner diameter ya stator \(D_s\).
Lengo ni kuongeza ufanisi. Kwa kuwa algoriti zinafanya kazi katika mfumo wa minimization:
\[ OF=-\eta \]
ilitumika.
Tatizo pia lina inequality constraints sita, ikiwemo uzito wa active components, maximum current, outer/inner diameter na joto la sumaku.
Loney solenoid inapima nini?
Tatizo la Loney ni benchmark ya vigezo viwili inayolenga kutengeneza magnetic flux density iliyo sawa iwezekanavyo katika eneo la kati kwa kurekebisha jiometria ya coil kuu na coil mbili za marekebisho zilizo na ulinganifu.
Objective function:
\[ OF= \frac{B_{max}-B_{min}}{B_0} \]
imefafanuliwa kwa namna hii. \(B_{max}\) na \(B_{min}\) zinawakilisha magnetic flux density ya juu na ya chini katika eneo la udhibiti, huku \(B_0\) ikiwa thamani ya katikati. Thamani ndogo ina maana ya field iliyo sawa zaidi.
Kwa nini TEAM22 ni tata zaidi?
TEAM22 ni tatizo la usanifu wa Superconducting Magnetic Energy Storage (SMES). Vigezo vinane vya continuous design vinatumika na malengo mawili yanaunganishwa ndani ya function moja: kuleta stored energy karibu na thamani ya marejeo ya 180 MJ na kupunguza stray magnetic field.
Objective function:
\[ OF= \frac{B_{stray}^{2}}{B_{norm}^{2}} + w\frac{|E-E_{ref}|}{E_{ref}} \]
iko katika namna hii. Katika utafiti \(B_{norm}=200\,\mu T\), \(E_{ref}=180\) MJ na \(w=100\) zilitumika.
Tatizo pia lina geometric constraint inayozuia solenoids mbili kuingiliana na physical constraint inayozuia superconductor kuvuka quench limit.
Kwa nini Safety Transformer ni tatizo la multiphysics?
Katika benchmark ya Safety Transformer, thermal, electrical na magnetic behavior zimeunganishwa. Lengo ni kupunguza jumla ya uzito wa active iron na copper materials.
Constraints kama temperature, voltage drop, current ratio, winding fill factors na efficiency zinatumika kwa pamoja. Individual Discipline Feasible (IDF) formulation ilitumika kupunguza gharama ya hesabu.
Ingawa Jedwali 4 la chanzo linaorodhesha vigezo saba vya kimwili vya usanifu, tatizo linafafanuliwa kuwa na vigezo tisa vya uboreshaji kwa jumla; vingine viwili ni auxiliary IDF variables \(T_{cond,IDF}\) na \(\Delta V_{2,IDF}\).
Tatizo la C-Core linalotegemea FEM linafanya nini?
Katika benchmark ya C-Core, umbo la pole face ya sumaku linaboreshwa ili magnetic flux density katika eneo la mstatili ndani ya air gap iwe sawa kadiri iwezekanavyo.
Magnetic flux density huhesabiwa kwa FEM katika assessment points 35. Objective function:
\[ OF= -\sum_{i=1}^{35} \frac{|B_0-B_i|}{B_0} \]
imetolewa kwa namna hii.
Maandishi ya chanzo yanafafanua control points sita \(x_1,x_2,\ldots,x_6\) kwa pole profile na kutoa constraint:
\[ 18\leq x_j\leq30,\qquad j=1,\ldots,6 \]
Ufafanuzi huu wa kina haulingani na kauli ya “vigezo 7” katika Jedwali 1 la muhtasari.
Ni nini kinachoboreshwa katika tatizo la Magnetizer?
Benchmark ya Magnetizer ni tatizo la 2D linear magnetostatic FEM. Pole face huundwa na uniform non-rational cubic B-spline curve inayofafanuliwa na radial control points nne.
Lengo ni kupunguza tofauti ya magnetic field kando ya chord AB:
\[ OF= \frac{\sigma_B}{\bar{B}} \]
Hapa \(\sigma_B\) ni standard deviation ya magnetic flux density kando ya AB, na \(\bar{B}\) ni wastani wake. Field ilitathminiwa kwenye points 50 zilizo na nafasi sawa kati ya 35°–89°.
Algoriti zililinganishwaje kwa haki?
Katika majaribio makuu, kwa algoriti zote:
- population size = 50,
- maximum iteration = 1000,
- maximum function evaluations = 20.000
ziliwekwa. Kigezo cha kusitisha kilitegemea maximum number of function evaluations.
Initial populations zilitengenezwa kwa nasibu ndani ya lower na upper bounds za problem variables kwa mbinu zote.
Ikiwa original method ya algoriti ilikuwa na special constraint-handling mechanism, mekanizimu hiyo ilihifadhiwa; vinginevyo penalty-based method ilitumika.
Randomness inayoweza kurudiwa ilihakikishwaje?
Katika parallel computations, pseudo-random number generator ya MATLAB mrg32k3a ilitumika. Kila independent run ilipewa substream tofauti lakini deterministic ili random sequences za runs sambamba zisigongane na matokeo yawe reproducible.
Performance score ilihesabiwaje?
Utafiti ulitumia rank-sum metric inayotegemea ranking approach ya mashindano ya CEC. Independent runs zote za algoriti zote katika benchmark moja hupangwa kwa pamoja. Thamani ndogo za objective function huchukuliwa kuwa bora.
Score ya algorithm \(a\) kwenye benchmark \(f\):
\[ S_{a,f}= \sum_{i=1}^{N} rank_{i,a,f} - \frac{N(N+1)}{2} \]
iko katika namna hii.
Independent runs 25 zilitumika kwa kila algoriti. Total score ya juu inawakilisha utendaji wenye nguvu zaidi.
Kwa nini score hii si “suluhisho bora zaidi la run moja” pekee?
Mfumo huu hauangalii run bora zaidi ya algoriti pekee. Unapima ranking ya pamoja ya runs 25 huru za algoriti ikilinganishwa na runs za algoriti nyingine. Kwa hiyo mbinu inayotoa matokeo mazuri kwa uthabiti inaweza kupata score ya juu kuliko mbinu inayopata matokeo mazuri sana mara chache lakini mara nyingi huwa dhaifu zaidi.
Tofauti hii inaonekana wazi katika matumizi ya circular antenna array: ingawa best objective value ya run moja ya AFT ilikuwa chini kuliko ya MuCAO, MuCAO ilikuwa ya kwanza kwa overall ranking score.
Ni mbinu zipi zilijitokeza katika ranking kuu?
| Nafasi ya jumla | Algoriti | Alama ya jumla | Range ya nafasi katika benchmark sita |
|---|---|---|---|
| 1 | MuCAO | 50.534,5 | 2–6 |
| 2 | WSO | 48.408,5 | 1–9 |
| 3 | TDO | 48.075,5 | 1–9 |
| 4 | AHA | 43.353,5 | 3–10 |
| 5 | DE | 41.166 | 2–14 |
MuCAO haikuwa ya kwanza katika benchmark yoyote; hata hivyo matokeo yake mabaya zaidi yalikuwa nafasi ya sita. WSO ilikuwa ya kwanza katika benchmark tatu, TDO katika mbili na TTA katika moja. Kwa hiyo hoja kuu ya utafiti ni kwamba MuCAO hutoa utendaji wenye uwiano katika aina tofauti za matatizo kuliko kufikia peak performance ya juu katika tatizo moja pekee.
Verianla Live: Utendaji wa jumla wa uboreshaji
Ulinganisho unatumia total scores za Jedwali 8 kuu la utafiti. Katika rank-sum metric hii, score ya juu inaonyesha overall performance yenye nguvu zaidi.
| Algoriti | Alama ya jumla ya utendaji | Nafasi ya jumla | Chanzo |
|---|---|---|---|
| MuCAO | 50534,5 | 1 | Jedwali 8 |
| WSO | 48408,5 | 2 | Jedwali 8 |
| TDO | 48075,5 | 3 | Jedwali 8 |
| AHA | 43353,5 | 4 | Jedwali 8 |
| DE | 41166 | 5 | Jedwali 8 |
Algoriti za marejeo zilikuwa na ushindani kiasi gani?
Kati ya mbinu za marejeo, matokeo yenye nguvu zaidi yalitoka kwa DE na DE ikawa ya tano. Kulingana na Jedwali 8, kati ya mbinu nyingine za marejeo MVPA ilikuwa ya nane, GWO ya kumi na mbili, PSO ya kumi na tatu, BBO ya kumi na nne, SSA ya kumi na sita na TLBO ya kumi na nane.
Ingawa mjadala wa matokeo katika maandishi ya chanzo unasema MVPA ilikuwa ya saba, Jedwali 8 kuu linaonyesha TTA ya saba na MVPA ya nane. Ranking ya jedwali imehifadhiwa hapa.
Je, kuwa mpya kulifanya algoriti iwe bora moja kwa moja?
Hapana. Utafiti unaonyesha hasa kwamba baadhi ya mbinu mpya zinaweza kufanya vibaya katika matatizo ya usanifu wa sumakuumeme. GEO ilikuwa ya 15 na RSO ya 17 katika ranking ya jumla. TLBO ilikuwa ya mwisho katika benchmark zote.
Matokeo haya yanaunga mkono kwamba mafanikio ya mbinu mpya ya metaheuristic kwenye general mathematical test functions hayamaanishi moja kwa moja ubora katika usanifu wa vifaa vya sumakuumeme.
Je, tofauti kati ya MuCAO na washindani wenye nguvu ilikuwa statistically significant katika kila benchmark?
Hapana. Watafiti walilinganisha MuCAO kando na WSO, TDO, AHA na DE kwa pairwise Wilcoxon rank-sum tests.
- Tofauti ya MuCAO–WSO ni significant katika Benchmark 1 na 2 pekee kwa kiwango cha 5%.
- Tofauti ya MuCAO–TDO ni significant katika Benchmark 1, 3, 4 na 5.
- Tofauti ya MuCAO–AHA ni significant katika Benchmark 1, 2 na 5.
- Tofauti ya MuCAO–DE ni significant katika Benchmark 1, 2, 3 na 6.
Kwa hiyo overall score superiority ya MuCAO haimaanishi statistical superiority dhidi ya kila mpinzani katika kila benchmark moja.
Violin plots zinaonyesha nini?
Figure 10 ya utafiti inaonyesha objective-function distributions za algoriti nne zenye nguvu zaidi, MuCAO, WSO, TDO na AHA, katika independent runs 25. Baadhi ya violin distributions kuwa nyembamba karibu kama mstari wima kunaonyesha run-to-run variability ni ndogo sana.
Hasa distribution ya WSO katika tatizo la BLDC na ya TDO katika tatizo la C-Core ni nyembamba sana. Algoriti zote mbili zilikuwa za kwanza katika benchmark husika. Hii inaonyesha si matokeo mazuri pekee bali pia repeatability ya juu katika matatizo hayo.
Mwenendo wa convergence wa MuCAO ulikuwaje?
Figure 11 inaonyesha normalized best-so-far convergence curves za MuCAO katika benchmark sita. Mstari mnene unaonyesha median ya independent runs na eneo lenye kivuli linaonyesha interquartile range.
Katika matatizo ya Safety Transformer na Magnetizer objective value hushuka haraka katika iterations za mwanzo. C-Core inaonyesha mchakato mrefu zaidi wa improvement. Katika matatizo yote, eneo lenye kivuli kuwa jembamba kadiri search inavyoendelea linaonyesha run-to-run variability inapungua.
Matatizo ya FEM yaliongeza computational cost kiasi gani?
Utafiti ulipata tofauti kubwa kati ya muda wa matatizo ya analytical na FEM-based. Thamani za Jedwali 9 ni jumla ya muda wa runs 25 kwa kila algoriti.
Kwa MuCAO:
| Benchmark | Aina ya modeli | Jumla ya muda wa runs 25 |
|---|---|---|
| Loney | Analytical | 1,83 s |
| BLDC | Analytical | 3,75 s |
| Safety Transformer | Analytical | 7,18 s |
| TEAM22 | Analytical | 00:42:06 |
| C-Core | FEM | 03:12:34 |
| Magnetizer | FEM | 01:12:27 |
Katika algoriti zote, wastani wa muda wa C-Core optimization uliripotiwa kuwa takribani saa 4 dakika 6 sekunde 39, huku Magnetizer ikiwa takribani saa 1 dakika 18 sekunde 22. Tofauti hii inaonyesha kwamba katika matatizo yanayohitaji FEM solution kwa objective function, gharama ya model evaluation inaweza kuwa muhimu bila kujali optimization algorithm yenyewe.
Kwa nini uzito wa vipimo viwili vya utendaji ni muhimu katika MuCAO?
Katika main MuCAO configuration:
\[ w_1=w_2=0.5 \]
ilitumika. Watafiti walijaribu variants nyingine tatu kuona kama hili lilikuwa chaguo la bahati nasibu:
| Variant | Uzito wa average performance \(w_1\) | Uzito wa best performance \(w_2\) | Nafasi ya jumla ndani ya Jedwali 17 |
|---|---|---|---|
| Main MuCAO | 0,50 | 0,50 | 1 |
| MuCAO1 | 0,25 | 0,75 | 3 |
| MuCAO2 | 0,75 | 0,25 | 4 |
| MuCAO3 | 1,00 | 0,00 | 5 |
Katika ulinganisho huu, muundo wa uzito sawa ulipata ranking ya juu zaidi. Watafiti wanahitimisha kwamba average historical performance na best historical performance hutoa taarifa zinazokamilishana.
Kwa nini score ya MuCAO inafika 56.644 katika Jedwali 17?
Namba hii haipaswi kulinganishwa moja kwa moja na 50.534,5 ya Jedwali 8. Rank-sum score inayotumika inategemea jumla ya ranking ya algoriti na runs zilizopo katika ulinganisho huo huo. Variants tatu za ziada za MuCAO zinapoongezwa kwenye Jedwali 17, ukubwa wa ranking pool hubadilika na kiwango cha possible total score pia hubadilika.
Kwa hiyo interpretation sahihi ya sensitivity analysis si kwamba “56.644 ni kubwa kuliko 50.534,5, kwa hiyo mbinu imeboreshwa”; interpretation sahihi ni kwamba katika comparison pool ile ile ya Jedwali 17, MuCAO yenye equal weighting ilikuwa ya kwanza.
Je, kuongeza algoriti zaidi kwenye MuCAO kulisaidia?
Si kila wakati. Main MuCAO hutumia mbinu tatu:
- WSO,
- TDO,
- AHA.
MuCAO5 variant ambayo DE iliongezwa kama mbinu ya nne yenye nguvu pia ilijaribiwa.
| Muundo | Idadi ya mbinu zilizounganishwa | Jumla ya score ya Jedwali 18 | Nafasi ya Jedwali 18 |
|---|---|---|---|
| MuCAO | 3 | 52.357,5 | 1 |
| MuCAO5 | 4 | 51.715,5 | 2 |
Kuongeza algoriti ya nne hakukuongeza performance. Watafiti wanaeleza kuwa candidate pool kubwa inaweza kuongeza diversity lakini pia kupunguza sehemu ya uchaguzi ya algoriti zenye nguvu na kuleta variability ya ziada katika adaptive selection process.
Matumizi ya circular antenna array yaliundwaje?
Tatizo la ziada la validation ni modeli ya Circular Antenna Array (CAA) yenye isotropic elements 12 zilizosambazwa kwa angular spacing sawa kwenye duara.
Array factor:
\[ AF(\phi)= \sum_{n=1}^{N} I_n \exp \left\{ j[ kr(\cos(\phi-\phi_n)-\cos(\phi_0-\phi_n)) +\beta_n ] \right\} \]
imefafanuliwa kwa namna hii.
Angular position ya kila element:
\[ \phi_n= \frac{2\pi(n-1)}{N} \]
iko katika namna hii.
Lengo ni kupunguza side-lobe level huku main lobe ikiwekwa karibu na direction inayotakiwa.
Ni vigezo vingapi viliboreshwa katika tatizo la CAA?
Kwa kila antenna element kati ya 12:
- current amplitude \(I_n\): 0,2–1 A,
- phase excitation \(\beta_n\): −180°–180°
viliboreshwa.
Jumla ya design variables:
\[ 12+12=24 \]
ilikuwa hivyo. Desired main-beam direction ilichaguliwa kama \(\phi_{des}=180^\circ\).
Ni algoriti ipi ilijitokeza katika CAA application?
| Nafasi | Algoriti | Jumla ya score | Best objective value | Average objective value |
|---|---|---|---|---|
| 1 | MuCAO | 9516 | −21,282 | −18,955 |
| 2 | WSO | 9069 | −21,006 | −18,216 |
| 3 | TDO | 9013 | −20,340 | −18,103 |
| 4 | AHA | 8670 | −21,184 | −17,417 |
MuCAO ilikuwa ya kwanza katika overall ranking score na average objective value.
Hata hivyo, kati ya mbinu zote, best single-run objective value ya chini zaidi ilikuwa −21,428 iliyopatikana na AFT. Hii ni tofauti muhimu inayonyesha kwamba superiority ya MuCAO haitokani na run moja ya bahati au ya kipekee, bali na distribution ya jumla ya independent runs.
Verianla Live: Uthibitishaji wa circular antenna array
Total rank-sum scores kutoka Jedwali 19 la utafiti zilitumika. Total score ya juu inaonyesha overall performance yenye nguvu zaidi katika independent runs 25.
| Algoriti | Jumla ya score | Nafasi ya jumla | Average objective value | Chanzo |
|---|---|---|---|---|
| MuCAO | 9516 | 1 | −18,955 | Jedwali 19 |
| WSO | 9069 | 2 | −18,216 | Jedwali 19 |
| TDO | 9013 | 3 | −18,103 | Jedwali 19 |
| AHA | 8670 | 4 | −17,417 | Jedwali 19 |
Hitimisho zinazoungwa mkono na utafiti
- MuCAO ilipata total score ya juu zaidi kati ya mbinu 18 katika overall rank-sum evaluation ya benchmark sita za sumakuumeme zilizochunguzwa.
- Nafasi ya MuCAO katika benchmark sita ilikuwa kati ya 2 na 6, range nyembamba zaidi katika ulinganisho mkuu.
- WSO na TDO zilipata nafasi ya juu kuliko MuCAO katika baadhi ya benchmark moja moja, lakini zilikuwa nyuma yake katika overall score.
- Kati ya reference algorithms, DE ilionyesha matokeo yenye nguvu zaidi kwa nafasi ya tano.
- Baadhi ya algoriti za kisasa, hasa GEO na RSO, zilionyesha overall ranking ya chini katika benchmark za sumakuumeme zilizochunguzwa.
- MuCAO configuration yenye equal \(w_1=w_2=0,5\) ilipata overall ranking ya juu kuliko weight combinations nyingine zilizojaribiwa.
- MuCAO5 yenye algoriti nne haikuweza kuipita main MuCAO yenye algoriti tatu.
- Katika optimization ya circular antenna array yenye elements 12, MuCAO ilikuwa ya kwanza kwa total rank-sum score.
- Runtime ya FEM-based benchmarks ilikuwa juu sana kuliko analytical problems.
Hitimisho ambazo utafiti hauungi mkono au haukupima
- Haijaonyeshwa kwamba MuCAO ni algoriti bora katika matatizo yote ya uboreshaji.
- MuCAO haikushika nafasi ya kwanza katika benchmark yoyote kati ya sita zilizochunguzwa.
- Haijaonyeshwa kwamba MuCAO ina statistically significant superiority dhidi ya kila mpinzani katika kila benchmark.
- Haijaonyeshwa kwamba metaheuristic algorithms mpya daima ni bora kuliko classical methods.
- Utafiti haukutengeneza wala kupima prototipu halisi ya motor, transformer, magnetizer au C-Core.
- CAA validation si physical antenna measurement au electromagnetic chamber test.
- Haijaonyeshwa kwamba MuCAO itahifadhi ranking hiyo hiyo kwa algorithm pools tofauti, population sizes tofauti na function-evaluation budgets tofauti.
- Kwa kuwa main MuCAO components zilichaguliwa kwa global performance katika benchmark set, haijathibitishwa kwamba components hizo hizo zitakuwa optimal katika problem class mpya kabisa.
- Computation times zilizoripotiwa kwa FEM problems si lazima zibaki sawa kwa hardware tofauti, FEM solver tofauti au parallelization configuration tofauti.
Mbinu na Matokeo ya Utafiti
Mlolongo wa mbinu wa MuCAO
Verianla Live: MuCAO huchaguaje algoriti inayofuata?
Mchakato huu unafupisha adaptive selection logic iliyotolewa katika Algorithm 1. Uchaguzi unafanyika kati ya independent optimization runs.
| Hatua | Operesheni ya MuCAO | Maana ya kisayansi |
|---|---|---|
| 1 | Unda pool ya candidate algorithms | Main configuration hutumia WSO, TDO na AHA. |
| 2 | Sawazisha initial probabilities | Kila algoriti ina probability ya 1/N mwanzoni. |
| 3 | Chagua algoriti moja na endesha independent run | Uchaguzi unafanywa kulingana na current probability distribution. |
| 4 | Ongeza objective value ya run kwenye historia | Performance history ya selected algorithm inasasishwa. |
| 5 | Hesabu average performance | Tabia ya jumla ya algoriti huangaliwa, si run moja nzuri pekee. |
| 6 | Hesabu best historical performance | Matokeo yenye nguvu zaidi hadi wakati huo huhifadhiwa kando. |
| 7 | Unganisha scores mbili kwa uzito | Main experiment hutumia w1 = 0,5 na w2 = 0,5. |
| 8 | Sasisha selection probabilities | Mbinu zenye better past performance zinapata nafasi kubwa zaidi ya kuchaguliwa katika runs zinazofuata. |
Mpangilio mkuu wa kompyuta
| Kigezo | Thamani iliyotumika katika utafiti |
|---|---|
| Programu | MATLAB 2025b |
| Mfumo wa kompyuta | Mfumo unaotegemea Intel Core i7 |
| Idadi ya independent runs | 25 |
| Population size | 50 |
| Maximum iteration | 1000 |
| Maximum function evaluations | 20.000 |
| Stopping criterion | Maximum number of function evaluations |
| Random number generator | mrg32k3a |
| Parallel runs | Separate deterministic substreams |
| Main weights za MuCAO | w1 = 0,5; w2 = 0,5 |
| Main components za MuCAO | WSO + TDO + AHA |
Alama kuu za utendaji katika benchmark sita
| Algoriti | Loney | BLDC | TEAM22 | Safety Transformer | C-Core | Magnetizer | Jumla | Nafasi ya jumla |
|---|---|---|---|---|---|---|---|---|
| MuCAO | 8666 | 8883 | 8696,5 | 9501 | 7891 | 6897 | 50.534,5 | 1 |
| WSO | 6703 | 9954 | 9273,5 | 9558 | 6512 | 6408 | 48.408,5 | 2 |
| TDO | 9464 | 8046 | 7403,5 | 5584 | 9822 | 7756 | 48.075,5 | 3 |
| AHA | 6423 | 7690 | 8600,5 | 9312 | 4788 | 6540 | 43.353,5 | 4 |
| DE | 6101 | 9818 | 8004,5 | 5368 | 8024,5 | 3850 | 41.166 | 5 |
Ujumbe mkuu wa jedwali ni kwamba ingawa WSO na TDO zilipata scores za juu katika baadhi ya matatizo moja moja, MuCAO ilibaki katika nafasi za juu katika matatizo yote sita.
Nafasi za MuCAO katika benchmark
| Benchmark | Nafasi ya MuCAO |
|---|---|
| Loney | 2 |
| BLDC | 3 |
| TEAM22 | 2 |
| Safety Transformer | 2 |
| C-Core | 4 |
| Magnetizer | 6 |
Range hii ya 2–6 ni moja ya ushahidi mkuu ambao watafiti hutumia kuelezea behavior ya MuCAO kama “robust” au balanced kwa ujumla.
Matatizo magumu zaidi kwa muda wa hesabu
Wakati average benchmark times bila kujali algoriti zilipotathminiwa, C-Core ilikuwa tatizo ghali zaidi kwa takribani saa 4 dakika 6 sekunde 39. Magnetizer ilikuwa ya pili kwa takribani saa 1 dakika 18 sekunde 22.
Muda mrefu zaidi wa single algorithm–benchmark total ulikuwa wa TLBO katika C-Core kwa saa 5 dakika 26 sekunde 16. Muda mfupi zaidi ulikuwa total ya POA katika tatizo la Loney kwa takribani sekunde 1,47.
Muda huu si wa optimization run moja, bali ni jumla ya independent runs 25 za algoriti husika.
Muhtasari wa pairwise statistical results
| Ulinganisho | Total score ya MuCAO | Total score ya mpinzani | Overall rank ya MuCAO |
|---|---|---|---|
| MuCAO vs WSO | 1944 | 1806 | 1 |
| MuCAO vs TDO | 2150 | 1600 | 1 |
| MuCAO vs AHA | 2640 | 1110 | 1 |
| MuCAO vs DE | 2250 | 1500 | 1 |
MuCAO ilikuwa ya kwanza katika pairwise overall comparisons zote nne. Hata hivyo, si p-values zote za benchmark moja moja ziko chini ya 0,05; statistical superiority inategemea tatizo.
Technical settings za CAA validation
| Sifa | Thamani |
|---|---|
| Antenna geometry | Circular antenna array |
| Idadi ya elements | 12 |
| Design variables | 24 |
| Current amplitude | 0,2–1 A |
| Phase excitation | −180°–180° |
| Desired beam direction | 180° |
| Main objective | Kupunguza side-lobe level na kuhifadhi main-lobe direction |
| Population | 50 |
| Maximum iteration | 1000 |
| Maximum function evaluations | 20.000 |
Mapungufu makuu ya kimetodolojia ya utafiti
- Main components za MuCAO zilichaguliwa kulingana na global performance katika benchmark set hiyo hiyo ya sumakuumeme.
- Waandishi wanakubali wazi kwamba uchaguzi huu unaweza kupunguza generalizability kwa aina tofauti za matatizo.
- Idadi ya component algorithms haikutolewa kwa utaratibu kutoka problem characteristics; iliwekwa kuwa tatu katika main study.
- FEM benchmarks zina computational cost ya juu.
- Utafiti haukutumia surrogate model kupunguza FEM cost; unaitaja kama future research direction.
- Hakuna experimental optimization validation iliyofanywa kwenye physical electromagnetic-device prototypes.
- CAA application si physical antenna measurement.
- Si algorithm parameters zote zilipelekwa katika separate automatic hyperparameter optimization.
- Kwa kuwa rank-sum total scores zinategemea idadi ya mbinu katika comparison pool, raw scores kutoka tables tofauti haziwezi kulinganishwa moja kwa moja.
- Kuna inconsistencies mbili za editorial/numerical ndani ya chanzo kuhusu idadi ya C-Core variables na overall rank ya MVPA.
Dokezo la Chanzo na Mbinu
Jina kamili la kazi asili: Performance Evaluation and Hybrid Combination of Modern Metaheuristics for the Optimal Design of Electromagnetic Devices
Waandishi: Houssem Rafik El-Hana Bouchekara, Mostafa Kamel Smail, Muhammad Sharjeel Javaid, Abdelhak Goudjil, Yusuf Abubakar Sha’aban, Mohammad Shoaib Shahriar, Md Nurul Islam, Ali Mukhaylif Mohammed na Bander Marshud Alshammari.
Mwandishi wa mawasiliano: Houssem Rafik El-Hana Bouchekara.
Mchango sawa/uandishi wa kwanza wa pamoja: Hakuna tamko la mchango sawa au co-first authorship katika chanzo.
Taasisi:
- Department of Electrical Engineering, University of Hafr Al Batin, Hafr Al Batin, Saudi Arabia.
- IPSA—Institut Polytechnique des Sciences Avancées, Ivry-sur-Seine, France.
- GeePs—Group of Electrical Engineering Paris, UMR CNRS 8507, CentraleSupélec, Université Paris-Saclay, Sorbonne University, Gif-sur-Yvette, France.
- Department of Electrical and Electronic Engineering, Imperial College London, London, United Kingdom.
- Department of Computer, Electrical and Software Engineering, Embry-Riddle Aeronautical University, Prescott, Arizona, USA.
Jarida: Actuators.
Mchapishaji: MDPI, Basel, Switzerland.
Taarifa ya bibliografia: Actuators 2026, 15(6), 284.
Kiungo rasmi cha chapisho:MDPI – Actuators 15(6), 284
Tarehe ya kuchapishwa: 25 Mei 2026. Utafiti ulipokelewa 23 Machi 2026, ukafanyiwa marekebisho 14 Mei 2026 na ukakubaliwa 19 Mei 2026.
Aina ya chanzo na hali ya peer review: Ni makala ya utafiti iliyokubaliwa na kuchapishwa katika jarida la Actuators.
Leseni: Creative Commons Attribution (CC BY).
Ufadhili: Utafiti uliungwa mkono na Saudi Arabia Ministry of Education, Deputyship for Research & Innovation chini ya mradi namba 0027-1446-S.
Kamati ya maadili: Haitumiki.
Ridhaa iliyoarifiwa: Haitumiki.
Upatikanaji wa data: Waandishi wanaeleza kwamba michango asili ya utafiti ipo katika makala na maswali ya ziada yanaweza kuelekezwa kwa mwandishi wa mawasiliano.
Mgongano wa maslahi: Waandishi wametangaza kwamba hakuna mgongano wa maslahi.
Tamko la matumizi ya akili bandia: Waandishi wanaeleza kwamba walitumia ChatGPT-5.5 Pro wakati wa maandalizi ya makala kwa language editing na text improvement pekee; research design, method, experimental results, analysis na scientific contributions ni za waandishi.
Michango ya waandishi: Conceptualization Houssem Rafik El-Hana Bouchekara; methodology timu pana ya waandishi; software Houssem Rafik El-Hana Bouchekara, Muhammad Sharjeel Javaid, Yusuf Abubakar Sha’aban, Mohammad Shoaib Shahriar na Md Nurul Islam; formal analysis Houssem Rafik El-Hana Bouchekara; first draft Houssem Rafik El-Hana Bouchekara na Mohammad Shoaib Shahriar; supervision, project management na funding acquisition Houssem Rafik El-Hana Bouchekara. Full CRediT distribution imetolewa kwa kina katika chanzo asili.
Upeo wa kisayansi: Utafiti unachunguza performance ya metaheuristic algorithms katika electromagnetic-device design kwa computational benchmarks na kuendeleza adaptive multi-algorithm MuCAO method. Findings zinahusu optimization simulations; hakuna physical electromagnetic-device manufacturing au field testing iliyofanywa.
Dokezo la inconsistency ndani ya chanzo 1: Jedwali 1 linasema benchmark ya C-Core ina design variables saba, ilhali Sehemu 3.5 na Equation (31) zinafafanua variables sita tu x1–x6. Tofauti hii haijaelezwa katika chanzo.
Dokezo la inconsistency ndani ya chanzo 2: Katika discussion ya results, overall rank ya MVPA imeandikwa 7; Jedwali 8 kuu linaonyesha TTA ya 7 na MVPA ya 8. Katika maudhui haya, numerical ranking ya Jedwali 8 imechukuliwa kama msingi na tofauti ya text–table imehifadhiwa.
Dokezo la kulinganisha scores: Jedwali 8, Jedwali 17 na Jedwali 18 yana total rank-sum scores tofauti kwa MuCAO. Sababu ni kwamba sensitivity analyses zinaongeza algorithm variants za ziada kwenye comparison pool. Kwa kuwa rank-sum scale inategemea pool size, raw total scores katika tables tofauti hazipaswi kulinganishwa moja kwa moja kwa ukubwa.
Kikomo cha CAA validation: Utafiti unaita tatizo la circular antenna array “real-life application”; hata hivyo tathmini ni ya kihesabu kupitia mathematical array-factor model na haina physical antenna prototype au measurement experiment.
Kikomo cha generalizability: Watafiti wanaeleza kwamba kuchagua MuCAO components kulingana na global performance katika benchmark zote kunaweza kuleta limitation katika problem types tofauti. Automatic algorithm selection kulingana na problem signature, dynamic component count na lower-cost FEM surrogate models ni miongoni mwa future research directions.
Matokeo ya kisayansi katika maudhui haya ya Verianla yanategemea utafiti uliopitiwa pekee. External verification ilitumika tu kuthibitisha title, DOI, journal na published bibliographic identity ya makala; hakuna optimization result mpya au scientific finding kutoka external source iliyoongezwa kwenye maudhui makuu.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *