

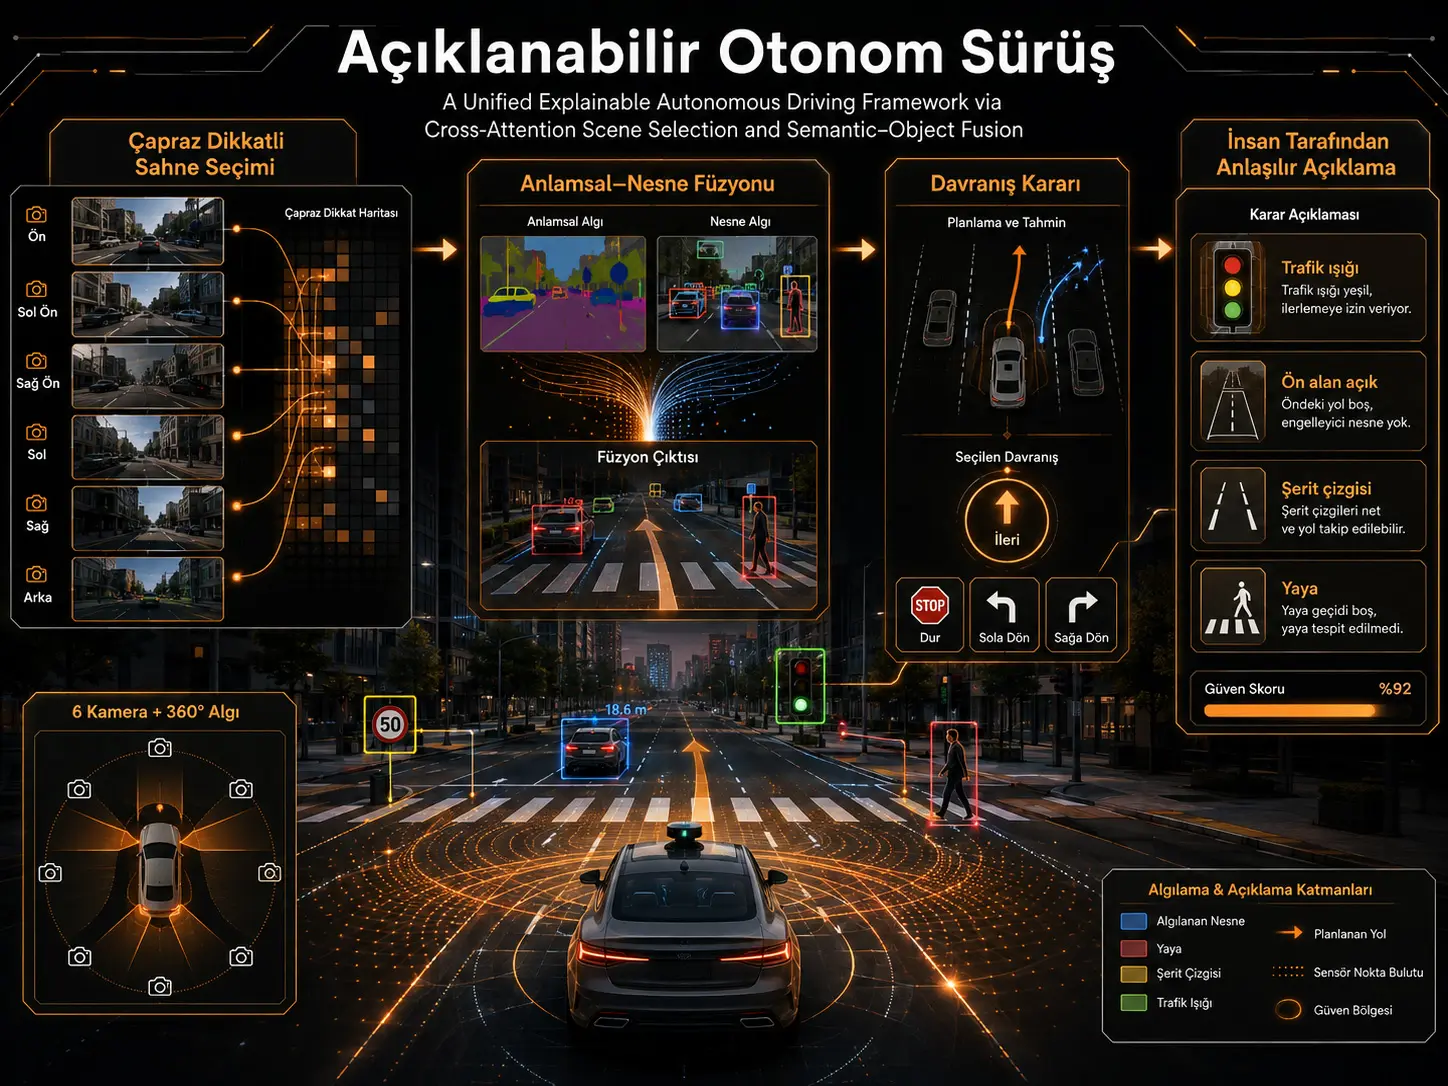
Utafiti huu unalenga autonomous-driving model isitoe tu behavior decisions kama “enda mbele”, “simama”, “geuka kushoto” au “geuka kulia”, bali pia itabiri sababu zinazohusiana na decisions hizi ambazo zinaweza kutafsiriwa na binadamu kutoka kwenye visual representation ileile. Mfumo unaoitwa CrossAD unaunganisha shared visual encoder inayotegemea Swin Transformer na Object Selection Module (OSM) inayotoa scene-level meaning, Object-Token Extractor (OTE) inayohifadhi class-agnostic local object tokens, na Semantic–Object Fusion (SOF) module inayounganisha aina hizi mbili za taarifa. Kwenye BDD-OIA benchmark, CrossAD imeripoti values za juu zaidi miongoni mwa methods zilizolinganishwa upande wa interpretation kwa \(F1_m=0,417\) na \(F1_{all}=0,584\), huku kwenye nu-AD ikifikia \(0,848/0,887\) kwa behavior na \(0,909/0,919\) kwa interpretation. Hata hivyo, results hizi ni offline benchmark evaluations; mfumo haujavalidated kwa closed-loop driving safety au field performance kwenye real vehicle.
Main architectural idea ya CrossAD ni kuweka tofauti taarifa ya “scene kwa ujumla ina maana gani” na “ni local object au region gani maalum inaweza kuathiri decision” kabla ya kuziunganisha ndani ya representation moja. OSM inaassume kwamba visual tokens zote kwenye road image si equally important, huzipa scores na kubadilisha subset yenye taarifa zaidi kuwa single scene-level semantic vector kupitia cross-attention. OTE, kwa kutumia scorer tofauti kutoka same Swin-T token sequence, huchagua local tokens nane. Hakuna bounding-box au segmentation label inayotolewa ili token hizi zilingane na meaningful objects kama traffic light, vehicle iliyo mbele au cyclist; selection hujifunzwa kutoka joint training objective ya behavior na interpretation tasks.
Ingawa behavior na explanation branches hutumia input ileile kwenye system, hazisomi feature vector ileile katika final decision stage. Behavior head hutumia representation iliyounganishwa kupitia cross-attention kati ya semantic vector kutoka OSM na local tokens kutoka OTE. Interpretation head hutumia directly scene-level semantic vector ya OSM kupitia skip connection. Researchers wanaweka asymmetric routing hii kwenye wazo kwamba behavior decision inaweza kutumia specific local objects kwa kiwango tofauti, huku explanation labels zikitumia more general scene state.
Katika six-camera nu-AD use, kuunganisha cameras pekee haitoshi. Katika ablation ya study, kuaverage tokens za cameras sita bila kuhifadhi camera identity kulitoa result ya chini hata kuliko kutumia single front camera. Waandishi wanaona hili linahusiana na network kutoweza kutofautisha views ambazo ni spatially similar lakini semantically different kama front-left na rear-left. Kwa hiyo, learnable identity vector ya dimension 768 imeongezwa tu kwa kila camera; total additional overhead kwa cameras sita ilikuwa parameters 4608.
Kuna important limit upande wa natural-language explanation. TinyLlama-1.1B iliyoadaptishwa kwa LoRA haisomi raw camera image directly na kutengeneza free-form rationale. Model inaconditioniwa kwa behavior na interpretation labels zilizotabiriwa awali na CrossAD. Kwa hiyo, study inatest jinsi generated sentence inavyolingana na structured decision output; haionyeshi kwamba language model imegundua causal visual reason ya decision.
Kwa mtazamo wa Uturuki, study ni architectural example inayoonyesha kwamba katika autonomous-vehicle research, si decision accuracy pekee inayoweza kutazamwa bali pia scene state ambayo model inaripoti kama reason ya decision inaweza kuchukuliwa kama separate output. Hata hivyo, haiwezi kuhitimishwa kutoka research hii kwamba benchmark results hizi zinatumika kwa road geometry, traffic signs, driver behaviors, weather conditions au real vehicle sensor layout nchini Uturuki. Matumizi kama haya yanahitaji retraining kwenye local data, independent validation na real-vehicle tests.
CrossAD inajaribu kutatua tatizo gani?
Katika autonomous driving, model kutabiri action sahihi pekee hakionyeshi kwa nini ilifanya decision hiyo. Problem inayoshughulikiwa na study ni tofauti hii: je, model ileile inaweza kutengeneza both driving behavior na human-understandable scene reasons zinazohusiana na behavior hiyo?
Researchers wanaanzia kwenye limitations za approaches tatu za kawaida. Kwanza, katika multi-stage systems zinazofanya object detection au segmentation kwanza na kisha kubadilisha output kuwa natural language, early perception errors zinaweza kuhamia kwenye explanation ya baadaye. Pili, post-hoc importance maps kama Grad-CAM zinaweza kuonyesha kwamba pixel region fulani ni muhimu lakini zisieleze “kwa nini ni muhimu” kwa semantic sentence. Tatu, decision na explanation zinapotoka kwenye separate networks, hakuna guarantee kwamba explanation inategemea evidence ileile iliyotumiwa katika behavior decision.
Kwa hiyo CrossAD hutengeneza behavior prediction na interpretation labels kutoka shared Swin-T visual encoder.
Model inatabiri behaviors zipi?
Benchmarks zote mbili hutumia behavior labels nne:
- Forward — kusonga mbele,
- Stop — kusimama au kupunguza mwendo,
- Left — kugeuka kushoto,
- Right — kugeuka kulia.
Task hii si classical single-class classification. Kwa sababu more than one behavior label inaweza kuwa active kwa wakati mmoja katika scene moja, sigmoid activation imetumika katika behavior na interpretation heads zote mbili.
BDD-OIA pia ina interpretation labels 21, huku nu-AD ikiwa na interpretation labels 8. BDD-OIA ina focus zaidi kwenye conceptual reasons kama traffic sign, lane marking au obstacle; nu-AD ina spatial interpretations zinazolenga openness ya surrounding regions kama front, front-left, rear-left na traffic-light state.
Visual encoder inafanya nini?
Main visual encoder ni Swin-T model iliyopretrained kwenye ImageNet. Single 224 × 224 pixel image inabadilishwa katika final stage kuwa 7 × 7 spatial feature map na kutoka hapo kuwa:
\[ N=49 \]
spatial tokens. Feature dimension ya kila token imetolewa kuwa:
\[ d=768 \]
.
Kwa hiyo, katika BDD-OIA basic token sequence ina dimension \(49\times768\), na katika nu-AD inayotumia cameras sita, sequences kutoka cameras sita zikiconcatenated zinakuwa \(294\times768\).
Kwa nini Object Selection Module inahitajika?
Sehemu kubwa ya driving image inaweza kuwa na visual regions ambazo si useful kwa decision kwa kiwango kilekile kila wakati, kama sky, building façade, uniform road surface au vegetation. Task ya OSM ni kuchagua tokens zenye taarifa zaidi kwa decision badala ya kusummarize tokens zote kwa equal weight.
Kwanza, horizontal-position information huongezwa kwa kila token. Katika 7 × 7 token grid, horizontal coordinate ya token:
\[ x_j\in[-1,1] \]
inaelezwa na kuhamishwa kwenye 768-dimensional token space kwa learnable linear transformation:
\[ p_j=W_px_j+b_p \]
\[ \tilde z_j=z_j+p_j \]
. Purpose ya additional information hii ni kuhifadhi, hasa katika right/left directional driving decisions, visual evidence imetoka kwenye horizontal region gani ya image.
Kisha kila token:
\[ s_j=W_s\tilde z_j+b_s \]
inapewa score na tokens zenye score za juu zaidi zinahifadhiwa.
| Dataset | Initial token count | Tokens zilizohifadhiwa na OSM |
|---|---|---|
| BDD-OIA | 49 | 16 |
| nu-AD | 294 | 64 |
Kuna source-internal difference katika pooled-query definition ya OSM
Equation (5) katika Section 3.3 inasema cross-attention query ni mean ya entire position-aware token sequence:
\[ q_{pool} = \frac{1}{N} \sum_{j=1}^{N}\tilde z_j \]
na kisha:
\[ h_{sem} = MHA(q_{pool},Z_{top},Z_{top}) \]
inafanywa.
Kinyume chake, step 4 ya Algorithm 1 katika article inafafanua query kama:
qpool ← Mean(Ztop)
. Yaani hapa mean ya selected top-K tokens pekee inatumika. Definitions hizi mbili si sawa. Kwa sababu source haisuluhishi wazi ndani ya text hii ni ipi iliyotumika katika actual implementation, Verianla article haitangazi moja ya definitions hizi kimya kimya kuwa “sahihi”.
Object-Token Extractor inafanya nini?
Wakati OSM inatengeneza general semantic summary ya scene, OTE inalenga kuzuia specific local evidence isipotee. Same visual token sequence inapewa scores na separate small MLP:
\[ r_j=g(z_j) \]
na highest-scoring:
\[ K_{obj}=8 \]
tokens huchaguliwa.
Selected tokens hupitishwa kwenye linear layer, GELU, dropout na LayerNorm na kubadilishwa kuwa final object-token set:
\[ O\in\mathbb{R}^{8\times768} \]
. Neno “object” hapa halipaswi kutafsiriwa kwa maana ya classical object detector. Model haina human-labeled bounding box, class name au segmentation mask. Kile tokens zinachowakilisha hujifunzwa end-to-end kutoka behavior na explanation losses.
Semantic–Object Fusion inafanyaje kazi?
Katika SOF module, semantic vector hutumika kama query na object tokens nane kama key na value:
\[ a=MHA(h_{sem},O,O) \]
. Kisha residual connection na LayerNorm hutumika:
\[ u=LayerNorm(h_{sem}+a) \]
na baada ya two-layer feed-forward network:
\[ h_{fuse} = LayerNorm(u+FFN(u)) \]
inapatikana.
Vector hii ya \(h_{fuse}\) ndiyo input ya behavior head.
Kwa nini behavior na interpretation heads zinasoma features tofauti?
Behavior head inahesabiwa kwa:
\[ \hat B_i = \sigma(MLP_{beh}(h_{fuse})) \]
na interpretation head kwa:
\[ \hat E_i = \sigma(MLP_{int}(h_{sem})) \]
.
Hypothesis ya researchers ni kwamba interpretation labels kama “kuna red light”, “front area iko open” au “kuna straight line upande wa right” zinafaa zaidi kwa scene-level features; behavior decision hutumia specific local objects pamoja na scene context.
Kwa hiyo interpretation head inaunganishwa directly kwenye semantic vector bila kupitishwa kwenye object fusion.
Je, object tokens zinazuiwaje kuwa copies za kila nyingine?
Diversity regularizer imetumika kupunguza OTE tokens nane kuchagua visual evidence ileile mara kwa mara. Kwa row-wise L2-normalized token matrix \(\tilde O\):
\[ L_{div} = \left\| \tilde O\tilde O^T-I_{K_{obj}} \right\|_F^2 \]
inahesabiwa.
Total loss:
\[ L_{total} = \alpha L_{VB} + \beta L_{des} + \lambda L_{div} \]
na weights zilizotumika:
\[ (\alpha,\beta,\lambda) = (0,5,\ 1,0,\ 0,005) \]
.
Katika behavior loss, fixed class weights kwa Forward, Stop, Left na Right:
\[ [1,0,\ 1,0,\ 2,0,\ 2,0] \]
zilitumika; hivyo turn classes ambazo ziliwakilishwa kidogo zilipewa weight zaidi.
Cameras sita zinaunganishwaje?
Katika nu-AD, kila moja ya cameras sita inaprocessiwa separately na Swin-T. Learnable identity embedding ya dimension 768 inaongezwa kwa kila camera:
\[ T= Concat( Z^{(1)}+e_1,\ldots,Z^{(6)}+e_6 ) \]
. Method hii huweka camera identity ndani ya features bila kuongeza token dimension.
Additional parameter count kwa cameras sita ni:
\[ 6\times768=4608 \]
, hivyo ni ndogo sana ikilinganishwa na visual-network size.
Je, camera identity imeonyeshwa kuwa muhimu kweli?
Ablation study inatoa finding yenye nguvu lakini ambayo haija-isolate kabisa suala hili.
| Variant | Structure | Behavior F1m | Interpretation F1m | Overall behavior F1 |
|---|---|---|---|---|
| V1 | Single front camera | 0,825 | 0,862 | 0,851 |
| V2 | 6 cameras, token average | 0,757 | 0,747 | 0,792 |
| V3 | 6 cameras + camera embedding + cyclic LR | 0,838 | 0,905 | 0,877 |
| V4 | Full model | 0,848 | 0,909 | 0,887 |
Kuunganisha cameras sita bila identity information kulishusha behavior F1m kutoka 0,825 hadi 0,757 na interpretation F1m kutoka 0,862 hadi 0,747 relative kwa V1.
Performance inarecover strongly katika V3. Hata hivyo, V3 ina changes tatu kwa wakati mmoja: camera embedding, cyclic learning-rate na different training budget. Kwa hiyo, researchers wanaeleza wazi kwamba V2→V3 gain haipaswi kusomwa kama isolated causal effect ya camera embedding pekee.
Additive camera embedding au concatenation?
Separate comparison ililinganisha kuongeza camera identity kwenye token na kutoa camera identity kupitia concatenation + projection.
Additive method ilitoa interpretation \(F1_m=0,909\), huku concatenation method ikitoa \(0,908\). Performance ilikuwa karibu sawa, lakini concatenation approach ilihitaji approximately 0,59 million additional parameters; additive embedding iliongeza parameters 4608 pekee.
BDD-OIA results zinaonyesha nini?
| Method | Behavior F1m | Behavior F1all | Interpretation F1m | Interpretation F1all |
|---|---|---|---|---|
| OIA | 0,718 | 0,734 | 0,208 | 0,422 |
| Inaction | 0,694 | 0,714 | 0,347 | 0,565 |
| NLE-DM | 0,723 | 0,733 | 0,312 | 0,517 |
| Interrelation | 0,701 | 0,722 | 0,335 | 0,537 |
| CrossAD | 0,716 | 0,739 | 0,417 | 0,584 |
CrossAD inatoa highest value kwa metrics zote mbili upande wa interpretation. Upande wa behavior, overall F1 ndiyo highest lakini class-mean F1 ni lower kuliko NLE-DM.
Kwa nini left turn ni problematic?
Behavior distribution katika BDD-OIA training data:
| Behavior | Number ya samples | Frequency |
|---|---|---|
| Forward | 8734 | %54,3 |
| Stop | 7277 | %45,2 |
| Left | 1210 | %7,5 |
| Right | 10.660 | %66,3 |
Ikumbukwe kwamba labels si mutually exclusive; kwa hiyo sum ya percentages kuzidi %100 si error.
Class F1 results za CrossAD:
| Class | CrossAD F1 |
|---|---|
| Forward | 0,839 |
| Stop | 0,803 |
| Left | 0,580 |
| Right | 0,641 |
Left turn ndiyo main class inayoshusha behavior average ya CrossAD. NLE-DM inaripoti 0,651 kwenye class hiyo.
nu-AD results zinaonyesha nini?
Verianla Live: CrossAD na previous methods kwenye nu-AD
Table inaonyesha four aggregate F1 metrics katika nu-AD test split comparison ya study.
| Method | Behavior F1m | Behavior F1all | Interpretation F1m | Interpretation F1all |
|---|---|---|---|---|
| OIA | 0,739 | 0,771 | 0,853 | 0,852 |
| NLE-DM | 0,760 | 0,836 | 0,882 | 0,879 |
| VB-CASeg | 0,767 | 0,844 | 0,907 | 0,903 |
| CrossAD | 0,848 | 0,887 | 0,909 | 0,919 |
Verianla Live: Values zimetolewa kutoka nu-AD test split comparison ya study. Hata graph engine ikiwa disabled, scientific source values zinahifadhiwa kwenye table hapo juu.
Kwenye nu-AD, CrossAD inafikia highest value katika all four aggregate measures kwenye table. Relative kwa VB-CASeg, behavior class-mean F1 gain ni 0,081; overall behavior F1 gain ni 0,043. Difference upande wa interpretation ni smaller: 0,002 katika class-mean F1 na 0,016 katika overall F1.
Je, OSM inaangalia traffic-related regions kweli?
Katika OSM visualization ya study, attention weights kwenye 7 × 7 token grid zimewekwa juu ya input image. Katika example scene, higher weights zinaonekana kujikita kwenye lane markings, road-direction arrows na forward driving corridor ya vehicle, huku buildings pembeni zikipata lower weights.
Visual hii inaonyesha kwamba OSM, angalau katika example iliyowasilishwa, inaweza kuhighlight task-relevant regions. Hata hivyo, single attention map haipaswi kutafsiriwa kama causal explanation ya all model decisions.
Natural-language explanation inazalishwaje?
System ina explanation-generation paths mbili.
Path ya kwanza: deterministic rule engine. Kuna templates 47 kwa BDD-OIA na 18 kwa nu-AD. Active behavior na reason labels zinasomwa kupitia rules na auditable sentence inatengenezwa.
Path ya pili: TinyLlama-1.1B version iliyoadaptishwa kwa Low-Rank Adaptation.
LoRA parameters:
- rank \(r=2\),
- scale \(\alpha_{LoRA}=64\),
- approximately 12.300 prompt–completion pairs,
- %90 training / %10 validation split.
Prompt inajumuisha predicted behavior na interpretation vectors. Yaani TinyLlama haioni scene image directly.
Verianla Live: CrossAD chain kutoka image hadi behavior na natural-language explanation
Process hapa chini inasummarize main steps zilizotolewa katika architecture na inference descriptions za study.
| Stage | Operation | Output / purpose |
|---|---|---|
| 1. Visual encoding | Single-camera au six-camera image inabadilishwa kuwa spatial tokens kwa Swin-T. | Shared visual feature sequence |
| 2. Scene selection | OSM inaongeza horizontal-position information, inascore tokens na kuchagua top-K scene tokens. | Scene subset muhimu kwa decision |
| 3. Semantic summary | Scene-level semantic vector inatengenezwa kwa cross-attention. | hsem |
| 4. Local-token selection | OTE inachagua object tokens nane kutoka same visual token sequence kwa separate scorer. | O ∈ R8×768 |
| 5. Semantic–object fusion | Semantic vector kama query na object tokens kama key/value zinaunganishwa kwa cross-attention. | hfuse |
| 6. Behavior prediction | Behavior head inasoma fused representation. | Forward / Stop / Left / Right probabilities |
| 7. Interpretation prediction | Interpretation head inasoma semantic vector directly kupitia skip connection. | Multi-label human-readable reason labels |
| 8. Language generation | Predicted behavior na interpretation labels zinapelekwa kwenye rule engine au LoRA-TinyLlama. | Natural-language rationale |
Verianla Live: Flow inategemea source architecture. Imehifadhiwa specifically kwamba language generator haitumii raw visual tokens directly.
Natural-language explanations zina consistency kiasi gani?
Katika BDD-OIA held-out test set yenye \(n=4572\) samples, three main checks zimeripotiwa:
| Check metric | Result |
|---|---|
| Predicted behavior kutajwa kwenye sentence | %99,93 |
| Word usage inayohusiana na prediction confidence | %99,80 |
| Alignment na at least one scene cue | %92,11 |
Results hizi zinaonyesha kwamba language generator inahifadhi kwa kiwango kikubwa structured outputs ilizopewa na model ndani ya sentence. Lakini peke yake hazionyeshi kwamba explanation ni correct katika real world au causally linked kwa visual evidence.
Explanation ni better wakati decision ni correct?
Researchers walitathmini separately samples ambazo behavior vector ilitabiriwa completely correctly na incorrectly.
| Subset | n | ROUGE-L | Scene-cue alignment |
|---|---|---|---|
| Behavior prediction correct | 1111 | 0,8016 | %92,64 |
| Behavior prediction incorrect | 3461 | 0,6788 | %91,94 |
ROUGE-L difference imeripotiwa kuwa:
\[ 0,8016-0,6788=0,1228 \]
.
Zaidi ya hayo, same language generator ilipopewa true labels badala ya predicted labels, ROUGE-L iliongezeka:
\[ 0,7087\rightarrow0,9226 \]
na difference ikawa 0,2139.
Researchers wanatafsiri hili kwamba natural-language generation quality inalimitiwa na upstream behavior-prediction accuracy.
Hii “explanation faithfulness” inathibitisha nini hasa?
Distinction ya study yenyewe ni muhimu sana hapa. Kwa sababu language generator inaconditioniwa na structured predictions, behavior ikiwa wrong inaweza kuielezea wrong behavior kwa consistency. Hii inaweza kuonyesha language generator ni faithful kwa model decision; lakini haithibitishi kwamba model ilifanya decision kwa sababu ya correct visual object kweli.
Waandishi wanatenganisha hili explicitly kati ya “decision-level faithfulness to the structured outputs” na “causal grounding to the raw visual evidence”.
Kwa hiyo study ya sasa inaunga mkono claim hii:
“Language generator kwa kiasi kikubwa inatengeneza rationale inayolingana na structured predictions za CrossAD.”
Lakini haiungi mkono stronger claim hii:
“Generated sentence inathibitisha actual causal visual evidence iliyosababisha model kufanya decision kwenye raw image.”
Nini kilitokea kwenye stress tests?
Study ilichunguza 15 difficult variants katika scenario groups tano:
- left turn,
- occlusion,
- night condition,
- complex traffic signs,
- multi-object scenes.
| Scenario | BDD-OIA confidence | nu-AD confidence | BDD-OIA entropy |
|---|---|---|---|
| Left turn | 0,2878 ± 0,0267 | 0,2754 ± 0,0017 | 1,3747 ± 0,0103 |
| Occlusion | 0,2904 ± 0,0131 | 0,2580 ± 0,0014 | 1,3768 ± 0,0054 |
| Night | 0,3109 ± 0,0160 | 0,2684 ± 0,0005 | 1,3689 ± 0,0063 |
| Complex signs | 0,2771 ± 0,0000 | 0,2719 ± 0,0000 | 1,3835 ± 0,0000 |
| Multi-object | 0,3031 ± 0,0290 | 0,2641 ± 0,0043 | 1,3666 ± 0,0184 |
Theoretical maximum entropy kwa classes nne ni:
\[ \ln4\approx1,386 \]
, hivyo values karibu 1,37 zinaonyesha high uncertainty katika samples hizi. Source yenyewe inaeleza stress-test results hizi si population statistics bali diagnostic results za model behavior under difficult conditions.
Matokeo yanayoungwa mkono na utafiti
- Behavior na human-readable reason labels zilitabiriwa pamoja kupitia single Swin-T visual encoder.
- OSM inatengeneza scene-level semantic representation kwa top-K token selection na cross-attention.
- OTE inachagua class-agnostic object tokens nane bila bounding-box au segmentation supervision.
- SOF inaunganisha semantic vector na object tokens kupitia cross-attention.
- Katika BDD-OIA, CrossAD imeripoti highest two interpretation F1 metrics miongoni mwa methods zilizolinganishwa.
- Katika nu-AD, CrossAD imeripoti highest result katika all four aggregate behavior/interpretation F1 metrics miongoni mwa methods zilizolinganishwa.
- Katika nu-AD, six-camera token averaging bila kuhifadhi camera identity ilishusha performance relative kwa single camera.
- Additive camera-embedding solution ilitumia far fewer additional parameters kwa accuracy karibu sawa na concatenation alternative.
- Explanations zilizotengenezwa na LoRA-TinyLlama zilionekana highly consistent na structured model outputs.
- ROUGE-L kushuka katika incorrect behavior predictions kuliunga mkono kwamba language generation inalimitiwa na upstream prediction accuracy.
Matokeo ambayo utafiti hauungi mkono au bado haujavalidate
- CrossAD haijavalidated kwa closed-loop autonomous-driving test kwenye real vehicle.
- Benchmark F1 values si real-road safety rate.
- Haijathibitishwa kwamba model itaonyesha performance ileile kwenye datasets nyingine nje ya BDD-OIA na nu-AD.
- Direct generalizability kwa road na traffic conditions za Uturuki haijatestwa.
- Model haitumii long temporal sequences; basic structure inategemea single frame au camera images zilizochukuliwa wakati mmoja.
- Object tokens hazijapewa names kwa supervised object labels wala kuvalidated katika bounding-box level.
- OSM attention visualization peke yake si evidence ya causal explanation.
- Kwa sababu LoRA-TinyLlama haiconditioniwi directly na raw visual tokens, visual causal faithfulness ya natural-language output haijathibitishwa.
- Entire V2→V3 ablation difference haiwezi kuhusishwa na camera-embedding mechanism pekee.
- Parameter value ya 27,4 million haiwakilishi all parameters za frozen TinyLlama-1.1B base network.
Mbinu na Matokeo ya Utafiti
Benchmark datasets
| Dataset | Source | Camera | Behavior class | Interpretation category |
|---|---|---|---|---|
| BDD-OIA | BDD100K | 1 | 4 | 21 |
| nu-AD | nuScenes | 6 | 4 | 8 |
CrossAD main tensor dimensions
| Component | BDD-OIA | nu-AD |
|---|---|---|
| Input | 3 × 224 × 224 | 6 × 3 × 224 × 224 |
| Swin-T token sequence | 49 × 768 | 294 × 768 |
| OSM selected tokens | 16 × 768 | 64 × 768 |
| Semantic vector | 768 | 768 |
| Object token | 8 × 768 | 8 × 768 |
| Fused representation | 768 | 768 |
| Behavior output | 4 | 4 |
| Interpretation output | 21 | 8 |
Training environment na optimization
| Parameter | Setting iliyotolewa katika source |
|---|---|
| Framework | PyTorch 2.7.1 |
| CUDA | 11.8 |
| GPU | NVIDIA RTX 3080 Ti |
| Training image | 256 × 256 resize → random 224 × 224 crop |
| Inference | Deterministic center crop |
| Optimizer | AdamW |
| Weight decay | 10⁻⁴ |
| Swin-T learning rate | 2 × 10⁻⁶ |
| Task modules learning rate | 10⁻⁴ |
| Warm-up | 3 epoch linear |
| Precision | bfloat16 mixed precision |
| Gradient clipping | L2 norm 0,5 |
| nu-AD mini-batch | 2 surround-view tuple |
| Gradient accumulation | 8 mini-batch |
| Effective batch size | 16 |
Swin-T ilifrozen kwa first three epochs, kisha ikafunguliwa gradually. Horizontal flip haikutumika katika BDD-OIA kwa sababu imeelezwa kwamba inge-reverse right/left semantics. Katika nu-AD, geometrically consistent flip ilitumika kwa remapping cameras na corresponding labels pamoja.
Loss function
Kwa behavior, class-weighted binary cross-entropy:
\[ L_{VB} = BCE_{w_B}(\hat B_i,B_i) \]
ilitumika.
Kwa interpretation, positive-class weights zilizohesabiwa kutoka training-data frequencies na clipped kwa upper bound zilitumika na:
\[ L_{des} = BCE_{w+}(\hat E_i,E_i) \]
.
Final objective pamoja na object-token diversity ni:
\[ L_{total} = 0,5L_{VB} + 1,0L_{des} + 0,005L_{div} \]
.
BDD-OIA main results
| Method | F1beh m | F1beh all | F1des m | F1des all | Forward | Stop | Left | Right |
|---|---|---|---|---|---|---|---|---|
| Local selector | 0,699 | 0,711 | 0,196 | 0,406 | 0,810 | 0,762 | 0,600 | 0,624 |
| OIA | 0,718 | 0,734 | 0,208 | 0,422 | 0,829 | 0,781 | 0,630 | 0,634 |
| Inaction | 0,694 | 0,714 | 0,347 | 0,565 | 0,800 | 0,747 | 0,612 | 0,619 |
| NLE-DM | 0,723 | 0,733 | 0,312 | 0,517 | 0,827 | 0,760 | 0,651 | 0,653 |
| Interrelation | 0,701 | 0,722 | 0,335 | 0,537 | 0,802 | 0,753 | 0,619 | 0,625 |
| CrossAD | 0,716 | 0,739 | 0,417 | 0,584 | 0,839 | 0,803 | 0,580 | 0,641 |
Ingawa CrossAD ni strong katika interpretation, si method ya highest behavior class-mean F1 kwenye BDD-OIA table. Distinction hii inapaswa kuhifadhiwa katika result interpretation.
nu-AD main results
| Method | F1beh m | F1beh all | F1des m | F1des all |
|---|---|---|---|---|
| OIA | 0,739 | 0,771 | 0,853 | 0,852 |
| NLE-DM | 0,760 | 0,836 | 0,882 | 0,879 |
| VB-CASeg | 0,767 | 0,844 | 0,907 | 0,903 |
| CrossAD | 0,848 | 0,887 | 0,909 | 0,919 |
nu-AD CrossAD class results
| Behavior | F1 |
|---|---|
| Forward | 0,963 |
| Stop | 0,852 |
| Left | 0,760 |
| Right | 0,818 |
Multi-camera ablation
| Variant | Camera | Forward | Stop | Left | Right | F1des m | F1des all | F1beh all |
|---|---|---|---|---|---|---|---|---|
| V1 — single camera | 1 | 0,963 | 0,824 | 0,739 | 0,773 | 0,862 | 0,867 | 0,851 |
| V2 — token average | 6 | 0,954 | 0,785 | 0,582 | 0,708 | 0,747 | 0,780 | 0,792 |
| V3 — cam embedding + cyclic LR | 6 | 0,958 | 0,837 | 0,752 | 0,805 | 0,905 | 0,917 | 0,877 |
| V4 — full model | 6 | 0,963 | 0,852 | 0,760 | 0,818 | 0,909 | 0,919 | 0,887 |
Comparison kati ya V3 na V2 si pure ablation ya camera-embedding effect pekee; article yenyewe inaeleza kwamba V3 pia inatofautiana na V2 kwa optimiser schedule na training budget.
Efficiency comparison
| Method | Parameter | Runtime / image | nu-AD F1beh m | nu-AD F1des all |
|---|---|---|---|---|
| OIA | 21,68 M | 65,63 ms | 0,739 | 0,852 |
| NLE-DM | 41,55 M | 47,10 ms | 0,760 | 0,879 |
| VB-CASeg | 28,11 M | 52,78 ms | 0,767 | 0,903 |
| CrossAD | 27,4 M | 50,9 ms | 0,848 | 0,919 |
Katika detailed complexity table ya source, CrossAD visual branch imeripotiwa kuwa parameters 22,21 M, 17,89 G MAC na 35,78 G FLOP. Profile hii imefanywa kwa nu-AD six-camera input na batch size 1.
Kwa TinyLLaMA-LoRA module, number ya 4,51 M inawakilisha trainable LoRA adapter parameters pekee. TinyLlama-1.1B base model imefrozen; kwa hiyo 27,4 M value haipaswi kutafsiriwa kama total system size inayojumuisha all physical model parameters za language model.
Natural-language faithfulness analysis
| Metric | Subset | Value |
|---|---|---|
| Behavior kutajwa kwenye sentence | All test | %99,93 |
| Confidence expression kutajwa | All test | %99,80 |
| Scene-cue alignment | All test | %92,11 |
| ROUGE-L | Behavior completely correct, n=1111 | 0,8016 |
| ROUGE-L | Behavior incorrect, n=3461 | 0,6788 |
| ROUGE-L | Generation with predicted labels | 0,7087 |
| ROUGE-L | Oracle generation with true labels | 0,9226 |
Faithfulness hapa inalenga structured behavior na interpretation labels. Study yenyewe inaeleza kwamba results hizi hazitoi causal faithfulness kwa raw visual evidence.
Technical attention points ndani ya source
OSM pooled query: Equation (5) inatumia mean ya all position-aware tokens huku Algorithm 1 ikitumia mean ya selected \(Z_{top}\) tokens.
V2–V3 ablation: Kwa sababu cyclic learning rate na training budget pia hubadilika pamoja na camera embedding, gain haiwezi kuhusishwa causally na camera embedding pekee.
Parameter count: Number ya 27,4 M iliyotolewa kwa CrossAD si total deployed-model size inayojumuisha all frozen base parameters za TinyLlama-1.1B.
BDD-OIA F1 terminology: Value ya 0,716 ni class-mean behaviour F1 katika Table 6; overall behaviour F1 ni 0,739. Katika later text 0,716 imetajwa kama “behaviour-prediction accuracy”.
Explanation faithfulness: Language generator ni label-conditioned. Kwa hiyo decision-level faithfulness na causal faithfulness kwa raw visual evidence zinapaswa kutenganishwa.
Maelezo ya Chanzo na Mbinu
Jina kamili asilia la utafiti: A Unified Explainable Autonomous Driving Framework via Cross-Attention Scene Selection and Semantic–Object Fusion
Waandishi: Habib Dhahri, Fahad Alotaibi, Awais Mahmood, Mousa Jari.
Author order: Order katika source imehifadhiwa exactly.
Corresponding author: Habib Dhahri.
Equal contribution/co-first author: Hakuna statement kama hiyo katika source.
Taasisi: College of Applied Computer Science, King Saud University, Riyadh 11545, Saudi Arabia.
Jarida: Machines.
Mchapishaji: MDPI.
Bibliographic record: Machines 2026, 14, 677.
DOI: 10.3390/machines14060677.
Official publication link:https://doi.org/10.3390/machines14060677
Publication date: 10 June 2026.
Source type na peer-review status: Ni peer-reviewed original research article. Study inategemea deep-learning model development na evaluation kwenye open BDD-OIA na nu-AD benchmark datasets.
Leseni: Creative Commons Attribution (CC BY).
Funding: Study iliungwa mkono na King Saud University, Riyadh chini ya Ongoing Research Funding program kwa number ORF-2026-2100.
Data na code availability: Open BDD-OIA na nu-AD benchmarks zilitumika katika research. Waandishi wamesema stratified subset manifest, sampling scripts, training code, rule-engine templates na evaluation scripts zimetolewa kupitia GitHub; LoRA-adapted TinyLlama checkpoint itachapishwa baada ya acceptance.
Conflict of interest: Waandishi walitangaza kwamba hakuna conflict of interest.
Author contributions: Habib Dhahri na Fahad Alotaibi katika conceptualization; Habib Dhahri, Awais Mahmood na Mousa Jari katika methodology; Habib Dhahri katika software; authors wote wanne katika validation; Habib Dhahri katika formal analysis na data curation; Habib Dhahri na Mousa Jari katika investigation; Fahad Alotaibi na Awais Mahmood katika resources; Habib Dhahri katika first draft na visualization; Fahad Alotaibi, Awais Mahmood na Mousa Jari katika review/editing; Awais Mahmood na Mousa Jari katika supervision; Fahad Alotaibi katika project administration na funding acquisition.
Architecture, tensor dimensions, loss functions, training settings, benchmark results, ablations, efficiency values, natural-language explanation results, stress tests na limitations katika Verianla article hii zinategemea source study iliyochunguzwa. Hakuna new scientific model result au performance claim kutoka external sources iliyoongezwa isipokuwa bibliographic identity verification.
Main methodological boundary: Study inatoa offline model evaluation kwenye BDD-OIA na nu-AD benchmarks. Closed-loop driving kwenye real vehicle, field test, long-term use, safety certification au independent validation katika different country na traffic distributions haijafanywa. Model inatumia mainly static images/camera frames na long-term temporal reasoning si main part ya current architecture.
Explainability boundary: LoRA-TinyLlama explanation generator haiconditioniwi directly na raw visual tokens; inatengeneza explanation kutoka predicted behavior na interpretation labels. Kwa hiyo study inatoa decision-level faithfulness finding kwa structured decisions; haitoi evidence ya causal faithfulness kwa raw visual evidence.
OSM source-internal inconsistency note: Section 3.3 Equation (5) inafafanua pooled query kama mean ya all position-aware tokens, huku step 4 ya Algorithm 1 ikitumia mean ya selected top-K tokens pekee. Source haisuluhishi definitions hizi mbili kuwa single final implementation.
Ablation boundary: Change kati ya V2 na V3 si camera embedding pekee; cyclic learning-rate schedule na training budget pia hubadilika. Kwa hiyo source haitathmini V2→V3 gain kama causal effect ya camera embedding pekee.
Model-size note: CrossAD 27,4 M value katika efficiency table na 4,51 M value iliyotolewa kwa TinyLLaMA-LoRA haziwakilishi all parameters za frozen TinyLlama base network yenye approximately 1,1 billion parameters. 4,51 M ni trainable LoRA adapter parameters pekee.
F1 terminology note: Katika BDD-OIA Table 6, CrossAD behaviour mean F1 ni 0,716 na overall behaviour F1 ni 0,739. Katika later natural-language explanation discussion, value ya 0,716 imetajwa kama “behaviour-prediction accuracy”. Katika Verianla article, metrics hizi mbili zimehifadhiwa separately.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *