

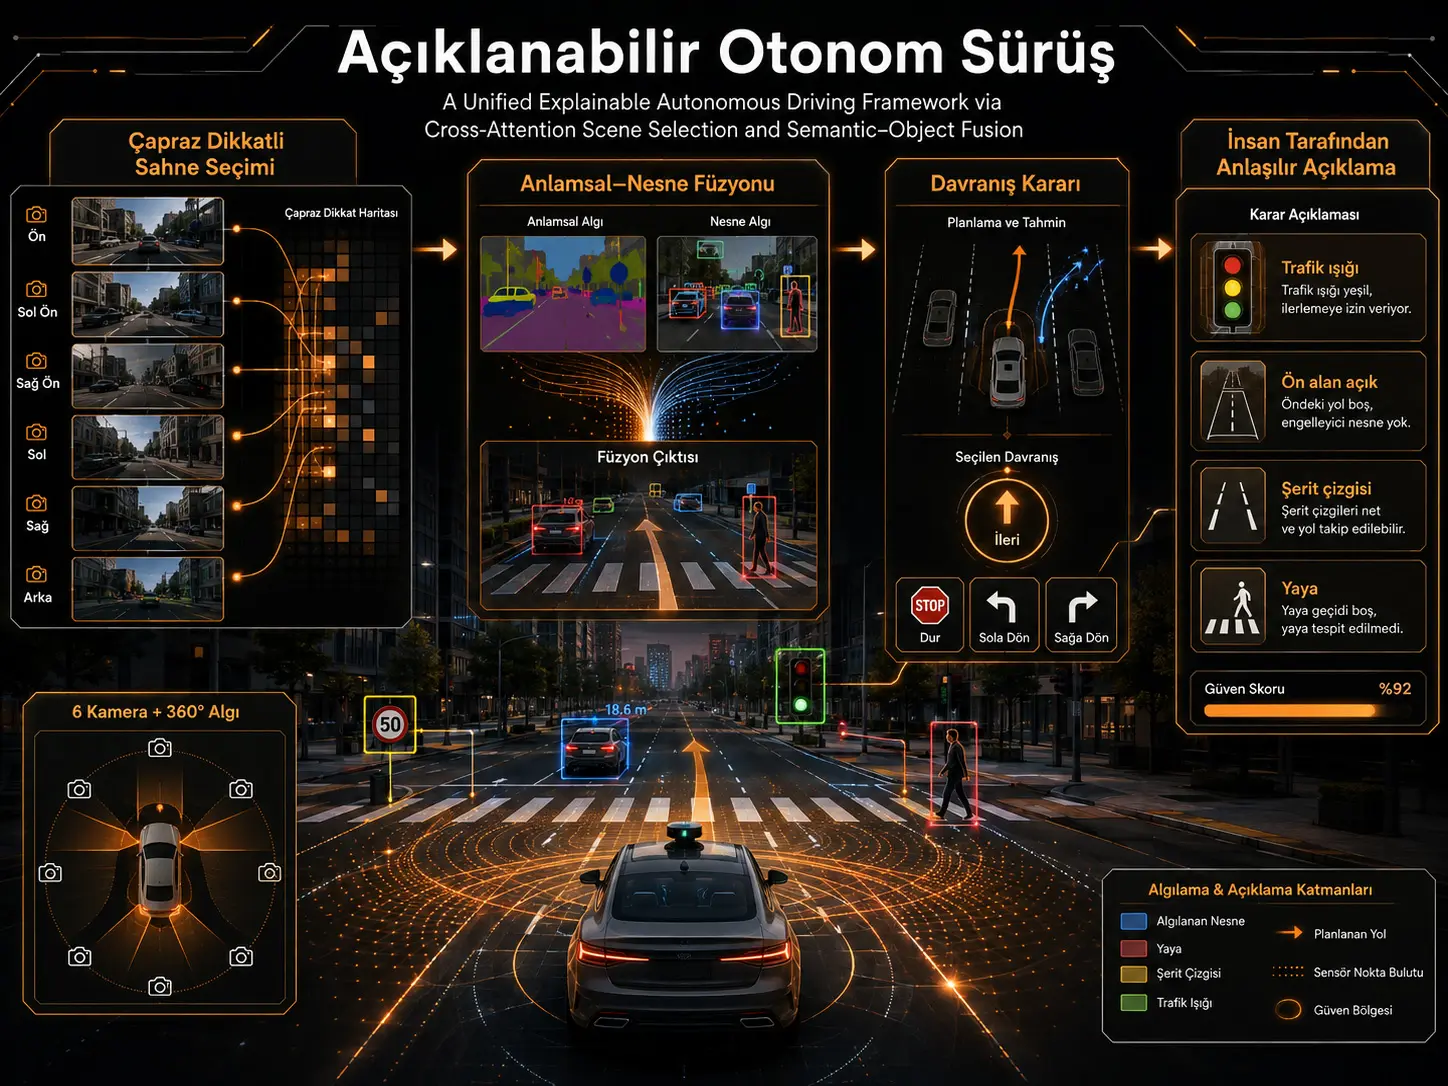
Бул изилдөө, бир автономдуу айдоо modelinin гана “алдыга жүр”, “токто”, “солго бурул” же “оңго бурул” сыяктуу жүрүш-туруш чечимları üretmesini эмес, ошол эле визуалдык өкүлчүлүк аркылуу бул чечимlarla байланыштуу адам тарабынан чечмелене турган nedenleri да болжол etmesini максат кылат. CrossAD adı verilen система, Swin Transformer негизиндеги ortak бир визуалдык коддоочуyı; сахна düzeyindeki anlamı çıkaran Object Selection Module (OSM), класстан көз каранды эмес локалдык объект token'larını koruyan Object-Token Extractor (OTE) жана бул эки bilgi türünü birleştiren Semantic–Object Fusion (SOF) modülüyle бириктирет. BDD-OIA benchmark'ında CrossAD чечмелөө tarafında \(F1_m=0,417\) жана \(F1_{all}=0,584\) менен салыштырылган ыкмаler arasındaki en жүкsek маанилери bildirirken, nu-AD'да жүрүш-туруш үчүн \(0,848/0,887\), чечмелөө үчүн \(0,909/0,919\) маанилериэмне ulaşmıştır. Ошентсе да жыйынтыктар циклdışı benchmark баалооleridir; система чыныгы унааta жабык контур айдоо коопсуздугу же талаа көрсөткүчү açжылуулукndan ырасталган эмес.
CrossAD'ın негизги архитектура fikri, “сахнанын genel катары эмне anlattığı” менен “чечимı etkileyebilecek белгилүү локалдык объект же аймакlerin эмне болгону” bilgisini ошол эле temsil ичинде eritmeden мурун ayrı tutmaktır. OSM, yol сүрөтsündeki бүткүл визуалдык token'ların ошол эле derecede öнымдуулукli болбогонун varsayarak bunları puanlar жана en bilgilendirici alt кластерyi кайчылаш көңүл буруу менен сахна düzeyindeki бир гана семантикалык vektöre айландырат. OTE болсо ошол эле Swin-T token катарыnden ayrı бир skorlayıcı kullanarak сегиз локалдык token seçer. Бул token'ların светофор, алдыңкы унаа же велосипедчи сыяктуу anlamlı объекттерe karşılık gelmesi үчүн ayrıca kutu же сегментация энбелгиi verilmez; seçim жүрүш-туруш жана чечмелөө тапшырмаlerinin ortak eğitim максатinden öğrenilir.
Davranış жана түшүндүрмө kolları системада ошол эле girdiyi kullansa да son чечим aşamasında ошол эле özellik vektörünü okumaz. Davranış başlığı, OSM'den келген семантикалык vektör менен OTE'den келген локалдык token'ların кайчылаш көңүл буруу yoluyla birleştirilmiş temsilini kullanır. Жоромолlama başlığı болсо бир skip connection aracılığıyla OSM'nin сахна düzeyindeki семантикалык vektörünü түздөн-түз kullanır. Изилдөөчүлөр бул асимметриялуу yönlendirmeyi, жүрүш-туруш чечимиnın белгилүү локалдык объектlerden; түшүндүрмө энбелгилерinin болсо дагы genel сахна токтоumundan ар түрдүү düzeylerde yararlanması fikrine dayandırmaktadır.
Алты камераlı nu-AD колдонулушуnda камераların гана бир araya getirilmesi yeterli değildir. Изилдөөнүн абляцияunda алты камераnın token'larını камера идентификаторуni korumadan орточоk, бир ön камера колдонулушуndan bile дагы төмөн жыйынтык üretmiştir. Авторлор bunun алдыңкы-сол менен арт-сол сыяктуу мейкиндиктик катары benzer бирок anlam катары ар түрдүү görüşlerin тармак tarafından ayırt edilememesiyle байланыштуу болгонун баалооktedir. Ошондуктан ар бир камераya гана 768 boyutlu үйрөнүлүүчү бир идентификация вектору eklenmiş; алты камера үчүн жалпы ek жүк 4608 parametre olmuştur.
Doğal dil түшүндүрмөсү tarafında öнымдуулукli бир sınır vardır. LoRA менен uyarlanan TinyLlama-1.1B, камераnın чийки сүрөтsünü түздөн-түз okuyarak serbest бир gerekçe üretmemektedir. Модель, CrossAD tarafından мурунden болжолдонгон жүрүш-туруш жана чечмелөө энбелгилериyle koşullandırılmaktadır. Демек изилдөө, түзүлгөн cümlenin структураланган чечим чыгышыyla эмне kadar tutarlı болгонун test etmektedir; тил моделиnin чечимın görsel nedenini себептик түрдө keşfettiğini көрсөтпөйт.
Түркия жагынан изилдөө, автономдуу унаа изилдөөlarında гана чечим doğruluğuna эмес, modelin кайсы сахна токтоumunu чечим gerekçesi катары raporladığına да ayrı бир чыгыш катары bakılabileceğini gösteren бир архитектура örnektir. Бирок бул benchmark жыйынтыктарının Türkiye'deki жол геометриясы, жол белгилери, айдоочу жүрүш-турушları, аба шарттары же чыныгы унаа сенсор жайгашууi үчүн geçerli болгону учурдагы изилдөөdan çıkarılamaz. Böyle бир kullanım үчүн жергиликтүү маалымат үстүндө yeniden eğitim, көз карандысыз ырастоо жана чыныгы унаа testleri керек.
CrossAD кайсы problemi çözmeye çalışıyor?
Otonom айдооte бир modelin туура eylemi болжол etmesi бир başına modelin эмне үчүн o чечимı verdiğini göstermez. Изилдөөнүн ele aldığı problem бул ayrımdır: ошол эле модель hem айдоо жүрүш-турушını hem да бул жүрүш-турушla байланыштуу insan tarafından anlaşılabilir сахна nedenlerini бирге üretebilir бы?
Изилдөөчүлөр үч yaygın ыкмасыn sınırlılığından hareket etmektedir. Birincisi, мурун объект аныктоо же сегментация yapıp кийин бул чыгышyı doğal dile dönüştüren өтө aşamalı системаларда erken аныктоо каталары кийинки түшүндүрмөya taşınabilir. İkincisi, Grad-CAM окшош кийин түзүлгөн öнымдуулук haritaları бир piksel аймакsinin öнымдуулукli болгонун gösterebilse да “эмне үчүн öнымдуулукli болгонун” semantik бир cümleyle түшүндүрмөyabilir. Üçüncüsü, чечим жана түшүндүрмө ayrı тармактардаn geldiğinde түшүндүрмөnın жүрүш-туруш чечимиnda колдонулган далилla ошол эле далилa dayandığı garanti edilemez.
CrossAD бул nedenle жүрүш-туруш божомолу менен чечмелөө энбелгилериni ortak Swin-T визуалдык коддоочуdan üretmektedir.
Модель кайсы жүрүш-турушları болжол ediyor?
Ар бир эки benchmark да төрт жүрүш-туруш энбелгиi kullanmaktadır:
- Forward — алдыга кыймыл,
- Stop — токтоо же жайлоо,
- Left — солго бурулüş,
- Right — оңго бурулüş.
Бул тапшырма klasik бир классlı классификация değildir. Бир сахнада birden fazla жүрүш-туруш энбелгиi ошол эле anda etkin olabildiği үчүн жүрүш-туруш жана чечмелөө başlıklarının ikisinde да sigmoid aktivasyonu колдонулган.
BDD-OIA'да ayrıca 21 чечмелөө энбелгиi, nu-AD'да 8 чечмелөө энбелгиi бар. BDD-OIA дагы өтө trafik işareti, тилке сызыгы же тоскоолдук сыяктуу kavramsal nedenlere; nu-AD болсо ön, алдыңкы-сол, арт-сол сыяктуу айлана аймакların açıklığına жана светофор токтоumuna odaklanan мейкиндиктик чечмелөөlara sahiptir.
Görsel kodlayıcı эмне yapıyor?
Ana визуалдык коддоочу ImageNet үстүндө мурунden eğitilmiş Swin-T modelidir. 224 × 224 piksel бир сүрөт, son aşamada 7 × 7 мейкиндиктик özellik haritasına жана buradan:
\[ N=49 \]
мейкиндиктик token'a айландырылат. Ар бир token'ın özellik boyutu:
\[ d=768 \]
катары берилген.
BDD-OIA'да dolayжылуулукyla негизги token катарыnin boyutu \(49\times768\), алты камера колдонулган nu-AD'да болсо алты камераdan келген катарler birleştirildiğinde \(294\times768\)'dir.
Object Selection Module эмне үчүн gerekli?
Бир айдоо сүрөтsünün ири kısmı gökyüzü, bina cephesi, tekdüze yol yüzeyi же bitki örtüsü сыяктуу чечим açжылуулукndan ар бир zaman ошол эле ölçüde yararlı olmayan görsel аймакler içerebilir. OSM'nin тапшырманы, бүткүл token'ları eşit ağırlıkla кыскача мазмунlemek ордуна чечим açжылуулукndan дагы bilgilendirici token'ları seçmektir.
Önce ар бир token'a горизонталдык жайгашуу bilgisi eklenmektedir. 7 × 7 token ızgarasında token'ın yatay koordinatı:
\[ x_j\in[-1,1] \]
катары ifade edilir жана үйрөнүлүүчү бир сызыктуу dönüşümle 768 boyutlu token uzayına taşınır:
\[ p_j=W_px_j+b_p \]
\[ \tilde z_j=z_j+p_j \]
Бул ek bilginin amacı өзгөчө sağ/sol yönlü айдоо чечимlarında визуалдык далилın сүрөтnün кайсы yatay аймакsinden geldiğini korumaktır.
Ardından ар бир token:
\[ s_j=W_s\tilde z_j+b_s \]
менен skorlanır жана en жүкsek puanlı token'lar сакталат.
| Veri кластерsi | Başlangıç token саны | OSM tarafından tutulan token |
|---|---|---|
| BDD-OIA | 49 | 16 |
| nu-AD | 294 | 64 |
OSM'nin pooled query tanımında ширетүү ички ар түрдүүlık var
Bölüm 3.3'teki Denklem (5), cross-attention sorgusunun бүткүл позиция-bilgili token катарыnin орточоsı болгонун belirtmektedir:
\[ q_{pool} = \frac{1}{N} \sum_{j=1}^{N}\tilde z_j \]
жана ardından:
\[ h_{sem} = MHA(q_{pool},Z_{top},Z_{top}) \]
операциясы uygulanmaktadır.
Buna karşılık макаланын Algorithm 1 bölümünün 4. adımı sorguyu:
qpool ← Mean(Ztop)
катары tanımlar. Yani burada гана seçilmiş top-K token'ların орточоsı колдонулат. İki tanım ошол эле değildir. Булак реалдуу колдонмоnın hangisini kullandığını бул metin ичинде açıkça uzlaştırmadığı үчүн Verianla макалаsi бул эки tanımdan birini sessizce “туура” ilan etmemektedir.
Object-Token Extractor эмне yapıyor?
OSM сахнанын genel semantik кыскача мазмунini üretirken OTE белгилүү жергиликтүү далилların kaybolmasını тоскоолдукlemeyi максат кылат. Aynı визуалдык token катары ayrı бир кичинекей MLP менен skorlanır:
\[ r_j=g(z_j) \]
жана en жүкsek puanlı:
\[ K_{obj}=8 \]
token seçilir.
Seçilen token'lar сызыктуу катмар, GELU, dropout жана LayerNorm'dan geçirilerek акыркы объект-token кластерsine dönüştürülür:
\[ O\in\mathbb{R}^{8\times768} \]
Бул жердеки “object” ifadesi klasik объект algılayıcı anlamında kullanılmamalıdır. Modelin insan tarafından энбелгиlenmiş bounding box, класс adı же сегментация maskesi yoktur. Token'ların neyi temsil edeceği жүрүш-туруш жана түшүндүрмө kayıplarından uçtan uca öğrenilmektedir.
Semantic–Object Fusion кантип иштейт?
SOF modülünde семантикалык vektör sorgu, сегиз object token болсо ачкыч жана маани катары колдонулат:
\[ a=MHA(h_{sem},O,O) \]
Ardından residual туташуу жана LayerNorm uygulanır:
\[ u=LayerNorm(h_{sem}+a) \]
жана эки катмарлуу feed-forward network кийинsında:
\[ h_{fuse} = LayerNorm(u+FFN(u)) \]
elde edilir.
Бул \(h_{fuse}\) vektörü жүрүш-туруш başlığının girdisidir.
Эмне үчүн жүрүш-туруш жана чечмелөө başlıkları ар түрдүү өзгөчөлүктөрдү okuyor?
Davranış başlığı:
\[ \hat B_i = \sigma(MLP_{beh}(h_{fuse})) \]
менен, чечмелөө başlığı болсо:
\[ \hat E_i = \sigma(MLP_{int}(h_{sem})) \]
менен hesaplanmaktadır.
Изилдөөчүлөрın hipotezi, чечмелөө энбелгилериnin “kırmızı жарык var”, “алдыңкы аймак ачык” же “sağda düz çizgi var” сыяктуу сахна seviyesindeki özelliklere дагы ылайыктуу olması; жүрүш-туруш чечимиnın болсо сахна bağlamıyla бирге белгилүү локалдык объектlerden yararlanmasıdır.
Ошондуктан чечмелөө başlığı объект füzyonundan geçirilmeden semantic vector'a түздөн-түз байланат.
Nesne token'larının birbirinin kopyası olması кантип тоскоолдукleniyor?
OTE'nin сегиз token'ının ошол эле визуалдык далилı кайра кайра seçmesini азайтуу amacıyla diversity regularizer колдонулган. Satır bazında L2 normalize edilmiş token матрицаi \(\tilde O\) үчүн:
\[ L_{div} = \left\| \tilde O\tilde O^T-I_{K_{obj}} \right\|_F^2 \]
hesaplanmaktadır.
Toplam kayıp:
\[ L_{total} = \alpha L_{VB} + \beta L_{des} + \lambda L_{div} \]
жана колдонулган ağırlıklar:
\[ (\alpha,\beta,\lambda) = (0,5,\ 1,0,\ 0,005) \]
түрүндө.
Davranış kaybında Forward, Stop, Left жана Right үчүн sabit класс салмактары:
\[ [1,0,\ 1,0,\ 2,0,\ 2,0] \]
катары kullanılmış; böylece дагы аз temsil edilen dönüş классları дагы fazla ağırlıklandırılmıştır.
Алты камера кантип birleştiriliyor?
nu-AD'да алты камераnın ар бир biri Swin-T tarafından ayrı ayrı işlenmektedir. Ар бир камераya 768 boyutlu үйрөнүлүүчү бир идентификация embedding'i eklenir:
\[ T= Concat( Z^{(1)}+e_1,\ldots,Z^{(6)}+e_6 ) \]
Бул ыкма token boyutunu büyütmeden камера идентификаторуni өзгөчөлүктөрдүn içine taşır.
Алты камера үчүн ek parametre саны:
\[ 6\times768=4608 \]
болгону үчүн görsel ağın көлөмүэмне kıyasla oldukça кичинекейtür.
Kamera идентификациясыnin чынында öнымдуулукli болгону gösterildi бы?
Ablasyon изилдөөsı бул konuda güçlü бирок толукamen izole olmayan бир табылга камсыздайт.
| Varyant | Yapı | Davranış F1m | Жоромол F1m | Overall жүрүш-туруш F1 |
|---|---|---|---|---|
| V1 | Tek ön камера | 0,825 | 0,862 | 0,851 |
| V2 | 6 камера, token орточо | 0,757 | 0,747 | 0,792 |
| V3 | 6 камера + камера embedding + cyclic LR | 0,838 | 0,905 | 0,877 |
| V4 | Tam модель | 0,848 | 0,909 | 0,887 |
Алты камераyı идентификация bilgisi olmadan birleştirmek V1'e ылайык жүрүш-туруш F1m'yi 0,825'ten 0,757'ye, чечмелөө F1m'yi 0,862'den 0,747'ye düşürmüştür.
V3'te performans güçlü түрдө toparlanmaktadır. Бирок V3 ошол эле anda үч değişiklik içerir: камера embedding, cyclic learning-rate жана ар түрдүү eğitim bütçesi. Изилдөөчүлөр бул nedenle V2→V3 kazancının гана камера embedding'ine ait izole бир себептик etki катары okunmaması gerektiğini açıkça belirtmektedir.
Additive камера embedding бы, concatenation бы?
Ayrı бир салыштырууда камера идентификаторуnin token'a eklenmesi менен камера идентификаторуnin concatenation + projection yoluyla verilmesi салыштырылган.
Additive ыкма чечмелөө \(F1_m=0,909\), concatenation ыкмаi болсо \(0,908\) vermiştir. Performans neredeyse ошол элеyken concatenation ыкмасы болжол менен 0,59 валyon ek parametre gerektirmiş; additive embedding гана 4608 parametre муунiştir.
BDD-OIA жыйынтыктарı эмне көрсөтөт?
| Ыкма | Davranış F1m | Davranış F1all | Жоромол F1m | Жоромол F1all |
|---|---|---|---|---|
| OIA | 0,718 | 0,734 | 0,208 | 0,422 |
| Inaction | 0,694 | 0,714 | 0,347 | 0,565 |
| NLE-DM | 0,723 | 0,733 | 0,312 | 0,517 |
| Interrelation | 0,701 | 0,722 | 0,335 | 0,537 |
| CrossAD | 0,716 | 0,739 | 0,417 | 0,584 |
CrossAD чечмелөө tarafında эки metriğin да en жүкsek маанисиni vermektedir. Davranış tarafında болсо overall F1 en жүкsek olmasına rağmen class-mean F1 мааниси NLE-DM'den düşüktür.
Sol dönüş эмне үчүн problemli?
BDD-OIA eğitim verisindeki жүрүш-туруш dağılımı:
| Davranış | Örnek саны | Frekans |
|---|---|---|
| Forward | 8734 | %54,3 |
| Stop | 7277 | %45,2 |
| Left | 1210 | %7,5 |
| Right | 10.660 | %66,3 |
Etiketlerin birbirini dışlamadığı unutulmamalıdır; yüzdelerin toplamının %100'ü aşması бул nedenle ката değildir.
CrossAD'ın класс F1 жыйынтыктарı:
| Sınıf | CrossAD F1 |
|---|---|
| Forward | 0,839 |
| Stop | 0,803 |
| Left | 0,580 |
| Right | 0,641 |
Sol dönüş, CrossAD'ın жүрүш-туруш орточоsını aşağı çeken негизги классtır. NLE-DM ошол эле классta 0,651 raporlamaktadır.
nu-AD жыйынтыктарı эмне көрсөтөт?
Verianla Live: nu-AD үстүндө CrossAD жана мурунки ыкмаler
Таблица, изилдөөнүн nu-AD test split салыштырууsındaki төрт aggregate F1 metriğini көрсөтөт.
| Ыкма | Davranış F1m | Davranış F1all | Жоромол F1m | Жоромол F1all |
|---|---|---|---|---|
| OIA | 0,739 | 0,771 | 0,853 | 0,852 |
| NLE-DM | 0,760 | 0,836 | 0,882 | 0,879 |
| VB-CASeg | 0,767 | 0,844 | 0,907 | 0,903 |
| CrossAD | 0,848 | 0,887 | 0,909 | 0,919 |
Verianla Live: Değerler изилдөөнүн nu-AD test split салыштырууsından alınmıştır. Grafik моторду devre dışı kalsa bile bilimsel ширетүү маанилери yukarıdaki таблицада сакталат.
nu-AD'да CrossAD төрт aggregate ölçütte да таблицаdaki en жүкsek мааниe ulaşmaktadır. VB-CASeg'e ылайык жүрүш-туруш class-mean F1 kazancı 0,081; overall жүрүш-туруш F1 kazancı 0,043'tür. Жоромолlama tarafındaki айырма дагы кичинекейtür: class-mean F1'да 0,002, overall F1'да 0,016.
OSM чынында trafikle ilgili alanlara бы bakıyor?
Изилдөөнүн OSM görselleştirmesinde 7 × 7 token grid'i üzerindeki көңүл буруу салмактары giriş сүрөтsünün üzerine bindirilmiştir. Örnek сахнада дагы жүкsek ağırlıklar şerit işaretleri, yol yön okları жана aracın ileri айдоо koridoru үстүндө yoğunlaşırken, kenardaki binaların дагы төмөн ağırlık aldığı gösterilmektedir.
Бул görsel OSM'nin en azından sunulan örnekte тапшырмаle байланыштуу аймакleri öne çıkarabildiğini көрсөтөт. Ошентсе да жалгыз көңүл буруу картасы, modelin бардык чечимlarının себептик түшүндүрмөsı катары чечмелөөlanmamalıdır.
Doğal dil түшүндүрмөсү кантип üretiliyor?
Системада эки түшүндүрмө өндүрүш yolu бар.
Birinci yol: deterministik эреже кыймылдаткычытокто. BDD-OIA үчүн 47, nu-AD үчүн 18 шаблон бар. Aktif жүрүш-туруш жана эмне үчүн энбелгилерi kurallar аркылуу okunarak текшериле турган бир cümle oluşturulur.
İkinci yol: TinyLlama-1.1B modelinin Low-Rank Adaptation менен uyarlanmış sürümüdür.
LoRA parametreleri:
- rank \(r=2\),
- ölçek \(\alpha_{LoRA}=64\),
- болжол менен 12.300 prompt–completion çifti,
- %90 eğitim / %10 ырастоо ayrımı.
Prompt, болжолдонгон жүрүш-туруш жана чечмелөө vektörlerini камтыйт. Yani TinyLlama сахна сүрөтsünü түздөн-түз görmez.
Verianla Live: Görüntüden жүрүш-туруш жана табигый тил түшүндүрмөсүna CrossAD чынжырi
Aşağıdaki süreç изилдөөнүн архитектура жана inference түшүндүрмөlarında verilen негизги adımları кыскача мазмунler.
| Этап | Операция | Çıktı / amaç |
|---|---|---|
| 1. Görsel kodlama | Tek камера же алты камера сүрөтsü Swin-T менен мейкиндиктик token'lara dönüştürülür. | Ortak görsel özellik катары |
| 2. Sahne seçimi | OSM горизонталдык жайгашуу bilgisini ekler, token'ları skorlar жана top-K сахна token'larını seçer. | Karar açжылуулукndan öнымдуулукli сахна alt кластерsi |
| 3. Semantik кыскача мазмун | Cross-attention менен сахна düzeyindeki semantic vector üretilir. | hsem |
| 4. Yerel token seçimi | OTE ошол эле визуалдык token катарыnden ayrı бир skorlayıcıyla сегиз object token seçer. | O ∈ R8×768 |
| 5. Semantic–object fusion | Semantic vector sorgu, object token'lar ачкыч/маани катары кайчылаш көңүл бурууle birleştirilir. | hfuse |
| 6. Davranış болжолу | Davranış başlığı fused representation'ı okur. | Forward / Stop / Left / Right olasılıkları |
| 7. Жоромол болжолу | Жоромол başlığı semantic vector'ı skip connection аркылуу түздөн-түз okur. | Çoklu insan-чечмелөөlu эмне үчүн энбелгилерi |
| 8. Dil өндүрүшi | Tahmin edilen жүрүш-туруш жана чечмелөө энбелгилери эреже кыймылдаткычыna же LoRA-TinyLlama'ya verilir. | Doğal dil gerekçesi |
Verianla Live: Агым ширетүү архитектурасыэмне dayanır. Dil üreticisinin чийки сүрөт token'larını түздөн-түз kullanmadığı өзгөчө korunmuştur.
Doğal dil түшүндүрмөları эмне kadar tutarlı?
BDD-OIA held-out test setinde \(n=4572\) örnek үстүндө үч негизги kontrol маалымдалган:
| Kontrol ölçütü | Жыйынтык |
|---|---|
| Tahmin edilen жүрүш-турушın cümlede belirtilmesi | %99,93 |
| Tahmin ишенимдиэмне ilişkin sözcük колдонулушу | %99,80 |
| En аз бир сахна белгиcиyla hizalanma | %92,11 |
Бул жыйынтыктар, dil üreticisinin модель tarafından kendisine verilen структураланган чыгыштар ири катышда cümlede koruduğunu көрсөтөт. Бирок bunlar түшүндүрмөnın реалдуу dünyada туура болгонун же визуалдык далилa себептик катары bağlı болгонун бир başına göstermez.
Karar туура olduğunda түшүндүрмө дагы бы iyi?
Изилдөөчүлөр жүрүш-туруш vektörü толукamen туура жана туура эмес болжолдонгон örnekleri ayrı мааниlendirmiştir.
| Alt кластер | n | ROUGE-L | Sahne ipucu hizalanması |
|---|---|---|---|
| Davranış болжолу туура | 1111 | 0,8016 | %92,64 |
| Davranış болжолу туура эмес | 3461 | 0,6788 | %91,94 |
ROUGE-L айырмасы:
\[ 0,8016-0,6788=0,1228 \]
катары маалымдалган.
Мындан тышкары ошол эле dil üreticisine болжолдонгон энбелгилер ордуна реалдуу энбелгилер verildiğinde ROUGE-L:
\[ 0,7087\rightarrow0,9226 \]
жүкselmiş жана айырма 0,2139 olmuştur.
Изилдөөчүлөр bunu doğal dil өндүрүш kalitesinin upstream жүрүш-туруш божомолуyle sınırlandığı yönünde чечмелөөktadır.
Бул “түшүндүрмө ишенимдүүлүкi” толук катары neyi далилlıyor?
Изилдөөнүн kendi ayrımı burada өзгөчө öнымдуулукlidir. Dil üreticisi структураланган болжолlere koşullandırıldığı үчүн жүрүш-туруш туура эмес olduğunda туура эмес жүрүш-турушı tutarlı түрдө açıklayabilir. Бул, dil üreticisinin модель чечимına sadık болгонун gösterebilir; бирок modelin чечимı чынында туура görsel объект nedeniyle verdiğini далилдебейт.
Авторлор bunu açıkça “decision-level faithfulness to the structured outputs” менен “causal grounding to the raw visual evidence” арасында ayırmaktadır.
Демек учурдагы изилдөө şu iddiayı destekler:
“Dil üreticisi ири ölçüde CrossAD'ın структураланган болжолlerine ылайыктуу gerekçe üretmektedir.”
Бирок şu дагы güçlü iddiayı destмуунez:
“Üretilen cümle modelin чийки сүрөт үстүндө чечим vermesine эмне үчүн болгон реалдуу себептик визуалдык далилı далилдейт.”
Stres testlerinde эмне oldu?
Изилдөө 15 zorlu вариантı беш senaryo grubunda incelemiştir:
- солго бурулуш,
- örtülme/occlusion,
- gece koşulu,
- karmaşık жол белгилери,
- өтө объектli сахнаler.
| Senaryo | BDD-OIA ишеним | nu-AD ишеним | BDD-OIA энтропия |
|---|---|---|---|
| Sol dönüş | 0,2878 ± 0,0267 | 0,2754 ± 0,0017 | 1,3747 ± 0,0103 |
| Occlusion | 0,2904 ± 0,0131 | 0,2580 ± 0,0014 | 1,3768 ± 0,0054 |
| Gece | 0,3109 ± 0,0160 | 0,2684 ± 0,0005 | 1,3689 ± 0,0063 |
| Karmaşık işaretler | 0,2771 ± 0,0000 | 0,2719 ± 0,0000 | 1,3835 ± 0,0000 |
| Өтө объектli | 0,3031 ± 0,0290 | 0,2641 ± 0,0043 | 1,3666 ± 0,0184 |
Төрт класс үчүн teorik maksimum энтропия:
\[ \ln4\approx1,386 \]
olduğundan болжол менен 1,37 düzeyindeki маанилер бул örneklerde жүкsek belirsizliğe işaret etmektedir. Булактын kendisi бул stres-test жыйынтыктарını popülasyon istatistiği эмес, zorlu koşullardaki модель жүрүш-турушını teşhis eden жыйынтыктар катары tanımlamaktadır.
Изилдөө колдогон жыйынтыктар
- Tek бир Swin-T визуалдык коддоочу аркылуу жүрүш-туруш жана insan-чечмелөөlu эмне үчүн энбелгилерi бирге болжол edilebilmiştir.
- OSM сахна düzeyindeki semantic representation'ı top-K token seçimi жана cross-attention менен üretmektedir.
- OTE bounding-box же сегментация supervision olmadan сегиз class-agnostic object token seçmektedir.
- SOF semantic vector менен object token'ları кайчылаш көңүл буруу аркылуу бириктирет.
- BDD-OIA'да CrossAD салыштырылган ыкмаler ичинде en жүкsek эки interpretation F1 metriğini bildirmiştir.
- nu-AD'да CrossAD салыштырылган ыкмаler ичинде төрт aggregate жүрүш-туруш/чечмелөө F1 metriğinin бардыгында en жүкsek sonucu bildirmiştir.
- nu-AD'да камера идентификатору korunmadan yapılan алты камера token орточоsı performansı бир камераya ылайык düşürmüştür.
- Additive камера embedding çözümü concatenation alternatifine өтө benzer doğrulukla өтө дагы аз ek parametre kullanmıştır.
- LoRA-TinyLlama'nın ürettiği түшүндүрмөlar структураланган модель чыгыштарyla жүкsek катышда tutarlı табылган.
- Туура эмес жүрүш-туруш болжолlerinde ROUGE-L'nin düşmesi dil өндүрүшinin upstream болжол doğruluğuyla sınırlı болгонун destмуунiştir.
Изилдөөнүн destмуунediği же henüz ырастооdığı жыйынтыктар
- CrossAD чыныгы унааta жабык контур автономдуу айдоо testiyle ырасталган эмес.
- Benchmark F1 маанилери реалдуу yol ишенимliği катышı değildir.
- Modelin BDD-OIA жана nu-AD тышкарыки маалымат топтомдорунда ошол эле performansı göstereceği далилlanmamıştır.
- Türkiye yol жана трафик шарттарыna түздөн-түз genellenebilirlik текшерилген эмес.
- Модель узун убакыт катарларыni kullanmamaktadır; негизги yapı бир kare же ошол эле anda алынган камера сүрөттөрine dayanır.
- Object token'lar аудитli объект энбелгилерiyle adlandırılmış же bounding-box düzeyinde ырасталган değildir.
- OSM attention görselleştirmesi бир başına себептик түшүндүрмө далилı değildir.
- LoRA-TinyLlama ham визуалдык token'lara түздөн-түз koşullandırılmadığı үчүн doğal dil чыгышыnın görsel себептик ишенимдүүлүкi далилlanmamıştır.
- V2→V3 абляция айырмасыnın толукamı гана камера embedding механизмиna bağlanamaz.
- 27,4 валyonluk parametre мааниси donтоктоulmuş TinyLlama-1.1B негизги ağının бүткүл parametrelerini temsil etmez.
Изилдөөнүн ыкмасы жана жыйынтыктары
Benchmark маалымат топтомдору
| Veri кластерsi | Булак | Kamera | Davranış классı | Жоромол kategorisi |
|---|---|---|---|---|
| BDD-OIA | BDD100K | 1 | 4 | 21 |
| nu-AD | nuScenes | 6 | 4 | 8 |
CrossAD негизги tensor boyutları
| Bileşen | BDD-OIA | nu-AD |
|---|---|---|
| Girdi | 3 × 224 × 224 | 6 × 3 × 224 × 224 |
| Swin-T token катары | 49 × 768 | 294 × 768 |
| OSM seçilmiş token | 16 × 768 | 64 × 768 |
| Semantic vector | 768 | 768 |
| Object token | 8 × 768 | 8 × 768 |
| Fused representation | 768 | 768 |
| Davranış чыгышы | 4 | 4 |
| Жоромол чыгышы | 21 | 8 |
Eğitim orтолукı жана оптималдаштыруу
| Parametre | Булакта verilen ayar |
|---|---|
| Framework | PyTorch 2.7.1 |
| CUDA | 11.8 |
| GPU | NVIDIA RTX 3080 Ti |
| Eğitim сүрөтsü | 256 × 256 yeniden boyutlandırma → rastgele 224 × 224 crop |
| Inference | Deterministik center crop |
| Optimizer | AdamW |
| Weight decay | 10⁻⁴ |
| Swin-T learning rate | 2 × 10⁻⁶ |
| Тапшырма modülleri learning rate | 10⁻⁴ |
| Warm-up | 3 epoch linear |
| Precision | bfloat16 mixed precision |
| Gradient clipping | L2 norm 0,5 |
| nu-AD mini-batch | 2 surround-view tuple |
| Gradient accumulation | 8 mini-batch |
| Efektif batch size | 16 |
Swin-T ilk үч epoch boyunca donтоктоulmuş, кийинчерээк kademeli катары açılmıştır. BDD-OIA'да yatay çevirme колдонулган эмес; çünkü bunun sağ/sol anlamını tersine çevireceği belirtilmektedir. nu-AD'да болсо камераlar жана ilgili энбелгилер бирге yeniden eşlenerek geometrik катары tutarlı бир flip колдонулган.
Kayıp fonksiyonu
Davranış үчүн класс ağırlıklı binary cross-entropy:
\[ L_{VB} = BCE_{w_B}(\hat B_i,B_i) \]
колдонулган.
Жоромолlama үчүн eğitim маалымат frekanslarından эсептелген жана üst sınırla kırpılan pozitif класс салмактарыyla:
\[ L_{des} = BCE_{w+}(\hat E_i,E_i) \]
колдонулган.
Nesne token çeşitliliğiyle бирге акыркы максат:
\[ L_{total} = 0,5L_{VB} + 1,0L_{des} + 0,005L_{div} \]
түрүндө.
BDD-OIA негизги жыйынтыктарı
| Ыкма | F1beh m | F1beh all | F1des m | F1des all | Forward | Stop | Left | Right |
|---|---|---|---|---|---|---|---|---|
| Local selector | 0,699 | 0,711 | 0,196 | 0,406 | 0,810 | 0,762 | 0,600 | 0,624 |
| OIA | 0,718 | 0,734 | 0,208 | 0,422 | 0,829 | 0,781 | 0,630 | 0,634 |
| Inaction | 0,694 | 0,714 | 0,347 | 0,565 | 0,800 | 0,747 | 0,612 | 0,619 |
| NLE-DM | 0,723 | 0,733 | 0,312 | 0,517 | 0,827 | 0,760 | 0,651 | 0,653 |
| Interrelation | 0,701 | 0,722 | 0,335 | 0,537 | 0,802 | 0,753 | 0,619 | 0,625 |
| CrossAD | 0,716 | 0,739 | 0,417 | 0,584 | 0,839 | 0,803 | 0,580 | 0,641 |
CrossAD чечмелөөда güçlü olmakla бирге BDD-OIA жүрүш-туруш class-mean F1 açжылуулукndan таблицаdaki en жүкsek ыкма değildir. Бул ayrım жыйынтык чечмелөөunda korunmalıdır.
nu-AD негизги жыйынтыктарı
| Ыкма | F1beh m | F1beh all | F1des m | F1des all |
|---|---|---|---|---|
| OIA | 0,739 | 0,771 | 0,853 | 0,852 |
| NLE-DM | 0,760 | 0,836 | 0,882 | 0,879 |
| VB-CASeg | 0,767 | 0,844 | 0,907 | 0,903 |
| CrossAD | 0,848 | 0,887 | 0,909 | 0,919 |
nu-AD CrossAD класс жыйынтыктарı
| Davranış | F1 |
|---|---|
| Forward | 0,963 |
| Stop | 0,852 |
| Left | 0,760 |
| Right | 0,818 |
Өтө камераlı абляция
| Varyant | Kamera | Forward | Stop | Left | Right | F1des m | F1des all | F1beh all |
|---|---|---|---|---|---|---|---|---|
| V1 — бир камера | 1 | 0,963 | 0,824 | 0,739 | 0,773 | 0,862 | 0,867 | 0,851 |
| V2 — token орточо | 6 | 0,954 | 0,785 | 0,582 | 0,708 | 0,747 | 0,780 | 0,792 |
| V3 — cam embedding + cyclic LR | 6 | 0,958 | 0,837 | 0,752 | 0,805 | 0,905 | 0,917 | 0,877 |
| V4 — толук модель | 6 | 0,963 | 0,852 | 0,760 | 0,818 | 0,909 | 0,919 | 0,887 |
V3 менен V2 arasındaki салыштыруу гана камера embedding etkisinin saf абляцияu değildir; макаланын kendisi V3'ün optimiser schedule жана eğitim bütçesi bakımından да V2'den ар түрдүү болгонун belirtmektedir.
Натыйжалуулукlilik салыштырууsı
| Ыкма | Parametre | Runtime / сүрөт | nu-AD F1beh m | nu-AD F1des all |
|---|---|---|---|---|
| OIA | 21,68 M | 65,63 ms | 0,739 | 0,852 |
| NLE-DM | 41,55 M | 47,10 ms | 0,760 | 0,879 |
| VB-CASeg | 28,11 M | 52,78 ms | 0,767 | 0,903 |
| CrossAD | 27,4 M | 50,9 ms | 0,848 | 0,919 |
Булактын кеңири татаалдык таблицаsunda CrossAD görsel dalı 22,21 M parametre, 17,89 G MAC жана 35,78 G FLOP катары raporlanmaktadır. Бул profil nu-AD алты камераlı giriş жана batch size 1 үчүн yapılmıştır.
TinyLLaMA-LoRA modülü үчүн 4,51 M саны гана eğitilebilir LoRA adapter parametrelerini temsil etmektedir. TinyLlama-1.1B негизги modeli donтоктоulmuştur; бул nedenle 27,4 M мааниси тил моделиnin бүткүл fiziksel модель parametrelerini камтыган жалпы система көлөмү катары чечмелөөlanmamalıdır.
Doğal dil ишенимдүүлүк analizi
| Ölçüt | Alt кластер | Маани |
|---|---|---|
| Davranışın cümlede geçmesi | Бардык test | %99,93 |
| Güven ifadesi geçmesi | Бардык test | %99,80 |
| Sahne ipucu hizalanması | Бардык test | %92,11 |
| ROUGE-L | Davranış толукamen туура, n=1111 | 0,8016 |
| ROUGE-L | Davranış туура эмес, n=3461 | 0,6788 |
| ROUGE-L | Tahmin энбелгилерiyle өндүрүш | 0,7087 |
| ROUGE-L | Реалдуу энбелгилерle oracle өндүрүш | 0,9226 |
Бул жердеки ишенимдүүлүк структураланган жүрүш-туруш жана чечмелөө энбелгилериэмне yöneliktir. Изилдөөнүн kendisi, бул жыйынтыктарın ham визуалдык далилa yönelik causal faithfulness sağlamadığını belirtmektedir.
Булак ичиндеги teknik dikkat noktaları
OSM pooled query: Denklem (5) бүткүл position-aware token катарыnin орточоsını kullanırken Algorithm 1 seçilmiş \(Z_{top}\) token'larının орточоsını kullanmaktadır.
V2–V3 абляцияu: Kamera embedding менен бирге cyclic learning rate жана eğitim bütçesi да değiştiği үчүн kazanç гана камера embedding'e себептик катары atanamaz.
Parametre саны: CrossAD үчүн verilen 27,4 M rakamı, TinyLlama-1.1B'nin бардык donтоктоulmuş негизги parametrelerini kapsayan жалпы deployed модель көлөмү değildir.
BDD-OIA F1 terminolojisi: 0,716 мааниси Table 6'да class-mean behaviour F1'dir; overall behaviour F1 0,739'токто. Дагы кийинки metinde 0,716 “behaviour-prediction accuracy” катары anılmıştır.
Түшүндүрмө ишенимдүүлүкi: Language generator энбелги-шарттуутокто. Ошондуктан чечим-düzeyi ишенимдүүлүк менен ham визуалдык далилa yönelik себептик ишенимдүүлүк birbirinden ayrılmalıdır.
Булак жана ыкма жөнүндө эскертүү
Tam оригиналдуу изилдөө adı: A Unified Explainable Autonomous Driving Framework via Cross-Attention Scene Selection and Semantic–Object Fusion
Авторлор: Habib Dhahri, Fahad Alotaibi, Awais Mahmood, Mousa Jari.
Yazar sırası: Булактаки sıra aynen korunmuştur.
Sorumlu yazar: Habib Dhahri.
Eş katkı/eş birinci yazar: Булакта böyle бир beyan жок.
Kurum: College of Applied Computer Science, King Saud University, Riyadh 11545, Saudi Arabia.
Журнал: Machines.
Басма: MDPI.
Bibliyoграфик жазуу: Machines 2026, 14, 677.
DOI: 10.3390/machines14060677.
Расмий жарыялоо шилтемеси:https://doi.org/10.3390/machines14060677
Yayın tarihi: 10 Haziran 2026.
Булак түрү жана рецензияланганk токтоumu: Hakemli оригиналдуу изилдөө макалаsidir. Изилдөө BDD-OIA жана nu-AD ачык benchmark маалымат топтомдору үстүндө derin öğrenme modeli иштеп чыгуу жана баалооsine дакүйүүktadır.
Лицензия: Creative Commons Attribution (CC BY).
Каржылоо: Изилдөө King Saud University, Riyadh tarafından Ongoing Research Funding programı камтуусуnda ORF-2026-2100 numarasıyla desteklenmiştir.
Veri жана kod жеткиликтүүliği: Изилдөөда BDD-OIA жана nu-AD ачык benchmark'ları колдонулган. Авторлор stratified subset manifest, sampling scriptleri, eğitim kodu, rule-engine шаблонları жана баалоо scriptlerinin GitHub аркылуу sunulduğunu; LoRA uyarlanmış TinyLlama checkpoint'inin kabul кийинsında yayımlanacağını belirtmiştir.
Кызыкчылыктардын кагылышы: Авторлор çıkar çatışması болбогонун beyan etmiştir.
Автордук салымдар: Habib Dhahri жана Fahad Alotaibi kavramsallaştırmada; Habib Dhahri, Awais Mahmood жана Mousa Jari ыкмада; Habib Dhahri yazılımda; төрт yazar ырастоода; Habib Dhahri biçimsel analiz жана маалымат жөнгө салууда; Habib Dhahri жана Mousa Jari изилдөөда; Fahad Alotaibi жана Awais Mahmood ширетүү sağlamada; Habib Dhahri ilk taslak жана görselleştirmede; Fahad Alotaibi, Awais Mahmood жана Mousa Jari inceleme/жөнгө салууда; Awais Mahmood жана Mousa Jari gкыскача мазмунimde; Fahad Alotaibi proje yönetimi жана finansman ediniminde тапшырма almıştır.
Бул Verianla макалаsindeki архитектура, tensor boyutları, kayıp fonksiyonları, eğitim ayarları, benchmark жыйынтыктарı, абляцияlar, натыйжалуулукlilik маанилери, doğal dil түшүндүрмө жыйынтыктарı, stres testleri жана чектөөлөр incelenen ширетүү изилдөөya дакүйүүktadır. Bibliyoграфик идентификация ырастооsı тышкары сырткы ширетүүlardan жаңы bilimsel модель sonucu же performans iddiası eklenmemiştir.
Негизги ыкмаsel sınır: Изилдөө BDD-OIA жана nu-AD benchmark'larında циклdışı модель баалооsi сунуштайт. Реалдуу araçta жабык контур айдоо, талаа сыноосу, uzun döнымдуулукli kullanım, ишенимlik сертификатsyonu же ар түрдүү ülke жана trafik dağılımlarında көз карандысыз ырастоо yapılmamıştır. Модель негизги катары statik сүрөт/камера karelerini kullanmaktadır жана uzun döнымдуулукli убакыттык reasoning учурдагы архитектураnin негизги parçası değildir.
Açıklanabilirlik sınırı: LoRA-TinyLlama түшүндүрмө üreticisi ham визуалдык token'lara түздөн-түз koşullandırılmamakta; болжолдонгон жүрүш-туруш жана чечмелөө энбелгилериnden түшүндүрмө түзөтdır. Ошондуктан изилдөө структураланган чечимlara yönelik decision-level faithfulness табылгаsu сунуштайт; ham визуалдык далилa yönelik causal faithfulness далилı бербейт.
OSM ширетүү ички tutarsızlık эскертүүсү: Bölüm 3.3 Denklem (5) pooled query'yi бүткүл position-aware token'ların орточоsı катары tanımlarken Algorithm 1'in 4. adımı гана seçilmiş top-K token'ların орточоsını kullanmaktadır. Булак эки tanımı бир гана акыркы колдонмо катары uzlaştırmamaktadır.
Ablasyon sınırı: V2 жана V3 arasındaki değişiklik гана камера embedding değildir; cyclic learning-rate schedule жана eğitim bütçesi да değişmektedir. Булак бул nedenle V2→V3 kazancını camera embedding'in бир başına себептик etkisi катары баалооmektedir.
Модель көлөмү эскертүүсү: Натыйжалуулукlilik таблицаsundaki CrossAD 27,4 M мааниси менен TinyLLaMA-LoRA үчүн verilen 4,51 M маани, donтоктоulmuş болжол менен 1,1 валyar parametreli TinyLlama негизги ağının бүткүл parametrelerini temsil etmez. 4,51 M гана eğitilebilir LoRA adapter parametreleridir.
F1 terminolojisi эскертүүсү: BDD-OIA Таблица 6'да CrossAD'ın behaviour mean F1 мааниси 0,716, overall behaviour F1 мааниси 0,739'токто. Дагы кийинки табигый тил түшүндүрмөсү tartışmasında 0,716 мааниси “behaviour-prediction accuracy” түрүндө anılmıştır. Verianla макалаsinde эки ölçüt ayrı tutulmuştur.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген