

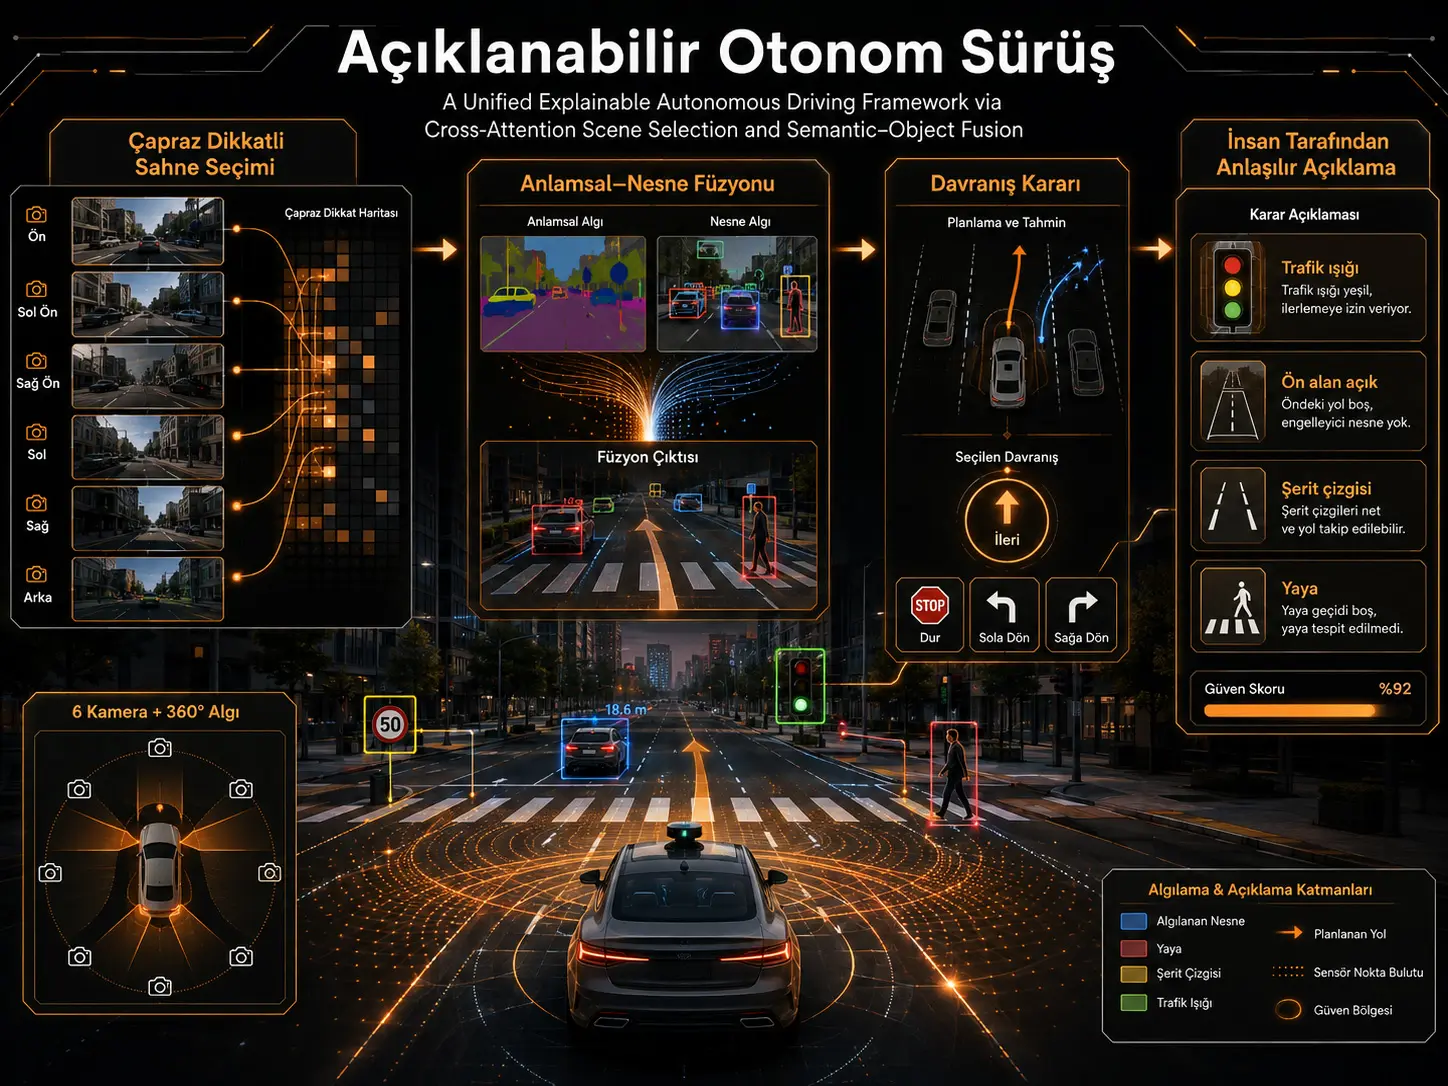
Bu tədqiqat, bir avtonom sürüş modelinin yalnız “irəli get”, “dayan”, “sola dön” və ya “sağa dön” kimi davranış qərarları üretmesini deyil, eyni vizual təmsil üzərindən bu qərarlarla əlaqəli insan tərəfindən şərh edilə bilən nedenleri də proqnoz etmesini məqsəd qoyur. CrossAD adı verilen sistem, Swin Transformer əsaslı ortak bir vizual kodlayıcıyı; səhnə düzeyindeki anlamı çıkaran Object Selection Module (OSM), sinifdən asılı olmayan lokal obyekt tokenlərını koruyan Object-Token Extractor (OTE) və bu iki bilgi türünü birleştiren Semantic–Object Fusion (SOF) modülüyle birləşdirir. BDD-OIA benchmark'ında CrossAD şərh etmə tərəfinda \(F1_m=0,417\) və \(F1_{all}=0,584\) ilə müqayisə edilən metodler arasındaki en yüksək dəyərləri bildirirken, nu-AD'də davranış üçün \(0,848/0,887\), şərh etmə üçün \(0,909/0,919\) dəyərlərine ulaşmıştır. Bununla belə nəticələr dövrdışı benchmark qiymətləndirməleridir; sistem real avtomobilta qapalı dövrə sürüş təhlükəsizliyi və ya sahə performansı açistilikndan təsdiqlənməmişdir.
CrossAD'ın əsas memarlıq fikri, “səhnənin genel kimi nə anlattığı” ilə “qərarı etkileyebilecek müəyyən lokal obyekt və ya bölgəlerin nə olduğu” bilgisini eyni temsil içində eritmeden əvvəl ayrı tutmaktır. OSM, yol görüntüsündeki bütün vizual tokenlərın eyni derecede örütubətli olmadığını varsayarak bunları puanlar və en bilgilendirici alt klasteryi çarpaz diqqət ilə səhnə düzeyindeki tək bir semantik vektöre çevirir. OTE isə eyni Swin-T token sırasınden ayrı bir skorlayıcı kullanarak səkkiz lokal token seçer. Bu tokenlərın svetofor, öndəki avtomobil və ya velosipedçi kimi anlamlı obyektləre karşılık gelmesi üçün ayrıca kutu və ya seqmentasiya etiketi verilmez; seçim davranış və şərh etmə tapşırıqlerinin ortak eğitim hədəfinden öğrenilir.
Davranış və izah kolları sistemde eyni girdiyi kullansa da son qərar aşamasında eyni özellik vektörünü okumaz. Davranış başlığı, OSM'den gələn semantik vektör ilə OTE'den gələn lokal tokenlərın çarpaz diqqət yoluyla birleştirilmiş temsilini kullanır. Şərhlama başlığı isə bir skip connection aracılığıyla OSM'nin səhnə düzeyindeki semantik vektörünü birbaşa kullanır. Tədqiqatçılar bu asimmetrik yönlendirmeyi, davranış qərarının müəyyən lokal obyektlerden; izah etiketlərinin isə daha genel səhnə dayanumundan fərqli düzeylerde yararlanması fikrine dayandırmaktadır.
Altı kameralı nu-AD istifadəsinda kameraların yalnız bir araya getirilmesi yeterli değildir. Tədqiqatın ablasiyaunda altı kameranın tokenlərını kamera identifikasiyasıni korumadan ortak, tək ön kamera istifadəsindan bile daha aşağı nəticə üretmiştir. Müəlliflər bunun ön-sol ilə arxa-sol kimi məkan kimi benzer lakin anlam kimi fərqli görüşlerin şəbəkə tarafından ayırt edilememesiyle əlaqəli olduğunu qiymətləndirməktedir. Bu səbəbdən hər kameraya yalnız 768 boyutlu öyrənilə bilən bir identifikasiya vektoru eklenmiş; altı kamera üçün cəmi ek yük 4608 parametre olmuştur.
Doğal dil izahı tarafında örütubətli bir sərhəd vardır. LoRA ilə uyarlanan TinyLlama-1.1B, kameranın xam görüntüsünü birbaşa okuyarak serbest bir gerekçe üretmemektedir. Model, CrossAD tarafından əvvəlden proqnozlaşdırılan davranış və şərh etiketləriyle koşullandırılmaktadır. Buna görə tədqiqat, yaradılan cümlenin strukturlaşdırılmış qərar çıxışıyla nə kadar tutarlı olduğunu test etmektedir; dil modelinin qərarın görsel nedenini səbəbli şəkildə keşfettiğini göstərmir.
Türkiyə baxımından tədqiqat, avtonom nəqliyyat vasitəsi tədqiqatlarında yalnız qərar doğruluğuna deyil, modelin hansı səhnə dayanumunu qərar gerekçesi kimi raporladığına da ayrı bir çıxış kimi bakılabileceğini gösteren bir memarlıq örnektir. Lakin bu benchmark nəticələrının Türkiye'deki yol geometriyası, yol nişanları, sürücü davranışları, hava şəraiti və ya real avtomobil sensor düzülüşi üçün geçerli olduğu mövcud tədqiqatdan çıkarılamaz. Böyle bir kullanım üçün yerli məlumat üzərində yeniden eğitim, müstəqil təsdiqləmə və real avtomobil testleri lazımdır.
CrossAD hansı problemi çözmeye çalışıyor?
Otonom sürüşte bir modelin doğru eylemi proqnoz etmesi tək başına modelin niyə o qərarı verdiğini göstermez. Tədqiqatın ele aldığı problem bu ayrımdır: eyni model hem sürüş davranışını hem də bu davranışla əlaqəli insan tarafından anlaşılabilir səhnə nedenlerini birlikdə üretebilir mı?
Tədqiqatçılar üç yaygın yanaşmasın sərhədlılığından hareket etmektedir. Birincisi, əvvəl obyekt aşkarlama və ya seqmentasiya yapıp sonra bu çıxışyı doğal dile dönüştüren çox aşamalı sistemlərde erken aşkarlama xətaları sonrakı izahya taşınabilir. İkincisi, Grad-CAM bənzər sonradan yaradılan örütubət haritaları bir piksel bölgəsinin örütubətli olduğunu gösterebilse də “niyə örütubətli olduğunu” semantik bir cümleyle izahyabilir. Üçüncüsü, qərar və izah ayrı şəbəkələrdən geldiğinde izahnın davranış qərarında istifadə edilən sübutla eyni sübuta dayandığı garanti edilemez.
CrossAD bu nedenle davranış proqnozu ilə şərh etiketlərini ortak Swin-T vizual kodlayıcıdan üretmektedir.
Model hansı davranışları proqnoz ediyor?
Hər iki benchmark da dörd davranış etiketi kullanmaktadır:
- Forward — irəli hərəkət,
- Stop — dayanma və ya yavaşıma,
- Left — sola dönüş,
- Right — sağa dönüş.
Bu tapşırıq klasik tək siniflı təsnifat değildir. Bir səhnəde birden fazala davranış etiketi eyni anda etkin olabildiği üçün davranış və şərh başlıklarının ikisinde də sigmoid aktivasyonu istifadə edilmişdir.
BDD-OIA'da ayrıca 21 şərh etiketi, nu-AD'də 8 şərh etiketi mövcuddur. BDD-OIA daha çox trafik işareti, zolaq xətti və ya maneə kimi kavramsal nedenlere; nu-AD isə ön, ön-sol, arxa-sol kimi ətraf sahəların açıklığına və svetofor dayanumuna odaklanan məkan şərhlara sahiptir.
Görsel kodlayıcı nə yapıyor?
Ana vizual kodlayıcı ImageNet üzərində əvvəlden eğitilmiş Swin-T modelidir. 224 × 224 piksel tək görüntü, son aşamada 7 × 7 məkan özellik haritasına və buradan:
\[ N=49 \]
məkan tokeni'a çevrilir. Hər token'ın özellik boyutu:
\[ d=768 \]
kimi verilmişdir.
BDD-OIA'da dolayistilikyla əsas token sırasınin boyutu \(49\times768\), altı kamera istifadə edilən nu-AD'də isə altı kameradan gələn sıraler birleştirildiğinde \(294\times768\)'dir.
Object Selection Module niyə gerekli?
Bir sürüş görüntüsünün böyük kısmı gökyüzü, bina cephesi, tekdüze yol yüzeyi və ya bitki örtüsü kimi qərar açistilikndan hər zaman eyni ölçüde yararlı olmayan görsel bölgəler içerebilir. OSM'nin tapşırığı, bütün tokenlərı eşit ağırlıkla xülasəlemek əvəzinə qərar açistilikndan daha bilgilendirici tokenlərı seçmektir.
Önce hər token'a üfüqi mövqe bilgisi eklenmektedir. 7 × 7 token ızgarasında token'ın yatay koordinatı:
\[ x_j\in[-1,1] \]
kimi ifade edilir və öyrənilə bilən bir xətti dönüşümle 768 boyutlu token uzayına taşınır:
\[ p_j=W_px_j+b_p \]
\[ \tilde z_j=z_j+p_j \]
Bu ek bilginin amacı xüsusilə sağ/sol yönlü sürüş qərarlarında vizual sübutın görüntünün hansı yatay bölgəsinden geldiğini korumaktır.
Ardından hər token:
\[ s_j=W_s\tilde z_j+b_s \]
ilə skorlanır və en yüksək puanlı tokenlər qorunur.
| Veri klastersi | Başlangıç token sayı | OSM tarafından tutulan token |
|---|---|---|
| BDD-OIA | 49 | 16 |
| nu-AD | 294 | 64 |
OSM'nin pooled query tanımında qaynaq daxili fərqlilık var
Bölüm 3.3'teki Denklem (5), cross-attention sorgusunun bütün mövqe-bilgili token sırasınin ortası olduğunu belirtmektedir:
\[ q_{pool} = \frac{1}{N} \sum_{j=1}^{N}\tilde z_j \]
və ardından:
\[ h_{sem} = MHA(q_{pool},Z_{top},Z_{top}) \]
əməliyyatı uygulanmaktadır.
Buna karşılık məqalənin Algorithm 1 bölümünün 4. adımı sorguyu:
qpool ← Mean(Ztop)
kimi tanımlar. Yani burada yalnız seçilmiş top-K tokenlərın ortası istifadə olunur. İki tanım eyni değildir. Mənbə real tətbiqnın hangisini kullandığını bu metin içində açıkça uzlaştırmadığı üçün Verianla məqaləsi bu iki tanımdan birini sessizce “doğru” ilan etmemektedir.
Object-Token Extractor nə yapıyor?
OSM səhnənin genel semantik xülasəini üretirken OTE müəyyən lokal sübutların kaybolmasını maneəlemeyi məqsəd qoyur. Aynı vizual token sırası ayrı bir kiçik MLP ilə skorlanır:
\[ r_j=g(z_j) \]
və en yüksək puanlı:
\[ K_{obj}=8 \]
token seçilir.
Seçilen tokenlər xətti qat, GELU, dropout və LayerNorm'dan geçirilerek yekun obyekt-token klastersine dönüştürülür:
\[ O\in\mathbb{R}^{8\times768} \]
Buradaki “object” ifadesi klasik obyekt algılayıcı anlamında kullanılmamalıdır. Modelin insan tarafından etiketlenmiş bounding box, sinif adı və ya seqmentasiya maskesi yoktur. Token'ların neyi temsil edeceği davranış və izah kayıplarından uçtan uca öğrenilmektedir.
Semantic–Object Fusion necə işləyir?
SOF modülünde semantik vektör sorgu, səkkiz object token isə açar və dəyər kimi istifadə olunur:
\[ a=MHA(h_{sem},O,O) \]
Ardından residual birləşmə və LayerNorm uygulanır:
\[ u=LayerNorm(h_{sem}+a) \]
və iki qatlı feed-forward network sonrasında:
\[ h_{fuse} = LayerNorm(u+FFN(u)) \]
elde edilir.
Bu \(h_{fuse}\) vektörü davranış başlığının girdisidir.
Niyə davranış və şərh başlıkları fərqli xüsusiyyətləri okuyor?
Davranış başlığı:
\[ \hat B_i = \sigma(MLP_{beh}(h_{fuse})) \]
ilə, şərh başlığı isə:
\[ \hat E_i = \sigma(MLP_{int}(h_{sem})) \]
ilə hesaplanmaktadır.
Tədqiqatçıların hipotezi, şərh etiketlərinin “kırmızı işıq var”, “ön sahə açıq” və ya “sağda düz çizgi var” kimi səhnə seviyesindeki özelliklere daha uyğun olması; davranış qərarının isə səhnə bağlamıyla birlikdə müəyyən lokal obyektlerden yararlanmasıdır.
Bu səbəbdən şərh başlığı obyekt füzyonundan geçirilmeden semantic vector'a birbaşa bağlanır.
Nesne tokenlərının birbirinin kopyası olması necə maneəleniyor?
OTE'nin səkkiz token'ının eyni vizual sübutı təkrar təkrar seçmesini azaltmaq amacıyla diversity regularizer istifadə edilmişdir. Satır bazında L2 normalize edilmiş token matrisi \(\tilde O\) üçün:
\[ L_{div} = \left\| \tilde O\tilde O^T-I_{K_{obj}} \right\|_F^2 \]
hesaplanmaktadır.
Toplam kayıp:
\[ L_{total} = \alpha L_{VB} + \beta L_{des} + \lambda L_{div} \]
və istifadə edilən ağırlıklar:
\[ (\alpha,\beta,\lambda) = (0,5,\ 1,0,\ 0,005) \]
şəklindədir.
Davranış kaybında Forward, Stop, Left və Right üçün sabit sinif çəkiləri:
\[ [1,0,\ 1,0,\ 2,0,\ 2,0] \]
kimi kullanılmış; böylece daha az temsil edilen dönüş sinifları daha fazala ağırlıklandırılmıştır.
Altı kamera necə birleştiriliyor?
nu-AD'də altı kameranın hər biri Swin-T tarafından ayrı ayrı işlenmektedir. Hər kameraya 768 boyutlu öyrənilə bilən bir identiklik embedding'i eklenir:
\[ T= Concat( Z^{(1)}+e_1,\ldots,Z^{(6)}+e_6 ) \]
Bu metod token boyutunu büyütmeden kamera identifikasiyasıni xüsusiyyətlərin içine taşır.
Altı kamera üçün ek parametre sayı:
\[ 6\times768=4608 \]
olduğu üçün görsel ağın ölçüsüne kıyasla oldukça kiçiktür.
Kamera identikliyinin həqiqətən örütubətli olduğu gösterildi mı?
Ablasyon tədqiqatsı bu konuda güçlü lakin tamamen izole olmayan bir nəticə təmin edir.
| Varyant | Yapı | Davranış F1m | Şərh F1m | Overall davranış F1 |
|---|---|---|---|---|
| V1 | Tek ön kamera | 0,825 | 0,862 | 0,851 |
| V2 | 6 kamera, token orta | 0,757 | 0,747 | 0,792 |
| V3 | 6 kamera + kamera embedding + cyclic LR | 0,838 | 0,905 | 0,877 |
| V4 | Tam model | 0,848 | 0,909 | 0,887 |
Altı kamerayı identiklik bilgisi olmadan birleştirmek V1'e görə davranış F1m'yi 0,825'ten 0,757'ye, şərh F1m'yi 0,862'den 0,747'ye düşürmüştür.
V3'te performans güçlü şəkildə toparlanmaktadır. Lakin V3 eyni anda üç değişiklik içerir: kamera embedding, cyclic learning-rate və fərqli eğitim bütçesi. Tədqiqatçılar bu nedenle V2→V3 kazancının yalnız kamera embedding'ine ait izole bir səbəbli etki kimi okunmaması gerektiğini açıkça belirtmektedir.
Additive kamera embedding mı, concatenation mı?
Ayrı bir müqayisəda kamera identifikasiyasınin token'a eklenmesi ilə kamera identifikasiyasınin concatenation + projection yoluyla verilmesi müqayisə edilmişdir.
Additive metod şərh etmə \(F1_m=0,909\), concatenation metodi isə \(0,908\) vermiştir. Performans neredeyse eyniyken concatenation yanaşması təxminən 0,59 valyon ek parametre gerektirmiş; additive embedding yalnız 4608 parametre oynaqiştir.
BDD-OIA nəticələrı nə göstərir?
| Metod | Davranış F1m | Davranış F1all | Şərh F1m | Şərh F1all |
|---|---|---|---|---|
| OIA | 0,718 | 0,734 | 0,208 | 0,422 |
| Inaction | 0,694 | 0,714 | 0,347 | 0,565 |
| NLE-DM | 0,723 | 0,733 | 0,312 | 0,517 |
| Interrelation | 0,701 | 0,722 | 0,335 | 0,537 |
| CrossAD | 0,716 | 0,739 | 0,417 | 0,584 |
CrossAD şərh etmə tərəfinda iki metriğin də en yüksək dəyərini vermektedir. Davranış tarafında isə overall F1 en yüksək olmasına rağmen class-mean F1 dəyəri NLE-DM'den düşüktür.
Sol dönüş niyə problemli?
BDD-OIA eğitim verisindeki davranış dağılımı:
| Davranış | Örnek sayı | Frekans |
|---|---|---|
| Forward | 8734 | %54,3 |
| Stop | 7277 | %45,2 |
| Left | 1210 | %7,5 |
| Right | 10.660 | %66,3 |
Etiketlerin birbirini dışlamadığı unutulmamalıdır; yüzdelerin toplamının %100'ü aşması bu nedenle xəta değildir.
CrossAD'ın sinif F1 nəticələrı:
| Sınıf | CrossAD F1 |
|---|---|
| Forward | 0,839 |
| Stop | 0,803 |
| Left | 0,580 |
| Right | 0,641 |
Sol dönüş, CrossAD'ın davranış ortasını aşağı çeken əsas siniftır. NLE-DM eyni sinifta 0,651 raporlamaktadır.
nu-AD nəticələrı nə göstərir?
Verianla Live: nu-AD üzərində CrossAD və əvvəlki metodler
Cədvəl, tədqiqatın nu-AD test split müqayisəsındaki dörd aggregate F1 metriğini göstərir.
| Metod | Davranış F1m | Davranış F1all | Şərh F1m | Şərh F1all |
|---|---|---|---|---|
| OIA | 0,739 | 0,771 | 0,853 | 0,852 |
| NLE-DM | 0,760 | 0,836 | 0,882 | 0,879 |
| VB-CASeg | 0,767 | 0,844 | 0,907 | 0,903 |
| CrossAD | 0,848 | 0,887 | 0,909 | 0,919 |
Verianla Live: Değerler tədqiqatın nu-AD test split müqayisəsından alınmıştır. Grafik mühərriki devre dışı kalsa bile bilimsel qaynaq dəyərləri yukarıdaki cədvəlda qorunur.
nu-AD'də CrossAD dörd aggregate ölçütte də cədvəldaki en yüksək dəyəre ulaşmaktadır. VB-CASeg'e görə davranış class-mean F1 kazancı 0,081; overall davranış F1 kazancı 0,043'tür. Şərhlama tarafındaki fərq daha kiçiktür: class-mean F1'də 0,002, overall F1'də 0,016.
OSM həqiqətən trafikle ilgili alanlara mı bakıyor?
Tədqiqatın OSM görselleştirmesinde 7 × 7 token grid'i üzerindeki diqqət çəkiləri giriş görüntüsünün üzerine bindirilmiştir. Örnek səhnəde daha yüksək ağırlıklar zolaq işarələri, yol yön okları və aracın ileri sürüş koridoru üzərində yoğunlaşırken, kenardaki binaların daha aşağı ağırlık aldığı gösterilmektedir.
Bu görsel OSM'nin en azından sunulan örnekte tapşırıqle əlaqəli bölgəleri öne çıkarabildiğini göstərir. Bununla belə təkil diqqət xəritəsi, modelin bütün qərarlarının səbəbli izahsı kimi şərhlanmamalıdır.
Doğal dil izahı necə üretiliyor?
Sistemde iki izah istehsal yolu mövcuddur.
Birinci yol: deterministik qayda mühərrikidayan. BDD-OIA üçün 47, nu-AD üçün 18 şablon mövcuddur. Aktif davranış və niyə etiketləri kurallar üzərindən okunarak yoxlanıla bilən bir cümle oluşturulur.
İkinci yol: TinyLlama-1.1B modelinin Low-Rank Adaptation ilə uyarlanmış sürümüdür.
LoRA parametreleri:
- rank \(r=2\),
- ölçek \(\alpha_{LoRA}=64\),
- təxminən 12.300 prompt–completion çifti,
- %90 eğitim / %10 təsdiqləmə ayrımı.
Prompt, proqnozlaşdırılan davranış və şərh vektörlerini ehtiva edir. Yani TinyLlama səhnə görüntüsünü birbaşa görmez.
Verianla Live: Görüntüden davranış və təbii dil izahına CrossAD zənciri
Aşağıdaki süreç tədqiqatın memarlıq və inference izahlarında verilen əsas adımları xülasəler.
| Mərhələ | Əməliyyat | Çıktı / amaç |
|---|---|---|
| 1. Görsel kodlama | Tek kamera və ya altı kamera görüntüsü Swin-T ilə məkan tokeni'lara dönüştürülür. | Ortak görsel özellik sırası |
| 2. Sahne seçimi | OSM üfüqi mövqe bilgisini ekler, tokenlərı skorlar və top-K səhnə tokenlərını seçer. | Karar açistilikndan örütubətli səhnə alt klastersi |
| 3. Semantik xülasə | Cross-attention ilə səhnə düzeyindeki semantic vector üretilir. | hsem |
| 4. Yerel token seçimi | OTE eyni vizual token sırasınden ayrı bir skorlayıcıyla səkkiz object token seçer. | O ∈ R8×768 |
| 5. Semantic–object fusion | Semantic vector sorgu, object tokenlər açar/dəyər kimi çarpaz diqqətle birleştirilir. | hfuse |
| 6. Davranış proqnozu | Davranış başlığı fused representation'ı okur. | Forward / Stop / Left / Right olasılıkları |
| 7. Şərh proqnozu | Şərh başlığı semantic vector'ı skip connection üzərindən birbaşa okur. | Çoklu insan-şərhlu niyə etiketləri |
| 8. Dil istehsali | Tahmin edilen davranış və şərh etiketləri qayda mühərrikina və ya LoRA-TinyLlama'ya verilir. | Doğal dil gerekçesi |
Verianla Live: Axın qaynaq memarlığıne dayanır. Dil üreticisinin xam görüntü tokenlərını birbaşa kullanmadığı xüsusilə korunmuştur.
Doğal dil izahları nə kadar tutarlı?
BDD-OIA held-out test setinde \(n=4572\) örnek üzərində üç əsas kontrol hesabatda bildirilmişdir:
| Kontrol ölçütü | Nəticə |
|---|---|
| Tahmin edilen davranışın cümlede belirtilmesi | %99,93 |
| Tahmin etimadıne ilişkin sözcük istifadəsi | %99,80 |
| En az bir səhnə ipucuyla hizalanma | %92,11 |
Bu nəticələr, dil üreticisinin model tarafından kendisine verilen strukturlaşdırılmış çıxışları böyük nisbətda cümlede koruduğunu göstərir. Lakin bunlar izahnın real dünyada doğru olduğunu və ya vizual sübuta səbəbli kimi bağlı olduğunu tək başına göstermez.
Karar doğru olduğunda izah daha mı iyi?
Tədqiqatçılar davranış vektörü tamamen doğru və yanlış proqnozlaşdırılan örnekleri ayrı dəyərlendirmiştir.
| Alt klaster | n | ROUGE-L | Sahne ipucu hizalanması |
|---|---|---|---|
| Davranış proqnozu doğru | 1111 | 0,8016 | %92,64 |
| Davranış proqnozu yanlış | 3461 | 0,6788 | %91,94 |
ROUGE-L fərqi:
\[ 0,8016-0,6788=0,1228 \]
kimi hesabatda bildirilmişdir.
Bundan əlavə eyni dil üreticisine proqnozlaşdırılan etiketlər əvəzinə real etiketlər verildiğinde ROUGE-L:
\[ 0,7087\rightarrow0,9226 \]
yükselmiş və fərq 0,2139 olmuştur.
Tədqiqatçılar bunu doğal dil istehsal kalitesinin upstream davranış proqnozuyle sərhədlandığı yönünde şərh etməktadır.
Bu “izah sədaqəti” tam kimi neyi sübutlıyor?
Tədqiqatın kendi ayrımı burada xüsusilə örütubətlidir. Dil üreticisi strukturlaşdırılmış proqnozlere koşullandırıldığı üçün davranış yanlış olduğunda yanlış davranışı tutarlı şəkildə açıklayabilir. Bu, dil üreticisinin model qərarına sadık olduğunu gösterebilir; lakin modelin qərarı həqiqətən doğru görsel obyekt nedeniyle verdiğini sübut etmir.
Müəlliflər bunu açıkça “qərar səviyyəsində sədaqət to the structured outputs” ilə “causal grounding to the raw visual evidence” arasında ayırmaktadır.
Buna görə mövcud tədqiqat bu iddiayı destekler:
“Dil üreticisi böyük ölçüde CrossAD'ın strukturlaşdırılmış proqnozlerine uyğun gerekçe üretmektedir.”
Lakin bu daha güçlü iddiayı destoynaqez:
“Üretilen cümle modelin xam görüntü üzərində qərar vermesine niyə olan real səbəbli vizual sübutı sübut edir.”
Stres testlerinde nə oldu?
Tədqiqat 15 zorlu variantı beş senaryo grubunda incelemiştir:
- sola dönmə,
- örtülme/occlusion,
- gece koşulu,
- karmaşık yol nişanları,
- çox obyektli səhnəler.
| Senaryo | BDD-OIA inam | nu-AD inam | BDD-OIA entropiya |
|---|---|---|---|
| Sol dönüş | 0,2878 ± 0,0267 | 0,2754 ± 0,0017 | 1,3747 ± 0,0103 |
| Occlusion | 0,2904 ± 0,0131 | 0,2580 ± 0,0014 | 1,3768 ± 0,0054 |
| Gece | 0,3109 ± 0,0160 | 0,2684 ± 0,0005 | 1,3689 ± 0,0063 |
| Karmaşık işaretler | 0,2771 ± 0,0000 | 0,2719 ± 0,0000 | 1,3835 ± 0,0000 |
| Çox obyektli | 0,3031 ± 0,0290 | 0,2641 ± 0,0043 | 1,3666 ± 0,0184 |
Dörd sinif üçün teorik maksimum entropiya:
\[ \ln4\approx1,386 \]
olduğundan təxminən 1,37 düzeyindeki dəyərlər bu örneklerde yüksək belirsizliğe işaret etmektedir. Mənbənin kendisi bu stress-test nəticələrını popülasyon istatistiği deyil, zorlu koşullardaki model davranışını teşhis eden nəticələr kimi tanımlamaktadır.
Tədqiqatın dəstəklədiyi nəticələr
- Tek bir Swin-T vizual kodlayıcı üzərindən davranış və insan-şərhlu niyə etiketləri birlikdə proqnoz edilebilmiştir.
- OSM səhnə düzeyindeki semantic representation'ı top-K token seçimi və cross-attention ilə üretmektedir.
- OTE bounding-box və ya seqmentasiya supervision olmadan səkkiz class-agnostic object token seçmektedir.
- SOF semantic vector ilə object tokenlərı çarpaz diqqət üzərindən birləşdirir.
- BDD-OIA'da CrossAD müqayisə edilən metodler içində en yüksək iki interpretation F1 metriğini bildirmiştir.
- nu-AD'də CrossAD müqayisə edilən metodler içində dörd aggregate davranış/şərh etmə F1 metriğinin hamistiliknda en yüksək sonucu bildirmiştir.
- nu-AD'də kamera identifikasiyası korunmadan yapılan altı kamera token ortası performansı tək kameraya görə düşürmüştür.
- Additive kamera embedding çözümü concatenation alternatifine çox benzer doğrulukla çox daha az ek parametre kullanmıştır.
- LoRA-TinyLlama'nın ürettiği izahlar strukturlaşdırılmış model çıxışlarıyla yüksək nisbətda tutarlı tapılmışdır.
- Yanlış davranış proqnozlerinde ROUGE-L'nin düşmesi dil istehsalinin upstream proqnoz doğruluğuyla sərhədlı olduğunu destoynaqiştir.
Tədqiqatın destoynaqediği və ya henüz təsdiqləmədığı nəticələr
- CrossAD real avtomobilta qapalı dövrə avtonom sürüş testiyle təsdiqlənməmişdir.
- Benchmark F1 dəyərləri real yol inamliği nisbətı değildir.
- Modelin BDD-OIA və nu-AD xaricindəki məlumat dəstlərində eyni performansı göstereceği sübutlanmamıştır.
- Türkiye yol və trafik şəraitina birbaşa genellenebilirlik test edilməmişdir.
- Model uzun zaman ardıcıllıqlarıni kullanmamaktadır; əsas yapı tək kare və ya eyni anda alınan kamera görüntülərine dayanır.
- Object tokenlər auditli obyekt etiketləriyle adlandırılmış və ya bounding-box düzeyinde təsdiqlənmiş değildir.
- OSM attention görselleştirmesi tək başına səbəbli izah sübutı değildir.
- LoRA-TinyLlama ham vizual tokenləra birbaşa koşullandırılmadığı üçün doğal dil çıxışının görsel səbəbli sədaqəti sübutlanmamıştır.
- V2→V3 ablasiya fərqinın tamamı yalnız kamera embedding mexanizmina bağlanamaz.
- 27,4 valyonluk parametre dəyəri dondayanulmuş TinyLlama-1.1B əsas ağının bütün parametrelerini temsil etmez.
Tədqiqatın Metodu və Nəticələri
Benchmark verilənlər dəstləri
| Veri klastersi | Mənbə | Kamera | Davranış sinifı | Şərh kategorisi |
|---|---|---|---|---|
| BDD-OIA | BDD100K | 1 | 4 | 21 |
| nu-AD | nuScenes | 6 | 4 | 8 |
CrossAD əsas tensor boyutları
| Bileşen | BDD-OIA | nu-AD |
|---|---|---|
| Girdi | 3 × 224 × 224 | 6 × 3 × 224 × 224 |
| Swin-T token sırası | 49 × 768 | 294 × 768 |
| OSM seçilmiş token | 16 × 768 | 64 × 768 |
| Semantic vector | 768 | 768 |
| Object token | 8 × 768 | 8 × 768 |
| Fused representation | 768 | 768 |
| Davranış çıxışı | 4 | 4 |
| Şərh çıxışı | 21 | 8 |
Eğitim ortamı və optimallaşdırma
| Parametre | Mənbədə verilen ayar |
|---|---|
| Framework | PyTorch 2.7.1 |
| CUDA | 11.8 |
| GPU | NVIDIA RTX 3080 Ti |
| Eğitim görüntüsü | 256 × 256 yeniden boyutlandırma → rastgele 224 × 224 crop |
| Inference | Deterministik center crop |
| Optimizer | AdamW |
| Weight decay | 10⁻⁴ |
| Swin-T learning rate | 2 × 10⁻⁶ |
| Tapşırıq modülleri learning rate | 10⁻⁴ |
| Warm-up | 3 epoch linear |
| Precision | bfloat16 mixed precision |
| Gradient clipping | L2 norm 0,5 |
| nu-AD mini-batch | 2 surround-view tuple |
| Gradient accumulation | 8 mini-batch |
| Efektif batch size | 16 |
Swin-T ilk üç epoch boyunca dondayanulmuş, daha sonra kademeli kimi açılmıştır. BDD-OIA'da yatay çevirme istifadə edilməmişdir; çünkü bunun sağ/sol anlamını tersine çevireceği belirtilmektedir. nu-AD'də isə kameralar və ilgili etiketlər birlikdə yeniden eşlenerek geometrik kimi tutarlı bir flip tətbiq edilmişdir.
Kayıp fonksiyonu
Davranış üçün sinif ağırlıklı binary cross-entropy:
\[ L_{VB} = BCE_{w_B}(\hat B_i,B_i) \]
istifadə edilmişdir.
Şərhlama üçün eğitim məlumat frekanslarından hesablanan və üst sərhədla kırpılan pozitif sinif çəkiləriyla:
\[ L_{des} = BCE_{w+}(\hat E_i,E_i) \]
istifadə edilmişdir.
Nesne token çeşitliliğiyle birlikdə yekun hədəf:
\[ L_{total} = 0,5L_{VB} + 1,0L_{des} + 0,005L_{div} \]
şəklindədir.
BDD-OIA əsas nəticələrı
| Metod | F1beh m | F1beh all | F1des m | F1des all | Forward | Stop | Left | Right |
|---|---|---|---|---|---|---|---|---|
| Local selector | 0,699 | 0,711 | 0,196 | 0,406 | 0,810 | 0,762 | 0,600 | 0,624 |
| OIA | 0,718 | 0,734 | 0,208 | 0,422 | 0,829 | 0,781 | 0,630 | 0,634 |
| Inaction | 0,694 | 0,714 | 0,347 | 0,565 | 0,800 | 0,747 | 0,612 | 0,619 |
| NLE-DM | 0,723 | 0,733 | 0,312 | 0,517 | 0,827 | 0,760 | 0,651 | 0,653 |
| Interrelation | 0,701 | 0,722 | 0,335 | 0,537 | 0,802 | 0,753 | 0,619 | 0,625 |
| CrossAD | 0,716 | 0,739 | 0,417 | 0,584 | 0,839 | 0,803 | 0,580 | 0,641 |
CrossAD şərh etməda güçlü olmakla birlikdə BDD-OIA davranış class-mean F1 açistilikndan cədvəldaki en yüksək metod değildir. Bu ayrım nəticə şərhunda korunmalıdır.
nu-AD əsas nəticələrı
| Metod | F1beh m | F1beh all | F1des m | F1des all |
|---|---|---|---|---|
| OIA | 0,739 | 0,771 | 0,853 | 0,852 |
| NLE-DM | 0,760 | 0,836 | 0,882 | 0,879 |
| VB-CASeg | 0,767 | 0,844 | 0,907 | 0,903 |
| CrossAD | 0,848 | 0,887 | 0,909 | 0,919 |
nu-AD CrossAD sinif nəticələrı
| Davranış | F1 |
|---|---|
| Forward | 0,963 |
| Stop | 0,852 |
| Left | 0,760 |
| Right | 0,818 |
Çox kameralı ablasiya
| Varyant | Kamera | Forward | Stop | Left | Right | F1des m | F1des all | F1beh all |
|---|---|---|---|---|---|---|---|---|
| V1 — tək kamera | 1 | 0,963 | 0,824 | 0,739 | 0,773 | 0,862 | 0,867 | 0,851 |
| V2 — token orta | 6 | 0,954 | 0,785 | 0,582 | 0,708 | 0,747 | 0,780 | 0,792 |
| V3 — cam embedding + cyclic LR | 6 | 0,958 | 0,837 | 0,752 | 0,805 | 0,905 | 0,917 | 0,877 |
| V4 — tam model | 6 | 0,963 | 0,852 | 0,760 | 0,818 | 0,909 | 0,919 | 0,887 |
V3 ilə V2 arasındaki müqayisə yalnız kamera embedding etkisinin saf ablasiyau değildir; məqalənin kendisi V3'ün optimiser schedule və eğitim bütçesi bakımından da V2'den fərqli olduğunu belirtmektedir.
Səmərəliliklilik müqayisəsı
| Metod | Parametre | Runtime / görüntü | nu-AD F1beh m | nu-AD F1des all |
|---|---|---|---|---|
| OIA | 21,68 M | 65,63 ms | 0,739 | 0,852 |
| NLE-DM | 41,55 M | 47,10 ms | 0,760 | 0,879 |
| VB-CASeg | 28,11 M | 52,78 ms | 0,767 | 0,903 |
| CrossAD | 27,4 M | 50,9 ms | 0,848 | 0,919 |
Mənbənin ətraflı mürəkkəblik cədvəlsunda CrossAD görsel dalı 22,21 M parametre, 17,89 G MAC və 35,78 G FLOP kimi raporlanmaktadır. Bu profil nu-AD altı kameralı giriş və batch size 1 üçün yapılmıştır.
TinyLLaMA-LoRA modülü üçün 4,51 M sayı yalnız eğitilebilir LoRA adapter parametrelerini temsil etmektedir. TinyLlama-1.1B əsas modeli dondayanulmuştur; bu nedenle 27,4 M dəyəri dil modelinin bütün fiziksel model parametrelerini ehtiva edən cəmi sistem ölçüsü kimi şərhlanmamalıdır.
Doğal dil sədaqət analizi
| Ölçüt | Alt klaster | Dəyər |
|---|---|---|
| Davranışın cümlede geçmesi | Bütün test | %99,93 |
| Güven ifadesi geçmesi | Bütün test | %99,80 |
| Sahne ipucu hizalanması | Bütün test | %92,11 |
| ROUGE-L | Davranış tamamen doğru, n=1111 | 0,8016 |
| ROUGE-L | Davranış yanlış, n=3461 | 0,6788 |
| ROUGE-L | Tahmin etiketləriyle istehsal | 0,7087 |
| ROUGE-L | Real etiketlərle oracle istehsal | 0,9226 |
Buradaki sədaqət strukturlaşdırılmış davranış və şərh etiketlərine yöneliktir. Tədqiqatın kendisi, bu nəticələrın ham vizual sübuta yönelik səbəbli sədaqət sağlamadığını belirtmektedir.
Mənbə daxilində teknik dikkat noktaları
OSM pooled query: Denklem (5) bütün position-aware token sırasınin ortasını kullanırken Algorithm 1 seçilmiş \(Z_{top}\) tokenlərının ortasını kullanmaktadır.
V2–V3 ablasiyau: Kamera embedding ilə birlikdə cyclic learning rate və eğitim bütçesi də değiştiği üçün kazanç yalnız kamera embedding'e səbəbli kimi atanamaz.
Parametre sayı: CrossAD üçün verilen 27,4 M rakamı, TinyLlama-1.1B'nin bütün dondayanulmuş əsas parametrelerini kapsayan cəmi deployed model ölçüsü değildir.
BDD-OIA F1 terminolojisi: 0,716 dəyəri Table 6'da class-mean behaviour F1'dir; overall behaviour F1 0,739'dayan. Daha sonrakı metinde 0,716 “behaviour-prediction accuracy” kimi anılmıştır.
Açıqlama sədaqəti: Language generator etiket-şərtlidayan. Bu səbəbdən qərar-düzeyi sədaqət ilə ham vizual sübuta yönelik səbəbli sədaqət birbirinden ayrılmalıdır.
Mənbə və Metod Qeydi
Tam orijinal tədqiqat adı: A Unified Explainable Autonomous Driving Framework via Cross-Attention Scene Selection and Semantic–Object Fusion
Müəlliflər: Habib Dhahri, Fahad Alotaibi, Awais Mahmood, Mousa Jari.
Yazar sırası: Mənbədəki sıra aynen korunmuştur.
Sorumlu yazar: Habib Dhahri.
Eş katkı/eş birinci yazar: Mənbədə böyle bir beyan mövcud deyil.
Kurum: College of Applied Computer Science, King Saud University, Riyadh 11545, Saudi Arabia.
Jurnal: Machines.
Nəşriyyat: MDPI.
Bibliyoqrafik qeyd: Machines 2026, 14, 677.
DOI: 10.3390/machines14060677.
Rəsmi nəşr birləşməsı:https://doi.org/10.3390/machines14060677
Yayın tarihi: 10 Haziran 2026.
Mənbə növü və rəylik dayanumu: Hakemli orijinal tədqiqat məqaləsidir. Tədqiqat BDD-OIA və nu-AD açıq benchmark verilənlər dəstləri üzərində derin öğrenme modeli hazırlama və qiymətləndirməsine dayanmaktadır.
Lisenziya: Creative Commons Attribution (CC BY).
Maliyyələşdirmə: Tədqiqat King Saud University, Riyadh tarafından Ongoing Research Funding programı əhatəsinda ORF-2026-2100 numarasıyla desteklenmiştir.
Veri və kod əlçatanlığı: Tədqiqatda BDD-OIA və nu-AD açıq benchmark'ları istifadə edilmişdir. Müəlliflər stratified subset manifest, sampling scriptleri, eğitim kodu, rule-engine şablonları və qiymətləndirmə scriptlerinin GitHub üzərindən sunulduğunu; LoRA uyarlanmış TinyLlama checkpoint'inin kabul sonrasında yayımlanacağını belirtmiştir.
Maraqlar toqquşması: Müəlliflər çıkar çatışması olmadığını beyan etmiştir.
Müəllif töhfələri: Habib Dhahri və Fahad Alotaibi kavramsallaştırmada; Habib Dhahri, Awais Mahmood və Mousa Jari metodde; Habib Dhahri yazılımda; dörd yazar təsdiqləməda; Habib Dhahri biçimsel analiz və məlumat tənzimləməde; Habib Dhahri və Mousa Jari tədqiqatda; Fahad Alotaibi və Awais Mahmood qaynaq sağlamada; Habib Dhahri ilk taslak və görselleştirmede; Fahad Alotaibi, Awais Mahmood və Mousa Jari inceleme/tənzimləməde; Awais Mahmood və Mousa Jari gxülasəimde; Fahad Alotaibi proje yönetimi və finansman ediniminde tapşırıq almıştır.
Bu Verianla məqaləsindeki memarlıq, tensor boyutları, kayıp fonksiyonları, eğitim ayarları, benchmark nəticələrı, ablasiyalar, səmərəliliklilik dəyərləri, doğal dil izah nəticələrı, stres testleri və məhdudiyyətlər incelenen qaynaq tədqiqatya dayanmaktadır. Bibliyoqrafik identiklik təsdiqləməsı xaricində xarici qaynaqlardan yeni bilimsel model sonucu və ya performans iddiası eklenmemiştir.
Əsas metodsel sərhəd: Tədqiqat BDD-OIA və nu-AD benchmark'larında dövrdışı model qiymətləndirməsi təqdim edir. Real araçta qapalı dövrə sürüş, sahə testi, uzun dörütubətli kullanım, inamlik sertifikatsyonu və ya fərqli ülke və trafik dağılımlarında müstəqil təsdiqləmə yapılmamıştır. Model əsas kimi statik görüntü/kamera karelerini kullanmaktadır və uzun dörütubətli zaman əsaslı reasoning mövcud memarlıqnin əsas parçası değildir.
Açıklanabilirlik sərhədi: LoRA-TinyLlama izah üreticisi ham vizual tokenləra birbaşa koşullandırılmamakta; proqnozlaşdırılan davranış və şərh etiketlərinden izah yaradırdır. Bu səbəbdən tədqiqat strukturlaşdırılmış qərarlara yönelik qərar səviyyəsində sədaqət nəticəsu təqdim edir; ham vizual sübuta yönelik səbəbli sədaqət sübutı təqdim etmir.
OSM qaynaq daxili tutarsızlık qeydi: Bölüm 3.3 Denklem (5) pooled query'yi bütün position-aware tokenlərın ortası kimi tanımlarken Algorithm 1'in 4. adımı yalnız seçilmiş top-K tokenlərın ortasını kullanmaktadır. Mənbə iki tanımı tək bir yekun tətbiq kimi uzlaştırmamaktadır.
Ablasyon sərhədi: V2 və V3 arasındaki değişiklik yalnız kamera embedding değildir; cyclic learning-rate schedule və eğitim bütçesi də değişmektedir. Mənbə bu nedenle V2→V3 kazancını camera embedding'in tək başına səbəbli etkisi kimi qiymətləndirməmektedir.
Model ölçüsü qeydi: Səmərəliliklilik cədvəlsundaki CrossAD 27,4 M dəyəri ilə TinyLLaMA-LoRA üçün verilen 4,51 M dəyər, dondayanulmuş təxminən 1,1 valyar parametreli TinyLlama əsas ağının bütün parametrelerini temsil etmez. 4,51 M yalnız eğitilebilir LoRA adapter parametreleridir.
F1 terminolojisi qeydi: BDD-OIA Cədvəl 6'da CrossAD'ın behaviour mean F1 dəyəri 0,716, overall behaviour F1 dəyəri 0,739'dayan. Daha sonrakı təbii dil izahı tartışmasında 0,716 dəyəri “behaviour-prediction accuracy” şəklində anılmıştır. Verianla məqaləsinde iki ölçüt ayrı tutulmuştur.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib