

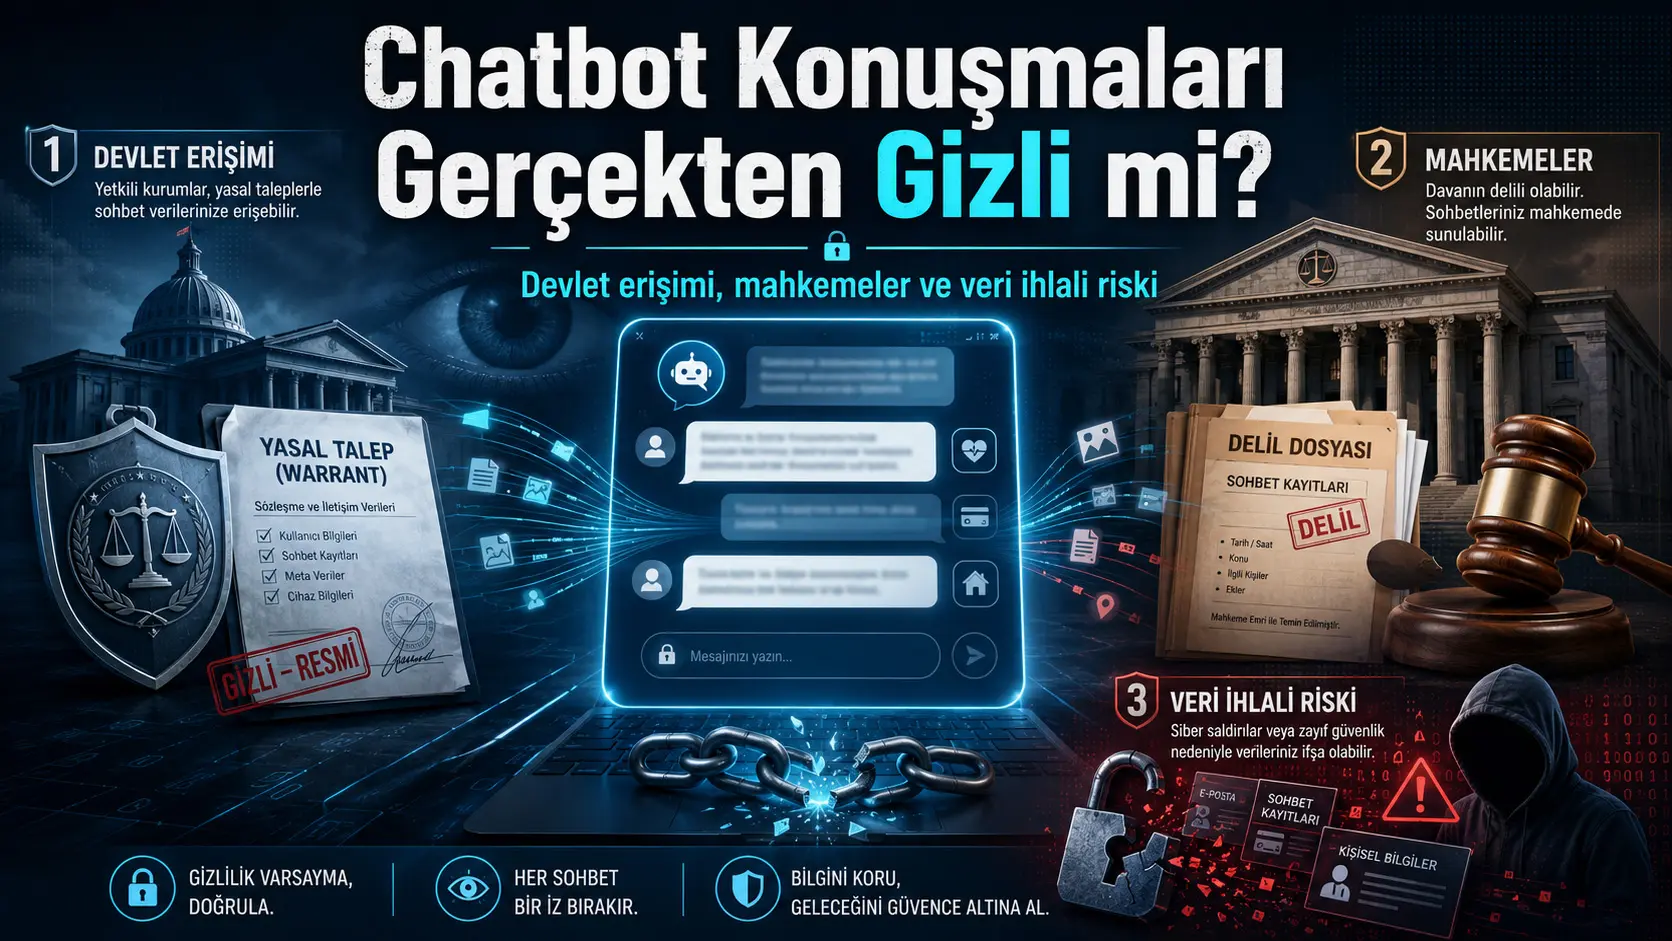
Utafiti huu wa sheria na sera ya umma ulioandaliwa na Theodore Christakis unachunguza ni katika hali gani mazungumzo yanayofanywa katika huduma za AI zinazolenga watumiaji, kama ChatGPT, Claude, Gemini, Grok na DeepSeek, yanaweza kutoka nje ya udhibiti wa mtumiaji. Mtafiti analinganisha sera za kampuni, ripoti za uwazi, maamuzi ya mahakama, sheria, matukio yaliyojitokeza hadharani na practices zinazoweza kuonekana za watoa huduma watano, na kubainisha njia nne kuu za access: provider kuripoti mazungumzo kwa law enforcement kwa hiari yake, serikali kudai data kwa njia za kisheria, mazungumzo kuombwa kama evidence katika lawsuit, na records kufichuka kutokana na cyberattack au corporate-security failure. Hitimisho kuu la study ni kwamba features za retention, memory, personalization, logging na connected tools zinazofanya chatbots ziwe useful pia hufanya conversations ziwe searchable, preservable, discoverable in court na vulnerable to theft katika attacks. Hata hivyo, research hii si experimental user study; ni ramani ya law-policy inayotegemea kwa kiasi kikubwa US law na developments zinazobadilika haraka za 2025–2026.
Mazungumzo na chatbot yanaweza kuhisiwa na user kama private thinking space. Lakini ukweli kwamba conversation inahifadhiwa technically katika systems za kampuni huipa legal character tofauti na kushiriki siri katika daily life au face-to-face. Record inaweza kuhifadhiwa kwa court order, kuombwa katika investigation kuhusu specific user, kuhitajika kama document katika lawsuit ambayo person ni party, au kuibiwa katika security breach.
Study inasema risks hizi haziwezi kutatuliwa kwa new laws pekee. Pamoja na legal rules, inahitajika data minimization, real deletion mechanisms, limited retention, least-privilege access, private-by-default sharing na architectures ambako hata provider hawezi kusoma conversation. Mtafiti anaeleza approach hii kama policy na technical architecture kufanya kazi pamoja, na anatoa recommendations 19 kwa providers, courts, regulators na lawmakers.
Kwa nini watu huwaambia chatbots mambo mengi ya faragha?
Starting point ya study ni kwamba consumer chatbots hazitumiki kama search engine ya kawaida au document editor. Watu wanaweza kuwaambia systems hizi symptoms za afya, fears, debts, relationships, legal problems, professional plans na thoughts ambazo bado hazijakomaa. Conversation interface humpa user hisia kwamba kuna interlocutor anayesikiliza na kujibu.
Hata hivyo, tofauti na baadhi ya mazungumzo na doctor, lawyer, spouse au psychologist, general-purpose chatbot conversation haipati automatically professional secrecy, attorney–client confidentiality au special “AI privilege”. Kile user anachoandika ni digital record inayohifadhiwa katika system ya service provider. Kwa hiyo protection ya conversation mara nyingi hutegemea zaidi provider retention architecture, contracts, security practices na settings zilizochaguliwa na user kuliko special legal privilege.
Njia nne za risk zilizounganishwa na research
Contribution ya kipekee ya study ni kutathmini katika system moja njia nne za access ambazo mara nyingi huchunguzwa tofauti. Same conversation inaweza, kutegemea conditions, kuwa exposed kwa zaidi ya njia moja kwa wakati mmoja.
| Njia ya access | Jinsi conversation inavyotoka nje ya control ya user | Main risk |
|---|---|---|
| Voluntary provider reporting | Kampuni inaamua kwamba kuna serious na imminent danger katika conversation na kuwasiliana na law enforcement. | Ambiguous au context-stripped statements kutafsiriwa kama real threat; criteria na error rates kutowekwa wazi kwa umma. |
| Compulsory government access | Account na conversation data zinaombwa kupitia court order, search warrant, subpoena, preservation request au intelligence authority. | Records ambazo user alidhani zimefutwa kuwekwa chini ya legal preservation; badala ya specific user, kutafutwa kila mtu aliyeandika content fulani. |
| Document production katika litigation | Conversations zinaombwa kutoka provider au directly from user kama evidence ya dispute. | Records za millions of people wasiokuwa related to case kuchunguzwa, au chatbot history ya person kujitokeza dhidi yake katika own divorce, employment au commercial case. |
| Cyberattack na security error | Records zinafichuka kupitia database vulnerability, wrong sharing setting, stolen account, malware, insider access au supplier vulnerability. | Severe privacy loss kwa sababu conversation ina identity data pamoja na thoughts na life context ya person. |
Njia ya kwanza: Kampuni kuripoti mazungumzo kwa law enforcement
Chatbot provider kuzuia harmful content na kumripoti user kwa law enforcement si hatua ile ile. Content moderation inaweza kuishia model kutokujibu au account restriction. Law-enforcement reporting inamaanisha conversation kuhamishwa kwa public authority nje ya kampuni.
Study inachunguza incidents za 2025–2026 zilizojulikana kwa umma, kama Tumbler Ridge attack nchini Canada, Florida State University attack na armed police intervention mjini Strasbourg, France. Examples hizi zinaonyesha kwamba chatbot conversations si hypothetical issue tena kwa threat assessment na law-enforcement communication. Hata hivyo, katika baadhi ya incidents, exact route ya information flow haiwezi kuthibitishwa kutoka public records. Kwa hiyo mtafiti anauliza si tu kama reports zipo, bali pia transparency ya decision-making process.
Main problem ni difficulty ya kuelewa intent katika chatbots. User anaweza kutumia maneno sawa kueleza real plan, fiction text, role-play scenario, expression of anger, curiosity au harmless research. Automated classifier na subsequent human review haziwezi kufanya distinction hii perfectly kila wakati.
Ingawa katika nchi nyingi kuna clearer reporting duties na established processes kuhusu child sexual abuse material, thresholds za general violence threats kuripotiwa kwa police mara nyingi hazielezwi. Kuna significant data gap kuhusu providers review conversations ngapi, refer ngapi kwa law enforcement, reports ngapi ni false alarms, na katika conditions gani user anaarifiwa.
Njia ya pili: Serikali kuomba chatbot records
Public authorities kuomba data kutoka digital service providers si jambo jipya. Subscriber information, traffic records na content data zimekuwa zikiombwa kwa muda mrefu kupitia tools kama subpoena, court order na search warrant. Jambo jipya ni tools hizi kutumika kwa chatbot records ambako watu huandika inner thoughts zao kwa undani.
Katika study, legal-access tools zinaonyeshwa kama ladder kutoka low-intensity account-information requests hadi more intrusive demands for conversation content. Scope ya demand, required legal threshold, kama user notified, kama provider challenges overbroad demands, na jinsi cross-border process inavyoendeshwa ni main elements za ladder hii.
Deletion button inaweza isisimamishe legal preservation request
Investigating authority inaweza kumwomba provider kuhifadhi data ambayo inaweza kuombwa baadaye. Preservation request kama hiyo inaweza kusababisha record kuhifadhiwa kwa legal reasons licha ya temporary-chat au deletion settings za user. Conversation isiyoonekana kwenye interface haiwezi kudhaniwa kuwa imeondolewa simultaneously kutoka all operational systems, security logs, backups na review queues za provider.
Moja ya important implications za study ni kwamba kila product feature inayoongeza retention period pia huongeza amount of data inayoweza kufikiwa na government access. Memory, conversation history, connected applications na agent action logs zinaweza kuwa si personalization tools tu bali pia “surveillance multiplier” kwa legal demands.
Reverse prompt search warrant ni nini?
Katika traditional search request, serikali kawaida hulenga known user na kuomba account ya person huyo. Katika reverse prompt search, starting point si person bali content: inatafutwa ni nani aliyeandika specific phrase, method, name au topic.
Katika first publicly reported federal example iliyoelezwa na study, investigators walijaribu kutambua one account kupitia two specific prompts. Mtafiti anasisitiza kwamba narrow example hii lazima itenganishwe na mass requests zinazotafuta broad semantic patterns katika entire user database. Type ya pili huibua maswali mazito zaidi ya generality, proportionality na privacy protection kwa sababu inaanza kwa kuscan large user population badala ya specific known suspect.
Users nje ya US na foreign intelligence
Study pia inatathmini position ya persons outside the United States chini ya foreign-intelligence law. Kwa interpretation ya mtafiti, FISA Section 702 hufanya kazi kupitia selectors zinazohusishwa na specified foreign targets, kwa hiyo haifai naturally kwa generalized content search katika entire chatbot user base. Hata hivyo, accessible memory record au agent-action history ya specific person aliyelengwa validly inaweza kuhitaji different legal assessment.
Assessment hii haijawasilishwa kama settled court ruling. Mtafiti anasema wazi kwamba interpretation ya law ni contested, baadhi ya practices zinabaki secret, na conclusion yake inapaswa kusomwa cautiously.
Kwa nini memory feature ni sensitive zaidi kuliko normal conversation history?
Normal chat record inaonyesha user aliandika nini na model ilijibu nini. Persistent memory inaweza kuchagua preferences, health concerns, family situation, professional goals, fears na plans kutoka conversations nyingi na kuzibadilisha kuwa structured profile.
Profile hii inaweza kuwa personal dossier rahisi kutafutwa kuliko raw conversation history. Social-media profiles mara nyingi hufanya inference kutoka observed behaviors kama clicks, location na purchases, wakati chatbot memory inaweza kujumuisha private thoughts ambazo person ameiambia system directly.
Agent features hupeleka risk hatua moja mbele. Ikiwa system inaweza kusoma email, kufikia files, kusimamia calendar, kufanya action katika websites au kutuma message kwa niaba ya user, records zinaweza kuwa na si thought tu bali pia actions zilizofanywa based on that thought. Hivyo intent, automated action na real-world result zinaunganishwa katika same record chain.
Njia ya tatu: Chatbot conversations kuwa evidence katika court
Moja ya examples muhimu zaidi katika study ni dispute kuhusu document production katika copyright case kati ya The New York Times na OpenAI. Kulingana na research, katika Aralık 2025 production ya 20 million de-identified ChatGPT conversations iliamriwa; kufikia Mart 2026, additional pool iliyotakiwa kureview ilifanya total scope kufikia 108 million conversations.
Sehemu kubwa ya conversations hizi ni za ordinary users ambao si parties to the case. Removal ya identifying information inaweza kupunguza risk; lakini combination ya unique health event, workplace, date, location, relationship na life details inaweza kufanya person re-identifiable. Kwa hiyo pseudonymization au deletion ya direct identity fields haitoi necessarily true anonymity katika kila case.
Hakuna general “AI confidentiality privilege”
Study inaeleza kwamba legal questions mbili tofauti mara nyingi huchanganywa:
- Kama general consumer chatbot records zilizopo kwa provider zinalindwa kutoka court kwa special legal privilege,
- Kama person kutumia AI wakati wa kujiandaa kwa own case kunaondoa work-product protection ambayo normally angekuwa nayo.
Kwa question ya kwanza, current law haitambui general “AI privilege” inayolinda all consumer records za provider. Kwa question ya pili, early US decisions zimegawanyika.
Katika Heppner, court ilitazama information iliyotolewa kwa publicly available AI platform kama disclosure to a third party na kuchukua stricter approach dhidi ya attorney–client na work-product protection. Katika Warner v. Gilbarco, iliyotolewa one week earlier, AI ilionekana kama tool used in litigation preparation badala ya person, na court ikaamua kwamba work-product protection haipotei merely because ChatGPT was used.
Split hii bado haijasuluhishwa. Kama chatbot itaonekana kama tool kama word processor, cloud storage na legal database, au separate recipient ambaye user anamfunulia information, itakuwa central issue katika future decisions.
Protective court orders hupunguza risk lakini haziiondoi
De-identification, closed review environments, access controls na protective court orders zinaweza kuzuia random dissemination ya millions of conversations. Hata hivyo records zinaweza kuhamishwa kwa law firms, experts, e-discovery platforms, review databases na service providers.
Pia quotations, statistical analyses, expert reports, machine-readable subsets au embedding representations zinaweza kuzalishwa kutoka original conversations. Hata main records zikifutwa baadaye, baadhi ya derivative materials zinaweza kuendelea kuwepo. Kwa hiyo study inapendekeza courts kudhibiti si initial data transfer tu, bali retention na use ya secondary materials generated from data.
Je, hali kama hii inaweza kutokea Europe na Türkiye?
Kulingana na mtafiti, combination ya broad pretrial discovery culture nchini US na kutokuwepo general federal data-protection law inafanya iwe rahisi zaidi kuomba millions of third-party conversations kutoka provider. Mass provider order ya aina hiyo ni harder to replicate kwa same form katika European legal systems.
Kwa upande mwingine, ni realistic zaidi kwamba person nchini Europe anaweza kulazimika kutoa chatbot conversations chini ya own control katika litigation ambayo yeye ni party. Study inatoa examples za disclosure rules katika England and Wales na specific document-production mechanisms katika France na Germany. Data-protection law haikatazi automatically demands kama hizi; inahitaji balance kati ya scope, necessity na rights of parties.
Study haichunguzi Turkish law. Hata hivyo same basic question ni muhimu katika Turkish law pia: Katika person’s own divorce, employment, commercial, criminal au intellectual-property dispute, chatbot conversation inaweza kutathminiwa kama electronic evidence chini ya conditions gani? Answer inategemea nature ya concrete case, namna data ilivyopatikana, lawfulness na applicable procedural rules.
Njia ya nne: Data breaches, account takeover na insider access
Tofauti ya chatbot records kwa security si tu kwamba zina sensitive data. Records hizi zinaunganisha health, family, money, fear, intent, timeline na personal reasons katika one narrative. Hata identity fields ziondolewe, context ya conversation inaweza kumfanya person au close circle yake identifiable.
Study inaweka public incidents hadi sasa katika groups kadhaa:
- Open databases na software bugs,
- Sharing designs zinazofanya private conversation accidentally public,
- Data leakage kupitia browser, extension au supply chain,
- Tracker na telemetry tools katika provider sites kufikia sensitive data,
- Account credentials zilizoibiwa kwa malware,
- Employees kuweka company secrets katika publicly available chatbots,
- Overbroad employee, contractor na vendor access.
Katika finding iliyotolewa na Group-IB mwaka 2023, iliripotiwa kwamba stored ChatGPT account credentials kutoka 101.134 devices zilizo infected na information-stealing malware zilipatikana katika illicit markets. Incident hii si breach ya OpenAI infrastructure; ni compromise ya user devices. Hata hivyo ikiwa account ina conversation history, memory, uploaded files na connected services, stolen password inaweza kutoa access si kwa account tu bali kwa long-term private-life record ya person.
Samsung employees kuweka source code, test data na meeting content katika ChatGPT kwa work purpose pia si attack dhidi ya provider. Incident hii inaonyesha “shadow AI” risk inayotokea authorized user anapoingiza corporate secret mwenyewe kwenye tool anayoona useful.
Agents huunda attack surface mpya
Chatbot inayozalisha response inaweza kupokea na process sensitive text. Agentic system inaweza pia kufanya actions katika other services. Hidden instruction katika malicious web page likichukuliwa na agent kama command, overly broad permissions, au weaknesses katika memory na document-retrieval systems vinaweza kusababisha si kusomwa kwa data tu bali pia exfiltration au unwanted action kufanywa kwa niaba ya user.
Kwa hiyo research inapendekeza agent permissions zipunguzwe kwa least-privilege principle, short-lived access tokens zitumike, user confirmation ipatikane kwa high-impact actions, na special protection dhidi ya indirect prompt injections itengenezwe.
Kwa nini reliability ya deletion ni muhimu?
User kufuta conversation kwenye interface haimaanishi lazima content imeondolewa kutoka all operational systems. Copy ya chat inaweza kuwa kwenye security log, customer-support record, analytics event, quality-review dataset, backup au vendor system.
Kulingana na study, ili deletion iwe trustworthy, maswali manne lazima yajibiwe: Conversation ilisafirishwa wapi, nani aliweza kusoma plaintext, copies ngapi zilitengenezwa, na copies hizo zilihifadhiwa kwa muda gani? Ikiwa deletion inaondoa main record kwenye user interface pekee, significant part ya privacy surface inaendelea kuwepo.
Sealed Mode: Conversation ambayo hata provider hawezi kusoma
“Sealed Mode” iliyopendekezwa na mtafiti ni architectural approach inayoweza kuitwa Hali Iliyofungwa kwa Kiswahili. Lengo ni kulinda highly sensitive conversations si kwa contract au company promise pekee, bali kwa technical design.
Wakati study ilikuwa ikiandaliwa kwa publication, Meta iliripotiwa kutangaza tarehe 13 Mayıs 2026 confidential mode kwa conversations na Meta AI ndani ya WhatsApp, based on trusted execution environment. Katika system hii, conversation inaprocessiwa katika hardware-backed environment ambako provider hawezi kusoma plaintext. Mtafiti anaiona kama first mass-market example ya privacy by design katika consumer chatbots.
Conversation ambayo provider hawezi kusoma huwa harder to report spontaneously to law enforcement, harder to search by content, harder to obtain from provider through court process, na harder to steal kutoka centralized plaintext database. Lakini same architecture pia inapunguza uwezo wa provider kuona dangerous conversations, kufanya content-based safety review na intervene in emergency.
Kwa hiyo Sealed Mode haisuluhishi problems zote peke yake. Additional mechanisms zinahitajika, kama in-model safety boundaries, classifiers zinazo-run inside sealed environment, crisis-resource referrals, abuse rate limits na clear accountability rules. Approach ya study si technical architecture kuchukua nafasi ya legal na institutional policy; zote zinapaswa kufanya kazi pamoja.
Maswali makuu yanayojitokeza kwa Türkiye
Ingawa study haitathmini Turkish legislation, inaibua concrete issues zinazohitaji majibu nchini Türkiye:
- Chatbot conversations zinaweza kuwa na categories zipi za personal na special-category data chini ya KVKK?
- Providers huhifadhi conversations, memory profiles na agent-action logs kwa muda gani?
- Deletion request inatumika pia kwa backups, security logs na derivative datasets?
- User anapewa information gani kuhusu government requests kwa foreign providers na cross-border data transfers?
- Uwasilishaji wa chatbot history kama electronic evidence katika courts unapaswa kufungwa na conditions zipi za lawfulness na proportionality?
- Lawyers, healthcare workers, engineers, public officials na company employees hawapaswi kuingiza information gani kabisa katika general-purpose chatbots?
- AI-use policy katika public institutions na businesses inajumuisha memory na connected-app features?
- Je, high-confidentiality work modes ambazo hata provider hawezi kusoma zinapatikana kwa users nchini Türkiye?
Umuhimu wa questions hizi hautokani na personal privacy pekee. Company secrets, public data, legal strategy, health information na critical-infrastructure details zinaweza pia kuingizwa katika same general-purpose systems. Kwa hiyo chatbot privacy inapaswa kuonekana si tu kama individual data-protection issue bali pia corporate information-security na national digital-sovereignty issue.
Hitimisho zinazoungwa mkono na study
- Retention, memory, logging, personalization na connected tools zinaweza kufanya same conversation iwe exposed kwa multiple legal na technical access paths.
- Chatbot conversations hazipati automatically same privilege kama conversations na doctor, lawyer au therapist chini ya current law.
- Data ambayo users wanafikiri imefutwa inaweza kuhifadhiwa kwa legal preservation requests au operational copies.
- Reverse prompt searches huunda broader privacy na proportionality concerns kuliko requests zinazolenga specific user.
- Removal ya identifying information haiondoi kabisa re-identification risk katika contextual na unique conversations.
- Agent, memory na connected-app features huongeza both scope of legal access na impact of cyberattack.
- Data minimization, real deletion, access segmentation na provider-unreadable architectures zinaweza kutoa stronger technical protection kuliko policy promises.
Hitimisho ambazo study haithibitishi au haichunguzi moja kwa moja
- Haithibitishi kwamba all chatbot providers husoma user conversations regularly au huzishare systematically na law enforcement.
- Haitoi independent technical audit inayoonyesha kwamba specific provider ni definitely safer kuliko others.
- Si epidemiological au statistical study inayopima prevalence ya chatbot data breaches katika society.
- Haifikii conclusion kwamba all reverse prompt demands zinazojadiliwa nchini US ni unlawful.
- Haidai kwamba Sealed Mode imesuluhisha safety, child-protection na emergency-intervention problems completely.
- Haibainishi katika cases zipi nchini Türkiye chatbot records zitakuwa definitely admissible evidence.
- Haih guarantee kwamba decisions za 2025–2026 zitatumika kwa same direction katika future.
Nguvu na mapungufu
Nguvu kubwa ya study ni kuunganisha risks zinazochunguzwa katika disciplines tofauti—company reporting, government access, litigation process na cybersecurity breach—katika one data lifecycle. Comparison ya policies za five major providers, interpretation ya legal decisions pamoja na technical architecture, na recommendations 19 concrete zinaifanya research ipite simple problem identification.
Mtafiti anaweka wazi limits za position yake. Study ni comprehensive but external assessment ya US law kutoka kwa European legal scholar; haijawasilishwa kama opinion ya US-licensed legal practitioner. Chinese law, criminal procedures za EU Member States, United Kingdom national-security law na regimes za other countries hazijafunikwa kwa undani.
Review haitumii systematic-review methodology. Hakuna reproducible literature-search protocol yenye database queries, inclusion–exclusion criteria na source-quality scoring. Kwa kuwa baadhi ya company practices zinaonekana tu kupitia public policies na transparency reports, internal decision processes, error rates na real access powers haziwezi kuthibitishwa kutoka nje.
Pia law na product architecture hubadilika haraka. Product features, cases, data-retention choices na regulatory interpretations zinazoonekana current kufikia Haziran 2026 zinaweza kubadilika baadaye. Kwa hiyo study inapaswa kusomwa si kama permanent na complete legal encyclopedia, bali kama detailed status map ya rapidly evolving field.
Mbinu na Matokeo ya Utafiti
Research design
Study haitumii experiment, survey au statistical sample. Qualitative comparative law na policy analysis imetumika. Same five consumer chatbot providers wametathminiwa kupitia public privacy policies, terms of use, transparency reports, observed product behavior na legal events.
| Method component | Ilitumika vipi katika study? | Interpretation limit |
|---|---|---|
| Provider comparison | Public policies na reports za ChatGPT, Claude, Gemini, Grok na DeepSeek zililinganishwa. | Internal practices ambazo hazijawekwa public haziwezi kuonekana directly. |
| Legal-doctrine analysis | US criminal procedure, search warrants, electronic-communications rules, FISA Section 702, document production na privilege doctrines zilichunguzwa. | Baadhi ya decisions ni new, contested au zinaweza kubadilika through appeal. |
| Case review | Examples za law-enforcement reporting, mass conversation production, account takeover na corporate data leakage zilianalysis. | Katika some incidents, all technical na institutional details si public. |
| European comparison | GDPR, England and Wales disclosure system na document-production routes katika France na Germany zilitathminiwa. | Criminal, civil na administrative procedure ya every European country haikuchunguzwa separately. |
| Architectural assessment | Retention, memory, agents, trusted execution environments na legal consequences za Sealed Mode zilichunguzwa together. | Hakuna independent penetration test au source-code audit iliyofanywa. |
Viashiria vikuu vya nambari
| Indicator | Value reported katika study | Ina maana gani? |
|---|---|---|
| Major consumer chatbot providers examined | 5 | ChatGPT, Claude, Gemini, Grok na DeepSeek zililinganishwa. |
| Change in government requests reported to OpenAI | 6 katika first half of 2023; 309 katika second half of 2025 | Requests zilikua haraka kutoka low baseline; growth inapaswa kutafsiriwa pamoja na expansion ya user base. |
| Conversation pool sought katika New York Times–OpenAI dispute | Kwanza 20 million, kisha additional 88 million; total 108 million | Inaonyesha kwamba conversations za users ambao si parties to the case zinaweza kuwa subject ya large-scale document production. |
| Stored ChatGPT credentials found on devices linked to information-stealing malware | 101.134 devices | Inaonyesha access ya chat history inaweza kutokea kupitia compromise ya user device hata bila provider-infrastructure breach. |
| Total policy na architecture recommendations | 19 | Recommendations zimegawanywa katika groups nne: company reporting, government access, litigation processes na cybersecurity. |
Values hizi si experimental results. Ni date-specific indicators zilizokusanywa kutoka transparency reports, court records na publicly reported incidents zilizochunguzwa na researcher.
Recommendations kwa voluntary provider reporting
- Kampuni zinapaswa kuchapisha kwa aggregated form idadi na reasons za law-enforcement reports zinazofanywa on their own initiative.
- Automated na human decision criteria zinazopeleka conversation kwenye reporting pipeline zinapaswa kufunguliwa kwa independent audit.
- Legal preservation, conversation ambayo user amechagua kuhifadhi, na data inayohifadhiwa na provider kwa operational purposes zinapaswa kutenganishwa.
- Encryption na provider-inaccessible architectures zinapaswa kutengenezwa kwa kuzingatia context na risk level ya chatbot use.
- User anapaswa kuelekezwa wazi relationship yake na chatbot ni nini na haifanani na professional-confidentiality relationships zipi.
Recommendations kwa compulsory government access
- Transparency reports zinapaswa kutenganisha government requests for chatbot data, reverse prompt searches, memory records na agent-action logs katika separate categories.
- Providers wanapaswa kutangaza public kwamba watapinga overbroad “who wrote this prompt?” demands zinazoscan entire user base.
- Memory profiles na agent-action records zinapaswa kutazamwa kama more sensitive legal-data categories tofauti na ordinary chat text.
Recommendations kwa document production na evidence katika courts
- Retention, memory na Sealed Mode features zinapaswa kutengenezwa kwa kuzingatia litigation na discovery risks.
- Technical na institutional architecture inayoweza kuunda basis ya narrow AI confidentiality privilege inapaswa kutengenezwa.
- Decision split kuhusu kama AI use inaondoa work-product protection katika litigation preparation inapaswa kutatuliwa.
- Chatbot-specific necessity na proportionality guidelines zinapaswa kuandaliwa kwa demands zinazohusisha millions of third-party conversations.
- De-identification inapaswa kuimarishwa; secondary materials kama quotations, derivative datasets, expert analyses na embedding representations zinapaswa pia kudhibitiwa.
- Users wanapaswa kuambiwa kwamba chats zao zinaweza kuombwa katika own disputes na wapewe real retention–deletion control.
Recommendations kwa cyber threats, insider access na data breaches
- Chatbot conversations zinapaswa kuchukuliwa by default kama highly sensitive data class.
- Breach blast radius inapaswa kupunguzwa kupitia less data retention, system segmentation na technical controls kama Sealed Mode.
- Least-privilege principle inapaswa kutumika kwa employees, contractors, vendors na AI agents.
- Sharing links zinapaswa kuwa private by default; severity ya breach ibainishwe si kwa identity fields kama name na email pekee, bali pia kwa content na context ya conversation.
- Kampuni zinapaswa regularly disclose si government requests tu, bali pia AI-specific security incidents na data breaches.
Tafsiri jumuishi ya main finding
Njia nne za access si alternatives. Same retention choice inaweza kuwezesha later law-enforcement cooperation, kuongeza amount of data inayoweza kutolewa court, na kuongeza data pool inayoweza kuibiwa na attackers. Memory feature ni simultaneously personalization tool, surveillance target, litigation evidence na data-breach asset.
Kwa hiyo study inaonyesha kwamba chatbot privacy haiwezi kutathminiwa kwa swali “does the company sell data?” pekee. Retention period, teams zenye plaintext access, vendor chain, backups, sharing design, policy ya challenging legal demands, memory na connected apps zinapaswa kuchunguzwa together.
Managerial conclusion ya study ni kwamba company policy na technical architecture ni two separate protection layers. Policy inahusu contracts, transparency, data-retention decisions, access permissions na vendor management. Architecture inaweza kuhakikisha kwamba certain data haipo from the start katika form inayoweza kusomwa au centrally searched. Strong privacy system haiwezi kutegemea one of these layers pekee.
Dokezo la Chanzo na Mbinu
Jina la asili la study:You Trust Your Chatbot With Everything. Should You? Part 2: Governments, Courts, and the Battle Over Your Chatbot Conversations
Author: Theodore Christakis.
Author order na contribution status: Study ni single-authored. Hakuna equal first authorship au equal contribution statement. Separate corresponding-author information haijatajwa.
Institutional affiliations: University Grenoble Alpes; Cross-Border Data Forum; Future of Privacy Forum; “Responsible AI: Design, Regulation and Conformity” work ndani ya Multidisciplinary Institute in Artificial Intelligence.
Source type: Comparative-law na public-policy research report.
Series: AI Regulation Papers, 2026-06-1.
Publication platform na original publisher: AI-Regulation.com.
Publication date: Haziran 2026; official study page ina date 8 Haziran 2026.
DOI: Version hii haina DOI information.
Peer-review status: Study si research article iliyochapishwa katika peer-reviewed academic journal. Independent academic peer review haikuweza kuthibitishwa kutoka text au official publication page.
Financial support: Study inasema ilipokea support ndani ya MIAI @ Grenoble Alpes kupitia ANR-23-IACL-0006 na ndani ya Interdisciplinary Project on Privacy katika Cybersecurity PEPR kupitia ANR 22-PECY-0002 IPOP.
Conflict of interest: Hakuna separate conflict-of-interest statement iliyopatikana katika text.
Official link:Official AI-Regulation.com study page
Cover image: Cover ina human figure ambaye face imefunikwa na evidence file iliyoandikwa “Exhibit A”, ikisimbolize private chatbot conversations kubadilika kuwa case-file material na reviewable evidence. Image imeelezwa kuwa designed na directed na author na prepared kwa generative-AI assistance. Author anaruhusu reproduction kwa non-commercial use kwa condition ya full attribution na citation ya study source.
Maelezo haya ya Kiswahili yameandaliwa kwa msingi wa study text, comparative tables, footnotes, case assessments na final recommendations. External sources zilitumika tu kwa bibliographic verification ya title, author, institutional affiliation, publication date, series na official study link; hakuna external scientific au legal finding iliyoongezwa.
Study inategemea predominantly US law na inatathmini rapidly evolving field as of Haziran 2026. Explanations katika text ni general scientific na legal information; si substitute ya legal advice kwa specific lawsuit, investigation au personal-data dispute.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *