

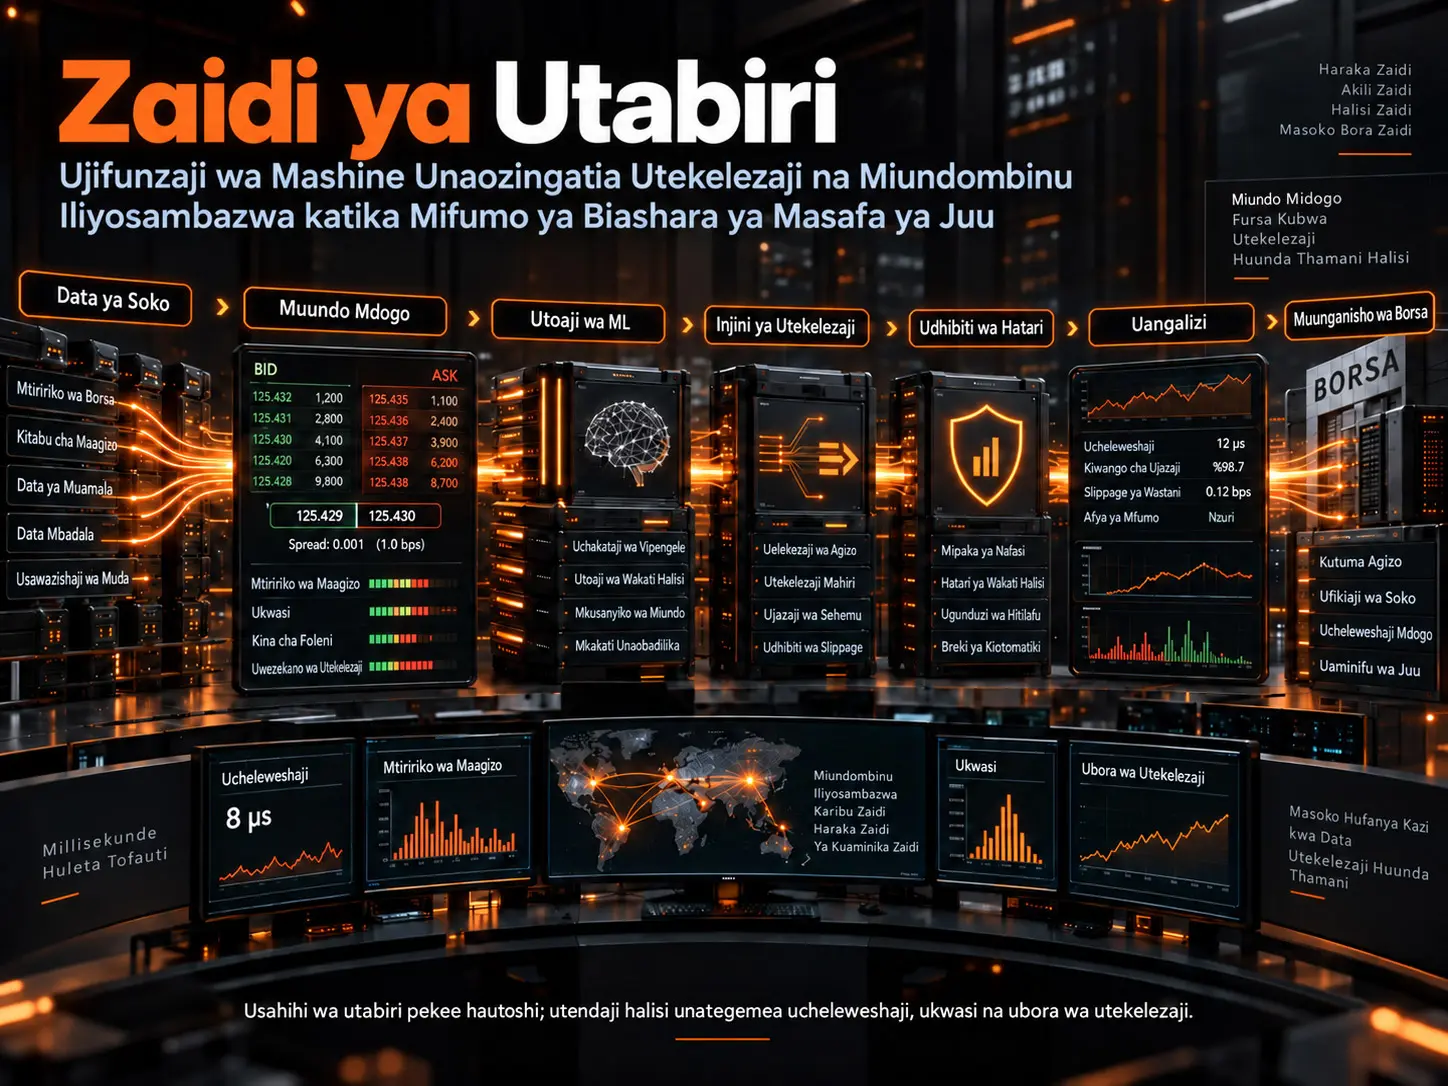
Katika mifumo ya kisasa ya biashara ya masafa ya juu, kutengeneza utabiri sahihi wa bei ni hatua ya mwanzo tu ya muamala wenye faida. Fursa iliyotabiriwa inaweza kutoweka ndani ya millisekunde chache au hata muda mfupi zaidi; agizo linaweza kurudi nyuma kwenye foleni, ukwasi unaolengwa ukaisha, spread ikapanuka, mfumo ukachelewa au utabiri sahihi ukatekelezwa kwa bei isiyofaa na hivyo kupoteza thamani yake ya kiuchumi.
Utafiti huu hauchukulii HFT kama “algoriti inayotabiri bei” pekee, bali kama mfumo wa udhibiti wa wakati halisi uliosambazwa na wenye mzunguko uliofungwa. Katika mfumo huu, upokeaji wa data za soko, uundaji upya wa kitabu cha maagizo ya kikomo, vipengele vya muundo mdogo, inference ya ujifunzaji wa mashine, injini ya utekelezaji wa maagizo, udhibiti wa hatari, exchange gateway na miundombinu ya observability hufanya kazi kwa pamoja.
Muundo mkuu wa performance wa chanzo ni:
\[ P_{\mathrm{realized}} = f(L,E,Q,M,I,R) \]
. Hapa \(L\) inawakilisha determinism ya latency, \(E\) ubora wa execution, \(Q\) mienendo ya foleni na fill probability, \(M\) taarifa ya microstructure ya soko, \(I\) ufanisi na uwezo wa kuongeza kiwango wa miundombinu, na \(R\) ustahimilivu wa kiutendaji.
Wazo kuu la mkabala huu ni kwamba thamani ya kiuchumi ya ishara yenye nguvu kitakwimu huhifadhiwa tu kwa kiwango ambacho inaweza kutekelezwa kwa kweli. Chanzo kinaeleza hili kwa uhusiano wa dhana:
\[ E_{\mathrm{realized}} = \alpha \times P_{\mathrm{fill}} \times \eta_{\mathrm{latency}} \times L_{\mathrm{access}} \]
. \(\alpha\) inawakilisha faida ya bei iliyotabiriwa, \(P_{\mathrm{fill}}\) uwezekano wa agizo kutekelezwa, \(\eta_{\mathrm{latency}}\) ufanisi wa latency na \(L_{\mathrm{access}}\) ukwasi unaoweza kufikiwa.
Kwa hiyo, hitimisho kuu la utafiti ni tofauti na swali “ni modeli gani ya ML iliyo bora zaidi?”: Katika HFT ya kisasa, faida ya kiuchumi haitokani na modeli moja, bali hutokana na utabiri, execution, microstructure na miundombinu kufanya kazi kwa upatanifu wa wakati.
Kwa nini HFT ya kisasa si tatizo la utabiri pekee?
Modeli ya ujifunzaji wa mashine inaweza kuwa imetabiri kwa usahihi mwelekeo wa bei wa muda mfupi. Lakini hali ya soko inaweza kubadilika katika muda kati ya utabiri na agizo kufika kwenye exchange. Katika hali hiyo, mafanikio ya kitakwimu ya modeli hayageuki kuwa thamani halisi ya kiuchumi.
Chanzo kinaonyesha kupungua kwa alpha ya muda mfupi kwa sababu ya latency kwa modeli ya dhana ifuatayo:
\[ \alpha(t)=\alpha_0e^{-\lambda t} \]
. \(\alpha_0\) ni faida ya utabiri wakati ishara inapotengenezwa kwa mara ya kwanza, \(\lambda\) ni kiwango cha alpha decay na \(t\) ni latency ya execution.
Usemi huu si kazi ya universal decay iliyokalibishwa kwa data ya kihalisia katika exchange maalum. Ni modeli iliyorahisishwa inayowakilisha kihisabati tatizo la uhandisi ambalo thamani ya ishara huharibika kadiri muda unavyopita.
Kwa Nini Ishara ya HFT Inaweza Kutokuletea Faida Hata Ikiwa ni Sahihi?
Kwa sababu usahihi wa utabiri na usahihi wa execution si kitu kimoja. Baada ya kutabiri mwelekeo sahihi, ikiwa agizo halitekelezwi katika kiwango cha bei kilicholengwa, spread ikivukwa, kipaumbele cha foleni kikapotea au ukwasi ukatoweka, alpha iliyotabiriwa inaweza kumezwa na execution friction.
Mgawanyo wa dhana wa chanzo ni:
\[ PnL_{\mathrm{realized}} = PnL_{\mathrm{theoretical}} - Execution\ Friction \]
.
Execution friction kimsingi hujumuisha:
- gharama ya spread,
- slippage,
- mabadiliko ya bei yanayosababishwa na latency,
- market impact,
- hasara ya queue-position,
- ada za exchange,
- na ukwasi usioweza kufikiwa
.
Muundo wa Mwisho-hadi-Mwisho wa Mfumo wa Kisasa wa HFT Unajengwaje?
Mnyororo mkuu wa usanifu unaotolewa na utafiti ni:
Market Data → Feed Handlers → Stream Processing → Feature Engineering → Machine Learning Inference → Execution Engine → Risk Controls → Exchange Gateway → Monitoring & Observability
.
Hapa kila hatua huunda thamani na pia huongeza latency. Lengo la usanifu wa mfumo si kuharakisha kila kipengele kivyake tu, bali pia kudhibiti latency variance na gharama ya uratibu katika mnyororo mzima.
Latency ya jumla ya execution imegawanywa katika chanzo kama:
\[ T_{\mathrm{total}} = T_{\mathrm{network}} + T_{\mathrm{serialization}} + T_{\mathrm{inference}} + T_{\mathrm{routing}} + T_{\mathrm{exchange}} \]
.
Modeli hii inaonyesha ukweli muhimu: modeli ya ML iliyoharakishwa kwa 5 µs inaweza kutotoa faida inayotarajiwa kwa mfumo mzima ikiwa hatua nyingine ina latency ya foleni inayobadilika ya 100 µs.
Kwa Nini Usanifu wa Moduli Unatumika Katika HFT?
Chanzo kinagawanya usanifu wa kisasa wa HFT katika mifumo midogo yenye kazi maalum badala ya monolith moja kubwa.
| Mfumo mdogo | Jukumu kuu |
|---|---|
| Feed Handler | Kupokea na kufasiri data ya soko |
| Order Book Engine | Kujenga upya kitabu cha maagizo ya kikomo kwa wakati halisi |
| Feature Engine | Kuhesabu vipengele vya microstructure |
| ML Inference | Kutengeneza ishara ya muda mfupi yenye msingi wa uwezekano |
| Execution Engine | Kuunda agizo, kulielekeza na kusimamia mzunguko wake wa maisha |
| Risk System | Inventory, exposure na mipaka ya usalama |
| Telemetry | Kufuatilia latency, afya ya mfumo na ubora wa execution |
Mgawanyo huu unaweza kuwezesha fault isolation, matengenezo, deployment huru na scaling ya kuchagua. Hata hivyo, utafiti pia unakubali kwamba kugawanya kupita kiasi kuwa microservices kunaweza kuongeza mzigo wa mawasiliano na synchronization.
Kwa hiyo, pendekezo la mwisho ni mkabala wa selective modularity: latency-critical hot path huwekwa kuwa thabiti na deterministic kadiri iwezekanavyo, huku vipengele kama utafiti, analytics na telemetry vikifungamanishwa kwa kulegea zaidi.
Kwa Nini Market Data Pipeline ni Sehemu ya Msingi ya HFT?
Katika mfumo wa HFT, utabiri wa bei hauwezi kutenganishwa na usahihi wa data ya soko inayopokelewa. Packet inayokosekana, muhuri wa muda usio sahihi, pengo la sequence number au order-book update iliyochelewa vinaweza kufanya modeli iamue kwa kuzingatia hali ya soko ambayo kwa kweli haipo tena.
Chanzo kinaeleza mtiririko wa data kama:
\[ M_{\mathrm{event}}(t) \rightarrow N \rightarrow OB \rightarrow Q \]
.
Hapa tukio ghafi la exchange kwanza hunormishwa, kisha hutumika kwenye order book state na kupelekwa kwenye event queue za ndani.
Kwa pipeline ya aina ya production, chanzo kinajadili mbinu zifuatazo:
- kernel-bypass networking,
- CPU affinity,
- lock-free ring buffer,
- kumbukumbu ya NUMA-aware,
- uchakataji wa data unaooana na DMA,
- udhibiti wa sequence-number,
- miundo ya data ya cache-aligned,
- kumbukumbu iliyotengwa mapema,
- na uhamishaji wa zero-copy.
Chanzo pia kinajadili suluhisho kama DPDK, RDMA na Solarflare/OpenOnload kama mifano.
Tofauti Kati ya ITCH na OUCH ni Nini?
Ingawa protokali mbalimbali za exchange zinatajwa katika muktadha mmoja katika utafiti, majukumu yao katika utekelezaji ni tofauti.
ITCH ni familia ya feed upande wa Nasdaq ambapo matukio ya order-book na execution husambazwa kama data ya soko.
OUCH ni protokali ya kiwango cha chini ya order-entry inayotumiwa na washiriki kutuma, kubadilisha na kughairi maagizo kwa Nasdaq na kupokea majibu ya execution/status yanayohusiana na maagizo yao.
Kwa hiyo, mtiririko uliorahisishwa wa HFT unaweza kufikiriwa kama:
ITCH → ona hali ya soko → uamuzi wa mkakati/execution → OUCH → tuma agizo kwa exchange
.
Kwa Nini Queue Stability ni Muhimu Kama Latency?
Chanzo kinatoa hali ya msingi ya uthabiti kwa stream-processing pipeline kama:
\[ \lambda<\mu \]
.
\(\lambda\) ni kasi ya event zinazoingia kwenye mfumo na \(\mu\) ni uwezo wa uchakataji.
Kasi ya kuwasili kwa event inapokaribia uwezo wa uchakataji, queue huanza kukua. Kwa hivyo, hata kama kazi za mtu mmoja mmoja ni za haraka sana, latency ya mwisho-hadi-mwisho ya mfumo inaweza kuongezeka.
Hasa wakati wa:
- matangazo ya data za uchumi mkuu,
- minada ya kufungua/kufunga,
- mishtuko ya volatility,
- na kuvunjika kwa liquidity
event burst za muda mfupi huwa muhimu.
Chanzo kinajadili mbinu kama bounded ring buffer, priority filtering, horizontal ingestion scaling na load shedding inayodhibitiwa. Hata hivyo, kwa kuwa kupoteza data katika mifumo ya HFT kunaweza kuharibu order-book state, haiwezekani kutupa event kiholela kama inavyoweza kufanyika katika mifumo ya kawaida ya web.
Ni Ishara Gani Zinazojitokeza Katika Microstructure ya Soko?
Kulingana na utafiti, utabiri wa HFT wa muda mfupi sana hutegemea zaidi muundo wa sasa wa kitabu cha maagizo ya kikomo kuliko mfululizo wa bei wa muda mrefu wa kawaida.
Uwakilishi mkuu wa market-state ni:
\[ M_{\mathrm{state}} = f(OI,S,D,QP,V) \]
.
| Alama | Maana |
|---|---|
| OI | Order Imbalance |
| S | Bid–Ask Spread |
| D | Market Depth |
| QP | Queue Pressure |
| V | Hali ya volatility |
Order Imbalance Hupima Nini?
Order imbalance rahisi ya kiwango cha juu hutolewa kama:
\[ OI= \frac{V_{\mathrm{bid}}-V_{\mathrm{ask}}} {V_{\mathrm{bid}}+V_{\mathrm{ask}}} \]
.
Thamani chanya inaonyesha kuwa liquidity upande wa bid ni kubwa zaidi, na thamani hasi inaonyesha kuwa upande wa ask ni mkubwa zaidi.
Utafiti unasisitiza kwamba kutumia imbalance katika viwango vingi vya order-book, si best bid/best ask pekee, kunaweza kuwa na maana zaidi:
\[ Imbalance= \frac{ \sum_iV_{\mathrm{bid},i} - \sum_iV_{\mathrm{ask},i} }{ \sum_iV_{\mathrm{bid},i} + \sum_iV_{\mathrm{ask},i} }. \]
Hata hivyo, order imbalance peke yake haimaanishi “bei hakika itapanda”. Katika tafsiri ya chanzo, imbalance ni state variable inayodhihirisha udhaifu katika muundo wa liquidity zaidi kuliko kuwa sababu pekee inayosababisha mabadiliko ya bei moja kwa moja.
Kwa Nini Microprice ni Tofauti na Mid-Price ya Kawaida?
Bei ya kati ya kawaida:
\[ P_{\mathrm{mid}} = \frac{P_{\mathrm{bid}}+P_{\mathrm{ask}}}{2} \]
hutumia viwango vya bei pekee.
Chanzo kinatoa usemi ufuatao kwa microprice:
\[ P_{\mathrm{micro}} = \frac{ P_{\mathrm{ask}}V_{\mathrm{bid}} + P_{\mathrm{bid}}V_{\mathrm{ask}} }{ V_{\mathrm{bid}}+V_{\mathrm{ask}} } \]
.
Kwa njia hii, kutolingana kwa kiasi katika viwango bora vya ununuzi na uuzaji hujumuishwa katika kipimo cha bei. Lengo ni kuwakilisha shinikizo la muda mfupi ndani ya order book vizuri zaidi kuliko midpoint ya kijiometri pekee.
Kwa Nini Queue Position Inaweza Kuwa Muhimu Zaidi Hata Kuliko Utabiri?
Hata kama maagizo mawili ya kikomo yanatumwa karibu wakati mmoja katika kiwango kimoja cha bei, agizo lililo mbele kwenye foleni hutekelezwa kwanza kwa sababu ya price-time priority.
Kwa hiyo, kwa execution, muhimu si tu:
“Je, bei itasogea katika mwelekeo sahihi?”
bali pia;
“Je, agizo langu litatimizwa kweli kabla ya mabadiliko ya bei?”
.
Chanzo kinasisitiza kwamba queue position ni muhimu kwa:
- fill probability,
- adverse selection,
- slippage,
- na mafanikio ya passive execution
.
Ujifunzaji wa Mashine Unatumika Vipi Katika HFT?
Kulingana na chanzo, output ya ML katika HFT haipaswi kuonekana moja kwa moja kama “kitufe cha nunua/uza”, bali kama state estimator yenye msingi wa uwezekano.
Output ya kawaida huonyeshwa kama:
\[ Signal_t= \begin{cases} Buy,&P(up)>\theta\\ Sell,&P(down)>\theta\\ Hold,&otherwise \end{cases} \]
.
Miundo inayojadiliwa katika utafiti ni:
- CNN,
- LSTM,
- mseto wa CNN-LSTM,
- Temporal Convolutional Network,
- Transformer,
- Reinforcement Learning,
- na mifumo ya online-learning ya baadaye.
Wazo kuu la chanzo ni kwamba modeli tata zaidi si lazima iwe na thamani zaidi kila wakati. Uwezo wa uwakilishi unapoongezeka, inference latency pia inaweza kuongezeka na utabiri unaweza kupoteza thamani ya kiuchumi kabla ya execution.
Kwa Nini Usahihi wa Modeli Pekee Hautoshi Katika Ujifunzaji wa Mashine?
Modeli inaweza kuwa na classification accuracy au F1 ya juu, lakini:
- ikiwa utabiri ni sahihi tu katika mabadiliko madogo sana ya bei,
- utabiri usio sahihi ukizalisha hasara kubwa,
- spread ikiwa kubwa kuliko edge iliyotabiriwa,
- agizo la kikomo lisipotimizwa,
- slippage ikiwa juu,
- au signal decay ikitokea wakati wa inference latency
PnL ya mkakati inaweza kuwa hasi.
Kwa hiyo, utafiti unasema tathmini ya ML inapaswa kwenda zaidi ya accuracy na kujumuisha:
- calibration,
- execution-aware PnL,
- latency-to-inference,
- regime stability,
- na ustahimilivu wa transaction-cost
.
Kwa Nini Concept Drift ni Tatizo Kubwa kwa HFT?
Chanzo kinaieleza kama:
\[ P(X,Y)_{\mathrm{train}} \neq P(X,Y)_{\mathrm{live}} \]
.
Mahusiano ya order-flow, spread, volatility na liquidity katika kipindi cha mafunzo ya modeli yanaweza yasibaki vilevile katika soko la moja kwa moja.
Sababu zake zinaweza kujumuisha:
- mabadiliko ya rejimu za soko,
- urekebishaji wa algoriti za washindani,
- washiriki wapya,
- mabadiliko katika muundo wa liquidity,
- na alpha kufyonzwa haraka na soko
.
Je, Kazi ya Execution Engine ni Kutuma Maagizo Pekee?
Hapana. Katika mfumo wa chanzo, execution engine ni mfumo wa udhibiti unaobadilisha ishara kuwa hatua halisi ya soko.
Mzunguko wa maisha wa agizo ni:
Ishara → pre-trade risk → kuunda agizo → kuchagua venue → kutuma → acknowledgment → queue → partial fill → modify/cancel → completion → risk/PnL feedback
.
Kila hatua inaweza kubadilisha PnL ya mwisho.
Smart Order Routing ni Tatizo la Aina Gani la Uamuzi?
Utafiti unawakilisha uchaguzi wa venue kwa kazi ya dhana ya utility ifuatayo:
\[ U_{\mathrm{venue}} = P_{\mathrm{fill}} - C_{\mathrm{latency}} - C_{\mathrm{impact}} - C_{\mathrm{fees}}. \]
Kwa hiyo, exchange iliyo karibu zaidi au ya gharama nafuu si lazima iwe venue bora zaidi. Mfumo unapaswa kutathmini kwa pamoja fill probability, latency, market impact, muundo wa ada/rebate na hali ya sasa ya order-book.
Uamuzi Kati ya Agizo la Passive na Aggressive Unafanywaje?
Agizo la passive linaweza kupata spread na kupunguza gharama ya muamala; lakini linategemea queue position na lina hatari ya adverse selection.
Agizo la aggressive huongeza execution certainty; kwa upande mwingine linaweza kuleta gharama ya spread crossing na market impact.
Kulingana na chanzo, execution engine ya kisasa inaweza kubadilisha kwa nguvu kati ya hali hizi mbili kulingana na spread, volatility, imbalance, inventory na liquidity depth.
Udhibiti wa Hatari Uko Wapi Katika Usanifu wa HFT?
Usimamizi wa hatari si mfumo tofauti wa kuripoti unaofanya kazi baada ya execution, bali ni sehemu ya hot path.
Hatari zinazojadiliwa na chanzo ni:
- inventory accumulation,
- directional exposure,
- kuvuka volatility-adjusted limit,
- slippage spike,
- execution divergence,
- kupotea kwa muunganisho wa exchange,
- model instability,
- na latency degradation.
Hatari ya inventory inaonyeshwa kimawazo kama:
\[ Risk_{\mathrm{inventory}} \propto |Position|\times\sigma \]
.
Volatility inapoongezeka, ukubwa uleule wa nafasi hubeba hatari kubwa zaidi, hivyo mfumo unaweza kupunguza exposure limit kwa nguvu.
Kwa Nini Kill Switch ni Kipengele cha Lazima?
Kwa kuwa mifumo ya HFT inaweza kutengeneza maagizo haraka zaidi kuliko uingiliaji wa binadamu, kujaribu kusimamisha kwa mkono hitilafu ya programu iliyo nje ya udhibiti kunaweza kuchelewa.
Chanzo kinaonyesha mekanizimu za kill-switch kama sehemu kuu za usanifu wa production unaopendekezwa ambazo zinapaswa:
- kughairi maagizo yaliyo wazi,
- kusimamisha utengenezaji wa maagizo mapya,
- kuhamisha execution engine katika hali salama,
- na kudhibiti ukuaji wa exposure.
.
Kwa Nini HFT Backtest ya Kihalisia ni Ngumu?
Backtest ya kawaida mara nyingi inaweza kufanya kazi kama “bei ya zamani → ishara → muamala wa kudhaniwa”. Katika HFT, hata hivyo, bei pekee haitoshi.
Mfumo wa replay wa kihalisia unapaswa kuiga mekanizimu za:
- tick-level market data,
- order submissions,
- cancellations,
- queue position,
- partial fills,
- latency,
- market impact,
- na transaction cost
.
Chanzo kinaeleza tofauti muhimu kama:
\[ S_{\mathrm{real}}(t)\neq S_{\mathrm{sim}}(t) \]
.
Hata replay bora haiwezi kuunda upya soko halisi kikamilifu; lengo ni kupunguza tofauti kadiri iwezekanavyo.
“Phantom Alpha” ni Nini?
Ikiwa backtest inachukulia:
- latency sifuri,
- fill iliyohakikishwa,
- liquidity isiyo na kikomo,
- market impact sifuri,
- na bei iliyoonekana zamani kama bei halisi ya execution
inaweza kutengeneza faida ambayo haiwezi kutekelezwa katika uhalisia.
Utafiti unafafanua hali hii:
\[ PnL_{\mathrm{sim}} \gg PnL_{\mathrm{live}} \]
kama phantom alpha.
Ni Metriki Gani Zinapaswa Kutumiwa Pamoja Katika HFT Backtest?
Chanzo kinaona kuwa metriki moja haitoshi.
| Metriki | Hupima nini? |
|---|---|
| PnL | Matokeo ya kiuchumi baada ya transaction cost |
| Sharpe | Marejesho yaliyorekebishwa kwa hatari kulingana na volatility ya jumla |
| Sortino | Marejesho kwa kuzingatia hatari ya upande wa chini pekee |
| Maximum Drawdown | Hasara mbaya zaidi ya mtaji kutoka kilele |
| Hit Ratio | Uwiano wa miamala yenye faida |
| Slippage Distribution | Tofauti kati ya bei inayotarajiwa na bei halisi ya execution |
| Fill Ratio | Tabia ya kutimizwa kwa maagizo yaliyotumwa |
| Latency Distribution | Latency ya kawaida na tail execution |
Hasa hit ratio peke yake haionyeshi faida. Faida nyingi ndogo zinaweza kufutwa na idadi ndogo ya hasara kubwa.
Kwa hiyo, chanzo kinatumia uhusiano:
\[ E[PnL] = HitRatio\times\mu_{\mathrm{win}} - (1-HitRatio)\times\mu_{\mathrm{loss}} \]
.
Tofauti Kati ya Cloud na Colocation ni Nini?
Utafiti unaweka cloud na colocation katika production HFT kwa kazi tofauti.
| Cloud | Colocation / Edge |
|---|---|
| Mafunzo ya modeli | Utekelezaji wa moja kwa moja wa agizo |
| Backtesting | Uchakataji wa exchange market-data |
| Batch analytics | Uamuzi wa latency-sensitive |
| Scaling nyumbufu | Muunganisho wenye determinism zaidi |
Chanzo kinaeleza hili kama:
\[ Latency_{\mathrm{colo}}<Latency_{\mathrm{cloud}} \]
. Hii si jedwali la kipimo maalum, bali ni ulinganisho wa usanifu unaotolewa katika muktadha wa muunganisho wa ultra-low-latency exchange.
Je, Kukuza Mfumo Uliosambazwa Daima Hufanya Uwe wa Haraka Zaidi?
Hapana. Kuongeza node mpya kunaweza kuongeza uwezo wa compute; lakini state synchronization na network communication pia huongezeka.
Chanzo kinaonyesha ufanisi wa scaling kimawazo kama:
\[ Efficiency= \frac{Performance_{\mathrm{scaled}}}{Nodes} \]
.
Katika HFT, tatizo kuu linaweza kuwa gharama ya distributed coordination badala ya ukosefu wa compute.
Kwa hiyo, mkabala bora wa scaling ni:
- kupunguza utegemezi wa cross-node,
- kuweka state kwa market/venue kuwa ya ndani kadiri iwezekanavyo,
- na kupunguza synchronization iliyosambazwa kwenye latency-critical hot path.
Je, GPU na FPGA Hufanya Kazi Sawa Katika HFT?
Chanzo kinahusisha vifaa hivi viwili na kazi tofauti.
FPGA:
- deterministic packet parsing,
- market-data preprocessing,
- udhibiti wa hatari katika kiwango cha vifaa,
- execution latency ya chini sana na inayotabirika.
GPU:
- feature computation inayohitaji parallelism kubwa,
- deep-learning inference,
- na operesheni kubwa za matrix.
Utafiti unatoa uhusiano wa kimchoro:
\[ Latency_{\mathrm{FPGA}} < Latency_{\mathrm{CPU}} < Latency_{\mathrm{GPU}} \]
. Mpangilio huu si sheria ya vifaa ya jumla iliyothibitishwa kwa controlled benchmark katika utafiti; umetumiwa kufafanua kimawazo hali maalum ya latency-critical execution.
Mbinu na Matokeo ya Utafiti
Utafiti ulifanywaje?
Utafiti unashughulikia kwa utaratibu maswali kumi ya utafiti:
- Athari za scaling na matengenezo za usanifu wa HFT wa moduli wenye latency ya chini,
- vikwazo vya miundombinu katika HFT ya wakati halisi,
- uboreshaji wa market-data na tick pipeline,
- viashiria vya microstructure katika utabiri wa muda mfupi,
- athari za microstructure kwenye execution quality,
- uwezo wa modeli za ML kutabiri tabia ya muda mfupi,
- hatari na mipaka ya ujumuishaji wa ML,
- execution engine na udhibiti wa hatari wa kiotomatiki,
- metriki zinazofaa za backtest katika tathmini ya HFT,
- matatizo ya kuhama kutoka mfumo wa utafiti hadi production-grade HFT.
Uchambuzi unatokana na usanisi wa uhandisi wa mfumo unaotumia fasihi ya kitaaluma ya microstructure, tafiti za order-book ML kama DeepLOB, utafiti wa RL execution na utekelezaji wa open-source kama Trading-System, ML-HFT, DeepLOB na NautilusTrader.
Matokeo makuu 1: Alpha hujitokeza katika kiwango cha mfumo
Utafiti unatafsiri alpha si kama output ya modeli pekee bali kama:
\[ Alpha= f( Microstructure, Execution, Infrastructure, Timing, Risk ) \]
.
Hili ndilo hitimisho muhimu zaidi linalounganisha sehemu zote za utafiti.
Matokeo makuu 2: Market microstructure ni signal na constraint kwa pamoja
Order imbalance, spread, depth na queue pressure hazitumiki tu kutabiri bei. Vigezo hivyo hivyo pia huamua kama agizo:
- litatekelezwa au la,
- litatekelezwa kwa gharama gani,
- hatari ya adverse selection,
- na uchaguzi wa passive/aggressive execution
.
Kwa hiyo, tafsiri ya pamoja:
Microstructure = Prediction Signal + Execution Constraint
ni mojawapo ya michango yenye nguvu ya dhana ya utafiti.
Matokeo makuu 3: Latency yenye determinism ina thamani zaidi kuliko latency ya wastani
Chanzo kinasisitiza hasa latency variance:
\[ \sigma^2_{\mathrm{latency}} = E[(T-\mu)^2]. \]
Mfumo ambao ni wa haraka kwa wastani lakini wakati mwingine hutoa spike kubwa unaweza kuwa mbaya zaidi kwa queue position na execution quality kuliko mfumo ulio polepole zaidi lakini deterministic.
Grafu ya percentile katika ukurasa wa 24 pia inaonyesha wazo hili la “chunguza usambazaji mzima wa latency badala ya wastani”; hata hivyo, kwa kuwa protokali ya majaribio ya grafu haijafafanuliwa kikamilifu, haijatumika kama benchmark ya kiasi katika Verianla.
Matokeo makuu 4: ML ina maana tu ikiwa execution-aware
Chanzo kinatetea uhusiano:
\[ ML_{\mathrm{effective}} \Rightarrow Execution_{\mathrm{aware}} \]
.
Ikiwa modeli inafundishwa na kutathminiwa bila kuhusisha kabisa vigezo vya execution kama:
- fill probability,
- slippage,
- latency,
- liquidity,
- na market impact
pengo kubwa linaweza kutokea kati ya utafiti na mfumo wa moja kwa moja.
Matokeo makuu 5: Production HFT si toleo lililokuzwa tu la prototype ya utafiti
Mfumo wa production unahitaji:
- failover,
- telemetry,
- state consistency,
- kill switch,
- redundant feed,
- safe-state transition,
- deployment discipline,
- na bounded-risk operation
.
Mojawapo ya hitimisho zenye nguvu za chanzo linaweza kufupishwa kama:
\[ Stable\ Execution > Maximum\ Theoretical\ Performance \]
.
Utafiti Una Mipaka Katika Maeneo Gani?
Kizuizi cha kwanza: Licha ya usemi “empirical insights” katika kichwa, makala haina seti moja ya data ya kihalisia ya HFT iliyo asilia ambayo inajaribu madai yote. Muundo wake kwa kiasi kikubwa ni usanisi wa fasihi na usanifu wa mfumo.
Kizuizi cha pili: Chanzo cha data, kipindi cha sampuli na metodolojia ya majaribio inayoweza kurudiwa kwa baadhi ya grafu na majedwali ya performance havijaelezwa kwa uwazi wa kutosha katika maandishi ya karibu. Hasa jedwali la classifier katika ukurasa wa 46 halipaswi kutumiwa kama matokeo huru ya kiempiria kwa sababu hiyo.
Kizuizi cha tatu: Semi nyingi za kihisabati ni mahusiano ya dhana ya makadirio. Vigawo vyake havijakadiriwa kiempiria.
Kizuizi cha nne: Makala inajadili teknolojia nyingi za production kwa pamoja; lakini haitoi controlled benchmark inayolinganisha Kafka, RabbitMQ, gRPC, FPGA, GPU, RDMA, DPDK na suluhisho zinazofanana katika production HFT hot path maalum.
Kizuizi cha tano: Exchange latency, market-data burst, fill probability na tabia ya queue zinaweza kutofautiana sana kulingana na venue. Utafiti unazijadili katika kiwango cha kanuni za jumla za mfumo.
Kizuizi cha sita: Matumizi ya LLM kwa HFT market representation ni mwelekeo wa utafiti wa baadaye katika chanzo; si matokeo ya moja kwa moja ya matumizi ya production-grade yenye latency ya chini.
Kizuizi cha saba: Sehemu za online learning na reinforcement learning ni hali za dhana za baadaye; hazimaanishi kuwa mfumo salama na endelevu wa self-learning execution umethibitishwa katika exchange ya moja kwa moja.
Matokeo Yanayoungwa Mkono na Utafiti
- Mifumo ya kisasa ya HFT haiwezi kuchukuliwa kama modeli za utabiri wa bei pekee.
- Data ya soko, microstructure, inference, execution na tabaka za hatari huunda mfumo mmoja wa mwisho-hadi-mwisho.
- Order imbalance, spread, depth na queue dynamics ni vipengele vya msingi vya microstructure ya muda mfupi.
- Usahihi wa utabiri hauonyeshi mafanikio ya kiuchumi bila execution friction kuzingatiwa.
- Queue position na fill probability huathiri moja kwa moja utekelezekaji wa mikakati ya limit-order.
- Latency inapaswa kutathminiwa si kwa wastani pekee bali pia kwa variance na tail distribution.
- Kukosekana kwa latency, partial fill, queue position na transaction cost katika backtest kunaweza kuzalisha phantom alpha.
- Usanifu wa moduli hutoa faida ya fault isolation na matengenezo; usambazaji uliopitiliza unaweza kuongeza synchronization overhead.
- Colocation inaendana zaidi na live execution ya ultra-low-latency; cloud inaendana zaidi na utafiti, training na analytics kubwa.
- Katika mifumo ya production, fail-safe, observability na kill-switch ni sehemu zisizotenganishwa za mkakati.
Matokeo Ambayo Utafiti Hauyathibitishi Moja kwa Moja
- Hauonyeshi kwamba modeli fulani ya ML hutoa faida kubwa zaidi katika production HFT.
- Haithibitishi kiempiria kwamba Transformer kwa ujumla ni bora kuliko LSTM au CNN.
- Hauonyeshi kwamba order-book signal fulani hutoa alpha iliyohakikishwa.
- Hauonyeshi kwamba equations za fill-probability zilizotolewa zimekalibishwa kwa exchange zote.
- Haithibitishi kwa majaribio kwamba FPGA hutoa latency ya chini kuliko CPU na GPU katika kila workload.
- Hautoi jedwali la latency lililopimwa kwa miundombinu maalum ya cloud au colocation.
- Hauonyeshi kwamba classifier accuracy za juu katika ukurasa wa 46 hubadilika kuwa faida ya HFT ya moja kwa moja.
- Hauonyeshi kwamba HFT inayotegemea LLM ni production standard leo.
Maelezo ya Chanzo na Mbinu
Kichwa asili: Beyond Prediction: Execution-Aware Machine Learning and Distributed Infrastructure in High-Frequency Trading Systems
Waandishi wa bibliografia ya SSRN: Ganesh Rayapati; Malichalima Shashank; Sai Tarun Paleti; Balaji Peddavenkugari; Sai Krishna Murthy M.
Taarifa ya majukumu ndani ya PDF: Ganesh Rayapati – Distributed Systems Architecture, Execution Engine Analysis, Original Draft; Shashank Malichalima – Market Microstructure Analysis, Formal Writing; Sai Tarun Paleti – Backtesting Framework Analysis, Data Curation; Balaji Peddavenkugari – Methodology, Formal Analysis, Writing; Mr. M. Sai Krishna Murthy – Advisor, Review and Guidance.
Taasisi – SSRN: Ganesh Rayapati, Sai Tarun Paleti na Sai Krishna Murthy M – Malla Reddy College of Engineering and Technology; Malichalima Shashank – Narsimha Reddy Engineering College; Balaji Peddavenkugari – VNR Vignana Jyothi Institute of Engineering and Technology.
Tarehe ya utafiti: 7 Juni 2026.
Tarehe ya kuchapishwa/kuwasilishwa SSRN: 1 Julai 2026.
SSRN ID: 6900821.
DOI: 10.2139/ssrn.6900821.
Urefu: kurasa 91.
Aina ya uchapishaji: SSRN preprint / mapitio ya kiufundi katika kiwango cha mfumo.
Peer review: Haipaswi kutathminiwa kama makala ya jarida la peer-reviewed.
Hakimiliki / leseni: Rekodi ya SSRN inaonyesha hali “All rights reserved; no reuse allowed without permission”. Michoro na miundo asili ya grafiki ya chanzo haijatumika tena katika Verianla.
Muundo mkuu wa utafiti: Uchambuzi wa kiufundi wa kimfumo wa tabaka za low-latency infrastructure, market-data pipeline, market microstructure, machine learning, execution engine, risk control, backtesting na production scalability katika usanifu wa kisasa wa HFT kupitia maswali kumi ya utafiti.
Vyanzo vikuu vya utekelezaji: Repository za open-source za Trading-System, ML-HFT, DeepLOB na NautilusTrader.
Mfumo mkuu wa kitaaluma: Nadharia ya limit order book, tafiti za order-book deep-learning kama DeepLOB, fasihi ya reinforcement-learning execution na tafiti za microstructure ya algorithmic/high-frequency trading.
Dokezo la protokali: PDF katika baadhi ya sehemu inatoa FIX, ITCH na OUCH kama mifano ya pamoja ya mawasiliano. Katika ufafanuzi wa kiufundi wa Nasdaq, OUCH ni protokali ya order-entry/execution, huku TotalView-ITCH ikiwa market-data feed. Kwa hiyo, majukumu yamegawanywa katika maelezo ya Verianla.
Dokezo la uadilifu wa kuona: ML limit-order submission workflow katika kurasa 3 na 29, grafu ya latency percentile katika ukurasa wa 24, mchoro wa order-book queue katika ukurasa wa 40, vielelezo vya ML performance katika kurasa 46–47 na execution architecture diagram katika ukurasa wa 71 ni sehemu ya maudhui ya chanzo; hazijachapishwa tena kwa kuwa hakuna leseni wazi ya matumizi tena.
Kizuizi kikuu cha metodolojia: Makala inatoa usanisi mpana na wenye manufaa wa uhandisi wa mifumo ya production HFT; lakini si utafiti wa empirical benchmark ambapo kila dai la kiufundi limepimwa katika seti moja ya majaribio yaliyodhibitiwa. Kwa hiyo, mahusiano ya usanifu yasiyo ya kiasi yanapaswa kusomwa kama “modeli ya mfumo ya chanzo”.
Hitimisho kuu la kisayansi: Hitimisho linaloweza kutetewa zaidi na linalodumu katika chanzo ni kwamba katika HFT ya kisasa predictive accuracy na realized performance si kigezo kimoja; thamani ya kiuchumi hutokea pamoja na market microstructure, execution quality, latency, liquidity, risk na operational resilience.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *