

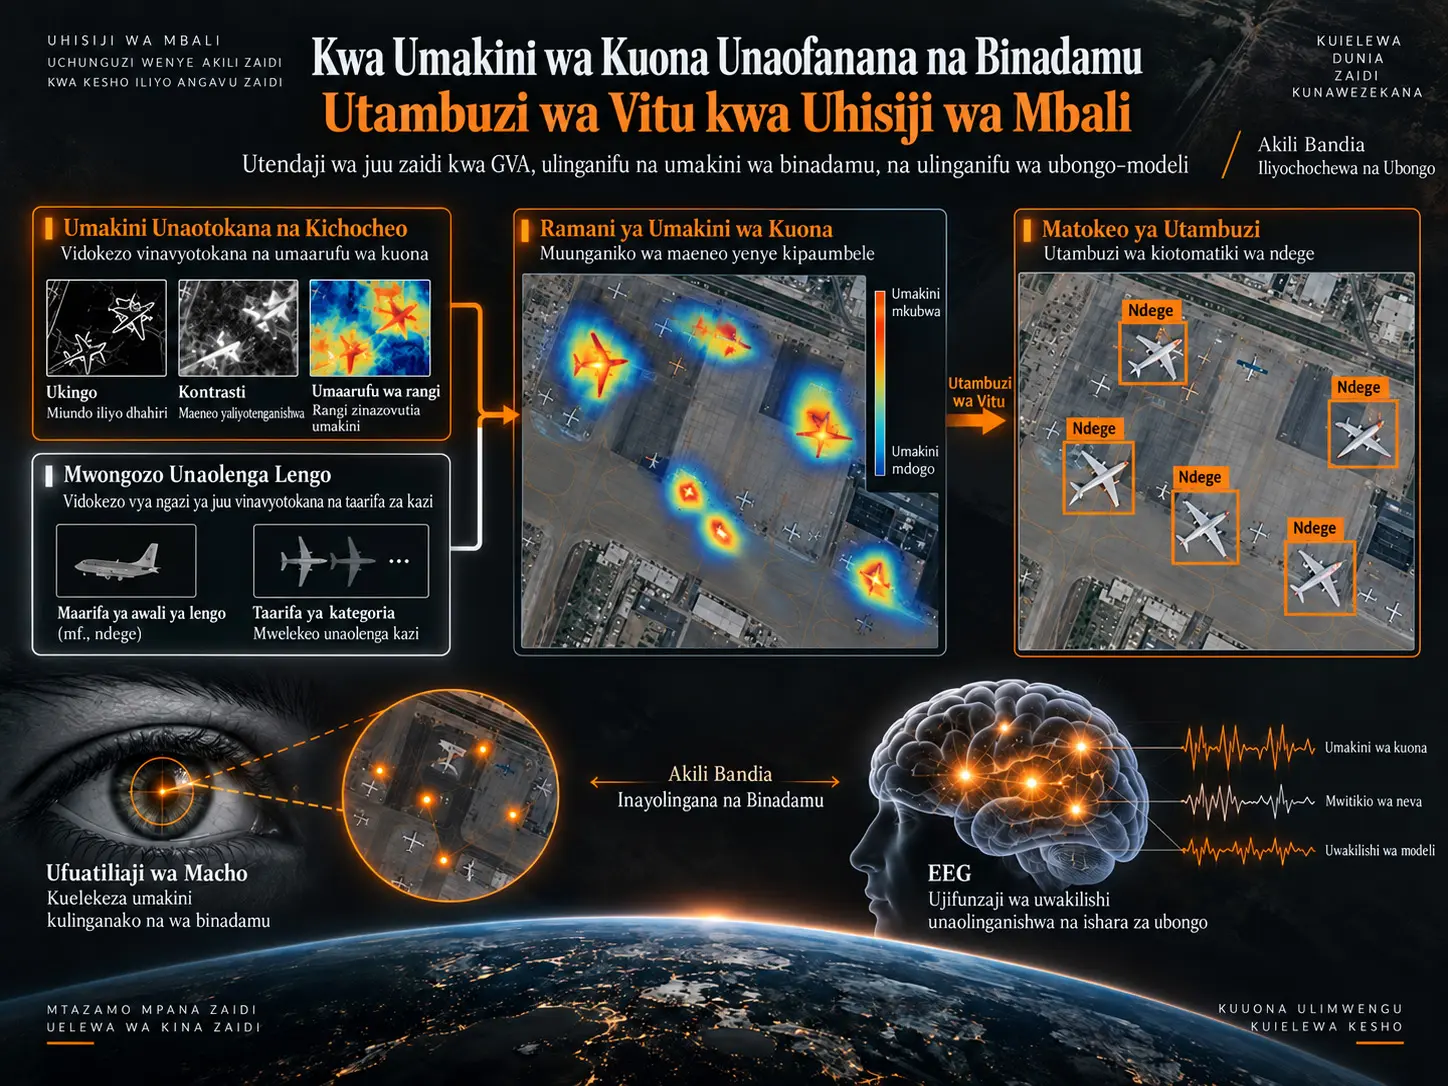
Guided-Search Visual Attention (GVA) ni mfumo wa umakini uliochochewa na ubongo unaoratibu uchakataji wa vipengele katika mitandao ya kutambua vitu kwa uhisiji wa mbali kwa kuiga kwa pamoja umaarufu wa kuona unaochochewa na kichocheo na uelekezaji wa umakini unaolenga kazi katika utafutaji wa kuona wa binadamu. Utafiti uliingiza GVA katika usanifu tano tofauti za utambuzi wa vitu—Faster R-CNN, RetinaNet, YOLOv5s, YOLOv8n na CenterNet—na kutathmini utendaji kwenye seti ya data ya DIOR, ulinganifu wa kitabia na binadamu kwa data ya ufuatiliaji wa macho iliyokusanywa kwa wakati mmoja, na ulinganifu wa uwakilishi wa ubongo–modeli kwa representational similarity analysis inayotegemea EEG. Katika kategoria ya ndege, usanifu wote ulionyesha ongezeko la AP50 na ongezeko kubwa zaidi la moja kwa moja lilikuwa +0,260 kwa YOLOv5. Uhusiano wa Pearson kati ya ramani ya umakini ya GVA na usambazaji wa fixation wa binadamu ulifikia 0,740; katika uchanganuzi wa EEG–model RSA, ongezeko dhahiri zaidi la ulinganifu liliripotiwa katika eneo la oksipitali linalohusishwa na usimbaji wa mapema wa kuona na eneo la mbele linalohusishwa na udhibiti wa umakini wa top-down. Hata hivyo, utafiti huu bado ni preprint ambayo haijapitiwa na wenzao, na ulinganifu wa ubongo unapaswa kufasiriwa tu ndani ya mfumo wa kipimo cha EEG/RSA uliotumika.
Katika modeli za kisasa za uhisiji wa mbali, mifumo ya attention hutumiwa kwa upana; hata hivyo, sehemu kubwa ya mifumo hii hujifunzwa si kwa lengo la kuiga umakini wa kuona wa binadamu bali kwa kuboresha moja kwa moja utendaji wa kazi. Kwa hiyo, maeneo ambayo modeli huyapa umakini yanaweza kutofautiana na maeneo ambayo waangalizi wa kitaalamu wa binadamu huyatafuta kwenye picha.
Hapo ndipo makala inaanzia. Badala ya kulazimisha umakini wa modeli ufanane moja kwa moja na ramani za fixation za binadamu, watafiti wanapendekeza kubadilisha utaratibu wa guided search unaosimamia utafutaji wa kuona wa binadamu kuwa moduli ya kihesabu. Hivyo, badala ya kunakili tu matokeo ya tabia ya binadamu, wanajaribu kuiga michakato miwili mikuu inayozalisha usambazaji wa umakini.
Mchakato wa kwanza ni stimulus-driven saliency, yaani sifa za kiwango cha chini za picha kama kingo, tofauti za rangi na hali ya eneo kuwa isiyo ya kawaida huvuta umakini moja kwa moja. Mchakato wa pili ni target-directed guidance, yaani lengo la kazi la mwangalizi, kama “natafuta ndege”, huelekeza umakini kwenye maeneo yanayofanana na shabaha. GVA huunganisha ramani hizi mbili na kutoa kipaumbele kwa maeneo ambayo ni ya kuvutia kwa macho na pia yana maana kwa kazi.
Kwa Nini Umakini wa Kuona Unaofanana na wa Binadamu ni Muhimu katika Utambuzi wa Vitu kwa Uhisiji wa Mbali?
Umakini wa kuona unaofanana na wa binadamu unalenga kufanya modeli izingatie si tu sifa zenye nguvu kitakwimu katika picha, bali pia maeneo ya kuona na yanayohusiana na kazi ambayo binadamu huyapa kipaumbele wanapotafuta shabaha. Kwa kuwa katika picha za uhisiji wa mbali shabaha zinaweza kuwa ndogo, nadra na kufichwa ndani ya mandhari ya nyuma yenye msongamano, utaratibu kama huu wa umakini unaweza kupunguza matokeo chanya ya uongo, kupunguza shabaha zinazokosekana na kurahisisha kulinganisha maamuzi ya modeli na mikakati ya utafutaji wa kuona ya binadamu.
Katika picha za uhisiji wa mbali, njia za kurukia ndege, maeneo ya ardhini, maeneo ya maji, majengo au maumbo mengine yenye msongamano vinaweza kuunda sifa zenye nguvu za kuona bila kuwa shabaha. Detector ya kawaida inaweza kutoa activation kubwa katika maeneo haya na kutengeneza bounding box zisizo za lazima.
Mwangalizi wa binadamu, kwa upande mwingine, hachukulii maeneo yote yenye utofauti mkubwa kwa namna sawa. Huunganisha umaarufu wa kuona unaotokana na picha yenyewe na maarifa ya awali kuhusu kitu anachotafuta. Guided search theory hufafanua utafutaji wa kuona wa binadamu kama muunganiko wa mikondo hii miwili ya taarifa.
Guided Search Theory Inabadilishwa Vipi Kuwa Modeli ya GVA?
GVA hutekeleza vyanzo viwili vya msingi vya umakini katika guided search theory kama njia tofauti za kihesabu: njia ya bottom-up hutoa sifa za kuona zisizotegemea kazi kama kingo na hali isiyo ya kawaida ya rangi, huku njia ya top-down ikitengeneza ramani ya uwezekano wa shabaha kutoka kwa maarifa ya kuona yaliyojifunzwa kuhusu darasa la shabaha. Ramani hizi mbili huzidishwa kwa kiwango cha pikseli ili kuunda ramani ya pamoja ya kipaumbele, na ni maeneo ambayo ni maarufu na yanayohusiana na kazi ndiyo yanayopata umakini mkubwa.
Bottom-up: Njia ya umaarufu unaochochewa na kichocheo
Njia ya stimulus-driven saliency hutengeneza ramani ya umakini kwa kuzingatia sifa za kuona za picha yenyewe bila kujua shabaha ni nini. Chanzo kinaunda mnyororo huu wa uchakataji kwa hatua za kawaida za uchakataji wa picha zinazoweza kuelezeka kikamilifu.
Kwanza picha huchakatwa kwa mean-shift filtering na kubadilishwa kwenda nafasi ya rangi ya CIE-Lab. Kisha Gaussian pyramid ya mizani mitatu hutumiwa:
- 1× azimio asili,
- 0,5× kipimo,
- 0,25× kipimo.
Katika kila kipimo, vipengele vya kingo hutolewa kwa kutumia 3×3 Sobel operator. Zaidi ya hayo, ramani ya color-rarity huhesabiwa ili kupima jinsi rangi ya kila pikseli ilivyo nadra au isiyo ya kawaida ikilinganishwa na mazingira yake.
Bottom-up attention map imefafanuliwa katika chanzo kama ifuatavyo:
\[ M_{bu}(x,y)= \mathcal{N} \left[ \sum_{s=1}^{3} w_s \left( E_s(x,y)+C_s(x,y) \right) \right] \]
Hapa \(E_s\) inawakilisha ramani ya sifa za kingo katika kipimo s; \(C_s\) ramani ya nadra ya rangi; \(w_s\) uzito wa kipimo; na \(\mathcal{N}\) min-max normalization.
Top-down: Njia ya uelekezaji unaolenga shabaha
Njia ya pili huleta taarifa mahususi ya shabaha ya kazi kwenye attention map. Katika utafiti, Random Forest classifier ilifundishwa kwa mifano 500 ya ndege iliyowekwa lebo kwa mkono ili kujifunza saini za rangi za Lab za shabaha za ndege.
Random Forest hutumia:
- miti 10,
- kina cha juu 5
na hutoa uwezekano wa shabaha kwa kila pikseli. Ramani hii hulainishwa kwa 5×5 Gaussian kernel na \(\sigma=2\).
Top-down guidance map:
\[ M_{td}(x,y)= \mathcal{N} \left[ G_{\sigma=2} * RF(Lab(x,y)) \right] \]
inaelezwa kwa namna hii.
Random Forest hapa imefundishwa kwa vipande vya picha vya ziada vilivyo huru na sehemu za train/test za detector ili kupunguza hatari ya kuvuja kwa data.
Njia hizi mbili za umakini zinaunganishwaje?
Ramani za bottom-up na top-down attention huunganishwa kwa element-wise multiplication. Hivyo, lengo ni kukandamiza maeneo ambayo yanaonekana sana kimwili lakini hayahusiani na shabaha, na pia maeneo yanayofanana na shabaha lakini ushahidi wa kuona ni dhaifu.
Ramani iliyounganishwa hugawanywa kuwa maeneo ya wagombea kwa marker-controlled watershed algorithm. Chanzo kinasema wagombea huchujwa kwa masharti haya:
- eneo: 50–8000 pikseli,
- uwiano wa pande: 0,2–5.
Viini vya Gaussian vya pande mbili vyenye \(\sigma=10\) pikseli huwekwa kwenye vituo vya maeneo halali ili kuunda attention map ya mwisho inayofanana na ya binadamu:
\[ A_{GVA}(x,y)= \mathcal{N} \left[ \sum_{k=1}^{K} \mathcal{G} \left( (x,y);c_k,\sigma=10 \right) \right] \]
Hapa \(K\) ni idadi ya maeneo halali ya wagombea, na \(c_k\) ni vituo vya maeneo hayo.
Je, GVA Kweli ni Moduli ya Umakini Isiyo na Parameta?
Kuingizwa kwa GVA ndani ya mtandao wa detector hakuongezi vigezo vipya vya kina vinavyoweza kujifunzwa, na njia ya bottom-up saliency inajumuisha uchakataji wa picha wa kideterministi; hata hivyo, njia ya top-down guidance hutumia Random Forest iliyofundishwa kwa mifano 500 iliyowekwa lebo. Kwa hiyo, kauli ya “parameter-free” katika chanzo haipaswi kufasiriwa kuwa hakuna sehemu yoyote iliyojifunzwa katika mnyororo mzima wa GVA, bali kwamba hakuna vigezo vipya vya neural network vinavyoboreshwa vinavyoongezwa kwenye usanifu wa detector.
Tofauti hii ni muhimu kimetodolojia. Chanzo kinasema matawi ya classification na regression ya detector hayakubadilishwa, GVA huhifadhi native loss functions, na hakuna learnable layer mpya inayoongezwa kwenye mafunzo ya detector.
Hata hivyo, Random Forest inayotumika kuunda attention map ya target-directed hufundishwa mapema. Kwa hiyo, sehemu ya top-down ya GVA hubeba taarifa iliyojifunzwa kuhusu darasa la shabaha.
GVA inaingizwa vipi katika detector tano tofauti?
| Usanifu | Aina ya detector | Mbinu ya kuingiza GVA |
|---|---|---|
| Faster R-CNN | Hatua mbili | GVA candidate box zinazopatikana kwa Watershed hutumika badala ya anchor mnene za kawaida; wastani wa attention score katika eneo hutathminiwa kama proposal confidence. |
| RetinaNet | Hatua moja, anchor-based | Wagombea wa GVA hutumika badala ya multi-scale anchor grid zilizofafanuliwa mapema. |
| YOLOv5s | Hatua moja, anchor-based | GVA binary mask hupimwa kulingana na ukubwa wa feature map; gradient backpropagation na maeneo ya matokeo huwekewa mipaka kwa maeneo ya attention yanayofanana na ya binadamu. |
| YOLOv8n | Hatua moja | GVA mask hubadilishwa kwa kipimo cha feature-map ili kurekebisha feature allocation na maeneo ya prediction. |
| CenterNet | Anchor-free | GVA mask iliyopimwa upya hubadilisha center-point heatmap predictions. |
Uamuzi muhimu wa usanifu katika utafiti ni kuweka GVA kati ya detector backbone na Feature Pyramid Network (FPN) ili kutoharibu sana usanifu wa msingi wa detector.
Mbinu na Matokeo ya Utafiti
Seti ya data ya EEGET-RSOD ya ufuatiliaji wa macho na EEG
Seti ya data ya EEGET-RSOD ilitumika kama benchmark ya tabia ya binadamu na uwakilishi wa ubongo. Seti hiyo ina picha 1.000 za macho za uhisiji wa mbali zenye pikseli 800×800 zilizochukuliwa kutoka DIOR.
Washiriki 38 walijumuishwa katika utafiti, na chanzo kinasema wote walitoa informed consent kwa maandishi. Idhini ya maadili ilitolewa na Beijing Normal University Ethics Committee kwa nambari 20221024111.
| Kipimo | Vifaa / parameta |
|---|---|
| Ufuatiliaji wa macho | SMI RED250, 250 Hz |
| EEG | NE Enobio, 32 channel, 500 Hz, mpangilio wa 10–20 |
| Usawazishaji | <2 ms trigger error |
| Muda wa kichocheo | 3000 ms |
| Skrini tupu | 500 ms |
Fixations zilitolewa kwa I-DT algorithm, na group fixation heatmaps ziliundwa kwa \(\sigma=8\) Gaussian kernel.
Uchakataji wa awali wa EEG
Ishara za EEG zilipitia:
- uchujaji wa 0,5–45 Hz,
- mastoid re-referencing,
- uondoaji wa artefact kwa ICA,
- −200–0 ms baseline correction
.
Maeneo manne ya kiutendaji yalifafanuliwa kwa madirisha tofauti ya muda:
| Eneo la ubongo | Dirisha la muda |
|---|---|
| Oksipitali | 0–300 ms |
| Temporal | 100–400 ms |
| Frontal | 200–500 ms |
| Parietal | 300–600 ms |
Whole-brain Representational Similarity Matrices ziliundwa katika dirisha la 0–600 ms.
Mpangilio wa mafunzo ya detector
Sehemu kuu ya majaribio ya detector ilifanywa kwenye subset ya ndege ya DIOR.
| Parameta | Thamani |
|---|---|
| Train / validation / test | 7 : 2 : 1 |
| Framework | PyTorch |
| GPU | RTX 4090 |
| Batch size | 16 |
| Azimio la ingizo | 800×800 |
| Epoch | 300 |
| Mwanzo wa backbone | ImageNet pre-trained |
| Uchaguzi wa checkpoint | AP50 ya juu zaidi |
GVA Iliongeza Utendaji wa Utambuzi wa Vitu kwa Kiasi Gani?
Katika jaribio la ndege la DIOR, kuongezwa kwa GVA kuliongeza AP50 katika detector zote tano; ongezeko kubwa zaidi la moja kwa moja kati ya usanifu lilikuwa kwa YOLOv5, kutoka 0,680 hadi 0,940, yaani +0,260. Modeli zenye utendaji dhaifu wa mwanzo zilipata faida kubwa zaidi, huku ongezeko likiwa dogo kwa RetinaNet na YOLOv8 ambazo tayari zilikuwa na utendaji wa juu.
| Modeli | Baseline Precision | Baseline Recall | Baseline AP50 | GVA Precision | GVA Recall | GVA AP50 | Tofauti ya AP50 |
|---|---|---|---|---|---|---|---|
| Faster R-CNN | 0,915 | 0,442 | 0,600 | 0,786 | 0,739 | 0,760 | +0,160 |
| YOLOv5 | 0,717 | 0,647 | 0,680 | 0,979 | 0,907 | 0,940 | +0,260 |
| CenterNet | 0,841 | 0,775 | 0,810 | 0,901 | 0,852 | 0,880 | +0,070 |
| RetinaNet | 0,982 | 0,874 | 0,920 | 0,991 | 0,918 | 0,950 | +0,030 |
| YOLOv8 | 0,982 | 0,932 | 0,920 | 0,974 | 0,938 | 0,960 | +0,040 |
Kwa Faster R-CNN, baseline model ilikuwa na precision ya juu sana lakini recall ya 0,442 tu. Baada ya GVA, recall iliongezeka hadi 0,739 huku precision ikishuka hadi 0,786, lakini AP50 kwa jumla iliongezeka kutoka 0,600 hadi 0,760.
Kwa YOLOv5, precision na recall zote ziliongezeka kwa wakati mmoja, na modeli hii ilipata faida kubwa zaidi ya jumla ya detector.
Kwa nini modeli zenye nguvu hupata faida ndogo?
Tafsiri ya chanzo ni kwamba modeli zenye utendaji wa mwanzo wa chini zina nafasi zaidi ya kuboresha katika kukandamiza mandharinyuma na kusawazisha precision–recall. Kwa kuwa baseline zenye nguvu kama RetinaNet na YOLOv8 tayari zina feature fusion na tabia za attention zilizoboreshwa, GVA hufanya zaidi kama urekebishaji wa mwisho katika modeli hizi.
Je, GVA Iliweza Kujumlishwa kwa Shabaha Tofauti za Uhisiji wa Mbali?
Katika jaribio la madarasa manne kwa YOLOv5, GVA iliongeza AP50 katika ndege, meli, tanki la kuhifadhi na daraja; wastani wa AP50 uliongezeka kutoka 0,666 hadi 0,855. Hata hivyo, ukubwa wa faida ulitofautiana sana kulingana na jiometri ya shabaha, ongezeko kubwa zaidi likiwa katika matangi ya kuhifadhi na dogo zaidi katika madaraja.
| Kategoria | Baseline AP50 | GVA AP50 | Tofauti ya moja kwa moja |
|---|---|---|---|
| Ndege | 0,680 | 0,942 | +0,262 |
| Meli | 0,914 | 0,958 | +0,044 |
| Tanki la kuhifadhi | 0,493 | 0,918 | +0,425 |
| Daraja | 0,576 | 0,603 | +0,027 |
| Wastani | 0,666 | 0,855 | +0,189 |
Chanzo kinapendekeza kwamba utaratibu wa kingo na color-rarity una ufanisi zaidi kwa shabaha zenye jiometri iliyobana na ya kawaida, huku madaraja, ambayo ni miundo mirefu ya mstari, yakiwa na ulinganifu mdogo na muundo wa sasa wa saliency.
Kwa ndege, AP50 imeripotiwa kuwa 0,940 katika jaribio kuu la modeli tano na 0,942 katika jaribio la madarasa mbalimbali. Hizi ni thamani kutoka jedwali tofauti za majaribio na hazipaswi kulazimishwa kuwa sawa.
GVA Inalingana kwa Kiasi Gani na Harakati za Macho za Binadamu?
Katika kulinganisha na human fixation heatmaps, GVA iliripotiwa kuwa na CC=0,740, NSS=2,600 na KL=0,898; thamani hizi zinaonyesha kuwa attention ya modeli ilikuwa karibu zaidi na usambazaji wa macho ya binadamu kuliko baseline detector. Hata hivyo, vipimo vilivyotumika hupima vipengele tofauti vya umakini na havipaswi kuunganishwa kuwa “asilimia moja ya kufanana na binadamu”.
Vipimo vya ulinganifu wa umakini
| Kipimo | Kina pima nini? | Mwelekeo bora |
|---|---|---|
| CC | Uhusiano wa jumla wa anga kati ya attention maps | Juu |
| SSIM | Ufanano wa anga/kimuundo | Juu |
| NSS | Kukusanyika kwa model saliency kwenye fixation points za binadamu | Juu |
| KL divergence | Tofauti kati ya usambazaji wa uwezekano wa umakini | Chini |
Ablation ya GVA ilionyesha nini?
Chanzo kinalinganisha mifumo minne:
- Itti saliency baseline,
- stimulus-driven saliency pekee,
- target-directed guidance pekee,
- Guided-Search Visual Attention kamili.
| Mbinu | CC | SSIM | NSS | KL |
|---|---|---|---|---|
| Itti | 0,388 | 0,357 | 0,920 | 1,562 |
| Stimulus-driven | 0,505 | 0,613 | 2,598 | 2,090 |
| Target-directed | 0,511 | 0,565 | 2,017 | 1,826 |
| Full GVA | 0,740 | 0,581 | 2,600 | 0,898 |
Jedwali hili linaonyesha kuwa muundo wa njia mbili unatoa ukamilishanaji mkubwa hasa katika CC na KL. GVA hutoa CC na NSS za juu zaidi na KL ya chini zaidi.
Hitilafu ya ndani ya chanzo: ingawa maandishi katika sehemu hiyo hiyo yanasema full GVA inazidi mbinu za njia moja “katika vipimo vyote”, Figure 4 inaonyesha SSIM ya 0,613 kwa stimulus-driven na 0,581 kwa full GVA. Kwa hiyo, Figure 4 haiungi mkono sentensi hiyo kwa SSIM.
Ulinganifu wa Ubongo–Modeli Ulipimwaje?
Ulinganifu wa ubongo–modeli ulipimwa kwa Spearman correlation kati ya Representational Similarity Matrices zilizotengenezwa kutoka P3, P4 na P5 features za tabaka za FPN za detector na RSM zilizotengenezwa kutoka fixation-locked EEG signals. Mbinu hii haionyeshi moja kwa moja kwamba modeli “inafikiri kama ubongo”; inapima ni kwa kiwango gani mahusiano ya uwakilishi kati ya vichocheo tofauti yanafanana na jiometri ya uwakilishi katika EEG ya binadamu.
Uundaji wa model RSMs
Target na background regions zilikatwa kutoka P3, P4 na P5 feature maps kwa ROI-Align, zikafanyiwa pooling na normalization. Model RSMs ziliundwa kwa kutumia cosine dissimilarity kati ya kila jozi ya vichocheo.
Uundaji wa EEG RSMs
EEG epochs ziligawanywa kuwa target na background kulingana na lebo za fixation. ERP signals katika maeneo manne ya korteksi zilibadilishwa kuwa feature vectors zinazolingana na mpangilio wa model feature, Fisher-Z transform ikatumika, na kisha wastani ukachukuliwa kati ya washiriki.
Uhusiano kati ya modeli na EEG RSM ulipimwa kwa Spearman rank correlation; umuhimu wa kitakwimu ulitathminiwa kwa 5.000 permutation test na FDR correction.
Nini kilitokea kati ya tabaka za P3, P4 na P5?
Katika baseline detector, uhusiano wa ubongo–modeli ulikuwa mdogo na usio thabiti; Spearman's r ilikuwa karibu 0,006–0,024.
Baada ya GVA, ulinganifu uliongezeka katika usanifu wote na kwa ujumla gradient ya tabaka inayoongezeka kutoka P3 hadi P5 ilijitokeza.
Ongezeko la juu zaidi la RSA lililoripotiwa na chanzo kwa P3–P5:
| Modeli | Ongezeko la juu la RSA | Ongezeko la wastani la RSA |
|---|---|---|
| Faster R-CNN | 133% | 108% |
| YOLOv5 | 50% | 73% |
| RetinaNet | 14% | 13% |
| CenterNet | 40% | 78% |
| YOLOv8 | 4% | 31% |
Ni muhimu kukumbuka kwamba asilimia hizi ni ongezeko la jamaa dhidi ya uhusiano mdogo wa kuanzia; thamani kamili za RSA bado ni ndogo.
GVA Ililingana Zaidi na Maeneo Gani ya Ubongo?
Katika uchanganuzi wa RSA wa kikanda, ongezeko kubwa zaidi la wastani liliripotiwa katika korteksi ya oksipitali, Δρ=0,012, na la pili katika korteksi ya frontal, Δρ=0,008. Ongezeko la parietal Δρ=0,001 na temporal Δρ=0,003 lilikuwa dogo na chanzo kinasema kwa kiasi kikubwa halikuwa na umuhimu wa kitakwimu.
Chanzo kinahusisha usambazaji huu na njia mbili za usanifu wa GVA:
- Ongezeko la oksipitali: uchakataji wa sifa za mapema za kuona kama kingo na utofauti wa rangi kupitia njia ya bottom-up saliency,
- Ongezeko la frontal: uigaji wa udhibiti wa top-down attention unaolenga shabaha kupitia njia ya task-guidance.
Tafsiri hii ni nadharia ya kimekanika. Azimio la anga la EEG, kama chanzo chenyewe linavyotaja kama kikomo, haliruhusu hitimisho la kina kuhusu taratibu ndogo za korteksi.
Je, ngazi ya tabaka na ngazi ya kuona ya binadamu ni kitu kimoja?
Chanzo kinafasiri ongezeko la RSA kutoka P3 hadi P5 baada ya GVA kama muundo unaoendana na mpangilio wa kihierarkia wa uchakataji wa mfumo wa kuona wa binadamu. Hata hivyo, haijaonyeshwa kwamba P3/P4/P5 detector features ni sawa moja kwa moja kianatomia na hatua maalum za uchakataji wa korteksi.
Kauli sahihi ni kwamba kuongezeka kwa ulinganifu wa uwakilishi kuelekea tabaka za kina za model feature hierarchy huunda muundo unaoendana zaidi na hierarchy ya uchakataji wa kuona wa binadamu ndani ya mfumo wa EEG/RSA uliotumika.
Tathmini ya kitakwimu
Kwa eye-tracking attention metrics, one-way ANOVA, FDR-adjusted Tukey HSD na sampuli 1.000 za bootstrap zilitumika.
Kwa Neural RSA, 5.000 permutation test ilitumika na FDR correction kufanywa katika kiwango cha \(\alpha=0,05\).
Chanzo kinaripoti FDR-corrected \(p<0,001\) katika ulinganisho mkuu wa visual alignment.
Matokeo yanayoungwa mkono na utafiti
- GVA ni mfumo wa attention wa njia mbili unaochanganya bottom-up na top-down attention mechanisms za guided search theory.
- Katika jaribio la ndege la DIOR, GVA iliongeza AP50 katika detector zote tano zilizojaribiwa.
- Ongezeko kubwa zaidi la AP50 ya ndege kati ya usanifu lilikuwa +0,260 kwa YOLOv5.
- Katika jaribio la jumla la kategoria nne la YOLOv5, wastani wa AP50 uliongezeka kutoka 0,666 hadi 0,855.
- GVA attention map ilifikia CC=0,740 na usambazaji wa human fixation.
- Katika Figure 4, Full GVA iko mbele ya njia moja kwa CC, NSS na KL.
- EEG–model RSA values ziliongezeka baada ya GVA katika usanifu uliojaribiwa.
- Ongezeko dhahiri zaidi la RSA ya kikanda liliripotiwa katika maeneo ya oksipitali na frontal.
- Kuingiza GVA katika detector hakubadilishi native classification/regression branches au loss functions.
Matokeo yasiyoungwa mkono na utafiti
- Haijaonyeshwa kwamba detector zinazotumia GVA hufanya hesabu sawa na ubongo wa binadamu.
- CC=0,740 haiwezi kufasiriwa kwa ujumla kuwa “modeli inafanana na ubongo wa binadamu kwa %74”.
- EEG RSA correlation si ushahidi wa usawa wa kliniki au kibayolojia.
- Cognitive alignment data haijathibitishwa kwa kategoria za shabaha isipokuwa ndege.
- Haijaonyeshwa kwamba GVA itatoa utendaji sawa kwenye SAR au hyperspectral images.
- Haijathibitishwa kwamba GVA itatoa ongezeko lilelile la AP50 katika detector zote za uhisiji wa mbali.
- Kauli “parameter-free” haimaanishi top-down Random Forest haijafundishwa.
- Figure 4 haionyeshi full GVA kuizidi stimulus-driven kwa SSIM.
- Matokeo ya preprint hayapaswi kuchukuliwa kama ushahidi wa mwisho uliopitiwa na wenzao.
Vikomo vya utafiti
Chanzo kinaeleza wazi vikomo vitatu vikuu.
- Kikomo cha data ya kognitivi: tathmini ya eye-tracking na EEG alignment inapatikana tu kwa shabaha za ndege. Ingawa utendaji wa detector umejaribiwa katika kategoria nyingine, hakuna human cognitive benchmark inayolingana bado.
- Kikomo cha modality: utafiti ulifanywa tu kwenye optical remote sensing images; SAR na hyperspectral images hazijajaribiwa.
- Azimio la anga la EEG: EEG huzuia uchanganuzi wa neural mechanism katika maeneo makubwa ya ubongo ya kiutendaji.
Maeneo ya utafiti wa baadaye
Waandishi wanapendekeza kwamba bottom-up saliency mechanism inaweza kubadilishwa kwa modalities tofauti za sensor. Kwa SAR, polarimetric signatures, na kwa hyperspectral images, spectral band features zinaweza kuwa uwakilishi mbadala wa taarifa za rangi.
Katika matumizi ya uchunguzi wa maeneo makubwa yenye mifano michache yenye lebo, kujifunza top-down prior kwa unsupervised au self-supervised methods pia kunatajwa kama mwelekeo wa utafiti wa baadaye.
Utafiti pia unapendekeza kwamba kuingizwa kwa GVA kunaweza kuwa na uwezo kwa lightweight na edge-processing architectures kwa sababu hakuongezi trainable neural-network parameters mpya kwenye detector; hata hivyo, hakuna jaribio la kina la latency au matumizi ya nishati kwenye kifaa halisi cha edge lililoripotiwa.
Maelezo ya Chanzo na Mbinu
Kichwa asili: Embedding human-like visual attention for brain-aligned and high-performance remote sensing object detection
Waandishi: Bing He, Tong Qin, Dajun Xing, Ying Qu, Qiaosong Hei, Chunfeng Gao, Zheng Gong, Qiao Wang, Weihua Dong
Aina ya chanzo: Makala ya utafiti ya preprint.
Nambari ya usajili ya SSRN: 7346288.
Ilipakiwa SSRN: 24 Agosti 2026.
Hali ya peer review: Chanzo kinasema wazi “This preprint research paper has not been peer reviewed”.
Mbinu kuu: Guided-Search Visual Attention (GVA).
Msingi wa kinadharia: Guided search theory; muunganiko wa stimulus-driven saliency na target-directed guidance ili kuunda priority map.
Detector: Faster R-CNN, RetinaNet, YOLOv5s, YOLOv8n na CenterNet.
Seti kuu ya data ya utambuzi wa vitu: DIOR.
Kognitivi benchmark: EEGET-RSOD; picha 1.000 za 800×800 remote sensing na data ya wakati mmoja ya eye-tracking–EEG kutoka kwa washiriki 38.
Idhini ya maadili: Beijing Normal University Ethics Committee, No. 20221024111.
Eye tracker: SMI RED250, 250 Hz.
EEG: NE Enobio, 32 channel, 500 Hz, mpangilio wa 10–20.
Visual alignment metrics: Pearson correlation coefficient (CC), structural similarity index (SSIM), normalized scanpath saliency (NSS), Kullback–Leibler divergence (KL).
Neural alignment method: Representational Similarity Analysis (RSA), model P3/P4/P5 FPN features na fixation-locked EEG RSMs.
Data availability: Chanzo kinataja seti ya data ya EEGET-RSOD kwenye Figshare kwa DOI 10.6084/m9.figshare.26943565.
Code availability: Chanzo kinasema code ya uchanganuzi ipo GitHub katika repository “Bing-1997/Human-like_visual_attention_embedding_framework”.
Nuance muhimu ya ndani ya chanzo: GVA haiongezi trainable neural-network parameters mpya kwenye detector; hata hivyo, njia ya target-directed hutumia Random Forest iliyofundishwa kwa mifano 500 yenye lebo.
Hitilafu muhimu ya ndani ya chanzo: katika Figure 4 full GVA SSIM=0,581 huku stimulus-driven saliency SSIM=0,613; kwa hiyo sentensi ya sehemu hiyo inayosema “full GVA all metrics'te üstündür” haipatani na mchoro kwa SSIM.
Kikomo kikuu cha tafsiri: Matokeo ya “Brain-aligned” yanamaanisha ufanano wa uwakilishi/umakini uliopimwa kwa EEG/RSA na eye-tracking metrics; hayamaanishi usawa wa moja kwa moja wa utaratibu wa kibayolojia au kunakili mchakato wa hesabu wa ubongo.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *