

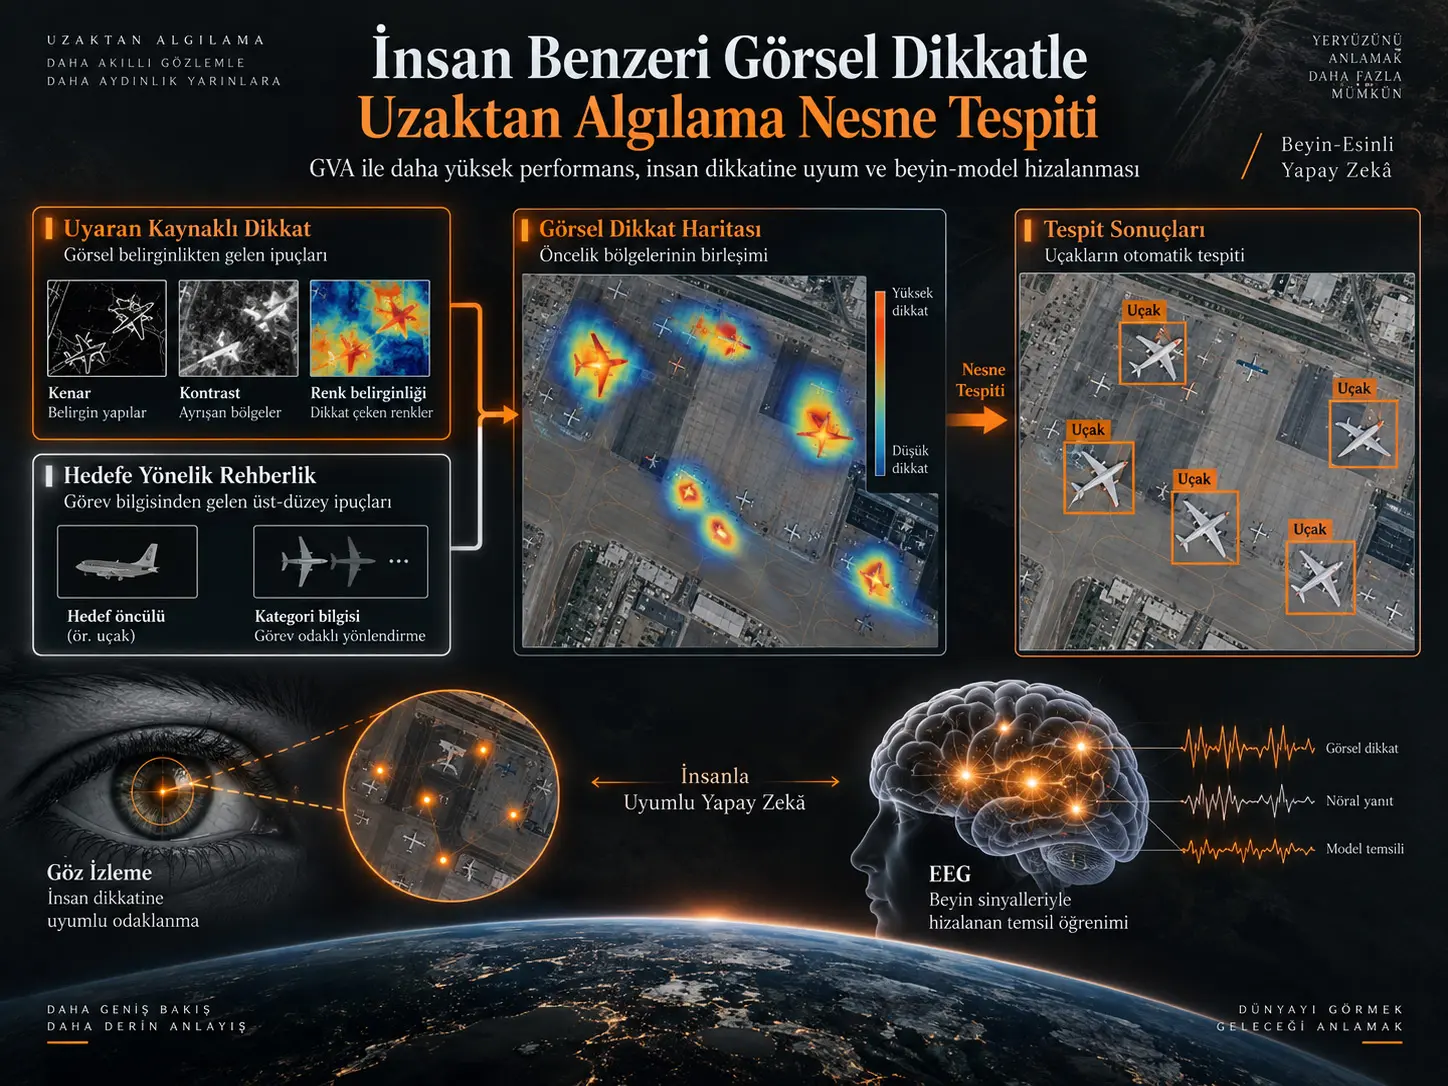
Guided-Search Visual Attention (GVA), insan görsel aramasındaki uyaran kaynaklı görsel belirginlik ile görev hedefli dikkat yönlendirmesini birlikte modelleyerek uzaktan algılama nesne tespit ağlarının özellik işleme sürecini düzenleyen beyin-esinli bir dikkat çerçevesidir. Çalışma, GVA'yı Faster R-CNN, RetinaNet, YOLOv5s, YOLOv8n ve CenterNet olmak üzere beş farklı nesne tespit mimarisine yerleştirmiş; performansı DIOR veri setinde, insanla davranışsal uyumu eşzamanlı göz izleme verisiyle ve beyin–model temsil uyumunu EEG tabanlı representational similarity analysis ile değerlendirmiştir. Uçak kategorisinde bütün mimariler AP50 artışı göstermiş ve en büyük mutlak artış YOLOv5 için +0,260 olmuştur. GVA dikkat haritasının insan fiksasyon dağılımlarıyla Pearson korelasyonu 0,740'a ulaşmış; EEG–model RSA analizinde en belirgin hizalama artışları erken görsel kodlamayla ilişkili oksipital bölge ve top-down dikkat kontrolüyle ilişkili frontal bölgede raporlanmıştır. Bununla birlikte çalışma henüz hakem değerlendirmesinden geçmemiş bir preprinttir ve beyin hizalaması yalnız kullanılan EEG/RSA ölçüm çerçevesi içinde yorumlanmalıdır.
Günümüz uzaktan algılama modellerinde attention mekanizmaları yaygın biçimde kullanılmaktadır; ancak bu mekanizmaların büyük bölümü insan görsel dikkatini taklit etmek amacıyla değil, doğrudan görev performansını optimize etmek amacıyla öğrenilir. Dolayısıyla modelin dikkat ettiği bölgeler ile profesyonel insan gözlemcilerin görüntüde aradığı bölgeler birbirinden ayrılabilir.
Makalenin çıkış noktası bu ayrımdır. Araştırmacılar, model dikkatini doğrudan insan fiksasyon haritalarına uydurmak yerine insan görsel aramasının altında yatan guided search mekanizmasını hesaplamalı bir modüle dönüştürmeyi önermektedir. Böylece insan davranışının yalnız sonucunu kopyalamak yerine, dikkat dağılımına yol açan iki ana süreç modellenmeye çalışılmaktadır.
Birinci süreç stimulus-driven saliency, yani görüntünün kenar, renk farklılığı ve yerel sıra dışılığı gibi düşük seviyeli özelliklerin dikkati kendiliğinden çekmesidir. İkinci süreç target-directed guidance, yani gözlemcinin “uçak arıyorum” gibi görev hedefinin dikkati hedefe benzeyen bölgelere yönlendirmesidir. GVA bu iki haritayı birleştirerek hem görsel olarak dikkat çekici hem de görev açısından anlamlı bölgeleri öne çıkarır.
İnsan Benzeri Görsel Dikkat Neden Uzaktan Algılama Nesne Tespitinde Önemlidir?
İnsan benzeri görsel dikkat, modelin görüntüde yalnız istatistiksel olarak güçlü özelliklere değil, insanların hedef ararken öncelik verdiği görsel ve görev ilişkili bölgelere odaklanmasını amaçlar. Uzaktan algılama görüntülerinde hedeflerin küçük, seyrek ve yoğun arka plan içinde bulunabilmesi nedeniyle böyle bir dikkat mekanizması yanlış pozitifleri azaltabilir, kaçırılan hedefleri düşürebilir ve model kararlarının insan görsel arama stratejileriyle daha kolay karşılaştırılabilmesini sağlayabilir.
Uzaktan algılama görüntülerinde havaalanı pistleri, kara yüzeyleri, su alanları, binalar veya diğer yoğun dokular hedef olmayan fakat güçlü görsel özellikler oluşturabilir. Geleneksel bir detector bu bölgelerde yüksek aktivasyon üreterek gereksiz bounding box'lar oluşturabilir.
İnsan gözlemci ise görüntüdeki bütün yüksek kontrastlı bölgelere eşit davranmaz. Görüntünün kendisinden gelen görsel belirginliği, aradığı nesneye ilişkin önbilgiyle birleştirir. Guided search theory, insan görsel aramasını tam olarak bu iki bilgi akışının birleşimi olarak kavramsallaştırmaktadır.
Guided Search Theory GVA Modeline Nasıl Dönüştürülüyor?
GVA, guided search theory'deki iki temel dikkat kaynağını ayrı hesaplama yolları olarak uygular: bottom-up yol görüntünün kenar ve renk sıra dışılığı gibi görevden bağımsız görsel özelliklerini çıkarırken, top-down yol hedef sınıfına ilişkin öğrenilmiş görsel önbilgiden bir hedef olasılık haritası üretir. İki harita piksel düzeyinde çarpılarak ortak bir öncelik haritası oluşturulur ve yalnız hem belirgin hem de görevle ilişkili bölgeler güçlü dikkat kazanır.
Bottom-up: Uyaran kaynaklı belirginlik yolu
Stimulus-driven saliency yolu hedefin ne olduğunu bilmeden görüntünün kendi görsel özelliklerine göre dikkat haritası üretir. Kaynak bu işlem hattını tamamen açıklanabilir klasik görüntü işleme adımlarıyla kurmaktadır.
Önce görüntü mean-shift filtering ile işlenir ve CIE-Lab renk uzayına dönüştürülür. Ardından üç ölçekli Gaussian pyramid kullanılır:
- 1× özgün çözünürlük,
- 0,5× ölçek,
- 0,25× ölçek.
Her ölçekte 3×3 Sobel operatörüyle kenar özellikleri çıkarılır. Buna ek olarak her pikselin çevresine göre ne kadar nadir veya sıra dışı bir renk taşıdığını ölçen color-rarity haritası hesaplanır.
Bottom-up attention map kaynakta şu biçimde tanımlanır:
\[ M_{bu}(x,y)= \mathcal{N} \left[ \sum_{s=1}^{3} w_s \left( E_s(x,y)+C_s(x,y) \right) \right] \]
Burada \(E_s\), s ölçeğindeki kenar özellik haritasını; \(C_s\), renk nadirliği haritasını; \(w_s\), ölçek ağırlığını ve \(\mathcal{N}\) min-max normalizasyonunu temsil eder.
Top-down: Hedef yönelimli rehberlik yolu
İkinci yol, göreve özgü hedef bilgisini attention map'e taşır. Çalışmada uçak hedeflerinin Lab renk imzalarını öğrenmek için 500 elle etiketlenmiş uçak örneği üzerinde Random Forest sınıflandırıcısı eğitilmiştir.
Random Forest:
- 10 ağaç,
- maksimum derinlik 5
kullanır ve her piksel için hedef olasılığı üretir. Bu harita 5×5 Gaussian kernel ve \(\sigma=2\) ile yumuşatılır.
Top-down guidance map:
\[ M_{td}(x,y)= \mathcal{N} \left[ G_{\sigma=2} * RF(Lab(x,y)) \right] \]
biçiminde ifade edilmektedir.
Buradaki Random Forest, detector'ın eğitim/test bölümlerinden bağımsız yardımcı görüntü yamalarıyla eğitilerek veri sızıntısını önleyecek biçimde yapılandırılmıştır.
İki dikkat yolu nasıl birleşiyor?
Bottom-up ve top-down attention haritaları element-wise multiplication ile birleştirilir. Böylece yalnız fiziksel olarak dikkat çekici olan fakat hedefle ilgisiz alanların ve yalnız hedefe benzeyen fakat görsel kanıtı zayıf alanların baskılanması amaçlanır.
Birleşik harita marker-controlled watershed algoritmasıyla aday bölgelere ayrılır. Kaynakta adayların şu koşullarla filtrelendiği belirtilmektedir:
- alan: 50–8000 piksel,
- en-boy oranı: 0,2–5.
Geçerli bölge merkezlerine \(\sigma=10\) piksel olan iki-boyutlu Gaussian çekirdekler yerleştirilerek son insan-benzeri attention map oluşturulur:
\[ A_{GVA}(x,y)= \mathcal{N} \left[ \sum_{k=1}^{K} \mathcal{G} \left( (x,y);c_k,\sigma=10 \right) \right] \]
Burada \(K\) geçerli aday bölge sayısını, \(c_k\) ise bu bölgelerin merkezlerini ifade eder.
GVA Gerçekten Parametresiz Bir Dikkat Modülü müdür?
GVA'nın detector ağına gömülmesi yeni öğrenilebilir derin ağ parametreleri eklememektedir ve bottom-up saliency yolu deterministik görüntü işleme işlemlerinden oluşmaktadır; ancak top-down rehberlik yolu 500 etiketli örnek üzerinde eğitilmiş bir Random Forest kullanır. Bu nedenle kaynakta geçen “parameter-free” ifadesi, GVA'nın bütün hesaplama zincirinde hiçbir öğrenilmiş bileşen bulunmadığı anlamında değil, detector mimarisine yeni optimize edilen sinir ağı parametreleri eklenmemesi anlamında dikkatli biçimde yorumlanmalıdır.
Bu ayrım metodolojik olarak önemlidir. Kaynak, detector'ın sınıflandırma ve regression kollarının değiştirilmediğini, GVA'nın native loss fonksiyonlarını koruduğunu ve detector eğitimine yeni learnable layer eklemediğini belirtmektedir.
Ancak hedef yönelimli attention map'in oluşturulması için kullanılan Random Forest önceden eğitilmektedir. Dolayısıyla GVA'nın top-down bileşeni hedef sınıfına ilişkin öğrenilmiş bilgi taşımaktadır.
GVA beş farklı detector'a nasıl gömülüyor?
| Mimari | Detector türü | GVA gömme yaklaşımı |
|---|---|---|
| Faster R-CNN | İki aşamalı | Watershed ile elde edilen GVA candidate box'ları klasik yoğun anchor'ların yerine kullanılır; bölgedeki ortalama attention skoru proposal confidence olarak değerlendirilir. |
| RetinaNet | Tek aşamalı, anchor-based | GVA adayları önceden tanımlı multi-scale anchor grid'lerin yerine kullanılır. |
| YOLOv5s | Tek aşamalı, anchor-based | GVA binary mask özellik haritalarının boyutuna ölçeklenir; gradient backpropagation ve çıktı bölgeleri insan-benzeri attention alanlarıyla sınırlandırılır. |
| YOLOv8n | Tek aşamalı | GVA maskesi feature-map ölçeğine uyarlanarak feature allocation ve prediction alanlarını modüle eder. |
| CenterNet | Anchor-free | Yeniden ölçeklenmiş GVA maskesi center-point heatmap tahminlerini modüle eder. |
Çalışmanın önemli tasarım kararı, GVA'yı detector backbone ile Feature Pyramid Network (FPN) arasına yerleştirerek temel detector mimarisini mümkün olduğunca bozmamaktır.
Çalışmanın Yöntemi ve Bulguları
EEGET-RSOD göz izleme ve EEG veri seti
İnsan davranışı ve beyin temsili için benchmark olarak EEGET-RSOD veri seti kullanılmıştır. Veri setinde DIOR'dan alınmış 1.000 adet 800×800 piksel optik uzaktan algılama görüntüsü bulunmaktadır.
Çalışmaya 38 katılımcı dahil edilmiştir ve kaynak bütün katılımcıların yazılı informed consent verdiğini belirtmektedir. Etik onay Beijing Normal University Ethics Committee tarafından 20221024111 numarasıyla verilmiştir.
| Ölçüm | Donanım / parametre |
|---|---|
| Göz izleme | SMI RED250, 250 Hz |
| EEG | NE Enobio, 32 kanal, 500 Hz, 10–20 yerleşimi |
| Senkronizasyon | <2 ms trigger hatası |
| Uyaran süresi | 3000 ms |
| Boş ekran | 500 ms |
Fiksasyonlar I-DT algoritmasıyla çıkarılmış ve grup fixation heatmap'leri \(\sigma=8\) Gaussian kernel ile oluşturulmuştur.
EEG ön işleme
EEG sinyallerine:
- 0,5–45 Hz filtreleme,
- mastoid re-referencing,
- ICA ile artefakt temizleme,
- −200–0 ms baseline correction
uygulanmıştır.
Dört fonksiyonel bölge farklı zaman pencereleriyle tanımlanmıştır:
| Beyin bölgesi | Zaman penceresi |
|---|---|
| Oksipital | 0–300 ms |
| Temporal | 100–400 ms |
| Frontal | 200–500 ms |
| Parietal | 300–600 ms |
Whole-brain Representational Similarity Matrices ise 0–600 ms penceresinde oluşturulmuştur.
Detector eğitim düzeni
Detector deneylerinin ana bölümü DIOR uçak alt kümesinde gerçekleştirilmiştir.
| Parametre | Değer |
|---|---|
| Train / validation / test | 7 : 2 : 1 |
| Framework | PyTorch |
| GPU | RTX 4090 |
| Batch size | 16 |
| Girdi çözünürlüğü | 800×800 |
| Epoch | 300 |
| Backbone başlangıcı | ImageNet pre-trained |
| Checkpoint seçimi | En yüksek AP50 |
GVA Nesne Tespit Performansını Ne Kadar Artırdı?
DIOR uçak testinde GVA'nın eklenmesi beş detector'ın tamamında AP50'yi artırmıştır; en büyük mimariler arası mutlak artış YOLOv5'te 0,680'den 0,940'a çıkarak +0,260 olmuştur. Daha zayıf başlangıç modelleri daha büyük kazançlar elde ederken, başlangıç performansı zaten yüksek RetinaNet ve YOLOv8'de artışlar daha küçüktür.
| Model | Baseline Precision | Baseline Recall | Baseline AP50 | GVA Precision | GVA Recall | GVA AP50 | AP50 farkı |
|---|---|---|---|---|---|---|---|
| Faster R-CNN | 0,915 | 0,442 | 0,600 | 0,786 | 0,739 | 0,760 | +0,160 |
| YOLOv5 | 0,717 | 0,647 | 0,680 | 0,979 | 0,907 | 0,940 | +0,260 |
| CenterNet | 0,841 | 0,775 | 0,810 | 0,901 | 0,852 | 0,880 | +0,070 |
| RetinaNet | 0,982 | 0,874 | 0,920 | 0,991 | 0,918 | 0,950 | +0,030 |
| YOLOv8 | 0,982 | 0,932 | 0,920 | 0,974 | 0,938 | 0,960 | +0,040 |
Faster R-CNN özelinde baseline model çok yüksek precision'a rağmen yalnız 0,442 recall göstermektedir. GVA sonrasında recall 0,739'a çıkarken precision 0,786'ya gerilemiş, fakat AP50 toplamda 0,600'den 0,760'a yükselmiştir.
YOLOv5'te hem precision hem recall aynı anda yükselmiş ve bu model en büyük genel detector kazancını elde etmiştir.
Güçlü modeller neden daha az kazanıyor?
Kaynağın yorumu, düşük başlangıç performansına sahip modellerde arka plan baskılama ve precision–recall dengesi açısından daha fazla iyileştirme alanı bulunmasıdır. RetinaNet ve YOLOv8 gibi güçlü baseline'lar zaten gelişmiş feature fusion ve attention davranışına sahip olduğundan GVA bu modellerde daha çok ince ayar etkisi göstermektedir.
GVA Farklı Uzaktan Algılama Hedeflerine Genellenebildi mi?
YOLOv5 üzerinde yapılan dört-sınıflı deneyde GVA uçak, gemi, depolama tankı ve köprü kategorilerinin tamamında AP50 artışı sağlamıştır; ortalama AP50 0,666'dan 0,855'e yükselmiştir. Ancak kazanç büyüklüğü hedef geometrisine göre büyük ölçüde değişmiş, en büyük artış depolama tanklarında ve en küçük artış köprülerde görülmüştür.
| Kategori | Baseline AP50 | GVA AP50 | Mutlak fark |
|---|---|---|---|
| Uçak | 0,680 | 0,942 | +0,262 |
| Gemi | 0,914 | 0,958 | +0,044 |
| Depolama tankı | 0,493 | 0,918 | +0,425 |
| Köprü | 0,576 | 0,603 | +0,027 |
| Ortalama | 0,666 | 0,855 | +0,189 |
Kaynak, kompakt ve düzenli geometrili hedeflerde kenar ve renk-rarity mekanizmasının daha etkili olduğunu, uzun doğrusal yapılar olan köprülerin mevcut saliency tasarımıyla daha az uyumlu olduğunu ileri sürmektedir.
Uçak için ana beş-model deneyinde AP50 0,940 olarak, kategoriler arası deneyde ise 0,942 olarak raporlanmıştır. Bunlar farklı deney tablolarında verilen değerlerdir ve tek bir değere zorla eşitlenmemelidir.
GVA İnsan Göz Hareketleriyle Ne Kadar Uyumlu?
İnsan fixation heatmap'leriyle yapılan karşılaştırmada GVA için CC=0,740, NSS=2,600 ve KL=0,898 bildirilmiştir; bu değerler model attention'ının insan bakış dağılımına baseline detector'lardan daha yakın olduğunu göstermektedir. Bununla birlikte kullanılan metrikler farklı dikkat özelliklerini ölçer ve tek bir “insana benzerlik yüzdesi” olarak birleştirilmemelidir.
Dikkat hizalama metrikleri
| Metrik | Ne ölçer? | Daha iyi yön |
|---|---|---|
| CC | Attention haritaları arasındaki genel uzamsal korelasyon | Yüksek |
| SSIM | Uzamsal/yapısal benzerlik | Yüksek |
| NSS | Model saliency'sinin insan fiksasyon noktalarında yoğunlaşması | Yüksek |
| KL divergence | İki dikkat olasılık dağılımı arasındaki fark | Düşük |
GVA ablasyonu ne gösterdi?
Kaynak dört sistemi karşılaştırmaktadır:
- Itti saliency baseline,
- yalnız stimulus-driven saliency,
- yalnız target-directed guidance,
- tam Guided-Search Visual Attention.
| Yöntem | CC | SSIM | NSS | KL |
|---|---|---|---|---|
| Itti | 0,388 | 0,357 | 0,920 | 1,562 |
| Stimulus-driven | 0,505 | 0,613 | 2,598 | 2,090 |
| Target-directed | 0,511 | 0,565 | 2,017 | 1,826 |
| Full GVA | 0,740 | 0,581 | 2,600 | 0,898 |
Bu tablo çift-yol tasarımının özellikle CC ve KL açısından güçlü tamamlayıcılık sağladığını göstermektedir. GVA en yüksek CC ve NSS ile en düşük KL değerini verir.
Kaynak içi tutarsızlık: aynı bölümün metni tam GVA'nın “tüm metriklerde” tek-yollu yöntemleri geçtiğini söylese de Şekil 4'te stimulus-driven yolun SSIM değeri 0,613, tam GVA'nınki 0,581'dir. Dolayısıyla SSIM açısından Şekil 4 bu cümleyi desteklememektedir.
Beyin–Model Hizalanması Nasıl Ölçüldü?
Beyin–model hizalaması, detector'ın FPN katmanlarındaki P3, P4 ve P5 özelliklerinden oluşturulan Representational Similarity Matrices ile fixation-locked EEG sinyallerinden oluşturulan RSM'lerin Spearman korelasyonu üzerinden ölçülmüştür. Bu yöntem modelin “beyin gibi düşündüğünü” doğrudan göstermez; farklı uyaranlar arasındaki temsil ilişkilerinin insan EEG'sindeki temsil geometrisine ne ölçüde benzediğini test eder.
Model RSM'lerinin oluşturulması
Target ve background bölgeleri ROI-Align ile P3, P4 ve P5 feature map'lerinden kırpılmış, pooled ve normalize edilmiştir. Her uyaran çifti arasındaki cosine dissimilarity kullanılarak model RSM'leri oluşturulmuştur.
EEG RSM'lerinin oluşturulması
EEG epoch'ları göz fiksasyon etiketlerine göre target ve background olarak ayrılmıştır. Dört kortikal bölgedeki ERP sinyalleri model feature sırasıyla eşleştirilen feature vektörlerine dönüştürülmüş, Fisher-Z transform uygulanmış ve katılımcılar arasında ortalanmıştır.
Model ile EEG RSM arasındaki ilişki Spearman rank correlation ile ölçülmüş; istatistiksel anlamlılık 5.000 permutation testi ve FDR correction ile değerlendirilmiştir.
P3, P4 ve P5 katmanları arasında ne oldu?
Baseline detector'larda beyin–model korelasyonları düşük ve düzensizdir; Spearman's r yaklaşık 0,006–0,024 aralığındadır.
GVA sonrasında hizalama tüm mimarilerde artmış ve genel olarak P3'ten P5'e doğru güçlenen bir katman gradyanı ortaya çıkmıştır.
Kaynağın P3–P5 üzerinden raporladığı maksimum RSA artışları:
| Model | Maksimum RSA artışı | Ortalama RSA artışı |
|---|---|---|
| Faster R-CNN | 133% | 108% |
| YOLOv5 | 50% | 73% |
| RetinaNet | 14% | 13% |
| CenterNet | 40% | 78% |
| YOLOv8 | 4% | 31% |
Bu yüzde artışların düşük başlangıç korelasyonlarına göre göreli artışlar olduğu unutulmamalıdır; mutlak RSA değerleri küçük kalmaktadır.
GVA Hangi Beyin Bölgeleriyle Daha Fazla Hizalandı?
Bölgesel RSA analizinde en büyük ortalama artış oksipital kortekste Δρ=0,012, ikinci büyük artış frontal kortekste Δρ=0,008 olarak bildirilmiştir. Parietal Δρ=0,001 ve temporal Δρ=0,003 artışları daha küçüktür ve kaynakta çoğunlukla istatistiksel olarak anlamlı olmadığı belirtilmektedir.
Kaynak bu dağılımı GVA mimarisinin iki yoluyla ilişkilendirmektedir:
- Oksipital artış: kenar ve renk kontrastı gibi erken görsel özelliklerin bottom-up saliency yoluyla işlenmesi,
- Frontal artış: hedefe yönelik top-down dikkat kontrolünün task-guidance yoluyla modellenmesi.
Bu yorum mekanistik bir hipotezdir. EEG'nin mekânsal çözünürlüğü, kaynağın kendisinin de sınırlılık olarak belirttiği üzere, ince ölçekli kortikal mekanizma çıkarımlarına izin vermemektedir.
Katman hiyerarşisi ile insan görsel hiyerarşisi aynı şey midir?
Kaynak, GVA sonrasında P3'ten P5'e artan RSA'yı insan görsel sisteminin hiyerarşik işleme düzeniyle tutarlı bir örüntü olarak yorumlamaktadır. Bununla birlikte P3/P4/P5 detector özellikleri ile belirli kortikal işleme aşamalarının birebir anatomik eşdeğer olduğu gösterilmemiştir.
Doğru ifade, model feature hiyerarşisindeki temsil uyumunun derin katmanlara doğru artmasının kullanılan EEG/RSA çerçevesinde insan görsel işleme hiyerarşisiyle daha uyumlu bir örüntü oluşturduğudur.
İstatistiksel değerlendirme
Göz izleme attention metrikleri için one-way ANOVA, FDR-adjusted Tukey HSD ve 1.000 bootstrap örneği kullanılmıştır.
Neural RSA için 5.000 permutation testi uygulanmış ve \(\alpha=0,05\) düzeyinde FDR correction yapılmıştır.
Kaynak, ana visual alignment karşılaştırmalarında FDR-corrected \(p<0,001\) bildirmektedir.
Çalışmanın desteklediği sonuçlar
- GVA, guided search theory'deki bottom-up ve top-down dikkat mekanizmalarını birleştiren çift-yollu bir attention çerçevesidir.
- DIOR uçak testinde GVA test edilen beş detector'ın tamamında AP50'yi artırmıştır.
- En büyük mimariler arası uçak AP50 artışı YOLOv5 için +0,260'tır.
- YOLOv5'in dört kategorili genelleme deneyinde ortalama AP50 0,666'dan 0,855'e yükselmiştir.
- GVA attention map'i insan fixation dağılımıyla CC=0,740 değerine ulaşmıştır.
- Full GVA, Şekil 4'te CC, NSS ve KL bakımından tek yolların önündedir.
- EEG–model RSA değerleri GVA sonrasında test edilen mimarilerde artmıştır.
- En belirgin bölgesel RSA artışları oksipital ve frontal bölgelerde raporlanmıştır.
- GVA'nın detector'a gömülmesi native classification/regression branch'lerini ve loss fonksiyonlarını değiştirmemektedir.
Çalışmanın desteklemediği sonuçlar
- GVA kullanan detector'ların insan beyniyle aynı hesaplamayı yaptığı gösterilmemiştir.
- CC=0,740 değeri genel anlamda “model %74 insan beynine benziyor” biçiminde yorumlanamaz.
- EEG RSA korelasyonu klinik veya biyolojik eşdeğerlik kanıtı değildir.
- Kognitif alignment verisi uçak dışındaki hedef kategorilerinde henüz doğrulanmamıştır.
- GVA'nın SAR veya hyperspectral görüntülerde aynı performansı vereceği gösterilmemiştir.
- GVA'nın bütün uzaktan algılama detector'larında aynı AP50 artışını sağlayacağı kanıtlanmamıştır.
- “Parameter-free” ifadesi, top-down Random Forest'ın hiçbir eğitim görmediği anlamına gelmez.
- Şekil 4, full GVA'nın SSIM'de stimulus-driven yolu geçtiğini göstermemektedir.
- Preprint sonuçları hakemli nihai kanıt olarak değerlendirilmemelidir.
Çalışmanın sınırlılıkları
Kaynak üç ana sınırlılığı açık biçimde belirtmektedir.
- Kognitif veri sınırlılığı: göz izleme ve EEG alignment değerlendirmesi yalnız uçak hedefleri için mevcuttur. Diğer kategorilerde detector performansı test edilmiş olsa da karşılık gelen insan cognitive benchmark henüz yoktur.
- Modalite sınırlılığı: çalışma yalnız optik remote sensing görüntülerinde yapılmıştır; SAR ve hyperspectral görüntüler test edilmemiştir.
- EEG mekânsal çözünürlüğü: EEG, neural mechanism analizini makroskopik fonksiyonel beyin bölgeleriyle sınırlar.
Gelecek araştırma alanları
Yazarlar bottom-up saliency mekanizmasının farklı sensör modalitelerine uyarlanabileceğini önermektedir. SAR için polarimetric signatures, hyperspectral görüntüler için spectral band özellikleri renk bilgisinin yerine kullanılabilecek aday temsillerdir.
Etiketli örneğin az olduğu büyük alanlı gözlem uygulamalarında top-down prior'ın unsupervised veya self-supervised yöntemlerle öğrenilmesi de gelecekteki çalışma yönü olarak belirtilmektedir.
Çalışma ayrıca GVA gömülmesinin detector'a yeni trainable neural-network parametreleri eklememesi nedeniyle lightweight ve edge-processing mimarileri için potansiyel taşıdığını ileri sürmektedir; ancak gerçek edge cihazında ayrıntılı latency veya enerji tüketimi deneyi raporlanmamaktadır.
Kaynak ve Yöntem Notu
Özgün başlık: Embedding human-like visual attention for brain-aligned and high-performance remote sensing object detection
Yazarlar: Bing He, Tong Qin, Dajun Xing, Ying Qu, Qiaosong Hei, Chunfeng Gao, Zheng Gong, Qiao Wang, Weihua Dong
Kaynak türü: Preprint araştırma makalesi.
SSRN kayıt numarası: 7346288.
SSRN'ye yüklenme: 24 Ağustos 2026.
Hakemlik durumu: Kaynak açıkça “This preprint research paper has not been peer reviewed” ifadesini taşımaktadır.
Ana yöntem: Guided-Search Visual Attention (GVA).
Kuramsal temel: Guided search theory; stimulus-driven saliency ve target-directed guidance yollarının priority map üretmek üzere birleştirilmesi.
Detector'lar: Faster R-CNN, RetinaNet, YOLOv5s, YOLOv8n ve CenterNet.
Temel nesne tespit veri seti: DIOR.
Kognitif benchmark: EEGET-RSOD; 1.000 adet 800×800 remote sensing görüntüsü ve 38 katılımcının eşzamanlı göz izleme–EEG verileri.
Etik onay: Beijing Normal University Ethics Committee, No. 20221024111.
Eye tracker: SMI RED250, 250 Hz.
EEG: NE Enobio, 32 kanal, 500 Hz, 10–20 yerleşimi.
Visual alignment metrikleri: Pearson correlation coefficient (CC), structural similarity index (SSIM), normalized scanpath saliency (NSS), Kullback–Leibler divergence (KL).
Neural alignment yöntemi: Representational Similarity Analysis (RSA), model P3/P4/P5 FPN özellikleri ve fixation-locked EEG RSM'leri.
Data availability: EEGET-RSOD veri seti Figshare üzerinde 10.6084/m9.figshare.26943565 DOI'siyle kaynakta belirtilmektedir.
Code availability: Kaynak, analiz kodunun GitHub'da “Bing-1997/Human-like_visual_attention_embedding_framework” deposunda bulunduğunu belirtmektedir.
Kaynak içi önemli nüans: GVA detector'a yeni öğrenilebilir neural-network parametreleri eklememektedir; buna karşılık target-directed yol 500 etiketli örnek üzerinde eğitilen bir Random Forest kullanmaktadır.
Kaynak içi önemli tutarsızlık: Şekil 4'te full GVA SSIM=0,581, stimulus-driven saliency SSIM=0,613'tür; bu nedenle aynı bölümdeki “full GVA all metrics'te üstündür” cümlesi SSIM açısından şekille uyuşmamaktadır.
Temel yorum sınırı: “Brain-aligned” sonucu EEG/RSA ve eye-tracking metriklerinde ölçülen temsil/dikkat benzerliği anlamındadır; doğrudan biyolojik mekanizma eşdeğerliği veya beynin hesaplama sürecinin kopyalanması anlamına gelmez.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir