

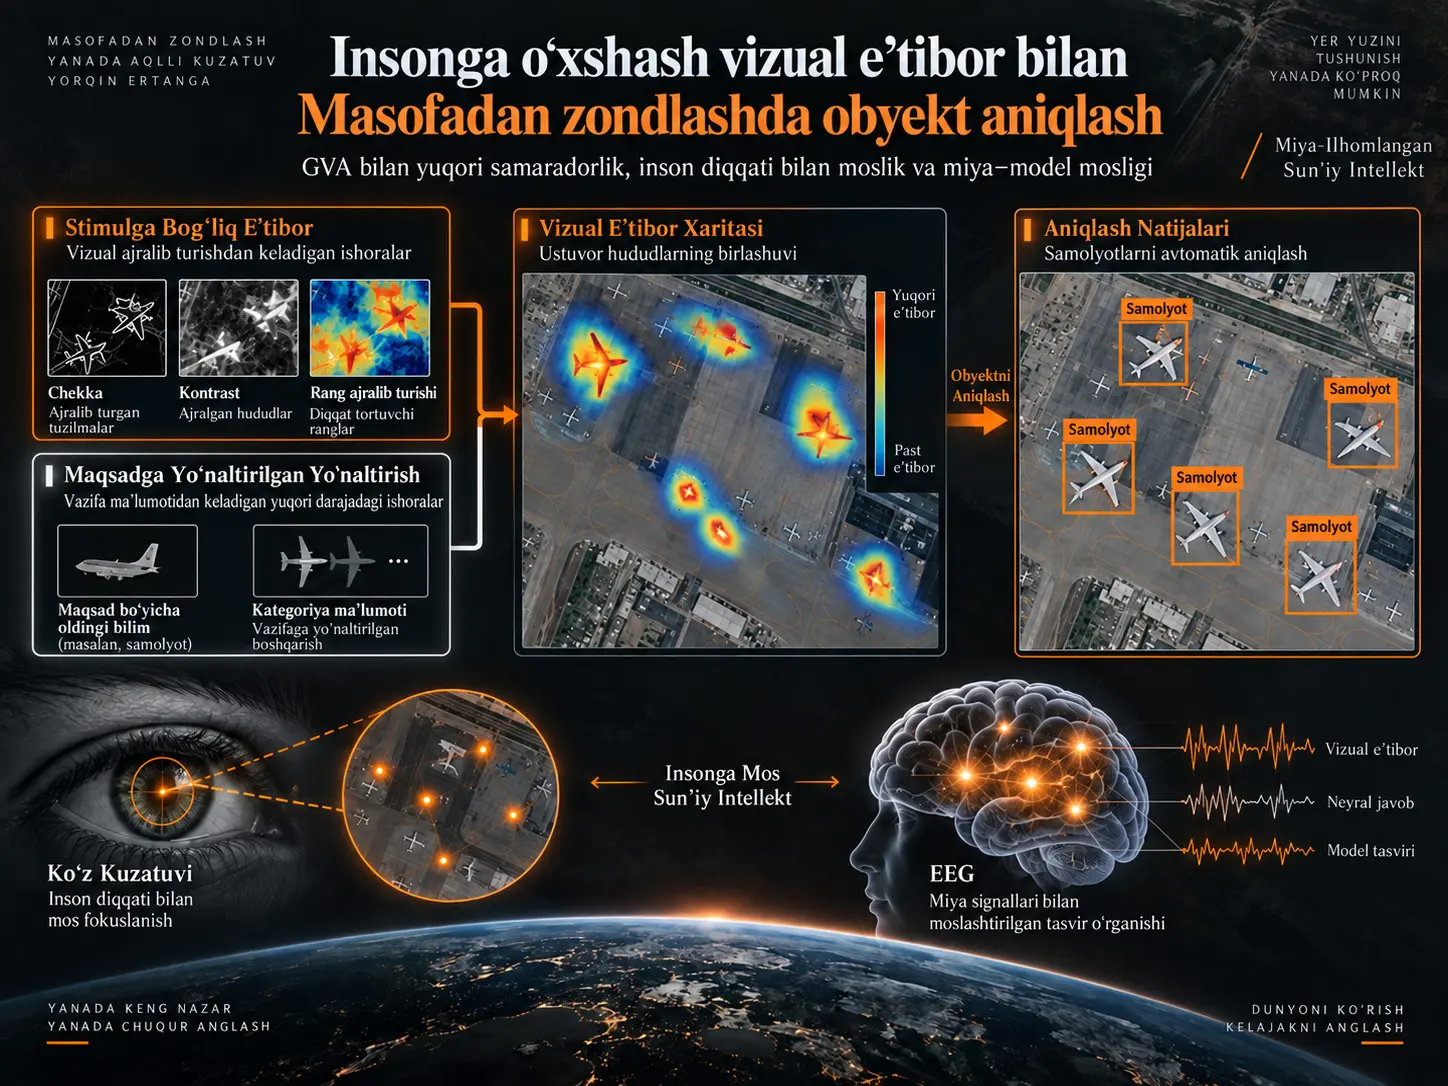
Guided-Search Visual Attention (GVA) — insonning vizual qidiruvidagi stimulga bogʻliq vizual ajralib turish va vazifa maqsadiga yoʻnaltirilgan eʼtibor boshqaruvini birgalikda modellashtirib, masofadan zondlash obyektlarini aniqlash tarmoqlarining xususiyatlarni qayta ishlash jarayonini tartibga soluvchi miya-ilhomlangan eʼtibor doirasidir. Tadqiqot GVA’ni Faster R-CNN, RetinaNet, YOLOv5s, YOLOv8n va CenterNet kabi besh xil obyekt aniqlash arxitekturasiga joylashtirgan; samaradorlikni DIOR maʼlumotlar toʻplamida, inson bilan xulqiy moslikni bir vaqtdagi koʻz kuzatuvi maʼlumotlari bilan va miya–model vakillik mosligini EEG asosidagi representational similarity analysis orqali baholagan. Samolyot toifasida barcha arxitekturalar AP50 oshishini koʻrsatgan va eng katta mutlaq oʻsish YOLOv5 uchun +0,260 boʻlgan. GVA eʼtibor xaritasining inson fiksatsiyasi taqsimotlari bilan Pearson korrelyatsiyasi 0,740 ga yetgan; EEG–model RSA tahlilida eng sezilarli moslashuv oshishlari erta vizual kodlash bilan bogʻliq oksipital hududda va top-down eʼtibor nazorati bilan bogʻliq frontal hududda qayd etilgan. Biroq tadqiqot hali ekspert taqrizidan oʻtmagan preprint bo‘lib, miya bilan moslik faqat qoʻllangan EEG/RSA oʻlchov doirasi ichida talqin qilinishi kerak.
Zamonaviy masofadan zondlash modellarida attention mexanizmlari keng qoʻllanadi; biroq bu mexanizmlarning katta qismi inson vizual eʼtiborini taqlid qilish uchun emas, bevosita vazifa samaradorligini optimallashtirish uchun oʻrganiladi. Shu sababli model eʼtibor beradigan hududlar bilan professional inson kuzatuvchilari tasvirda qidiradigan hududlar bir-biridan farq qilishi mumkin.
Maqolaning boshlangʻich nuqtasi aynan shu farqdir. Tadqiqotchilar model eʼtiborini toʻgʻridan-toʻgʻri inson fiksatsiya xaritalariga moslashtirish oʻrniga, inson vizual qidiruvi asosida yotgan guided search mexanizmini hisoblash moduliga aylantirishni taklif qiladi. Shunday qilib, inson xulqining faqat natijasini nusxalash oʻrniga eʼtibor taqsimotini yuzaga keltiradigan ikki asosiy jarayon modellashtirilishga harakat qilinadi.
Birinchi jarayon stimulus-driven saliency, yaʼni tasvirning qirra, rang farqi va lokal noodatiylik kabi quyi darajali xususiyatlari eʼtiborni oʻz-oʻzidan jalb qilishidir. Ikkinchi jarayon target-directed guidance, yaʼni kuzatuvchining “samolyot qidiryapman” kabi vazifa maqsadi eʼtiborni nishonga oʻxshash hududlarga yoʻnaltirishidir. GVA bu ikki xaritani birlashtirib, ham vizual jihatdan ajralib turadigan, ham vazifa nuqtayi nazaridan mazmunli hududlarni ustun qiladi.
Insonga Oʻxshash Vizual Eʼtibor Masofadan Zondlashda Obyekt Aniqlash Uchun Nega Muhim?
Insonga oʻxshash vizual eʼtibor modelni tasvirda faqat statistik jihatdan kuchli xususiyatlarga emas, balki odamlar nishonni qidirishda ustuvor deb biladigan vizual va vazifaga aloqador hududlarga qaratishni maqsad qiladi. Masofadan zondlash tasvirlarida nishonlar kichik, siyrak va zich fon ichida boʻlishi mumkinligi sababli, bunday eʼtibor mexanizmi yolgʻon musbatlarni kamaytirishi, oʻtkazib yuborilgan nishonlarni kamaytirishi va model qarorlarini inson vizual qidiruv strategiyalari bilan osonroq taqqoslash imkonini berishi mumkin.
Masofadan zondlash tasvirlarida aeroport uchish-qoʻnish yoʻlaklari, quruqlik yuzalari, suv hududlari, binolar yoki boshqa zich teksturalar nishon boʻlmasa ham kuchli vizual xususiyatlar hosil qilishi mumkin. Anʼanaviy detector bunday hududlarda yuqori aktivatsiya hosil qilib, keraksiz bounding box-lar yaratishi mumkin.
Inson kuzatuvchisi esa tasvirdagi barcha yuqori kontrastli hududlarga bir xil munosabatda boʻlmaydi. U tasvirning oʻzidan keladigan vizual ajralib turishni qidirayotgan obyekt haqidagi oldingi bilim bilan birlashtiradi. Guided search theory inson vizual qidiruvini aynan shu ikki axborot oqimining birlashuvi sifatida konseptuallashtiradi.
Guided Search Theory GVA Modeliga Qanday Aylantiriladi?
GVA guided search theory dagi ikki asosiy eʼtibor manbasini alohida hisoblash yoʻllari sifatida amalga oshiradi: bottom-up yoʻl tasvirning qirra va rang noodatiyligi kabi vazifadan mustaqil vizual xususiyatlarini ajratadi, top-down yoʻl esa nishon sinfiga oid oʻrganilgan vizual oldingi bilimdan nishon ehtimollik xaritasini hosil qiladi. Ikki xarita piksel darajasida ko‘paytirilib, umumiy ustuvorlik xaritasi yaratiladi va faqat ham ajralib turadigan, ham vazifaga aloqador hududlar kuchli eʼtibor oladi.
Bottom-up: Stimulga bogʻliq ajralib turish yoʻli
Stimulus-driven saliency yoʻli nishon nima ekanini bilmasdan tasvirning oʻz vizual xususiyatlariga qarab eʼtibor xaritasini yaratadi. Manba bu qayta ishlash zanjirini toʻliq izohlanadigan klassik tasvirni qayta ishlash bosqichlari bilan quradi.
Avval tasvir mean-shift filtering bilan qayta ishlanadi va CIE-Lab rang fazosiga oʻtkaziladi. Soʻng uch masshtabli Gaussian pyramid qoʻllanadi:
- 1× asl aniqlik,
- 0,5× masshtab,
- 0,25× masshtab.
Har bir masshtabda 3×3 Sobel operatori bilan qirra xususiyatlari ajratiladi. Bundan tashqari, har bir pikselning atrofga nisbatan qanchalik noyob yoki noodatiy rangga ega ekanini oʻlchaydigan color-rarity xaritasi hisoblanadi.
Bottom-up attention map manbada quyidagicha taʼriflanadi:
\[ M_{bu}(x,y)= \mathcal{N} \left[ \sum_{s=1}^{3} w_s \left( E_s(x,y)+C_s(x,y) \right) \right] \]
Bu yerda \(E_s\), s masshtabdagi qirra xususiyatlar xaritasini; \(C_s\), rang noyobligi xaritasini; \(w_s\), masshtab ogʻirligini va \(\mathcal{N}\) min-max normallashtirishni ifodalaydi.
Top-down: Nishonga yoʻnaltirilgan boshqaruv yoʻli
Ikkinchi yoʻl vazifaga xos nishon maʼlumotini attention map ga olib kiradi. Tadqiqotda samolyot nishonlarining Lab rang imzolarini oʻrganish uchun 500 qoʻlda belgilangan samolyot namunasi ustida Random Forest klassifikatori oʻqitilgan.
Random Forest:
- 10 daraxt,
- maksimal chuqurlik 5
dan foydalanadi va har bir piksel uchun nishon ehtimolini ishlab chiqaradi. Bu xarita 5×5 Gaussian kernel va \(\sigma=2\) bilan silliqlanadi.
Top-down guidance map:
\[ M_{td}(x,y)= \mathcal{N} \left[ G_{\sigma=2} * RF(Lab(x,y)) \right] \]
koʻrinishida ifodalanadi.
Bu yerdagi Random Forest detectorning train/test boʻlimlaridan mustaqil yordamchi tasvir yamoqlari bilan oʻqitilib, maʼlumot sizib chiqishining oldi olinadigan tarzda tuzilgan.
Ikki eʼtibor yoʻli qanday birlashtiriladi?
Bottom-up va top-down attention xaritalari element-wise multiplication orqali birlashtiriladi. Shu tariqa faqat jismonan diqqatga sazovor, ammo nishonga aloqasiz hududlar hamda faqat nishonga oʻxshash, biroq vizual dalili zaif hududlarni bostirish maqsad qilinadi.
Birlashtirilgan xarita marker-controlled watershed algoritmi bilan nomzod hududlarga ajratiladi. Manbada nomzodlar quyidagi shartlar bilan filtrlashgani ko‘rsatilgan:
- maydon: 50–8000 piksel,
- tomonlar nisbati: 0,2–5.
Yaroqli hudud markazlariga \(\sigma=10\) piksel boʻlgan ikki oʻlchovli Gaussian yadrolari joylashtirilib, yakuniy insonga oʻxshash attention map hosil qilinadi:
\[ A_{GVA}(x,y)= \mathcal{N} \left[ \sum_{k=1}^{K} \mathcal{G} \left( (x,y);c_k,\sigma=10 \right) \right] \]
Bu yerda \(K\) yaroqli nomzod hududlar sonini, \(c_k\) esa ushbu hududlarning markazlarini bildiradi.
GVA Haqiqatan Parametrsiz Eʼtibor Modulimi?
GVAning detector tarmogʻiga joylashtirilishi yangi oʻrganiladigan chuqur tarmoq parametrlarini qoʻshmaydi va bottom-up saliency yoʻli deterministik tasvirni qayta ishlash amallaridan iborat; ammo top-down boshqaruv yoʻli 500 belgilangan namuna ustida oʻqitilgan Random Forestdan foydalanadi. Shu sababli manbadagi “parameter-free” iborasi GVAning butun hisoblash zanjirida hech qanday oʻrganilgan komponent yoʻq degan maʼnoda emas, balki detector arxitekturasiga yangi optimallashtiriladigan neyron tarmoq parametrlari qoʻshilmasligi maʼnosida ehtiyotkorlik bilan talqin qilinishi kerak.
Bu farq metodologik jihatdan muhim. Manba detectorning classification va regression tarmoqlari oʻzgartirilmaganini, GVA native loss funksiyalarini saqlashini va detector treningiga yangi learnable layer qoʻshmasligini qayd etadi.
Biroq nishonga yoʻnaltirilgan attention mapni yaratishda ishlatiladigan Random Forest oldindan oʻqitiladi. Demak, GVAning top-down komponenti nishon sinfiga oid oʻrganilgan maʼlumotni oʻzida saqlaydi.
GVA besh xil detectorga qanday joylashtiriladi?
| Arxitektura | Detector turi | GVA joylashtirish yondashuvi |
|---|---|---|
| Faster R-CNN | Ikki bosqichli | Watershed orqali olingan GVA candidate boxlari klassik zich anchorlar oʻrnida ishlatiladi; hududdagi oʻrtacha attention balli proposal confidence sifatida baholanadi. |
| RetinaNet | Bir bosqichli, anchor-based | GVA nomzodlari oldindan belgilangan multi-scale anchor gridlar oʻrnida ishlatiladi. |
| YOLOv5s | Bir bosqichli, anchor-based | GVA binary mask xususiyat xaritalari oʻlchamiga moslashtiriladi; gradient backpropagation va chiqish hududlari insonga oʻxshash attention maydonlari bilan cheklanadi. |
| YOLOv8n | Bir bosqichli | GVA maskasi feature-map masshtabiga moslashtirilib, feature allocation va prediction hududlarini modulyatsiya qiladi. |
| CenterNet | Anchor-free | Qayta masshtablangan GVA maskasi center-point heatmap prognozlarini modulyatsiya qiladi. |
Tadqiqotning muhim dizayn qarori GVAni detector backbone bilan Feature Pyramid Network (FPN) orasiga joylashtirib, asosiy detector arxitekturasini imkon qadar oʻzgartirmaslikdir.
Tadqiqot Usuli va Natijalari
EEGET-RSOD koʻz kuzatuvi va EEG maʼlumotlar toʻplami
Inson xulqi va miya vakilligi uchun benchmark sifatida EEGET-RSOD maʼlumotlar toʻplamidan foydalanilgan. Toʻplamda DIORdan olingan 1.000 ta 800×800 piksel optik masofadan zondlash tasviri mavjud.
Tadqiqotga 38 ishtirokchi kiritilgan va manba barcha ishtirokchilar yozma informed consent berganini bildiradi. Etik tasdiq Beijing Normal University Ethics Committee tomonidan 20221024111 raqami bilan berilgan.
| Oʻlchov | Uskuna / parametr |
|---|---|
| Koʻz kuzatuvi | SMI RED250, 250 Hz |
| EEG | NE Enobio, 32 kanal, 500 Hz, 10–20 joylashuvi |
| Sinxronizatsiya | <2 ms trigger xatosi |
| Stimulus davomiyligi | 3000 ms |
| Boʻsh ekran | 500 ms |
Fiksatsiyalar I-DT algoritmi bilan ajratilgan va guruh fixation heatmaplari \(\sigma=8\) Gaussian kernel yordamida yaratilgan.
EEG oldindan qayta ishlash
EEG signallariga:
- 0,5–45 Hz filtrlash,
- mastoid re-referencing,
- ICA bilan artefaktlarni tozalash,
- −200–0 ms baseline correction
qoʻllangan.
Toʻrt funksional hudud turli vaqt oynalari bilan aniqlangan:
| Miya hududi | Vaqt oynasi |
|---|---|
| Oksipital | 0–300 ms |
| Temporal | 100–400 ms |
| Frontal | 200–500 ms |
| Parietal | 300–600 ms |
Whole-brain Representational Similarity Matrices esa 0–600 ms oynasida yaratilgan.
Detector trening tartibi
Detector tajribalarining asosiy qismi DIOR samolyot quyi toʻplamida bajarilgan.
| Parametr | Qiymat |
|---|---|
| Train / validation / test | 7 : 2 : 1 |
| Framework | PyTorch |
| GPU | RTX 4090 |
| Batch size | 16 |
| Kirish aniqligi | 800×800 |
| Epoch | 300 |
| Backbone boshlanishi | ImageNet pre-trained |
| Checkpoint tanlovi | Eng yuqori AP50 |
GVA Obyekt Aniqlash Samaradorligini Qanchalik Oshirdi?
DIOR samolyot testida GVA qoʻshilishi besh detectorning barchasida AP50ni oshirgan; arxitekturalar orasidagi eng katta mutlaq oʻsish YOLOv5da 0,680dan 0,940ga ko‘tarilib, +0,260 bo‘lgan. Boshlangʻich samaradorligi pastroq modellar kattaroq yutuq olgan, boshlangʻich samaradorligi allaqachon yuqori boʻlgan RetinaNet va YOLOv8da esa oʻsishlar kichikroq bo‘lgan.
| Model | Baseline Precision | Baseline Recall | Baseline AP50 | GVA Precision | GVA Recall | GVA AP50 | AP50 farqi |
|---|---|---|---|---|---|---|---|
| Faster R-CNN | 0,915 | 0,442 | 0,600 | 0,786 | 0,739 | 0,760 | +0,160 |
| YOLOv5 | 0,717 | 0,647 | 0,680 | 0,979 | 0,907 | 0,940 | +0,260 |
| CenterNet | 0,841 | 0,775 | 0,810 | 0,901 | 0,852 | 0,880 | +0,070 |
| RetinaNet | 0,982 | 0,874 | 0,920 | 0,991 | 0,918 | 0,950 | +0,030 |
| YOLOv8 | 0,982 | 0,932 | 0,920 | 0,974 | 0,938 | 0,960 | +0,040 |
Faster R-CNNda baseline model juda yuqori precisionga qaramay atigi 0,442 recall ko‘rsatadi. GVAdan soʻng recall 0,739ga ko‘tarilgan, precision 0,786ga tushgan, biroq AP50 umumiy hisobda 0,600dan 0,760ga oshgan.
YOLOv5da precision ham, recall ham bir vaqtning oʻzida oshgan va bu model eng katta umumiy detector yutugʻiga erishgan.
Kuchli modellar nega kamroq yutuq oladi?
Manbaning izohiga ko‘ra, boshlangʻich samaradorligi past modellarda fonni bostirish va precision–recall muvozanatini yaxshilash uchun ko‘proq imkoniyat mavjud. RetinaNet va YOLOv8 kabi kuchli baselinelar allaqachon rivojlangan feature fusion va attention xulqiga ega bo‘lgani sababli GVA bu modellarda ko‘proq nozik sozlash taʼsirini ko‘rsatadi.
GVA Turli Masofadan Zondlash Nishonlariga Umumlashtirila Oldimi?
YOLOv5da oʻtkazilgan toʻrt sinfli tajribada GVA samolyot, kema, saqlash tanki va koʻprik toifalarining barchasida AP50 oshishini taʼminlagan; oʻrtacha AP50 0,666dan 0,855ga ko‘tarilgan. Biroq yutuq miqdori nishon geometriyasiga ko‘ra ancha farq qilgan, eng katta oʻsish saqlash tanklarida, eng kichik oʻsish esa koʻpriklarda kuzatilgan.
| Toifa | Baseline AP50 | GVA AP50 | Mutlaq farq |
|---|---|---|---|
| Samolyot | 0,680 | 0,942 | +0,262 |
| Kema | 0,914 | 0,958 | +0,044 |
| Saqlash tanki | 0,493 | 0,918 | +0,425 |
| Koʻprik | 0,576 | 0,603 | +0,027 |
| Oʻrtacha | 0,666 | 0,855 | +0,189 |
Manba ixcham va muntazam geometriyali nishonlarda qirra va color-rarity mexanizmi samaraliroq, uzun chiziqli tuzilmalar boʻlgan koʻpriklar esa mavjud saliency dizayni bilan kamroq mos kelishini ilgari suradi.
Samolyot uchun asosiy besh-model tajribasida AP50 0,940, toifalararo tajribada esa 0,942 deb berilgan. Bular turli tajriba jadvallarida keltirilgan qiymatlar bo‘lib, ularni sunʼiy ravishda bitta qiymatga tenglashtirmaslik kerak.
GVA Inson Koʻz Harakatlari Bilan Qanchalik Mos?
Inson fixation heatmaplari bilan solishtirishda GVA uchun CC=0,740, NSS=2,600 va KL=0,898 qayd etilgan; bu qiymatlar model attentioni inson qarash taqsimotiga baseline detectorlarga qaraganda yaqinroq ekanini ko‘rsatadi. Biroq ishlatilgan metriklar eʼtiborning turli xususiyatlarini oʻlchaydi va ularni yagona “insonga oʻxshashlik foizi” sifatida birlashtirmaslik kerak.
Eʼtibor moslashuvi metriklari
| Metrik | Nimani oʻlchaydi? | Yaxshiroq yoʻnalish |
|---|---|---|
| CC | Attention xaritalari orasidagi umumiy fazoviy korrelyatsiya | Yuqori |
| SSIM | Fazoviy/tuzilmaviy oʻxshashlik | Yuqori |
| NSS | Model saliencysining inson fiksatsiya nuqtalarida jamlanishi | Yuqori |
| KL divergence | Ikki eʼtibor ehtimollik taqsimoti orasidagi farq | Past |
GVA ablatsiyasi nimani ko‘rsatdi?
Manba toʻrt tizimni solishtiradi:
- Itti saliency baseline,
- faqat stimulus-driven saliency,
- faqat target-directed guidance,
- toʻliq Guided-Search Visual Attention.
| Usul | CC | SSIM | NSS | KL |
|---|---|---|---|---|
| Itti | 0,388 | 0,357 | 0,920 | 1,562 |
| Stimulus-driven | 0,505 | 0,613 | 2,598 | 2,090 |
| Target-directed | 0,511 | 0,565 | 2,017 | 1,826 |
| Full GVA | 0,740 | 0,581 | 2,600 | 0,898 |
Bu jadval ikki yoʻlli dizayn ayniqsa CC va KL nuqtayi nazaridan kuchli komplementarlik berishini koʻrsatadi. GVA eng yuqori CC va NSS hamda eng past KL qiymatini beradi.
Manba ichidagi nomuvofiqlik: shu bo‘lim matnida toʻliq GVA “barcha metriklarda” bir yoʻlli usullardan ustun deyilgan bo‘lsa-da, 4-rasmda stimulus-driven yoʻlning SSIM qiymati 0,613, toʻliq GVAniki esa 0,581. Demak, SSIM bo‘yicha 4-rasm bu jumlani qoʻllab-quvvatlamaydi.
Miya–Model Mosligi Qanday Oʻlchandi?
Miya–model mosligi detectorning FPN qatlamlaridagi P3, P4 va P5 xususiyatlaridan tuzilgan Representational Similarity Matrices bilan fixation-locked EEG signallaridan tuzilgan RSMlarning Spearman korrelyatsiyasi orqali oʻlchangan. Bu usul model “miya kabi oʻylaydi” deganini bevosita ko‘rsatmaydi; turli stimullar orasidagi vakillik munosabatlari inson EEGsidagi vakillik geometriyasiga qanchalik oʻxshashini tekshiradi.
Model RSMlarini yaratish
Target va background hududlari ROI-Align orqali P3, P4 va P5 feature maplaridan kesib olingan, pooled va normalize qilingan. Har bir stimulus jufti orasidagi cosine dissimilaritydan foydalanib model RSMlari tuzilgan.
EEG RSMlarini yaratish
EEG epochlari koʻz fiksatsiyasi belgilariga koʻra target va backgroundga ajratilgan. Toʻrt kortikal hududdagi ERP signallari model feature ketma-ketligiga mos feature vektorlariga aylantirilgan, Fisher-Z transform qoʻllangan va ishtirokchilar bo‘yicha oʻrtachalangan.
Model bilan EEG RSM orasidagi munosabat Spearman rank correlation bilan oʻlchangan; statistik ahamiyat 5.000 permutation testi va FDR correction bilan baholangan.
P3, P4 va P5 qatlamlari orasida nima bo‘ldi?
Baseline detectorlarda miya–model korrelyatsiyalari past va tartibsiz; Spearman's r taxminan 0,006–0,024 oraligʻida.
GVAdan keyin moslashuv barcha arxitekturalarda oshgan va umuman P3dan P5ga tomon kuchayuvchi qatlam gradienti paydo bo‘lgan.
Manbaning P3–P5 bo‘yicha hisobot bergan maksimal RSA oshishlari:
| Model | Maksimal RSA oshishi | Oʻrtacha RSA oshishi |
|---|---|---|
| Faster R-CNN | 133% | 108% |
| YOLOv5 | 50% | 73% |
| RetinaNet | 14% | 13% |
| CenterNet | 40% | 78% |
| YOLOv8 | 4% | 31% |
Bu foizli oshishlar past boshlangʻich korrelyatsiyalarga nisbatan nisbiy oʻsish ekanini unutmaslik kerak; mutlaq RSA qiymatlari kichikligicha qoladi.
GVA Qaysi Miya Hududlari Bilan Koʻproq Moslashdi?
Hududiy RSA tahlilida eng katta oʻrtacha oshish oksipital korteksda Δρ=0,012, ikkinchi katta oshish frontal korteksda Δρ=0,008 deb qayd etilgan. Parietal Δρ=0,001 va temporal Δρ=0,003 oshishlari kichikroq bo‘lib, manbada ko‘pincha statistik ahamiyatli emasligi bildiriladi.
Manba bu taqsimotni GVA arxitekturasining ikki yoʻli bilan bogʻlaydi:
- Oksipital oshish: qirra va rang kontrasti kabi erta vizual xususiyatlarning bottom-up saliency yoʻli orqali qayta ishlanishi,
- Frontal oshish: nishonga yoʻnaltirilgan top-down eʼtibor nazoratining task-guidance yoʻli orqali modellashtirilishi.
Bu talqin mexanistik gipotezadir. EEGning fazoviy aniqligi, manbaning oʻzi ham cheklov sifatida ko‘rsatganidek, nozik miqyosli kortikal mexanizm xulosalarini chiqarishga imkon bermaydi.
Qatlam iyerarxiyasi bilan inson vizual iyerarxiyasi bir xilmi?
Manba GVAdan keyin P3dan P5ga oshuvchi RSAni inson vizual tizimining iyerarxik qayta ishlash tartibi bilan mos namuna sifatida talqin qiladi. Biroq P3/P4/P5 detector xususiyatlari muayyan kortikal qayta ishlash bosqichlariga birma-bir anatomik ekvivalent ekani ko‘rsatilmagan.
Toʻgʻri ifoda shuki, model feature iyerarxiyasidagi vakillik mosligining chuqur qatlamlarga tomon oshishi qoʻllangan EEG/RSA doirasi ichida inson vizual qayta ishlash iyerarxiyasiga ko‘proq mos keladigan namuna hosil qiladi.
Statistik baholash
Koʻz kuzatuvi attention metriklari uchun one-way ANOVA, FDR-adjusted Tukey HSD va 1.000 bootstrap namunasi ishlatilgan.
Neural RSA uchun 5.000 permutation testi qoʻllanib, \(\alpha=0,05\) darajasida FDR correction bajarilgan.
Manba asosiy visual alignment taqqoslashlarida FDR-corrected \(p<0,001\) deb bildiradi.
Tadqiqot qoʻllab-quvvatlaydigan xulosalar
- GVA guided search theory dagi bottom-up va top-down eʼtibor mexanizmlarini birlashtiradigan ikki yoʻlli attention doirasidir.
- DIOR samolyot testida GVA sinovdan oʻtgan besh detectorning barchasida AP50ni oshirgan.
- Arxitekturalar orasidagi eng katta samolyot AP50 oshishi YOLOv5 uchun +0,260.
- YOLOv5ning toʻrt toifali umumlashtirish tajribasida oʻrtacha AP50 0,666dan 0,855ga koʻtarilgan.
- GVA attention map inson fixation taqsimoti bilan CC=0,740 qiymatiga yetgan.
- Full GVA 4-rasmda CC, NSS va KL bo‘yicha bir yoʻlli variantlardan ustun.
- EEG–model RSA qiymatlari GVAdan soʻng sinovdan oʻtgan arxitekturalarda oshgan.
- Eng sezilarli hududiy RSA oshishlari oksipital va frontal hududlarda qayd etilgan.
- GVAni detectorga joylashtirish native classification/regression branchlarini va loss funksiyalarini oʻzgartirmaydi.
Tadqiqot qoʻllab-quvvatlamaydigan xulosalar
- GVA ishlatadigan detectorlar inson miyasi bilan bir xil hisoblashni bajarishi ko‘rsatilmagan.
- CC=0,740 qiymatini umumiy maʼnoda “model %74 inson miyasiga oʻxshaydi” deb talqin qilib boʻlmaydi.
- EEG RSA korrelyatsiyasi klinik yoki biologik ekvivalentlik isboti emas.
- Kognitiv alignment maʼlumotlari samolyotdan boshqa nishon toifalarida hali tasdiqlanmagan.
- GVAning SAR yoki hyperspectral tasvirlarda bir xil samaradorlik berishi ko‘rsatilmagan.
- GVAning barcha masofadan zondlash detectorlarida bir xil AP50 oshishini berishi isbotlanmagan.
- “Parameter-free” iborasi top-down Random Forest umuman oʻqitilmagan degani emas.
- 4-rasm full GVAning SSIMda stimulus-driven yoʻldan ustunligini ko‘rsatmaydi.
- Preprint natijalari taqrizdan oʻtgan yakuniy dalil sifatida baholanmasligi kerak.
Tadqiqot cheklovlari
Manba uchta asosiy cheklovni ochiq ko‘rsatadi.
- Kognitiv maʼlumot cheklovi: koʻz kuzatuvi va EEG alignment baholashi faqat samolyot nishonlari uchun mavjud. Boshqa toifalarda detector samaradorligi sinovdan oʻtgan boʻlsa-da, mos inson cognitive benchmark hali yoʻq.
- Modal cheklov: tadqiqot faqat optik remote sensing tasvirlarida bajarilgan; SAR va hyperspectral tasvirlar sinovdan oʻtkazilmagan.
- EEG fazoviy aniqligi: EEG neural mechanism tahlilini makroskopik funksional miya hududlari bilan cheklaydi.
Kelajak tadqiqot yoʻnalishlari
Mualliflar bottom-up saliency mexanizmini turli sensor modalliklariga moslashtirish mumkinligini taklif qiladi. SAR uchun polarimetric signatures, hyperspectral tasvirlar uchun spectral band xususiyatlari rang maʼlumoti oʻrnida ishlatilishi mumkin boʻlgan nomzod vakilliklardir.
Belgilangan namunalar kam boʻlgan katta hududli kuzatuv ilovalarida top-down priorni unsupervised yoki self-supervised usullar bilan oʻrganish ham kelajakdagi tadqiqot yoʻnalishi sifatida koʻrsatiladi.
Tadqiqot, shuningdek, GVA joylashtirilishi detectorga yangi trainable neural-network parametrlarini qoʻshmagani sababli lightweight va edge-processing arxitekturalari uchun salohiyatga ega ekanini ilgari suradi; ammo real edge qurilmada batafsil latency yoki energiya isteʼmoli tajribasi qayd etilmagan.
Manba va Usul Haqida Izoh
Asl sarlavha: Embedding human-like visual attention for brain-aligned and high-performance remote sensing object detection
Mualliflar: Bing He, Tong Qin, Dajun Xing, Ying Qu, Qiaosong Hei, Chunfeng Gao, Zheng Gong, Qiao Wang, Weihua Dong
Manba turi: Preprint tadqiqot maqolasi.
SSRN roʻyxat raqami: 7346288.
SSRNga yuklangan sana: 24 avgust 2026.
Taqriz holati: Manba ochiq ravishda “This preprint research paper has not been peer reviewed” iborasini o‘z ichiga oladi.
Asosiy usul: Guided-Search Visual Attention (GVA).
Nazariy asos: Guided search theory; stimulus-driven saliency va target-directed guidance yoʻllarining priority map yaratish uchun birlashtirilishi.
Detectorlar: Faster R-CNN, RetinaNet, YOLOv5s, YOLOv8n va CenterNet.
Asosiy obyekt aniqlash maʼlumotlar toʻplami: DIOR.
Kognitiv benchmark: EEGET-RSOD; 1.000 ta 800×800 remote sensing tasviri va 38 ishtirokchining bir vaqtdagi koʻz kuzatuvi–EEG maʼlumotlari.
Etik tasdiq: Beijing Normal University Ethics Committee, No. 20221024111.
Eye tracker: SMI RED250, 250 Hz.
EEG: NE Enobio, 32 kanal, 500 Hz, 10–20 joylashuvi.
Visual alignment metriklari: Pearson correlation coefficient (CC), structural similarity index (SSIM), normalized scanpath saliency (NSS), Kullback–Leibler divergence (KL).
Neural alignment usuli: Representational Similarity Analysis (RSA), model P3/P4/P5 FPN xususiyatlari va fixation-locked EEG RSMlari.
Data availability: EEGET-RSOD maʼlumotlar toʻplami Figshare platformasida 10.6084/m9.figshare.26943565 DOI bilan manbada ko‘rsatilgan.
Code availability: Manba tahlil kodi GitHubda “Bing-1997/Human-like_visual_attention_embedding_framework” repositoriyasida mavjudligini bildiradi.
Manba ichidagi muhim nozik jihat: GVA detectorga yangi oʻrganiladigan neural-network parametrlarini qoʻshmaydi; biroq target-directed yoʻl 500 belgilangan namuna ustida oʻqitilgan Random Forestdan foydalanadi.
Manba ichidagi muhim nomuvofiqlik: 4-rasmda full GVA SSIM=0,581, stimulus-driven saliency SSIM=0,613; shuning uchun shu bo‘limdagi “full GVA all metrics'te üstündür” jumlasi SSIM bo‘yicha rasm bilan mos kelmaydi.
Asosiy talqin chegarasi: “Brain-aligned” natijasi EEG/RSA va eye-tracking metriklarida oʻlchangan vakillik/eʼtibor oʻxshashligini anglatadi; bu bevosita biologik mexanizm ekvivalentligi yoki miyaning hisoblash jarayonini nusxalash degani emas.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan