

Makine öğrenmesi modelleri benchmark testlerinde yüksek başarı gösterebilir. Ancak bir modeli hastane, sigorta şirketi veya regülasyon baskısı altındaki kurumsal sistemlerde çalıştırmak bambaşka bir problemdir. Çünkü gerçek dünyada veri dağınıktır, kullanıcılar temkinlidir, kararların hukuki ve operasyonel sonuçları vardır.
Bu çalışma, iki üretim deneyimi üzerinden bu farkı inceliyor. Birinci sistem, büyük bir kurumsal müşteri için geliştirilen uyum hassasiyetli NLP tabanlı belge erişim sistemidir. İkinci deneyim ise sağlık ve sigorta alanında 15 kurumsal müşteriye yayılan tahmin modelleridir. Bu sistemler teknik olarak başarısız olmamıştır; fakat açıklanabilirlik, kurumlar arası veri farkları ve kullanıcı güveni açısından beklenmeyen duvarlara çarpmıştır.
Çalışmanın ana mesajı nettir: Yapay zekâ üretim ortamında yalnızca doğru tahmin yapmak zorunda değildir. Aynı zamanda kararını açıklayabilmeli, farklı kurumların veri üretme biçimlerine uyum sağlayabilmeli ve kullanıcıların hangi durumda modele güvenebileceğini anlayabileceği bir karar ortamı sunmalıdır.
Problem Ne?
Yapay zekâ literatüründe üretime alma sorunu çoğu zaman veri dağılımı değişimi, altyapı eksikliği, küçük eğitim seti veya model performans düşüşü gibi teknik başlıklarla anlatılır. Bunlar önemlidir; fakat bu çalışma daha farklı bir soruna dikkat çekiyor: Model doğru çalışsa bile, insanlar onu kullanmak için yeterli gerekçeye sahip olmayabilir.
Sağlık ve sigorta sistemlerinde bir modelin çıktısı yalnızca teknik skor değildir. Bir hasta bekleme süresi tahmini, kaynak planlamasını etkileyebilir. Bir sigorta hasar tahmini, rezerv hesaplamasında kullanılabilir. Bir belge erişim sistemi, uyum denetiminde regülatöre karşı savunulması gereken sonuçlar üretebilir. Bu nedenle “model yüzde kaç doğru?” sorusu tek başına yetersiz kalır.
Uyum denetimi bağlamında sorun daha da keskindir. Bir belge erişim sistemi belirli bir dokümanı 0,87 güven skoru ile ilgili bulduğunda, bu skor uyum görevlisi için yeterli açıklama değildir. Uyum görevlisinin ihtiyacı şudur: Bu belge hangi hüküm, hangi kavram veya hangi düzenleyici gerekçe nedeniyle getirildi? Aynı sorgu küçük bir değişiklikle sorulduğunda aynı mantıkla aynı sonuç açıklanabilecek mi?
Çalışmanın merkezindeki problem bu nedenle “model başarısız mı?” değildir. Daha zor soru şudur: Model doğru sonuç ürettiğinde bile, bu sonucu denetlenebilir, kurumsal bağlama uyarlanabilir ve insan karar süreçlerine güvenilir biçimde yerleştirilebilir hale getirebiliyor muyuz?
Yöntem Ne Öneriyor?
Çalışma yeni bir algoritma önermekten çok, üretim deneyimlerinden çıkan üç temel problem alanını sistematik biçimde belgeliyor. Birinci problem, açıklanabilirlik boşluğudur. Model bir sonuç verebilir; fakat bu sonucun uyum, denetim veya regülasyon bağlamında savunulabilir açıklamasını üretemeyebilir.
İkinci problem, kurumsal domain shift olarak adlandırılabilecek durumdur. Domain shift, modelin eğitim aldığı veri dağılımı ile üretimde karşılaştığı veri dağılımı arasındaki farktır. Ancak çalışmanın vurguladığı fark yalnızca istatistiksel değildir. Sağlık ve sigorta kurumları veriyi farklı biçimde üretir, kodlar, işler ve yorumlar. Örneğin ICD-10 tanı kodlarının kullanım sıklığı sadece hasta popülasyonunu değil, kurumun dokümantasyon kültürünü de yansıtabilir.
Üçüncü problem, güven kalibrasyonudur. Bir model doğru tahminler üretebilir; fakat pratisyenler, klinisyenler, aktüerler veya operasyon ekipleri hangi durumda bu tahmine güvenmeleri gerektiğini bilmiyorsa model kullanılmaz. Güven, doğruluktan otomatik olarak doğmaz. Kullanıcı, modelin hangi sınırlar içinde çalıştığını ve kendi uzman kararıyla nasıl birlikte kullanılacağını anlayabilmelidir.
Çalışmanın ampirik bölümü, açıklanabilirlik sorununu ölçmek için BGE-M3 tabanlı bir NLP modeli üzerinde üç post-hoc açıklama yöntemini karşılaştırır: Attention, LIME ve SHAP. Post-hoc açıklama, model eğitildikten sonra modelin kararını açıklamaya çalışan yöntemleri ifade eder. Deney, MultiNLI veri kümesinin government ve slate türlerinden 50 örnek kullanılarak yürütülür.
Açıklamalar iki ölçüte göre değerlendirilir: stability ve faithfulness. Stability, küçük girdi değişikliklerinde açıklamanın ne kadar tutarlı kaldığını ölçer. Faithfulness ise açıklamada önemli denilen tokenların modelin kararını gerçekten taşıyıp taşımadığını ölçer. Çalışma bu iki ölçütü birleştirerek audit-ready, yani denetime hazır açıklama oranını hesaplar.
Formüller Ne Anlatıyor?
Çalışmada açıklama kalitesini ölçmek için iki ana kavram kullanılır: stability ve faithfulness. Bunlar okuyucuya sade biçimde şöyle anlatılabilir.
Stability, aynı ya da çok az değiştirilmiş girdilerde açıklama skorlarının benzer kalıp kalmadığını ölçer. Çalışmada bu benzerlik, token önem sıralamaları arasındaki Spearman korelasyonu ile değerlendirilir.
Burada \(E_i\) ve \(E_j\), aynı örneğin küçük değişikliklere uğratılmış farklı sürümleri için üretilen token önem skorlarını; \(\rho_{\text{Spearman}}\) ise sıralama benzerliğini temsil eder. Açıklama küçük değişikliklerde tamamen değişiyorsa, denetim bağlamında güvenilir kabul edilmesi zorlaşır.
Faithfulness, açıklamanın gerçekten model kararını taşıyan bilgiyi yakalayıp yakalamadığını ölçer. Çalışmada sufficiency yaklaşımı kullanılır: Yalnızca en önemli görülen ilk 5 token bırakıldığında modelin özgün karar güveni ne kadar korunuyor?
Burada \(P_{\text{original}}(\hat{y})\), modelin tam metinle verdiği tahmin güvenini; \(P_{\text{top-5 tokens}}(\hat{y})\), yalnızca açıklama yönteminin seçtiği en önemli tokenlar bırakıldığında modelin aynı tahmine verdiği güveni gösterir. Oran yüksekse, açıklama yönteminin seçtiği parçalar modelin kararında gerçekten etkili olabilir.
Çalışmanın audit-ready ölçütü iki eşiğin birlikte sağlanmasına dayanır:
Yani bir açıklamanın denetime hazır sayılması için hem küçük değişikliklere karşı yeterince kararlı olması hem de model kararını taşıyan bilgiyi yeterince iyi yakalaması gerekir.
Çalışmanın ana üretim dersi de sade biçimde şöyle özetlenebilir:
Bu son iki ifade, çalışmada birebir denklem olarak yer almaz; makalenin ana fikrini Verianla okuyucusu için sadeleştiren editoryal gösterimlerdir.
Grafik, Tablo ve Şema Ana Mesajı
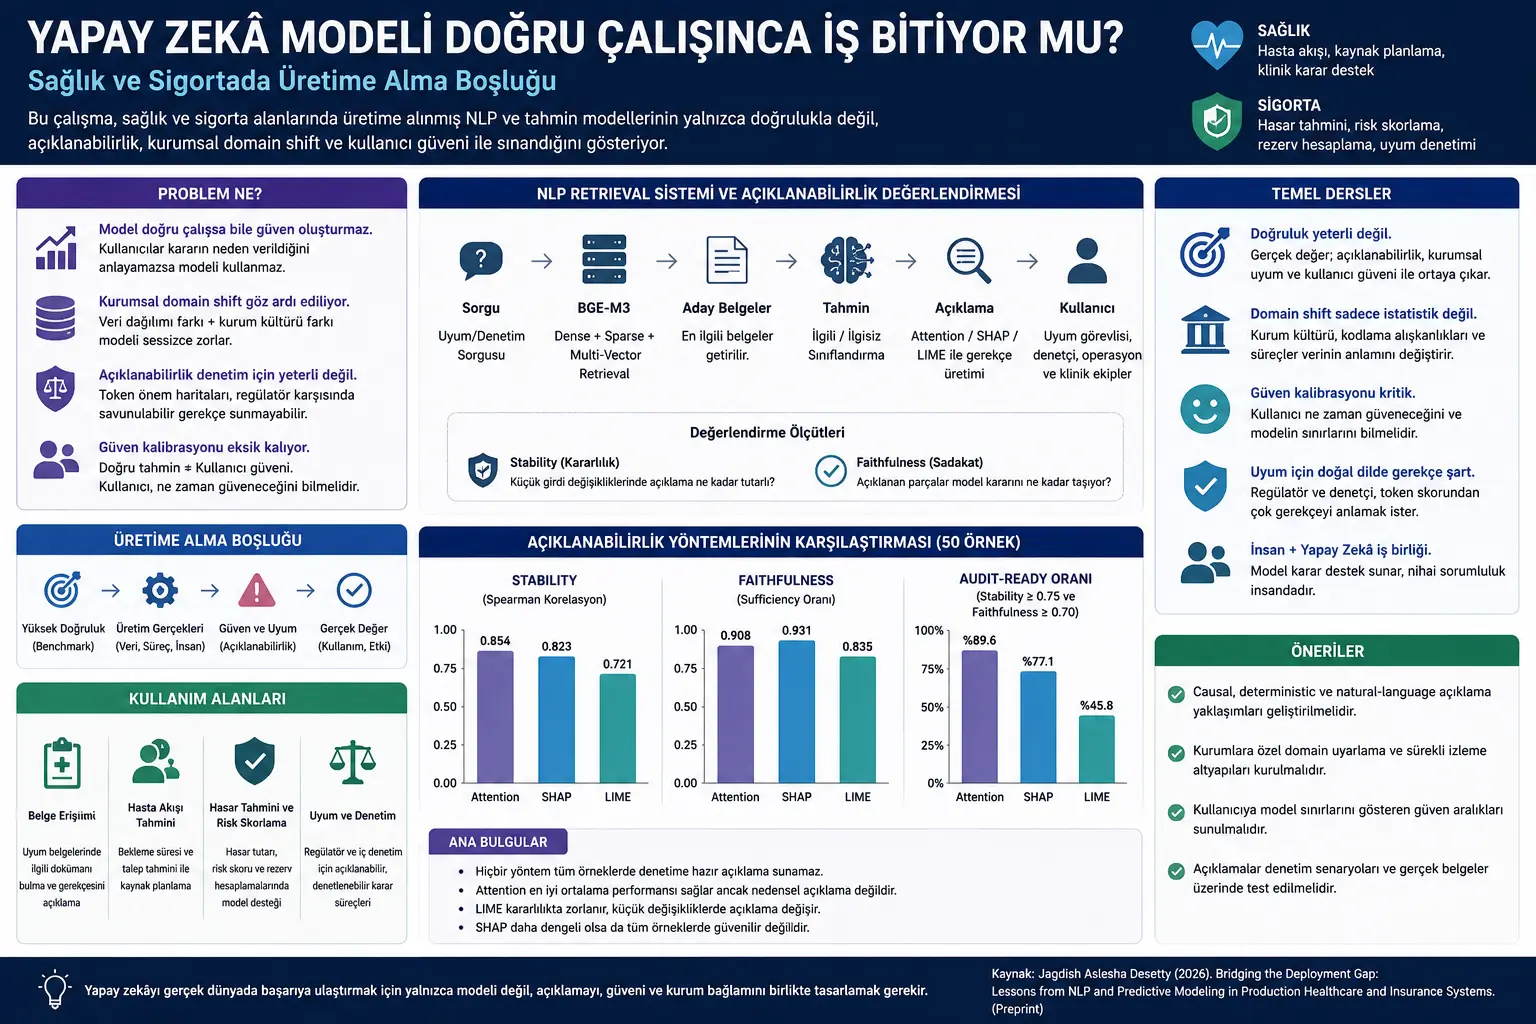
Tablo ve şeklin ana mesajı, mevcut açıklama yöntemlerinin üretim uyum gereksinimini tam olarak karşılamadığıdır. Attention yöntemi en yüksek audit-ready oranına ulaşır: yüzde 89,6. Bu ilk bakışta güçlü görünür; fakat uyum denetimi açısından hâlâ yaklaşık her 10 örnekten 1’inde açıklamanın beklenen eşiği karşılamadığı anlamına gelir.
LIME yöntemi özellikle stability tarafında zorlanır. Ortalama stability değeri 0,721 olarak raporlanır ve 0,75 eşiğinin altında kalır. Bu, küçük ifade değişikliklerinde token önem sıralamasının anlamlı biçimde değişebildiğini gösterir. Denetim bağlamında aynı kararın farklı zamanlarda farklı açıklanması ciddi bir güvenilirlik sorunudur.
SHAP daha dengeli görünür. Faithfulness değeri yüksektir ve stability ortalaması LIME’dan daha iyidir. Ancak çalışmanın vurguladığı nokta, ortalamanın yetmediğidir. Bazı örneklerde açıklama denetim eşiğinin altına düşüyorsa, üretim ortamında bu durum hâlâ risk yaratır.
Şekilde üç ayrı bakış birlikte verilir: açıklama kararlılığı, açıklamanın model kararını taşıma gücü ve iki kriteri aynı anda sağlayan örnek oranı. Bu üçlü değerlendirme önemlidir; çünkü yalnızca “açıklama güzel görünüyor mu?” sorusu yerine “aynı kalıyor mu, kararı gerçekten taşıyor mu ve denetimde savunulabilir mi?” soruları birlikte sorulur.
Çalışmanın görsel sonuçları, teknik açıklanabilirlik ile denetime hazır açıklanabilirlik arasında fark olduğunu gösterir. Bir yöntem token önem haritası verebilir; ancak bu harita uyum görevlisinin regülatör karşısında kullanabileceği doğal, tutarlı ve nedensel gerekçeye dönüşmüyorsa gerçek üretim ihtiyacını karşılamaz.
Deneyler Nasıl Yapılmış?
Deneylerde BGE-M3 adlı modern bir retrieval embedding modeli kullanılır. BGE-M3; dense retrieval, sparse retrieval ve multi-vector retrieval özelliklerini destekleyen, uzun belge işleme kapasitesi nedeniyle kurumsal belge erişim sistemlerine uygun bir model olarak ele alınır.
Çalışma, gerçek uyum belgeleri yerine kamuya açık MultiNLI veri kümesinin government ve slate türlerini proxy olarak kullanır. Bu türler, resmi veya yapılandırılmış metinlere daha yakın görüldüğü için uyum belgesi erişimi deneyine benzetilir. Premise kısmı belge, hypothesis kısmı uyum sorgusu gibi ele alınır. Entailment ilişkisi ilgili belge, contradiction veya neutral ilişkisi ilgisiz belge olarak düşünülür.
Toplam 50 örnek üzerinde üç açıklama yöntemi test edilir. Attention için son transformer katmanındaki dikkat ağırlıkları kullanılır. LIME, yerel doğrusal açıklama üretmek için 75 perturbation örneğiyle çalıştırılır. SHAP ise partition tabanlı Shapley değer tahminiyle token önemlerini üretir.
Stability deneyinde aynı girdiyi tekrar tekrar çalıştırmak yerine küçük perturbationlar yapılır. Bazı kelimeler silinir, kontrollü eş anlamlı kelime değişimleri yapılır veya noktalama küçük biçimde değiştirilir. Böylece açıklamanın küçük metin değişiklikleri karşısında ne kadar kararlı kaldığı ölçülür.
Faithfulness deneyinde açıklama yönteminin en önemli gördüğü ilk 5 token tutulur ve modelin özgün tahmin güveninin ne kadar korunduğu ölçülür. Eğer model yalnızca bu tokenlarla aynı karara benzer güvenle ulaşabiliyorsa, açıklama daha faithful kabul edilir.
Sonuçlar, Attention’ın yüzde 89,6, SHAP’in yüzde 77,1, LIME’ın ise yüzde 45,8 audit-ready oranına ulaştığını gösterir. Ancak çalışmanın yorumu açıktır: En iyi yöntemin bile tüm örneklerde güvenilir uyum açıklaması sağlayamaması, üretim sistemleri için ciddi bir araştırma açığına işaret eder.
Sonuçlar Ne Gösteriyor?
İlk sonuç, açıklanabilirlik sorununun yalnızca teknik bir görselleştirme sorunu olmadığıdır. Uyum bağlamında bir açıklama, teknik ekibin anlayacağı token önem skorundan ibaret olamaz. Denetçi veya uyum görevlisi, kararın düzenleyici gerekçesini doğal dilde ve savunulabilir biçimde ifade edebilmelidir.
İkinci sonuç, Attention’ın ölçülen kriterlerde en iyi sonucu vermesine rağmen tek başına yeterli olmadığıdır. Attention haritası, modelin hangi parçalara odaklandığını gösterebilir; fakat bu, modelin neden o kararı verdiğini nedensel olarak açıklamak anlamına gelmez.
Üçüncü sonuç, LIME’ın uyum bağlamında ciddi stability sorunu taşıdığıdır. Küçük metin değişiklikleri açıklamayı belirgin biçimde değiştirebiliyorsa, aynı kararın farklı sorgularda farklı gerekçelerle açıklanması riski doğar. Bu durum hukuki veya uyum denetimi olan alanlarda kabul edilemez olabilir.
Dördüncü sonuç, SHAP’in daha güçlü ama hâlâ yeterince güvenilir olmadığıdır. Ortalama performansın iyi görünmesi, her örnekte denetim eşiğinin karşılandığı anlamına gelmez. Üretim uyumu, ortalama başarıdan çok hatasızlığa ve tutarlılığa yakın beklenti üretir.
Beşinci sonuç, domain shift sorununun kurum kültürüyle ilişkili olabileceğidir. Sağlık ve sigorta kurumlarında aynı veri alanı farklı anlamlar taşıyabilir. Kodlama alışkanlıkları, hasar değerlendirme politikaları, dokümantasyon kültürü ve operasyonel süreçler verinin yapısını değiştirir. Bu farkı yalnızca istatistiksel yeniden ağırlıklandırmayla gidermek zor olabilir.
Altıncı sonuç, doğruluğun güveni otomatik olarak üretmediğidir. Kullanıcılar modelin ne zaman güvenilir olduğunu, hangi sınırları olduğunu ve kendi uzman kararlarıyla nasıl birlikte kullanılacağını anlamadığında, doğru tahminler bile kullanılmayabilir.
Bu Neden Önemli?
Bu çalışma, yapay zekânın gerçek dünyaya geçişinde genellikle gözden kaçan bir noktayı görünür kılıyor: Modelin çalışması, sistemin işe yaradığı anlamına gelmez. Özellikle sağlık ve sigorta gibi yüksek etkili alanlarda model çıktısının açıklanabilir, denetlenebilir, kurum bağlamına uyarlanabilir ve kullanıcı tarafından anlamlandırılabilir olması gerekir.
Sağlıkta yanlış veya açıklanamayan bir öneri hasta akışını, kaynak kullanımını veya klinik kararı etkileyebilir. Sigortada açıklanamayan bir risk skoru, müşteri ilişkisini, hasar yönetimini veya uyum denetimini zorlaştırabilir. Uyum sistemlerinde ise bir belgeyi neden getirdiğini açıklayamayan retrieval modeli, teknik olarak doğru olsa bile regülatör karşısında savunulamaz hale gelebilir.
Çalışma aynı zamanda “açıklanabilir yapay zekâ” tartışmasının pratik tarafını güçlendirir. Açıklama yöntemi yalnızca araştırma makalesinde iyi görünen bir grafik üretmemelidir. Gerçek kullanıcıya, gerçek karar anında, gerçek kurum dilinde anlamlı gerekçe sunmalıdır.
Bu nedenle gelecekteki araştırmaların yalnızca daha yüksek benchmark skoru hedeflemesi yeterli değildir. Causal, deterministic ve natural-language explanation olarak özetlenebilecek üçlü ihtiyaç öne çıkar: açıklama nedensel temele sahip olmalı, aynı girdiye benzer koşullarda tutarlı davranmalı ve teknik olmayan paydaşların kullanabileceği doğal dilde sunulmalıdır.
Dikkat Noktaları
İlk dikkat noktası, çalışmanın preprint olmasıdır. Bulgular hakem değerlendirmesi sonrası değişebilir. Bu nedenle sonuçlar kesinleşmiş akademik standart gibi değil, üretim deneyimine dayalı güçlü bir araştırma çağrısı olarak okunmalıdır.
İkinci dikkat noktası, deney örnekleminin sınırlı olmasıdır. Açıklanabilirlik deneyi 50 örnek üzerinde ve MultiNLI veri kümesinin belirli türleriyle yapılmıştır. Bu veri, gerçek uyum belgelerinin yerine proxy olarak kullanılmıştır. Gerçek sağlık veya sigorta uyum belgeleriyle daha geniş değerlendirme yapılması gerekir.
Üçüncü dikkat noktası, deneyin downstream task accuracy yerine açıklama kalitesine odaklanmasıdır. Kullanılan sınıflandırma başlığı fine-tune edilmemiştir; amaç modelin asıl görev başarısını değil, açıklama yöntemlerinin stability ve faithfulness özelliklerini test etmektir. Bu tasarım, XAI değerlendirme açısından anlamlı olsa da sonuçlar doğrudan tüm üretim performansına genellenmemelidir.
Dördüncü dikkat noktası, Attention sonucunun yanlış yorumlanmamasıdır. Attention’ın yüksek audit-ready oranı, attention ağırlıklarının gerçek nedensel açıklama olduğu anlamına gelmez. Çalışma bunu özellikle vurgular: Dikkat haritası modelin odaklandığı parçaları gösterebilir, fakat karar gerekçesini tam olarak açıklamayabilir.
Beşinci dikkat noktası, sağlık ve sigorta uygulamalarında insan denetiminin zorunluluğudur. Bu tür sistemler karar destek aracı olarak düşünülmeli; klinik, hukuki, finansal veya sigortacılık kararlarında tek başına otomatik otorite haline getirilmemelidir.
Sonuç
Bu çalışma, yapay zekâ sistemlerinin üretime alınmasında kritik bir ayrımı netleştiriyor: Modelin doğru çalışması yeterli değildir. Sağlık ve sigorta gibi yüksek etkili alanlarda model aynı zamanda açıklanabilir, denetlenebilir, kurum bağlamına uyumlu ve kullanıcı güvenini doğru biçimde kalibre edebilir olmalıdır.
Deneysel sonuçlar, Attention, SHAP ve LIME gibi yaygın post-hoc açıklama yöntemlerinin önemli sınırlara sahip olduğunu gösteriyor. Attention en yüksek audit-ready oranına ulaşsa da nedensel açıklama sunmaz. SHAP daha dengeli görünse de tüm örneklerde güvenilir değildir. LIME ise özellikle stability açısından uyum denetimi için zayıf kalır.
Çalışmanın üretim deneyimlerinden çıkan daha geniş ders de önemlidir. Kurumsal domain shift yalnızca veri dağılımı farkı değildir; kurumların veriyi üretme, kodlama ve yorumlama biçiminden doğan yapısal bir farktır. Kullanıcı güveni de yalnızca doğruluktan doğmaz; kullanıcı modelin sınırlarını ve karar sürecindeki yerini anlayabilmelidir.
Verianla açısından çalışmanın ana mesajı şudur: Yapay zekâyı gerçek dünyaya taşımak, yalnızca modeli deploy etmek değildir. Gerçek üretim başarısı; açıklanabilirlik, kurumsal bağlam, kullanıcı güveni ve denetlenebilir karar süreçlerinin birlikte tasarlanmasını gerektirir.
Kaynak ve Yöntem Notu
Bu içerik, Jagdish Aslesha Desetty tarafından hazırlanan “Bridging the Deployment Gap: Lessons from NLP and Predictive Modeling in Production Healthcare and Insurance Systems” başlıklı preprint çalışmaya dayalı olarak hazırlanmıştır. Çalışma; sağlık ve sigorta üretim sistemlerinde NLP tabanlı belge erişimi, tahmin modelleri, açıklanabilirlik yöntemleri, kurumsal domain shift, kullanıcı güveni ve audit-readiness problemlerini ele almaktadır.
Bu içerik birebir çeviri değildir; çalışmanın ana fikri Verianla yayın çizgisine uygun biçimde sadeleştirilmiş ve özgün Türkçe editoryal makaleye dönüştürülmüştür.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir