


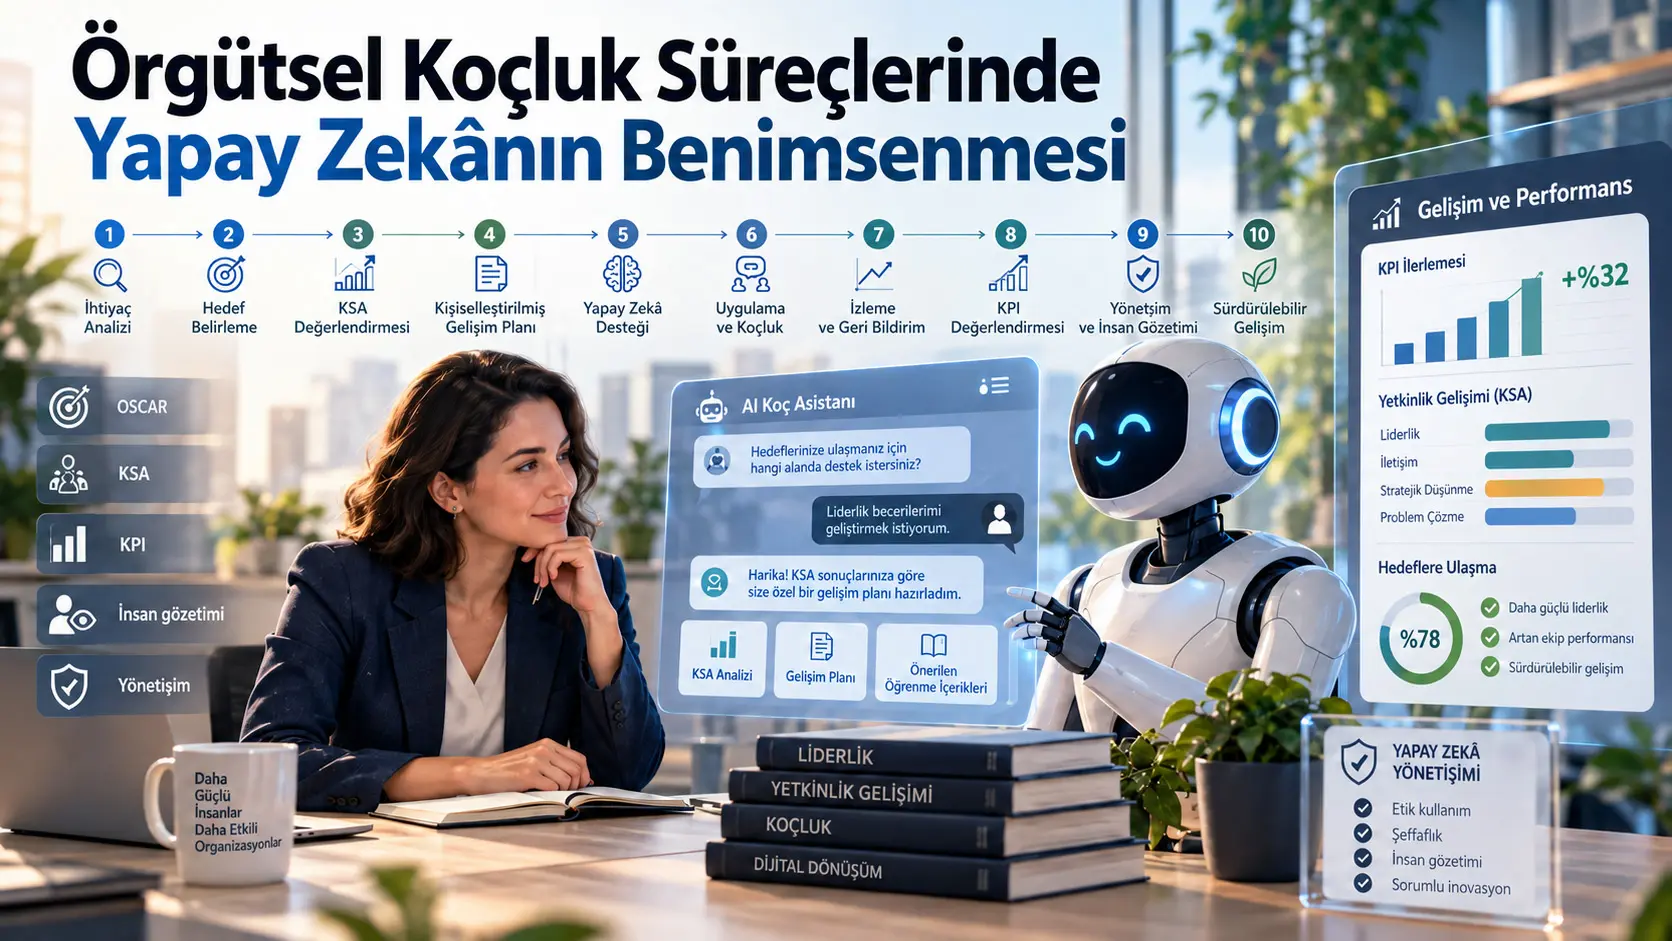
Bu çalışma, yapay zekânın örgütsel koçluk içinde nasıl kullanılabileceğini test edilmiş bir “insan koçunun yerine geçme” modeli olarak değil, karar yetkileri ve denetim mekanizmaları açıkça tanımlanmış bir süreç mimarisi olarak ele almaktadır. Önerilen yapay zekâ destekli örgütsel koçluk çerçevesi, OSCAR koçluk modelini ana süreç omurgası olarak kullanan; KSA ile yetkinlik hedeflerini somutlaştıran, Situational Leadership ile rehberlik düzeyini çalışanın hazır oluşuna göre uyarlayan ve KPI yapısıyla ilerlemeyi izlenebilir hale getiren 10 aşamalı bir tasarım çerçevesidir. Araştırma; yapılandırılmış literatür taraması, kuramsal çerçeve geliştirme, üç farklı genel amaçlı büyük dil modeli hizmetiyle iki kurgusal senaryo üzerinde prototipleme, n8n tabanlı iş akışı kanıt-kavramı ve altı uzmandan oluşan çevrim içi odak grup değerlendirmesini bir araya getirmektedir.
Çalışmanın temel sonucu, çerçevenin prototip düzeyinde uygulanabilir, izlenebilir ve örgütsel yönetişime bağlanabilir bir tasarım artefaktı olduğudur. Aynı yapı farklı yapay zekâ hizmetlerinde SMART hedefi, gelişim düzeyi, seçenekler, eylem planı, KSA haritası, KPI seti ve gözden geçirme planı gibi beklenen çıktıları üretebilmiştir. Ancak araştırma gerçek çalışanlarla uzun dönemli saha uygulaması yapmamış, kontrol grubu kullanmamış, insan koçluğuyla karşılaştırmalı etkililik testi gerçekleştirmemiş ve oluşturulan KPI'ların gerçek performans gelişimini öngördüğünü göstermemiştir. Bu nedenle bulgular etkililik kanıtı değil; süreç bütünlüğü, prototip uygulanabilirliği ve yönetişim açısından örgütsel uygulanabilirlik olasılığını destekleyen erken aşama kanıt olarak yorumlanmalıdır.
Araştırmanın çözmeye çalıştığı problem
Yapay zekâ destekli koçluk literatürü; erişilebilirlik, kişiselleştirme, sürekli takip, yapılandırılmış soru sorma ve veri destekli yansıtma gibi olası avantajlar tanımlamaktadır. Buna karşılık mahremiyet, önyargı, şeffaflık, empati kaybı, aşırı otomasyon ve hatalı önerilere aşırı güven gibi riskler de öne çıkmaktadır. Çalışmanın belirlediği asıl boşluk, bu avantaj ve risklerin örgütsel kullanım için tek bir işlem akışında yeterince bütünleştirilmemiş olmasıdır. Literatürde yapay zekâ koçluğunun yetenekleri, benimsenme koşulları ve etik ilkeleri ayrı ayrı tartışılmış olsa da; koçluk aşamalarının nasıl sıralanacağı, yetkinlik hedeflerinin nasıl tanımlanacağı, ilerlemenin hangi ölçülebilir çıktılarla izleneceği ve insan gözetiminin hangi karar noktalarında devreye gireceği konusunda uygulamaya dönük bütünleşik bir mimari eksik kalmaktadır.
Araştırma sorusu bu nedenle “Yapay zekâ koçluğu işe yarıyor mu?” biçiminde kurulmamıştır. Çalışmanın odaklandığı soru, iş stratejisiyle uyumlu yetkinlik gelişimini desteklerken yönetişimi ve insan gözetimini koruyan bir yapay zekâ destekli örgütsel koçluk sürecinin nasıl tasarlanıp işletilebileceğidir.
Yapay zekâ destekli örgütsel koçluk bu çalışmada nasıl yapılandırılıyor?
Çalışmada yapay zekâ destekli örgütsel koçluk, yapay zekânın hedef belirleme, durumu yapılandırma, seçenek üretme, eylem planlama, yetkinlik hedefleri oluşturma ve izleme artefaktları hazırlama görevlerinde yardımcı olduğu; buna karşılık nihai karar ve onay yetkisinin çalışan, yönetici veya örgütsel onaylayıcıda kaldığı, OSCAR merkezli katmanlı bir süreç mimarisidir.
Çerçevenin kuramsal merkezinde OSCAR bulunur. OSCAR; Outcome, Situation, Choices, Actions ve Review aşamalarını içeren çözüm odaklı bir koçluk omurgasıdır. Çalışma OSCAR'ı diğer bileşenlerle eşit düzeyde bir “teori paketi” olarak kullanmaz. Bunun yerine her bileşene sınırlı ve ayrı bir işlev verir:
- OSCAR: Koçluk diyaloğunun süreç omurgasını ve ilerleme sırasını sağlar.
- KSA (Knowledge, Skills, Abilities): Geniş gelişim hedeflerini bilgi, beceri ve yetenek düzeyinde daha açık yetkinlik hedeflerine dönüştürür.
- Situational Leadership: Çalışanın yetkinlik ve bağlılık/hazır oluş profiline göre rehberliğin ne kadar yönlendirici veya özerklik verici olacağını ayarlar.
- KPI: Gelişim planını hedef, veri kaynağı, ölçüm sıklığı, sorumlu ve gözden geçirme ritmi gibi izlenebilir alanlara bağlar.
Bu ayrım önemlidir: çerçevenin yeniliği çok sayıda modeli aynı anda kullanmak değil, her bir modeli farklı bir tasarım ihtiyacına bağlayarak süreç, yetkinlik, uyarlama ve ölçüm katmanlarını birbirine eklemlemektir.
On aşamalı koçluk döngüsü
| Aşama | Temel amaç | Başlıca çıktı | İnsan karar rolü |
|---|---|---|---|
| 1. Şirket Kurulumu | Strateji, misyon, ilkeler, sınırlar ve izin verilen koçluk alanlarını bağlama yerleştirmek | Asgari örgüt profili ve güvenlik sınırları | Örgüt/onaylayıcı kapsamı belirler |
| 2. Rol ve İş Bağlamı | Çalışanın rolünü, sorumluluklarını ve güncel iş bağlamını açıklığa kavuşturmak | Rol profili | Çalışan bilgiyi doğrular |
| 3. Outcome | SMART mantığıyla gelişim hedefini ve başarı ölçütünü tanımlamak | SMART hedefi ve ilk başarı ölçütleri | Gerçek gelişim hedefini çalışan seçer; gerektiğinde örgütsel onay gerekir |
| 4. Situation | Mevcut durumu, engelleri, kaynakları ve etkileyen koşulları görünür kılmak | Durum özeti ve engel/kaynak haritası | Çalışan durum tanısını doğrular |
| 5. Level | Yetkinlik ve bağlılık göstergelerinden D1-D4 gelişim profili önermek | Gelişim düzeyi ve rehberlik stili | Sınıflandırma geçicidir; insan doğrulaması gerekir |
| 6. Choices | Seçenekleri, artı/eksi yönleri ve uygulanabilirliği yapılandırmak | Seçenek seti ve karar gerekçesi | Seçimi çalışan yapar; kaynak/politika etkisinde yönetici devreye girebilir |
| 7. Actions | Seçilen yolu tarihli, kaynaklı ve sorumlulukları tanımlı bir plana çevirmek | Eylem kontrol listesi | Çalışan taahhüt eder; zaman, kaynak ve sahiplik insan tarafından doğrulanır |
| 8. KSA Üretimi | Hedefe uygun bilgi, beceri ve yetenek ihtiyaçlarını eşlemek | KSA planı | Yapay zekâ önerir, insan kabul eder veya düzeltir |
| 9. KPI Üretimi | İlerlemeyi izlemek için öncü/gecikmeli göstergeler ve gözden geçirme sıklığı tasarlamak | Hedef, kaynak, sıklık ve sorumlu içeren KPI sayfası | Ne ölçüleceğine ve hangi yönetişim kurallarıyla izleneceğine insanlar karar verir |
| 10. Review | İlerlemeyi değerlendirmek, sapmayı saptamak, öğrenmeyi kaydetmek ve gerekirse önceki aşamalara dönmek | Gözden geçirme günlüğü, güncellenmiş plan ve yeniden giriş kararı | Devam, revizyon veya insan gözetimine yükseltme kararı insanda kalır |
Döngü neden doğrusal değil?
Çerçeve tasarım ve yazılım uygulanabilirliği açısından sıralı aşamalarla gösterilir; fakat koçluk tek yönlü bir form doldurma süreci olarak düşünülmez. Review aşamasında hedefin artık uygun olmadığı, durumun değiştiği, seçilen seçeneğin işlemediği, eylem planının gerçekçi olmadığı veya KPI'ların anlamını yitirdiği görülürse süreç ilgili önceki aşamaya geri dönebilir. Bu yeniden giriş mantığı, çerçevenin yalnız “10 kutudan geçen” bir otomasyon değil, geri bildirimle kendini düzelten bir koçluk döngüsü olmasını amaçlar.
İnsan karar yetkisi çerçevede nasıl korunuyor?
Çerçevede yapay zekâ; bilgiyi isteme, girdileri yapılandırma, seçenek üretme, sınıflandırma önerme ve SMART hedefi, KSA haritası, KPI seti veya eylem planı gibi taslak artefaktlar hazırlama yetkisine sahiptir; ancak kapsamı onaylama, gerçek gelişim hedefini seçme, seçenekleri kabul etme, kaynak ve zaman taahhüdü verme, KPI yönetişimini onaylama ve yüksek riskli durumlarda nihai karar alma yetkisi insanlarda bırakılmıştır.
Bu yaklaşımın nedeni yalnız etik değildir. Örgütsel koçluk; bütçe, rol sınırları, çalışan mahremiyeti, performans değerlendirmesi ve yönetici sorumluluğu gibi yapay zekânın tek başına belirleyemeyeceği kurumsal sonuçlar doğurabilir. Bu nedenle çalışma, yapay zekâyı özerk karar verici değil, sınırlı bir kolaylaştırıcı ve taslak üretici olarak konumlandırır.
Yönetişim ve risk denetimleri
| Risk alanı | Neden önemli? | Önerilen kontrol |
|---|---|---|
| Hallüsinasyon / temelsiz öneri | Yanlış gelişim önerileri hedefleri, öz-değerlendirmeyi veya eylem planını bozabilir. | Tüm yapay zekâ çıktıları taslak kabul edilir; insan doğrulaması ve gözden geçirme zorunludur. |
| Mahremiyet ve gizlilik | Koçluk konuşmaları kişisel, kişiler arası veya kurumsal olarak hassas bilgi içerebilir. | Veri minimizasyonu, rol sınırları, açıklama ve denetlenebilir kayıtlar; gerekli olmayan hassas verinin istenmemesi. |
| Önyargı | Yetkinlik veya gelişim düzeyi sınıflandırmaları haksız varsayımlar üretebilir. | Sınıflandırmalar geçici kabul edilir; insan incelemesi, düzeltme ve gerekirse yükseltme uygulanır. |
| Aşırı bağımlılık | Kullanıcı veya kurum yapay zekâ tavsiyesini sorgulamadan kabul edebilir. | Yapay zekânın rolü kolaylaştırıcıyla sınırlandırılır; hedef, plan, KSA, KPI ve Review kararlarını insanlar kabul eder. |
| Yükseltme eşiği hatası | Bazı konular AI koçluğunun uygun sınırlarını aşar. | Kapsam dışı, hassas, etik açıdan belirsiz veya uygulanabilirliği kuşkulu durumlarda yönetici, onaylayıcı veya insan koça aktarım. |
Çalışma ayrıca başlangıçta yapay zekâ ile etkileşimde bulunulduğunun açıklanmasını, yalnız görev için gereken verinin işlenmesini, kapsam dışına çıkışın saptanmasını, temel çıktılarda insan override yetkisinin korunmasını, karar ve Review kayıtlarının denetlenebilir olmasını ve önyargı/zarar incelemesinin yönetişim sürecine eklenmesini önerir. Bunlar çalışmada tam kurumsal uyumluluk denetiminden geçirilmiş kontroller değil; çerçevenin tasarımına gömülmüş yönetişim mekanizmalarıdır.
Bu çalışma yapay zekâ koçluğunun insan koçluğundan daha etkili olduğunu gösteriyor mu?
Hayır. Çalışmada insan koçluğu ile yapay zekâ destekli koçluk arasında kontrollü karşılaştırma yapılmamış, kontrol grubu kullanılmamış ve gerçek çalışanlarda uzun dönemli davranış değişikliği, yetkinlik gelişimi, KPI başarımı veya örgütsel performans ölçülmemiştir; dolayısıyla sonuçlar karşılaştırmalı etkililik veya üstünlük kanıtı olarak yorumlanamaz.
Bu ayrım makalenin en kritik yorum sınırıdır. Araştırma, çerçevenin uygulanabilir bir tasarım olup olmadığını ve beklenen artefaktları üretip üretemediğini incelemektedir. “Çerçeve çalıştırılabiliyor” sonucu ile “çerçeve çalışanları daha iyi geliştiriyor” sonucu aynı şey değildir. İkinci iddia için gerçek örgütlerde, karşılaştırma gruplarıyla ve zaman içinde sonuç izleyen yeni çalışmalar gerekmektedir.
Çalışmanın Yöntemi ve Bulguları
Araştırma tasarımı
Araştırma çok aşamalı, karma yöntemli ve tasarım odaklı bir yaklaşım benimsemektedir. Bununla birlikte “karma yöntem” ifadesi geniş örneklemli nicel etki doğrulaması anlamına gelmemektedir. Çalışmanın empirik doğrulama bölümü keşifsel ve küçüktür.
| Aşama | Uygulama | Ne sağladı? | Ne sağlamadı? |
|---|---|---|---|
| 1. Yapılandırılmış literatür taraması | Scopus birincil olmak üzere EBSCOhost, Elicit ve tamamlayıcı olarak Google Scholar | AI koçluğu, benimsenme, tasarım, yönetişim ve sonuç literatürü için tasarım bilgi tabanı | Tam raporlanmış PRISMA uyumlu sistematik derleme protokolü |
| 2. Kuramsal çerçeve tasarımı | OSCAR + KSA + Situational Leadership + SMART + KPI | 10 aşamalı, katmanlı koçluk mimarisi | Bileşenlerin ayrı ayrı nedensel katkısının deneysel izolasyonu |
| 3. LLM prototipleme | ChatGPT, Gemini ve DeepSeek hizmetleri; aynı iskelet prompt ve aynı kurgusal şirket bağlamı | Farklı hizmetlerde süreç ve artefakt üretiminin uygulanabilirliği | Model üstünlüğü benchmark'ı veya koçluk etkililiği testi |
| 4. n8n kanıt-kavramı | Trigger → Tools Agent → LLaMA3-70B-8192 → Memory | Durum taşıma, izlenebilirlik ve otomatik iş akışı mantığı | Kurumsal ölçeklenebilirlik, hata toleransı, güvenlik sertleştirmesi veya üretim hazır olma kanıtı |
| 5. Çevrim içi odak grup | Altı uzman, Microsoft Teams, 120 dakika, NVivo 15 ile tümevarımsal kodlama | Netlik, akış, yönetişim, yararlılık algısı ve iyileştirme önerileri | Son kullanıcı saha kullanılabilirliği veya gerçek performans etkisi |
| 6. V1 → V2 iyileştirmesi | Odak grup geri bildirimleriyle karar kapıları, asgari artefakt alanları ve yükseltme kuralları güçlendirildi | Daha yönetişim odaklı ikinci sürüm | Yeni sürümün uzun dönemli saha etkililiği |
Literatür taramasının kapsamı
Birinci aşamada AI destekli koçlukla ilgili benimsenme faktörleri, bildirilen yararlar ve riskler, kullanılan sistemler, tasarım ilkeleri, yönetişim gereksinimleri ve mevcut sonuç kanıtları taranmıştır. Kaynak yazarları bu aşamayı sistematik biçimde yürütülen yapılandırılmış bir tarama olarak tanımlar; ancak açık arama dizileri, eleme sayıları ve resmî akış diyagramıyla eksiksiz raporlanmış PRISMA uyumlu bir sistematik derleme olarak sunmaz. Bu nedenle tarama, çerçeve tasarımını besleyen yapılandırılmış bir bilgi tabanı olarak değerlendirilmelidir.
Prototipleme: iki kurgusal kullanım senaryosu
Prototipleme gerçek çalışanlarla yapılmamıştır. “CreativeTech” adlı kurgusal bir şirket bağlamında iki senaryo kullanılmıştır. Birinci senaryoda Noah adlı kıdemli UX yöneticisinin kullanılabilirlik titizliği ile sprint kısıtlarını dengelemesi; ikinci senaryoda Emily adlı React geliştiricisinin zaman baskısı altında Angular'a geçişi ele alınmıştır. Her model/hizmet ve her kullanım durumu için aynı örgütsel bağlam, rol örüntüsü, aşama sırası ve REVIEW/DONE komutları kullanılmış; araçlara özel prompt yeniden yazımı yapılmamıştır.
Karşılaştırmanın amacı hangi yapay zekâ modelinin “daha iyi” olduğunu bulmak değildir. Bir çalıştırmanın başarılı sayılması için SMART hedefi, gerekçeli D düzeyi, en az üç seçenek ve seçim gerekçesi, tarihli eylem planı, hedef ve eylemlerle uyumlu KSA çıktısı, hedef/kaynak/sıklık içeren KPI seti ve Review planı gibi asgari artefaktların üretilmesi beklenmiştir. Değerlendirme; artefakt tamlığı, iç tutarlılık ve süreç kurallarına uyum gibi görünür özelliklere dayanmıştır.
Her model-kullanım durumu çifti için tek tam çalıştırma yapılmış; tekrarlı denemeler, kör uzman puanlaması veya modeller arası varyans analizi uygulanmamıştır. Bu nedenle araçlar arasında görülen farklılıklar örnek prototip çıktılarıdır; kararlı model performansı veya güvenilir bir sıralama olarak yorumlanamaz.
n8n otomasyonu neyi gösterdi?
Çalışma, çerçevenin yalnız bağımsız sohbetlerde değil, durum bilgisi taşıyan bir iş akışında da uygulanabileceğini göstermek için n8n üzerinde bir kanıt-kavramı kurmuştur. Akışta sohbet girdisi bir Trigger düğümünden Tools Agent'a, oradan LLaMA3-70B-8192 modeline ve konuşma bağlamını korumak için Memory düğümüne aktarılmıştır. Bu düzen, aşama farkındalığı, izlenebilir artefakt üretimi ve oturum bağlamının sürdürülmesi açısından prototip uygulanabilirliğini göstermiştir.
Ancak bu otomasyon; eşzamanlı çok kullanıcılı yük, kuyruk yönetimi, model sağlayıcı kesintileri, otomatik retry/fallback, bozuk oturum durumu, gelişmiş hata yönetimi, kimlik doğrulama, rol tabanlı yetkilendirme, secrets management, gözlemlenebilirlik, olay yönetimi, altyapı sertleştirmesi veya maliyet/performans ölçeklemesi açısından test edilmemiştir. Dolayısıyla “iş akışı çalışıyor” sonucu “kurumsal üretime hazır” anlamına gelmez.
Odak grup nasıl yapıldı?
Ön nitel doğrulama için koçluk uygulaması, psikoloji, öğrenen organizasyonlar/e-öğrenme, insan kaynakları, bilgi sistemleri/yükseköğretim ve yapay zekâ araştırması alanlarını temsil eden altı uzman amaçlı örnekleme ile seçilmiştir. Kaynak, grubun toplam 129 yıllık mesleki deneyime sahip olduğunu; ortalamanın 21,5 yıl ve aralığın 12-32 yıl olduğunu bildirmektedir. Oturum 22 Temmuz 2025 tarihinde Microsoft Teams üzerinden gerçekleştirilmiş, 120 dakika sürmüş, ses kaydı alınmış ve analiz için metne dönüştürülmüştür.
Nitel analiz NVivo 15 ile yürütülmüştür. İlk turda tekrar eden yargılar, kaygılar, geliştirme önerileri ve yönetişim gözlemleri açık kodlamayla işaretlenmiş; ikinci turda ilgili kodlar faz netliği, akış, yetkinlik gelişimi, yönetişim, empati ve gelecek tasarım önerileri gibi daha üst kategorilerde birleştirilmiştir. NVivo'nun yapay zekâ destekli özetleme özelliği, insan kodlamasından sonra yardımcı yoğunlaştırma aracı olarak kullanılmış; kodlamanın veya yorumlamanın yerine geçirilmemiştir. Çalışma küçük nitel veri seti nedeniyle resmî istatistiksel kodlayıcılar arası güvenilirlik katsayısı bildirmemektedir.
Prototiplemeden çıkan bulgular
Prototipleme üç dar fakat önemli sonuç alanı desteklemiştir. Birincisi operasyonel tamlıktır: iki kurgusal rolde beklenen hedef, gelişim düzeyi, seçenekler, plan, KSA, KPI ve Review artefaktları üretilebilmiştir. İkincisi prosedürel tutarlılıktır: farklı yapay zekâ hizmetlerinde çerçevenin faz mantığı genel olarak tanınabilir kalmıştır. Üçüncüsü örgütsel uygulanabilirlik olasılığıdır: üretilen artefaktlar ölçülebilir alanlar, gözden geçirme ritmi ve denetlenebilir kayıtlar gibi yönetişim açısından kullanılabilecek yapılara dönüştürülebilmiştir.
Bununla birlikte testlerde bazı pratik sorunlar gözlenmiştir. Yapay zekâların zaman zaman birden fazla soruyu aynı anda sorma eğilimi, koçluk akışını mekanikleştirebilmiştir. Bazı aşamalarda derinlik sınırlı kalmış ve zamanlanmış Review gibi davranışların prototipte tam temsil edilmesi zorlaşmıştır. Bu gözlemler, kuramsal çerçevenin daha döngüsel ve adaptif mantığı ile test için kullanılan daha basit doğrusal prompt arasında ayrım yapılması gerektiğini göstermiştir.
Odak grubun temel geri bildirimleri
Uzmanlar araştırma konusunu güncel ve önemli görmüş; çerçevenin özellikle eylem planlarını yapılandırma ve oturumları özetleme gibi sınırları belirli görevlerde yararlı olabileceğini değerlendirmiştir. Ancak katılımcıların önerileri, çerçevenin yalnız konuşma kalitesine değil, örgütsel karar ve denetim mimarisine dayanması gerektiğini güçlendirmiştir.
| Alan | Uzman geri bildiriminin yönü | Çerçeveye etkisi |
|---|---|---|
| Yetkinlik/konu onayı | Geliştirilecek becerinin şirketin onaylı alanlarından gelmesi veya çalışan öneriyorsa gerekçelendirilip onaylanması | Koçluk başlangıcına go/no-go karar kapısı |
| Kapsam sınırları | AI'ın hangi konuda koçluk yapabileceği açıkça tanımlanmalı ve kapsam kayması işaretlenmeli | Guardrail ve yükseltme kuralları |
| Zaman çizelgesi gerçekçiliği | SMART hedefinin süresi, mevcut teknik yetkinlik görülmeden sabitlenmemeli | Hedef zamanından önce yetkinlik/teknik bilgi kontrolü |
| KPI ve Review ritmi | Ölçüm sıklığı ve kontrol kapıları tanımlanmalı; sapmada önceki aşamalara dönüş olmalı | Review aşaması ana geri besleme noktası haline geliyor |
| Yönetici müdahalesi | Bütçe, çaba, etik belirsizlik veya kapsam aşımında kimin devreye gireceği açık olmalı | Yetki ve yükseltme matrisi |
| Empati ve ton | AI kimi durumda yararlı, kimi durumda kişiliksiz veya aşırı coşkulu algılandı | Ton/stil ayarı; koçlukta çalışanın merkezde kalması |
| Gizlilik | Şirket konu ve kapsamı doğrulayabilir; bire bir koçluk içeriğinin gizliliği ayrı korunmalı | Yönetişim ile özel koçluk içeriği arasında sınır |
Çalışmanın ana bulgusu nasıl yorumlanmalıdır?
Çalışmanın ana bulgusu, önerilen çerçevenin farklı yapay zekâ hizmetlerinde ve otomasyon kanıt-kavramında beklenen koçluk artefaktlarını üretebilen, uzmanlar tarafından kavramsal olarak anlaşılır ve yönetişim açısından makul bulunan bir tasarım olduğudur; bu bulgu gerçek çalışan performansının arttığını, insan koçluğuna üstünlük sağlandığını veya oluşturulan KPI'ların geçerli performans ölçütleri olduğunu göstermez.
Çalışmanın desteklediği sonuçlar
- OSCAR merkezli katmanlı mimari, prototip koşullarında farklı LLM hizmetlerinde uygulanabilir biçimde işletilebilmiştir.
- Çerçeve, hedef belirleme ile izleme arasında SMART hedefi, gelişim düzeyi, seçenek seti, eylem planı, KSA haritası, KPI sayfası ve Review kaydı gibi denetlenebilir ara ürünler üretmeye uygundur.
- n8n kanıt-kavramı, sürecin durum taşıyan ve izlenebilir bir iş akışına dönüştürülebileceğini göstermiştir.
- Uzman odak grup, netlik, yönetişim ve örgütsel uygulanabilirlik açısından çerçevede değer görmüş; aynı zamanda daha güçlü karar kapıları, kapsam sınırları ve insan gözetimi önermiştir.
- AI'ın süreç boyunca rolü değişkendir: bazı aşamalarda bilgi toplar ve yapılandırır, bazı aşamalarda analiz ve taslak üretimine daha aktif katılır.
Çalışmanın desteklemediği sonuçlar
- AI destekli koçluğun insan koçluğundan daha etkili olduğu gösterilmemiştir.
- Davranış değişikliği, performans iyileşmesi, öğrenme transferi veya uzun dönemli yetkinlik ilerlemesi ölçülmemiştir.
- KPI'ların gerçek performansı öngördüğü veya sıradan yönetim/koçluk planlamasından daha geçerli olduğu gösterilmemiştir.
- ChatGPT, Gemini veya DeepSeek arasında deneysel olarak güvenilir bir performans sıralaması yapılmamıştır.
- n8n/LLaMA3 prototipi kurumsal üretim yükü, güvenlik ve dayanıklılık açısından doğrulanmamıştır.
- Odak grup bulguları altı uzmanla sınırlıdır; çalışanlar veya örgütler geneline istatistiksel olarak genellenemez.
- OSCAR, KSA, Situational Leadership ve KPI katmanlarının marjinal katkıları ayrı deneysel ablasyonla ölçülmemiştir.
Örgütler için önerilen aşamalı uygulama yolu
Çalışmanın yönetimsel çıkarımı, doğrudan geniş ölçekli dağıtım yerine kontrollü pilot yaklaşımıdır. Önerilen yol; dar bir pilot kapsamı belirlemek, karar yetkileri ve guardrail'leri kurmak, KPI ve Review kayıtlarıyla izlenen koçluk döngüleri yürütmek, mahremiyet/insan doğrulaması/yükseltme gibi asgari etik önlemleri uygulamak ve yalnız pilot kanıtları yeterliyse kapsamı büyütmektir.
| Aşama | Yönetim amacı | Asgari çıktı/kontrol |
|---|---|---|
| 1. Pilot tanımı | Dar ve yönetilebilir kullanım alanı seçmek | Onaylı pilot kapsamı, beceri/konu ve ilk SMART hedef şablonu |
| 2. Yönetişim kurulumu | Karar haklarını ve örgütsel sınırları tanımlamak | Kapsam beyanı, onay kuralı, yükseltme ölçütü, rol/sorumluluk haritası |
| 3. İzlenen yürütme | Koçluk döngülerini denetlenebilir takip ile çalıştırmak | Eylem planı, KSA haritası, hedef/kaynak/sıklık/sorumlu içeren KPI sayfası, Review günlüğü |
| 4. Etik korumalar | Gizlilik, adillik ve sorumlu kullanım için asgari kontrolleri uygulamak | AI açıklaması, veri minimizasyonu, insan doğrulama kapısı ve yükseltme yolu |
| 5. Kontrollü ölçekleme | Yalnız pilot kanıtı yeterliyse kapsamı genişletmek | Ölçekleme kararı, revize yönetişim kuralları ve güncellenmiş izleme ritmi |
Sınırlılıklar ve gelecekte gerekli doğrulamalar
Çalışmanın prototipleri iki kurgusal senaryoya dayanmakta ve gerçek örgütsel kullanıcılarla tekrarlı koçluk döngülerini ölçmemektedir. Kullanılan LLM hizmetlerinin ücretsiz sürümleri bağlam uzunluğu ve durum yönetimi gibi pratik sınırlamalar taşımış; model çıktıları kör değerlendiricilerle standart puanlama rubriğine göre derecelendirilmemiş; model başına tekrarlı denemelerle varyans ölçülmemiştir. Odak grup küçük ve uzman odaklıdır. Literatür taraması tam PRISMA raporlama standardına ulaşmamıştır. Otomasyon ise kanıt-kavramı düzeyinde kalmıştır.
Yazarların önerdiği bir sonraki doğrulama düzeyi; çerçeve kullanan katılımcılar ile yönlendirilmemiş AI kullanımı, olağan iş geliştirme pratiği, yalnız insan koçluğu veya hibrit insan-AI koçluğu gibi karşılaştırma koşullarını içeren kontrollü çalışmalar olmalıdır. Bu araştırmalar yalnız artefakt tamlığını değil; uzman puanlı eyleme geçirilebilirliği, güven ve yararlılık algısını, KPI'ların gerçek gelişimle ilişkisini, davranış değişikliğini ve tekrarlı Review döngülerindeki yetkinlik ilerlemesini de ölçmelidir. Teknik tarafta eşzamanlı oturum yükü, hata dayanıklılığı, fallback mantığı, kimlik doğrulama, erişim kontrolü, gözlemlenebilirlik, audit pipeline'ları, prompt sürüm yönetimi ve maliyet/performans analizi test edilmelidir.
Kaynak ve Yöntem Notu
Özgün başlık: Adoption of Artificial Intelligence in Organizational Coaching Processes
Yazarlar: Yanis Faquir; Arnaldo Santos; Henrique S. Mamede.
Kurumlar: Yanis Faquir — Department of Communication and Arts, Universidade de Aveiro, Aveiro, Portugal. Arnaldo Santos ve Henrique S. Mamede — INESC TEC—Instituto de Engenharia de Sistemas e Computadores, Tecnologia e Ciência, Porto, Portugal; ayrıca Sciences and Technology Department, Universidade Aberta, Lisboa, Portugal.
Sorumlu yazar: Henrique S. Mamede.
Dergi / yayın: AI, 2026, cilt 7, sayı 5, makale 175. Yayınevi: MDPI.
DOI: 10.3390/ai7050175
Yayın süreci: Alındı: 2 Mart 2026; revize edildi: 12 Mayıs 2026; kabul edildi: 12 Mayıs 2026; yayımlandı: 19 Mayıs 2026.
Kaynak türü ve hak durumu: Dergi makalesi; MDPI version of record. Makale açık erişimlidir ve Creative Commons Attribution (CC BY) lisansı altında yayımlanmıştır.
Finansman: Çalışma FCT—Fundação para a Ciência e a Tecnologia, I.P. ulusal fonları tarafından UID/50014/2025 desteği kapsamında finanse edilmiştir.
Etik / onam: Kaynak, çalışmanın Helsinki Bildirgesi ve GDPR çerçevesinde yürütüldüğünü; profesyonel katılımcıların gönüllü olduğunu ve bilgilendirilmiş onam verdiğini bildirmektedir.
Veri erişilebilirliği: Makalenin sonuçlarını destekleyen ham verilerin yazarlardan talep üzerine sağlanacağı belirtilmiştir.
Çıkar çatışması: Yazarlar çıkar çatışması bildirmemiştir.
Yazar katkıları: Kavramsallaştırma Y.F., A.S. ve H.S.M.; metodoloji A.S. ve H.S.M.; yazılım, biçimsel analiz, araştırma, kaynaklar ve veri kürasyonu Y.F.; doğrulama Y.F., A.S. ve H.S.M.; görselleştirme Y.F. ve A.S.; danışmanlık/proje yönetimi A.S. ve H.S.M.; finansman edinimi H.S.M. olarak raporlanmıştır.
Kaynak içi önemli tutarsızlıklar: PDF'nin yöntem ve prototipleme bölümlerinde kullanılan model sürüm etiketleri birbiriyle tam uyuşmamaktadır: erken yöntem açıklaması ChatGPT 4.5, Gemini 3 ve DeepSeek-V3.2 adlarını verirken daha sonraki prototipleme bölümü ChatGPT 5.2, Gemini 2.5 ve DeepSeek V4 etiketlerini kullanmaktadır. Ayrıca prototipleme tablosunda kesin model sürümünün daha sonra eklenmesini isteyen bir yer tutucu metin bulunmaktadır. Bu nedenle Verianla anlatımı bilimsel sonucu etkileyen bir varsayım yapmamış, karşılaştırmayı sağlayıcı/hizmet düzeyinde “ChatGPT, Gemini ve DeepSeek” olarak aktarmıştır. Kaynakta KSA genel olarak Knowledge, Skills, Abilities olarak tanımlanırken bir tablo başlığında “Attitudes” ifadesi görülmektedir; ana çerçeve tanımı korunmuştur.
Temel yöntemsel sınır: Çalışma tasarım ve ön doğrulama düzeyindedir. İki kurgusal prototip senaryosu, tekil model çalıştırmaları ve altı kişilik uzman odak grup; gerçek dünya koçluk etkililiği, insan koçluğuna üstünlük, uzun dönemli davranış değişikliği veya örgütsel performans artışı hakkında nedensel sonuç çıkarmaya yeterli değildir.
Görsel yeniden inşa: Kaynakta araştırma metodolojisi şemaları, n8n ekran görüntüleri ve odak grup ısı haritası bulunmaktadır. Bu Verianla sürümünde yayınevi görselleri kopyalanmamış; çerçevenin kaynakta açıkça tarif edilen ilişkilerinden bağımsız bir 10 aşamalı SVG şeması üretilmiştir. Kaynak ısı haritasının kesin sayısal dağılımı ham veri olarak verilmediğinden yeniden çizilmemiştir.
Verianla Live / Live Figure uygunluğu: Kısmen uygun. 10 aşamalı koçluk döngüsünün aşama sırası ve Review üzerinden yeniden giriş mantığı, kaynak-değerleri değiştirmeyen bir Live Process/Live Flow sunumuna uygundur. Ancak bu makalede teknik Live motor sözleşmesi doğrulanmadığından statik ve bağımsız inline SVG tercih edilmiştir; kullanıcının KPI veya koçluk parametresi değiştirerek yeni bilimsel sonuç üretmesine izin veren bir simülasyon tasarlanmamıştır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir