

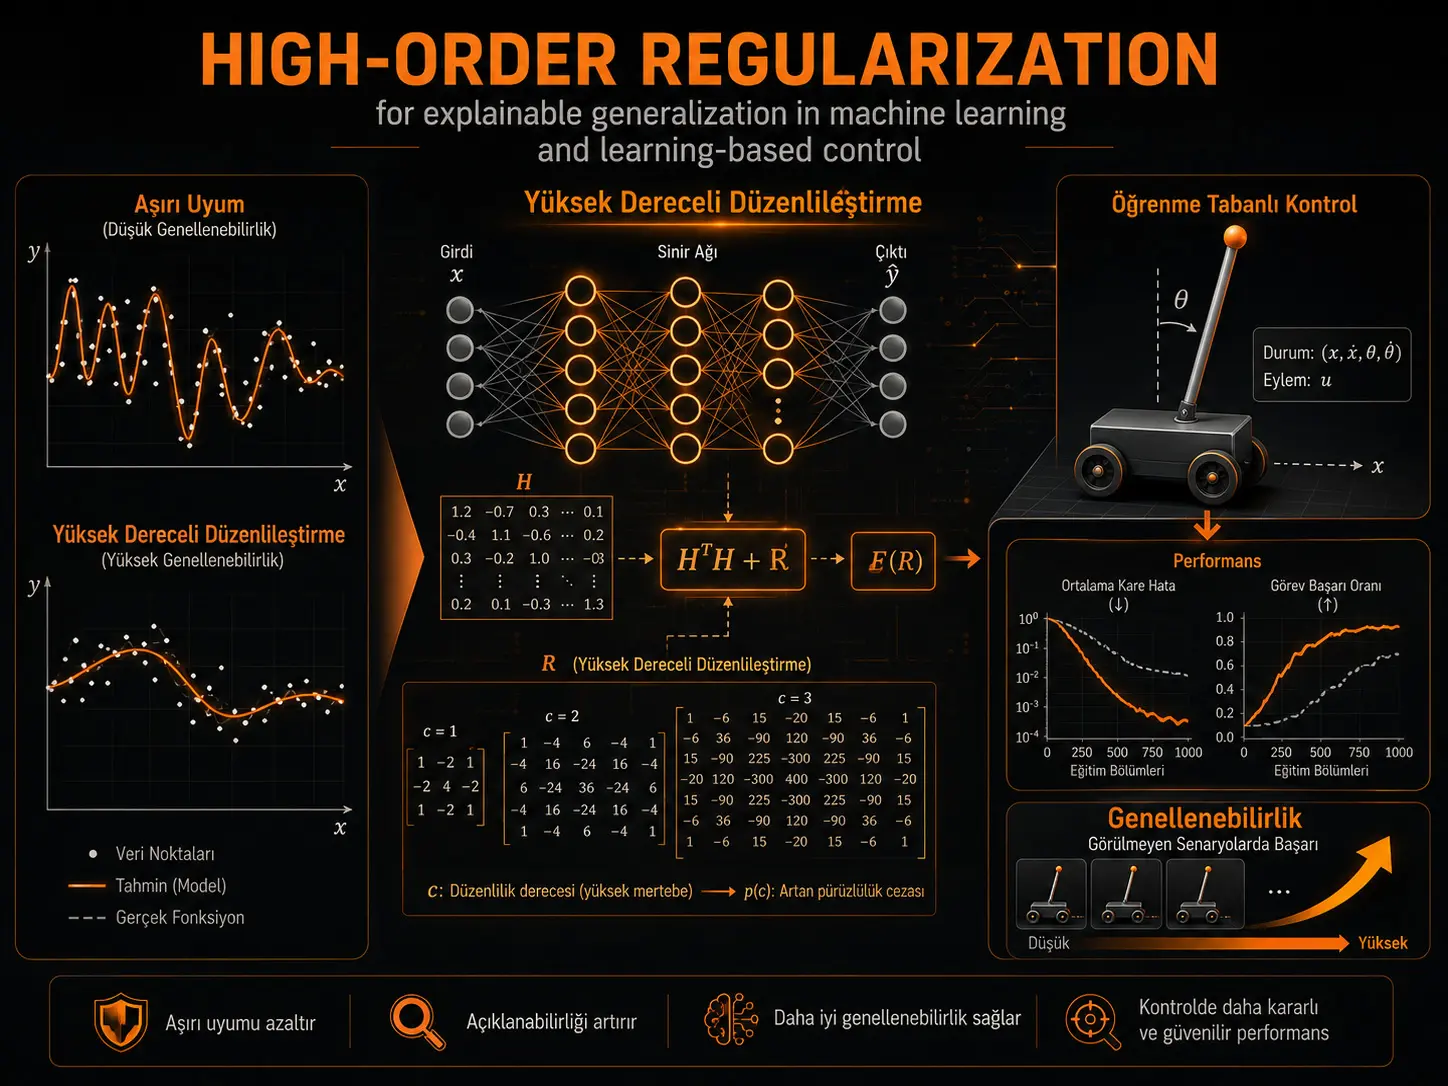
Bu çalışma, sinir ağlarında aşırı uyumu azaltırken düzenlileştirmenin neden ve nasıl genellenebilirliği değiştirdiğini matematiksel olarak açıklamak amacıyla High-Order Regularization (HR) — Yüksek Dereceli Düzenlileştirme adlı bir yöntem öneriyor. HR, sinir ağının son gizli katmanından çıkışa uzanan öğrenilebilir ağırlıkların hesaplanmasını bir ters eşleme problemi olarak ele alıyor ve \(H^\top H\) bilgi matrisinin tersini sonlu bir matris kuvvet serisiyle yaklaşıklaştırıyor. Geleneksel L2-norm düzenlileştirme bu çerçevede \(c=0\) olan düşük dereceli özel durum olarak ortaya çıkarken, çalışmada uygulamalar için çoğunlukla \(c=1\) kullanılıyor. Teorik bölüm yakınsama, hesaplanabilir alt ve üst hata sınırları ve düzenlileştirme matrisi üzerinden koşul sayısını kontrol eden bir genellenebilirlik ölçütü türetiyor. Deneylerde HR; Cart-Pole kontrolünde, IRIS ve MNIST sınıflandırmasında ve üç regresyon probleminde karşılaştırılan yöntemlere göre daha yüksek ödül/doğruluk veya daha düşük RMSE değerleri üretmiştir. Bununla birlikte deneyler sınırlı sayıda problem üzerinde yürütülmüş, veri bölmeleri özellikle aşırı uyumu teşvik edecek biçimde tasarlanmış ve büyük modern derin ağ mimarilerinde ölçeklenebilirlik henüz deneysel olarak gösterilmemiştir.
Cart-Pole deneyinin zaman adımı sınırının kaldırıldığı karşılaştırmasında son 50 bölümün ortalama ödülü Q-network için 207,4, EQLM için 208,2 ve önerilen HR için 273,4 olarak raporlanmıştır. Yazarlar bu sonucu Q-network'a göre %31,8 ve EQLM'ye göre %31,3 iyileşme olarak ifade etmektedir. Ancak HR sonucundaki koşular arası değişkenlik yüksektir; aynı tabloda HR için standart sapma 323,7 olarak verilmektedir. Dolayısıyla yüksek ortalama performans daha düşük varyans anlamına gelmemektedir.
200 zaman adımlı standart sınıra sahip Cart-Pole deneyinde HR'nin son 50 bölüm ödülü 175,2 iken Q-network için 123,8'dir; AUC değerleri sırasıyla \(87,5\times10^3\) ve \(71,0\times10^3\) olarak raporlanmıştır. Yazarlar bunları sırasıyla %41,5 ve %23,2 artış olarak değerlendirmektedir. Bu kontrollü deneyde HR'nin ödül sonuçlarındaki dağılımı sınırsız zaman adımlı deneyden daha dardır.
Makine öğrenmesi deneylerinde de aynı eğilim görülmektedir. IRIS test doğruluğu HR ile %95,0; Dropout ile %94,2; L2-norm ile %93,3 ve düzenlileştirmesiz FNN ile %87,5'tir. MNIST'te yalnız 1.000 eğitim görüntüsü kullanıldığında HR %84,1, Dropout %83,4, L2-norm %82,7 ve FNN %59,0 doğruluk vermiştir. Bu karşılaştırmalar HR'nin seçilmiş testlerde avantajını gösterir; ancak çalışma bu tablo sonuçları için tekrarlı deney dağılımı, güven aralığı veya yöntemler arası istatistiksel anlamlılık testi raporlamamaktadır.
Türkiye açısından: HR yaklaşımı Türkiye'deki makine öğrenmesi, robotik, adaptif kontrol, endüstriyel otomasyon veya sınırlı/yanlı eğitim verisiyle çalışan karar sistemlerinde araştırılabilecek bir matematiksel yöntem sunmaktadır. Ancak çalışmadaki performans değerleri Türkiye'deki herhangi bir gerçek sisteme doğrudan aktarılamaz. Yerel kullanım için ilgili veri dağılımı, ağ mimarisi, hesaplama donanımı, gerçek zamanlı kısıtlar, güvenlik gereksinimleri ve mevcut yöntemlerle bağımsız benchmark karşılaştırmaları ayrıca doğrulanmalıdır.
Araştırmanın temel problemi nedir?
Düzenlileştirme, bir sinir ağının eğitim verisine aşırı uyum sağlamasını önlemek ve görülmemiş veriler üzerinde daha iyi davranmasını sağlamak için yaygın biçimde kullanılır. L2, L1, dropout, mixup, erken durdurma ve benzeri yöntemlerin pratik başarısı iyi bilinmesine karşın çalışmanın hedeflediği boşluk, düzenlileştirmenin orijinal çözümü matematiksel olarak nasıl değiştirdiğini, hangi yanlılığı oluşturduğunu ve bu yanlılık ile genellenebilirlik arasındaki dengenin nasıl hesaplanabileceğini daha açık biçimde ortaya koymaktır.
Şekil 1 bu problemi regresyon ve sınıflandırma üzerinden görselleştirir. Eğitim noktalarına aşırı derecede kıvrılarak uyan karmaşık modeller mavi, daha düşük karmaşıklığa sahip düzenlileştirilmiş modeller siyah çizgilerle gösterilir. Görselin ana mesajı, eğitim örneklerini daha iyi takip eden modelin mutlaka görülmemiş veri için daha iyi model olmadığıdır.
Analiz neden Extreme Learning Machine üzerinden kuruluyor?
Çalışma teoriyi açık biçimde türetebilmek için Extreme Learning Machine (ELM) mimarisinden yararlanır. ELM, tek gizli katmanlı ileri beslemeli bir ağdır; girişten gizli katmana giden ağırlıklar ve olası bias rastgele atanırken yalnız gizli katmandan çıkışa giden \(\beta\) ağırlıkları analitik olarak hesaplanır.
Şekil 2'de giriş düğümlerinin gizli düğümlere, gizli düğümlerin de çıkışlara bağlandığı ELM mimarisi gösterilir. Bir giriş örneği \(x_j\) için ağ çıkışı:
\[ \sum_{i=1}^{L}\beta_i g_i(x_j) = \sum_{i=1}^{L}\beta_i g_i(w_i\cdot x_j+b_i) = o_j \]
biçiminde ifade edilir. Burada \(L\) gizli düğüm sayısını, \(w_i\) rastgele giriş ağırlıklarını, \(b_i\) bias'ı, \(g_i\) aktivasyon fonksiyonunu ve \(\beta_i\) öğrenilebilir çıkış ağırlığını temsil eder.
Temel eğitim problemi:
\[ \min_{\beta\in\mathbb{R}^{L\times k}} \left\|H\beta-Y\right\|^2 \]
olarak yazılır. \(H\), gizli katman çıkış matrisi; \(Y\) ise eğitim etiketidir. Düzenlileştirme olmadan en küçük normlu en küçük kareler çözümü Moore–Penrose sözde tersiyle:
\[ \hat{\beta}=H^\dagger Y \]
şeklinde elde edilir.
L2 düzenlileştirme bu yapı içinde nasıl görünüyor?
Kaynakta klasik L2 düzenlileştirilmiş çözüm:
\[ \hat{\beta} = \left( H^\top H+\frac{I}{\mu} \right)^\dagger H^\top Y \]
olarak verilir. Bu işlem kötü koşullu \(H^\top H\) matrisini sayısal olarak daha kararlı hâle getirebilir; ancak düzenlileştirme aynı zamanda teorik optimal çözüme göre bir tahmin yanlılığı oluşturur. Çalışmanın HR yaklaşımı bu yanlılığı doğrudan yaklaşık ters eşleme hatası olarak tanımlamaya çalışmaktadır.
Yüksek Dereceli Düzenlileştirme nasıl türetiliyor?
HR'nin başlangıç noktası:
\[ F(R) := R\left(H^\top H+R\right)^{-1} \]
tanımıdır. Burada \(R\), seçilebilir düzenlileştirme matrisidir. Uygun spektral yarıçap koşulu altında:
\[ (I-F(R))^{-1} = \sum_{i=0}^{\infty}F^i(R), \qquad \rho(F(R))<1 \]
matris kuvvet serisi kullanılabilir. Sonsuz seri \(c+1\) terimden sonra kesildiğinde çalışmanın önerdiği HR çözümü elde edilir:
\[ \hat{\beta}_{hr} = \left(H^\top H+R\right)^{-1} \sum_{i=0}^{c} F^i(R)H^\top Y, \qquad \rho(F(R))<1 \]
\(c\), düzenlileştirme derecesidir. \(c=0\) ve \(R=\bar{\mu}I\) seçildiğinde çözüm geleneksel L2-norm düzenlileştirmenin biçimine indirgenir. \(c\geq1\) olduğunda ters eşleme birden fazla matris-serisi terimiyle yaklaşıklandığı için çalışma bunu “high-order” düzenlileştirme olarak adlandırmaktadır.
L2 neden HR'nin özel durumu kabul ediliyor?
HR'de \(c=0\) seçildiğinde seri yalnız kimlik terimini içerir:
\[ \sum_{i=0}^{0}F^i(R)=I \]
ve:
\[ \hat{\beta}_{hr} = (H^\top H+R)^{-1}H^\top Y \]
elde edilir. \(R=\bar{\mu}I\) seçimi klasik L2/Tikhonov tipi çözümü verir. Appendix A ayrıca son gizli katmana uygulanan dropout'un beklenen kaybının:
\[ L(\beta)= \frac{1}{2N}\|y-H\beta\|_2^2+ \frac{1-p}{2pN} \beta^\top \operatorname{diag}(H^\top H) \beta \]
şeklinde norm düzenlileştirmeye dönüştürülebildiğini gösterir. Bu özel dropout türetiminde düzenlileştirme katsayısı \((1-p)/p\), dropout gürültüsünün varyansıyla ilişkilidir.
HR çözümünün yakınsaması nasıl açıklanıyor?
Çalışmada HR hatası:
\[ e_\beta=\hat{\beta}_{hr}-\beta_{opt} \]
olarak tanımlanır. Teorem 1, belirtilen pozitif tanımlılık ve spektral yarıçap koşulları altında düzenlileştirme matrisi sıfıra yaklaşırken veya düzenlileştirme derecesi sonsuza giderken HR çözüm hatasının sıfıra yaklaştığını gösterir:
\[ \lim_{R\rightarrow O}\|e_\beta\|=0, \qquad \lim_{c\rightarrow+\infty}\|e_\beta\|=0 \]
Bu sonuç, HR'nin seri kesme hatasının düzenlileştirme matrisi ve seri derecesiyle doğrudan ilişkilendirilebilmesini sağlar.
Hata neden hesaplanabilir kabul ediliyor?
Ters matris yaklaşık hatası:
\[ F_{ar}(R) = (H^\top H)^{-1} - (H^\top H+R)^{-1} \sum_{i=0}^{c}F^i(R) \]
biçiminde tanımlanır. Uygun koşullar altında:
\[ F_{ar}(R) = (H^\top H)^{-1}F^{c+1}(R) \]
elde edilmektedir. Çalışma daha sonra HR çözüm hatası için alt ve üst sınırlar türetir:
\[ \frac{1}{1-\lambda_{\min}(F(R))} \left\| (H^\top H+R)^{-1} F^{c+1}(R)H^\top Y \right\| \leq \|e_\beta\| \]
ve:
\[ \|e_\beta\| \leq \frac{1}{1-\lambda_{\max}(F(R))} \left\| (H^\top H+R)^{-1} F^{c+1}(R)H^\top Y \right\| \]
şeklindedir. Böylece düzenlileştirme nedeniyle teorik çözüme göre oluşan fark yalnız sezgisel bir ceza terimi değil, seçilen \(R\) ve \(c\) altında sınırlandırılabilen bir yaklaşık tersleme hatası olarak yorumlanmaktadır.
Düzenlileştirme neden bir daralma işlemi olarak yorumlanıyor?
Teorem 2'de uygun simetrik pozitif yarı tanımlı \(R\) ve pozitif tanımlı \(H^\top H\) koşullarında düzenlileştirme matrisinin \(F_{ar}(R)\) yaklaşık hata normu üzerinde bir daralma oluşturduğu gösterilmektedir. Daralma oranını hem \(R\) hem de düzenlileştirme derecesi \(c\) belirler.
Bu bakış açısında düşük derece, teorik optimum ile düzenlileştirilmiş çözüm arasında daha büyük bir uzaklık oluşturabilir; daha fazla seri terimi ise ters eşleme yaklaşımını iyileştirir. Bunun karşılığında düzenlileştirmenin kötü koşulluluğu azaltma etkisiyle tahmin yanlılığı arasında bir denge kurulması gerekir.
“Maksimum genellenebilirlik” ne anlama geliyor?
Çalışma genellenebilirliği doğrudan bütün olası test dağılımları üzerinde ölçmek yerine \(H^\top H+R\) matrisinin koşul sayısı üzerinden karakterize eder:
\[ \operatorname{Cond}(R) = \|H^\top H+R\| \, \|(H^\top H+R)^{-1}\| \]
Koşul sayısının küçülmesi, eğitim verisindeki küçük değişikliklerin ağırlık çözümünde aşırı büyük değişikliklere dönüşmesini azaltan daha iyi koşullu bir problem anlamına gelir. Çalışmanın denge kriteri:
\[ \operatorname{Obj}(R) = \|F_{ar}(R)\| \operatorname{Cond}(R) \]
olarak tanımlanır. Bu amaç fonksiyonu tahmin yanlılığı ile kötü koşulluluğu birlikte hesaba katmaktadır.
Önerme 2'de \(H^\top H\)'nin özdeğerleri \(\lambda_i\) iken:
\[ \lambda_{R,i} = \max\{\bar{\mu}-\lambda_i,0\} \]
şeklinde yapılandırılmış bir düzenlileştirme matrisi ele alınır. Çalışmanın matematiksel genellenebilirlik ölçütünde \(\bar{\mu}=\lambda_1\) civarında koşul sayısı 1'e kadar indirilebilir. Bu “maksimum genellenebilirlik” ifadesi çalışmanın koşul-sayısı temelli teorik tanımı içindedir; bütün gerçek dünya dağılımlarında evrensel maksimum performans garantisi olarak yorumlanmamalıdır.
Şekil 4 düzenlileştirmeyi nasıl açıklıyor?
Şekil 4, teorik açıklamanın görsel özetidir. En büyük çember, verilen eğitim verisi ve \(H^\top H\) bilgi matrisi için orijinal ağın olası çözümlerini; merkez ise teorik optimal çözümü temsil eder. Daha küçük çemberler farklı \(R\) matrisleri altında elde edilen düzenlileştirilmiş çözümleri gösterir. Kesikli çember yarıçapı belirli \(c\) için tahmin yanlılığını temsil eder.
Şeklin temel mesajı, daha güçlü düzenlileştirmenin otomatik olarak daha iyi olmadığıdır. Amaç, çözümü kararlı hâle getirirken teorik optimumdan gereksiz ölçüde uzaklaştırmayan bir \(R\) ve \(c\) kombinasyonu bulmaktır.
Tekil veya büyük eşlemelerde HR nasıl genişletiliyor?
Ağ ölçeği büyüdüğünde \(H^\top H\) tekil olabilir. Çalışma bu durumda Moore–Penrose sözde tersini kullanarak genel ters eşleme yaklaşımını genişletir. Yaklaşım:
\[ F_{aim}(H,R,c) = (H^\top H+R)^{-1} \sum_{i=0}^{c}F^i(R) \]
ile tanımlanır ve:
\[ F_{ar}(R) = (H^\top H)^\dagger-F_{aim}(H,R,c) \]
artık genel tersleme yaklaşık hatasını temsil eder. Teorem 3'te:
\[ \lim_{c\rightarrow+\infty}F_{ar}(R) = (H^\top H)^\dagger-R^{-1} \]
sonucu verilmektedir. Kaynağın yorumu, uygun \(R\) seçiminin tekil eşlemelerde de yaklaşık tersleme hatası ile koşulluluğu birlikte kontrol etmeye olanak tanıdığıdır.
Artımlı HR nasıl çalışıyor?
Incremental High-Order Regularization (IHR), yeni mini-batch verisi geldiğinde bütün ağı sıfırdan eğitmek yerine mevcut bilgi matrisi ve ağırlıkları günceller. Temel güncelleme:
\[ \hat{\beta}_{t+1} = K_{t+1}(c)\hat{\beta}_t + F_{aim,t+1}H_{ic}^{\top}Y_{ic} \]
biçimindedir. Burada yeni \(H_{ic},Y_{ic}\) mini-batch'i mevcut modele eklenir. Çalışma, özellikle öğrenme tabanlı kontrolde eğitimin ilk dönemindeki düşük kaliteli ve sınırlı verilerin oluşturabileceği aşırı uyumun zaman içinde azaltılması bağlamında bu artımlı yapıyı tartışmaktadır.
HR'nin “öğrenme, hafıza ve unutma” yorumu nedir?
Yazarlar düzenlileştirmenin erken eğitimde yetersiz veya yanlı verinin etkisini bastırmasını bir tür adaptif unutma olarak yorumlamaktadır. Eğitim ilerledikçe veri kalitesi ve bilgi miktarı arttığında düzenlileştirmenin etkisinin değişebilmesi, sistemin yeni bilgi öğrenmesiyle eski bilgiye verdiği ağırlık arasındaki ilişkiyi açıklamak için kullanılmaktadır.
Bu ifade nörobiyolojik bir hafıza mekanizmasının kanıtı değildir; çalışmanın matematiksel düzenlileştirme davranışına verdiği öğrenme tabanlı kontrol yorumudur.
Cart-Pole deneyinde ne bulundu?
OpenAI Gym Cart-Pole problemi, Q-network, EQLM ve HR-EQLM yaklaşımını karşılaştırmak için kullanılmıştır. Zaman adımı sınırının kaldırıldığı deneylerde 50 koşu üzerinden son 50 bölümün ortalama ödülleri:
| Yöntem | Son 50 bölüm ortalama ödülü | AUC (×10³) |
|---|---|---|
| Q-network | 207,4 (176,2–236,3) | 107,8 (103,8–111,8) |
| EQLM | 208,2 (188,51–224,98) | 97,2 (90,3–103,3) |
| Önerilen HR | 273,4 (166,1–340,3) | 116,3 (86,1–136,8) |
HR ortalama ödülde en yüksek değeri üretmiştir. Bununla birlikte aynı Tablo 4'te standart sapma Q-network için 108,7, EQLM için 66,2 ve HR için 323,7 olarak raporlanmaktadır. HR'nin yüksek ortalaması bazı koşularda 200 zaman adımının oldukça üzerinde elde edilen yüksek ödüllerden etkilenmektedir; dolayısıyla ortalama artışla birlikte koşular arası değişkenlik de dikkate alınmalıdır.
200 zaman adımlı deneyde sonuç nasıl değişiyor?
Standart 200 zaman adımlı sınır uygulandığında karşılaştırma daha dar bir performans aralığında yapılmıştır:
| Yöntem | Son 50 bölüm ortalama ödülü | AUC (×10³) |
|---|---|---|
| Q-network | 123,8 (112,4–135,5) | 71,0 (68,8–73,5) |
| Önerilen HR | 175,2 (169,6–180,9) | 87,5 (84,7–90,5) |
Kaynak, HR'nin son 50 bölüm ödülünde %41,5 ve AUC'de %23,2 iyileşme sağladığını raporlamaktadır. HR ödüllerinin standart sapması 20,3, Q-network'un ise 41,9'dur.
IRIS ve MNIST sonuçları ne gösteriyor?
Sınıflandırma deneylerinde FNN, Dropout, L2-norm ve \(c=1\) HR karşılaştırılmıştır:
Verianla Live: Düzenlileştirme yöntemlerinin sınıflandırma doğruluğu
Karşılaştırma, çalışmanın Tablo 6'sında raporlanan test doğruluklarını gösterir. MNIST deneyi yalnız 1.000 eğitim görüntüsüyle yürütülmüştür; bu nedenle değerler tam MNIST eğitim setiyle elde edilmiş standart benchmark değerleri olarak yorumlanmamalıdır.
| Veri seti | FNN | Dropout | L2-norm (c=0) | Önerilen HR (c=1) | Birim | Kaynak |
|---|---|---|---|---|---|---|
| IRIS | 87,5 | 94,2 | 93,3 | 95,0 | Test doğruluğu (%) | Tablo 6 |
| MNIST | 59,0 | 83,4 | 82,7 | 84,1 | Test doğruluğu (%) | Tablo 6 |
HR her iki veri setinde de en yüksek test doğruluğunu vermiştir. Ancak IRIS'te HR ile Dropout arasındaki fark 0,8 yüzde puanı, MNIST'te ise 0,7 yüzde puanıdır. Çalışma bu farklar için istatistiksel anlamlılık testi veya tekrarlı koşu güven aralığı raporlamadığından küçük farkların genellenebilir üstünlük olarak yorumlanması uygun değildir.
Regresyon deneylerinde ne bulundu?
Regresyon görevlerinde düşük Root Mean Squared Error (RMSE) daha iyi performansı ifade etmektedir:
| Veri seti | FNN RMSE | Dropout RMSE | L2-norm RMSE | HR (c=1) RMSE |
|---|---|---|---|---|
| Weather prediction | 4,2274 | 2,1575 | 2,7061 | 2,0888 |
| Power consumption | 0,7488 | 0,7140 | 0,7474 | 0,7096 |
| Appliances energy | 87,7197 | 79,0572 | 79,4058 | 77,3815 |
HR, çalışmadaki üç regresyon testinin tamamında en düşük RMSE'yi vermiştir. Weather prediction'da Dropout ile HR arasındaki fark görece küçükken, düzenlileştirmesiz FNN'nin hatası daha yüksektir.
Şekil 12 ve 13 ne gösteriyor?
Appliances Energy deneyinin Şekil 12'si tahmin eksi gerçek değer hatasını zaman boyunca FNN, L2, HR ve Dropout için gösterir. Şekil 13 aynı hataların dağılımlarını karşılaştırmaktadır. Düzenlileştirilmiş modellerin hata dağılımları sıfır çevresinde benzer biçimde yoğunlaşmaktadır.
Çalışmada regresyon modellerinin düzenlileştirme kaynaklı yanlılığını azaltmak için eğitim verisinden ayrılan doğrulama verileri kullanılarak yanlılık düzeltmesi uygulanmıştır. Bu nedenle tabloda verilen regresyon sonuçları yalnız ham düzenlileştirme çözümünün değil, çalışmada tanımlanan doğrulama-temelli düzeltme sürecinin de etkisini taşır.
Çalışmanın desteklediği sonuçlar
- HR, matris kuvvet serisinin kesilmiş bir yaklaşık tersleme biçimi olarak açıkça formüle edilmiştir.
- L2-norm düzenlileştirme, HR çerçevesinde \(c=0\) özel durumu olarak ifade edilebilmektedir.
- Belirtilen matris koşulları altında HR çözümünün yakınsaması ve hesaplanabilir hata sınırları teorik olarak türetilmiştir.
- Düzenlileştirme matrisi ve derece, yaklaşık tersleme hatasının daralma oranını kontrol etmektedir.
- Çalışmanın koşul-sayısı temelli tanımı altında \(R\) matrisinin özdeğer yapısı genellenebilirlik ölçütünü optimize etmek için tasarlanabilmektedir.
- Seçilen Cart-Pole, sınıflandırma ve regresyon deneylerinde \(c=1\) HR, raporlanan ana performans ölçütlerinde karşılaştırılan yöntemlerin üzerinde sonuçlar vermiştir.
Çalışmanın kanıtlamadığı veya henüz test etmediği sonuçlar
- HR'nin bütün makine öğrenmesi görevlerinde L2, Dropout veya diğer düzenlileştirme yöntemlerinden üstün olduğu gösterilmemiştir.
- Koşul sayısının minimum olması bütün gerçek veri dağılımlarında maksimum test performansını garanti ettiği anlamına gelmez.
- HR'nin büyük CNN, RNN veya transformer mimarilerindeki ölçeklenebilirliği deneysel olarak doğrulanmamıştır.
- Cart-Pole sonuçları gerçek robot veya güvenlik kritik kontrol sisteminde saha doğrulaması değildir.
- IRIS, MNIST ve regresyon tablosundaki küçük performans farkları için istatistiksel üstünlük testi raporlanmamıştır.
- MNIST sonucu tam standart eğitim setiyle elde edilmiş bir benchmark değildir; yalnız 1.000 eğitim görüntüsü kullanılmıştır.
- Kaynakta sunulan “açıklanabilirlik”, SHAP veya özellik atıf yöntemi gibi örnek-bazlı açıklama üretmekten ziyade düzenlileştirmenin matematiksel etkisini açıklamaya yöneliktir.
Çalışmanın Yöntemi ve Bulguları
Teorik yöntem
Çalışmanın teorik kısmı sinir ağının son gizli katman çıkışını \(H\) eşleme matrisiyle temsil eder ve öğrenilebilir çıkış ağırlıklarını \(\beta\) üzerinden inceler. HR, \(H^\top H\) veya bunun Moore–Penrose genel tersini doğrudan kullanmak yerine düzenlileştirilmiş matris ve kesilmiş kuvvet serisinden bir yaklaşık ters üretir.
| Bileşen | Kaynakta kullanılan ifade | İşlev |
|---|---|---|
| Bilgi/eşleme matrisi | \(H^\top H\) | Eğitim verisinden gelen eşleme bilgisini temsil eder. |
| Düzenlileştirme matrisi | \(R\) | Koşulluluk ve tahmin yanlılığı arasındaki dengeyi değiştirir. |
| Seri matrisi | \(F(R)=R(H^\top H+R)^{-1}\) | Yaklaşık tersleme kuvvet serisini oluşturur. |
| Düzenlileştirme derecesi | \(c\) | Seride tutulan yüksek dereceli terim sayısını belirler. |
| Yaklaşık ters | \(F_{aim}(H,R,c)\) | Genel ters eşlemenin HR yaklaşımıdır. |
| Yaklaşım kalıntısı | \(F_{ar}(R)\) | Teorik ters ile HR yaklaşık tersi arasındaki farktır. |
Cart-Pole deney düzeni
| Deney özelliği | Kaynakta verilen değer |
|---|---|
| Eylem uzayı | Sol, sağ |
| Durum değişkenleri | Araba konumu, araba hızı, çubuk açısı, çubuk açısal hızı |
| Çubuk açı sınırı | (−12°, 12°) dışına çıkışta sonlandırma |
| Araba konum sınırı | (−2,4, 2,4) dışına çıkışta sonlandırma |
| Standart maksimum zaman adımı | 200 |
| Ödül | Her adım +1 |
| Başlangıç durumu | (−0,05, 0,05) aralığında rastgele |
| Toplam koşu | 50 |
Ağ hiperparametreleri
| Hiperparametre | Q-network | ELM / EQLM-HR yapısı |
|---|---|---|
| Öğrenme oranı | 0,0065 | Uygulanmıyor |
| Düzenlileştirme parametresi | Uygulanmıyor | 1,827×10−5 |
| Gizli düğüm | 29 | 25 |
| Başlangıç exploration olasılığı | 0,670 | 0,599 |
| Exploration azaltma süresi | 400 bölüm | 360 bölüm |
| İskonto faktörü | 0,99 | 0,93 |
| Mini-batch | 26 | 2 |
| Target-network güncelleme adımı | 70 | 48 |
| Düzenlileştirme derecesi | Uygulanmıyor | EQLM: c=0; HR deneyleri: c=1 |
Çalışma Q-network ve ELM tabanlı yöntemlerde aynı ağ mimarisi veya aynı bütün hiperparametreleri kullanmamaktadır. HR ile EQLM karşılaştırmasında ise kaynak, aynı düzenlileştirme parametresinin korunduğunu ve temel ayrımın HR derecesi olduğunu belirtmektedir.
Makine öğrenmesi deney düzeni
Sınıflandırmada IRIS ve MNIST; regresyonda Individual Household Electric Power Consumption, Appliances Energy Prediction ve hava durumu verileri kullanılmıştır.
MNIST deneyinde yalnız 1.000 görüntü, yani kaynağın ifadesiyle toplam eğitim verisinin yaklaşık %1,7'si eğitim için kullanılmıştır. Diğer veri setlerinde çalışma alışılmış 80/20 düzeninin tersine %20 eğitim ve %80 test bölmesi kullanmıştır. Yazarlar bu seçimleri modelleri aşırı uyuma daha yatkın hâle getirerek sınırlı eğitim verisi koşullarını taklit etmek amacıyla yaptıklarını belirtmektedir.
Bütün makine öğrenmesi deneylerinde gizli düğüm sayısı 1.000'dir. FNN'lerde sınıflandırma için bir, regresyon için iki gizli katman kullanılmıştır. \(R=\bar{\mu}I\) için \(\bar{\mu}=1,0\); Dropout oranı ise 0,5 olarak belirlenmiştir. Hiperparametrelerin veri setine özel kapsamlı optimizasyon yerine standart varsayılan değerlerle seçildiği açıkça belirtilmektedir.
Performans ölçütleri
Sınıflandırmada test doğruluğu, regresyonda RMSE kullanılmıştır. Cart-Pole deneyinde ise bölüm ödülü ve öğrenme eğrisinin alanı (AUC) temel sonuç ölçütleridir. Cart-Pole grafiklerinde 50 koşunun bölüm başına ortalama ödülü ve %95 güven aralığı gölgeli bantla gösterilmektedir.
Hesaplama ortamı
Cart-Pole ağları Intel i7-12700 işlemci, 16 GB bellek ve 12 GB RTX 3060 GPU bulunan bir masaüstü sistemde eğitilmiştir. Kaynak, oyunun çalıştırılması dahil her ağ eğitiminin bir saatten uzun sürdüğünü belirtmektedir.
Şekil 5–11'in ortak mesajı
Q-network'un gradient-descent tabanlı güncellemelerinde koşular arasında daha belirgin dalgalanmalar görülürken EQLM daha tutarlı bir ortalama öğrenme eğrisi göstermektedir. HR'nin sınırsız zaman-adımı deneyinde bazı koşular daha yüksek ödüllere ulaşmış ve ortalama ödülü yükseltmiştir. Standart 200 adımlı deneyde HR öğrenme eğrisi Q-network'a göre daha yüksek ve daha kararlı bir plato göstermektedir.
Şekil 10 düzenlileştirme parametresi \(\bar{\mu}\) değiştirilirken performansın tekdüze biçimde sonsuza kadar artmadığını; belirli bir bölgeden sonra yaklaşık plato oluştuğunu göstermektedir. Şekil 11 ise exploration olasılığının azaltılma süresi değiştirilerek öğrenme hızının belirgin biçimde değişebildiğini gösterir. Bu sonuç, performansın yalnız HR formülüne değil öğrenme sürecindeki exploration ayarına da bağlı olduğunu ortaya koymaktadır.
Yeniden üretilebilirlik ve yorum sınırları
Çalışma temel deney hiperparametrelerini ve veri seti kaynaklarını açıklamaktadır; ancak makale içinde bağımsız bir kod/veri paylaşım deposu bildirilmemektedir. Sınıflandırma ve regresyon tablolarındaki tekil performans değerleri için koşu sayısı, standart sapma veya güven aralığı verilmediğinden bu deneylerde yöntemin varyansı değerlendirilememektedir.
Yazarların kendi sonuç bölümünde de HR'nin derin çok katmanlı ağlara, convolutional ağlara, attention yapılarına, recurrent ağlara ve transformer tabanlı modellere tam entegrasyonunun henüz açık araştırma konusu olduğu belirtilmektedir. Büyük ölçekli problemlerde hesaplama maliyeti ve sayısal kararlılık da gelecekte incelenmesi gereken alanlar arasındadır.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: High-order regularization for explainable generalization in machine learning and learning-based control
Yazarlar ve sıra: Xinghua Liu; Ming Cao.
Eş katkı/eş birinci yazarlık: Kaynakta eş katkı veya eş birinci yazarlık beyanı bulunmamaktadır.
Sorumlu/iletişim yazarı: Kaynak metninde ayrıca “corresponding author” işareti görünmemektedir. SSRN'nin resmî bibliyografik kaydı Xinghua Liu'yu “Contact Author” olarak göstermektedir.
Kurum: Engineering and Technology institute Groningen (ENTEG), University of Groningen, 9747 AG Groningen, the Netherlands.
Kaynak türü: Matematiksel yöntem geliştirme, makine öğrenmesi deneyleri ve öğrenme tabanlı kontrol deneyi içeren araştırma preprinti.
Hakemlik durumu: Bu çalışma hakem değerlendirmesinden geçmemiş bir preprinttir; sonuçları bu yayın aşaması dikkate alınarak değerlendirilmelidir.
Platform: SSRN.
DOI: 10.2139/ssrn.6963250
SSRN yayın tarihi: 18 Haziran 2026.
Kaynak metindeki tarih: “Preprint submitted to XXX June 6, 2026”. Buradaki “XXX” kaynakta bırakılmış yer tutucudur ve gerçek dergi adı olarak yorumlanmamıştır.
Resmî bağlantı: https://ssrn.com/abstract=6963250
DOI bağlantısı: https://doi.org/10.2139/ssrn.6963250
Dergi/cilt/sayı/makale numarası: İncelenen sürümde doğrulanmış bir hakemli dergi, cilt, sayı veya makale numarası bulunmamaktadır.
Yayınevi: Kaynak çalışmanın hakemli yayın yayınevi belirlenmemiştir; “XXX” ifadesi yayınevi veya dergi adı olarak kullanılmamıştır.
Lisans: İncelenen sürümde Creative Commons veya eşdeğer açık yeniden kullanım lisansı açık biçimde belirtilmemektedir. Bu nedenle özgün şekiller bu Verianla HTML'sine bire bir kopyalanmamıştır.
Finansman: Çalışma Netherlands Organization for Scientific Research kapsamında NWO-Vici-19902 ve China Scholarship Council tarafından kısmen desteklenmiştir.
Veri/kod erişilebilirliği: Kaynakta ayrı bir veri veya kod paylaşım beyanı bulunmamaktadır. Deneylerde kullanılan açık veri kaynakları ve OpenAI Gym referansları kaynakçada tanımlanmıştır.
Çıkar çatışması: İncelenen sürümde ayrı bir çıkar çatışması beyanı belirlenmemiştir.
CRediT katkıları: Xinghua Liu — Conceptualization, Writing – review & editing, Writing – original draft, Methodology, Validation, Formal analysis. Ming Cao — Writing – review & editing, Validation, Supervision, Funding acquisition.
Üretken yapay zekâ beyanı: Yazarlar ChatGPT'yi dil bilgisi ve yazım kontrolü ile metin kalitesinin iyileştirilmesi amacıyla kullandıklarını; daha sonra içeriği inceleyip düzenlediklerini ve çalışma içeriğinin sorumluluğunu üstlendiklerini belirtmektedir.
Kaynak içi tutarsızlık 1: Bölüm 3.7, Algorithm 2'yi tanıtırken önerilen HR için düzenlileştirme derecesinin \(c=1\) olduğunu belirtmekte ve Algorithm 2'nin 8. satırı da açıkça \(c=1\) vermektedir. Buna karşın aynı bölümdeki bir cümle Algorithm 2'nin güncelleme süreçlerinde \(c=0\) sabitlediğini söylemektedir. Bu çelişki sessizce düzeltilmemiştir; deney tabloları ve algoritmanın açık satırı HR'yi \(c=1\) olarak raporlamaktadır.
Kaynak içi tutarsızlık 2: Ana hesaplama karmaşıklığı tartışmasının bir bölümünde düzenlileştirme derecesi için \(k\) sembolü kullanılırken çalışmanın matematiksel tanımı ve Appendix D boyunca düzenlileştirme derecesi \(c\) ile gösterilmekte ve ek karmaşıklık \(O(cn)\) biçiminde ifade edilmektedir.
Temel bilimsel sınır: Çalışmanın teorik genellenebilirlik analizi esas olarak son gizli katman eşlemesi ve \(H^\top H\) bilgi matrisinin koşulluluğu üzerine kuruludur. Deneysel doğrulama Cart-Pole ve seçilmiş düşük/orta ölçekli sınıflandırma-regresyon görevleriyle sınırlıdır. Büyük modern derin ağ mimarilerinde performans, hesaplama maliyeti ve ölçeklenebilirlik bu çalışma içinde doğrulanmamıştır.
Bilimsel içerik sınırı: Bu Verianla makalesindeki HR denklemleri, teoremler, algoritmalar, veri bölmeleri, hiperparametreler, deney sonuçları, grafik yorumları ve sınırlılıklar yalnız incelenen çalışmaya dayanmaktadır. Dış kaynaklar yalnız bibliyografik kimlik doğrulaması için kullanılmış, ana bilimsel metne dış deney veya yeni performans sonucu eklenmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir