

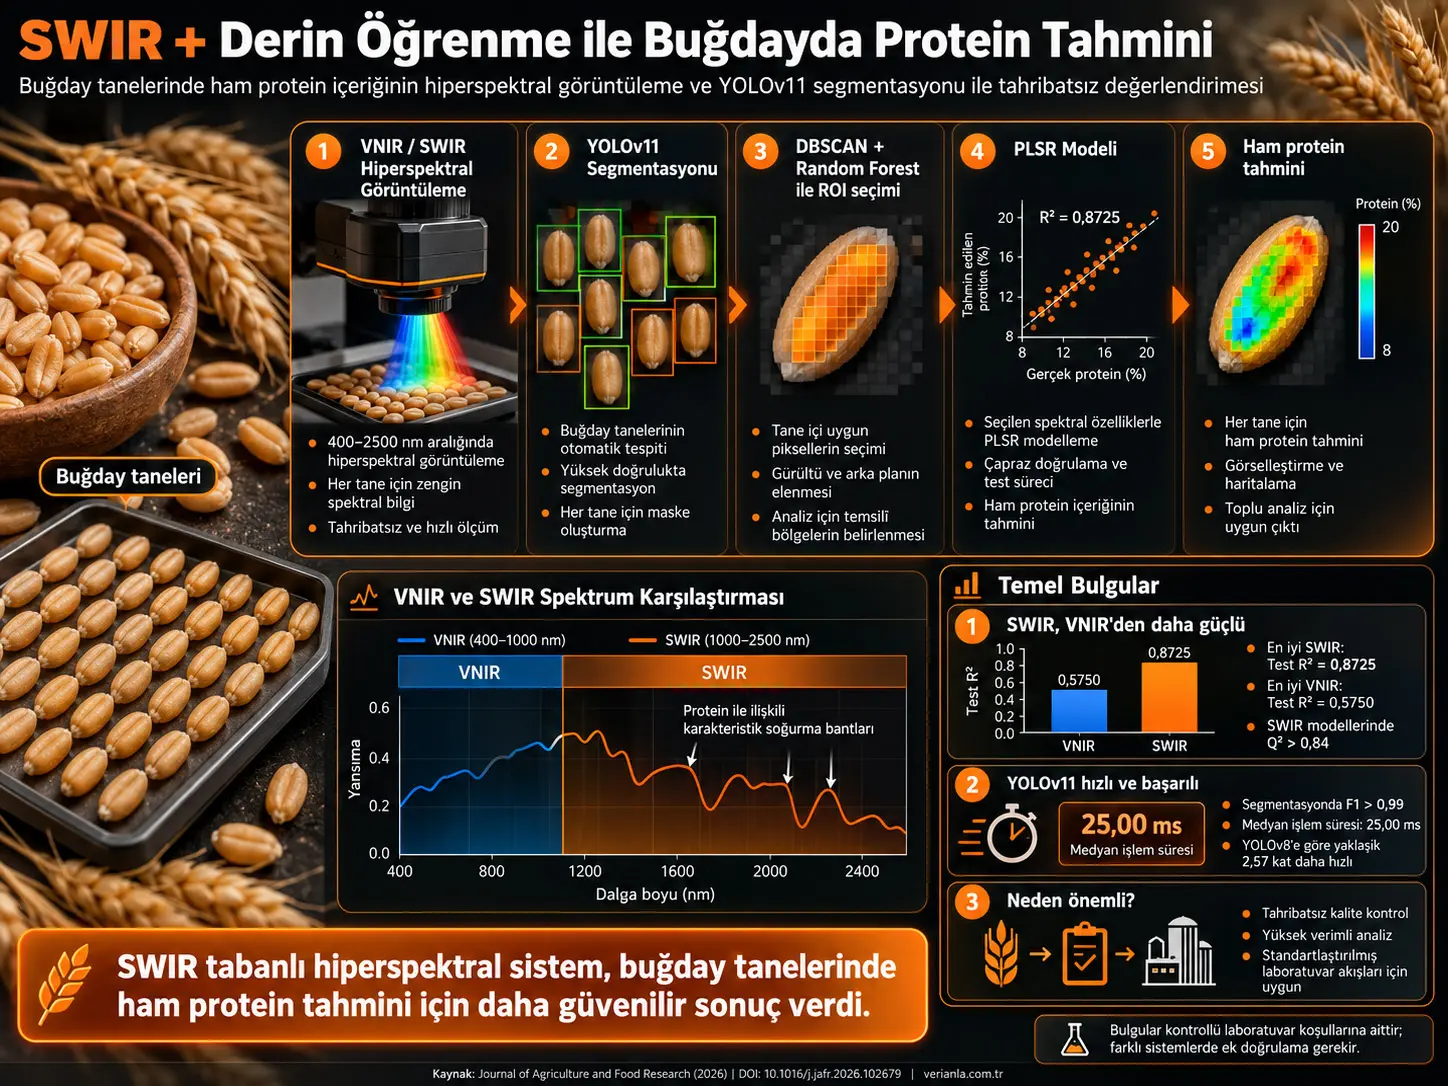
SWIR hiperspektral görüntüleme, bir nesnenin kısa dalga kızılötesi bölgedeki çok sayıdaki dar dalga boyunda yansıma bilgisini aynı görüntü içinde kaydeden tahribatsız bir görüntüleme yöntemidir. Bu çalışma, buğday tanelerinin ham protein içeriğini hızlı ve tahribatsız biçimde tahmin etmek amacıyla SWIR ve VNIR hiperspektral görüntülemeyi YOLOv11 tabanlı tane segmentasyonu, DBSCAN ve Random Forest tabanlı ilgi bölgesi seçimi ve Kısmi En Küçük Kareler Regresyonu (Partial Least Squares Regression, PLSR) ile birleştirmiştir. Toplam 45 buğday çeşidinden 2023 ve 2024 yıllarında elde edilen 4200 fiziksel tane iki farklı spektral sistemle görüntülenmiş, referans ham protein değerleri Dumas azot analizi üzerinden belirlenmiştir. Çalışmanın temel sonucu, kontrollü görüntüleme koşullarında SWIR spektrumunun ham protein tahmini açısından VNIR'den belirgin biçimde daha yüksek ve daha kararlı genelleme performansı sağlamasıdır.
En yüksek SWIR test performansı Multiplicative Scatter Correction (MSC) ön işlemiyle Test R² = 0,8725 ve RMSE = 0,7479 olarak elde edilmiştir. Bununla birlikte Savitzky–Golay ön işlemi, PLS bileşeni sayısını ham verideki 10'dan 3'e düşürürken Test R² = 0,8449 ve Q² = 0,8487 değerlerini koruyarak daha sade bir model sağlamıştır. SWIR modellerinde bütün test edilen ön işleme yöntemlerinin Q² değeri 0,84'ün üzerinde kalırken en iyi VNIR modeli Test R² = 0,5750 ve Q² = 0,5793 düzeyindedir.
YOLOv11 segmentasyonu, veri artırma uygulandığında cropped görüntülerde F1 değerini 0,99'un üzerinde tutabilmiştir. Modelin medyan işlem süresi 25,00 ms olarak ölçülmüş ve aynı çalışmadaki YOLOv8 karşılaştırmasına göre yaklaşık 2,57 kat daha hızlı çalışmıştır. Bununla birlikte sonuçlar aynı kameralar, kontrollü aydınlatma ve standart görüntüleme protokolü altında elde edilmiştir. Farklı cihazlarda, farklı çevre koşullarında ve bağımsız kurumların veri kümelerinde aynı performansın korunacağı bu çalışma tarafından kanıtlanmamıştır.
Neden buğdayın ham protein içeriği ölçülüyor?
Buğdayın protein bileşimi, özellikle gluten ağını oluşturan gliadin ve glutenin proteinleri nedeniyle unun işlenme özellikleriyle yakından ilişkilidir. Geleneksel ham protein tayininde Kjeldahl veya Dumas gibi kimyasal yöntemler kullanılabilir. Bu yöntemler yüksek doğruluk sağlayabilmekle birlikte numunenin hazırlanmasını, öğütülmesini ve kimyasal veya yanma temelli analizi gerektirir. Çok sayıda tanenin hızlı biçimde sınıflandırılması gereken bir üretim veya kalite kontrol senaryosunda her tanenin bu yöntemlerle ayrı ayrı incelenmesi yüksek verimli taramayı sınırlar.
Yakın kızılötesi spektroskopi tahribatsız analiz olanağı sağlar; ancak klasik spektrofotometreler çoğunlukla numunenin sınırlı bir bölgesinden spektrum alır. Hiperspektral görüntüleme ise görüntünün her uzamsal noktasında çok sayıda dalga boyunun yansıma bilgisini bir araya getirerek hem “nerede?” hem de “hangi spektral özellikte?” sorularını aynı veri kümesinde ele alabilir.
SWIR Neden Buğday Proteini Tahmininde VNIR'den Daha Güçlü Sonuç Verdi?
SWIR bölgesi, proteinlerde bulunan N–H, C=O ve C–N bağlarının titreşim üst tonları ve kombinasyon bantlarıyla ilişkili spektral bilgiyi kapsadığı için bu çalışmada ham protein içeriğine ilişkin daha doğrudan kimyasal sinyaller taşımıştır. Buna karşılık kullanılan VNIR aralığı proteinle ilişkili bu belirgin absorpsiyon bölgelerinin önemli bölümünü kapsamamış; tane kabuğu rengi gibi proteinle zayıf ilişkili fiziksel özelliklerden daha fazla etkilenmiştir. Sonuç olarak SWIR tabanlı PLSR modelleri bütün ön işleme seçeneklerinde Q² > 0,84 düzeyinde kalırken VNIR modellerinin genelleme performansı belirgin biçimde daha düşük olmuştur.
Çalışmada VNIR aralığı 397,32–1003,58 nm, SWIR aralığı ise 982,08–2576,58 nm'dir. Yüksek ve düşük ham protein gruplarının ortalama spektrumları karşılaştırıldığında VNIR'de yalnız bir belirgin dönüm noktası saptanırken SWIR spektrumunda sekiz dönüm noktası belirlenmiştir:
- 992,0 nm,
- 1200,5 nm,
- 1473,9 nm,
- 1779,3 nm,
- 1934,4 nm,
- 2283,0 nm,
- 2316,2 nm,
- 2487,8 nm.
Yazarlar 1473,9 nm noktasını N–H titreşimleriyle ilişkili yaklaşık 1500–1530 nm bölgesine; 2283,0 ve 2316,2 nm noktalarını ise protein yapısındaki C=O ve N–H titreşimleriyle ilişkili kombinasyon bantlarına yakın spektral özellikler olarak yorumlamaktadır. Bu yorum, gözlenen dönüm noktalarının proteinle ilişkili titreşimlerden kaynaklanabileceğini düşündürmektedir; çalışma bu noktaların her biri için bağımsız moleküler doğrulama gerçekleştirmemiştir.
VNIR'de saptanan yaklaşık 1000,5 nm dönüm noktası ise sensör aralığının uç sınırında bulunmaktadır. Araştırmacılar bu ani spektral değişimin gerçek biyokimyasal sinyalden çok cihazın ölçüm sınırındaki gürültüyü temsil etme olasılığına dikkat çekmektedir.
YOLOv11 Bu Çalışmada Ne Yapıyor?
YOLOv11 bu çalışmada ham protein miktarını doğrudan tahmin eden model değildir; hiperspektral görüntülerdeki tek tek buğday tanelerini ve beyaz referans bölgelerini otomatik olarak segmentleyerek her taneye ait spektral verinin çıkarılacağı uzamsal sınırı belirleyen derin öğrenme bileşenidir. Protein tahmini daha sonraki aşamada bu segmentlerden çıkarılan spektral özelliklerin PLSR modeline verilmesiyle yapılmaktadır.
Bu ayrım sistemin anlaşılması açısından önemlidir. Çalışmada üç farklı analitik iş birbirine bağlanmıştır:
- Nesnenin bulunması: YOLOv11 görüntüde hangi bölgenin buğday tanesi olduğunu belirler.
- Spektral ROI'nin rafine edilmesi: UMAP, DBSCAN ve Random Forest Classifier kullanılarak YOLO kutusu içindeki gerçekten taneye ait pikseller ayrıştırılır.
- Kimyasal özelliğin tahmini: Seçilen piksellerden çıkarılan spektrum PLSR modeline girer ve ham protein içeriği tahmin edilir.
Neden yalnız YOLO segmentasyonu yeterli görülmedi?
YOLO bir tanenin konumunu belirleyebilse de elde edilen bounding box yalnız taneyi değil çevresindeki arka plan piksellerini de içerebilir. Hiperspektral tahminde birkaç yanlış piksel bile ortalama yansıma spektrumunu değiştirebileceği için araştırmacılar tanenin gerçek spektral bölgesini ayrıca sınıflandırmıştır.
Bu amaçla spektral veriler önce Min-Max ölçekleme ile 0–1 aralığına getirilmiş, UMAP kullanılarak boyut indirgeme uygulanmış ve ardından DBSCAN kümeleri oluşturulmuştur. DBSCAN tarafından oluşturulan sınıf etiketleri Random Forest Classifier'ın eğitimi için kullanılmıştır. Deneysel değerlendirmede DBSCAN için eps = 0,46; Random Forest için maksimum derinlik = 2 seçilmiştir.
Son ROI çıkarımında çok düşük yansıma gösteren bölgeler de elenmiştir. Genel medyan yansımadan %30'dan fazla düşük yansımaya sahip bölgeler çıkarılmış ve üst üste binen tespit kutularında Intersection over Union (IoU) tabanlı non-maximum suppression uygulanmıştır.
Ham Protein İçeriği Bu Çalışmada Gerçekte Nasıl Ölçüldü?
Modelin öğreneceği referans ham protein değeri hiperspektral kameradan üretilmemiştir; görüntüleme tamamlandıktan sonra buğday örnekleri öğütülmüş, Dumas analizörüyle toplam azot miktarı ölçülmüş ve azot değeri 5,7 dönüşüm katsayısıyla çarpılarak ham protein içeriği hesaplanmıştır. Böylece görüntü tabanlı model, kimyasal referans ölçümünü tahmin etmeyi öğrenmiştir.
Numuneler Automill cihazında 140 rpm'de 60 saniye süreyle iki kez, toplam 120 saniye homojenize edilmiştir. Toplam azot analizi FlashSmart CHNS/O Dumas analizörü ile gerçekleştirilmiştir.
Toplam 306 referans ham protein ölçümü yapılmıştır:
- 2023 hasadı: 45 çeşit × 3 teknik tekrar = 135 ölçüm,
- 2024 kışlık buğday: 45 çeşit × 3 teknik tekrar = 135 ölçüm,
- 2024'te seçilen 6 temsili çeşit: 6 çeşit × 6 teknik tekrar = 36 ölçüm.
PLSR Bu Sistemde Neyi Tahmin Ediyor?
PLSR, birbirleriyle yüksek derecede korelasyonlu yüzlerce spektral dalga boyunu daha az sayıda gizli bileşende temsil ederek bu spektral bilgiden referans ham protein değerini tahmin eden regresyon modelidir. Bu özellik, komşu dalga boylarının birbirine güçlü biçimde bağlı olduğu hiperspektral veri için özellikle kullanışlıdır.
VNIR modelinde 204 bandın tamamı, SWIR modelinde ise 288 bandın tamamı kullanılmıştır. Model öncesinde ham spektrumun yanı sıra üç farklı spektral ön işleme yöntemi değerlendirilmiştir:
- SNV — Standard Normal Variate: saçılma ve ölçek farklılıklarını azaltmaya yönelik standartlaştırma yaklaşımı.
- MSC — Multiplicative Scatter Correction: multiplicative ışık saçılması ve benzeri etkileri düzeltmeye yönelik yöntem.
- Savitzky–Golay: spektral gürültüyü azaltmaya ve spektral şekli korumaya yönelik düzgünleştirme/türev yaklaşımı.
Savitzky–Golay için pencere uzunlukları 5, 7, 9 ve 11; polinom dereceleri 2 ve 3; türev dereceleri 1 ve 2; PLS bileşen sayısı ise 1–30 arasında grid search ile değerlendirilmiştir.
Model performans metrikleri
Çalışmada üç temel performans metriği kullanılmıştır.
\[ R^2 = 1 - \frac{\sum_i (y_i-\hat{y}_i)^2} {\sum_i (y_i-\bar{y})^2} \]
Burada \(y_i\) gözlenen ham protein değeri, \(\hat{y}_i\) model tahmini ve \(\bar{y}\) gözlenen değerlerin ortalamasıdır. \(R^2\), modelin veri varyasyonunu ne ölçüde açıkladığını gösterir.
\[ RMSE = \sqrt{ \frac{\sum_i (y_i-\hat{y}_i)^2}{n} } \]
RMSE, tahmin hatalarının karelerinin ortalamasının kareköküdür. Bu nedenle daha düşük RMSE, tahminlerin referans değerlere genel olarak daha yakın olduğunu gösterir.
\[ Q^2 = 1-\frac{PRESS}{SS_{tot}} \]
\[ PRESS=\sum_i (y_i-\hat{y}_{i,-i})^2 \]
\(Q^2\), çapraz doğrulama sırasında görülmeyen örneklere ilişkin tahminlerin ne ölçüde anlamlı olduğunu değerlendirmek için kullanılan tahminsel uygunluk göstergesidir. Çalışmada özellikle SWIR modellerinin Q² değerlerinin bütün ön işleme yöntemlerinde 0,84'ün üzerinde olması model kararlılığının ana kanıtlarından biri olarak kullanılmıştır.
Çalışmanın Yöntemi ve Bulguları
Bitkisel materyal ve örneklem yapısı
Çalışmada Kore'de yetiştirilen 45 buğday çeşidi kullanılmıştır. 2023 hasadında her çeşit için 20 tane ve üç teknik tekrar kullanılarak toplam 2700 tane görüntülenmiştir. 2024 hasadında aynı 45 çeşitten 900 tane ile, Kore'de yaygın olarak yetiştirilen altı temsili çeşitten çeşidi başına 100 tane olacak şekilde ilave 600 tane kullanılmıştır. Böylece 2024 toplamı 1500, bütün çalışma toplamı ise 4200 fiziksel buğday tanesine ulaşmıştır.
Her fiziksel tane VNIR ve SWIR sistemlerinde ayrı ayrı görüntülendiği için 42 VNIR ve 42 SWIR olmak üzere toplam 84 hiperspektral görüntü oluşturulmuş ve analiz sonunda 4200 × 2 = 8400 bireysel spektral tane profili elde edilmiştir.
İki hiperspektral görüntüleme sistemi
| Özellik | VNIR | SWIR |
|---|---|---|
| Kamera | Specim IQ | Specim SWIR |
| Spektral aralık | 397,32–1003,58 nm | 982,08–2576,58 nm |
| Band sayısı | 204 | 288 |
| Yöntemde raporlanan spektral çözünürlük | 7 nm | 12 nm FWHM |
| Yaklaşık kamera mesafesi | 1 m | 1 m |
| Aydınlatma | İki halojen ışık kaynağı | İki halojen ışık kaynağı |
| Beyaz referans | %99,9 yansıtıcı baryum sülfat | Standart cihaz beyaz referans paneli |
SWIR görüntülemede hareketli konveyör kullanılmıştır. Her iki sistemde de ham yoğunluk değerleri beyaz ve karanlık referanslar kullanılarak yansımaya dönüştürülmüştür:
\[ R=\frac{I-D}{W-D} \]
Burada \(R\) kalibre edilmiş yansıma, \(I\) ölçülen ham yoğunluk, \(D\) karanlık akım yoğunluğu ve \(W\) beyaz referans yoğunluğudur. Denklem, sensörün karanlık sinyalini çıkardıktan sonra ölçümü beyaz referans aralığına normalize eder.
YOLOv11 eğitim veri seti nasıl oluşturuldu?
Toplam 84 görüntünün 10'u — 5 VNIR ve 5 SWIR — rastgele seçilerek Labelme ile manuel biçimde etiketlenmiştir. Taneler sınıf 0, beyaz referans ise sınıf 1 olarak tanımlanmış ve başlangıçta 1000 tane etiketi ile 10 beyaz referans etiketi oluşturulmuştur.
Hiperspektral küpler YOLO eğitimi için üç banttan pseudo-RGB görüntülere dönüştürülmüştür. VNIR için 634,11 nm, 560,30 nm ve 452,25 nm; SWIR için ise 1133,52 nm, 1335,78 nm ve 1662,69 nm bantları kullanılmıştır.
Veri artırmada random cropping ve image concatenation uygulanmış ve kaynak çalışmanın raporlamasına göre eğitim veri kümesi özgün veri kümesine göre 110 kat büyütülmüştür.
YOLOv11 eğitim parametreleri
| Parametre | Değer |
|---|---|
| Epoch | 100 |
| Görüntü boyutu | 640 × 640 piksel |
| Batch size | 4–6 |
| Başlangıç öğrenme oranı | 0,01 |
| Momentum | 0,937 |
| Weight decay | 0,0005 |
| IoU doğrulama eşiği | 0,7 |
| Horizontal flip | 0,5 |
| Scale | 0,5 |
| Translation | 0,1 |
| HSV hue | 0,015 |
| HSV saturation | 0,7 |
| HSV value | 0,4 |
| Mosaic | 1,0 |
| Random erasing | 0,4 |
Eğitim iş istasyonu AMD Ryzen 5 3600 işlemci, 32 GB RAM ve NVIDIA RTX 3060 GPU kullanmıştır. Mixed-precision training (AMP) etkinleştirilmiştir.
Veri Artırma YOLO Genellemesini Nasıl Etkiledi?
Veri artırma, modelin aynı buğday tanesi görüntülerinin konum, ölçek ve kırpma değişimlerine karşı dayanıklılığını belirgin biçimde artırmıştır. Ham görüntülerle eğitilen modeller bütün tam boy görüntülerde çok yüksek F1 değerlerine ulaşabilmelerine rağmen cropped doğrulama görüntülerinde recall ve F1 düşmüştür; artırılmış eğitim kümeleri kullanıldığında cropped görüntülerde F1 değerleri yeniden yaklaşık 0,99–1,00 aralığına yükselmiştir.
| Model | Precision | Recall | F1 |
|---|---|---|---|
| IA2 | 0,9735 | 1,0000 | 0,9866 |
| IA4 | 1,0000 | 1,0000 | 1,0000 |
| IA6 | 0,9932 | 1,0000 | 0,9966 |
| IA8 | 0,9932 | 1,0000 | 0,9966 |
| IA10 | 0,9932 | 0,9932 | 0,9932 |
Bu tablo yalnız çalışmanın cropped görüntülerden oluşturduğu doğrulama koşulunu temsil eder. Farklı kamera, kurum veya çevre koşullarındaki genel performans olarak yorumlanmamalıdır.
İşlem hızı
YOLOv11 segmentasyonunun medyan toplam işlem süresi 25,00 ms olarak ölçülmüştür. Aynı karşılaştırmada YOLOv8 için 64,30 ms raporlanmıştır. 25 ms/görüntü değeri teorik olarak yaklaşık 40 görüntü/saniye işlem hızına karşılık gelir ve araştırmacılar bunu yüksek verimli veri işleme açısından önemli bir avantaj olarak değerlendirmiştir.
PLSR eğitim/doğrulama/test stratejisi
2023 ve 2024 spektral verileri birleştirilmiş ve toplam verinin %10'u rastgele bağımsız test seti olarak ayrılmıştır. Kalan %90 üzerinde beş katlı çapraz doğrulama uygulanmış; her fold içinde veri %80 eğitim ve %20 doğrulama biçiminde kullanılmıştır.
VNIR ve SWIR tahmin sonuçları
| Ön işleme | Spektrum | PLS bileşeni | Test R² | Test RMSE | Q² / yorum |
|---|---|---|---|---|---|
| Ham veri | VNIR | 10 | 0,0641 | 2,0260 | Düşük genelleme |
| Ham veri | SWIR | 10 | 0,8693 | 0,7571 | SWIR grubu Q² > 0,84 |
| SNV | VNIR | 9 | 0,5205 | 1,4501 | VNIR sınırlı |
| SNV | SWIR | 7 | 0,8547 | 0,7984 | SWIR grubu Q² > 0,84 |
| MSC | VNIR | 9 | -0,0495 | 2,1455 | Q² = -0,0296 |
| MSC | SWIR | 9 | 0,8725 | 0,7479 | Q² = 0,8738 |
| Savitzky–Golay | VNIR | 8 | 0,5750 | 1,3653 | Q² = 0,5793 |
| Savitzky–Golay | SWIR | 3 | 0,8449 | 0,8247 | Q² = 0,8487 |
Tablo iki farklı “iyi model” kavramını ayırmayı gerektirir. Yalnız en yüksek test R² aranırsa MSC–SWIR kombinasyonu öne çıkar. Buna karşılık model karmaşıklığı da hesaba katılırsa Savitzky–Golay–SWIR modeli yalnız üç PLS bileşeniyle yüksek tahmin gücünü korumuştur. Dolayısıyla çalışmada en yüksek doğruluk ile en sade model aynı konfigürasyon değildir.
Yüksek ve düşük protein gruplarındaki tahminler
Üst ve alt %10'luk protein gruplarında Savitzky–Golay ile ön işlenmiş PLSR modelleri ayrıca karşılaştırılmıştır. Yüksek protein grubunda ölçülen değer 15,030 ± 0,908 %, SWIR tahmini 14,988 ± 1,588 %, VNIR tahmini 15,176 ± 2,664 % olarak raporlanmıştır. Düşük protein grubunda ölçülen değer 11,838 ± 1,02 % iken VNIR 12,254 ± 2,538 %, SWIR 10,845 ± 2,156 % tahmin etmiştir.
Bu tek grup ortalamaları tüm model performansının yerine kullanılmamalıdır. Araştırmacıların SWIR üstünlüğü yorumu, yalnız bu iki grup ortalamasına değil test R², RMSE, Q² ve çapraz doğrulama sonuçlarının bütününe dayanmaktadır.
Çalışmanın desteklediği sonuçlar
- YOLOv11 hiperspektral görüntülerde tek tek buğday tanelerinin otomatik segmentasyonunda yüksek performans sağlayabilmiştir.
- Veri artırma, cropped görüntülerdeki segmentasyon genellemesini belirgin biçimde geliştirmiştir.
- DBSCAN ve Random Forest yaklaşımı, YOLO kutularının içinden spektral ROI seçimini otomatikleştirmiştir.
- SWIR tabanlı PLSR, bu veri kümesinde VNIR tabanlı modellerden daha yüksek ve daha kararlı protein tahmini sağlamıştır.
- MSC–SWIR en yüksek test R² değerini vermiştir.
- Savitzky–Golay–SWIR, yalnız üç PLS bileşeniyle daha basit fakat güçlü bir model oluşturmuştur.
- YOLOv11, çalışmadaki YOLOv8 karşılaştırmasında daha kısa işlem süresi göstermiştir.
Çalışmanın desteklemediği sonuçlar
- Modelin bütün buğday çeşitlerinde ve bütün ülkelerde aynı doğruluğu sağlayacağı gösterilmemiştir.
- Farklı SWIR/VNIR kameralarındaki performans doğrulanmamıştır.
- Kontrolsüz fabrika veya tarla koşullarında aynı sonuçların korunacağı kanıtlanmamıştır.
- Model doğrudan protein molekülünü “görmemektedir”; spektral yansıma ile Dumas referans değeri arasındaki istatistiksel ilişkiyi öğrenmektedir.
- YOLO'nun yüksek F1 değeri, protein regresyonunun aynı doğrulukta olduğu anlamına gelmez.
- VNIR'in genel olarak bütün kimyasal tahmin görevlerinde yetersiz olduğu sonucu çıkarılamaz.
- SWIR üstünlüğü bu çalışma, bu sensörler, bu örnekler ve bu protein tahmini bağlamında değerlendirilmelidir.
Temel sınırlılıklar
Bütün hiperspektral görüntüler aynı Specim SWIR ve Specim IQ kameralarıyla, kontrollü aydınlatma ve standart konumlandırma altında alınmıştır. Araştırmacılar, 84 görüntünün tamamı üzerindeki performans değerlendirmesine eğitim için kullanılan görüntülerin de dahil olduğunu açıkça belirtmektedir. Cropped bölgeler üzerinde ayrıca değerlendirme yapılmış olsa da gerçek çapraz-sistem genellemesi için başka kurumlara, başka cihazlara ve farklı çevresel koşullara ait bağımsız veri kümeleri gereklidir.
Tahıl hiperspektral görüntüleri için büyük ve standartlaştırılmış kamu veri kümelerinin bulunmaması, çalışmanın daha geniş benchmark karşılaştırmaları yapmasını da sınırlandırmıştır.
Kaynak içi sayısal raporlama notu
Kaynak sonuç bölümünde YOLO için “maksimum F1 = 0,9989” ifadesini kullanmaktadır; buna karşın çalışmanın tablolarında farklı veri ve değerlendirme koşulları için R10 = 0,9995, IA10 = 0,9996 ve cropped IA4 = 1,0000 değerleri bulunmaktadır. Bu nedenle performans değerleri hangi tablo ve değerlendirme koşuluna ait olduğu belirtilerek yorumlanmalıdır.
Ayrıca yöntem bölümünde VNIR için 7 nm, SWIR için 12 nm FWHM spektral çözünürlük raporlanırken tartışma kısmında yaklaşık 3,0 nm ve 5,2 nm değerleri yine “spectral resolution” ifadesi altında kullanılmaktadır. Kaynak bu iki değer grubunun optik çözünürlük ile spektral örnekleme aralığı ayrımını açık biçimde tanımlamadığı için burada herhangi biri diğerinin yerine düzeltilmemiştir.
Kaynak ve Yöntem Notu
Özgün çalışma:Assessment of crude protein in wheat kernels using SWIR hyperspectral imaging combined with deep learning-based segmentation
Yazarlar: Jae Gyeong Jung; Jin-Hyun Kim; Changsoo Kim; Donghwan Shim.
Sorumlu yazar: Donghwan Shim.
Kurumlar: Department of Biological Sciences, Chungnam National University; Genomics Division, Department of Agricultural Biotechnology, National Institute of Agricultural Sciences, Rural Development Administration; Department of Crop Science, Chungnam National University, Republic of Korea.
Dergi: Journal of Agriculture and Food Research.
Cilt / makale numarası: 26 (2026), 102679.
DOI: 10.1016/j.jafr.2026.102679
Yayınevi: Elsevier B.V.
Alınma tarihi: 20 Ağustos 2025.
Revizyon: 8 Ocak 2026.
Kabul tarihi: 14 Ocak 2026.
Çevrimiçi yayın: 17 Ocak 2026.
Lisans: Creative Commons Attribution–NonCommercial 4.0 International (CC BY-NC 4.0).
Finansman: Rural Development Administration, Republic of Korea, Cooperative Research Program for Agricultural Science and Technology Development No. RS-2025-00512183; ayrıca Institute of Information & Communications Technology Planning & Evaluation (IITP), Korea government (MSIT), No. RS-2022-00155857, Artificial Intelligence Convergence Innovation Human Resources Development, Chungnam National University.
Çıkar çatışması: Yazarlar çalışmayı etkileyebilecek bilinen finansal çıkar veya kişisel ilişki bildirmemiştir.
Veri erişilebilirliği: Verilerin talep üzerine sağlanacağı belirtilmiştir.
Bilimsel sınır: Sonuçlar kontrollü laboratuvar hiperspektral görüntüleme koşullarına aittir. Farklı sensörler, bağımsız kurum veri kümeleri ve değişken çevresel koşullar üzerinde dış doğrulama yapılmamıştır. Çalışmanın güçlü sonucu, mevcut standartlaştırılmış düzenek içinde SWIR + YOLOv11 + spektral ROI + PLSR mimarisinin yüksek verimli ham protein tahmini için uygulanabilirliğidir; evrensel cihazlar-arası saha performansı değildir.
Verianla anlatım ilkesi: Bu içerik özgün akademik makalenin tam metin çevirisi değildir. Deney tasarımı, matematiksel metrikler, cihaz koşulları, raporlanan performans değerleri ve yöntemsel sınırlılıklar kaynağa sadık tutulmuş; anlatım bağımsız bir bilimsel öğrenme yapısında yeniden kurulmuştur. Akademik atıf ve kaynak şekillerin özgün bağlamı için DOI üzerinden yayımlanmış çalışma incelenmelidir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir