

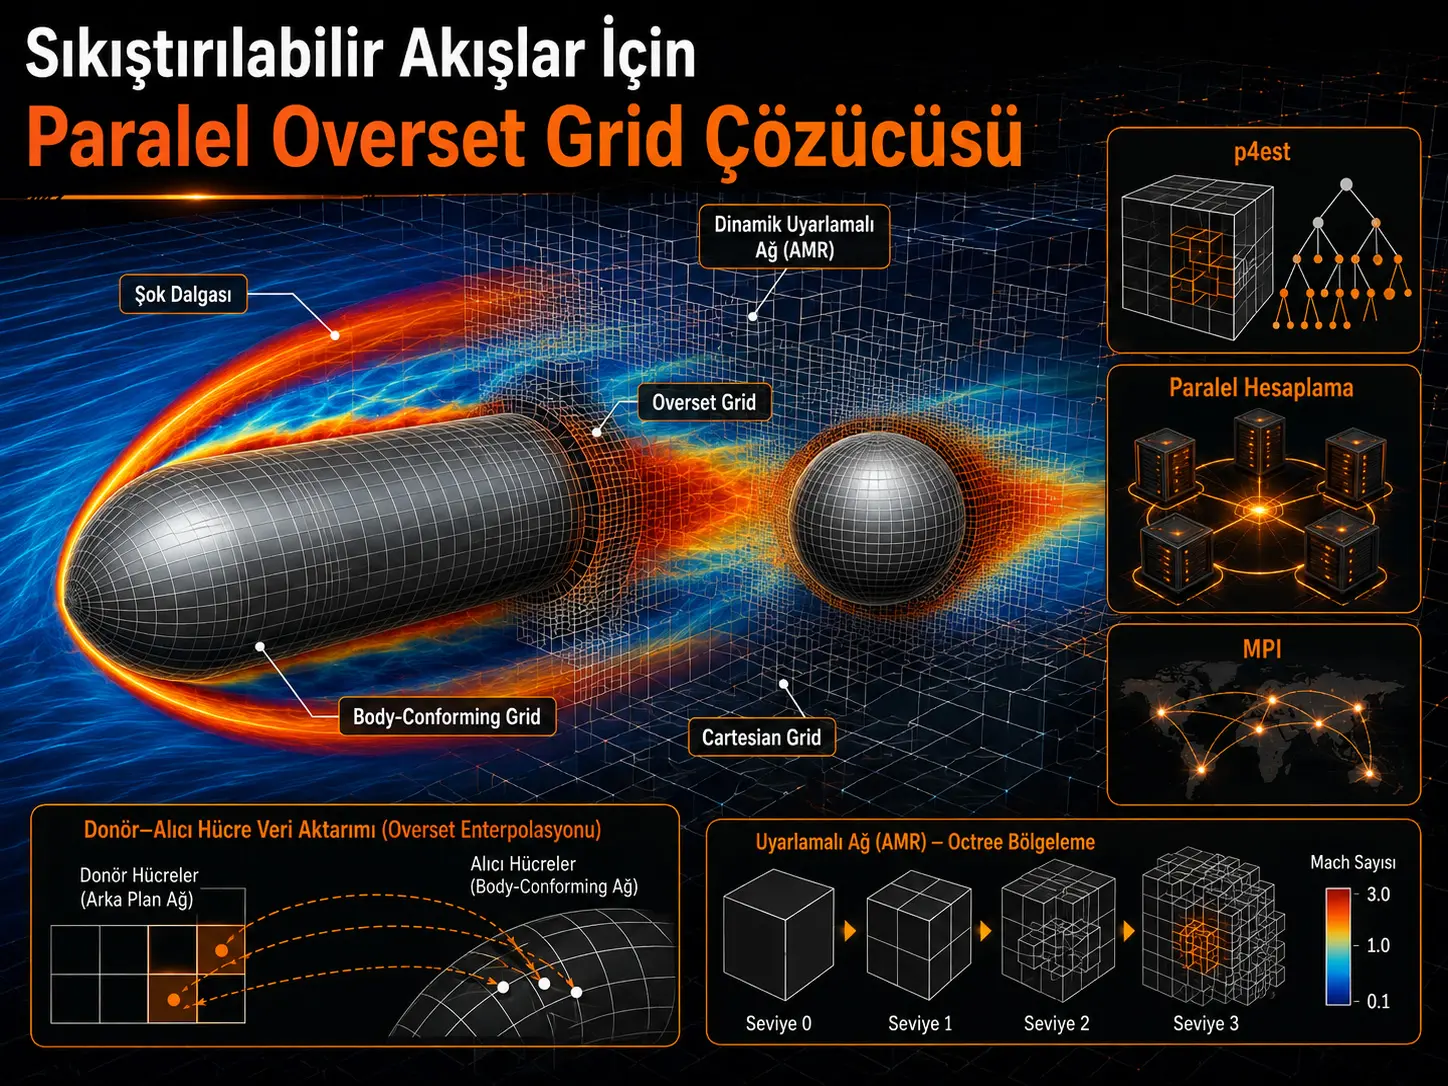
Bu araştırma, üç boyutlu sıkıştırılabilir akış problemlerini çözmek için paralel çalışan, sonlu hacim tabanlı ve dinamik Adaptive Mesh Refinement (AMR) yeteneğine sahip bir Navier–Stokes çözücüsü geliştirmektedir. Yöntem iki farklı ağ yapısını bir araya getirmektedir: geometrinin yüzeyini izleyen body-conforming grid ve akış alanının geri kalanında dinamik olarak inceltilip kabalaştırılabilen Cartesian off-body grid. Adaptif Cartesian ağın oluşturulması, partition işlemleri ve yük dengelenmesi açık kaynaklı p4est octree kütüphanesiyle gerçekleştirilmektedir.
Çalışmanın başlıca yazılım yeniliği, akış alanı verilerinin p4est'in kendi node veri alanından ayrılmasıdır. Klasik yapıda yoğunluk, hız, sıcaklık, türbülans değişkenleri, gradyanlar ve MUSCL limiter bilgileri p4est node'larıyla birlikte taşınırken önerilen mimaride p4est içinde yalnız bir adres işaretçisi ve MPI rank bilgisi tutulmaktadır. Gerçek akış alanı ayrı bir veri yapısında saklanmaktadır. Böylece ağ yeniden bölümlendiğinde yeniden hesaplanabilecek veya artık geçerliliğini yitirmiş bütün verilerin MPI üzerinden taşınmasına gerek kalmamakta; yalnız temel akış değişkenlerinin aktarılması yeterli olmaktadır.
Geliştirilen çözücü iki üç boyutlu benchmark probleminde test edilmiştir. Mach 2 hızındaki akışın yarı sonsuz kör burunlu bir silindir üzerinden geçtiği kararlı durumda sayısal yüzey basınç katsayısı deneysel sonuçlarla genel olarak uyum göstermiş ve adaptif ağ bow shock bölgesinde otomatik olarak yoğunlaşmıştır. İkinci testte Mach 2,89'luk düzlemsel bir şok dalgasının durağan havadaki küreyle etkileşimi modellenmiş; yansıyan şok, triple point, difrakte şok ve wake vorteksi dinamik ağ uyarlamasıyla izlenebilmiştir.
Paralel performans deneyinde kararlı overset çözüm 32 MPI rank'ta %89,7, 64 rank'ta %80 ve 128 rank'ta %65 paralel verim göstermiştir. Dinamik küre–şok probleminde flow solver ile AMR birlikte değerlendirildiğinde 128 MPI rank'taki paralel verim %61 olarak raporlanmıştır. Önerilen dağıtık yaklaşım, önceki master–slave uygulamasına kıyasla 32 MPI rank'ta toplam çözücü paralel veriminde %50 artış sağlamıştır. Bununla birlikte 128 rank'a çıkıldığında özellikle az sayıdaki donor–receiver hücresinin rank'lar arasında eşitsiz dağılımı nedeniyle interpolation ve overset grid assembly aşamalarında verim düşmektedir.
Türkiye açısından: Çalışma doğrudan İstanbul Teknik Üniversitesi'nde geliştirilen bir CFD çözücüsüne dayanmaktadır. Bu nedenle Türkiye açısından yalnız yabancı bir yöntemin uygulanması değil, üç boyutlu sıkıştırılabilir akış, dinamik AMR, overset grid ve paralel MPI hesaplama bileşenlerinin aynı kurum içi çözücüde birleştirilmesine ilişkin somut bir sayısal yöntem geliştirme örneğidir. Bununla birlikte makale iki benchmark ve tek HPC düğümü üzerinde doğrulama sunmaktadır; gerçek uçak geometrileri, çok düğümlü süperbilgisayar ölçeklenmesi veya endüstriyel doğrulama bu çalışma tarafından test edilmemiştir.
Overset grid ve Adaptive Mesh Refinement neden birlikte kullanılıyor?
Temel amaç, bütün hesaplama alanını sürekli olarak çok ince bir ağla çözmek yerine yüksek çözünürlüğü yalnız fiziksel olarak gerekli bölgelerde kullanmaktır. Şok dalgaları, güçlü gradyanlar ve ayrılma bölgeleri gibi alanlarda hücre boyutu küçültülürken uzak alanlarda daha kaba ağ kullanılabilir. Böylece aynı fiziksel olayı daha düşük toplam hücre sayısıyla çözmek mümkün hale gelir.
Overset yaklaşımı bu adaptasyonu geometriden ayırmaktadır. Geometrinin yüzeyini ve sınır tabakasını body-conforming grid çözerken, geometriden uzaktaki akış off-body Cartesian grid üzerinde hesaplanır. İki ağ birbirinin üzerine bindirilir ve kesişim bölgelerindeki receiver hücreler için diğer ağdaki donor hücrelerden interpolasyon yapılır.
Bu yapı özellikle üç boyutlu hareketli veya güçlü şok yapılarının bulunduğu problemlerde avantajlıdır; çünkü Cartesian off-body grid'in refine/coarsen işlemleri doğrudan karmaşık yüzey geometrisini yeniden üretmek zorunda değildir.
Hangi akış denklemleri çözülüyor?
İki benchmark da üç boyutlu sıkıştırılabilir Navier–Stokes denklemleriyle modellenmiştir. Kararlı kör burunlu cisim problemi türbülanslı olduğundan Reynolds-Averaged Navier–Stokes (RANS) formülasyonu, geçici küre–şok problemi ise laminer formülasyon kullanmaktadır.
Kütlenin korunumu:
\[ \frac{\partial \rho}{\partial t} + \frac{\partial \rho u_j}{\partial x_j} =0 \]
Momentumun korunumu:
\[ \frac{\partial \rho u_i}{\partial t} + \frac{\partial \rho u_i u_j}{\partial x_j} = -\frac{\partial p}{\partial x_i} + \frac{\partial \tau_{ij}}{\partial x_j} \]
Toplam enerjinin korunumu:
\[ \frac{\partial \rho e_t}{\partial t} + \frac{\partial \rho e_t u_j}{\partial x_j} = -\frac{\partial p u_j}{\partial x_j} + \frac{\partial}{\partial x_j} \left( k\frac{\partial T}{\partial x_j} \right) + \frac{\partial u_i\tau_{ij}}{\partial x_j} \]
Kararlı benchmark'ta Reynolds gerilmelerini modellemek için k–ω SST 2003 türbülans modeli kullanılmıştır. Gaz kalorik olarak mükemmel kabul edilmiştir. Kararlı durumda viskozitenin sıcaklık değişimi Sutherland yasasıyla modellenirken geçici benchmark'ta dinamik viskozite sıcaklıktan bağımsız sabit alınmıştır.
Sayısal akılar nasıl hesaplanıyor?
Denklemler sonlu hacim yöntemiyle ayrıklaştırılmıştır. Bir hücrenin yarı-ayrık denklemi kaynakta şu genel biçimde verilmektedir:
\[ \frac{\partial W_i}{\partial t} = \frac{1}{V_i} \sum_{j=1}^{J} \left(F_{v,ij}-F_{c,ij}\right)S_{ij} + Q_i \]
Konvektif akılarda AUSM+up şeması kullanılmış, ikinci mertebe uzaysal doğruluk için MUSCL rekonstrüksiyonu uygulanmıştır. Şok gibi süreksizliklerin yakınında salınımları baskılamak amacıyla Venkatakrishnan slope limiter kullanılmıştır. Diffusive flux'lar ikinci mertebe merkezi fark yaklaşımıyla hesaplanmış, zaman integrasyonu birinci mertebe explicit Euler yöntemiyle yapılmıştır.
Kararlı çözümde her hücre için zaman adımı sabit Courant sayısına göre yerel olarak belirlenirken, transient problemlerde bütün hücreler için kullanılan zaman adımı Courant koşulundan elde edilen minimum değer olarak seçilmiştir.
Off-body ve body-conforming ağlar nasıl birleşiyor?
Off-body Cartesian grid, farklı refinement seviyelerinde sabit sayıda hücre içeren bloklardan oluşmaktadır. Komşu iki grid bloğunun refinement seviyeleri arasındaki maksimum fark 1 olarak tutulmaktadır; başka bir ifadeyle 2:1 balance koşulu korunmaktadır.
Farklı refinement seviyelerindeki Cartesian hücrelerin ortak yüzeyinde klasik overset interpolation yerine hanging-cell yaklaşımı kullanılmaktadır. Bir kaba hücrenin yüzey akısı, komşu ince hücrelerin akılarının toplamıyla hesaplanmaktadır:
\[ F_i=\sum_{j=1}^{4}F_j \]
Body-conforming ve Cartesian ağların birbirini örttüğü bölgede ise donor–receiver ilişkisi kullanılmaktadır. Receiver hücresindeki bir akış özelliği inverse-distance interpolasyonuyla:
\[ \phi_i= \frac{\sum_{j=1}^{J}w_j\phi_j} {\sum_{j=1}^{J}w_j} \]
ve ağırlık:
\[ w_j= \frac{1} {|x_{c,j}-x_{c,i}|} \]
olarak hesaplanmaktadır.
p4est bu sistemde ne yapıyor?
p4est, octree koleksiyonlarını yani bir “forest of octrees” yapısını paralel olarak yöneten açık kaynaklı bir kütüphanedir. Çalışmada her octree node'u fiziksel olarak bir Cartesian grid bloğuna karşılık gelmektedir. Node'lar Morton veya Z-order space-filling curve boyunca sıralanmaktadır.
Bu yapı p4est'in:
- grid refinement ve coarsening,
- 2:1 balance,
- partitioning,
- ghost-layer oluşturma,
- MPI rank'lar arasında grid bloklarının dağıtılması
işlemlerini gerçekleştirmesine olanak vermektedir.
Çalışmadaki p4est kullanımı tamamen CPU ve MPI tabanlıdır. GPU veya başka bir accelerator'a device offloading uygulanmamıştır.
Önceki bellek mimarisinin sorunu neydi?
p4est'in klasik kullanıcı veri modelinde her node için kullanıcı tarafından belirlenen boyutta bir veri bloğu p4est tarafından allocate edilip yönetilir. CFD çözücüsünde bu blok yalnız yoğunluk veya hız gibi birkaç sayı içermez; bütün grid bloğunun akış verilerini taşıması gerekir.
Kaynak üç veri grubunu ayırmaktadır:
- Gp: temel akış özellikleri \([\rho,u,v,w,T,k,\omega]\),
- Gs: viskozite, basınç ve akış gradyanları gibi ikincil özellikler,
- Gl: MUSCL limiter terimleri.
Klasik yapıda bu veri gruplarının tamamının p4est node'uyla birlikte saklanması ve partition sırasında taşınması gerekir. Oysa Gs'nin önemli bir bölümü Gp'den yeniden hesaplanabilir; ayrıca gradyanlar ve limiter değerleri grid migration aşamasında bir önceki iterasyona ait olduklarından yeni iterasyonda zaten yeniden üretilecektir.
Önerilen ayrıştırılmış veri yapısı nasıl çalışıyor?
Araştırmacılar akış verilerini p4est'in allocation alanından çıkararak ayrı bir q veri yapısında tutmaktadır. p4est node'unun kullanıcı alanında ise yalnız:
- akış verisinin bellekteki adresini gösteren pointer,
- node'un ait olduğu MPI rank
saklanmaktadır.
Bu küçük değişiklik iki önemli problemi çözmektedir.
Coarsen–balance sırasında veri kaybının önlenmesi
Klasik p4est akışında bir grup node coarsen edildiğinde çocuk hücrelerin akış özellikleri parent hücrede hacim ağırlıklı ortalamayla birleştirilmektedir:
\[ \phi_i= \sum_{j=1}^{J} \left( \frac{\phi_j V_j}{V_i} \right) \]
Fakat ortaya çıkan parent node 2:1 balance koşulunu bozuyorsa sonraki p4est_balance çağrısı bu node'u tekrar refine edebilir. Bu durumda önce çocuklardan parent'a ortalanmış veri daha sonra yeniden çocuklara dağıtılmış olur ve özgün yüksek çözünürlüklü bilgi kaybolur.
Önerilen yapıda akış alanı p4est'in node allocation'ından ayrı olduğundan coarsen işlemi sırasında çocukların gerçek verileri hemen yok edilmez. Eğer balance işlemi coarsen'ı geri alırsa eski veriler yeniden oluşturulan çocuk node'lara bağlanır. Yalnız coarsen sonucu gerçekten kalıcı hale gelirse maskelenmiş çocuk verileri serbest bırakılır.
Load balancing sırasında gereksiz MPI trafiğinin azaltılması
p4est_partition ağ bloklarını MPI rank'lar arasında yeniden dağıttığında klasik yaklaşım node'un bütün kullanıcı verisini taşır. Araştırmacılar ise yalnız Gp grubunun yeni MPI rank'a gönderilmesini sağlamaktadır. Gs ve Gl yeni çözüm çevriminde tekrar oluşturulur.
Böylece partition aşaması iki iletişim adımına ayrılsa da toplam taşınan veri miktarı azaltılmaktadır. Çalışmanın iddiası, bu yaklaşımın iletişim süresini ve toplam solver runtime'ını düşürmesidir.
Dinamik ağ değişince overset bağlantıları neden yeniden kuruluyor?
Cartesian grid refine veya coarsen edildiğinde mevcut donor–receiver hücre çiftleri geçerliliğini kaybedebilir. Load balancing sonrasında grid bloklarının MPI rank sahipliği de değişir. Bu nedenle her AMR çağrısından sonra overset grid assembly tekrar yapılmak zorundadır.
Önceki master–slave yaklaşımında receiver geometrileri merkezi bir MPI rank'a gönderiliyor, master rank bütün body-conforming grid bilgisini tutuyor ve donor aramasını tek noktada gerçekleştiriyordu. Bu hem bellek tüketimini artırıyor hem de MPI rank sayısı yükseldikçe merkezi darboğaz oluşturuyordu.
Yeni yöntemde grid assembly tamamen dağıtık hale getirilmektedir.
Bounding box yaklaşımı iletişimi nasıl sınırlandırıyor?
Her Cartesian ve body-conforming grid partition, minimum ve maksimum koordinatlarını içeren bir bounding box ile temsil edilmektedir. Receiver hücrelerin bounding box'ları MPI rank'lara duyurulmakta ve yalnız kesişen partition'lar arasında ayrıntılı geometri bilgisi değiştirilmektedir.
İki partition'ın belirli bir koordinat yönünde kesişmesi:
\[ x_{A,max}\geq x_{B,min} \quad\land\quad x_{A,min}\leq x_{B,max} \]
koşuluyla sınanmaktadır.
Böylece bir rank'ın bütün grid hücrelerini bütün diğer rank'lara göndermesine gerek kalmaz.
Body-conforming grid donor araması nasıl hızlandırılıyor?
Body-conforming grid için Alternating Digital Tree (ADT) oluşturulmaktadır. Her hücre bir tree node'u olarak temsil edilir ve bounding box koordinatlarına göre binary tree yapısına yerleştirilir.
Receiver hücre için donor aranırken ağacın kökünden başlanır. Bounding box'ların kesişmediği durumda koordinat karşılaştırması yardımıyla ağacın bir kolu tamamen elenir. Kesişme varsa hücre aday donor listesine eklenir ve arama alt dallarda devam eder. Sonuçta centroid'i receiver hücreye en yakın aday donor olarak seçilir ve interpolation stencil için çevresindeki komşular da kullanılır.
Body-conforming grid önceden partition edildiği ve çözüm sırasında geometrisi değişmediği için ADT çözüm başında yalnız bir kez oluşturulup bellekte tutulabilmektedir.
Cartesian donor aramasında Morton kodu nasıl kullanılıyor?
Cartesian grid zaten p4est octree forest tarafından yönetildiğinden ayrı bir spatial tree oluşturulmasına gerek yoktur. Receiver hücrenin koordinatları en yüksek refinement seviyesine göre bit dizisine dönüştürülmekte ve üç boyutta bu bitler bir Morton kodunda birleştirilmektedir.
Morton kodunun ilgili bit grupları sırayla okunarak octree içinde hangi child node'a gidileceği belirlenmekte ve yaprak node'a ulaşıldığında receiver noktasını kapsayan Cartesian grid bloğu bulunmuş olmaktadır.
Bu sistem donor araması için p4est'in zaten mevcut olan uzamsal veri yapısını ikinci kez kullanmaktadır.
İlk benchmark nasıl kuruldu?
İlk doğrulama problemi, Mach 2 serbest akışın yarı sonsuz kör burunlu bir silindir üzerinden geçtiği kararlı ve türbülanslı sıkıştırılabilir akıştır.
| Serbest akış parametresi | Kaynakta kullanılan değer |
|---|---|
| Mach sayısı | 2 |
| Reynolds sayısı | 353.100 |
| Sıcaklık | 242,3 K |
| Türbülans yoğunluğu | %0,05 |
Problem eksensimetrik olmasına rağmen çözücünün üç boyutlu performansını göstermek amacıyla hesaplama alanının dörtte biri üç boyutlu olarak modellenmiştir.
Cartesian grid 3 × 3 × 3 octree forest ile başlatılmış ve her node 2 × 2 × 2 hücrelik grid bloğunu temsil etmiştir. Maksimum refinement seviyesi 5'tir. Refinement kriteri Mach gradyanıdır ve eşik değerleri:
\[ Q_{lower}=0.185, \qquad Q_{upper}=0.218 \]
olarak kullanılmıştır. Body-conforming grid'in ilk duvar hücresi yaklaşık \(y^+=5\) olacak şekilde kurulmuş ve yakınsama kriteri cumulative residual relative error için %0,01 olarak belirlenmiştir.
Ağ yakınsama çalışmasında kaç hücre kullanıldı?
Üç ağ seviyesi karşılaştırılmıştır:
| Ağ çözünürlüğü | Maksimum refinement seviyesi | Kararlı durumdaki hücre sayısı |
|---|---|---|
| Kaba | 4 | 334.627 |
| Orta — ana çözüm | 5 | 1.419.996 |
| İnce | 6 | 3.697.852 |
Basınç katsayısı eğrilerinin karşılaştırılması, orta ağın problem için yeterli olduğunu göstermiştir. Araştırmacılar bu nedenle performans analizlerinde yaklaşık 1,42 milyon hücrelik orta ağı kullanmıştır.
Kör burunlu cisim sonucu deneyle uyuşuyor mu?
Genel olarak evet. Sayısal \(C_p\) dağılımı referans deneysel sonuçlarla iyi uyum göstermiştir. Bununla birlikte stagnation point bölgesinde \(s/D=0\) ve cismin uç tabanına yakın \(s/D>0.8\) bölgesinde çözüm deneysel değerleri bir miktar düşük tahmin etmektedir.
Çalışmanın karşılaştırmasına göre geliştirilen çözücünün sonucu, aynı grafikte verilen önceki scFLOW sayısal sonucundan deneysel veriye daha yakın görünmektedir. Bu karşılaştırma yalnız bu benchmark ve kullanılan koşullar için geçerlidir; genel bir CFD yazılım üstünlüğü anlamına gelmez.
Numerical schlieren ve Mach contour görsellerinde adaptif Cartesian grid'in bow shock çizgisi boyunca en yüksek refinement seviyesine geçtiği görülmektedir. Böylece uzak bölgelerde gereksiz ince ağ kullanılmadan şok süreksizliği yüksek çözünürlükte tutulmaktadır.
Kararlı benchmark paralel olarak nasıl ölçeklendi?
Strong-scaling deneyinde 1.419.996 hücrelik grid sabit tutulmuş ve MPI rank sayısı kademeli olarak artırılmıştır. Bu ağdaki receiver hücre sayısı 34.970'tir. Her rank sayısı için 100 çözüm iterasyonunun wall-clock süresi ölçülmüştür.
Speed-up:
\[ S_f=\frac{T_1}{T_N} \]
ve paralel verim:
\[ \eta=\frac{S_f}{N}\times100 \]
olarak tanımlanmıştır.
Verianla Live: Overset çözücünün MPI rank sayısına göre paralel verimi
Aşağıdaki değerler kararlı Mach 2 kör burunlu cisim benchmark'ında yaklaşık 1,42 milyon hücre sabit tutulurken ölçülen overset-grid çözücü paralel verimidir. Bunlar weak-scaling değil, strong-scaling sonuçlarıdır.
| MPI rank sayısı | Paralel verim (%) | Test türü | Kaynak |
|---|---|---|---|
| 32 | 89,7 | Strong scaling — overset solver | Şekil 12 ve sonuç metni |
| 64 | 80 | Strong scaling — overset solver | Şekil 12 ve sonuç metni |
| 128 | 65 | Strong scaling — overset solver | Şekil 12 ve sonuç metni |
Verianla Live kaynak notu: Görselleştirme bu görünür bilimsel veri tablosundan oluşturulur. Tablo bilimsel kaynak-of-truth olarak korunur.
Solver 32 MPI rank'a kadar güçlü ölçeklenme göstermiştir. 32 rank'taki paralel verim %89,7 iken 64 rank'ta %80'e ve 128 rank'ta %65'e düşmektedir. 128 rank'ta overset çözüm ile aynı hücre sayısına sahip tek-grid referansı arasındaki paralel performans farkı en fazla yaklaşık %7 olarak raporlanmıştır.
Interpolation neden toplam solver'dan daha kötü ölçekleniyor?
Interpolation için yapılan hesaplama donor–receiver hücreleriyle sınırlıdır. MPI rank sayısı yükseldikçe her rank'a düşen receiver sayısı çok azalmakta ve overlap hücreleri rank'lar arasında eşit dağılmamaktadır.
Interpolation computation segmentinin paralel verimi yaklaşık:
- 32 MPI rank'a kadar %70,
- 64 MPI rank'ta %44,
- 128 MPI rank'ta %30
seviyelerine inmektedir.
Buna karşın interpolation toplam iterasyon maliyetinin yalnız yaklaşık %0,2'sini 1 rank'ta ve %5,11'ini 128 rank'ta oluşturduğu için bu düşük alt-rutin verimi genel solver performansını sınırlı ölçüde etkilemektedir.
Yeni yaklaşım önceki master–slave çözücüden ne kadar daha iyi?
Kaynak, aynı araştırma grubunun önceki master–slave yaklaşımıyla karşılaştırıldığında yeni dağıtık yöntemin 32 MPI rank'ta toplam solver paralel verimini %50 artırdığını bildirmektedir.
Bu sonuç belirli donanım, grid ve benchmark için yapılan karşılaştırmadır. Yeni algoritmanın her problemde veya her HPC mimarisinde tam %50 kazanç sağlayacağı çalışma tarafından gösterilmemiştir.
İkinci benchmark neden daha zor?
İkinci problem kararlı değildir. Mach 2,89 hızında ilerleyen düzlemsel şok dalgası başlangıçta durağan havada bulunan küreye çarpmakta; zaman içinde yansıyan şok, incident shock, triple point, difracted shock ve vortex yapıları oluşmaktadır.
Bu akış yapıları hareket ettiği için ince grid bölgesinin de zaman içinde hareket etmesi gerekir. Dolayısıyla yalnız bir kez refine edilmiş sabit ağ yeterli değildir; AMR çözüm sırasında tekrar tekrar çağrılmaktadır.
Akış Reynolds sayısı 7800 olarak verilmiş ve laminer modellenmiştir. Kullanılan hava için kaynak:
- \(R=287.2\) J/(kg·K),
- \(c_p=1005.2\) J/(kg·K),
- \(\gamma=1.4\)
değerlerini vermektedir.
Küre benchmark'ındaki Region 1 ve Region 2 verileri neden dikkatli okunmalı?
Kaynak metin Region 1'in durağan, Region 2'nin ise post-shock ve sonlu x-yönlü hız içeren bölge olduğunu söylemektedir. Buna karşılık yayımlanan Tablo 2 şu değerleri vermektedir:
| Kaynakta verilen büyüklük | Region 1 | Region 2 |
|---|---|---|
| Yoğunluk — tabloda kg/m³ olarak etiketlenmiş | 5,1432014 | 1,4 |
| Sıcaklık — tabloda K olarak etiketlenmiş | 0,006123676 | 0,002487067 |
| Hız — tabloda m/s olarak etiketlenmiş | 2,0451168 | 0 |
Hız değerleri metinsel Region tanımıyla ters yöndedir: tablo Region 1'i hareketli, Region 2'yi durağan göstermektedir. Ayrıca sıcaklık değerlerinin K etiketiyle 10−3 mertebesinde verilmesi gerçek boyutlu sıcaklıkla bağdaşmayan bir ölçeklendirme/etiket sorunu görünümü taşımaktadır. Kaynak bunu açıklamadığından Verianla bu sayıların birimini veya Region sırasını varsayımla düzeltmemektedir.
Dinamik AMR nasıl yapılandırıldı?
Cartesian grid 10 × 5 × 5 base octree node ile başlatılmış ve her node 2 × 2 × 2 hücrelik grid bloğu içermiştir. Maksimum refinement seviyesi 5'tir. AMR her 25 flow-solver iterasyonunda bir çağrılmıştır.
Refinement kriteri density gradient'tir:
\[ Q_{lower}=0.6, \qquad Q_{upper}=0.625 \]
Body-conforming grid ilk hücresinin yaklaşık \(y^+\approx2.5\) olması sağlanmış ve ağ küre yüzeyinden 2,5D dışarı uzatılmıştır.
Çözüm CFL = 0,7 ile yürütülmüş; global boyutsuz zaman adımı iterasyona göre yaklaşık \(9.2\times10^{-5}\) ile \(1.5\times10^{-4}\) arasında değişmiştir.
Küre benchmark'ındaki hücre sayısında kaynak neden çelişiyor?
Çalışmanın bir bölümünde “initial overset grid system” için 3.241.936 hücre ve 54.294 receiver hücre verilmektedir. Fakat akışın zaman içindeki gelişiminin anlatıldığı sonraki bölümde, \( \bar{t}=1.832 \) anında grid'in 2.232.704 başlangıç hücresinden 3.241.936 hücreye çıktığı yazılmaktadır.
Bu iki ifade aynı “başlangıç” hücre sayısını desteklemediğinden burada kaynak içi tutarsızlık olarak korunmaktadır. Buna karşılık \( \bar{t}=1.832 \) için 3.241.936 hücre değeri iki bağlamda da görünmektedir ve güçlü ölçeklenme testinde yüksek yüklü dinamik durum olarak seçilen ağ budur.
Şok dalgası küre etrafında nasıl gelişti?
Numerical schlieren ve Mach görüntüleri akışın birkaç boyutsuz zaman noktasındaki gelişimini göstermektedir:
- \(\bar{t}=0\): düzlemsel incident shock küre merkezinden yaklaşık 0,6D uzaklıktadır.
- \(\bar{t}\approx0.307\): şok küre yüzeyine ulaştığında reflected shock oluşur.
- \(\bar{t}=0.615\): incident ve reflected shock'un kesişiminde triple point belirginleşir.
- \(\bar{t}=1.832\): diffracted shock ve triple point küre wake bölgesine ilerler ve bir vortex görülür.
Adaptif ağ çizgileri, yüksek refinement seviyesinin hareket eden şok yapılarını takip ettiğini göstermektedir. Araştırmacılar \( \bar{t}=1.832 \) anında reflected shock'un triple point'e bağlandığı bölgede density gradient'in zayıflaması nedeniyle izleme kalitesinde küçük bir kayıp olduğunu da belirtmektedir.
Deneysel schlieren karşılaştırması ne gösterdi?
Numerical schlieren görüntüsü klasik Bryson ve Gross deneysel görüntüsüyle karşılaştırılmıştır. Reflected shock, triple point ve transmitted shock konumlarının genel olarak deneyle iyi uyuştuğu raporlanmıştır.
Reflected shock standoff distance açısından küçük bir fark bulunmaktadır. Yazarlar bu farkın deneysel görüntüde görülen deformasyonlar nedeniyle görüntüleme artefaktlarından kaynaklanabileceğini önermektedir. Bu açıklama yazar yorumudur; çalışma bu farkın nedenini ayrıca deneysel olarak test etmemiştir.
Bir dinamik AMR çağrısında hangi işlemler gerçekleşiyor?
Çalışmada AMR süreci beş ardışık segmente ayrılmaktadır:
- Cell flagging: hücreler sensor function ile değerlendirilip refine/coarsen için işaretlenir.
- Grid adaptation: işaretlenen bloklar refine veya coarsen edilir.
- Load balancing: grid blokları MPI rank'lar arasında yeniden dağıtılır ve ghost layer'lar oluşturulur.
- Connectivities: komşu hücre bağlantıları yeniden kurulur ve cache edilir.
- Grid assembly: overset donor–receiver çiftleri, interpolation katsayıları ve communication tabloları yeniden oluşturulur.
Dinamik problemde bu beş aşamanın tamamı her 25 solver iterasyonunda bir tekrar edilmektedir.
AMR'nin hesaplama maliyeti ne kadar?
AMR işlemi bütün MPI rank sayılarında tek bir flow-solver iterasyonundan daha kısa sürmektedir; ancak aynı mertebededir. AMR yalnız her 25 iterasyonda bir çalıştığı için toplam etkisi seyrekleştirilir.
128 MPI rank'ta bir AMR çağrısının süresi, iki AMR arasında geçen 25 flow-solver iterasyonunun toplam süresinin yaklaşık %8'i olarak raporlanmıştır.
AMR'nin en pahalı parçası overset grid assembly'dir. İncelenen rank sayılarında grid assembly AMR süresinin en az %53'ünü oluşturmaktadır.
Dinamik problem 128 MPI rank'ta nasıl ölçeklendi?
AMR sürecinin tek başına scaling performansı solver kadar güçlü değildir. Bunun başlıca nedeni donor/receiver sorgularının ve overlap bölgelerinin MPI rank'lar arasında eşit dağılmamasıdır.
Buna rağmen AMR'nin yalnız 25 iterasyonda bir çağrılması nedeniyle bütün flow solver + AMR sistemi yüksek rank sayılarında daha iyi davranmaktadır. Çalışma dinamik benchmark için 128 MPI rank'ta yaklaşık %61 paralel verim raporlamaktadır.
Sonuç bölümünde AMR ve overset-grid-assembly aşamalarının 64 MPI rank'ta yaklaşık %42 paralel verime ulaştığı belirtilmektedir.
Load balancing gerçekten işe yarıyor mu?
Evet; kullanılan benchmark'ta ölçülebilir bir kazanç bulunmaktadır. Araştırmacılar 32 MPI rank için aynı dinamik grid durumunu load balancing açık ve kapalı biçimde karşılaştırmıştır.
Load-balanced durumda rank'ların normalize CPU workload dağılımı daha homojen hale gelmiştir. Kaynak, MPI rank'larda en az %17,4 workload azalması raporlamaktadır.
Ghost-layer ve inter-grid communication dahil wall-clock süre üzerinden bakıldığında load-balanced solver iterasyonu, load balancing uygulanmayan iterasyondan %10,1 daha kısa sürmüştür.
Bu ölçüm tek bir adaptation sonrası durum içindir. Yazarlar, gerçek çözümde AMR birçok kez çağrıldığından kazancın çözüm boyunca birikebileceğini belirtmektedir.
Çalışmanın desteklediği sonuçlar
- p4est ile üç boyutlu block-based Cartesian AMR, body-conforming overset grid ile aynı sıkıştırılabilir CFD çözücüsünde birleştirilebilmiştir.
- Akış verilerini p4est node allocation'ından ayıran mimari gereksiz veri migration'ını azaltmakta ve coarsen–balance sırasında akış bilgisinin gereksiz kaybını önlemektedir.
- Distributed bounding-box, ADT ve octree arama yapılarıyla merkezi master rank gerektirmeyen overset reassembly uygulanabilmiştir.
- Mach 2 kör burunlu cisim benchmark'ında hesaplanan yüzey basınç katsayısı genel olarak deneysel veriyle uyumludur.
- Adaptive grid bow shock çevresinde yüksek refinement seviyesine geçmiştir.
- Küre–şok benchmark'ında reflected shock, triple point, diffracted/transmitted shock ve vortex yapıları sayısal olarak yakalanabilmiştir.
- Kararlı benchmark'ta overset solver 128 MPI rank'ta %65 paralel verim göstermiştir.
- Dinamik solver + AMR sistemi 128 MPI rank'ta yaklaşık %61 paralel verim göstermiştir.
- 32 MPI rank'taki load balancing deneyi wall-clock iteration süresinde %10,1 azalma sağlamıştır.
- Yeni dağıtık yaklaşım önceki master–slave sürüme göre 32 MPI rank'ta toplam paralel verimde %50 artış sağlamıştır.
Çalışmanın desteklemediği veya test etmediği sonuçlar
- Çözücünün bütün sıkıştırılabilir CFD problemlerinde aynı doğruluk veya scaling performansını vereceği gösterilmemiştir.
- Çalışmada GPU veya accelerator offloading test edilmemiştir.
- 128 çekirdeğin ötesinde veya birden fazla HPC node üzerinde scaling testi yapılmamıştır.
- Gerçek uçak, füze, roket veya turbomakine geometrisinde endüstriyel validasyon yapılmamıştır.
- Kör burunlu cisim benchmark'ında stagnation ve tip-base bölgelerindeki deneysel fark tamamen ortadan kaldırılmamıştır.
- Küre benchmark'ında bütün şok yapıları kusursuz biçimde izlenmemiş; \( \bar{t}=1.832 \) civarında zayıflayan density gradient nedeniyle küçük tracking kaybı görülmüştür.
- Overset grid assembly'nin yüksek MPI rank'larda ideal biçimde load-balanced olduğu gösterilmemiştir.
- Kaynakta Region 1/Region 2 başlangıç durumları ile hücre başlangıç sayısındaki iç tutarsızlıklar çözülmemiştir.
- Tek düğümde elde edilen %65 veya %61 paralel verim, çok düğümlü süperbilgisayar ortamına doğrudan genellenemez.
Çalışmanın Yöntemi ve Bulguları
Sayısal çözücü mimarisi
Geliştirilen yazılım üç boyutlu density-based finite-volume sıkıştırılabilir Navier–Stokes çözücüsüdür. Kararlı türbülanslı problemde k–ω SST 2003 modeli kullanılmıştır. Konvektif akılarda AUSM+up, ikinci mertebe rekonstrüksiyonda MUSCL ve süreksizlik yakınında Venkatakrishnan limiter uygulanmıştır. Diffusive terimler ikinci mertebe merkezi yöntemle, zaman integrasyonu explicit Euler ile hesaplanmıştır.
Grid mimarisi iki bileşenden oluşur:
- geometriyi ve yakın duvar akışını çözen önceden partition edilmiş structured body-conforming grid,
- p4est octree forest tarafından yönetilen block-based adaptive Cartesian off-body grid.
Refinement ve coarsening kriteri
Her Cartesian grid bloğunda seçilen akış parametresi \(Q\), alt ve üst eşiklerle karşılaştırılmaktadır:
- \(Q>Q_{upper}\) ise refine,
- \(Q<Q_{lower}\) ise coarsen
işlemi uygulanmaktadır.
p4est tarafında grid adaptation sırası:
p4est_refinep4est_balancep4est_coarsenp4est_balance
biçimindedir. İkinci balance çağrısı coarsen sonrasında 2:1 balance koşulunu yeniden sağlamak için gereklidir.
Önerilen veri mimarisinin computational mantığı
Önerilen veri yapısında p4est yalnız grid topology ve partition ownership bilgisiyle ilgilenirken fiziksel çözüm vektörleri solver tarafından ayrı bellekte tutulmaktadır.
Load balancing sırasında yalnız:
\[ G_p=[\rho,u,v,w,T,k,\omega] \]
temel veri grubunun aktarılması yeterli kabul edilmiştir. Basınç, viskozite ve türevlenebilir secondary değerler yeniden hesaplanmakta; gradyan ve MUSCL limiter değerleri yeni solver cycle sırasında yeniden oluşturulmaktadır.
Bu yaklaşım özellikle MPI rank sayısı yükseldiğinde iletişim hacmini düşürmeyi amaçlamaktadır.
Overset reassembly algoritması
Dinamik grid değişiminden sonra receiver–donor ilişkisinin yeniden kurulması üç aşamada düşünülebilir:
- Partition bounding box'ları kullanılarak hangi MPI rank'ların geometrik olarak etkileşebileceği belirlenir.
- Body-conforming grid donor adayları ADT, Cartesian donor adayları ise p4est octree/Morton yapısıyla aranır.
- Donor–receiver çiftleri belirlendikten sonra interpolation katsayıları ve inter-grid MPI communication tabloları oluşturulur.
Bu yöntem master rank üzerinde bütün body-conforming grid'in kopyasını bulundurma gereksinimini kaldırmaktadır.
Kararlı benchmark'ın temel sayısal sonuçları
| Ölçülen veya kullanılan büyüklük | Sonuç |
|---|---|
| Mach sayısı | 2 |
| Reynolds sayısı | 353.100 |
| Ana grid hücre sayısı | 1.419.996 |
| Receiver hücre sayısı | 34.970 |
| 32 MPI rank paralel verimi | %89,7 |
| 64 MPI rank paralel verimi | %80 |
| 128 MPI rank paralel verimi | %65 |
| 128 rank'ta single-grid'e göre performans farkı | En fazla yaklaşık %7 |
Bu benchmark, çözücünün hem sayısal doğruluğunu hem de sabit problem boyutunda MPI rank sayısı arttıkça strong-scaling davranışını sınamaktadır.
Dinamik benchmark'ın temel sayısal sonuçları
| Ölçülen veya kullanılan büyüklük | Kaynakta verilen sonuç |
|---|---|
| Incident shock Mach sayısı | 2,89 |
| Reynolds sayısı | 7800 |
| AMR çağrı aralığı | Her 25 solver iterasyonunda bir |
| Maksimum refinement seviyesi | 5 |
| Density-gradient refine eşikleri | 0,6 / 0,625 |
| \(\bar{t}=1.832\) ağ hücre sayısı | 3.241.936 |
| 128 MPI rank solver + AMR paralel verimi | %61 |
| 128 rank'ta AMR'nin 25 iterasyonluk aralıktaki süre payı | Yaklaşık %8 |
| Grid assembly'nin AMR süresindeki minimum payı | %53 |
| 32 rank load balancing wall-clock kazancı | %10,1 |
Paralel verimin neden ideal olmadığı
Çalışma, yüksek MPI rank sayısında paralel verimi sınırlayan temel unsurun yalnız genel MPI iletişim maliyeti olmadığını göstermektedir. Overset overlap bölgesindeki donor–receiver hücre sayıları, p4est'in space-filling-curve partition işlemi sırasında özel bir ağırlıkla dağıtılmamaktadır.
Bunun sonucu olarak bazı rank'larda çok sayıda interpolation sorgusu bulunurken bazı rank'larda çok az bulunabilir. MPI rank sayısı yükseldikçe receiver hücre başına düşen hesaplama miktarı küçülmekte ve communication latency ile workload imbalance daha belirgin hale gelmektedir.
Bu etki özellikle grid assembly ve interpolation alt-rutinlerinde görülmektedir. Flow solver'ın bütün hücrelerde yaptığı Navier–Stokes hesabı ise daha düzenli dağıldığından genel solver scaling'i daha güçlü kalmaktadır.
Çalışmanın mühendislik açısından temel katkısı
Çalışmanın ana katkısı yeni bir Navier–Stokes denklemi veya yeni bir shock-capturing flux geliştirmek değildir. Yenilik, mevcut ve doğrulanmış CFD yapı taşlarının paralel dinamik overset AMR içinde nasıl daha verimli bir veri ve iletişim mimarisiyle birleştirilebileceğine odaklanmaktadır.
Özellikle:
- p4est grid management ile akış verisinin ayrıştırılması,
- yalnız gerekli solution variables'ın migration'ı,
- coarsen–balance sırasında akış bilgisinin korunması,
- master rank yerine distributed overset assembly,
- ADT ve octree'nin grid türüne göre birlikte kullanılması
çalışmanın algoritmik katkılarının merkezindedir.
Başlıca sınırlılıklar
- Scaling testleri tek bir dual-socket HPC node üzerinde yapılmıştır.
- En yüksek test ölçeği 128 MPI rank'tır.
- GPU kullanılmamıştır.
- Yalnız iki benchmark incelenmiştir.
- Overset assembly workload'u MPI rank'lar arasında doğrudan ağırlıklı olarak dengelenmemektedir.
- Yüksek rank sayısında communication ve azalan receiver-cell yoğunluğu assembly performansını sınırlandırmaktadır.
- Küre benchmark'ındaki Region tanımları ve başlangıç hücre sayısı kaynak içinde tutarsızdır.
- Gerçek endüstriyel uçak veya uzay aracı geometrisiyle doğrulama yapılmamıştır.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: A Parallel Solver on a Dynamically Adaptive Overset Grid for Compressible Flow Problems
Yazarlar: Mohamad El Hajj Ali Barada; Bayram Celik.
Yazar sırası: Kaynaktaki özgün sıra aynen korunmuştur.
Eş katkı/eş birinci yazar: Kaynakta belirtilmemiştir.
Sorumlu yazar: Mohamad El Hajj Ali Barada.
Kurumlar: Aeronautical and Astronautical Engineering Program, Istanbul Technical University, Istanbul 34469, Turkey; Department of Astronautical Engineering, kaynakta “Istanbul Tehnical University” biçiminde yazılmıştır, Istanbul 34469, Turkey.
Afiliyasyon yazım notu: İlk afiliyasyonda “Istanbul Technical University”, ikinci afiliyasyonda ise “Istanbul Tehnical University” yazmaktadır. Verianla bunun ikinci afiliyasyondaki yazım hatası olduğu yönünde güçlü bir işaret bulunduğunu not eder; fakat özgün kaynak metnini sessizce değiştirmez.
Kaynak türü: Hakemli araştırma makalesi; üç boyutlu sıkıştırılabilir CFD çözücüsü, paralel hesaplama, dinamik adaptive mesh refinement ve benchmark doğrulaması içeren sayısal yöntem çalışması.
Dergi: Aerospace
Yayınevi: MDPI
Cilt / makale numarası: 13, 656
Yayın tarihi: 20 Temmuz 2026
DOI: 10.3390/aerospace13070656
Resmî yayın bağlantısı: https://www.mdpi.com/2226-4310/13/7/656
DOI bağlantısı: https://doi.org/10.3390/aerospace13070656
Hakemlik durumu: Çalışma, hakemli Aerospace dergisinde yayımlanmış araştırma makalesidir.
Lisans: Creative Commons Attribution 4.0 International (CC BY 4.0).
Finansman: Araştırma dış finansman almamıştır.
Veri erişilebilirliği: Çalışmada sunulan verilerin makul talep üzerine sorumlu yazardan edinilebildiği belirtilmiştir.
Çıkar çatışması: Yazarlar çıkar çatışması bildirmemiştir.
Yazar katkıları: Bayram Celik; gözden geçirme ve düzenleme, denetim ve hesaplama kaynaklarının ediniminden sorumludur. Mohamad El Hajj Ali Barada; ilk taslak, computational software development, veri analizi, metodoloji ve kavramsallaştırmayı gerçekleştirmiştir.
Hesaplama platformu: Benchmark'lar dual-socket tek HPC compute node üzerinde yürütülmüştür. Node iki AMD EPYC 7742 işlemciye, 2,25 GHz temel frekansa ve toplam 128 CPU çekirdeğine sahiptir. p4est ve çözücü MPI tabanlı CPU düzeyinde çalıştırılmış; GPU veya device offloading kullanılmamıştır.
Region 1 / Region 2 tutarsızlık notu: Küre–şok benchmark'ının metinsel açıklaması Region 1'i durağan, Region 2'yi post-shock sonlu hızlı bölge olarak tanımlar. Kaynaktaki Tablo 2 ise hız değerini Region 1 için 2,0451168, Region 2 için 0 vermektedir. Bölge sırasını Verianla varsayımla tersine çevirmemiştir.
Tablo 2 birim notu: Aynı tabloda sıcaklık değerleri 0,006123676 ve 0,002487067 olarak verilmekte ve birim K olarak etiketlenmektedir. Kaynak bu çok küçük sayıların boyutsuzlaştırılmış sıcaklık olup olmadığını açıklamadığından değerler gerçek Kelvin sıcaklığıymış gibi yorumlanmamıştır.
Başlangıç hücre sayısı tutarsızlık notu: Kaynağın bir bölümü küre benchmark'ında “initial overset grid” için 3.241.936 hücre bildirmektedir. Daha sonraki bölüm ise \( \bar{t}=1.832 \) anında ağın 2.232.704 başlangıç hücresinden 3.241.936 hücreye ulaştığını belirtmektedir. İki başlangıç değeri birbiriyle uyuşmadığından Verianla bunlardan birini sessizce düzeltmemiştir.
Sayısal doğrulama sınırı: Çözücü iki benchmark ile değerlendirilmiştir: Mach 2 yarı sonsuz kör burunlu cisim ve Mach 2,89 düzlemsel şok–küre etkileşimi. Doğrulamalar mevcut deneysel referans verileriyle yapılmıştır; çalışmanın kendisi yeni bir fiziksel deney kampanyası değildir.
Paralel performans sınırı: Raporlanan %89,7, %80, %65 ve %61 gibi paralel verim sonuçları çalışma içindeki belirli grid büyüklükleri, MPI rank sayıları ve tek HPC node'u için geçerlidir. Çok düğümlü veya GPU tabanlı sistemlere doğrudan genellenemez.
İçerik üretim yöntemi: Bu Verianla açıklamasındaki bilimsel yöntemler, denklemler, benchmark koşulları, hücre sayıları, MPI sonuçları ve sınırlılıklar incelenen kaynak çalışmaya dayanmaktadır. Dış kontrol yalnız yayın kimliği ve derginin hakemlik durumunun bibliyografik doğrulanması amacıyla kullanılmış; dışarıdan yeni CFD sonucu, yeni benchmark verisi veya kaynakta bulunmayan sayısal performans değeri ana metne eklenmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir