

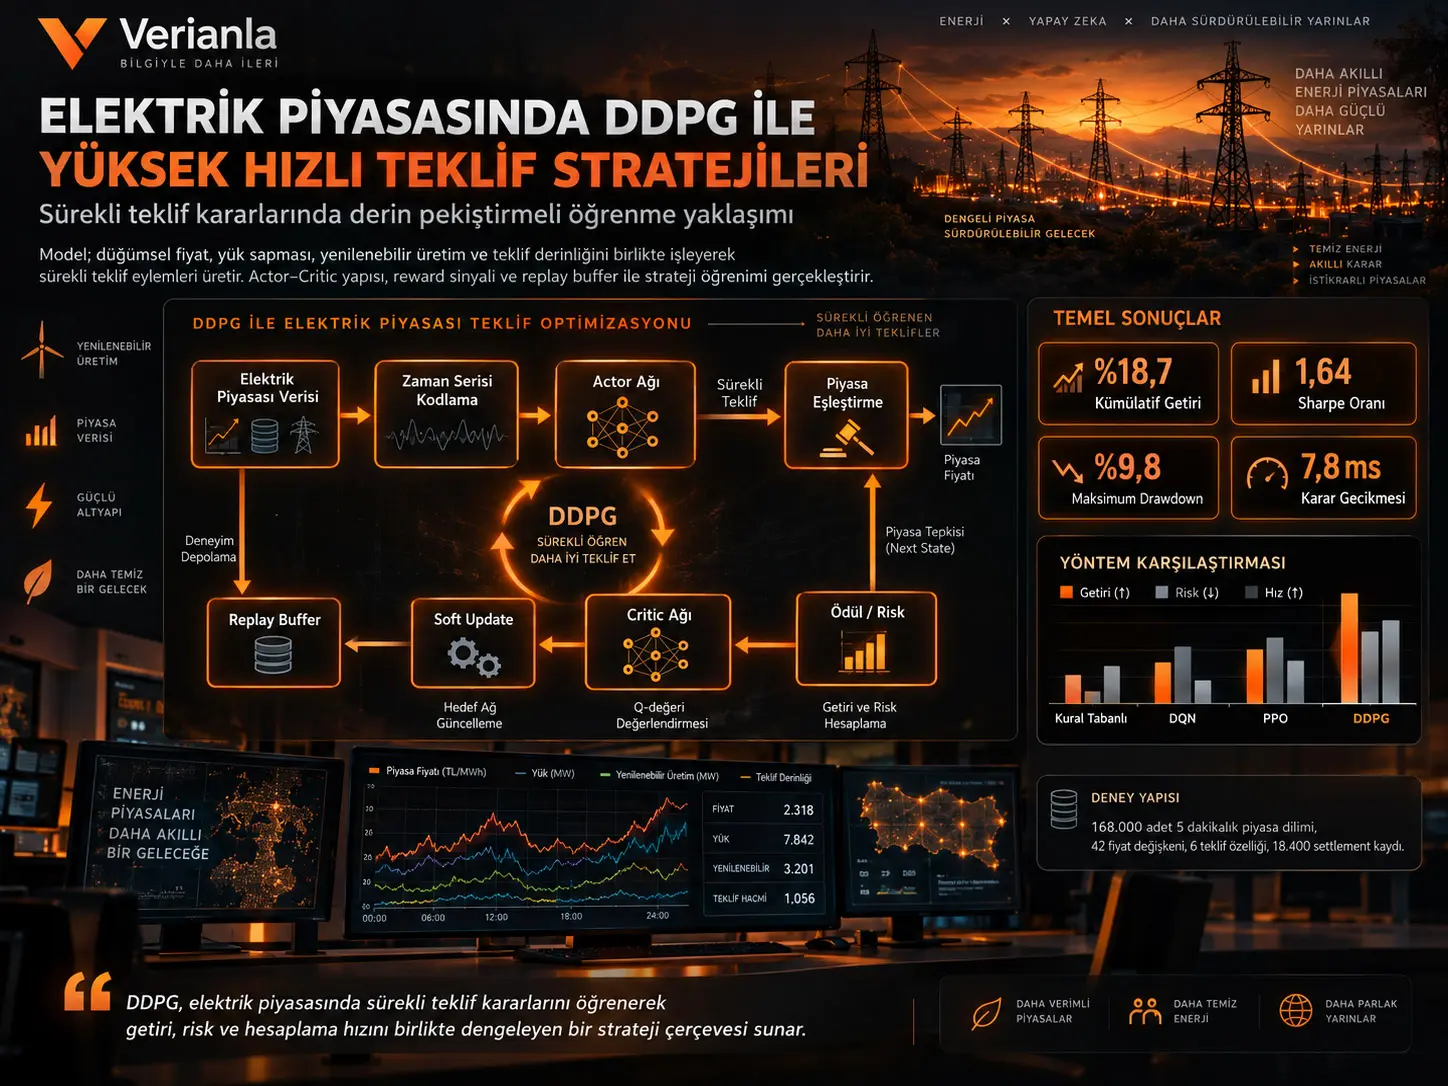
Elektrik piyasalarında fiyat, yük, yenilenebilir enerji üretimi ve işlem derinliği kısa zaman aralıklarında birlikte değişebilir. Bu çalışma, bu çok değişkenli ortamda teklif fiyatı ve teklif miktarı gibi sürekli kararların Deep Deterministic Policy Gradient (DDPG) ile öğrenilip öğrenilemeyeceğini araştırmaktadır. Önerilen sistem; düğümsel marjinal elektrik fiyatı, yük sapması, yenilenebilir üretim, teklif derinliği ve net pozisyon verilerini zaman serisi temsiline dönüştürmekte; Actor ağı sürekli teklif eylemleri oluştururken Critic ağı bu eylemlerin beklenen değerini tahmin etmektedir. Gelir, execution sapması, envanter baskısı ve fiyat oynaklığı aynı reward fonksiyonunda birlikte değerlendirilir.
Deney ortamı 168.000 adet 5 dakikalık piyasa zaman dilimi, 42 fiyat değişkeni, altı teklif özelliği ve 18.400 settlement kaydı içermektedir. Kaynakta DDPG için %18,7 kümülatif getiri, 1,64 Sharpe oranı, %9,8 maksimum drawdown ve 7,8 ms ortalama karar gecikmesi raporlanmaktadır. Aynı deney ortamında DDPG'nin DQN, PPO ve kural tabanlı teklif yöntemlerinden daha yüksek kümülatif getiri ve Sharpe oranı, daha düşük maksimum drawdown elde ettiği bildirilmektedir.
Bununla birlikte çalışmadaki “yüksek frekans” kavramı dikkatle yorumlanmalıdır. Piyasa durumları 5 dakikalık dilimlerle temsil edildiğinden deney, hisse ve kripto piyasalarında kullanılan mikro-saniyelik limit-emir-defteri HFT'siyle aynı zaman ölçeğinde değildir. 7,8 ms değeri modelin karar hesaplama gecikmesini ifade eder; piyasa verisinin örnekleme aralığı ise 5 dakikadır. Ayrıca veri kaynağının hangi gerçek elektrik piyasasına ait olduğu ve birçok kritik eğitim hiperparametresi açıkça raporlanmadığından sonuçların bağımsız yeniden üretimi sınırlıdır.
Deep Deterministic Policy Gradient (DDPG), sürekli eylem uzayları için geliştirilmiş model-free, off-policy bir Actor–Critic pekiştirmeli öğrenme yaklaşımıdır. Actor belirli piyasa durumunda hangi eylemin yapılacağını üretir; Critic ise bu durum–eylem çiftinin beklenen değerini tahmin eder. Experience replay ve yavaş güncellenen target networks eğitim kararlılığını desteklemek için kullanılır.
| Öğe | Kaynakta raporlanan değer |
|---|---|
| Piyasa alanı | Elektrik piyasası sürekli teklif kararları |
| Temel yöntem | Deep Deterministic Policy Gradient (DDPG) |
| Piyasa zaman dilimi | 168.000 adet 5 dakikalık time slice |
| Fiyat değişkenleri | 42 |
| Teklif özellikleri | 6 |
| Settlement kaydı | 18.400 |
| Karşılaştırılan yöntemler | Rule-based, DQN, PPO, DDPG |
| DDPG kümülatif getiri | %18,7 |
| DDPG Sharpe oranı | 1,64 |
| DDPG maksimum drawdown | %9,8 |
| DDPG karar gecikmesi | 7,8 ms |
Elektrik piyasasında teklif kararı neden sürekli bir kontrol problemi olarak ele alınıyor?
Klasik bir sınıflandırma problemi yalnız “al”, “sat” veya “bekle” gibi ayrık seçenekler üretir. Elektrik piyasası teklif mekanizmasında ise karar çoğu zaman daha karmaşıktır. Sistem hem teklif fiyatını hem teklif edilen enerji miktarını belirlemeli, aynı zamanda kapasite, pozisyon ve risk sınırlarına uymalıdır.
Bu nedenle eylem uzayı:
- teklif edilen güç miktarı,
- fiyat sapması,
- pozisyon ayarlaması,
- risk azaltma düzeyi
gibi sürekli büyüklüklerden oluşabilir.
DQN gibi yöntemler temelde ayrık eylem seçimine dayanır. Sürekli bir teklif alanını DQN ile kullanmak için eylemlerin belirli kutulara ayrılması gerekir. Bu ise fiyat ve miktarın aynı anda ince ölçekle ayarlanması gereken durumlarda çözünürlüğü azaltabilir.
DDPG'nin temel avantajı Actor ağının doğrudan sürekli sayısal eylem üretmesidir.
Çalışmanın genel işlem döngüsü
Kaynak Şekil 1'de sistem beş ana bölüm halinde gösterilmektedir:
Veri girişi → durum oluşturma → politika çıktısı → piyasa etkileşimi → parametre güncelleme.
İlk aşamada sisteme:
- düğümsel marjinal fiyat,
- işlem sonuçları,
- yük sapması,
- yenilenebilir üretim
gibi piyasa akışları gelir.
Veriler sliding window ve normalization işlemlerinden sonra ortak state representation'a dönüştürülür. Actor Network bu durumdan sürekli bidding action üretir. Teklif piyasa matching modülünde değerlendirilir. Oluşan gelir ve risk feedback'i Critic tarafından kullanılır ve deneyim replay buffer'a yazılır. Daha sonra Actor, Critic ve target network parametreleri güncellenir.
DDPG Elektrik Piyasası Tekliflerini Nasıl Öğreniyor?
DDPG'nin temelinde iki sinir ağı bulunmaktadır. Actor piyasa durumunu eyleme dönüştürür. Critic ise Actor tarafından üretilen teklifin mevcut piyasa koşullarında ne kadar değerli olduğunu hesaplamaya çalışır.
Actor'ın görevi kabaca:
\[ \text{piyasa durumu} \rightarrow \text{teklif fiyatı ve miktarı} \]
eşlemesini öğrenmektir.
Critic ise:
\[ Q(s,a) \]
fonksiyonuyla belirli bir \(s\) durumunda gerçekleştirilen \(a\) eyleminin beklenen uzun dönem değerini tahmin eder.
Zaman penceresi
Model yalnız mevcut piyasa gözlemini kullanmaz. Son \(L\) zaman dilimini bir pencereye yerleştirir:
\[ S_t= \{x_{t-L+1},x_{t-L+2},\ldots,x_t\} \]
Burada \(x_t\) mevcut piyasa gözlemini, \(S_t\) ise karar anındaki tarihsel state window'u temsil eder.
Amaç kısa dönem fiyat hareketleri, işlem yoğunluğu ve yük değişimlerinin yalnız tek bir noktadan değil yakın geçmiş içindeki örüntüsünden öğrenilmesidir.
Dört temel özellik grubu
Çalışma girdileri dört kategoriye ayırmaktadır:
- Fiyat: düğümsel fiyatlar ve fiyat sapmaları,
- İşlem: işlem hacmi, teklif kuyruğu ve execution bilgisi,
- Kısıt: kapasite ve teklif limitleri,
- Volatilite: piyasa dalgalanmasını temsil eden değişkenler.
Bu heterojen değişkenler ortak representation alanına:
\[ z_t= \sigma (W_p p_t+W_v v_t+W_c c_t+W_r r_t+b) \]
ile dönüştürülür.
Bu işlem fiyat, işlem, kısıt ve oynaklık bilgilerinin politika ağına ortak boyutta aktarılmasını amaçlar.
Tarihsel bilginin ağırlıklandırılması
Model yalnız özellikleri birleştirmekle kalmaz; tarihsel trend, işlem feedback'i ve constraint bilgisini de state içine ekler:
\[ h_t= \sum_{i=0}^{L-1}\alpha_i z_{t-i} + \beta\Delta q_t + \gamma\Delta m_t + \eta(z_t\odot u_t) \]
Bu ifade yakın geçmişin farklı parçalarına farklı ağırlıklar verilmesine ve hacim/fiyat değişimlerinin karar durumuna dahil edilmesine olanak verir.
Zaman Serisi Kodlama Neden Kullanılıyor?
Elektrik fiyatı, yük sapması ve yenilenebilir üretim yalnız mevcut değerleriyle değil, birkaç zaman dilimi boyunca izledikleri yol nedeniyle de karar açısından anlam taşıyabilir.
Kaynak çalışma bu nedenle dört aşamalı bir temporal representation yapısı oluşturur:
- yerel zaman örüntüsü çıkarımı,
- attention aggregation,
- gated fusion,
- policy input mapping.
Attention mekanizması
Geçmişteki her zaman diliminin mevcut teklif açısından aynı derecede önemli olması beklenmez. Kaynakta attention ağırlığı:
\[ \alpha_{t,j} = \frac {\exp(q_tk_j^{T}/\sqrt{d_k})} {\sum_m\exp(q_tk_m^{T}/\sqrt{d_k})} \]
biçiminde hesaplanmaktadır.
Ardından geçmiş temsiller:
\[ c_t= \sum_{j=t-L+1}^{t} \alpha_{t,j}e_j \]
ile tek bir context vector içinde birleştirilir.
Böylece yakın geçmişteki fiyat sıçraması veya işlem yoğunluğu gibi karar açısından daha anlamlı bölümlerin daha yüksek ağırlık alması amaçlanır.
Risk ve Getiri Aynı Reward Fonksiyonunda Nasıl Birleştiriliyor?
Pekiştirmeli öğrenme algoritması yalnız kârı maksimize edecek şekilde eğitilirse kısa vadede aşırı agresif teklifler üretebilir. Bu nedenle çalışmanın reward fonksiyonu yalnız işlem gelirini değil, execution sapmasını, inventory riskini ve fiyat volatilitesini de cezalandırmaktadır.
Kaynakta reward:
\[ r_t= m_t(\pi_t^{clr}-\pi_t^{bid}) -\lambda_1|a_t-m_t| -\lambda_2\max(0,|e_{t+1}|-\bar e) -\lambda_3 Var(\pi_{t-w:t}) \]
şeklinde kurulmuştur.
Burada ilk bölüm gerçekleşen işlem hacmi ile clearing ve bidding fiyatı arasındaki farktan türeyen gelir bileşenidir.
Sonraki terimler sırasıyla:
- execution / action sapması,
- izin verilen sınırı aşan net pozisyon,
- yüksek fiyat varyansı
için ceza uygular.
Böylece model yalnız “en fazla getiri hangi eylemde?” sorusunu değil, “getiri sağlarken pozisyon ve volatilite riskini nasıl sınırlarım?” sorusunu öğrenmeye çalışır.
Actor–Critic Mimarisi Nasıl Güncelleniyor?
Sürekli teklif üretimi
Actor ağı sürekli eylemi belirli alt ve üst sınırlar arasında üretir:
\[ a_t= \Gamma(W_an_t+b_a) \]
ve kaynakta ölçekleme fonksiyonu:
\[ \Gamma(x)= l+ \frac{u-l}{2}(1+\tanh(x)) \]
olarak verilmektedir.
Bu sayede sinir ağının ham çıktısı piyasanın izin verdiği teklif aralığına dönüştürülebilir.
Critic değer tahmini
Critic mevcut piyasa durumu ile Actor tarafından seçilen teklifin değerini:
\[ q_t=Q(y_t,a_t;\theta^Q) \]
ile tahmin eder.
Target network
Tek adımlık market reward yüksek oynaklığa sahip olabileceğinden kaynak, target Actor ve target Critic kullanmaktadır:
\[ \hat q_t= r_t+ \gamma Q'(y_{t+1}, \mu'(y_{t+1});\theta^{Q'}) \]
Target ağların online ağlarla aynı anda tamamen değiştirilmesi yerine soft update uygulanır:
\[ \theta^{Q'} \leftarrow \tau\theta^Q+(1-\tau)\theta^{Q'} \]
\[ \theta^{\mu'} \leftarrow \tau\theta^\mu+(1-\tau)\theta^{\mu'} \]
Bu yaklaşım hedef değerlerin eğitim sırasında aşırı hızlı değişmesini sınırlamayı amaçlar.
Çalışmanın Yöntemi ve Bulguları
Deney veri yapısı
Kaynakta deney veri seti:
- 168.000 adet 5 dakikalık piyasa zaman dilimi,
- 42 fiyat değişkeni,
- 6 bidding feature,
- 18.400 settlement record
olarak tanımlanmaktadır.
State input; node marginal price, gerçek zamanlı yük sapması, teklif derinliği, yenilenebilir üretim ve net pozisyondan oluşmaktadır.
Ancak kaynakta veri setinin hangi gerçek elektrik piyasasından geldiği, coğrafi bölgesi ve kapsadığı tam tarih aralığı açık biçimde belirtilmemektedir. Deneyler “unified matching environment” içinde yürütülmektedir.
DDPG hangi sonuçları verdi?
| Model | Kümülatif Getiri | Sharpe | Maksimum Drawdown | Karar Gecikmesi |
|---|---|---|---|---|
| Rule-based | %11,6 | 1,02 | %14,8 | 5,9 ms |
| DQN | %14,2 | 1,21 | %12,9 | 6,8 ms |
| PPO | %16,1 | 1,39 | %11,4 | 8,6 ms |
| DDPG | %18,7 | 1,64 | %9,8 | 7,8 ms |
Kaynak deneyinde DDPG en yüksek kümülatif getiri ve Sharpe oranına, aynı zamanda en düşük maksimum drawdown'a sahiptir.
Kural tabanlı yöntem 5,9 ms ile en hızlı karar üretirken performans ve risk ölçülerinde daha zayıf sonuç vermektedir. DDPG'nin 7,8 ms gecikmesi PPO'nun 8,6 ms değerinden düşük, DQN ve rule-based yöntemlerinden ise yüksektir.
“7,8 ms” gerçek HFT anlamına mı geliyor?
Bu değer yalnız modelin hesaplama/inference gecikmesidir. Çalışmadaki market state verileri 5 dakikalık dilimlerle düzenlenmektedir.
Dolayısıyla:
5 dakikalık piyasa gözlemi + 7,8 ms model inference
yapısı, mikro-saniye seviyesinde sürekli limit-order-book güncellemeleriyle çalışan menkul kıymet HFT sistemleriyle doğrudan karşılaştırılmamalıdır.
Elektrik piyasası bağlamında çalışma daha doğru biçimde kısa zaman aralıklı, hızlı ve sürekli bidding control problemi olarak okunmalıdır.
Hangi piyasa koşullarında model daha güçlü tepki verdi?
Kaynak Şekil 5'te fiyat sapması ve normalize işlem derinliğine göre unit-time return heat map gösterilmektedir.
Yüksek tepki bölgesi:
- pozitif spread: yaklaşık %0,8–%1,6,
- normalize transaction depth: 0,55–0,72
aralığında yoğunlaşmaktadır.
Bu bölgede ortalama birim-zaman getirisi 0,041–0,048 olarak raporlanmaktadır.
Tepe hücrede:
- return: 0,052,
- action intensity: 0,81
değerleri verilmektedir.
Buna karşılık fiyat sapması %0,3'ün altına veya transaction depth 0,30'un altına düştüğünde modelin action output'u belirgin biçimde küçülmektedir.
Bu sonuç, öğrenilen politikanın bütün volatilite durumlarında maksimum teklif üretmek yerine spread ve piyasa derinliğini birlikte kullandığını göstermektedir.
Haftalık getiriler
Kaynak Şekil 6'daki 12 test haftasında DDPG için:
- medyan haftalık getiri: 0,31,
- alt çeyrek: 0,27,
- üst çeyrek: 0,36,
- en düşük hafta: 0,18,
- en yüksek hafta: 0,44
olarak raporlanmaktadır.
DQN ve PPO dağılımları da çoğunlukla pozitif görünürken rule-based yöntemde alt uç sıfırın altına inmektedir.
Bununla birlikte yalnız 12 haftalık gözlem ve raporlanmamış random-seed tekrarları nedeniyle bu boxplot sonuçları istatistiksel kesinlik veya farklı piyasa dönemlerinde garanti edilen üstünlük olarak yorumlanmamalıdır.
Ablation deneyleri ne gösteriyor?
| Model Yapısı | Getiri | Sharpe | Drawdown | Gecikme |
|---|---|---|---|---|
| Tam model | %18,7 | 1,64 | %9,8 | 7,8 ms |
| Zaman serisi kodlaması olmadan | %15,8 | 1,34 | %12,6 | 7,3 ms |
| Risk cezası olmadan | %17,2 | 1,22 | %13,7 | 7,7 ms |
| Target smoothing olmadan | %16,0 | 1,31 | %12,8 | 7,6 ms |
| Priority sampling olmadan | %16,4 | 1,36 | %12,1 | 7,5 ms |
Ablation sonuçlarının en belirgin örneklerinden biri risk penalty bileşenidir. Risk cezası kaldırıldığında getiri %17,2 ile görece yüksek kalmakta, fakat maksimum drawdown %9,8'den %13,7'ye yükselmekte ve Sharpe oranı 1,64'ten 1,22'ye düşmektedir.
Bu sonuç, çalışmanın tasarımında yalnız ham getiriyi maksimize etmenin yeterli olmadığı ve reward içindeki risk düzeltmesinin strateji davranışını önemli ölçüde etkilediği görüşünü desteklemektedir.
Priority sampling
Kaynak normal replay sampling yerine zaman yeniliği, temporal-difference error ve risk exposure kullanan bir örnekleme ağırlığı tanımlar:
\[ \omega_i= \frac{ (\nu_i+\kappa_1|\delta_i|+\kappa_2r_i^{risk})^\zeta }{ \sum_{j=1}^{N} (\nu_j+\kappa_1|\delta_j|+\kappa_2r_j^{risk})^\zeta } \]
Böylece yüksek volatilite, yüksek prediction error veya yüksek risk taşıyan örneklerin eğitim batch'lerinde daha görünür tutulması amaçlanır.
Eylem sürekliliği kısıtı
Çalışma Actor güncellemesine ardışık teklifler arasındaki büyük sıçramaları cezalandıran ek bir regularization terimi eklemektedir:
\[ \|\mu(y_i)-\mu(y_{i-1})\|_2^2 \]
Bu terimin amacı gelir artışı aranırken teklif fiyatı veya miktarının ardışık kararlar arasında gereksiz biçimde sert değişmesini azaltmaktır.
DDPG'nin Daha Yüksek Getirisi Gerçek Piyasada Aynı Şekilde Beklenebilir mi?
Hayır. Çalışma belirli bir unified matching environment içinde DDPG'nin diğer üç yöntemden daha iyi performans verdiğini raporlamaktadır. Bu sonuç gerçek elektrik piyasalarının tamamına veya farklı düzenleyici yapıya sahip piyasalara otomatik olarak genellenemez.
Bunun birkaç nedeni vardır:
- Veri setinin belirli piyasa ve coğrafi kaynağı açık biçimde tanımlanmamıştır.
- Farklı elektrik piyasalarının teklif, settlement ve kapasite kuralları değişebilir.
- Model tek-agent yapıdadır.
- Rakip piyasa katılımcılarının stratejik adaptasyonu tam olarak modellenmemektedir.
- Extreme-tail shock yapısının reward modelinde daha ayrıntılı ele alınması gerektiğini kaynak kendisi kabul etmektedir.
- Cross-region ve cross-market doğrulama yapılmamıştır.
- Random-seed tekrarları ve confidence intervals raporlanmamıştır.
- Temel eğitim hiperparametrelerinin önemli bölümü sayısal olarak belirtilmemektedir.
“%13,2 daha düşük drawdown” ifadesine ilişkin not
Kaynak metin sonuç bölümünde maksimum geri çekilmenin %13,2 azaldığını ifade etmektedir. Ancak Tablo 4'te maksimum drawdown değerleri Rule-based için %14,8, DQN için %12,9, PPO için %11,4 ve DDPG için %9,8'dir.
Bu tablodan doğrudan:
- Rule-based → DDPG farkı: 5,0 yüzde puanı,
- DQN → DDPG farkı: 3,1 yüzde puanı,
- PPO → DDPG farkı: 1,6 yüzde puanı
hesaplanmaktadır.
Kaynak %13,2 değerinin hangi karşılaştırma tabanına göre hesaplandığını belirtmediği için Verianla bu oranı bağımsız performans sonucu olarak tekrar etmemektedir.
Çalışmanın güçlü tarafları
- Elektrik piyasası bidding problemini sürekli eylem uzayı olarak modellemesi.
- Fiyat, işlem, kısıt ve risk değişkenlerini aynı state yapısında birleştirmesi.
- Actor–Critic, replay buffer ve target network yapısını kapalı döngü piyasa ortamıyla birleştirmesi.
- Getirinin yanında drawdown ve latency raporlaması.
- DQN, PPO ve rule-based karşılaştırmalarının birlikte verilmesi.
- Dört önemli modül için ablation deneyi yapılması.
Başlıca yöntemsel sınırlılıklar
- “HFT” olarak tanımlanan market input'un 5 dakikalık zaman dilimleriyle temsil edilmesi.
- Verinin hangi piyasa ve tarihlerden geldiğinin yeterince açıklanmaması.
- Train/validation/test bölünmesinin ayrıntılı verilmemesi.
- Actor ve Critic ağ mimarisinin katman boyutlarının raporlanmaması.
- Learning rate, discount factor, soft-update coefficient ve replay-buffer kapasitesi gibi temel değerlerin eksik olması.
- Exploration noise yapısının ayrıntılı açıklanmaması.
- Karşılaştırma modellerinin hyperparameter tuning sürecinin verilmemesi.
- Birden fazla random seed ve confidence interval raporlanmaması.
- 12 haftalık test dağılımının uzun dönem piyasa rejimlerini temsil etmek için sınırlı olması.
- Tek-agent yaklaşımının stratejik rakip davranışını sınırlı temsil etmesi.
Kaynak ve Yöntem Notu
Özgün başlık: Exploration of deep deterministic policy gradient algorithm in high-frequency trading strategy in power market
Yazar: Yunpeng Feng.
Kurum: School of Automation Science and Engineering, South China University of Technology, Guangzhou, Guangdong, China.
Dergi: Ingegneria Sismica – International Journal of Earthquake Engineering.
Cilt / sayı: Volume 43 / Issue 2; PDF üzerinde Anno XLIII – Num. 2 – 2026.
Sayfalar: 1–23.
Yayın tarihi: 30 Nisan 2026.
DOI: 10.65102/is2026549.
Lisans: Derginin resmî copyright politikasına göre Creative Commons Attribution 4.0 International (CC BY 4.0).
Çalışma türü: Deep reinforcement learning tabanlı sürekli elektrik piyasası bidding modeli; unified matching environment içinde karşılaştırmalı deney ve ablation analizi.
Temel yöntem: Deep Deterministic Policy Gradient; Actor–Critic; target networks; experience replay; priority sampling; temporal feature encoding; attention aggregation; gated feature fusion.
Temel karşılaştırmalar: DQN, PPO ve rule-based bidding.
Temel sonuç: Kaynak deneyinde DDPG %18,7 kümülatif getiri, 1,64 Sharpe oranı, %9,8 maksimum drawdown ve 7,8 ms ortalama decision latency göstermiştir.
Veri: 168.000 adet 5 dakikalık market time slice, 42 fiyat değişkeni, altı bidding feature ve 18.400 settlement record.
Veri kökeni uyarısı: Kaynak veri giriş türlerini ayrıntılı biçimde açıklamakla birlikte belirli elektrik piyasasının adını, coğrafi bölgeyi ve tam tarih aralığını açık biçimde raporlamamaktadır.
HFT terminoloji uyarısı: 5 dakikalık state dilimleri kullanıldığı için çalışmadaki yüksek frekans kavramı, menkul kıymet piyasalarındaki mikro-saniye limit-order-book HFT tanımıyla doğrudan eşitlenmemelidir.
Reprodüksiyon uyarısı: Birçok temel hiperparametre, ağ boyutu, random seed ve ayrıntılı veri bölme prosedürü raporlanmadığından bağımsız reprodüksiyon sınırlıdır.
Performans uyarısı: Kaynakta “maximum back-off decreases by 13.2%” ifadesi bulunmaktadır; ancak Tablo 4 bu yüzdesinin referans değerini açık biçimde desteklememektedir. Bu nedenle Verianla anlatımında doğrudan tablo değerleri kullanılmıştır.
Genellenebilirlik: Sonuçlar makaledeki unified matching environment ve veri yapısıyla sınırlıdır; gerçek elektrik piyasasında canlı işlem performansı olarak yorumlanmamalıdır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir