

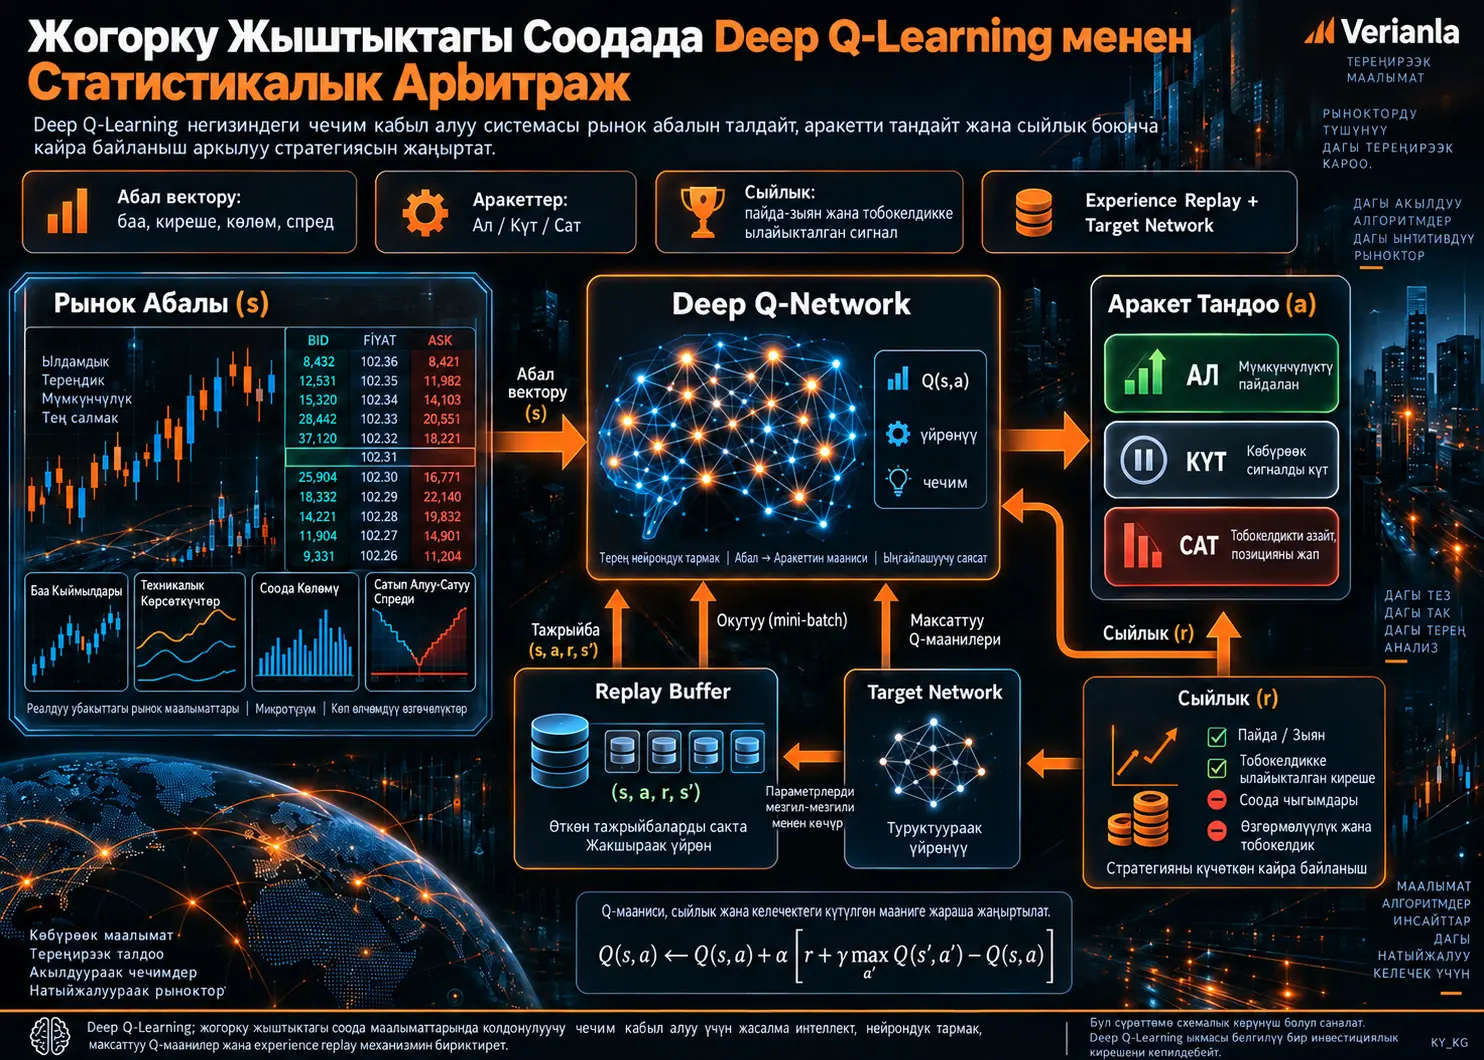
Deep Q-Learning — бекемдөөчү үйрөнүү агенти белгилүү бир рыноктук абалда ар кандай аракеттердин күтүлгөн узак мөөнөттүү маанилерин терең нейрондук тармак аркылуу болжол менен эсептеген model-free чечим үйрөнүү ыкмасы. Каралып жаткан изилдөө бул ыкманы жогорку жыштыктагы соодада (High-Frequency Trading, HFT) статистикалык арбитраж үчүн кантип колдонууга болорун Q-Learning жаңыртуусу, нейрондук тармакка негизделген Q-функция, максаттуу тармак, experience replay жана абал-аракет-сыйлык түзүлүшү аркылуу түшүндүрөт. Булак Deep Q-Learning өзгөрмөлүү рынок шарттарына ыңгайлаша аларын билдирет; бирок PDFтин негизги бөлүгү бул ырастоону тастыктай турган кеңири backtest маалыматтарын же сандык натыйжалуулук жыйынтыктарын бербейт.
Сунушталган HFT алкагында рыноктук абал акыркы баа кыймылдары, кирешелүүлүк, техникалык көрсөткүчтөр, соода көлөмү жана bid-ask spread сыяктуу өзгөрмөлөрдөн турушу мүмкүн. Агент ушул абалга жараша сатып алуу, позицияны сактоо же сатуу сыяктуу аракеттердин арасынан тандайт. Ишке ашкан пайда/зыян же тобокелдикке ылайыкташтырылган натыйжалуулук сыйлык сигналына айландырылат; андан соң Q-тармак өткөн тажрыйбалардан үйрөнүп, келечектеги чечимдерин жаңыртат.
Изилдөөнүн эң үйрөтүүчү жагы HFT маселесин бир жолку баа божомолу катары эмес, ырааттуу чечим кабыл алуу маселеси катары кароосунда. Ошентсе да ыкманын концептуалдык жактан ылайыктуу болушу анын реалдуу рынокто экономикалык артыкчылык берерин өзүнөн өзү далилдебейт. Кечигүү, буйрутмалар китебинин динамикасы, транзакциялык төлөмдөр, slippage, рынокко тийгизген таасир, реалдуу убакыттагы эсептөө чыгымы жана режимдин өзгөрүшү сыяктуу HFT үчүн маанилүү факторлордун булакта эмпирикалык түрдө сандык бааланбаганы маанилүү чектөө болуп саналат.
Эмне үчүн жогорку жыштыктагы соода ырааттуу чечим кабыл алуу маселеси болуп саналат?
Жогорку жыштыктагы соода системалары “кийинки баа жогорулайбы же төмөндөйбү?” деген суроого гана жооп бербейт. Соода агенти учурдагы рыноктук абалды байкайт, аракет тандайт, рыноктун кийинки абалга өтүшүн жана сооданын финансылык жыйынтыгын көрөт, андан соң жаңы чечим кабыл алат. Демек, соода процесси убакыт ичинде бири-бири менен байланышкан чечимдердин ырааттуулугунан турат.
Бул түзүлүш бекемдөөчү үйрөнүүнүн негизги маселе аныктамасына шайкеш келет. Агент чөйрөдөн \(s\) абалын байкайт, \(a\) аракетин аткарат, \(r\) сыйлыгын алат жана жаңы \(s'\) абалына өтөт. Үйрөнүүнүн максаты учурдагы соодадан алынган кирешени гана эмес, келечекте пайда болушу мүмкүн болгон сыйлыктарды да эске алган саясатты иштеп чыгуу.
Deep Q-Learning деген эмне?
Deep Q-Learning — классикалык Q-Learningдеги абал-аракет мааниси функциясын чоң таблицада сактоонун ордуна аны терең нейрондук тармак аркылуу болжол менен эсептеген бекемдөөчү үйрөнүү ыкмасы; ушундайча баа, кирешелүүлүк, көлөм жана рыноктук микротүзүм сыяктуу көп өлчөмдүү киргизүүлөр түзгөн чоң абал мейкиндиктеринде ар кандай аракеттердин күтүлгөн маанилерин баалоого болот.
Классикалык tabular Q-Learningде ар бир абал-аракет жуп үчүн өзүнчө маани сакталат. Бирок финансылык рыноктогу абал көп сандагы баа байкоолорунан, кирешелүүлүктөн, кыймылдуу орточолордон, волатилдүүлүк көрсөткүчтөрүнөн, көлөмдөн жана bid-ask spread сыяктуу өзгөрмөлөрдөн турса, мүмкүн болгон абалдардын саны өтө чоң болуп кетет. Deep Q-Learning бул масштаб маселесин нейрондук тармакка негизделген функциялык жакындатуу аркылуу чечет.
Q-Learning жаңыртуусу
Булакта негизги Q-Learning жаңыртуусу төмөнкүдөй берилет:
\[ Q(s,a) \leftarrow Q(s,a) + \alpha \left[ r+\gamma\max_{a'}Q(s',a')-Q(s,a) \right] \]
Бул теңдемеде \(Q(s,a)\) \(s\) абалындагы \(a\) аракетинин күтүлгөн жалпы маанисин билдирет. \(r\) — аракеттен кийин байкалган дароо сыйлык. \(s'\) — соодадан кийин пайда болгон жаңы абал. \(\max_{a'}Q(s',a')\) жаңы абалда жеткиликтүү аракеттер арасындагы эң жогорку болжолдонгон келечектеги маанини көрсөтөт.
\(\alpha\) — үйрөнүү ылдамдыгы жана жаңы байкоо учурдагы Q-маанини канчалык өзгөртөрүн аныктайт. \(\gamma\) — дисконт коэффициенти; маани 1 ге жакындаган сайын келечектеги сыйлыктарга берилген салмак көбөйөт, 0 го жакындаган сайын жакынкы мөөнөттөгү сыйлык үстөмдүк кылат.
Теңдемедеги чарчы кашаанын ичиндеги айырма учурдагы Q-божомол менен байкалган сыйлык жана келечекке байланыштуу божомол түзгөн максаттын ортосундагы ката. Үйрөнүү процесси ушул катаны колдонуп, маанилердин божомолдорун кайра-кайра оңдойт.
Нейрондук тармак Q-маанини кантип жакындатат?
Deep Q-Learningде Q-маанилер өзүнчө уячалардан турган таблицада сакталбайт. Булак төмөнкү жалпы ыкманы берет:
\[ Q(s,a;\theta)=f(s;\theta) \]
\(\theta\) нейрондук тармактын үйрөнүлүүчү параметрлерин; \(s\) рынокту көрсөткөн киргизүү абалын; \(f\) нейрондук тармак аткарган функциялык өзгөртүүнү билдирет. Тармактын чыгышы жеткиликтүү аракеттер үчүн болжолдонгон Q-маанилерден турган вектор болуп саналат.
Мисалы, аракеттер мейкиндиги сатып алуу, күтүү жана сатуу деп аныкталса, тармак ошол эле рыноктук абалда бул үч аракет үчүн үч башка маани божомолун чыгара алат. Чечим саясаты ушул божомолдорду колдонуп аракет тандайт.
Максаттуу тармак эмне үчүн колдонулат?
Deep Q-Learningде үйрөнүп жаткан тармак учурдагы божомолду да, өзүнүн үйрөнүү максатын да дайыма бир убакта өзгөртсө, окутуу туруксуз болуп калышы мүмкүн. Булак бул маселени азайтуу үчүн мезгил-мезгили менен жаңыртылып туруучу өзүнчө target network колдонуу ыкмасын түшүндүрөт.
Жоготуу функциясы булакта төмөнкүдөй берилет:
\[ L(\theta)= E\left[ \left( r+\gamma\max_{a'}Q(s',a';\theta^-) -Q(s,a;\theta) \right)^2 \right] \]
Бул жерде \(\theta\) учурдагы Q-тармактын, ал эми \(\theta^-\) максаттуу тармактын параметрлери. \(Q(s,a;\theta)\) учурдагы тармактын божомолу; \(r+\gamma\max Q(s',a';\theta^-)\) болсо окутуунун максатын түзөт. Чарчы айырманын күтүлгөн маанисин азайтуу аркылуу учурдагы тармакты максаттуу Q-маанилерге жакындатуу көздөлөт.
Максаттуу тармактын ар бир кадамда негизги тармак менен бир убакта өзгөртүлбөшү үйрөнүү максатынын кыска мөөнөттөрдө туруктуураак болушун камсыздайт. Булак муну Q-Learning окутуусундагы термелүү жана четтөө тобокелдигин азайткан механизмдердин бири катары берет.
Experience Replay эмне үчүн колдонулат?
Experience replay агенттин ырааттуу рынок байкоолорун ошол эле тартипте түздөн-түз үйрөнүүнүн ордуна \((s,a,r,s')\) тажрыйбаларын replay buffer ичинде сактап, окутуу учурунда ошол эстутумдан туш келди mini-batchтерди тандоого мүмкүндүк берүү аркылуу ырааттуу үлгүлөрдүн ортосундагы күчтүү корреляцияны азайтууну жана мурунку тажрыйбаларды кайра пайдаланууну көздөйт.
Финансылык убакыт катарларында бири-бирин ээрчиген байкоолор көбүнчө жогорку деңгээлде өз ара байланыштуу болот. Нейрондук тармакты акыркы бир нече ырааттуу байкоо менен гана окутуу үйрөнүүнүн тар рынок режимине ашыкча көз каранды болуп калышына алып келиши мүмкүн. Replay buffer ар башка мезгилдердин үлгүлөрүн бир окутуу тобуна бириктирип, үлгүлөрдүн ар түрдүүлүгүн көбөйтөт.
Булак mini-batch жаңыртуусун концептуалдык түрдө төмөнкүдөй билдирет:
\[ \Delta\theta = E_{(s,a,r,s')\sim U(D)} \left[ \nabla_\theta \left( r+\gamma\max_{a'}Q(s',a';\theta^-) -Q(s,a;\theta) \right)^2 \right] \]
\(D\) replay bufferди, \(U(D)\) ушул эстутумдан uniform үлгү алууну, ал эми \(\Delta\theta\) тармак параметрлеринин окутуу учурунда өзгөрүшүн билдирет.
HFT үчүн абал вектору
Булак сунуштаган HFT абалынын аныктамасы үч негизги маалымат тобуна таянат: акыркы баа кыймылдары жана кирешелүүлүк, техникалык көрсөткүчтөр жана рыноктук микротүзүм өзгөрмөлөрү. Жалпы абал вектору төмөнкүдөй көрсөтүлөт:
\[ s=[p_1,p_2,\ldots,p_n,i_1,i_2,\ldots,i_m,v,b] \]
Бул жерде \(p\) баа кыймылдарын, \(i\) техникалык көрсөткүчтөрдү, \(v\) соода көлөмүн жана \(b\) bid-ask spreadди билдирет. Булак техникалык көрсөткүчтөрдүн мисалы катары кыймылдуу орточолорду, Bollinger Bands жана Relative Strength Indexти (RSI) атайт.
Бул туюнтма так маалымат схемасы эмес. Макала канча баа кечигүүсү колдонуларын, кайсы көрсөткүчтөр тандаларын, маалымат кайсы убакыттык чечилиште үлгү алынарын же киргизүүлөр кантип нормалдаштырылары тууралуу маалымат бербейт.
Аракеттер мейкиндиги
Булак үч негизги аракетти аныктайт:
- Buy: баа өсөт деген күтүм менен актив сатып алуу.
- Hold: жаңы соода ачпастан учурдагы позицияны сактоо.
- Sell: позицияны азайтуу же жабуу.
Чыныгы HFT системасында буйрутма түрү, баа деңгээли, көлөм, жокко чыгаруу чечими жана кезектеги орун сыяктуу кеңири аракеттер талап кылынышы мүмкүн. Бирок булак бул кеңири execution деңгээлин моделдебейт.
Сыйлык функциясы
Макала соодадагы пайда же зыянды негизги сыйлык компоненти катары карайт жана жалаң чийки пайдага таянуу жогорку тобокелдик алган саясаттарды шыктандырышы мүмкүн экенине көңүл бурат. Тобокелдикке ылайыкташтырылган сыйлык концептуалдык түрдө:
\[ r = \frac{\text{Beklenen Getiri}} {\text{Getirilerin Standart Sapması}} \]
түрүндө берилет. Бул катыш Sharpe тибиндеги тобокелдикке ылайыкташтырылган натыйжалуулук идеясына жакын. Бирок булак чыныгы окутуу тажрыйбасында бул сыйлык кайсы убакыт терезесинде, кайсы тобокелдиксиз киреше божомолу менен же кайсы масштабдоо ыкмасы аркылуу эсептелгенин көрсөтпөйт.
Статистикалык арбитраж менен байланышы
Статистикалык арбитраж өз ара байланышкан финансылык инструменттердин же баа процесстеринин ортосундагы убактылуу салыштырмалуу четтөөлөрдү статистикалык ыкмалар менен аныктап, алардын нормалдашуусун күтүү негизинде соода жүргүзүүгө таянат. Deep Q-Learning көз карашында агент туруктуу кирүү-чыгуу босогосун гана колдонбостон, рыноктук абалдан жана мурунку сыйлыктардан үйрөнүп, аракет саясатын ыңгайлаштырууга аракет кылат.
Бул ыңгайлашуу жөндөмү теориялык жактан режимдин өзгөрүшүнө жооп берүү артыкчылыгын бере алат. Бирок финансылык рыноктордун non-stationary болушу мурун үйрөнүлгөн Q-маанилердин келечекте жарактуу болоруна кепилдик бербейт. Жаңы рынок режимдери replay bufferдеги эски тажрыйбаларга карама-каршы келиши мүмкүн жана сыйлык бөлүштүрүлүшү убакыт өткөн сайын өзгөрүшү мүмкүн.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Булакта аныкталган методологиялык компоненттер
| Компонент | Булакта аныкталган роль | Булакта жетишпеген колдонуу деталдары |
|---|---|---|
| Абал \(s\) | Баа, кирешелүүлүк, техникалык көрсөткүч, көлөм жана bid-ask spread сыяктуу рыноктук маалыматтарды билдирет. | Убакыттык чечилиш, терезе өлчөмү, нормалдаштыруу жана так өзгөчөлүктөр топтому берилген эмес. |
| Аракет \(a\) | Buy, Hold жана Sell чечимдери. | Буйрутманын көлөмү, limit/market буйрутма айырмасы жана execution деталдары берилген эмес. |
| Сыйлык \(r\) | Пайда/зыян же тобокелдикке ылайыкташтырылган киреше. | Чыныгы колдонмодо пайдаланылган так сыйлык функциясы жана параметрлер берилген эмес. |
| Q-Learning | Bellmanга негизделген маани жаңыртуусу аркылуу узак мөөнөттүү сыйлыкты үйрөнөт. | \(\alpha\) жана \(\gamma\) үчүн чыныгы тажрыйба маанилери билдирилген эмес. |
| Q-network | Жогорку өлчөмдүү абалдан аракеттердин Q-маанилерин божомолдойт. | Катмарлардын саны, нейрондордун саны, активдештирүү функциялары жана optimizer берилген эмес. |
| Target network | Үйрөнүү максатын туруктуураак кармоо үчүн өзүнчө Q-божомол берет. | Жаңыртуу жыштыгы түшүндүрүлгөн эмес. |
| Replay buffer | Мурунку тажрыйбаларды сактап, туш келди mini-batch окутууга мүмкүнчүлүк берет. | Buffer сыйымдуулугу, batch size жана sampling деталдары билдирилген эмес. |
| Жоготуу функциясы | Учурдагы Q-божомол менен максаттуу Q ортосундагы квадраттык айырманы азайтат. | Окутуу узактыгы, convergence критерийи жана үйрөнүү ийри сызыктары берилген эмес. |
Макала Deep Q-Learning HFTде көбүрөөк кирешелүү экенин далилдейби?
Жок; булактын кыскача мазмунунда симуляциялар жана backtestтер ыңгайлашуу, кирешелүүлүк жана тобокелдикке ылайыкташтырылган кирешелер боюнча оң натыйжа бергени айтылса да, макаланын негизги бөлүгүндө бул ырастоону көз карандысыз баалоого мүмкүндүк бере турган маалымат топтому, backtest мезгили, benchmark, PnL, Sharpe катышы, drawdown, транзакция чыгымы же статистикалык маанилүүлүк жыйынтыктары билдирилген эмес.
Бул айырма изилдөөнү чечмелөөдө борбордук мааниге ээ. Булак Deep Q-Learning HFT статистикалык арбитражына кантип ылайыкташтырылышы мүмкүн экенин түшүндүрүп, ыкманын мүмкүн болгон артыкчылыктарын талкуулайт. Бирок учурдагы PDF ыкма белгилүү рынок маалыматтарында белгилүү benchmarkтан сандык жактан ашып түшөрүн көрсөткөн кайра өндүрүлүүчү эмпирикалык далил бербейт.
Кыскача мазмун менен негизги бөлүктүн ортосундагы далил айырмасы
Кыскача мазмунда “extensive simulations and backtests” деген сөз айкашы колдонулат жана кирешелүүлүк метрикалары менен тобокелдикке ылайыкташтырылган кирешелер жакшырганы айтылат. Бирок булактын негизги бөлүгүндө өзүнчө маалымат, эксперимент, жыйынтык же backtest бөлүмү жок. Сандык киреше сериясы, натыйжалуулук таблицасы же модель салыштыруусу берилген эмес.
Ошондуктан Verianla үчүн коопсуз илимий билдирүү мындай: изилдөө Deep Q-Learningди HFT статистикалык арбитражы үчүн концептуалдык жактан негиздеп, колдонууга жарамдуу архитектураны сунуштайт; бирок бул PDF берген далил деңгээли ыкманын реалдуу экономикалык артыкчылыгын сандык түрдө тастыктоо үчүн жетишсиз.
Кайра өндүрүлүүчүлүк жагынан жетишпеген нерселер
- Колдонулган финансылык рынок же активдердин жыйындысы көрсөтүлгөн эмес.
- Tick, trade же limit-order-book маалымат булагы берилген эмес.
- Train, validation жана test мезгилдери билдирилген эмес.
- Out-of-sample баалоо протоколу берилген эмес.
- Q-network архитектурасы көрсөтүлгөн эмес.
- Learning rate, discount factor, batch size жана replay-buffer сыйымдуулугу берилген эмес.
- Epsilon-greedy же башка exploration саясатынын параметрлери көрсөтүлгөн эмес.
- Target network жаңыртуу жыштыгы берилген эмес.
- Соода комиссиялары, bid-ask чыгымы, slippage жана market impact моделденген эмес.
- Latency же соода инфраструктурасынын чыгымы билдирилген эмес.
- Салыштыруу benchmarkтары берилген эмес.
- Sharpe ratio, maximum drawdown, turnover же PnL сериясы билдирилген эмес.
Изилдөө колдогон жыйынтык
Булак Deep Q-Learning жогорку өлчөмдүү рыноктук абалдарды нейрондук тармак аркылуу көрсөтүү, аракет маанилерин Q-Learning принциби менен жаңыртуу, replay buffer аркылуу мурунку тажрыйбалардан кайра үйрөнүү жана target network менен окутуу максатын турукташтыруу үчүн логикалык HFT алкагын сунуштай турганын колдойт.
Изилдөө колдобогон жыйынтык
Булак бул архитектура белгилүү бир биржада, активде, соода мезгилинде же реалдуу убакыттагы HFT инфраструктурасында статистикалык жактан жогорку киреше бергенин, транзакция чыгымдарынан кийин кирешелүү калганын же классикалык статистикалык арбитраж ыкмаларынан жакшыраак болгонун сандык түрдө көрсөтпөйт.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска изилдөө: Harnessing Deep Q-Learning for Enhanced Statistical Arbitrage in High-Frequency Trading: A Comprehensive Exploration.
Автор: Soumyadip Sarkar.
Булак: arXiv:2311.10718v1, q-fin.TR.
Дата: 13-сентябрь 2023.
Туруктуу идентификатор: 10.48550/ARXIV.2311.10718.
Булак түрү: arXiv preprint; булакта рецензияланган журнал/конференция жарыясы жөнүндө маалымат берилген эмес.
Институционалдык аффилиация: Булак PDFте автордун институционалдык аффилиациясы көрсөтүлгөн эмес, байланыш үчүн электрондук почта дареги гана берилген.
Лицензия: Каралган PDFте жана библиографиялык жазууларда белгилүү бир ачык лицензия тастыкталбагандыктан, Verianla тексти булактын сөздөрүн кайра жарыялоонун ордуна илимий түшүнүктөрдү өз алдынча үйрөтүүчү түзүлүштө түшүндүрөт.
Маалыматтын жеткиликтүүлүгү: Булак белгилүү бир маалымат топтомун же маалымат репозиторийин аныктабайт.
Каржылоо жана кызыкчылыктардын кагылышы: PDFте ачык каржылоо же кызыкчылыктардын кагылышы жөнүндө билдирүү жок.
Негизги методологиялык чектөө: Булакта Deep Q-Learningдин математикалык жана концептуалдык компоненттери түшүндүрүлгөнү менен, эмпирикалык колдонмону кайра түзүү үчүн зарыл болгон маалымат, гиперпараметрлер, окутуу тартиби жана натыйжалуулук жыйынтыктары берилген эмес.
Финансылык чечмелөө чеги: Бул Verianla мазмуну соода стратегиясын сунуштоо же инвестициялык кеңеш эмес; бул булак изилдөөнүн методологиялык түзүлүшүн жана далил чектерин түшүндүргөн илимий билим берүүчү текст.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген