

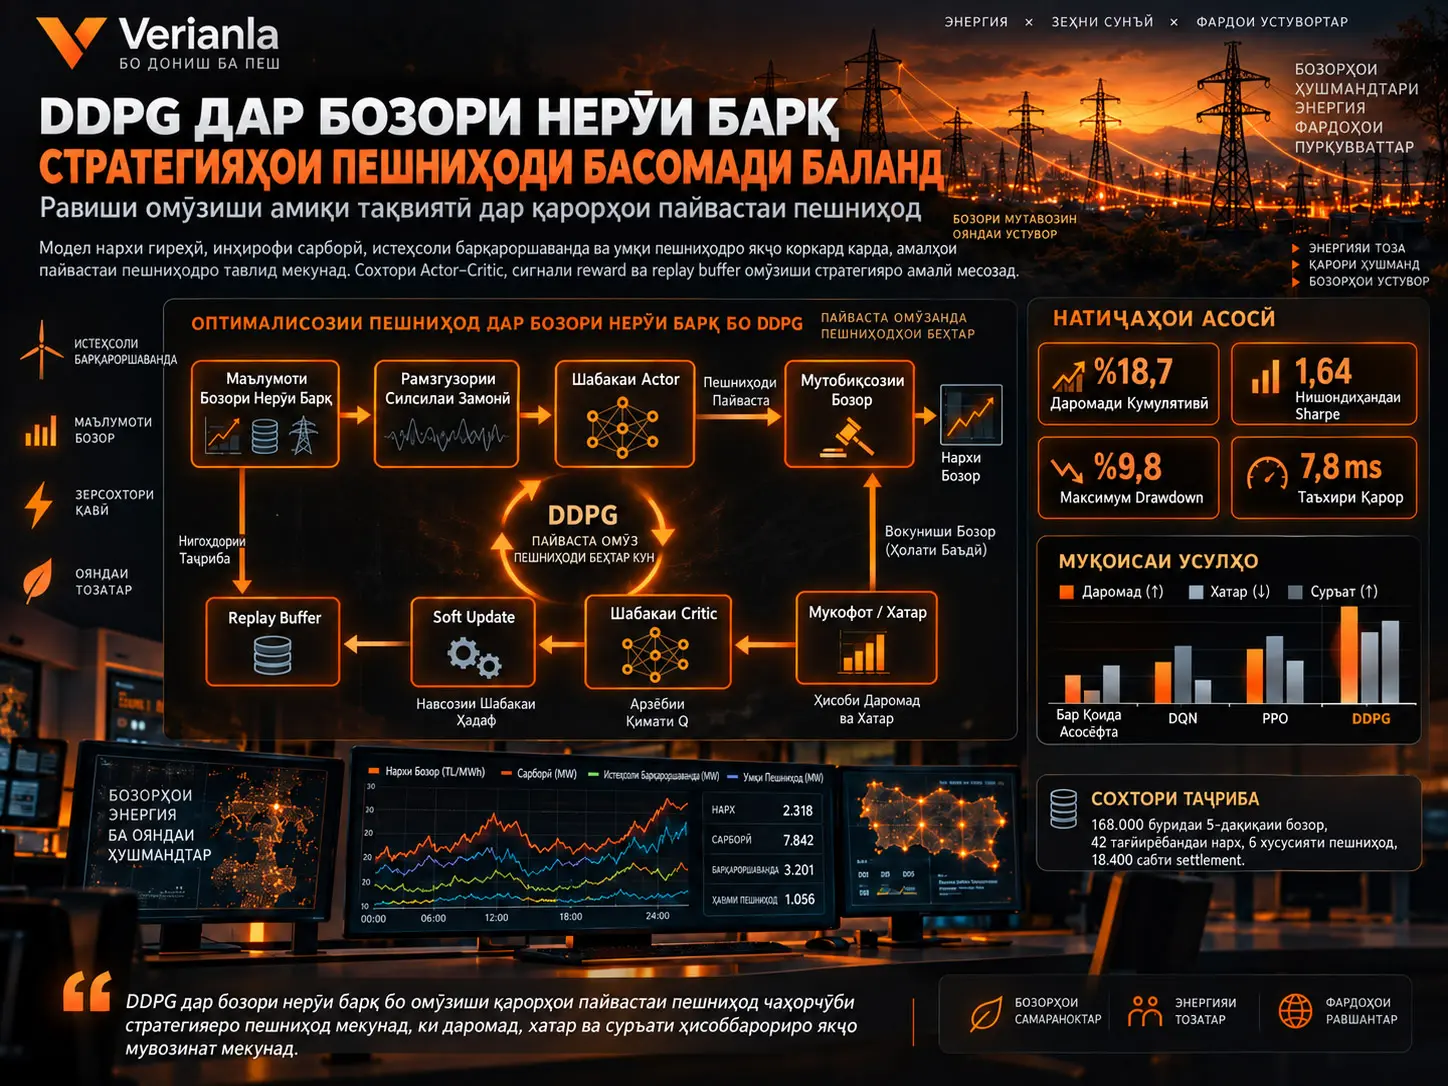
Дар бозорҳои нерӯи барқ нарх, сарборӣ, истеҳсоли энергияи барқароршаванда ва умқи муомила метавонанд дар фосилаҳои кӯтоҳи вақт ҳамзамон тағйир ёбанд. Ин таҳқиқот меомӯзад, ки оё дар чунин муҳити бисёртағйирёбанда қарорҳои пайваста, аз қабили нархи пешниҳод ва ҳаҷми пешниҳод, метавонанд бо Deep Deterministic Policy Gradient (DDPG) омӯхта шаванд. Системаи пешниҳодшуда нархи маржиналии гиреҳии нерӯи барқ, инҳирофи сарборӣ, истеҳсоли барқароршаванда, умқи пешниҳод ва маълумоти мавқеи софро ба намоиши силсилаи замонӣ табдил медиҳад; шабакаи Actor амалҳои пайвастаи пешниҳодро тавлид мекунад, дар ҳоле ки шабакаи Critic арзиши интизории ин амалҳоро арзёбӣ менамояд. Даромад, инҳирофи execution, фишори inventory ва ноустувории нарх дар як reward function якҷоя баҳогузорӣ мешаванд.
Муҳити таҷрибавӣ 168.000 буридаи 5-дақиқагии вақти бозор, 42 тағйирёбандаи нарх, шаш хусусияти пешниҳод ва 18.400 сабти settlement-ро дар бар мегирад. Дар манбаъ барои DDPG даромади кумулятивии %18,7, таносуби Sharpe-и 1,64, maximum drawdown-и %9,8 ва таъхири миёнаи қароргирии 7,8 ms гузориш шудааст. Дар ҳамон муҳити таҷрибавӣ гуфта мешавад, ки DDPG нисбат ба DQN, PPO ва усулҳои пешниҳоди rule-based даромади кумулятивӣ ва таносуби Sharpe-и баландтар ва maximum drawdown-и пасттар ба даст овардааст.
Бо вуҷуди ин, мафҳуми “басомади баланд” дар таҳқиқот бояд боэҳтиёт шарҳ дода шавад. Азбаски ҳолатҳои бозор бо буридаҳои 5-дақиқагӣ нишон дода мешаванд, таҷриба дар ҳамон миқёси вақт бо HFT-и limit-order-book-и микросониягӣ, ки дар бозорҳои саҳмия ва крипто истифода мешавад, нест. Арзиши 7,8 ms таъхири ҳисобкунии қарори моделро ифода мекунад; фосилаи намунагирии маълумоти бозор бошад 5 дақиқа аст. Илова бар ин, азбаски маълумоти он ки манбаи додаҳо ба кадом бозори воқеии нерӯи барқ тааллуқ дорад ва бисёр гиперпараметрҳои муҳими омӯзиш ба таври возеҳ гузориш нашудаанд, бозтавлиди мустақили натиҷаҳо маҳдуд аст.
Deep Deterministic Policy Gradient (DDPG) равиши Actor–Critic-и model-free ва off-policy барои омӯзиши тақвиятӣ мебошад, ки барои фазоҳои амали пайваста таҳия шудааст. Actor дар ҳолати муайяни бозор кадом амалро иҷро карданро тавлид мекунад; Critic бошад арзиши интизории ҷуфти ҳолат–амалро арзёбӣ менамояд. Experience replay ва target networks-и оҳиста навшаванда барои дастгирии устувории омӯзиш истифода мешаванд.
| Унсур | Арзиши дар манбаъ гузоришшуда |
|---|---|
| Соҳаи бозор | Қарорҳои пайвастаи пешниҳод дар бозори нерӯи барқ |
| Усули асосӣ | Deep Deterministic Policy Gradient (DDPG) |
| Буридаи вақти бозор | 168.000 адад time slice-и 5-дақиқагӣ |
| Тағйирёбандаҳои нарх | 42 |
| Хусусиятҳои пешниҳод | 6 |
| Сабти settlement | 18.400 |
| Усулҳои муқоисашуда | Rule-based, DQN, PPO, DDPG |
| Даромади кумулятивии DDPG | %18,7 |
| Таносуби Sharpe-и DDPG | 1,64 |
| Maximum drawdown-и DDPG | %9,8 |
| Таъхири қарори DDPG | 7,8 ms |
Чаро қарори пешниҳод дар бозори нерӯи барқ ҳамчун масъалаи идоракунии пайваста баррасӣ мешавад?
Масъалаи классикии тасниф танҳо имконоти ҷудогонаи монанди “харид”, “фурӯш” ё “интизор”-ро медиҳад. Аммо дар механизми пешниҳоди бозори нерӯи барқ қарор аксаран мураккабтар аст. Система бояд ҳам нархи пешниҳод ва ҳам миқдори энергияи пешниҳодшавандаро муайян кунад ва ҳамзамон маҳдудиятҳои иқтидор, мавқеъ ва хавфро риоя намояд.
Аз ин рӯ фазои амал метавонад аз бузургиҳои пайвастаи зерин иборат бошад:
- миқдори қувваи пешниҳодшуда,
- инҳирофи нарх,
- танзими мавқеъ,
- сатҳи коҳиши хавф
Аз ин рӯ фазои амал метавонад аз бузургиҳои пайвастаи зерин иборат бошад.
Усулҳое мисли DQN асосан ба интихоби амалҳои ҷудогона такя мекунанд. Барои истифодаи фазои пайвастаи пешниҳод бо DQN амалҳоро бояд ба қуттиҳои муайян ҷудо кард. Ин метавонад дар ҳолатҳое, ки нарх ва миқдор бояд ҳамзамон бо дақиқии баланд танзим шаванд, резолютсияро коҳиш диҳад.
Бартарии асосии DDPG дар он аст, ки шабакаи Actor бевосита амали ададии пайвастаро тавлид мекунад.
Даври умумии кори таҳқиқот
Дар Шакли 1-и манбаъ система дар панҷ қисми асосӣ нишон дода шудааст:
Воридшавии маълумот → сохтани ҳолат → баромади сиёсат → ҳамкорӣ бо бозор → навсозии параметрҳо.
Дар марҳилаи аввал ба система:
- нархи маржиналии гиреҳӣ,
- натиҷаҳои муомила,
- инҳирофи сарборӣ,
- истеҳсоли барқароршаванда
монанди ҷараёнҳои бозорӣ ворид мешаванд.
Пас аз амалҳои sliding window ва normalization додаҳо ба state representation-и умумӣ табдил дода мешаванд. Actor Network аз ин ҳолат bidding action-и пайвастаро тавлид мекунад. Пешниҳод дар модули matching-и бозор арзёбӣ мешавад. Даромад ва risk feedback-и ҳосилшуда аз ҷониби Critic истифода мешаванд ва таҷриба ба replay buffer навишта мешавад. Сипас параметрҳои Actor, Critic ва target network нав карда мешаванд.
DDPG Пешниҳодҳои Бозори Нерӯи Барқро Чӣ Гуна Меомӯзад?
Дар асоси DDPG ду шабакаи асабӣ қарор доранд. Actor ҳолати бозорро ба амал табдил медиҳад. Critic бошад кӯшиш мекунад арзиши пешниҳоди тавлидкардаи Actor-ро дар шароити кунунии бозор ҳисоб кунад.
Вазифаи Actor тақрибан чунин аст:
\[ \text{piyasa durumu} \rightarrow \text{teklif fiyatı ve miktarı} \]
яъне омӯхтани ин мувофиқат.
Critic бошад:
\[ Q(s,a) \]
бо ин функсия арзиши интизории дарозмуддатро дар ҳолати муайяни \(s\) барои амали иҷрошудаи \(a\) тахмин мекунад.
Равзанаи вақт
Модел танҳо мушоҳидаи ҷории бозорро истифода намекунад. Он \(L\) буридаи охирини вақтро дар як равзана ҷой медиҳад:
\[ S_t= \{x_{t-L+1},x_{t-L+2},\ldots,x_t\} \]
Дар ин ҷо \(x_t\) мушоҳидаи ҷории бозорро ва \(S_t\) state window-и таърихиро дар лаҳзаи қарор ифода мекунад.
Ҳадаф ин аст, ки ҳаракатҳои кӯтоҳмуддати нарх, шиддати муомила ва тағйироти сарборӣ на аз як нуқта, балки аз намунаи онҳо дар гузаштаи наздик омӯхта шаванд.
Чор гурӯҳи асосии хусусиятҳо
Таҳқиқот воридотро ба чор категория ҷудо мекунад:
- Нарх: нархҳои гиреҳӣ ва инҳирофҳои нарх,
- Муомила: ҳаҷми муомила, навбати пешниҳод ва маълумоти execution,
- Маҳдудият: иқтидор ва лимитҳои пешниҳод,
- Ноустуворӣ: тағйирёбандаҳое, ки ларзиши бозорро ифода мекунанд.
Ин тағйирёбандаҳои гетерогенӣ ба фазои representation-и умумӣ:
\[ z_t= \sigma (W_p p_t+W_v v_t+W_c c_t+W_r r_t+b) \]
табдил дода мешаванд.
Ин амал ҳадаф дорад маълумоти нарх, муомила, маҳдудият ва ноустувориро бо андозаи умумӣ ба шабакаи сиёсат интиқол диҳад.
Вазнгузории маълумоти таърихӣ
Модел танҳо хусусиятҳоро якҷо намекунад; инчунин тренди таърихӣ, feedback-и муомила ва маълумоти constraint-ро ба state илова мекунад:
\[ h_t= \sum_{i=0}^{L-1}\alpha_i z_{t-i} + \beta\Delta q_t + \gamma\Delta m_t + \eta(z_t\odot u_t) \]
Ин ифода имкон медиҳад ба қисмҳои гуногуни гузаштаи наздик вазнҳои гуногун дода шаванд ва тағйироти ҳаҷм/нарх ба ҳолати қарор дохил карда шаванд.
Чаро Рамзгузории Силсилаи Замонӣ Истифода Мешавад?
Нархи нерӯи барқ, инҳирофи сарборӣ ва истеҳсоли барқароршаванда на танҳо бо арзишҳои ҷории худ, балки бо роҳи тайкардаи онҳо дар тӯли якчанд буридаи вақт низ барои қарор аҳамият дошта метавонанд.
Аз ин рӯ таҳқиқоти манбаъ сохтори чормарҳилавии temporal representation месозад:
- истихроҷи намунаи маҳаллии вақт,
- attention aggregation,
- gated fusion,
- policy input mapping.
Механизми Attention
Интизор нест, ки ҳар як буридаи вақти гузашта барои пешниҳоди ҷорӣ як дараҷа муҳим бошад. Дар манбаъ вазни attention чунин ҳисоб карда мешавад:
\[ \alpha_{t,j} = \frac {\exp(q_tk_j^{T}/\sqrt{d_k})} {\sum_m\exp(q_tk_m^{T}/\sqrt{d_k})} \]
ба ҳамин шакл ҳисоб карда мешавад.
Сипас намоишҳои таърихӣ:
\[ c_t= \sum_{j=t-L+1}^{t} \alpha_{t,j}e_j \]
дар як context vector якҷо карда мешаванд.
Ҳамин тавр, ҳадаф ин аст, ки бахшҳои барои қарор муҳимтар, масалан ҷаҳиши нарх ё шиддати муомила дар гузаштаи наздик, вазни бештар гиранд.
Хавф ва Даромад Дар Як Reward Function Чӣ Гуна Якҷо Мешаванд?
Агар алгоритми омӯзиши тақвиятӣ танҳо барои ҳадди аксар кардани фоида омӯзонида шавад, он метавонад дар кӯтоҳмуддат пешниҳодҳои аз ҳад хашмгин тавлид кунад. Аз ин рӯ reward function-и таҳқиқот на танҳо даромади муомиларо, балки инҳирофи execution, хавфи inventory ва ноустувории нархро низ ҷарима мекунад.
Дар манбаъ reward:
\[ r_t= m_t(\pi_t^{clr}-\pi_t^{bid}) -\lambda_1|a_t-m_t| -\lambda_2\max(0,|e_{t+1}|-\bar e) -\lambda_3 Var(\pi_{t-w:t}) \]
ба ҳамин шакл сохта шудааст.
Дар ин ҷо қисми аввал ҷузъи даромадест, ки аз фарқи байни ҳаҷми муомилаи иҷрошуда ва нархи clearing ва bidding ҳосил мешавад.
Ҳадҳои баъдӣ мутаносибан барои:
- инҳирофи execution / action,
- мавқеи софе, ки аз ҳади иҷозашуда мегузарад,
- варианси баланди нарх
ҷарима татбиқ мекунанд.
Ҳамин тавр модел на танҳо саволи “кадом амал даромади бештар медиҳад?”, балки саволи “ҳангоми гирифтани даромад хавфи мавқеъ ва ноустувориро чӣ гуна маҳдуд кунам?”-ро низ меомӯзад.
Меъмории Actor–Critic Чӣ Гуна Нав Мешавад?
Тавлиди пешниҳоди пайваста
Шабакаи Actor амали пайвастаро байни ҳадҳои поёнӣ ва болоии муайян тавлид мекунад:
\[ a_t= \Gamma(W_an_t+b_a) \]
ва дар манбаъ функсияи масштабонӣ:
\[ \Gamma(x)= l+ \frac{u-l}{2}(1+\tanh(x)) \]
дода шудааст.
Ба ин восита баромади хоми шабакаи асабиро метавон ба доираи пешниҳоди иҷозатдодаи бозор табдил дод.
Тахмини арзиши Critic
Critic арзиши ҳолати ҷории бозор ва пешниҳоди интихобкардаи Actor-ро:
\[ q_t=Q(y_t,a_t;\theta^Q) \]
тахмин мекунад.
Target network
Азбаски market reward-и якқадамӣ метавонад ноустувории баланд дошта бошад, манбаъ target Actor ва target Critic истифода мебарад:
\[ \hat q_t= r_t+ \gamma Q'(y_{t+1}, \mu'(y_{t+1});\theta^{Q'}) \]
Ба ҷойи он ки target network-ҳо ҳамзамон бо online network-ҳо пурра иваз шаванд, soft update истифода мешавад:
\[ \theta^{Q'} \leftarrow \tau\theta^Q+(1-\tau)\theta^{Q'} \]
\[ \theta^{\mu'} \leftarrow \tau\theta^\mu+(1-\tau)\theta^{\mu'} \]
Ин равиш ҳадаф дорад тағйири аз ҳад босуръати арзишҳои ҳадафро ҳангоми омӯзиш маҳдуд кунад.
Усул ва Натиҷаҳои Таҳқиқот
Сохтори додаҳои таҷрибавӣ
Дар манбаъ маҷмӯи додаҳои таҷрибавӣ чунин тавсиф шудааст:
- 168.000 буридаи 5-дақиқагии вақти бозор,
- 42 тағйирёбандаи нарх,
- 6 bidding feature,
- 18.400 settlement record
ба ҳамин тарз тавсиф мешавад.
State input аз node marginal price, инҳирофи сарбории вақти воқеӣ, умқи пешниҳод, истеҳсоли барқароршаванда ва мавқеи соф иборат аст.
Аммо дар манбаъ возеҳ гуфта намешавад, ки маҷмӯи додаҳо аз кадом бозори воқеии нерӯи барқ гирифта шудааст, минтақаи ҷуғрофии он чист ва кадом давраи дақиқи санаҳоро фаро мегирад. Таҷрибаҳо дар дохили “unified matching environment” гузаронида мешаванд.
DDPG чӣ натиҷа дод?
| Модел | Даромади Кумулятивӣ | Sharpe | Maximum Drawdown | Таъхири Қарор |
|---|---|---|---|---|
| Rule-based | %11,6 | 1,02 | %14,8 | 5,9 ms |
| DQN | %14,2 | 1,21 | %12,9 | 6,8 ms |
| PPO | %16,1 | 1,39 | %11,4 | 8,6 ms |
| DDPG | %18,7 | 1,64 | %9,8 | 7,8 ms |
Дар таҷрибаи манбаъ DDPG баландтарин даромади кумулятивӣ ва таносуби Sharpe ва ҳамзамон пасттарин maximum drawdown-ро дорад.
Усули rule-based бо 5,9 ms зудтарин қарорро тавлид мекунад, аммо аз ҷиҳати нишондиҳандаҳои иҷро ва хавф натиҷаи заифтар медиҳад. Таъхири 7,8 ms-и DDPG аз арзиши 8,6 ms-и PPO паст, вале аз DQN ва усули rule-based баландтар аст.
Оё “7,8 ms” маънои HFT-и воқеиро дорад?
Ин арзиш танҳо таъхири ҳисобкунӣ/inference-и модел аст. Маълумоти market state дар таҳқиқот бо буридаҳои 5-дақиқагӣ тартиб дода шудааст.
Аз ин рӯ:
Мушоҳидаи 5-дақиқагии бозор + 7,8 ms model inference
набояд мустақиман бо системаҳои HFT-и коғазҳои қиматнок, ки бо навсозиҳои пайвастаи limit-order-book дар сатҳи микросония кор мекунанд, муқоиса шавад.
Дар заминаи бозори нерӯи барқ ин таҳқиқотро дурусттар аст ҳамчун масъалаи bidding control-и зуд, пайваста ва бо фосилаи кӯтоҳи вақт хонд.
Модел дар кадом шароити бозор вокуниши қавитар нишон дод?
Дар Шакли 5-и манбаъ unit-time return heat map аз рӯи инҳирофи нарх ва умқи муомилаи нормализатсияшуда нишон дода шудааст.
Минтақаи вокуниши баланд:
- spread-и мусбат: тақрибан %0,8–%1,6,
- normalize transaction depth: 0,55–0,72
дар ин фосила мутамарказ шудааст.
Дар ин минтақа даромади миёнаи воҳид-вақт 0,041–0,048 гузориш шудааст.
Дар ҳуҷайраи қулла:
- return: 0,052,
- action intensity: 0,81
арзишҳо дода шудаанд.
Баръакс, вақте инҳирофи нарх аз %0,3 ё transaction depth аз 0,30 поён меравад, action output-и модел ба таври назаррас кам мешавад.
Ин натиҷа нишон медиҳад, ки сиёсати омӯхташуда ба ҷойи тавлиди пешниҳоди максималӣ дар ҳамаи ҳолатҳои ноустуворӣ, spread ва умқи бозорро якҷоя истифода мебарад.
Даромадҳои ҳафтаина
Дар Шакли 6-и манбаъ, барои DDPG дар 12 ҳафтаи санҷишӣ:
- медианаи даромади ҳафтаина: 0,31,
- квартали поёнӣ: 0,27,
- квартали болоӣ: 0,36,
- ҳафтаи пасттарин: 0,18,
- ҳафтаи баландтарин: 0,44
гузориш шудааст.
Тақсимоти DQN ва PPO низ асосан мусбат менамояд, дар ҳоле ки дар усули rule-based нӯги поёнӣ аз сифр поён меравад.
Бо вуҷуди ин, бинобар танҳо 12 ҳафтаи мушоҳида ва такрорҳои random-seed-и гузоришнашуда, ин натиҷаҳои boxplot набояд ҳамчун қатъияти оморӣ ё бартарии кафолатшуда дар давраҳои гуногуни бозор шарҳ дода шаванд.
Таҷрибаҳои Ablation чӣ нишон медиҳанд?
| Сохтори Модел | Даромад | Sharpe | Drawdown | Таъхир |
|---|---|---|---|---|
| Модели пурра | %18,7 | 1,64 | %9,8 | 7,8 ms |
| Бе рамзгузории силсилаи замонӣ | %15,8 | 1,34 | %12,6 | 7,3 ms |
| Бе ҷаримаи хавф | %17,2 | 1,22 | %13,7 | 7,7 ms |
| Бе target smoothing | %16,0 | 1,31 | %12,8 | 7,6 ms |
| Бе priority sampling | %16,4 | 1,36 | %12,1 | 7,5 ms |
Яке аз мисолҳои равшани натиҷаҳои ablation ҷузъи risk penalty мебошад. Вақте ҷаримаи хавф хориҷ карда мешавад, даромад бо %17,2 нисбатан баланд мемонад, аммо maximum drawdown аз %9,8 ба %13,7 боло меравад ва таносуби Sharpe аз 1,64 ба 1,22 поён меояд.
Ин натиҷа андешаро дастгирӣ мекунад, ки дар тарҳи таҳқиқот танҳо ҳадди аксар кардани даромади хом кофӣ нест ва ислоҳи хавф дар дохили reward ба рафтори стратегия таъсири назаррас мерасонад.
Priority sampling
Манбаъ ба ҷойи replay sampling-и муқаррарӣ вазни намунагириро муайян мекунад, ки навгонии вақт, temporal-difference error ва risk exposure-ро истифода мебарад:
\[ \omega_i= \frac{ (\nu_i+\kappa_1|\delta_i|+\kappa_2r_i^{risk})^\zeta }{ \sum_{j=1}^{N} (\nu_j+\kappa_1|\delta_j|+\kappa_2r_j^{risk})^\zeta } \]
Бо ин роҳ ҳадаф он аст, ки намунаҳои дорои ноустувории баланд, prediction error-и баланд ё хавфи баланд дар batch-ҳои омӯзиш бештар намоён нигоҳ дошта шаванд.
Маҳдудияти пайвастагии амал
Таҳқиқот ба навсозии Actor як regularization term-и иловагӣ зам мекунад, ки ҷаҳишҳои калон байни пешниҳодҳои пайдарпайро ҷарима мекунад:
\[ \|\mu(y_i)-\mu(y_{i-1})\|_2^2 \]
Ҳадафи ин ҳад кам кардани тағйироти аз ҳад тези нарх ё миқдори пешниҳод байни қарорҳои пайдарпай ҳангоми ҷустуҷӯи афзоиши даромад мебошад.
Оё Даромади Баландтари DDPG Дар Бозори Воқеӣ Ҳам Ҳамин Гуна Интизор Мешавад?
Не. Таҳқиқот гузориш медиҳад, ки дар дохили як unified matching environment-и муайян DDPG нисбат ба се усули дигар иҷрои беҳтар нишон додааст. Ин натиҷа ба ҳамаи бозорҳои воқеии нерӯи барқ ё бозорҳое бо сохтори танзимии дигар худкорона умумӣ карда намешавад.
Барои ин чанд сабаб вуҷуд дорад:
- Манбаи мушаххаси бозорӣ ва ҷуғрофии маҷмӯи додаҳо ба таври возеҳ муайян нашудааст.
- Қоидаҳои пешниҳод, settlement ва иқтидор дар бозорҳои гуногуни нерӯи барқ метавонанд фарқ кунанд.
- Модел сохтори single-agent дорад.
- Мутобиқшавии стратегии иштирокчиёни рақиби бозор пурра моделсозӣ нашудааст.
- Худи манбаъ эътироф мекунад, ки сохтори extreme-tail shock бояд дар reward model муфассалтар баррасӣ шавад.
- Cross-region ва cross-market validation анҷом дода нашудааст.
- Такрорҳои random-seed ва confidence intervals гузориш нашудаанд.
- Қисми муҳими гиперпараметрҳои асосии омӯзиш бо арзишҳои ададӣ нишон дода нашудааст.
Эзоҳ дар бораи ибораи “%13,2 drawdown-и камтар”
Дар бахши натиҷаҳои манбаъ гуфта мешавад, ки maximum back-off %13,2 коҳиш ёфтааст. Аммо дар Ҷадвали 4 арзишҳои maximum drawdown барои Rule-based %14,8, барои DQN %12,9, барои PPO %11,4 ва барои DDPG %9,8 мебошанд.
Аз ин ҷадвал мустақиман:
- фарқи Rule-based → DDPG: 5,0 нуқтаи фоизӣ,
- фарқи DQN → DDPG: 3,1 нуқтаи фоизӣ,
- фарқи PPO → DDPG: 1,6 нуқтаи фоизӣ
ҳисоб карда мешавад.
Азбаски манбаъ нишон намедиҳад, ки арзиши %13,2 нисбат ба кадом заминаи муқоиса ҳисоб шудааст, Verianla ин нисбатро ҳамчун натиҷаи мустақили иҷро такрор намекунад.
Ҷанбаҳои қавии таҳқиқот
- Моделсозии масъалаи bidding-и бозори нерӯи барқ ҳамчун фазои амали пайваста.
- Якҷо кардани тағйирёбандаҳои нарх, муомила, маҳдудият ва хавф дар як сохтори state.
- Якҷо кардани Actor–Critic, replay buffer ва target network бо муҳити бозории ҳалқаи пӯшида.
- Гузориш додани drawdown ва latency дар баробари даромад.
- Пешниҳоди муқоисаҳои DQN, PPO ва rule-based якҷо.
- Гузаронидани ablation experiment барои чор модули муҳим.
Маҳдудиятҳои асосии методологӣ
- Market input, ки ҳамчун “HFT” таъриф шудааст, бо буридаҳои 5-дақиқагӣ нишон дода мешавад.
- Ба қадри кофӣ шарҳ дода нашудааст, ки додаҳо аз кадом бозор ва кадом санаҳо омадаанд.
- Тақсимоти train/validation/test муфассал дода нашудааст.
- Андозаи қабатҳои меъмории шабакаҳои Actor ва Critic гузориш нашудааст.
- Арзишҳои асосӣ, монанди learning rate, discount factor, soft-update coefficient ва replay-buffer capacity, мавҷуд нестанд.
- Сохтори exploration noise муфассал шарҳ дода нашудааст.
- Раванди hyperparameter tuning-и моделҳои муқоиса дода нашудааст.
- Якчанд random seed ва confidence interval гузориш нашудаанд.
- Тақсимоти санҷиши 12-ҳафтаина барои намояндагии режимҳои дарозмуддати бозор маҳдуд аст.
- Равиши single-agent рафтори стратегии рақибонро маҳдуд ифода мекунад.
Ёддошт оид ба Манбаъ ва Усул
Унвони аслӣ: Exploration of deep deterministic policy gradient algorithm in high-frequency trading strategy in power market
Муаллиф: Yunpeng Feng.
Муассиса: School of Automation Science and Engineering, South China University of Technology, Guangzhou, Guangdong, China.
Маҷалла: Ingegneria Sismica – International Journal of Earthquake Engineering.
Ҷилд / шумора: Volume 43 / Issue 2; дар PDF Anno XLIII – Num. 2 – 2026.
Саҳифаҳо: 1–23.
Санаи нашр: 30 Апрел 2026.
DOI: 10.65102/is2026549.
Иҷозатнома: Тибқи сиёсати расмии copyright-и маҷалла Creative Commons Attribution 4.0 International (CC BY 4.0).
Навъи таҳқиқот: Модели bidding-и пайвастаи бозори нерӯи барқ бар асоси Deep reinforcement learning; таҷрибаи муқоисавӣ ва ablation analysis дар дохили unified matching environment.
Усули асосӣ: Deep Deterministic Policy Gradient; Actor–Critic; target networks; experience replay; priority sampling; temporal feature encoding; attention aggregation; gated feature fusion.
Муқоисаҳои асосӣ: DQN, PPO ва rule-based bidding.
Натиҷаи асосӣ: Дар таҷрибаи манбаъ DDPG %18,7 даромади кумулятивӣ, 1,64 таносуби Sharpe, %9,8 maximum drawdown ва 7,8 ms миёнаи decision latency нишон додааст.
Додаҳо: 168.000 адад market time slice-и 5-дақиқагӣ, 42 тағйирёбандаи нарх, шаш bidding feature ва 18.400 settlement record.
Огоҳӣ дар бораи манбаи додаҳо: Гарчанде манбаъ навъҳои воридоти додаҳоро муфассал шарҳ медиҳад, номи бозори мушаххаси нерӯи барқ, минтақаи ҷуғрофӣ ва фосилаи дақиқи санаҳоро ба таври возеҳ гузориш намекунад.
Огоҳии истилоҳоти HFT: Азбаски state slice-ҳои 5-дақиқагӣ истифода мешаванд, мафҳуми басомади баланд дар таҳқиқот набояд бевосита бо таърифи HFT-и limit-order-book-и микросониягӣ дар бозорҳои коғазҳои қиматнок баробар карда шавад.
Огоҳии бозтавлид: Азбаски бисёр гиперпараметрҳои асосӣ, андозаи шабака, random seed ва тартиби муфассали тақсимоти додаҳо гузориш нашудаанд, бозтавлиди мустақил маҳдуд аст.
Огоҳии иҷро: Дар манбаъ ибораи “maximum back-off decreases by 13.2%” вуҷуд дорад; аммо Ҷадвали 4 арзиши истинодии ин фоизро ба таври возеҳ дастгирӣ намекунад. Аз ин рӯ дар баёни Verianla мустақиман арзишҳои ҷадвал истифода шудаанд.
Қобилияти умумисозӣ: Натиҷаҳо бо unified matching environment ва сохтори додаҳои мақола маҳдуданд; набояд ҳамчун иҷрои савдои зинда дар бозори воқеии нерӯи барқ шарҳ дода шаванд.
Шарҳ гузоред
Нишонии почтаи электронии шумо нашр намешавад. Майдонҳои ҳатмӣ бо * нишон дода шудаанд