

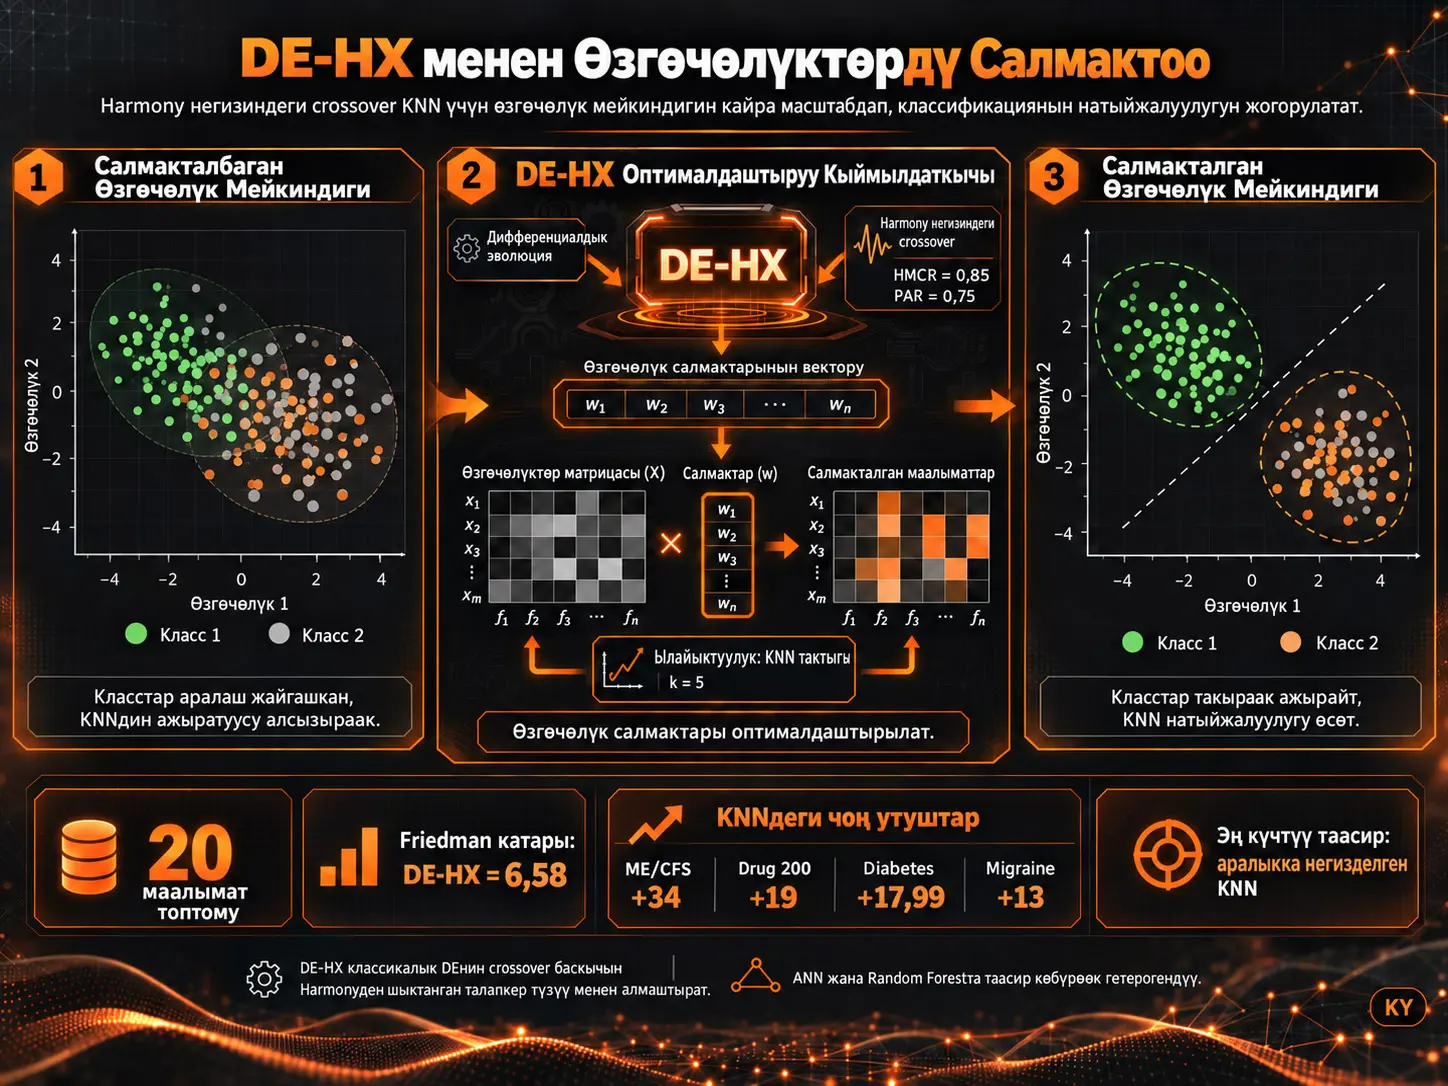
Белгилерди салмактоо, машиналык үйрөнүү моделинде бардык белгилер бирдей деңгээлде маанилүү деген божомолдон баш тартып, ар бир белгиге ар башка маанилүүлүк коэффициентин берүүнү көздөгөн маалыматты өзгөртүү ыкмасы. Бул изилдөө, айрыкча аралык эсептөөлөрүнө таянган k-эң жакын кошуна (KNN) алгоритми үчүн белгилердин салмактарын Дифференциалдык Эволюция (Differential Evolution, DE) аркылуу оптималдаштырууну жана классикалык crossover операторун Harmony Search принциптеринен шыктанган жаңы механизм менен алмаштырууну карайт.
Сунушталган DE-HX ыкмасында ар бир талапкер чечим белгилердин салмак вектору болуп саналат. Бул салмактар менен маалымат топтому кайра масштабдалат жана KNNдин 5-fold cross-validation тактыгы ылайыктуулук функциясы катары колдонулат. Классикалык DEде мутант жана максаттуу вектор binomial crossover аркылуу бириктирилгендин ордуна, DE-HX учурдагы популяцияны эс тутум катары колдонуп, ар бир өлчөм үчүн Harmony Memory Considering Rate (HMCR) жана Pitch Adjusting Rate (PAR) негизинде жаңы талапкер маанилерди түзөт.
Ыкма Kaggle жана UCI булактарынан алынган 20 ар түрдүү маалымат топтомунда бааланган. Натыйжалар DE-HX көптөгөн маалымат топтомдорунда классикалык DE, стандарттуу KNN, distance-weighted KNN жана ReliefF+KNNге караганда жогору Accuracy жана Macro-F1 камсыз кылганын көрсөтөт. Айрыкча ME/CFS vs. Depression, Diabetes Multiclass, Drug 200, Cryotherapy жана Migraine Classification сыяктуу маалымат топтомдорунда көрүнүктүү өсүштөр билдирилген.
Ошол эле учурда ыкма универсалдуу жакшыртуу механизми эмес. DE-HX салмактары ANN жана Random Forestка өткөрүлгөндө, жыйынтыктар маалымат топтомуна жараша жогорулашы, өзгөрбөй калышы же төмөндөшү мүмкүн. Изилдөөнүн жалпы жыйынтыгы — оптималдаштырылган белги салмактарынын эң табигый жана туруктуу пайдасы аралык геометриясына түздөн-түз көз каранды KNN сыяктуу моделдерде байкалат.
Эмне үчүн KNN белгилерди салмактоодон таасир алат?
KNN жаңы үлгүнү классификациялоодо анын маалымат топтомундагы башка үлгүлөр менен аралыкты эсептейт жана эң жакын \(k\) кошунанын көпчүлүк классын жаңы үлгүгө ыйгарат.
Стандарттуу Евклид аралыгында бардык белгилердин салымы бирдей математикалык масштабда бааланат. Бирок реалдуу маалымат топтомдорунда айрым белгилер класстарды күчтүү ажыратса, айрымдары классификация үчүн азыраак маалымат алып жүрүшү мүмкүн.
Ошондуктан изилдөө ар бир белгинин маанисин өзүнчө салмакка көбөйтүүнү сунуштайт:
\[ a_i^{(w)} = w_i a_i \]
Бул жерде \(a_i\) — баштапкы белги мааниси, \(w_i\) — тиешелүү белгинин салмагы, ал эми \(a_i^{(w)}\) — салмакталган маани.
Салмак чоңойгон сайын тиешелүү белги KNN аралык эсебинде көбүрөөк аныктоочу болот. Кичине салмак болсо ошол өлчөмдүн аралыкка кошкон салымын азайтат.
DE-HX Классикалык Дифференциалдык Эволюциядан Кантип Айырмаланат?
DE-HX классикалык Дифференциалдык Эволюция алгоритминин популяция, баалоо жана тандоо түзүмүн сактайт; бирок стандарттуу binomial crossover баскычын алып салып, анын ордуна Harmony Search принциптеринен шыктанган өлчөмгө негизделген талапкер түзүү механизмин колдонот.
Классикалык Дифференциалдык Эволюция
DE үзгүлтүксүз оптималдаштыруу маселелери үчүн колдонулган популяцияга негизделген метаэвристикалык ыкма. Изилдөөдө ар бир индивид:
\[ W=[w_1,w_2,\ldots,w_n] \]
түрүндөгү белги салмактарынын векторун билдирет.
Мутант вектор классикалык түрдө:
\[ v_i^{g}=x_{r1}^{g}+F(x_{r2}^{g}-x_{r3}^{g}) \]
теңдемеси менен түзүлөт.
Бул жерде \(F\) — мутацияны масштабдоо фактору; \(r_1\), \(r_2\) жана \(r_3\) — популяциядан тандалган ар башка индивиддер.
Андан кийин мутант жана максаттуу вектор binomial crossover аркылуу бириктирилет:
\[ u_{i,j}^{g}= \begin{cases} v_{i,j}^{g}, & rand_j \leq CR \text{ veya } j=j_{rand}\\ x_{i,j}^{g}, & \text{aksi halde} \end{cases} \]
Жаңы сыноо вектору жогорураак ылайыктуулук берсе, учурдагы индивиддин ордуна өтөт.
Harmony негизиндеги талапкер түзүү
DE-HXтин негизги айырмасы crossover баскычында. Система өзүнчө Harmony Memory түзбөйт. Учурдагы DE популяциясы ошол эле учурда талапкер компоненттери тандалуучу эс тутум катары кызмат кылат.
Ар бир \(j\) өлчөмү үчүн:
- ыктымалдык \(HMCR\) болсо, маани учурдагы популяциядагы башка чечимден алынат,
- болбосо издөө чектери \([L_b,U_b]\) ичинен кокус түзүлөт,
- ыктымалдык \(PAR\) болсо, тандалган мааниге жергиликтүү жөндөө колдонулат,
- маани жарактуу чектерде кармалат.
Изилдөөдө:
HMCR = 0,85
жана
PAR = 0,75
катары колдонулган.
Бул түзүм учурдагы жакшы чечимдерди пайдалануу менен жаңы аймактарды изилдөөнүн ортосундагы exploration–exploitation тең салмактуулугун классикалык crossoverдон башкача жөнгө салат.
Ылайыктуулук функциясы
Ар бир талапкер салмак вектору алгач маалымат топтомуна колдонулат. Андан кийин салмакталган маалымат KNN менен классификацияланат.
Изилдөөдө ылайыктуулук функциясы:
\[ fitness(W)=Accuracy(KNN(D\odot W)) \]
логикасына негизделет.
Бул жерде \(D\) — маалымат топтомун, \(W\) — салмак векторун, ал эми \(\odot\) — белги боюнча салмактоону билдирет.
KNN үчүн \(k=5\) жана Евклид аралыгы колдонулган.
Маалыматтар Кантип Даярдалды?
Изилдөөдө Kaggle жана UCI Machine Learning Repository булактарынан алынган 20 ар башка маалымат топтому колдонулган.
Маалымат топтомдору саламаттык, жүрүм-турум, айдоочулук күбөлүк, суусундук курамы, оюндагы жүрүм-турум, инсандык өзгөчөлүк, суунун сапаты жана шарап классификациясы сыяктуу ар башка көйгөй тармактарын камтыйт.
Категориялык өзгөрмөлөр эки жол менен өзгөртүлгөн:
- табигый ирети бар категориялар үчүн ordinal encoding,
- иреттүү байланышы жок категориялар үчүн one-hot encoding.
Сандык маанилер 1–10 аралыгына нормалдаштырылган:
\[ Norm(x_i) = \frac{x_i-x_{min}} {x_{max}-x_{min}} \times 9 + 1 \]
Авторлор бул масштабды өзгөчө өтө кичине floating-point маанилер менен иштебөө жана каталарды оңдоону жеңилдетүү үчүн колдонушканын белгилешет.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Эксперимент протоколу
Бардык эксперименттер 5-fold cross-validation менен жүргүзүлгөн.
Негизги параметрлер:
| Параметр | Маани |
|---|---|
| KNN кошуналардын саны | 5 |
| Аралык | Евклид |
| DE популяциясы | 12 |
| DE масштабдоо фактору \(F\) | 1 |
| DE-HX HMCR | 0,85 |
| DE-HX PAR | 0,75 |
| Салмак аралыгы | [0,1) |
| Random seed | 42 |
DE жана DE-HX бирдей баштапкы түзүмдү, бирдей ылайыктуулук функциясын жана stagnation негизиндеги токтотуу критерийин колдонгон.
DE-HX менен стандарттуу DEни салыштыруу
| Маалымат топтому | DE-HX Accuracy | DE Accuracy |
|---|---|---|
| Cirrhosis Patient Survival | 61,28 | 55,76 |
| Cryotherapy | 97,78 | 92,22 |
| Diabetes Multiclass | 98,87 | 96,23 |
| Drug 200 | 99,00 | 97,50 |
| ME/CFS vs. Depression | 99,60 | 90,80 |
| Migraine Classification | 91,50 | 86,25 |
| Spotify Recommendations | 96,41 | 93,85 |
DE-HX ар бир маалымат топтомунда үстөм эмес. Мисалы, Body Performance жана Customer Behavior сыяктуу айрым маалымат топтомдорунда стандарттуу DE жогорураак Accuracy берген. Ошондуктан ыкманы бардык маалымат топтомдорунда кепилденген артыкчылык бере турган оптималдаштыруу ыкмасы катары чечмелөөгө болбойт.
WeightedKNN жана ReliefF+KNN салыштырылышы
DE-HX ошондой эле distance-weighted KNN жана ReliefF негизиндеги KNN менен салыштырылган.
Мисалы:
- Diabetes Multiclass: DE-HX %98,87, WeightedKNN %85,98, ReliefF+KNN %92,42
- Heart Failure Clinical: DE-HX %90,30, WeightedKNN %84,75, ReliefF+KNN %83,44
- Migraine Classification: DE-HX %91,50, WeightedKNN %79,50, ReliefF+KNN %81,00
- Spotify Recommendations: DE-HX %96,41, WeightedKNN %90,26, ReliefF+KNN %91,79
Бул жыйынтыктар каралган эксперименттик түзүмдө DE-HX көптөгөн маалымат топтомдорунда күчтүү белги салмактоо ыкмасы экенин көрсөтөт.
Стандарттуу KNNге салыштырмалуу өсүштөр
DE-HX менен салмакталган KNNдин стандарттуу KNNге салыштырмалуу Accuracy өсүшү айрым маалымат топтомдорунда көңүл бурууга арзыйт:
| Маалымат топтому | KNN | DE-HX | Өсүш |
|---|---|---|---|
| ME/CFS vs. Depression | 65,60 | 99,60 | 34,00 упай |
| Drug 200 | 80,00 | 99,00 | 19,00 упай |
| Diabetes Multiclass | 80,88 | 98,87 | 17,99 упай |
| Migraine Classification | 78,50 | 91,50 | 13,00 упай |
| Body Performance | 55,69 | 68,44 | 12,75 упай |
Macro-F1 өсүштөрү
Macro-F1 боюнча да айрым маалымат топтомдорунда маанилүү айырмалар билдирилген:
- ME/CFS vs. Depression: +39,16 упай
- Migraine Classification: +37,21 упай
- Drug 200: +27,13 упай
- Diabetes Multiclass: +18,21 упай
- Body Performance: +12,70 упай
Macro-F1 өзгөчө класс бөлүштүрүлүшү тең салмаксыз болушу мүмкүн болгон маалымат топтомдорунда бир гана Accuracyге караганда тең салмактуу иштөө баасын берет.
Статистикалык Тесттер Эмнени Көрсөтөт?
Friedman тести жети ыкманын жалпы рейтингдеринде маанилүү айырма бар экенин көрсөткөн:
\[ \chi^2(6)=61{,}870,\quad p<0{,}001 \]
Орточо рейтингдер:
| Ыкма | Орточо орун |
|---|---|
| DE-HX | 6,58 |
| DE | 5,25 |
| Random Forest | 4,58 |
| ANN | 3,50 |
| ReliefF+KNN | 3,20 |
| WeightedKNN | 2,53 |
| KNN | 2,38 |
Holm post hoc түзөтүүсүнөн кийин DE-HX; RF, ANN, ReliefF+KNN, WeightedKNN жана KNNден статистикалык жактан маанилүү айырмаланган. Бирок DE-HX менен стандарттуу DEнин ортосундагы түзөтүлгөн маани:
p = 0,0515
болгон. Бул маани салттуу 0,05 чегинен бир аз жогору.
Ал эми түздөн-түз Wilcoxon signed-rank тестинде:
DE-HX vs. DE: p = 0,006, r = 0,652
жыйынтыгы билдирилген.
Демек, эки статистикалык талдоо ар башка түзөтүү контексттеринде окулушу керек; булактагы жыйынтыктарды “DE-HX бардык тесттерде талашсыз статистикалык маанилүү артыкчылык көрсөттү” деп жалпылоо туура эмес.
DE-HX Салмактары ANN жана Random Forestту да Жакшыртабы?
Ар дайым эмес. Үйрөнүлгөн DE-HX салмактары ANN жана Random Forestка кошумча модель-өзгөчө кайра оптималдаштыруусуз колдонулган. ANN айрым маалымат топтомдорунда көрүнүктүү жакшырса, айрымдарында начарлаган; Random Forestта болсо өзгөрүүлөр көбүнчө чакан жана маалымат топтомуна көз каранды.
ANNге таасири
Мисалы, ANN Accuracy:
- Cryotherapy боюнча ANN Accuracy %85,56 көрсөткүчүнөн %93,26 көрсөткүчүнө,
- Diabetes Multiclass боюнча %80,30 көрсөткүчүнөн %86,31 көрсөткүчүнө,
- ME/CFS vs. Depression боюнча %92,50 көрсөткүчүнөн %98,70 көрсөткүчүнө
жогорулаган.
Ал эми Migraine Classification боюнча %89,50 көрсөткүчүнөн %82,46 көрсөткүчүнө төмөндөгөн.
Бул жүрүм-турум тышкы белги салмактары нейрон тармагынын ички өкүлчүлүк үйрөнүү динамикасы менен ар дайым шайкеш боло бербеши мүмкүн экенин көрсөтөт.
Random Forestка таасири
Random Forest жыйынтыктары азыраак өзгөрөт. Булакта мунун себеби RF өзү эле random feature selection жана bagging сыяктуу ички белги тандоо механизмдерине ээ экени менен байланыштырылган.
Ошондуктан алдын ала колдонулган тышкы салмактоо RFге KNNдегидей ачык кошумча пайда бербейт.
Ыкманын эң табигый колдонуу тармагы
Булактын жалпы баалоосуна ылайык DE-HX эң күчтүү таасирин белгилер мейкиндигинин геометриясына түздөн-түз көз каранды аралыкка негизделген моделдерде көрсөтөт.
KNN бул жагынан табигый максат, анткени ар бир белги салмагы аралык эсептөөнү түздөн-түз өзгөртөт.
Изилдөөнүн Чектөөлөрү Кандай?
- Бир нече көз карандысыз оптималдаштыруу жүргүзүүсү аткарылган эмес.
- Nested cross-validation колдонулган эмес.
- Салыштыруулар туруктуу runtime же тең эсептөө бюджети боюнча жүргүзүлгөн эмес.
- Convergence plot берилген эмес.
- HMCR, PAR жана башка гиперпараметрлер үчүн кеңири sensitivity analysis жүргүзүлгөн эмес.
- Үйрөнүлгөн салмактардын жүргүзүүлөр арасындагы туруктуулугу талданган эмес.
- ANN жана RF өткөрүү эксперименттери модель-өзгөчө кайра tuning кылбастан жүргүзүлгөн.
- Жыйынтыктар маалымат топтомуна көз каранды жана DE-HX ар бир учурда эң жогорку көрсөткүчтү бербейт.
Авторлор келечектеги иштерде runtime жана convergence талдоосун, жергиликтүү издөө интеграциясын, гибрид жана ensemble түзүмдөрдү, ошондой эле нөлгө жакын салмактарды feature selection үчүн пайдалануу сыяктуу багыттарды изилдөөнү сунуштайт.
Булак жана Ыкма Жөнүндө Эскертүү
Бул Verianla мазмуну Andrea Ortega-Guzmán, Salvador Ibarra-Martínez, José Antonio Castan-Rocha, J. David Teran-Villanueva, Mayra Guadalupe Treviño-Berrones жана Aurelio Alejandro Santigo-Pineda тарабынан даярдалган Assessing Performance and Crossover Operators on Differential Evolution for Attribute Weighting аттуу академиялык ишке таянып өз алдынча даярдалган.
Макала AI журналында 2026-жылы, 7-том, 163-макала катары жарыяланган. DOI: 10.3390/ai7050163. Жарыяланган күнү 7-май 2026-жыл. Изилдөө MDPI тарабынан Creative Commons Attribution (CC BY) лицензиясы менен ачык жеткиликтүүлүктө жарыяланган.
Изилдөөнүн негизги ыкмасы ар бир маалымат топтому белгисине үзгүлтүксүз салмак ыйгарган Дифференциалдык Эволюцияга негизделген оптималдаштыруу процесси. Сунушталган DE-HX классикалык DEдеги binomial crossover баскычын Harmony Searchтен шыктанган талапкер түзүү механизми менен алмаштырат. Учурдагы DE популяциясы өзүнчө Harmony Memory түзбөстөн булак эс тутуму катары колдонулат.
KNNдин 5-fold cross-validation тактыгы оптималдаштыруунун ылайыктуулук функциясы болуп саналат. Эксперименттерде KNN үчүн k=5 жана Евклид аралыгы; DE-HX үчүн HMCR=0,85 жана PAR=0,75; классикалык DE үчүн F=1 колдонулган.
Ыкма 20 маалымат топтомунда бааланган; Accuracy жана Macro-F1 боюнча стандарттуу DE, KNN, WeightedKNN, ReliefF+KNN, ANN жана Random Forest менен салыштырылган. Friedman, Holm жана Wilcoxon тесттери жалпы жана жуптук статистикалык салыштыруулар үчүн колдонулган.
DE-HX стандарттуу DEге каршы түз Wilcoxon тестинде статистикалык маанилүү артыкчылык көрсөткөнү билдирилгени менен, Holm көп салыштырууларды түзөтүүсүнөн кийин DE-HX–DE айырмасы p=0,0515 экени көрсөтүлгөн. Ошондуктан статистикалык жыйынтыктар тесттин контекстин сактоо менен чечмелениши керек.
Авторлор тышкы каржылоо алынбаганын билдирген. Эксперимент коду жана баштапкы, ошондой эле алдын ала иштетилген маалымат топтомдору жеткиликтүү экени айтылган.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген