

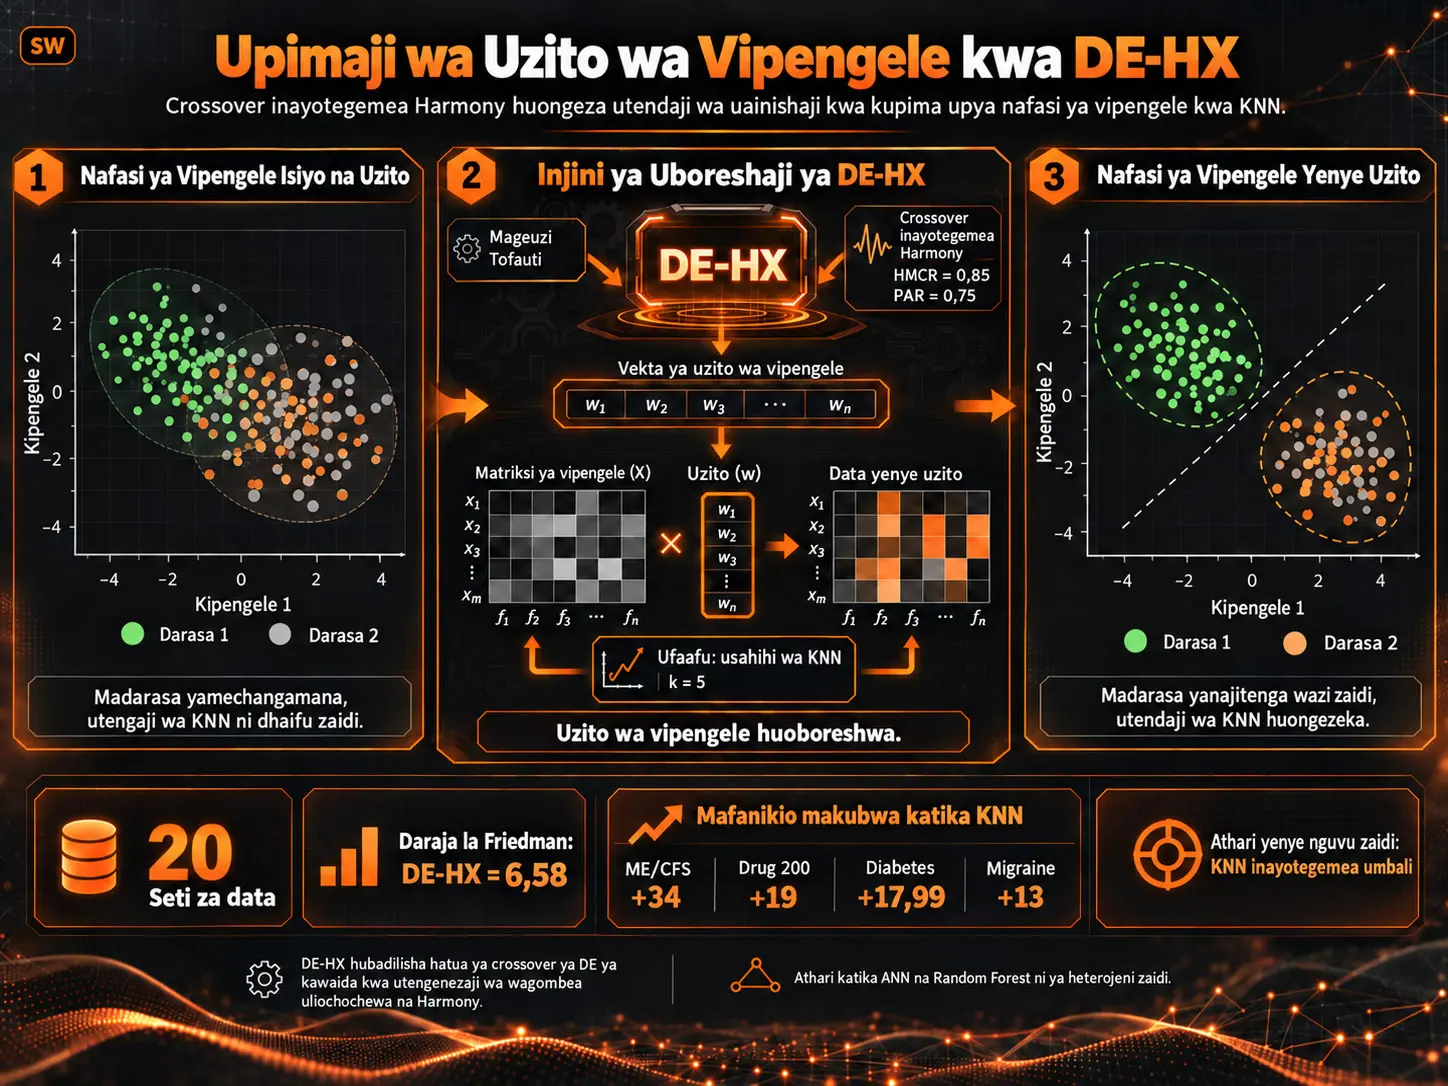
Uwekaji uzani wa vipengele, ni mbinu ya kubadilisha data inayolenga kuacha dhana kwamba vipengele vyote katika modeli ya ujifunzaji wa mashine vina umuhimu sawa na badala yake kukipa kila kipengele mgawo tofauti wa umuhimu. Utafiti huu unachunguza uboreshaji wa uzani wa vipengele kwa kutumia Differential Evolution (DE), hasa kwa algoriti ya k-nearest neighbors (KNN) inayotegemea hesabu za umbali, na kubadilisha opereta ya kawaida ya crossover kwa utaratibu mpya uliochochewa na kanuni za Harmony Search.
Katika mbinu iliyopendekezwa ya DE-HX, kila suluhisho teule ni vekta ya uzani wa vipengele. Seti ya data hupimwa upya kwa uzani huu na usahihi wa 5-fold cross-validation wa KNN hutumiwa kama fungsi ya ufaafu. Badala ya kuunganisha vekta mutant na vekta lengwa kwa binomial crossover katika DE ya kawaida, DE-HX hutumia idadi ya sasa kama kumbukumbu na hutengeneza thamani mpya teule kwa kila kipimo kwa msingi wa Harmony Memory Considering Rate (HMCR) na Pitch Adjusting Rate (PAR).
Mbinu ilitathminiwa kwenye seti 20 za data zenye utofauti kutoka Kaggle na UCI. Matokeo yanaonyesha kuwa DE-HX ilitoa Accuracy na Macro-F1 za juu kuliko DE ya kawaida, KNN ya kawaida, distance-weighted KNN na ReliefF+KNN katika seti nyingi za data. Maboresho yaliyo wazi yaliripotiwa hasa katika seti za data kama ME/CFS vs. Depression, Diabetes Multiclass, Drug 200, Cryotherapy na Migraine Classification.
Hata hivyo, mbinu hii si utaratibu wa uboreshaji wa jumla kwa kila hali. Uzani wa DE-HX unapohamishwa kwenda ANN na Random Forest, matokeo yanaweza kuongezeka, kubaki bila kubadilika au kupungua kulingana na seti ya data. Hitimisho la jumla la utafiti ni kwamba manufaa ya asili na thabiti zaidi ya uzani wa vipengele ulioboreshwa hupatikana katika modeli kama KNN ambazo zinategemea moja kwa moja jiometri ya umbali.
Kwa nini KNN huathiriwa na uwekaji uzani wa vipengele?
Wakati wa kuainisha sampuli mpya, KNN huhesabu umbali wake kutoka kwa sampuli nyingine katika seti ya data na kuipa sampuli hiyo darasa la walio wengi miongoni mwa majirani \(k\) walio karibu zaidi.
Katika umbali wa kawaida wa Euclidean, mchango wa vipengele vyote hutathminiwa katika kipimo kilekile cha kihisabati. Hata hivyo, katika seti halisi za data, baadhi ya vipengele vinaweza kutenganisha madarasa kwa nguvu huku vingine vikibeba taarifa kidogo kwa madhumuni ya uainishaji.
Kwa sababu hiyo, utafiti unapendekeza kuzidisha thamani ya kila kipengele kwa uzani wake tofauti:
\[ a_i^{(w)} = w_i a_i \]
Hapa \(a_i\) ni thamani ya awali ya kipengele, \(w_i\) ni uzani wa kipengele husika, na \(a_i^{(w)}\) ni thamani iliyowekewa uzani.
Uzani unapoongezeka, kipengele husika huwa na ushawishi mkubwa zaidi katika hesabu ya umbali wa KNN. Uzani mdogo hupunguza mchango wa kipimo hicho katika umbali.
DE-HX Inatofautianaje na Differential Evolution ya Kawaida?
DE-HX huhifadhi muundo wa idadi, tathmini na uteuzi wa algoriti ya kawaida ya Differential Evolution; hata hivyo, huondoa hatua ya kawaida ya binomial crossover na badala yake hutumia utaratibu wa kutengeneza wagombea kwa kila kipimo uliochochewa na kanuni za Harmony Search.
Differential Evolution ya Kawaida
DE ni mbinu ya metaheuristic inayotegemea idadi ya suluhisho na hutumika kwa matatizo ya uboreshaji endelevu. Katika utafiti, kila mtu binafsi:
\[ W=[w_1,w_2,\ldots,w_n] \]
huwakilisha vekta ya uzani wa vipengele katika umbo hilo.
Vekta mutant hutengenezwa kwa kawaida kama ifuatavyo:
\[ v_i^{g}=x_{r1}^{g}+F(x_{r2}^{g}-x_{r3}^{g}) \]
kwa mlinganyo huo.
Hapa \(F\) ni kipengele cha kupima mutasheni; \(r_1\), \(r_2\) na \(r_3\) ni watu tofauti waliochaguliwa kutoka katika idadi.
Kisha vekta mutant na vekta lengwa huunganishwa kwa binomial crossover:
\[ u_{i,j}^{g}= \begin{cases} v_{i,j}^{g}, & rand_j \leq CR \text{ veya } j=j_{rand}\\ x_{i,j}^{g}, & \text{aksi halde} \end{cases} \]
Ikiwa vekta mpya ya majaribio inatoa ufaafu wa juu zaidi, inachukua nafasi ya mtu binafsi aliyepo.
Utengenezaji wa wagombea unaotegemea Harmony
Tofauti kuu ya DE-HX iko katika hatua ya crossover. Mfumo hautengenezi Harmony Memory tofauti. Idadi ya sasa ya DE pia hutumika kama kumbukumbu ambayo vipengele vya wagombea huchaguliwa kutoka humo.
Kwa kila kipimo \(j\):
- ikiwa uwezekano ni \(HMCR\), thamani huchukuliwa kutoka suluhisho jingine katika idadi iliyopo,
- vinginevyo huzalishwa kwa nasibu ndani ya mipaka ya utafutaji \([L_b,U_b]\),
- ikiwa uwezekano ni \(PAR\), marekebisho ya ndani hutumika kwa thamani iliyochaguliwa,
- thamani huwekwa ndani ya mipaka halali.
Katika utafiti:
HMCR = 0,85
na
PAR = 0,75
zilitumika.
Muundo huu hupanga uwiano wa exploration–exploitation kati ya kutumia suluhisho nzuri zilizopo na kuchunguza maeneo mapya kwa namna tofauti na crossover ya kawaida.
Fungsi ya ufaafu
Kila vekta ya uzani teule hutumika kwanza kwenye seti ya data. Kisha data iliyowekewa uzani huainishwa kwa KNN.
Katika utafiti, fungsi ya ufaafu:
\[ fitness(W)=Accuracy(KNN(D\odot W)) \]
inatokana na mantiki hiyo.
Hapa \(D\) inawakilisha seti ya data, \(W\) vekta ya uzani, na \(\odot\) uwekaji uzani kwa kila kipengele.
Kwa KNN, \(k=5\) na umbali wa Euclidean vilitumika.
Data Ziliandaliwa Vipi?
Utafiti ulitumia seti 20 tofauti za data zilizopatikana kutoka Kaggle na UCI Machine Learning Repository.
Seti hizo za data zinahusisha maeneo tofauti ya matatizo kama afya, tabia, leseni ya udereva, maudhui ya vinywaji, tabia ya michezo, utu, ubora wa maji na uainishaji wa divai.
Vigeu vya kikategoria vilibadilishwa kwa njia mbili:
- ordinal encoding kwa makundi yenye mpangilio wa asili,
- one-hot encoding kwa makundi yasiyo na uhusiano wa mpangilio.
Thamani za nambari zilinormalishwa katika masafa ya 1–10:
\[ Norm(x_i) = \frac{x_i-x_{min}} {x_{max}-x_{min}} \times 9 + 1 \]
Waandishi wanaeleza kwamba walitumia kipimo hiki hasa ili kuepuka kushughulika na thamani ndogo sana za floating-point na kurahisisha utatuzi wa hitilafu.
Mbinu na Matokeo ya Utafiti
Itifaki ya majaribio
Majaribio yote yalifanywa kwa 5-fold cross-validation.
Vigezo vikuu:
| Kigezo | Thamani |
|---|---|
| Idadi ya majirani wa KNN | 5 |
| Umbali | Euclidean |
| Idadi ya DE | 12 |
| Kipengele cha kupima DE \(F\) | 1 |
| DE-HX HMCR | 0,85 |
| DE-HX PAR | 0,75 |
| Masafa ya uzani | [0,1) |
| Random seed | 42 |
DE na DE-HX zilitumia mpangilio uleule wa mwanzo, fungsi ileile ya ufaafu na kigezo cha kusimamisha kinachotegemea stagnation.
Ulinganisho wa DE-HX na DE ya kawaida
| Seti ya data | DE-HX Accuracy | DE Accuracy |
|---|---|---|
| Cirrhosis Patient Survival | 61,28 | 55,76 |
| Cryotherapy | 97,78 | 92,22 |
| Diabetes Multiclass | 98,87 | 96,23 |
| Drug 200 | 99,00 | 97,50 |
| ME/CFS vs. Depression | 99,60 | 90,80 |
| Migraine Classification | 91,50 | 86,25 |
| Spotify Recommendations | 96,41 | 93,85 |
DE-HX si bora katika kila seti ya data. Kwa mfano, katika baadhi ya seti kama Body Performance na Customer Behavior, DE ya kawaida ilitoa Accuracy ya juu zaidi. Kwa hiyo, mbinu hii haipaswi kutafsiriwa kama njia ya uboreshaji inayohakikisha ubora katika seti zote za data.
Ulinganisho wa WeightedKNN na ReliefF+KNN
DE-HX pia ililinganishwa na distance-weighted KNN na KNN inayotegemea ReliefF.
Kwa mfano:
- Diabetes Multiclass: DE-HX %98,87, WeightedKNN %85,98, ReliefF+KNN %92,42
- Heart Failure Clinical: DE-HX %90,30, WeightedKNN %84,75, ReliefF+KNN %83,44
- Migraine Classification: DE-HX %91,50, WeightedKNN %79,50, ReliefF+KNN %81,00
- Spotify Recommendations: DE-HX %96,41, WeightedKNN %90,26, ReliefF+KNN %91,79
Matokeo haya yanaonyesha kwamba katika mpangilio wa majaribio uliochunguzwa, DE-HX ni mbinu yenye nguvu ya uwekaji uzani wa vipengele katika seti nyingi za data.
Maboresho dhidi ya KNN ya kawaida
Ongezeko la Accuracy la KNN iliyowekewa uzani kwa DE-HX dhidi ya KNN ya kawaida ni kubwa katika baadhi ya seti za data:
| Seti ya data | KNN | DE-HX | Ongezeko |
|---|---|---|---|
| ME/CFS vs. Depression | 65,60 | 99,60 | pointi 34,00 |
| Drug 200 | 80,00 | 99,00 | pointi 19,00 |
| Diabetes Multiclass | 80,88 | 98,87 | pointi 17,99 |
| Migraine Classification | 78,50 | 91,50 | pointi 13,00 |
| Body Performance | 55,69 | 68,44 | pointi 12,75 |
Maboresho ya Macro-F1
Kwa Macro-F1 pia, tofauti muhimu ziliripotiwa katika baadhi ya seti za data:
- ME/CFS vs. Depression: pointi +39,16
- Migraine Classification: pointi +37,21
- Drug 200: pointi +27,13
- Diabetes Multiclass: pointi +18,21
- Body Performance: pointi +12,70
Macro-F1 hutoa tathmini ya utendaji iliyo na uwiano zaidi kuliko Accuracy pekee, hasa katika seti za data ambazo usambazaji wa madarasa unaweza kutokuwa na uwiano.
Vipimo vya Kitakwimu Vinaonyesha Nini?
Jaribio la Friedman lilionyesha kuwa kulikuwa na tofauti yenye maana katika nafasi za jumla za mbinu saba:
\[ \chi^2(6)=61{,}870,\quad p<0{,}001 \]
Nafasi za wastani:
| Mbinu | Nafasi ya wastani |
|---|---|
| DE-HX | 6,58 |
| DE | 5,25 |
| Random Forest | 4,58 |
| ANN | 3,50 |
| ReliefF+KNN | 3,20 |
| WeightedKNN | 2,53 |
| KNN | 2,38 |
Baada ya marekebisho ya Holm post hoc, DE-HX ilibainika kuwa tofauti kwa kiwango cha maana na RF, ANN, ReliefF+KNN, WeightedKNN na KNN. Hata hivyo, thamani iliyorekebishwa kati ya DE-HX na DE ya kawaida ilikuwa:
p = 0,0515
Thamani hii ilikuwa juu kidogo ya mpaka wa kawaida wa 0,05.
Kwa upande mwingine, katika jaribio la moja kwa moja la Wilcoxon signed-rank:
DE-HX vs. DE: p = 0,006, r = 0,652
matokeo hayo yaliripotiwa.
Kwa hiyo, uchanganuzi huo miwili wa kitakwimu unapaswa kusomwa katika miktadha tofauti ya marekebisho; si sahihi kujumlisha matokeo ya chanzo kama “DE-HX ilionyesha ubora wenye maana usiopingika katika vipimo vyote.”
Je, Uzani wa DE-HX Pia Huboresha ANN na Random Forest?
Si kila wakati. Uzani uliopatikana kwa DE-HX ulitumika kwa ANN na Random Forest bila uboreshaji upya wa ziada mahususi kwa modeli. ANN ilionyesha maboresho makubwa katika baadhi ya seti za data lakini ikashuka katika nyingine; kwa Random Forest, mabadiliko yalikuwa kwa kawaida madogo na yalitegemea seti ya data.
Athari kwa ANN
Kwa mfano, ANN Accuracy:
- katika Cryotherapy iliongezeka kutoka %85,56 hadi %93,26,
- katika Diabetes Multiclass kutoka %80,30 hadi %86,31,
- katika ME/CFS vs. Depression kutoka %92,50 hadi %98,70
iliongezeka.
Kwa upande mwingine, katika Migraine Classification ilishuka kutoka %89,50 hadi %82,46.
Tabia hii inaonyesha kwamba uzani wa vipengele wa nje huenda usilingane kila wakati na mienendo ya ndani ya ujifunzaji wa uwakilishi katika mtandao wa neva.
Athari kwa Random Forest
Matokeo ya Random Forest hubadilika kwa kiwango kidogo zaidi. Chanzo kinahusisha sababu hii na ukweli kwamba RF tayari ina taratibu zake za ndani za uteuzi wa vipengele, kama random feature selection na bagging.
Kwa hiyo, uwekaji uzani wa nje uliotumika mapema hauleti manufaa ya ziada yaliyo wazi kwa RF kama ilivyo kwa KNN.
Eneo la asili zaidi la matumizi ya mbinu
Kwa mujibu wa tathmini ya jumla ya chanzo, DE-HX huonyesha athari yake yenye nguvu zaidi katika modeli zinazotegemea umbali ambazo hutegemea moja kwa moja jiometri ya nafasi ya vipengele.
KNN ni lengo la asili kwa mtazamo huu kwa sababu kila uzani wa kipengele hubadilisha moja kwa moja hesabu ya umbali.
Mapungufu ya Utafiti ni Yapi?
- Majaribio mengi huru ya uboreshaji hayakufanywa.
- Nested cross-validation haikutumika.
- Ulinganisho haukufanywa kwa runtime thabiti au bajeti sawa ya ukokotoaji.
- Convergence plot haikutolewa.
- Sensitivity analysis ya kina haikufanywa kwa HMCR, PAR na hiperparameta nyingine.
- Uthabiti wa uzani uliopatikana kati ya marudio haukuchanganuliwa.
- Majaribio ya kuhamisha uzani kwa ANN na RF yalifanywa bila tuning upya mahususi kwa modeli.
- Matokeo yanategemea seti ya data na DE-HX haitoi utendaji wa juu zaidi katika kila hali.
Waandishi wanapendekeza katika kazi za baadaye kuchunguza uchanganuzi wa runtime na convergence, ujumuishaji wa utafutaji wa ndani, miundo ya hybrid na ensemble, na matumizi ya uzani ulio karibu na sifuri kwa feature selection.
Maelezo ya Chanzo na Mbinu
Maudhui haya ya Verianla yameandaliwa kwa kujitegemea kwa kutegemea kazi ya kitaaluma iliyoandaliwa na Andrea Ortega-Guzmán, Salvador Ibarra-Martínez, José Antonio Castan-Rocha, J. David Teran-Villanueva, Mayra Guadalupe Treviño-Berrones na Aurelio Alejandro Santigo-Pineda yenye kichwa Assessing Performance and Crossover Operators on Differential Evolution for Attribute Weighting.
Makala yalichapishwa katika jarida la AI mwaka 2026, Juzuu 7, Makala 163. DOI: 10.3390/ai7050163. Tarehe ya kuchapishwa ni 7 Mei 2026. Utafiti ulichapishwa na MDPI kwa ufikiaji wazi chini ya leseni ya Creative Commons Attribution (CC BY).
Mbinu kuu ya utafiti ni mchakato wa uboreshaji unaotegemea Differential Evolution ambao huipa kila kipengele cha seti ya data uzani endelevu. DE-HX iliyopendekezwa hubadilisha hatua ya binomial crossover ya DE ya kawaida kwa utaratibu wa kutengeneza wagombea uliochochewa na Harmony Search. Idadi ya sasa ya DE hutumiwa kama kumbukumbu chanzo bila Harmony Memory tofauti.
Usahihi wa 5-fold cross-validation wa KNN ndio fungsi ya ufaafu ya uboreshaji. Katika majaribio, kwa KNN zilitumika k=5 na umbali wa Euclidean; kwa DE-HX HMCR=0,85 na PAR=0,75; na kwa DE ya kawaida F=1.
Mbinu ilitathminiwa kwenye seti 20 za data; kwa Accuracy na Macro-F1 ililinganishwa na DE ya kawaida, KNN, WeightedKNN, ReliefF+KNN, ANN na Random Forest. Vipimo vya Friedman, Holm na Wilcoxon vilitumika kwa ulinganisho wa jumla na wa jozi wa kitakwimu.
Ingawa iliripotiwa kuwa DE-HX ilionyesha ubora wenye maana dhidi ya DE ya kawaida katika jaribio la moja kwa moja la Wilcoxon, baada ya marekebisho ya Holm kwa ulinganisho mwingi, tofauti ya DE-HX–DE iliripotiwa kuwa p=0,0515. Kwa hiyo, matokeo ya kitakwimu yanapaswa kufasiriwa huku muktadha wa kipimo ukihifadhiwa.
Waandishi waliripoti kutopokea ufadhili wa nje. Imeelezwa kuwa msimbo wa majaribio pamoja na seti za data asili na zilizochakatwa awali zinapatikana.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *