

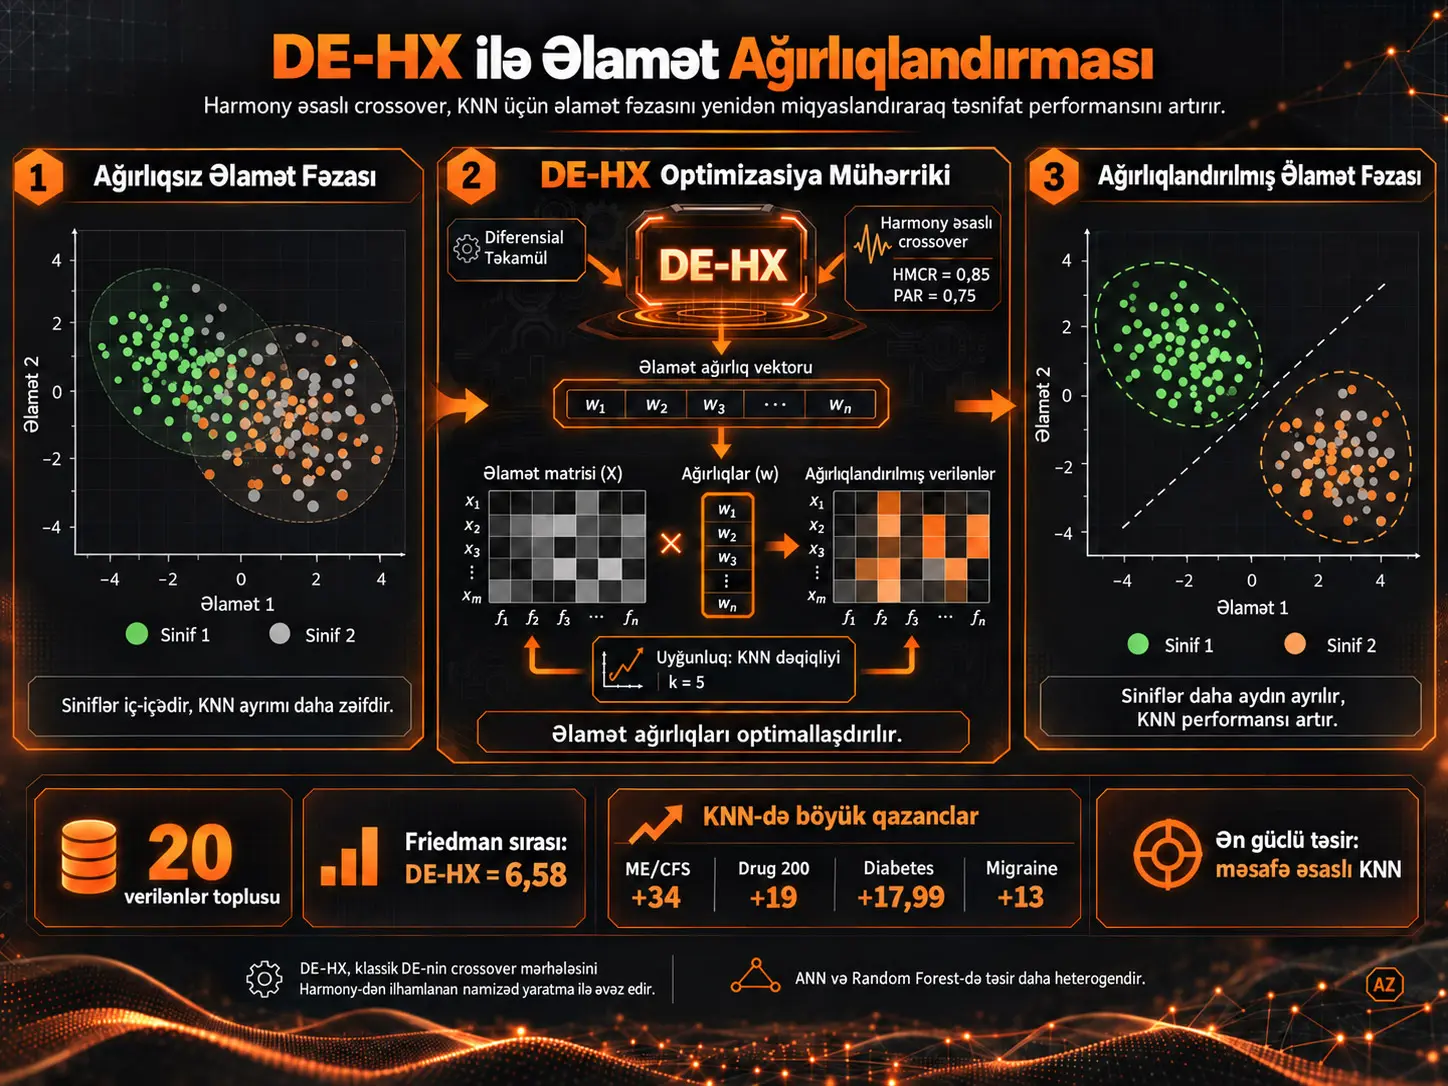
Xüsusiyyətlərin çəkiləndirilməsi, maşın öyrənməsi modelində bütün xüsusiyyətlərin eyni dərəcədə vacib olduğu fərziyyəsindən imtina edib hər bir xüsusiyyətə fərqli əhəmiyyət əmsalı verməyi hədəfləyən məlumat çevirmə yanaşmasıdır. Bu tədqiqat xüsusilə məsafə hesablamalarına əsaslanan k-ən yaxın qonşu (KNN) alqoritmi üçün xüsusiyyət çəkilərinin Diferensial Təkamül (Differential Evolution, DE) ilə optimallaşdırılmasını və klassik crossover operatorunun Harmony Search prinsiplərindən ilhamlanan yeni mexanizmlə əvəz edilməsini araşdırır.
Təklif olunan DE-HX metodunda hər namizəd həll xüsusiyyət çəkisi vektorudur. Bu çəkilərlə məlumat dəsti yenidən miqyaslanır və KNN-in 5-fold cross-validation dəqiqliyi uyğunluq funksiyası kimi istifadə olunur. Klassik DE-də mutant və hədəf vektorunun binomial crossover ilə birləşdirilməsi əvəzinə DE-HX mövcud populyasiyanı yaddaş kimi istifadə edərək hər ölçü üçün Harmony Memory Considering Rate (HMCR) və Pitch Adjusting Rate (PAR) əsasında yeni namizəd qiymətlər yaradır.
Metod Kaggle və UCI mənbəli 20 heterogen məlumat dəstində qiymətləndirilmişdir. Nəticələr DE-HX-in bir çox məlumat dəstində klassik DE, standart KNN, distance-weighted KNN və ReliefF+KNN-dən daha yüksək Accuracy və Macro-F1 təmin etdiyini göstərir. Xüsusilə ME/CFS vs. Depression, Diabetes Multiclass, Drug 200, Cryotherapy və Migraine Classification kimi məlumat dəstlərində nəzərəçarpan qazanclar bildirilmişdir.
Bununla belə, metod universal yaxşılaşdırma mexanizmi deyil. DE-HX çəkiləri ANN və Random Forest-a ötürüldükdə nəticələr məlumat dəstindən asılı olaraq arta, dəyişməz qala və ya azala bilər. Tədqiqatın ümumi nəticəsi odur ki, optimallaşdırılmış xüsusiyyət çəkilərinin ən təbii və ardıcıl faydası məsafə həndəsəsindən birbaşa asılı olan KNN kimi modellərdə əldə edilir.
KNN niyə xüsusiyyətlərin çəkiləndirilməsindən təsirlənir?
KNN yeni nümunəni təsnif edərkən onun məlumat dəstindəki digər nümunələrlə məsafəsini hesablayır və ən yaxın \(k\) qonşunun çoxluq sinfini yeni nümunəyə təyin edir.
Standart Evklid məsafəsində bütün xüsusiyyətlərin töhfəsi eyni riyazi miqyasda qiymətləndirilir. Lakin real məlumat dəstlərində bəzi xüsusiyyətlər sinifləri güclü şəkildə ayırdığı halda, bəziləri təsnifat baxımından daha az informasiya daşıya bilər.
Buna görə tədqiqat hər bir xüsusiyyətin qiymətini ayrıca çəki ilə vurmağı təklif edir:
\[ a_i^{(w)} = w_i a_i \]
Burada \(a_i\) ilkin xüsusiyyət qiyməti, \(w_i\) müvafiq xüsusiyyətin çəkisi, \(a_i^{(w)}\) isə çəkiləndirilmiş qiymətdir.
Çəki böyüdükcə müvafiq xüsusiyyət KNN məsafə hesabında daha müəyyənedici olur. Kiçik çəki isə həmin ölçünün məsafəyə töhfəsini azaldır.
DE-HX Klassik Diferensial Təkamüldən Necə Fərqlənir?
DE-HX klassik Diferensial Təkamül alqoritminin populyasiya, qiymətləndirmə və seçim strukturunu qoruyur; lakin standart binomial crossover mərhələsini aradan qaldıraraq onun yerinə Harmony Search prinsiplərindən ilhamlanan ölçü-əsaslı namizəd yaratma mexanizmi tətbiq edir.
Klassik Diferensial Təkamül
DE fasiləsiz optimallaşdırma problemləri üçün istifadə olunan populyasiya əsaslı meta-evristik üsuldur. Tədqiqatda hər fərd:
\[ W=[w_1,w_2,\ldots,w_n] \]
formasında xüsusiyyət çəkisi vektorunu təmsil edir.
Mutant vektor klassik şəkildə:
\[ v_i^{g}=x_{r1}^{g}+F(x_{r2}^{g}-x_{r3}^{g}) \]
bərabərliyi ilə yaradılır.
Burada \(F\) mutasiya miqyaslama faktorudur; \(r_1\), \(r_2\) və \(r_3\) populyasiyadan seçilən fərqli fərdlərdir.
Daha sonra mutant və hədəf vektoru binomial crossover ilə birləşdirilir:
\[ u_{i,j}^{g}= \begin{cases} v_{i,j}^{g}, & rand_j \leq CR \text{ veya } j=j_{rand}\\ x_{i,j}^{g}, & \text{aksi halde} \end{cases} \]
Yeni sınaq vektoru daha yüksək uyğunluq təmin edərsə, mövcud fərdi əvəz edir.
Harmony əsaslı namizəd yaradılması
DE-HX-in əsas fərqi crossover mərhələsindədir. Sistem ayrıca Harmony Memory yaratmır. Mövcud DE populyasiyası eyni zamanda namizəd komponentlərinin seçildiyi yaddaş rolunu oynayır.
Hər \(j\) ölçüsü üçün:
- ehtimal \(HMCR\) olduqda qiymət mövcud populyasiyadakı başqa həllindən götürülür,
- əks halda axtarış sərhədləri \([L_b,U_b]\) daxilindən təsadüfi yaradılır,
- ehtimal \(PAR\) olduqda seçilmiş qiymətə lokal tənzimləmə tətbiq edilir,
- qiymət etibarlı sərhədlər daxilində saxlanılır.
Tədqiqatda:
HMCR = 0,85
və
PAR = 0,75
kimi istifadə edilmişdir.
Bu struktur mövcud yaxşı həllərdən istifadə ilə yeni sahələrin araşdırılması arasındakı exploration–exploitation balansını klassik crossover-dan fərqli şəkildə tənzimləyir.
Uyğunluq funksiyası
Hər namizəd çəki vektoru əvvəlcə məlumat dəstinə tətbiq olunur. Sonra çəkiləndirilmiş məlumat KNN ilə təsnif edilir.
Tədqiqatda uyğunluq funksiyası:
\[ fitness(W)=Accuracy(KNN(D\odot W)) \]
məntiqinə əsaslanır.
Burada \(D\) məlumat dəstini, \(W\) çəki vektorunu və \(\odot\) xüsusiyyət-əsaslı çəkiləndirməni təmsil edir.
KNN üçün \(k=5\) və Evklid məsafəsi istifadə edilmişdir.
Məlumatlar Necə Hazırlandı?
Tədqiqatda Kaggle və UCI Machine Learning Repository mənbələrindən alınmış 20 fərqli məlumat dəsti istifadə edilmişdir.
Məlumat dəstləri sağlamlıq, davranış, sürücülük vəsiqəsi, içki tərkibi, oyun davranışı, şəxsiyyət, su keyfiyyəti və şərab təsnifatı kimi müxtəlif problem sahələrini əhatə edir.
Kateqorik dəyişənlər iki üsulla çevrilmişdir:
- təbii sıralaması olan kateqoriyalar üçün ordinal encoding,
- sıralı əlaqəsi olmayan kateqoriyalar üçün one-hot encoding.
Ədədi qiymətlər 1–10 aralığına normallaşdırılmışdır:
\[ Norm(x_i) = \frac{x_i-x_{min}} {x_{max}-x_{min}} \times 9 + 1 \]
Müəlliflər bu miqyasdan xüsusilə çox kiçik floating-point qiymətlərlə işləməmək və sazlama prosesini asanlaşdırmaq məqsədilə istifadə etdiklərini bildirirlər.
Tədqiqatın Metodu və Nəticələri
Eksperiment protokolu
Bütün eksperimentlər 5-fold cross-validation ilə həyata keçirilmişdir.
Əsas parametrlər:
| Parametr | Qiymət |
|---|---|
| KNN qonşu sayı | 5 |
| Məsafə | Evklid |
| DE populyasiyası | 12 |
| DE miqyas faktoru \(F\) | 1 |
| DE-HX HMCR | 0,85 |
| DE-HX PAR | 0,75 |
| Çəki aralığı | [0,1) |
| Random seed | 42 |
DE və DE-HX eyni başlanğıc quruluşundan, eyni uyğunluq funksiyasından və stagnation əsaslı dayandırma meyarından istifadə etmişdir.
DE-HX və standart DE müqayisəsi
| Məlumat dəsti | DE-HX Accuracy | DE Accuracy |
|---|---|---|
| Cirrhosis Patient Survival | 61,28 | 55,76 |
| Cryotherapy | 97,78 | 92,22 |
| Diabetes Multiclass | 98,87 | 96,23 |
| Drug 200 | 99,00 | 97,50 |
| ME/CFS vs. Depression | 99,60 | 90,80 |
| Migraine Classification | 91,50 | 86,25 |
| Spotify Recommendations | 96,41 | 93,85 |
DE-HX hər məlumat dəstində üstün deyil. Məsələn, Body Performance və Customer Behavior kimi bəzi məlumat dəstlərində standart DE daha yüksək Accuracy vermişdir. Buna görə metod bütün məlumat dəstlərində zəmanətli üstünlük təmin edən optimallaşdırma üsulu kimi şərh edilməməlidir.
WeightedKNN və ReliefF+KNN müqayisəsi
DE-HX həmçinin distance-weighted KNN və ReliefF əsaslı KNN ilə müqayisə edilmişdir.
Məsələn:
- Diabetes Multiclass: DE-HX %98,87, WeightedKNN %85,98, ReliefF+KNN %92,42
- Heart Failure Clinical: DE-HX %90,30, WeightedKNN %84,75, ReliefF+KNN %83,44
- Migraine Classification: DE-HX %91,50, WeightedKNN %79,50, ReliefF+KNN %81,00
- Spotify Recommendations: DE-HX %96,41, WeightedKNN %90,26, ReliefF+KNN %91,79
Bu nəticələr araşdırılan eksperiment quruluşunda DE-HX-in bir çox məlumat dəstində güclü xüsusiyyət çəkiləndirmə yanaşması olduğunu göstərir.
Standart KNN ilə müqayisədə qazanclar
DE-HX ilə çəkiləndirilmiş KNN-in standart KNN ilə müqayisədə Accuracy artımı bəzi məlumat dəstlərində diqqətəlayiqdir:
| Məlumat dəsti | KNN | DE-HX | Artım |
|---|---|---|---|
| ME/CFS vs. Depression | 65,60 | 99,60 | 34,00 bənd |
| Drug 200 | 80,00 | 99,00 | 19,00 bənd |
| Diabetes Multiclass | 80,88 | 98,87 | 17,99 bənd |
| Migraine Classification | 78,50 | 91,50 | 13,00 bənd |
| Body Performance | 55,69 | 68,44 | 12,75 bənd |
Macro-F1 qazancları
Macro-F1 baxımından da bəzi məlumat dəstlərində mühüm fərqlər bildirilmişdir:
- ME/CFS vs. Depression: +39,16 bənd
- Migraine Classification: +37,21 bənd
- Drug 200: +27,13 bənd
- Diabetes Multiclass: +18,21 bənd
- Body Performance: +12,70 bənd
Macro-F1 xüsusilə sinif paylanmasının balanssız ola biləcəyi məlumat dəstlərində yalnız Accuracy ilə müqayisədə daha balanslı performans qiymətləndirməsi təqdim edir.
Statistik Testlər Nə Göstərir?
Friedman testi yeddi metodun ümumi sıralamalarında əhəmiyyətli fərq olduğunu göstərmişdir:
\[ \chi^2(6)=61{,}870,\quad p<0{,}001 \]
Orta sıralamalar:
| Metod | Orta sıra |
|---|---|
| DE-HX | 6,58 |
| DE | 5,25 |
| Random Forest | 4,58 |
| ANN | 3,50 |
| ReliefF+KNN | 3,20 |
| WeightedKNN | 2,53 |
| KNN | 2,38 |
Holm post hoc düzəlişindən sonra DE-HX; RF, ANN, ReliefF+KNN, WeightedKNN və KNN-dən əhəmiyyətli dərəcədə fərqli tapılmışdır. Lakin DE-HX ilə standart DE arasındakı düzəldilmiş qiymət:
p = 0,0515
olmuşdur. Bu qiymət ənənəvi 0,05 həddinin dərhal üzərindədir.
Bunun əksinə, birbaşa Wilcoxon signed-rank testində:
DE-HX vs. DE: p = 0,006, r = 0,652
nəticəsi bildirilmişdir.
Buna görə iki statistik analiz fərqli düzəliş kontekstlərində oxunmalıdır; mənbə nəticələrini “DE-HX bütün testlərdə mübahisəsiz şəkildə əhəmiyyətli üstünlük göstərmişdir” kimi ümumiləşdirmək düzgün deyil.
DE-HX Çəkiləri ANN və Random Forest-ı da Yaxşılaşdırırmı?
Həmişə yox. Öyrənilmiş DE-HX çəkiləri ANN və Random Forest-a əlavə model-spesifik yenidən optimallaşdırma aparılmadan tətbiq edilmişdir. ANN bəzi məlumat dəstlərində nəzərəçarpan yaxşılaşma göstərərkən, bəzilərində geriləmişdir; Random Forest-da isə dəyişikliklər əsasən kiçik və məlumat dəstindən asılıdır.
ANN üzərində təsir
Məsələn, ANN Accuracy:
- Cryotherapy-də %85,56-dan %93,26-ya,
- Diabetes Multiclass-da %80,30-dan %86,31-ə,
- ME/CFS vs. Depression-da %92,50-dən %98,70-ə
yüksəlmişdir.
Bunun əksinə, Migraine Classification-da %89,50-dən %82,46-ya düşmüşdür.
Bu davranış xarici xüsusiyyət çəkilərinin neyron şəbəkəsinin öz daxili təmsil öyrənmə dinamikası ilə həmişə uyğun olmaya biləcəyini göstərir.
Random Forest üzərində təsir
Random Forest nəticələri daha məhdud dəyişir. Mənbədə bunun səbəbi RF-nin artıq random feature selection və bagging kimi öz daxili xüsusiyyət seçimi mexanizmlərinə malik olması ilə əlaqələndirilmişdir.
Buna görə əvvəlcədən tətbiq edilmiş xarici çəkiləndirmə RF-yə KNN-də olduğu qədər aydın əlavə fayda vermir.
Metodun ən təbii istifadə sahəsi
Mənbənin ümumi qiymətləndirməsinə görə DE-HX ən güclü təsirini xüsusiyyət məkanının həndəsəsindən birbaşa asılı olan məsafə əsaslı modellərdə göstərir.
KNN bu baxımdan təbii hədəfdir, çünki hər bir xüsusiyyət çəkisi məsafə hesabını birbaşa dəyişir.
Tədqiqatın Məhdudiyyətləri Nələrdir?
- Bir neçə müstəqil optimallaşdırma qaçışı aparılmamışdır.
- Nested cross-validation istifadə edilməmişdir.
- Müqayisələr sabit runtime və ya bərabər hesablama büdcəsi əsasında aparılmamışdır.
- Convergence plot təqdim edilməmişdir.
- HMCR, PAR və digər hiperparametrlər üçün ətraflı sensitivity analysis aparılmamışdır.
- Öyrənilmiş çəkilərin qaçışlararası sabitliyi təhlil edilməmişdir.
- ANN və RF ötürmə eksperimentləri model-spesifik yenidən tuning olmadan həyata keçirilmişdir.
- Nəticələr məlumat dəstindən asılıdır və DE-HX hər vəziyyətdə ən yüksək performansı vermir.
Müəlliflər gələcək tədqiqatlarda runtime və convergence analizi, lokal axtarış inteqrasiyası, hibrid və ensemble strukturlar, həmçinin sıfıra yaxın çəkilərin feature selection məqsədilə istifadəsi kimi istiqamətlərin araşdırılmasını təklif edirlər.
Mənbə və Metod Qeydi
Bu Verianla məzmunu Andrea Ortega-Guzmán, Salvador Ibarra-Martínez, José Antonio Castan-Rocha, J. David Teran-Villanueva, Mayra Guadalupe Treviño-Berrones və Aurelio Alejandro Santigo-Pineda tərəfindən hazırlanmış Assessing Performance and Crossover Operators on Differential Evolution for Attribute Weighting adlı akademik iş əsasında müstəqil şəkildə hazırlanmışdır.
Məqalə AI jurnalında 2026-cı ildə, Cild 7, Məqalə 163 kimi dərc edilmişdir. DOI: 10.3390/ai7050163. Nəşr tarixi 7 may 2026-dır. Tədqiqat MDPI tərəfindən Creative Commons Attribution (CC BY) lisenziyası ilə açıq girişdə yayımlanmışdır.
Tədqiqatın əsas metodu hər bir məlumat dəsti xüsusiyyətinə fasiləsiz çəki təyin edən Diferensial Təkamül əsaslı optimallaşdırma prosesidir. Təklif olunan DE-HX klassik DE-dəki binomial crossover mərhələsini Harmony Search-dən ilhamlanan namizəd yaratma mexanizmi ilə əvəz edir. Mövcud DE populyasiyası ayrıca Harmony Memory olmadan mənbə yaddaşı kimi istifadə olunur.
KNN-in 5-fold cross-validation dəqiqliyi optimallaşdırmanın uyğunluq funksiyasıdır. Eksperimentlərdə KNN üçün k=5 və Evklid məsafəsi; DE-HX üçün HMCR=0,85 və PAR=0,75; klassik DE üçün F=1 istifadə edilmişdir.
Metod 20 məlumat dəstində qiymətləndirilmiş; Accuracy və Macro-F1 üzrə standart DE, KNN, WeightedKNN, ReliefF+KNN, ANN və Random Forest ilə müqayisə edilmişdir. Friedman, Holm və Wilcoxon testləri ümumi və ikili statistik müqayisələr üçün istifadə edilmişdir.
DE-HX-in standart DE-yə qarşı birbaşa Wilcoxon testində əhəmiyyətli üstünlük göstərdiyi bildirilsə də, Holm çoxsaylı müqayisə düzəlişindən sonra DE-HX–DE fərqinin p=0,0515 olduğu göstərilmişdir. Buna görə statistik nəticələr test konteksti qorunaraq şərh edilməlidir.
Müəlliflər xarici maliyyə alınmadığını bildirmişdir. Eksperiment kodunun, ilkin və əvvəlcədən emal edilmiş məlumat dəstlərinin əlçatan olduğu qeyd olunur.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib