

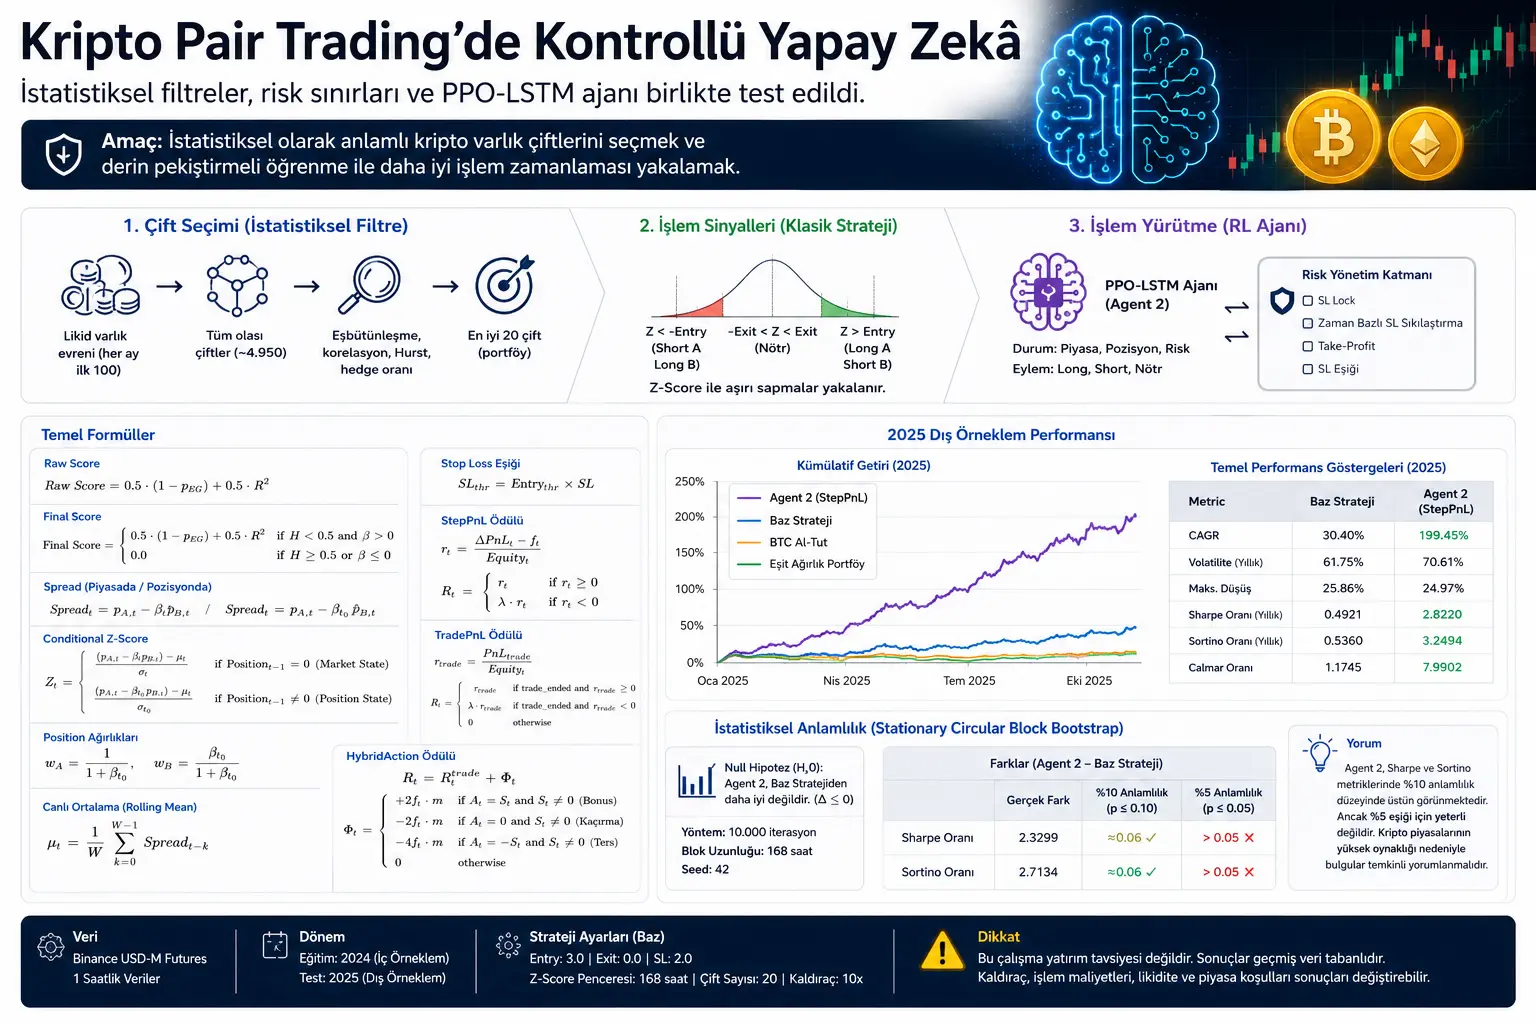
Bu yazı, kripto para piyasalarında istatistiksel arbitraj ve derin pekiştirmeli öğrenme yöntemlerini birlikte ele alan akademik bir çalışmadan hazırlanmıştır. Çalışma, Dynamic Multi-Pair Trading Strategy in Cryptocurrency Markets with Deep Reinforcement Learning başlığını taşımaktadır ve arXiv üzerinde ön baskı olarak yayımlanmıştır.
Makale; kripto para piyasalarında iki varlık arasındaki fiyat ilişkisinden yararlanan pair trading stratejisini, Derin Pekiştirmeli Öğrenme yani Deep Reinforcement Learning ile geliştirmeyi amaçlamaktadır. Ancak burada önemli bir ayrım vardır: Yapay zekâ modeli piyasada tamamen serbest bırakılmamıştır. Model, istatistiksel olarak seçilmiş varlık çiftleri ve önceden belirlenmiş risk sınırları içinde çalıştırılmıştır.
Bu nedenle yazıda anlatılan sonuçlar bir yatırım tavsiyesi olarak okunmamalıdır. Çalışma geçmiş veriler üzerinde test edilmiş akademik bir model sunmaktadır. Kripto piyasalarının yüksek oynaklığı, kaldıraç kullanımı, işlem maliyetleri ve canlı piyasadaki likidite koşulları sonuçları ciddi biçimde değiştirebilir.
Yeni bir akademik çalışma, kripto para piyasalarında pair trading stratejisini derin pekiştirmeli öğrenme ile birleştiren hibrit bir model öneriyor. Araştırmada önce istatistiksel olarak anlamlı kripto varlık çiftleri seçiliyor; ardından PPO-LSTM tabanlı yapay zekâ ajanı yalnızca işlem yürütme katmanı olarak kullanılıyor. Modelin en başarılı versiyonu, 2025 dış örneklem döneminde klasik baz stratejiye göre daha güçlü risk-ayarlı performans üretmiş görünüyor. Ancak bulgular, yüksek kaldıraç ve kripto piyasalarının oynak yapısı nedeniyle dikkatli yorumlanmalı.
Problem Ne?
Pair trading, birbirine istatistiksel olarak bağlı iki varlığın fiyatları geçici olarak ayrıştığında işlem açmayı, ilişki normale döndüğünde ise pozisyonu kapatmayı hedefleyen bir stratejidir. Örneğin iki kripto varlık uzun süre birlikte hareket ediyorsa, aralarındaki fark olağan dışı şekilde açıldığında sistem bu farkın tekrar kapanabileceğini varsayar.
Bu yaklaşım geleneksel hisse senedi piyasalarında uzun süredir incelenmektedir. Fakat kripto para piyasalarında durum daha zordur. Çünkü kripto varlıklarda volatilite yüksektir, piyasa rejimleri hızlı değişebilir, likidite koşulları bozulabilir ve geçmişte birlikte hareket eden iki varlık bir süre sonra tamamen farklı davranmaya başlayabilir.
Çalışmanın temel sorusu şudur: Klasik istatistiksel pair trading sistemi, derin pekiştirmeli öğrenme ile desteklenirse, kripto gibi gürültülü ve oynak bir piyasada daha iyi işlem zamanlaması yapabilir mi?
Araştırmacılar burada yapay zekâyı doğrudan “piyasayı tahmin eden” bağımsız bir sistem olarak kullanmamıştır. Bunun yerine önce istatistiksel olarak güçlü çiftler seçilmiş, ardından yapay zekâ yalnızca işlem açma, bekleme veya kapatma kararlarını iyileştirmeye çalışan kontrollü bir katman olarak eklenmiştir.
Yöntem Ne Öneriyor?
Çalışmanın yöntemi iki ana bölümden oluşmaktadır. İlk bölüm, işlem yapılacak kripto varlık çiftlerini seçen istatistiksel sistemdir. İkinci bölüm ise bu sistemin üzerine eklenen yapay zekâ tabanlı işlem yürütme katmanıdır.
İlk aşamada sistem, Binance USD-M Futures piyasasındaki likit kripto varlıkları inceler. Her ay en likit varlıklardan bir aday evren oluşturulur. Bu varlıklar arasındaki olası çiftler; eşbütünleşme, korelasyon, Hurst üssü ve hedge oranı gibi ölçütlerle değerlendirilir. Amaç yalnızca geçmişte birlikte hareket etmiş çiftleri bulmak değil, aynı zamanda ortalamaya dönme davranışı gösterebilecek çiftleri ayırmaktır.
İkinci aşamada PPO yani Proximal Policy Optimization algoritması ve LSTM mimarisi kullanılır. PPO, pekiştirmeli öğrenmede karar politikasını kontrollü biçimde güncellemek için kullanılan bir yöntemdir. LSTM ise zaman serilerinde geçmiş bilgiyi hatırlayabilen bir sinir ağı yapısıdır.
Bu yapı, klasik “uçtan uca yapay zekâ” yaklaşımından farklıdır. Model, piyasadan ham veri alıp her şeyi tek başına öğrenmeye çalışmaz. Önce istatistiksel sınırlar kurulur, sonra yapay zekâ bu sınırların içinde işlem zamanlamasını iyileştirmeye çalışır. Bu nedenle çalışma, “güvenli pekiştirmeli öğrenme” yaklaşımına yakın bir hibrit mimari sunmaktadır.
Formüller Ne Anlatıyor?
Çalışmadaki formüller, sistemin kripto varlık çiftlerini nasıl seçtiğini, fiyat farkını nasıl ölçtüğünü, risk sınırlarını nasıl kurduğunu ve yapay zekâ ajanına nasıl ödül verdiğini gösteriyor.
1. Ham skor: İki varlık arasındaki istatistiksel ilişki ne kadar güçlü?
İlk temel formül, iki varlık çiftinin istatistiksel kalitesini ölçen ham skor formülüdür:
Burada \(p_{EG}\), Engle-Granger eşbütünleşme testinden gelen p-değeridir. Bu değer ne kadar düşükse iki varlık arasında uzun vadeli denge ilişkisi bulunma ihtimali o kadar güçlenir. \(R^2\) ise iki varlık arasındaki doğrusal ilişkinin gücünü gösterir.
Formül iki farklı bilgiyi eşit ağırlıkla birleştirir: uzun vadeli denge ilişkisi ve kısa vadeli birlikte hareket etme gücü. Böylece yalnızca yüksek korelasyon değil, daha kalıcı bir istatistiksel bağ da aranır.
2. Nihai skor: İlişki gerçekten işlem yapılabilir mi?
Çalışma yalnızca ham skora güvenmez. Bir çiftin işlem yapılabilir sayılması için iki yapısal koşul aranır: Hurst üssü \(H \lt 0.5\) olmalı ve hedge oranı \(\beta \gt 0\) olmalıdır.
Bu formülün ana mesajı şudur: Eğer çift ortalamaya dönme davranışı göstermiyorsa veya pozitif hedge ilişkisi kurulamıyorsa, istatistiksel olarak iyi görünse bile işlem listesinden çıkarılır. Yani sistem, yüksek korelasyonun tek başına yeterli olmadığını kabul eder.
3. Conditional Z-Score: Fiyat farkı olağanın ne kadar dışına çıktı?
Stratejinin işlem kararı için kullandığı ana ölçü Conditional Z-Score değeridir:
Bu formül, iki varlık arasındaki fiyat farkının ortalamadan kaç standart sapma uzaklaştığını ölçer. Pozisyon yokken sistem güncel beta ve güncel standart sapmayı kullanır. Pozisyon açıldıktan sonra ise hedge oranı ve standart sapma dondurulur.
Bu ayrım önemlidir. Çünkü kripto piyasasında ani volatilite artışı olduğunda standart sapma da hızla büyüyebilir. Eğer sistem bu yeni standart sapmayı sürekli kullanırsa, fiyat farkı hâlâ riskli olmasına rağmen Z-Score yapay olarak küçülebilir. Bu nedenle pozisyon açıldıktan sonra risk ölçüsünün dondurulması, stratejinin daha tutarlı çalışmasını sağlar.
4. Spread: İki varlık arasındaki fark nasıl hesaplanıyor?
Piyasa izlenirken kullanılan spread formülü şöyledir:
Pozisyon açıldıktan sonra kullanılan spread formülü ise şöyledir:
İlk formül piyasada yeni fırsat aranırken kullanılır. İkinci formül ise işlem açıldıktan sonra eldeki gerçek pozisyonu izlemek için kullanılır. Böylece sistem işlem açıldıktan sonra sürekli değişen beta değerleriyle pozisyonun matematiksel temelini bozmaz.
5. Pozisyon ağırlıkları: Hangi varlığa ne kadar ağırlık veriliyor?
Çalışmada pozisyon ağırlıkları hedge oranına göre belirlenir:
Bu yapı, iki varlık arasında daha dengeli bir long/short kurgu oluşturmayı hedefler. Amaç, daha oynak varlığın portföyü tek başına sürüklemesini engellemektir.
6. Canlı ortalama: Sistem yeni piyasa dengesine nasıl uyum sağlıyor?
Çalışmada ortalama tamamen dondurulmaz. Spread’in ortalaması canlı olarak güncellenir:
Burada \(W\), Z-Score penceresidir. Çalışmada varsayılan pencere 168 saat, yani yaklaşık bir haftadır. Ortalama canlı kaldığı için sistem, kripto piyasasında oluşabilecek yeni denge seviyelerine kademeli biçimde uyum sağlayabilir.
7. Stop Loss eşiği: Risk sınırı nasıl sabitleniyor?
Stratejide zarar-kes eşiği, işlem açıldığı andaki aşırı Z-Score değerine göre değil, önceden belirlenen giriş eşiğine göre hesaplanır:
Bu yaklaşım, risk sınırının ani piyasa sıçramaları sırasında sonradan büyümesini engeller. Örneğin işlem çok geç ve aşırı bir sapma sırasında açılmışsa, sistem bu hatayı daha geniş zarar sınırı vererek ödüllendirmez.
8. StepPnL ödülü: Yapay zekâ her adımda nasıl puan alıyor?
Yapay zekâ ajanının öğrenmesinde kullanılan ödül fonksiyonlarından biri StepPnL ödülüdür:
Burada \(\Delta PnL_t\), ilgili zaman adımındaki kâr-zarar değişimini; \(f_t\), işlem maliyetini; \(\mathrm{Equity}_t\), portföy değerini ifade eder. \(\lambda\) katsayısı ise zararları daha sert cezalandırmak için kullanılır. Çalışmada başarılı bulunan Agent 2 yapılandırmasında \(\lambda=1.2\) kullanılmıştır.
9. TradePnL ödülü: Sadece işlem kapanınca puan veren yaklaşım
Bir diğer ödül yapısı, sadece işlem tamamlandığında puan verir:
Bu ödül tipi kısa vadeli piyasa gürültüsünü azaltabilir. Fakat ajan daha seyrek geri bildirim aldığı için öğrenme süreci zorlaşabilir.
10. HybridAction ödülü: Klasik sinyale uyarsa bonus, tersine giderse ceza
HybridAction ödülünde ajan, klasik stratejinin ürettiği sinyale uyarsa bonus alır; sinyali kaçırırsa veya tersine giderse ceza alır:
Bu ödülün son hali şöyledir:
Bu yapı, ajanı klasik stratejiye daha yakın davranmaya teşvik eder. Ancak çalışmadaki sonuçlar, fazla yönlendirilmiş ödül yapıların her zaman daha iyi dış örneklem performansı üretmediğini göstermektedir. En başarılı yapı, daha yalın bir gözlem alanı ve kayıpları biraz daha sert cezalandıran StepPnL ödül yapısıdır.
Grafik, Tablo ve Şemaların Ana Mesajı
Çalışmadaki grafikler ve tabloların ana mesajı, klasik pair trading stratejisinin kripto piyasasında tamamen işlevsiz olmadığını; fakat doğru biçimde sınırlandırılmış yapay zekâ katmanının bazı durumlarda bu baz stratejinin üzerine daha iyi işlem zamanlaması ekleyebileceğini göstermektedir.
Özellikle Agent 2 olarak adlandırılan yapılandırma öne çıkmaktadır. Agent 2; StepPnLReward ödül yapısını, Autonomous gözlem alanını ve \(\lambda=1.2\) kayıp cezasını kullanır. Bu yapı, 2025 dış örneklem döneminde baz stratejiye göre daha yüksek risk-ayarlı performans üretmiştir.
Ancak çalışmadaki tüm yapay zekâ ajanları başarılı değildir. Bazı ajanlar daha zayıf veya istikrarsız sonuçlar vermiştir. Bu da önemli bir noktaya işaret eder: Finansal piyasalarda “yapay zekâ eklemek” tek başına başarı anlamına gelmez. Model mimarisi, ödül fonksiyonu, risk sınırları ve dış örneklem testi sonucu belirleyen ana unsurlardır.
Deneyler Nasıl Yapılmış?
Araştırmada Binance USD-M Futures piyasasından 1 saatlik fiyat verileri kullanılmıştır. Eğitim dönemi 2024 yılı, dış örneklem test dönemi ise 2025 yılı olarak ayrılmıştır. Bu ayrım, modelin yalnızca geçmiş veriye ezber yapıp yapmadığını anlamak için önemlidir.
Sistem her ay yeni bir varlık evreni oluşturur. Önce geçmiş iki aylık döneme göre en likit 100 varlık belirlenir. Daha sonra bu varlıklar arasındaki yaklaşık 4.950 olası çift istatistiksel olarak değerlendirilir. Nihai skoru en yüksek 20 çift, ilgili ayın işlem sepetine alınır.
Baz stratejide giriş eşiği \(3.0\), çıkış eşiği \(0.0\), stop loss katsayısı \(2.0\), Z-Score penceresi 168 saat ve çift sayısı 20 olarak belirlenmiştir. Strateji 10x kaldıraçla test edilmiştir. Bu kaldıraç tercihi, stratejinin risk profilini daha oynak kripto benchmark’ları ile karşılaştırılabilir hale getirmek için kullanılmıştır. Ancak kaldıraç, gerçek piyasada zarar ve tasfiye riskini de büyütür.
Yapay zekâ ajanları 2024 iç örneklem döneminde eğitilmiş, 2025 dış örneklem döneminde sınanmıştır. Farklı ödül fonksiyonları, farklı gözlem alanları ve risk yönetimi katmanı ayarları karşılaştırılmıştır.
Sonuçlar Ne Gösteriyor?
Çalışmada baz strateji, 2025 dış örneklem döneminde Bitcoin al-tut ve eşit ağırlıklı portföy benchmark’larına karşı güçlü bir performans sergilemiştir. Bu, istatistiksel pair trading yaklaşımının kripto piyasasında belirli koşullar altında anlamlı sinyaller yakalayabildiğini göstermektedir.
En dikkat çekici sonuç ise Agent 2 modelinde görülmektedir. Çalışmada Agent 2 için 2025 dış örneklem döneminde yaklaşık %199,45 CAGR, 2,8220 Sharpe oranı ve 3,2494 Sortino oranı raporlanmıştır. Aynı dönemde baz strateji için yaklaşık %30,40 CAGR, 0,4921 Sharpe oranı ve 0,5360 Sortino oranı verilmiştir.
Bu fark ilk bakışta oldukça güçlü görünmektedir. Fakat araştırmacılar bunun tesadüfi olup olmadığını değerlendirmek için stationary circular block bootstrap yöntemi kullanmıştır. Sonuçlar, Agent 2’nin Sharpe ve Sortino farklarının %10 anlamlılık düzeyinde istatistiksel olarak desteklendiğini; ancak %5 gibi daha katı bir eşik için yeterince güçlü olmadığını göstermektedir.
Bu nedenle sonuç şöyle okunmalıdır: Model umut verici bir dış örneklem üstünlüğü göstermiştir; fakat kripto piyasasının yüksek gürültüsü ve sınırlı test dönemi nedeniyle bu bulgu kesin bir yatırım sonucu gibi yorumlanmamalıdır.
Bu Neden Önemli?
Bu çalışma, finansal yapay zekâ tartışmalarında önemli bir fikri öne çıkarıyor: Yapay zekâ finansal piyasalarda tamamen serbest bırakıldığında değil, sağlam matematiksel sınırlar ve risk kuralları içinde çalıştırıldığında daha anlamlı sonuçlar verebilir.
Kripto para piyasaları, uçtan uca öğrenen modeller için oldukça zor bir ortamdır. Çünkü geçmişte işe yarayan ilişki kısa sürede bozulabilir. Fiyat serileri yüksek gürültü içerir. Ayrıca işlem maliyetleri, kaldıraç ve likidite riskleri modelin canlı performansını ciddi biçimde etkileyebilir.
Bu çalışmadaki hibrit yaklaşım, önce istatistiksel olarak anlamlı işlem alanını daraltır; sonra yapay zekâyı bu alan içinde işlem zamanlamasını geliştirmek için kullanır. Bu yönüyle araştırma, yapay zekânın finansal sistemlerde “karar verici tek otorite” olmaktan çok, kontrollü bir optimizasyon katmanı olarak kullanılabileceğini gösterir.
Dikkat Noktaları
Bu çalışma yatırım tavsiyesi değildir. Sonuçlar geçmiş veriye dayalıdır ve gelecekte aynı performansın elde edileceği anlamına gelmez.
Model 10x kaldıraçla test edilmiştir. Kaldıraç, getiriyi artırabileceği gibi zararı ve tasfiye riskini de büyütür.
Dış örneklem dönemi yalnızca 2025 yılıdır. Saatlik veri çok sayıda gözlem sağlasa da, tek yıllık dönem farklı makro piyasa rejimlerini temsil etmek için sınırlı olabilir.
Çalışmada işlem ücretleri dikkate alınmıştır. Ancak canlı piyasada slippage, emir defteri derinliği, likidite kesilmesi, ani spread genişlemesi ve borsa kaynaklı riskler sonucu değiştirebilir.
Yapay zekâ ajanlarının performansı kullanılan seed, ödül fonksiyonu ve risk katmanı tasarımına duyarlı olabilir. Bu nedenle canlı kullanım için çoklu seed testleri, daha uzun dış örneklem dönemleri ve gerçekçi işlem simülasyonları gerekir.
Sonuç
Bu akademik çalışma, kripto pair trading stratejilerinde derin pekiştirmeli öğrenmenin potansiyelini kontrollü bir mimariyle incelemektedir. En önemli tarafı, yapay zekâyı tamamen serbest bırakmak yerine istatistiksel filtreler ve deterministik risk sınırlarıyla korunan bir sistem içinde kullanmasıdır.
Sonuçlar, Agent 2 yapılandırmasının 2025 dış örneklem döneminde klasik baz stratejiye göre daha iyi risk-ayarlı performans ürettiğini göstermektedir. Ancak bu üstünlük, %10 anlamlılık düzeyinde desteklenirken %5 eşiğini tam olarak geçmemektedir. Bu da bulgunun umut verici ama temkinli yorumlanması gerektiğini gösterir.
Verianla açısından bu çalışmanın ana mesajı şudur: Finansal yapay zekâ modellerinde başarı yalnızca daha karmaşık sinir ağları kurmakla gelmez. Bazen en güçlü sonuç, iyi tasarlanmış istatistiksel sınırlar, açık risk kuralları ve sınırlı görev verilen bir yapay zekâ katmanının birleşiminden doğar.
Kaynak ve Yöntem Notu
Bu içerik, Dynamic Multi-Pair Trading Strategy in Cryptocurrency Markets with Deep Reinforcement Learning başlıklı akademik PDF incelenerek hazırlanmıştır. Metin birebir çeviri değildir. Çalışmanın amacı, yöntemi, temel formülleri, deney tasarımı, bulguları ve sınırlılıkları Verianla okurları için sadeleştirilmiş, özgün ve editoryal Türkçe ile yeniden anlatılmıştır.
Formüller, çalışmadaki temel matematiksel yapıya sadık kalınarak MathJax uyumlu LaTeX formatında verilmiştir. Yazı yatırım tavsiyesi, al-sat önerisi veya canlı işlem sistemi önerisi değildir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir