

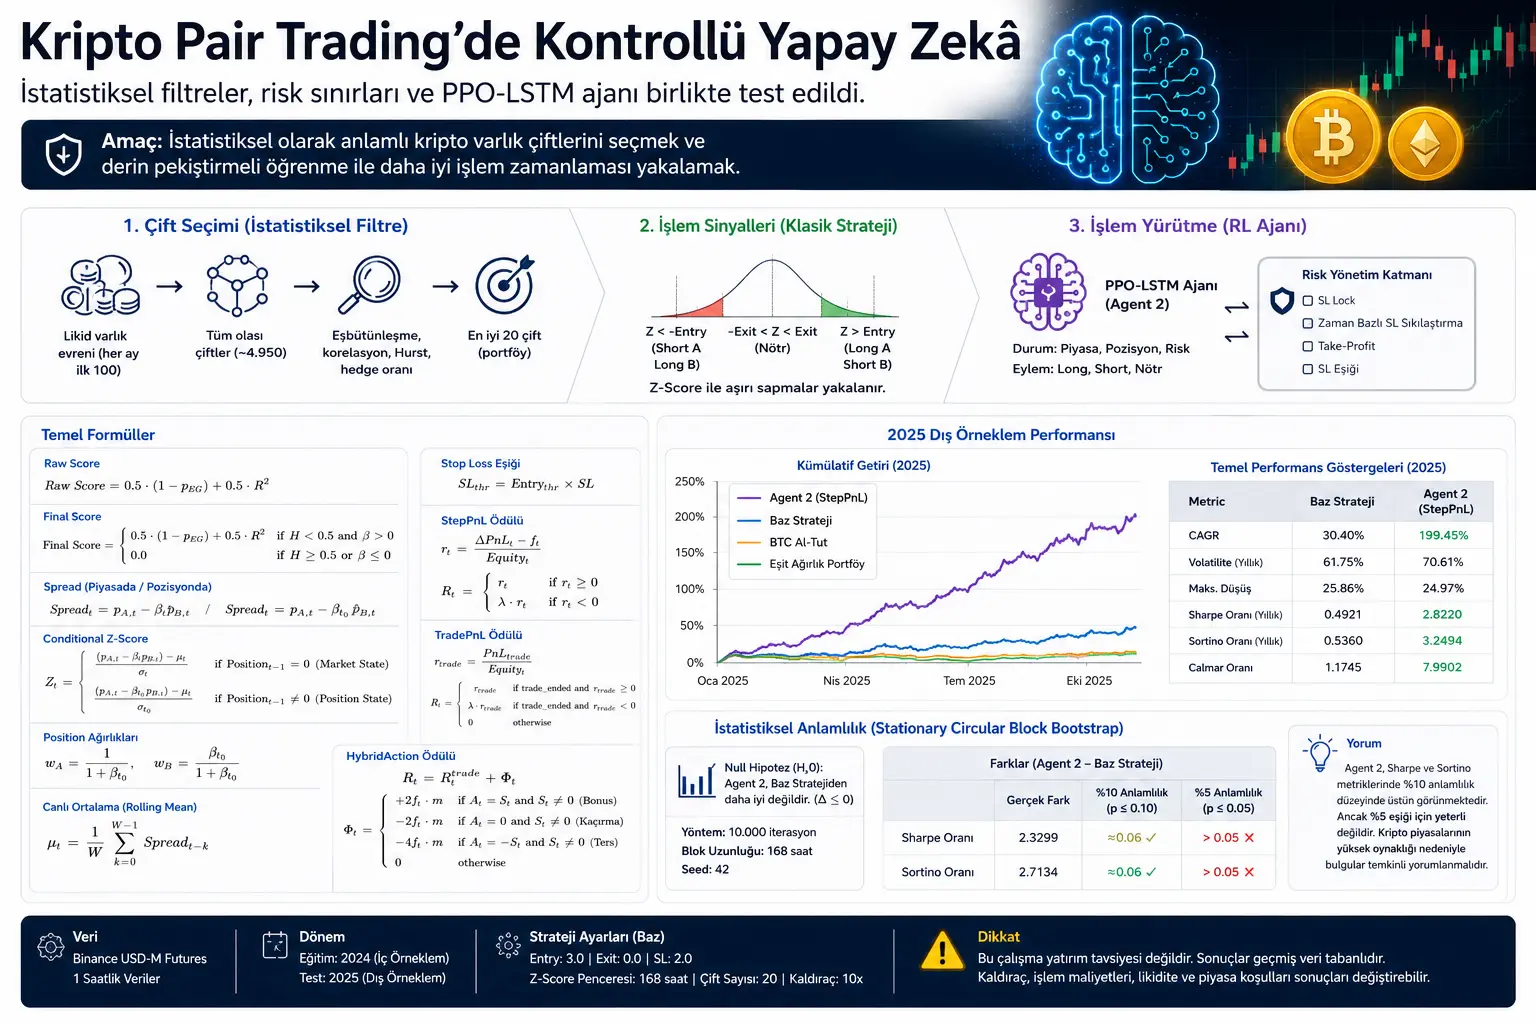
Бул жазуу криптовалюта базарларында статистикалык арбитраж жана терең бекемдөөчү үйрөнүү ыкмаларын бирге караган академиялык изилдөөнүн негизинде даярдалган. Изилдөө Dynamic Multi-Pair Trading Strategy in Cryptocurrency Markets with Deep Reinforcement Learning аталышын алып, arXiv платформасында preprint катары жарыяланган.
Макала криптовалюта базарларында эки активдин баа мамилесинен пайдаланган pair trading стратегиясын Терең Бекемдөөчү Үйрөнүү башкача айтканда Deep Reinforcement Learning менен өнүктүрүүнү максат кылат. Бирок бул жерде маанилүү айырма бар: жасалма интеллект модели рынокто толук эркин калтырылган эмес. Модель статистикалык жактан тандалган актив жуптары жана алдын ала белгиленген тобокелдик чектери ичинде иштетилген.
Ошондуктан бул жазууда айтылган натыйжаларды инвестициялык кеңеш катары кабыл албоо керек. Изилдөө тарыхый маалыматтарда сыналган академиялык моделди сунуштайт. Крипто базарларынын жогорку волатилдүүлүгү, leverage колдонуу, транзакция чыгымдары жана жандуу рыноктогу ликвиддүүлүк шарттары натыйжаларды олуттуу өзгөртүшү мүмкүн.
Жаңы академиялык изилдөө криптовалюта базарларында pair trading стратегиясын терең бекемдөөчү үйрөнүү менен айкалыштырган гибрид моделди сунуштайт. Изилдөөдө адегенде статистикалык жактан маанилүү крипто актив жуптары тандалат; андан кийин PPO-LSTM негизиндеги жасалма интеллект агенти жөн гана соода аткаруу катмары катары колдонулат. Моделдин эң ийгиликтүү версиясы 2025 тышкы үлгү мезгилинде классикалык базалык стратегияга караганда күчтүүрөөк тобокелдикке ылайыкталган көрсөткүч бергендей көрүнөт. Бирок табылгалар жогорку leverage жана крипто базарларынын туруксуз түзүлүшүнөн улам этият чечмелениши керек.
Көйгөй Эмне?
Pair trading — статистикалык жактан байланышкан эки активдин баалары убактылуу ажыраганда позиция ачып, мамиле кадимки абалга кайткандан кийин позицияны жабууну максат кылган стратегия. Мисалы, эки крипто актив узак убакыт бою бирге кыймылдап келсе, алардын айырмасы адаттан тыш кеңейгенде система бул айырма кайра кыскара алат деп болжолдойт.
Бул ыкма салттуу акция базарларында көптөн бери изилденип келет. Бирок криптовалюта базарларында абал кыйыныраак. Анткени крипто активдерде волатилдүүлүк жогору, рынок режимдери тез өзгөрүшү мүмкүн, ликвиддүүлүк шарттары начарлашы мүмкүн жана мурда бирге кыймылдаган эки актив кийин таптакыр башкача жүрүшү мүмкүн.
Изилдөөнүн негизги суроосу мындай: классикалык статистикалык pair trading системасы терең бекемдөөчү үйрөнүү менен колдоого алынса, крипто сыяктуу ызы-чуулуу жана туруксуз рынокто соода убактысын жакшыраак тандай алабы?
Изилдөөчүлөр бул жерде жасалма интеллектти түздөн-түз “рынокту божомолдогон” өз алдынча система катары колдонушкан эмес. Анын ордуна адегенде статистикалык жактан күчтүү жуптар тандалып, андан кийин жасалма интеллект позиция ачуу, күтүү же жабуу чечимдерин жакшыртууга аракет кылган көзөмөлдөнгөн катмар катары кошулган.
Ыкма Эмне Сунуштайт?
Изилдөөнүн ыкмасы эки негизги бөлүктөн турат. Биринчи бөлүк соода жүргүзүлө турган крипто актив жуптарын тандаган статистикалык система. Экинчи бөлүк болсо ушул системанын үстүнө кошулган жасалма интеллектке негизделген соода аткаруу катмары.
Биринчи баскычта система Binance USD-M Futures базарындагы ликвиддүү крипто активдерди карайт. Ар ай сайын эң ликвиддүү активдерден талапкер аалам түзүлөт. Бул активдер арасындагы мүмкүн болгон жуптар коинтеграция, корреляция, Hurst көрсөткүчү жана hedge ratio сыяктуу критерийлер менен бааланат. Максат тарыхта бирге кыймылдаган жуптарды гана табуу эмес, орточого кайтуу жүрүм-турумун көрсөтүшү мүмкүн болгон жуптарды ажыратуу.
Экинчи баскычта PPO башкача айтканда Proximal Policy Optimization алгоритми жана LSTM архитектурасы колдонулат. PPO бекемдөөчү үйрөнүүдө чечим саясатын көзөмөлдүү түрдө жаңыртуу үчүн колдонулган ыкма. LSTM болсо убакыт катарларында өткөн маалыматты эстей алган нейрон тармак түзүлүшү.
Бул түзүлүш классикалык “end-to-end жасалма интеллект” ыкмасынан айырмаланат. Модель рыноктон чийки маалымат алып, баарын өзү үйрөнүүгө аракет кылбайт. Адегенде статистикалык чектер коюлат, андан кийин жасалма интеллект ошол чектердин ичинде соода убактысын жакшыртууга аракет кылат. Ошондуктан изилдөө “коопсуз бекемдөөчү үйрөнүү” ыкмасына жакын гибрид архитектураны сунуштайт.
Формулалар Эмнени Түшүндүрөт?
Изилдөөдөгү формулалар система крипто актив жуптарын кантип тандай турганын, баа айырмасын кантип өлчөй турганын, тобокелдик чектерин кантип курарын жана жасалма интеллект агентине кантип сыйлык берерин көрсөтөт.
1. Чийки упай: Эки активдин ортосундагы статистикалык байланыш канчалык күчтүү?
Биринчи негизги формула эки актив жуптун статистикалык сапатын өлчөгөн чийки упай формуласы:
Бул жерде \(p_{EG}\) Engle-Granger коинтеграция тестинен алынган p-маани. Бул маани канчалык төмөн болсо, эки активдин ортосунда узак мөөнөттүү тең салмак мамилеси болушу ыктымалдыгы ошончолук күчтүү болот. \(R^2\) болсо эки активдин ортосундагы сызыктуу байланыштын күчүн көрсөтөт.
Формула эки башка маалыматты тең салмакта бириктирет: узак мөөнөттүү тең салмак мамилеси жана кыска мөөнөттүү бирге кыймылдоо күчү. Ошентип жогорку корреляция гана эмес, туруктуураак статистикалык байланыш да изделет.
2. Акыркы упай: Байланыш чынында соодага жарайбы?
Изилдөө чийки упайга гана таянбайт. Жуп соодага жарактуу деп эсептелиши үчүн эки түзүмдүк шарт талап кылынат: Hurst көрсөткүчү \(H \lt 0.5\) болушу жана hedge ratio \(\beta \gt 0\) болушу керек.
Бул формуланын негизги мааниси: эгер жуп орточого кайтуу жүрүм-турумун көрсөтпөсө же оң hedge мамилеси түзүлбөсө, статистикалык жактан жакшы көрүнсө да соода тизмесинен чыгарылат. Башкача айтканда, система жогорку корреляциянын өзү жетишсиз экенин кабыл алат.
3. Conditional Z-Score: Баа айырмасы адаттагыдан канчалык алыстап кетти?
Стратегиянын соода чечими үчүн колдонгон негизги көрсөткүчү Conditional Z-Score:
Бул формула эки активдин баа айырмасы орточодон канча стандарттык четтөө алыстаганын өлчөйт. Позиция жок кезде система учурдагы beta жана учурдагы стандарттык четтөөнү колдонот. Позиция ачылгандан кийин болсо hedge ratio жана стандарттык четтөө тоңдурулат.
Бул айырма маанилүү. Анткени крипто рыногунда волатилдүүлүк кескин көбөйгөндө стандарттык четтөө да тез өсүшү мүмкүн. Эгер система жаңы стандарттык четтөөнү дайыма колдоно берсе, баа айырмасы дагы эле кооптуу болгонуна карабай Z-Score жасалма түрдө кичирейиши мүмкүн. Ошондуктан позиция ачылгандан кийин тобокелдик өлчөмүн тоңдуруу стратегиянын ырааттуураак иштешин камсыз кылат.
4. Spread: Эки активдин ортосундагы айырма кантип эсептелет?
Рынок көзөмөлдөнүп жатканда колдонулган spread формуласы мындай:
Позиция ачылгандан кийин колдонулган spread формуласы болсо мындай:
Биринчи формула рынокто жаңы мүмкүнчүлүк изделгенде колдонулат. Экинчи формула болсо соода ачылгандан кийин кармалып турган реалдуу позицияны көзөмөлдөө үчүн колдонулат. Ошентип система соода ачылгандан кийин дайыма өзгөргөн beta маанилери менен позициянын математикалык негизин бузбайт.
5. Позиция салмактары: Кайсы активге канча салмак берилет?
Изилдөөдө позиция салмактары hedge ratio боюнча аныкталат:
Бул түзүлүш эки активдин ортосунда тең салмактуу long/short конфигурациясын түзүүнү максат кылат. Максат көбүрөөк туруксуз актив портфелди жалгыз өзү жетелеп кетпеши.
6. Жандуу орточо: Система жаңы рынок тең салмагына кантип ыңгайлашат?
Изилдөөдө орточо маани толугу менен тоңдурулбайт. Spread орточосу жандуу түрдө жаңыланат:
Бул жерде \(W\) — Z-Score терезеси. Изилдөөдө демейки терезе 168 саат, башкача айтканда болжол менен бир жума. Орточо жандуу бойдон калгандыктан, система крипто рыногунда пайда болушу мүмкүн болгон жаңы тең салмак деңгээлдерине акырындап ыңгайлаша алат.
7. Stop Loss чеги: Тобокелдик чеги кантип туруктуу коюлат?
Стратегияда зыянды токтотуу чеги соода ачылган учурдагы өтө чоң Z-Score маанисине эмес, алдын ала белгиленген кирүү чегине жараша эсептелет:
Бул ыкма рынок кескин секирген учурда тобокелдик чеги кийин кеңейип кетишине жол бербейт. Мисалы, соода өтө кеч жана чоң четтөө учурунда ачылса, система бул катаны кеңири зыян чегин берип сыйлабайт.
8. StepPnL сыйлыгы: Жасалма интеллект ар кадамда кантип упай алат?
Жасалма интеллект агентин үйрөтүүдө колдонулган сыйлык функцияларынын бири StepPnL сыйлыгы:
Бул жерде \(\Delta PnL_t\) тиешелүү убакыт кадамындагы пайда-зыян өзгөрүшүн; \(f_t\) транзакция чыгымын; \(\mathrm{Equity}_t\) портфелдин баасын билдирет. \(\lambda\) коэффициенти болсо зыяндарды катуураак жазалоо үчүн колдонулат. Изилдөөдө ийгиликтүү деп табылган Agent 2 конфигурациясында \(\lambda=1.2\) колдонулган.
9. TradePnL сыйлыгы: Упайды соода жабылганда гана берген ыкма
Дагы бир сыйлык түзүлүшү соода аяктаганда гана упай берет:
Бул сыйлык түрү кыска мөөнөттүү рынок ызы-чуусун азайтышы мүмкүн. Бирок агент азыраак кайтарым байланыш алгандыктан үйрөнүү процесси татаалдашы мүмкүн.
10. HybridAction сыйлыгы: Классикалык сигналга туура келсе бонус, тескерисине барса жаза
HybridAction сыйлыгында агент классикалык стратегия чыгарган сигналга туура келсе бонус алат; сигналды өткөрүп жиберсе же тескери аракет кылса жаза алат:
Бул сыйлыктын акыркы формасы мындай:
Бул түзүлүш агентти классикалык стратегияга жакыныраак жүрүүгө түрткү берет. Бирок изилдөөнүн натыйжалары өтө багытталган сыйлык түзүлүштөрү дайыма эле жакшы тышкы үлгү көрсөткүчүн бербей турганын көрсөтөт. Эң ийгиликтүү түзүлүш — жөнөкөйлөштүрүлгөн байкоо мейкиндиги жана зыяндарды бир аз катуураак жазалаган StepPnL сыйлык түзүлүшү.
Графиктердин, Таблицалардын жана Схемалардын Негизги Мааниси
Изилдөөдөгү графиктер менен таблицалардын негизги мааниси — классикалык pair trading стратегиясы крипто рыногунда толугу менен жараксыз эмес; бирок туура чектелген жасалма интеллект катмары айрым учурларда бул базалык стратегияга жакшыраак соода убактысын кошо алат.
Айрыкча Agent 2 деп аталган конфигурация өзгөчөлөнөт. Agent 2 StepPnLReward сыйлык түзүлүшүн, Autonomous байкоо мейкиндигин жана \(\lambda=1.2\) зыян жазасын колдонот. Бул түзүлүш 2025 тышкы үлгү мезгилинде базалык стратегияга караганда жогору тобокелдикке ылайыкталган көрсөткүч берген.
Бирок изилдөөдөгү бардык жасалма интеллект агенттери ийгиликтүү эмес. Айрым агенттер начарыраак же туруксуз натыйжалар берген. Бул маанилүү жагдайды көрсөтөт: финансылык рыноктордо “жасалма интеллект кошуу” өзү эле ийгилик дегенди билдирбейт. Модель архитектурасы, сыйлык функциясы, тобокелдик чектери жана тышкы үлгү тести натыйжаны аныктаган негизги факторлор.
Эксперименттер Кантип Жүргүзүлгөн?
Изилдөөдө Binance USD-M Futures базарынан 1 сааттык баа маалыматтары колдонулган. Үйрөтүү мезгили 2024 жыл, тышкы үлгү тест мезгили болсо 2025 жыл катары бөлүнгөн. Бул айырма модель тарыхый маалыматты жөн гана жаттап алганбы же жокпу түшүнүү үчүн маанилүү.
Система ар ай сайын жаңы актив ааламын түзөт. Адегенде өткөн эки айлык мезгилге карап эң ликвиддүү 100 актив аныкталат. Андан кийин бул активдердин арасындагы болжол менен 4.950 мүмкүн болгон жуп статистикалык жактан бааланат. Акыркы упайы эң жогору 20 жуп тиешелүү айдын соода себетине киргизилет.
Базалык стратегияда кирүү чеги \(3.0\), чыгуу чеги \(0.0\), stop loss коэффициенти \(2.0\), Z-Score терезеси 168 саат жана жуп саны 20 болуп белгиленген. Стратегия 10x leverage менен сыналган. Бул leverage тандоосу стратегиянын тобокелдик профилин туруксуз крипто benchmark’тары менен салыштырууга мүмкүн кылуу үчүн колдонулган. Бирок leverage реалдуу рынокто зыян жана ликвидация тобокелдигин да көбөйтөт.
Жасалма интеллект агенттери 2024 ички үлгү мезгилинде үйрөтүлүп, 2025 тышкы үлгү мезгилинде сыналган. Ар башка сыйлык функциялары, ар башка байкоо мейкиндиктери жана тобокелдик башкаруу катмарынын жөндөөлөрү салыштырылган.
Натыйжалар Эмнени Көрсөтөт?
Изилдөөдө базалык стратегия 2025 тышкы үлгү мезгилинде Bitcoin buy-and-hold жана тең салмактуу портфель benchmark’тарына каршы күчтүү көрсөткүч көрсөткөн. Бул статистикалык pair trading ыкмасы крипто рыногунда белгилүү шарттарда маанилүү сигналдарды кармай аларын көрсөтөт.
Эң көңүл бура турган натыйжа Agent 2 моделинде байкалган. Изилдөөдө Agent 2 үчүн 2025 тышкы үлгү мезгилинде болжол менен %199,45 CAGR, 2,8220 Sharpe катышы жана 3,2494 Sortino катышы кабарланган. Ошол эле мезгилде базалык стратегия үчүн болжол менен %30,40 CAGR, 0,4921 Sharpe катышы жана 0,5360 Sortino катышы берилген.
Бул айырма биринчи караганда абдан күчтүү көрүнөт. Бирок изилдөөчүлөр бул кокустукпу же жокпу баалоо үчүн stationary circular block bootstrap ыкмасын колдонушкан. Натыйжалар Agent 2 моделинин Sharpe жана Sortino айырмалары %10 маанилүүлүк деңгээлинде статистикалык жактан колдоого алынганын, бирок %5 сыяктуу катуураак чек үчүн жетиштүү күчтүү эмес экенин көрсөтөт.
Ошондуктан натыйжаны мындай окуу керек: модель үмүттөндүргөн тышкы үлгү артыкчылыгын көрсөткөн, бирок крипто рыногунун жогорку ызы-чуусу жана чектелген тест мезгилинен улам бул табылганы так инвестициялык жыйынтык катары кароого болбойт.
Бул Эмне Үчүн Маанилүү?
Бул изилдөө финансылык жасалма интеллект талкуусунда маанилүү идеяны алдыга чыгарат: жасалма интеллект финансылык рынокто толук эркин калганда эмес, бекем математикалык чектер жана тобокелдик эрежелери ичинде иштетилгенде маанилүүрөөк натыйжа бере алат.
Криптовалюта базарлары end-to-end үйрөнгөн моделдер үчүн өтө кыйын чөйрө. Анткени мурда иштеген мамиле кыска убакытта бузулушу мүмкүн. Баа катарларында көп ызы-чуу бар. Мындан тышкары, транзакция чыгымдары, leverage жана ликвиддүүлүк тобокелдиктери моделдин жандуу көрсөткүчүнө олуттуу таасир этиши мүмкүн.
Бул изилдөөдөгү гибрид ыкма адегенде статистикалык жактан маанилүү соода мейкиндигин тарылтат; андан кийин жасалма интеллектти ушул мейкиндиктин ичинде соода убактысын жакшыртуу үчүн колдонот. Ушул жагынан изилдөө жасалма интеллект финансылык системаларда “жалгыз чечим чыгаруучу бийлик” болуудан көрө көзөмөлдөнгөн оптималдаштыруу катмары катары колдонулушу мүмкүн экенин көрсөтөт.
Көңүл Буруучу Жагдайлар
Бул изилдөө инвестициялык кеңеш эмес. Натыйжалар тарыхый маалыматка негизделген жана келечекте ошол эле көрсөткүч алынат дегенди билдирбейт.
Модель 10x leverage менен сыналган. Leverage кирешени көбөйтө алгандай эле зыянды жана ликвидация тобокелдигин да көбөйтөт.
Тышкы үлгү мезгили 2025 жыл менен гана чектелет. Сааттык маалымат көп сандагы байкоону бергени менен, бир жылдык мезгил ар башка макро рынок режимдерин чагылдыруу үчүн чектелүү болушу мүмкүн.
Изилдөөдө транзакция төлөмдөрү эске алынган. Бирок жандуу рынокто slippage, order book тереңдиги, ликвиддүүлүктүн үзүлүшү, кескин spread кеңейиши жана биржага байланыштуу тобокелдиктер натыйжаны өзгөртүшү мүмкүн.
Жасалма интеллект агенттеринин көрсөткүчү колдонулган seed, сыйлык функциясы жана тобокелдик катмарынын дизайнына сезгич болушу мүмкүн. Ошондуктан жандуу колдонуу үчүн көп seed тесттери, узагыраак тышкы үлгү мезгилдери жана реалисттик соода симуляциялары керек.
Жыйынтык
Бул академиялык изилдөө крипто pair trading стратегияларында терең бекемдөөчү үйрөнүүнүн потенциалын көзөмөлдөнгөн архитектура менен изилдейт. Эң маанилүү жагы — жасалма интеллектти толук эркин калтырбастан, статистикалык фильтрлер жана детерминисттик тобокелдик чектери менен корголгон система ичинде колдонушу.
Натыйжалар Agent 2 конфигурациясы 2025 тышкы үлгү мезгилинде классикалык базалык стратегияга караганда жакшыраак тобокелдикке ылайыкталган көрсөткүч бергенин көрсөтөт. Бирок бул артыкчылык %10 маанилүүлүк деңгээлинде колдоого алынганы менен, %5 чегинен толук өтпөйт. Бул табылга үмүттөндүргөн, бирок этият чечмелениши керек экенин көрсөтөт.
Verianla үчүн бул изилдөөнүн негизги мааниси мындай: финансылык жасалма интеллект моделдеринде ийгилик жөн гана татаалыраак нейрон тармактарды куруудан келбейт. Кээде эң күчтүү натыйжа жакшы иштелип чыккан статистикалык чектердин, так тобокелдик эрежелеринин жана чектелген милдет берилген жасалма интеллект катмарынын айкалышынан чыгат.
Булак жана Ыкма Жөнүндө Эскертүү
Бул мазмун Dynamic Multi-Pair Trading Strategy in Cryptocurrency Markets with Deep Reinforcement Learning аттуу академиялык PDF каралып даярдалган. Текст сөзмө-сөз котормо эмес. Изилдөөнүн максаты, ыкмасы, негизги формулалары, эксперимент дизайны, табылгалары жана чектөөлөрү Verianla окурмандары үчүн жөнөкөйлөштүрүлүп, өзгөчө жана редакциялык түркчө менен кайра баяндалган.
Формулалар изилдөөдөгү негизги математикалык түзүлүшкө берилген бойдон MathJax шайкеш LaTeX форматында берилген. Жазуу инвестициялык кеңеш, сатып алуу-сатуу сунушу же жандуу соода системасынын сунушу эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген