

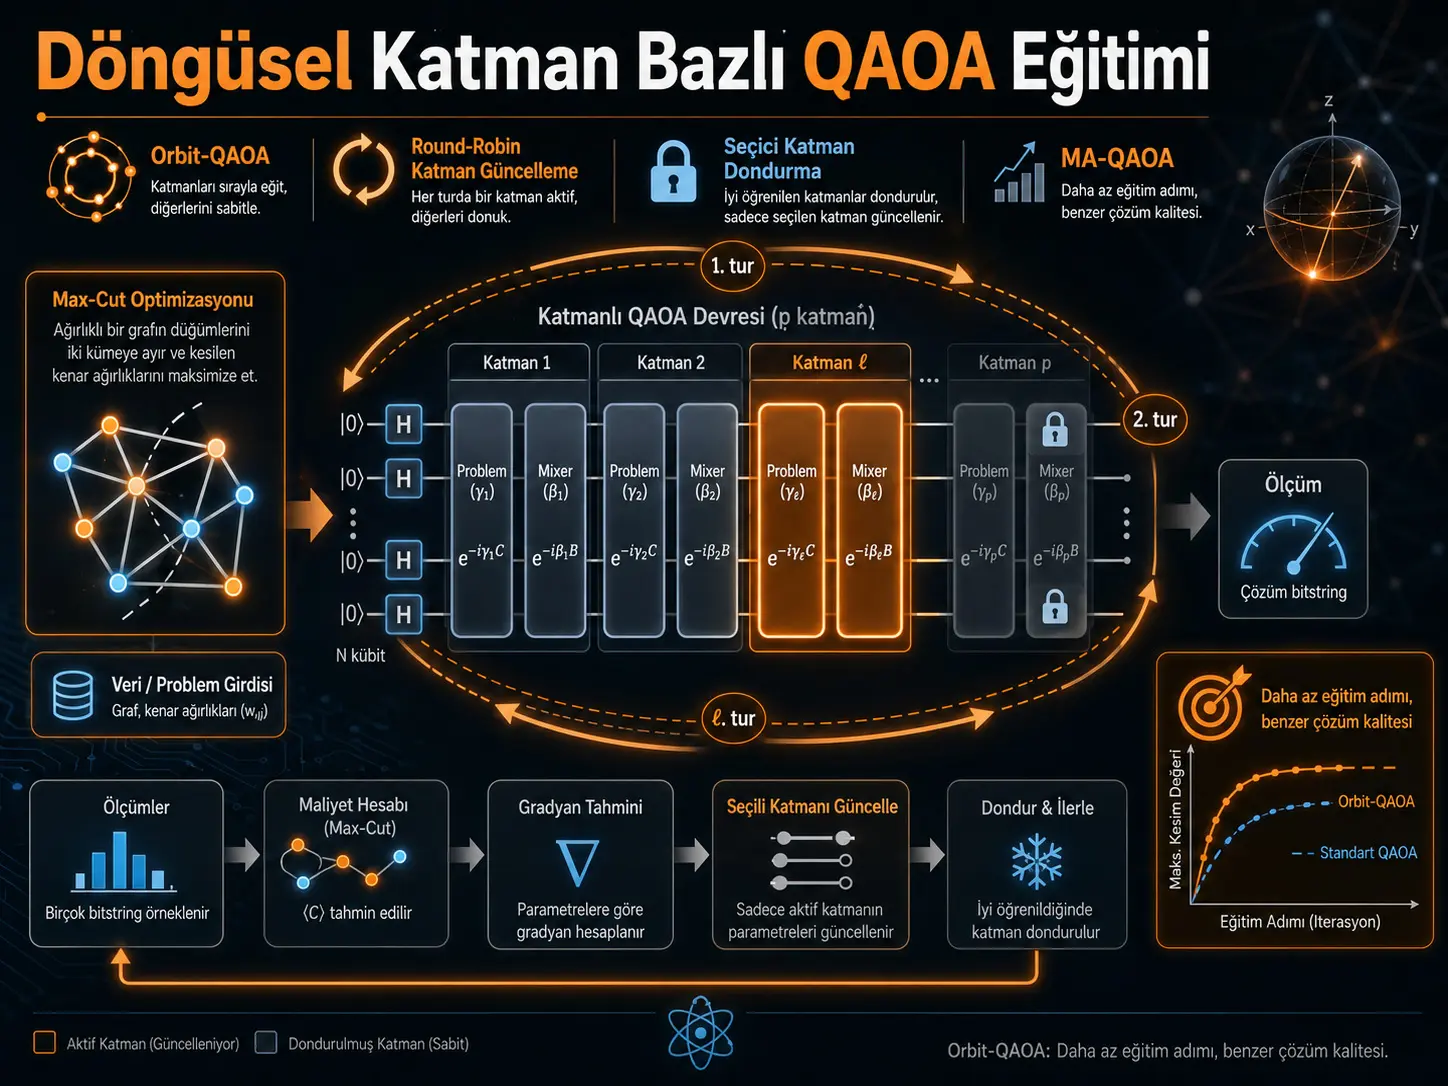
Bu araştırma, kombinatoryal optimizasyon problemlerini çözmek için kullanılan çok açılı Kuantum Yaklaşık Optimizasyon Algoritmasının (Multi-Angle Quantum Approximate Optimization Algorithm, MA-QAOA) klasik optimizasyon yükünü azaltırken çözüm kalitesini korumayı amaçlıyor. Araştırmacılar bunun için Orbit-QAOA adını verdikleri bir eğitim yaklaşımı geliştiriyor: kuantum devresinin bütün parametrelerini aynı anda güncellemek yerine her eğitim adımında yalnız bir QAOA katmanı güncelleniyor, katmanlar round-robin biçiminde tekrar tekrar ziyaret ediliyor ve maliyet fonksiyonuna artık anlamlı katkı sağlamayan katmanlar seçici olarak donduruluyor. Çeşitli Max-Cut grafik deneylerinde Orbit-QAOA, standart MA-QAOA ile karşılaştırılabilir yaklaşık kesim oranına ulaşırken daha az eğitim adımı gerektiriyor; ancak sonuçlar gerçek kuantum işlemcilerinden değil, PennyLane üzerinde yapılan sonlu örneklemeli kuantum devre simülasyonlarından elde ediliyor.
Altı kübit ve beş katmanlı temel karşılaştırmada standart MA-QAOA, RR ve Orbit-QAOA yöntemlerinin geometrik ortalama yaklaşık kesim oranı (Approximated Cut Ratio, ACR) 0,999 olarak raporlanıyor. Orbit-QAOA'nın geometrik ortalama yakınsama adımı 24,5, standart MA-QAOA'nın ise 32,9; kaynak bu karşılaştırma kümesinde Orbit'in gerekli eğitim adımlarını ortalama %25,4, toplam simülasyon çalışma süresini ise yaklaşık %35 azalttığını bildiriyor. Daha geniş değerlendirmelerde standartlaştırılmış durdurma koşulu uygulanmış LMA-QAOA türevine kıyasla eğitim adımlarında %81,8'e kadar azalma ve yaklaşım oranı hatasında 72 kata kadar azalma raporlanıyor.
Çalışmanın önemli sonucu yalnız “daha az parametre güncellemek” değildir. Araştırmacıların deneyleri, bir QAOA katmanının parametrelerinden yalnız yarısını veya üçte birini güncellemek gibi katman-altı parçalamaların yakınsamayı yavaşlatabildiğini gösteriyor. Buna karşılık bir tam QAOA katmanını tek optimizasyon birimi olarak güncellemek, klasik optimizasyon yükü ile yakınsama davranışı arasında etkili bir granülerlik olarak bulunuyor. Daha önce eğitilmiş katmanları kalıcı olarak dondurmak yerine yeniden ziyaret etmek de yeni katmanların oluşturduğu değişmiş parametre manzarasına uyum sağlamalarına olanak veriyor.
Türkiye açısından çalışma belirli bir ülke altyapısını veya Türkiye'deki bir kuantum bilgisayarı sistemini değerlendirmiyor. Dolayısıyla bildirilen hızlanma oranları Türkiye'deki donanımlara doğrudan aktarılabilecek performans rakamları değildir. Yöntemin Türkiye'deki kuantum algoritmaları veya yüksek başarımlı hesaplama araştırmalarına uygulanması durumunda aynı QAOA problemi, devre derinliği, örnekleme sayısı, klasik optimizasyon yöntemi ve gerçek ya da simüle kuantum altyapısı altında yeniden doğrulama gerekir.
QAOA hangi problemi çözmeye çalışıyor?
Kuantum Yaklaşık Optimizasyon Algoritması (Quantum Approximate Optimization Algorithm, QAOA), kombinatoryal optimizasyon problemleri için kuantum ve klasik hesaplamayı birlikte kullanan varyasyonel bir algoritmadır. Çalışmada ana test problemi Maximum Cut (Max-Cut) olarak seçiliyor. Bir \(G=(V,E)\) grafiğinde amaç, düğümleri iki ayrı kümeye ayırarak iki küme arasında kalan kenar sayısını mümkün olduğunca artırmaktır.
Kaynak Max-Cut maliyet Hamiltonyenini şu biçimde tanımlıyor:
\[ C = \frac{1}{2} \sum_{(i,j)\in E} \left( 1-\sigma_z^i\sigma_z^j \right) \]
Burada \(E\) grafiğin kenar kümesini, \(\sigma_z^i\) ve \(\sigma_z^j\) ise ilgili kübitlere uygulanan Pauli-Z operatörlerini ifade ediyor. Bir kenarın iki ucundaki bitlerin farklı kümelere yerleştirilmesi kesime katkı sağladığından amaç, ölçülen kesim sayısının beklenti değerini yüksek tutan devre parametrelerini bulmaktır.
Başlangıç kuantum durumu bütün hesaplama tabanı durumlarının eşit süperpozisyonudur:
\[ |\psi_0\rangle = H^{\otimes n}|0\rangle^{\otimes n} = |+\rangle^{\otimes n} \]
\(p\) katmanlı standart QAOA durumu ise maliyet ve karıştırıcı Hamiltonyenlerin dönüşümlü uygulanmasıyla oluşturulur:
\[ |\psi_p(\boldsymbol{\gamma},\boldsymbol{\beta})\rangle = \left[ \prod_{l=1}^{p} U_M(\beta_l)U_C(\gamma_l) \right] |\psi_0\rangle \]
Standart QAOA'da aynı katmandaki maliyet terimleri ortak \(\gamma_l\), karıştırıcı terimler ise ortak \(\beta_l\) parametresini paylaşır.
Multi-Angle QAOA neden daha pahalı?
Multi-Angle QAOA (MA-QAOA), aynı katmandaki her Hamiltonyen terimine bağımsız varyasyonel parametre atar. Böylece standart QAOA'ya göre daha yüksek ifade gücü elde edilir. Kaynakta bir katmandaki maliyet ve karıştırıcı işleçleri şu şekilde veriliyor:
\[ U_C^{(l)} = \prod_{(i,j)\in E} \exp \left( i\gamma_l^{(i,j)} \sigma_z^i\sigma_z^j \right) \]
\[ U_M^{(l)} = \prod_{j=1}^{n} \exp \left( -i\beta_l^{(j)} \sigma_x^j \right) \]
Grafikte \(m\) kenar, \(n\) düğüm ve devrede \(p\) katman olduğunda MA-QAOA'nın parametre uzayı yaklaşık \(O(pm+pn)\) büyüklüğündedir. Standart tek açılı QAOA'da ise katman başına yalnız bir maliyet ve bir karıştırıcı açısı bulunduğundan parametre sayısı \(O(2p)\) ölçeğindedir. MA-QAOA'nın daha yüksek ifade gücünün bedeli, klasik optimizatörün daha fazla parametre üzerinde gradyan ve güncelleme hesaplaması yapmasıdır.
LMA-QAOA'nın temel sorunu nedir?
Layerwise Multi-Angle QAOA (LMA-QAOA), klasik optimizasyon yükünü azaltmak için devreyi katman katman büyütür. Yeni katman eklenirken yalnız o katmanın parametreleri eğitilir; önceki katmanların parametreleri dondurulur. Böylece tek eğitim aşamasındaki etkin parametre boyutu \(O(pm+pn)\) yerine yaklaşık \(O(m+n)\) seviyesine indirilebilir.
Ancak araştırmacılar önceki katmanların kalıcı olarak dondurulmasının başka bir sorun yarattığını gözlüyor. Devreye yeni katman eklenmesi bütün optimizasyon manzarasını değiştirdiğinden, daha sığ bir devrede iyi çalışan eski parametreler daha derin devre için aynı derecede uygun olmayabiliyor.
Bu durum kaynakta altı düğümlü Sherrington–Kirkpatrick (SK) modeli üzerinden doğrudan inceleniyor. Tablo 1'de \(p=1\), \(p=2\) ve \(p=3\) için eğitilmiş karıştırıcı Hamiltonyen parametreleri karşılaştırılıyor. \(p=1\) durumundaki ilk katman parametrelerinin, \(p=2\) ve \(p=3\) devrelerinde ortaya çıkan parametre yapılarına benzemediği gözleniyor. Araştırmacılar bunu, sığ devrede optimize edilen bir katmanın daha derin devreye doğrudan taşınmasının her zaman iyi bir warm-start sağlamayabileceğine ilişkin deneysel bir işaret olarak yorumluyor.
Orbit-QAOA'nın temel fikri nedir?
Orbit-QAOA, LMA-QAOA'nın “bir defa eğit, sonra kalıcı olarak dondur” yaklaşımını değiştiriyor. Devrenin bütün katmanları baştan mevcut tutuluyor; fakat her eğitim adımında yalnız bir katmanın \(\gamma_l\) ve \(\beta_l\) parametreleri güncelleniyor. Sonraki adımda başka bir katmana geçiliyor ve aktif katmanlar döngüsel biçimde yeniden ziyaret ediliyor.
Bir \(l\) katmanı güncellenirken diğer bütün katmanların en güncel parametreleri sabit tutuluyor. Böylece bir katman, diğer katmanlarda daha önce yapılan değişikliklere göre yeniden uyarlanabiliyor. Çalışmanın ana hipotezi, bu yöntemin MA-QAOA'nın ifade gücünü korurken her adımda klasik optimizatörün işlemesi gereken parametre sayısını azaltabileceğidir.
Verianla Live: Orbit-QAOA eğitim döngüsü
Bu akış, çalışmadaki Algorithm 1 ve yöntem açıklamasının adım sırasını özetler. Şemaya kaynakta bulunmayan ek eğitim aşaması eklenmemiştir.
| Aşama | Açıklama | Kaynak |
|---|---|---|
| 1. Parametreleri başlat | γ ve β parametreleri küçük rastgele değerlerle başlatılır; bütün katmanlar başlangıçta aktif kümeye alınır. | Algorithm 1, satır 1–5 |
| 2. Aktif katmanı seç | Round-robin sırasındaki bir aktif katman ℓ seçilir. | Algorithm 1, satır 6–7 |
| 3. Yalnız seçili katmanı eğitilebilir yap | γ[ℓ] ve β[ℓ] için gradyan etkinleştirilir; diğer katmanlar geçici olarak sabit tutulur. | Algorithm 1, satır 8–10 |
| 4. Güncelleme öncesi maliyeti ölç | Seçili katman güncellenmeden hemen önce Cbefore hesaplanır. | Algorithm 1, satır 11 |
| 5. Bir optimizasyon adımı uygula | Klasik optimizatör yalnız seçili katmanın parametrelerini günceller. | Algorithm 1, satır 12 |
| 6. Güncelleme sonrası maliyeti ölç | Cafter hesaplanır ve değişim Δ = Cafter − Cbefore olarak izlenir. | Algorithm 1, satır 13–15 |
| 7. Katmanın etkinliğini değerlendir | |Δ| < ε ise katman kararlı kabul edilerek aktif kümeden çıkarılır; değilse sonraki döngülerde yeniden ziyaret edilir. | Algorithm 1, satır 16–18 |
| 8. Döngüyü sürdür | Aktif katman kalmayıncaya kadar round-robin eğitim devam eder. | Algorithm 1, satır 19–21 |
Verianla Live: Süreç görünümü bu görünür yöntem tablosundan tarayıcıda oluşturulur. Tablo bilimsel kaynak-of-truth olarak korunur.
Katman ne zaman donduruluyor?
Orbit-QAOA'nın seçici dondurma mekanizması, bir katmanın güncellenmesinden önce ve sonra ölçülen maliyet değişimini kullanıyor:
\[ \Delta C_l^{(t)} = C_l^{\mathrm{after}} - C_l^{\mathrm{before}} \]
Eğer
\[ |\Delta C_l^{(t)}| < \varepsilon \]
koşulu sağlanırsa ilgili katman yeterince kararlı kabul ediliyor ve aktif katman kümesinden çıkarılıyor:
\[ A^{(t+1)} = A^{(t)}\setminus\{l\} \]
Bu yapı bütün devreyi tek bir küresel durdurma kararına bağlamak yerine her katmanın ne kadar ilerleme sağladığını ayrı ayrı takip etmeyi amaçlıyor.
Neden ε = 0,001 seçildi?
Kaynak, sonlu ölçüm sayısının maliyet fonksiyonunda ölçülebilecek en küçük değişimi sınırladığını belirtiyor. Devre her değerlendirmede \(S\) shot ile örnekleniyorsa bir ölçüm sonucunun bir kesim seviyesinden komşu seviyeye kayması beklenen kesim sayısında en küçük
\[ \Delta C=\frac{1}{S} \]
değişimini üretir.
Deneylerde \(S=1024\) shot kullanılıyor. Buna göre \(1/S\) yaklaşık 0,0009766'dır ve araştırmacılar aktiflik eşiğini ε = 0,001 olarak seçiyor. Gerekçe, eşik değerini örnekleme çözünürlüğünün hemen üzerinde tutarak ölçüm nicemlenmesinden kaynaklanan çok küçük değişiklikleri gerçek eğitim ilerlemesi gibi değerlendirmemektir.
Kaynağın daha sonraki eşik duyarlılığı deneyleri, ε büyütüldükçe katmanların erken dondurulabildiğini ve son ACR'nin bozulabildiğini gösteriyor. Şekil 8'de ε, \(1/S\) ile \(125/S\) arasında taranıyor. ε değerinin \(10/S\) ve üzerine çıkmasıyla performans kaybı görünür hâle geliyor; araştırmacılar yeterli ifade gücünü korurken dondurmadan yararlanmak için eşiğin yaklaşık \(5/S\)'nin biraz altında tutulmasını öneriyor.
En verimli güncelleme granülerliği nedir?
Çalışmanın önemli deneylerinden biri, bir eğitim adımında ne kadar büyük bir parametre grubunun güncellenmesi gerektiğini araştırıyor. Şekil 2'de \(k\) değeri bir QAOA katmanının kaç alt parçaya ayrıldığını gösteriyor:
- k = 0,5: bir adımda iki katman güncelleniyor.
- k = 1: bir adımda tam bir QAOA katmanı güncelleniyor; Orbit-QAOA'nın temel granülerliği budur.
- k = 2: bir katmanın parametrelerinin yarısı güncelleniyor.
- k = 3: bir katmanın parametrelerinin üçte biri güncelleniyor.
- k = 2 (parallel): katmanın iki yarısı eşzamanlı güncellenip sonuçlar birleştirilmeye çalışılıyor.
Power-Law ve Sherrington–Kirkpatrick deneylerinde \(k=1\) ile iki katmanı aynı adımda güncelleyen \(k=0,5\) eğrileri birbirine çok yakın ilerliyor. Buna karşılık \(k=2\) ve \(k=3\) gibi tam katmandan daha küçük parametre grupları yakınsamayı yavaşlatıyor. Power-Law örneğinde \(k=1\) yaklaşık 130 adım civarında ACR ≈ 1'e yaklaşırken \(k=2\) benzer düzeye yaklaşık 190 adımda ulaşıyor.
Paralel \(k=2\) yaklaşımı ise aynı katmanın birbirine bağlı parametre gruplarını eşzamanlı güncellediğinde tutarlı bir gradyan iyileşme yönü oluşturamıyor ve kaynakta ACR'nin sürekli ilerlemediği görülüyor. Araştırmacılar bu deneylerden tek bir tam QAOA katmanının verimli eğitimin en küçük uygun parametre granülerliği olduğu sonucuna ulaşıyor.
Katmanların sırası önemli mi?
Şekil 3, 11 kübitli ve \(p=5\) veya \(p=10\) katmanlı devrelerde katmanların sabit sıra ile ya da her round-robin turunda rastgele sıra ile güncellenmesini karşılaştırıyor. Path, Power-Law ve Sherrington–Kirkpatrick grafiklerinde iki seçimin ACR eğrileri birbirine oldukça yakın. Kaynak bu sonucu, MA-QAOA katmanlarının yüksek parametre ifade gücü nedeniyle Orbit-QAOA'nın katman ziyaret sırasına görece dayanıklı olması şeklinde yorumluyor.
Çalışma hangi grafik türlerini test ediyor?
Max-Cut deneyleri sekiz farklı hedef grafik modeli içeriyor:
- Path,
- Power-Law (PL),
- Erdős–Rényi (ER),
- Barabási–Albert (BA),
- Bianconi–Barabási (BB),
- Watts–Strogatz (WS),
- Sherrington–Kirkpatrick (SK),
- Randomly connected (RA).
Bu çeşitlilik, yöntemin yalnız tek bir grafik topolojisinde değerlendirilmemesini sağlıyor; ancak bütün deneyler yine aynı temel Max-Cut/QAOA çerçevesi ve simülasyon ortamı içindedir.
ACR neyi ölçüyor?
Approximated Cut Ratio (ACR), eğitilmiş QAOA devresinin ölçüm sonuçlarından elde edilen beklenen kesim değerinin, aynı grafiğin gerçek maksimum kesim çözümüne oranıdır. Değer 0 ile 1 arasındadır; 1'e yaklaşması elde edilen yaklaşık çözümün gerçek Max-Cut değerine yaklaşması anlamına gelir.
Kaynak aynı zamanda küçük bir ACR'nin yalnız eğitim algoritmasının başarısızlığı anlamına gelmediğini vurguluyor. Yetersiz devre derinliği ifade gücünü sınırlayabilir; çok büyük parametre uzaylarında gradyanların zayıfladığı barren plateau davranışı ortaya çıkabilir ve gerçek kuantum donanımında fiziksel gürültü ayrıca optimizasyon manzarasını etkileyebilir.
Şekil 5 ve Tablo 3 ne gösteriyor?
Altı kübitli, beş katmanlı QAOA devreleri Power-Law, Erdős–Rényi, Barabási–Albert, Bianconi–Barabási, Watts–Strogatz ve Sherrington–Kirkpatrick grafiklerinde beş eğitim stratejisiyle karşılaştırılıyor: MA, LMA, LMA+, RR ve Orbit.
Standartlaştırılmış durdurma koşulunun uygulandığı yöntemler arasında temel sonuçlar şöyledir:
| Yöntem | Geometrik ortalama ACR | Geometrik ortalama çalışma süresi (s) | Geometrik ortalama yakınsama adımı | RPS | GIPS |
|---|---|---|---|---|---|
| MA-QAOA | 0,999 | 134,3 | 32,9 | 4,08 | 0,09 |
| LMA+ | 0,971 | 155,5 | 59,9 | 2,60 | 0,04 |
| RR | 0,999 | 106,3 | 28,8 | 3,69 | 0,11 |
| Orbit-QAOA | 0,999 | 87,2 | 24,5 | 3,56 | 0,12 |
Orbit-QAOA, bu deney grubunda MA-QAOA ile aynı 0,999 geometrik ortalama ACR'yi korurken daha az eğitim adımı ve daha düşük toplam simülasyon süresiyle sonuca ulaşıyor. LMA+ adım başına daha düşük parametre güncelleme maliyetine sahip olsa da erken katmanları tekrar optimize edemediğinden son ACR'si 0,971'de kalıyor ve yakınsama için daha fazla adım gerektiriyor.
Devre derinliği arttığında ne oluyor?
Şekil 4 ve Tablo 2, Orbit-QAOA'nın \(p=1\), \(p=2\) ve \(p=3\) katmanlı sığ devrelerdeki davranışını inceliyor. Path, Power-Law ve Sherrington–Kirkpatrick grafiklerinde 5, 10, 15 ve 20 kübitlik örnekler kullanılıyor.
Bütün bu örneklerin geometrik ortalamasında ACR, \(p=1\) için 0,801, \(p=2\) için 0,948 ve \(p=3\) için 0,959. Kaynak bunu \(p=1\)'e göre sırasıyla %18,4 ve %19,7 artış olarak raporluyor. Daha dikkat çekici sonuç, yakınsama adım sayısının katman sayısıyla birlikte artmaması: geometrik ortalama adım sayısı \(p=1\) için 71,6, \(p=2\) için 52,8 ve \(p=3\) için 35,6 olarak veriliyor.
Araştırmacılar bu davranışı daha derin devrenin artan ifade gücü ve Orbit'in kararlı katmanları eğitim programından çıkarmasıyla açıklıyor. Ancak bu sonuç, “daha derin kuantum devresi her zaman daha hızlıdır” şeklinde genel bir kural değildir; çalışmanın belirli grafik, optimizatör ve simülasyon koşullarında gözlenen davranışıdır.
Daha derin devrelerde MA-QAOA ile fark ne kadar?
Tablo 4'te farklı bağlantı oranlarına sahip rastgele grafiklerde MA-QAOA ile Orbit-QAOA karşılaştırılıyor. Her iki yöntem için geometrik ortalama ACR 0,999. MA-QAOA'nın geometrik ortalama yakınsama adımı 54,56 iken Orbit-QAOA için 36,55. Kaynak, Orbit'in gerekli eğitim adımlarını ortalama %25,52, incelenen tekil koşullardan birinde ise en fazla %59,26 azalttığını bildiriyor.
En büyük tablolaştırılmış azalma, bağlantı oranı \(r=0,2\) ve \(p=11\) olan durumda görülüyor: MA-QAOA 81, Orbit-QAOA 33 yakınsama adımı gerektiriyor ve her ikisi de 0,999 ACR değerine ulaşıyor.
Aktif katman sayısı eğitim boyunca nasıl değişiyor?
Şekil 6 ve Şekil 7, 21 kübitli Power-Law ve Barabási–Albert grafiklerinde Orbit-QAOA'nın aktif katman sayısını takip ediyor. Power-Law grafiğinde ACR 1'e yaklaştıktan sonra aktif katmanların sayısı hızla düşüyor; yani birçok katman kısa sürede donduruluyor ve son ince ayar birkaç katmana kalıyor.
Barabási–Albert grafiklerinde durum farklı. Özellikle düşük \(p\) değerlerinde sınırlı devre ifade gücü nedeniyle ACR yaklaşık 0,975 civarında sonlanabiliyor ve katmanların çoğu eğitimin sonlarına kadar aktif kalıyor. Daha yüksek \(p\) değerlerinde ACR ilerlemeye devam ettikçe dondurma işlemi de daha geç gerçekleşiyor. Kaynak bunu Orbit'in katman dondurma davranışının hedef grafiğin yapısına ve devre derinliğine uyum sağlayabildiğinin göstergesi olarak değerlendiriyor.
Quantum Alternating Operator Ansatz'a genişletildiğinde ne oluyor?
Orbit yaklaşımı yalnız standart MA-QAOA karıştırıcısıyla sınanmıyor. Çalışma, quantum alternating operator ansatz çerçevesinde XY-mixer ve Y-mixer Hamiltonyenleriyle 13 kübit, beş katmanlı Path, Power-Law ve Sherrington–Kirkpatrick devrelerini de inceliyor.
Tablo 5'in geometrik ortalamasında hem MA hem Orbit 0,999 ACR elde ediyor. MA'nın yakınsama adımı 64,9 iken Orbit'in değeri 40,7; kaynak bunu yaklaşık %37,3 daha az eğitim adımı olarak raporluyor. GIPS ise MA için 0,206'dan Orbit için 0,326'ya yükseliyor ve kaynak bunu yaklaşık %58,3 iyileşme olarak ifade ediyor.
Tek açılı QAOA'da yöntem çalışıyor mu?
Çalışmanın son genişletme deneyi Orbit'i single-angle QAOA'ya uyguluyor. Path ve Power-Law grafiklerinde 8, 10 ve 12 kübitli, beş katmanlı devreler karşılaştırılıyor.
Tablo 6'da standart Single-Angle QAOA'nın geometrik ortalama ACR'si 0,933, Orbit'in geometrik ortalama ACR'si de 0,933. Ortalama yakınsama adımı 45,2'den 36,2'ye düşüyor; bu %19,9 azalmaya karşılık geliyor. Geometrik ortalama simülasyon süresi 521,6 saniyeden 363,0 saniyeye düşüyor ve kaynak yaklaşık %30,4 azalma bildiriyor.
Kaynak içi editoryal not: Bölüm 6.7.2'de bu sonuç anlatılırken “RR achieves an average ACR of 0.933” ifadesi kullanılıyor. Ancak ilgili Şekil 10 ve Tablo 6 karşılaştırmasında listelenen yöntemler SA, LSA, LSA+ ve Orbit'tir; RR ayrı bir satır olarak bulunmamaktadır. Bu nedenle kaynak metindeki “RR” ifadesi bu makalede sessizce Orbit olarak değiştirilmemiş, bir kaynak tutarsızlığı olarak not edilmiştir.
Rastgele başlangıç parametrelerinde sonuç korunuyor mu?
Şekil 12, 7 kübitli ve beş katmanlı rastgele grafiklerde üç bağlantı oranı için beş farklı rastgele başlangıçla MA-QAOA ve Orbit-QAOA'yı karşılaştırıyor. Seyrek \(r=0,3\) grafiklerinde Orbit'in 0,99'un üzerinde ACR'ye ulaşmak için ortalama olarak MA-QAOA'dan %51'den fazla daha az eğitim adımı gerektirdiği bildiriliyor.
Yoğun \(r=0,9\) grafiklerinde her iki yöntem ilk beş adım içinde 0,97'nin üzerinde ACR'ye ulaşabiliyor; fark özellikle son ince ayar aşamasında ortaya çıkıyor. Orbit'in 0,999 ACR'ye ulaşmak için %35'ten fazla daha az adım kullandığı raporlanıyor.
Gerçek kuantum cihazları hakkında çalışma ne söylüyor?
Çalışma gerçek kuantum donanımında Orbit-QAOA eğitimi gerçekleştirmiyor. Bunun yerine tartışma bölümünde gelecekteki cihazlar için iki farklı senaryoyu değerlendiriyor. Fiziksel hata oranı yüksekse devre derinliğinin sınırlı tutulması gerektiği; hata oranı yeterince düşük fakat işlem hızı yavaşsa, Orbit'in daha derin devrelerde daha az eğitim epoch'u gerektirebilmesinin avantaj sağlayabileceği öne sürülüyor.
Bu kısım deneysel donanım doğrulaması değil, simülasyon sonuçlarından hareketle yapılan yöntemsel bir değerlendirmedir. Kaynak ayrıca toplam gerçek donanım süresinin yalnız devre derinliğiyle belirlenmeyebileceğini tartışıyor; fakat Orbit'in gerçek kuantum işlemcide aynı yüzdelerde hızlanma sağlayacağı bu çalışma tarafından ölçülmemiştir.
Çalışmanın desteklediği sonuçlar
- MA-QAOA eğitiminde bir tam katmanı tek güncelleme birimi yapmak, incelenen katman-altı güncellemelere göre daha etkili bir granülerliktir.
- Önceden eğitilmiş katmanları kalıcı biçimde dondurmak, devre derinliği değiştikçe parametrelerin yeni optimizasyon manzarasına uyumunu kısıtlayabilir.
- Katmanları round-robin biçimde yeniden ziyaret etmek standart MA-QAOA ile karşılaştırılabilir ACR değerlerine ulaşabilir.
- Kararlı katmanların seçici olarak dondurulması gereksiz parametre güncellemelerini azaltabilir.
- Altı kübit, beş katmanlı ana karşılaştırmada Orbit-QAOA 0,999 geometrik ortalama ACR'yi korurken MA-QAOA'ya göre daha az yakınsama adımı ve daha düşük toplam simülasyon süresi göstermiştir.
- Orbit yaklaşımı çalışmadaki deneylerde quantum alternating operator ansatz ve single-angle QAOA yapılarına da uygulanabilmiştir.
Çalışmanın desteklemediği veya kanıtlamadığı sonuçlar
- Orbit-QAOA'nın gerçek kuantum bilgisayarlarda aynı oranlarda hızlanacağı gösterilmemiştir.
- Simülasyon süresindeki azalma, gerçek kuantum donanımında aynı oranda duvar saati süresi veya enerji tüketimi azalması anlamına gelmez.
- Çalışma bütün kombinatoryal optimizasyon problemlerinde Orbit-QAOA'nın üstün olduğunu kanıtlamaz; ana deneyler Max-Cut ve belirli grafik aileleri üzerindedir.
- Daha derin devrelerin her kuantum donanımı ve her problemde daha hızlı yakınsayacağı sonucu çıkarılamaz.
- 0,999 ACR gerçek kuantum avantajı veya klasik algoritmalara karşı üstünlük kanıtı değildir.
- Sonlu-shot simülatör deneyleri gerçek cihaz gürültüsünü, kalibrasyon hatalarını ve donanım bağlantı kısıtlarını eksiksiz temsil etmez.
Çalışmanın Yöntemi ve Bulguları
Deneysel hesaplama ortamı
| Öğe | Kaynakta kullanılan değer/yöntem |
|---|---|
| Kuantum yazılım çerçevesi | PennyLane 0.38.0 |
| Python | 3.9.22 |
| Simülatör | default.qubit |
| Örnekleme | 1.024 shot |
| Klasik optimizatör | AdaGrad |
| AdaGrad step size | 0,1 |
| Aktiflik eşiği | ε = 0,001 |
| ≤20 kübit deneyler | Intel Jasper Lake N5095, 32 GB DDR4 |
| >20 kübit deneyler | AMD Threadripper PRO 3975WX, 1024 GB DDR4 |
Çalışma gerçek kuantum işlemci üzerinde değil, kuantum devre simülatörü üzerinde yürütülmüştür. Bu ayrım özellikle çalışma süresi sonuçları değerlendirilirken önemlidir.
Karşılaştırılan eğitim senaryoları
| Yöntem | Temel eğitim davranışı |
|---|---|
| MA | Bütün MA-QAOA katmanlarının parametreleri aynı eğitim adımında birlikte güncellenir. |
| LMA | Katmanlar sırayla eklenir; önceki katmanlar dondurulur. Kaynaktaki temel LMA deneyinde katman başına sabit 50 eğitim adımı kullanılır. |
| LMA+ | LMA yaklaşımına ε tabanlı birleşik durdurma/dondurma koşulu eklenir. |
| RR | Katmanlar round-robin biçimde yeniden eğitilir ancak kararlı katmanları seçici olarak atlama mekanizması kullanılmaz. |
| Orbit | Round-robin katman eğitimi ile ε tabanlı seçici katman dondurma birlikte kullanılır. |
Yakınsama adımı nasıl tanımlandı?
Standart durdurma koşulu uygulanmayan orijinal LMA-QAOA için her katmana sabit sayıda eğitim adımı ayrılıyor. Diğer yöntemlerde ise eğitim aktif katmanların iyileşmesi ε eşiğinin altına düşünce sonlandırılıyor.
Kaynak, yakınsama adımını eğitim sırasında gözlenen maksimum ACR'nin %99,9'una ilk ulaşılan adım olarak tanımlıyor. Bu nedenle “# Steps” yalnız toplam çalıştırma sayısı değil, kaynağın özel yakınsama ölçütüne bağlı bir metriktir.
Runtime Per Step nasıl hesaplandı?
Runtime Per Step (RPS) şu şekilde tanımlanıyor:
\[ \mathrm{RPS} = \frac{\mathrm{Toplam\ simülasyon\ süresi\ (s)}} {\#\mathrm{Steps}} \]
Bu süre kuantum devre simülasyonunu ve klasik optimizatörün parametre güncelleme yükünü birlikte içeriyor. Kaynak açık biçimde, simülasyon çalışma süresindeki azalmaların gerçek kuantum donanımındaki çalışma süresine bire bir çevrilemeyeceğini belirtiyor.
GIPS metriği ve kaynak içindeki işaret tutarsızlığı
Gradient Improvement Per Step (GIPS), kaynakta şu şekilde tanımlanıyor:
\[ \mathrm{GIPS} = \frac{ C_0-C_{\mathrm{converged}} }{ \#\mathrm{Steps} } \]
Kaynağın bu bölümünde QAOA'nın maliyet fonksiyonunu minimize ettiği ve dolayısıyla GIPS'in genellikle pozitif olduğu belirtiliyor. Buna karşılık çalışmanın Max-Cut girişinde \(\langle C\rangle\) değerinin klasik optimizatör tarafından maksimize edildiği açıklanıyor ve Orbit'in bazı yöntem denklemleri `arg min` biçiminde yazılıyor. Dolayısıyla kaynak boyunca maliyet fonksiyonunun işaret/yön konvansiyonu tamamen tek anlamlı değildir.
Bu Verianla açıklamasında söz konusu fark sessizce düzeltilmemiştir. GIPS değerleri kaynakta raporlandığı biçimde verilmiş; ACR karşılaştırmaları ise doğrudan çalışmanın tablolarındaki sonuçlara dayandırılmıştır.
Altı kübit, beş katmanlı ana karşılaştırmanın ayrıntıları
| Grafik | MA ACR / adım | Orbit ACR / adım |
|---|---|---|
| Power-Law | 0,999 / 12 | 0,999 / 10 |
| Erdős–Rényi | 0,999 / 44 | 0,999 / 34 |
| Barabási–Albert | 0,999 / 30 | 0,999 / 26 |
| Bianconi–Barabási | 0,999 / 46 | 0,999 / 29 |
| Watts–Strogatz | 0,999 / 47 | 0,999 / 37 |
| Sherrington–Kirkpatrick | 0,999 / 37 | 0,999 / 23 |
Bu tabloda Orbit bütün altı grafikte MA-QAOA ile aynı 0,999 ACR değerine ulaşırken kaynakta tanımlanan yakınsama adımını her örnekte daha düşük tutuyor. Bununla birlikte bu sonuçların tamamı altı kübit, beş katmanlı ve kaynakta tanımlanan simülasyon ortamına aittir.
Yöntemin en önemli sınırlılıkları
- Deneyler gerçek kuantum donanımında gerçekleştirilmemiştir.
- Çalışma süresi karşılaştırmaları simülasyon ve klasik optimizatör yükünü içerir.
- Gerçek cihazlardaki fiziksel gürültü ana performans tablolarında deneysel olarak uygulanmamıştır.
- Deneylerin temel optimizasyon problemi Max-Cut'tır.
- Aktiflik eşiğinin seçimi sonuçları etkiler; eşik fazla yüksek olduğunda katmanlar erken dondurulabilir.
- Devre derinliği ile yakınsama arasındaki olumlu ilişki test edilen problem ve konfigürasyonlarla sınırlıdır.
- Çalışmada üretilmiş veya analiz edilmiş bağımsız bir veri seti bulunmamaktadır; sonuçlar kuantum devre simülasyonlarından elde edilmektedir.
Kaynak ve Yöntem Notu
Yüklenen kaynağın tam özgün başlığı:A Cyclic Layerwise QAOA Training.
Yazarlar, kaynak sırasıyla: Enhyeok Jang; Zihan Chen; Dongho Ha; Seungwoo Choi; Yongju Lee; Jaewon Kwon; Eddy Z. Zhang; Yipeng Huang; Won Woo Ro.
Eş katkı/eş birinci yazar: Yüklenen kaynakta eş birinci yazar veya eş katkı beyanı bulunmamaktadır.
Sorumlu yazar: Won Woo Ro.
Kurumlar: School of Electrical and Electronic Engineering, Yonsei University, Seoul, Korea; Department of Computer Science, Rutgers University, Piscataway, NJ, United States; Dongho Ha için kaynakta “Unaffiliated, Seoul, Korea” ifadesi kullanılmaktadır.
Yüklenen kaynak türü: arXiv sürümü, arXiv:2601.20029v1 [quant-ph], 27 Ocak 2026. Yüklenen çalışma bir arXiv sürümüdür ve kendisi hakemli dergi nüshası değildir. Bununla birlikte aynı çalışmanın hakem değerlendirmesinden geçmiş yayımlanmış sürümü bulunmaktadır.
arXiv DOI: 10.48550/arXiv.2601.20029.
Hakemli yayın sürümü: Aynı çalışma resmî Springer kaydında “Layerwise retraining and freezing for multi-angle QAOA” başlığıyla yayımlanmıştır. Yüklenen arXiv başlığı ile hakemli yayın başlığı aynı değildir; bu farklılık sessizce birleştirilmemiştir.
Dergi:Quantum Machine Intelligence.
Cilt ve makale numarası: Volume 8, Article 5 (2026).
Hakemli yayın DOI: 10.1007/s42484-026-00357-w.
Yayınevi: Springer Nature.
Hakemli yayın tarihleri: Alınma: 20 Temmuz 2025; kabul: 7 Ocak 2026; yayımlanma/version of record: 26 Ocak 2026.
Resmî bağlantılar:https://arxiv.org/abs/2601.20029 ve https://doi.org/10.1007/s42484-026-00357-w.
Lisans: arXiv kaydı yüklenen sürüm için CC BY 4.0 lisansına yönlendirmektedir. Hakemli Springer sürümünde makale haklarının yayın anlaşması kapsamında Springer Nature veya ilgili hak sahibinde olduğu belirtilmektedir. Bu Verianla makalesinde yayıncı sürümünün özgün şekilleri kopyalanmamış; yüklenen kaynaktaki sayısal veriler ve yöntem adımları görünür HTML tablolarıyla yeniden ifade edilmiştir.
Finansman: Çalışma National Research Foundation of Korea kapsamında “Creation of the Quantum Information Science R&D Ecosystem Based on Human Resource” projesi (RS-2023-00303229), United States Department of Energy Award DE-SC0025563 ve Kore hükümeti MSIT tarafından desteklenen Quantum Information Research Support Center eğitim programı (RS-2023-NR057243) tarafından desteklenmiştir.
Veri erişilebilirliği: Kaynak, çalışma sırasında herhangi bir veri seti üretilmediğini veya analiz edilmediğini bildiriyor.
Kod erişilebilirliği: Kodun makul talep üzerine sorumlu yazardan edinilebileceği belirtiliyor.
Çıkar çatışması: Yazarlar çıkar çatışması bulunmadığını beyan ediyor.
Yazar katkıları: Enhyeok Jang proje fikrini geliştirmiş, sayısal deneyleri yürütmüş ve ilk taslağı yazmıştır. Zihan Chen fikir genel görünümünü ve deney sonuçlarını görselleştirmiştir. Dongho Ha yöntem kısmını düzenlemiştir. Seungwoo Choi ilgili çalışmaları araştırıp analiz etmiştir. Yongju Lee arka plan bölümünü, Jaewon Kwon motivasyon bölümünü düzenlemiştir. Eddy Z. Zhang sayısal deney sonuçlarını analiz etmiştir. Yipeng Huang giriş ve gözlem bölümlerini düzenlemiş ve sayısal deneylerin yazım akışını yönlendirmiştir. Won Woo Ro araştırmayı denetlemiştir.
Kaynak içi tutarsızlıklar: Max-Cut maliyet beklentisinin maksimize edildiği anlatımla bazı `arg min` ve GIPS minimizasyon ifadeleri arasında işaret/amaç fonksiyonu anlatımı açısından görünür bir uyumsuzluk bulunmaktadır. Bölüm 6.7.2'de Tablo 6 sonucu “RR”ye atfedilirken Tablo 6'da ilgili yöntem Orbit olarak listelenmiştir. Şekil 10 açıklaması “8-qubit” ifadesini kullanmasına karşın şekil 8, 10 ve 12 kübitlik alt grafikler içermektedir. Ayrıca Orbit-QAOA açılımının kaynak metninde “layewIse” biçiminde görünen bir yazım hatası bulunmaktadır. Bu noktalar bilimsel içeriğe yeni bir düzeltme eklenmeden kaynak içi editoryal sorunlar olarak korunmuştur.
Bilimsel içerik sınırı: Bu Verianla makalesindeki yöntem, sayısal sonuçlar, denklemler ve performans yorumları yüklenen çalışmaya dayanmaktadır. Dış kaynaklar yalnız başlık sürümü, DOI, dergi, hakemlik, yayın tarihi ve lisans gibi bibliyografik alanları doğrulamak için kullanılmış; dışarıdan yeni bilimsel sonuç eklenmemiştir. Çalışmanın ana performans değerlendirmeleri gerçek kuantum donanımından değil PennyLane tabanlı kuantum devre simülasyonlarından elde edilmiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir