

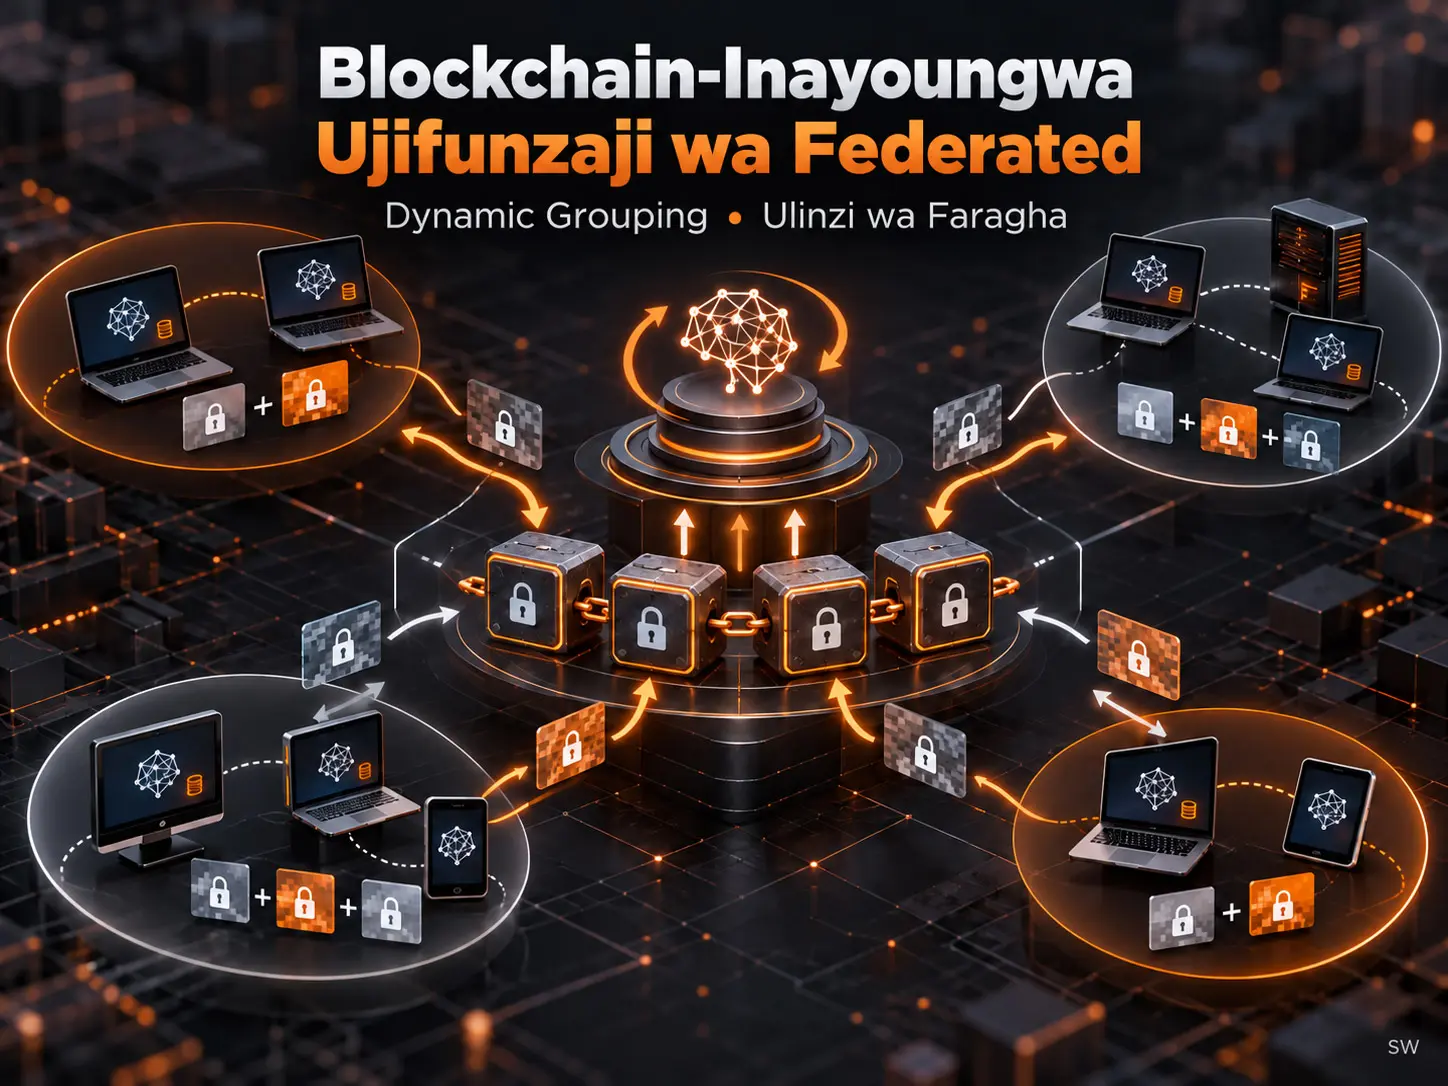
Mfumo uliopendekezwa katika utafiti huu ni mfumo wa ujifunzaji shirikishi unaolinda faragha unaounganisha ujifunzaji wa federated, unaolenga kuendeleza modeli ya pamoja ya ujifunzaji wa mashine bila kuhamisha data za mafunzo za ndani kwenda kituo kimoja, na blockchain yenye ruhusa ya Hyperledger Fabric, upangaji wa watumiaji katika makundi kwa njia ya dinamik, ugawaji wa jumla unaotegemea makundi, kuficha kwa muda na uratibu unaoungwa mkono na sifa. Data ghafi za mafunzo za watumiaji hazipakuliwi kwenye blockchain. Gradient za ndani pia haziandikwi moja kwa moja kwenye mnyororo; kwanza hugawanywa kuwa shares ndani ya makundi ya watumiaji wawili au watatu, thamani za kiwango cha share hufichwa kwa vekta za nasibu za muda, na ni thamani hizi zilizofichwa pamoja na rekodi zinazohusu aggregation pekee zinazohamishwa kwenye ledger yenye ruhusa.
Mfumo huu hugawa watumiaji katika makundi ya watu wawili au watatu katika kila raundi ya mawasiliano kulingana na sifa zao na utayari wa kushirikiana. Gradient za ndani hubadilishwa kuwa shares za jumla kwenye finite field; kila thamani ya kiwango cha share inayopakiwa hufunikwa kwa vekta tofauti ya nasibu. Jumla inayohitajika ya vekta za nasibu hulindwa kwa utaratibu wa threshold na kamati iliyoidhinishwa ya recovery ili kushughulikia hali ya mtumiaji kuondoka au kutotoa taarifa inayohitajika ya recovery. Safu ya Hyperledger Fabric hushughulikia uthibitishaji wa utambulisho, utekelezaji wa chaincode, endorsement, ordering, validation na rekodi zinazoweza kukaguliwa.
Majaribio ya proof-of-concept yalifanywa kwenye dataset ya MNIST. Operesheni ya additive sharing ya pande mbili ilichukua takribani 12,6 ms, na sharing ya pande tatu takribani 16,9 ms. Ingawa maandishi ya makala yanaripoti kuwa mbinu iliyopendekezwa ilifikia usahihi wa %99,6 katika jaribio la kulinganisha la MNIST, lebo kwenye Kielelezo 8 ni %99,56. Tofauti iliyoripotiwa na waandishi ni kati ya pointi za asilimia 1,06 na 3,96 ikilinganishwa na mbinu zilizolinganishwa. Hata hivyo, matokeo yanahusu tu mazingira ya prototype yaliyotathminiwa: utafiti hautoi proof kamili ya usalama wa cryptographic wa simulation-based, hauonyeshi usalama dhidi ya Byzantine model poisoning au collusion isiyo na kikomo, na haufanyi uthibitishaji wa kliniki kwenye data halisi za afya.
Tatizo la faragha katika federated learning hujitokeza wapi?
Wazo kuu katika federated learning ni kuweka data ghafi kwenye kifaa cha mtumiaji na, kwa ajili ya mafunzo ya kati, kushiriki taarifa za masasisho kama vile parameter za modeli au gradient badala ya data yenyewe. Ingawa mkabala huu huzuia data ghafi kukusanywa moja kwa moja katika kituo kimoja, masasisho ya modeli yenyewe pia yanaweza kubeba taarifa. Kwa sababu hiyo, utafiti chanzo hauchukulii sharti la “data ghafi haiendi kwenye chain” kuwa dhamana ya kutosha ya faragha peke yake; badala yake unalenga hasa kupunguza mwonekano wa moja kwa moja wa masasisho ya ndani ya mtu mmoja mmoja.
Dataset ya ndani ya mtumiaji \(u_i\) imefafanuliwa katika chanzo kama
\[ D_i=\{(x_{i,k},y_{i,k})\}_{k=1}^{N_i} \]
. Hapa \(N_i\) ni idadi ya sampuli za ndani alizo nazo mtumiaji. \(x_{i,k}\) inaonyesha sampuli ya kuingiza na \(y_{i,k}\) inaonyesha lebo.
Katika raundi ya mawasiliano \(t\), ikiwa vekta ya parameter za modeli ya global ni \(W^{(t)}\), empirical loss ya mtumiaji inaelezwa kwa
\[ L_i(W^{(t)})= \frac{1}{N_i} \sum_{k=1}^{N_i} \ell\left( f(x_{i,k};W^{(t)}),y_{i,k} \right) \]
. Gradient ya ndani
\[ g_i^{(t)}=\nabla L_i(W^{(t)}) \]
huhesabiwa na katika chanzo update ya modeli ya ndani hutolewa kama
\[ W_i^{(t+1)} = W^{(t)}-\alpha g_i^{(t)} \]
. Katika fomula hii, \(\alpha>0\) imefafanuliwa na chanzo kama learning rate.
Uingiliaji wa faragha wa protocol iliyopendekezwa hutokea kabla gradient \(g_i^{(t)}\) haijapakiwa kwenye blockchain katika hali hii. Gradient kwanza husimbwa kwenye finite field, hugawanywa kuwa additive shares ndani ya kundi dogo, na thamani ya kiwango cha share itakayoenda kwenye chain hufichwa pia kwa vekta ya nasibu ya muda.
Kwa nini Hyperledger Fabric inatumika?
Utafiti haujengi permissionless blockchain ya jumla wala mfumo wa Proof-of-Work. Hyperledger Fabric hutumiwa kama jukwaa la blockchain lenye ruhusa ambalo lina udhibiti juu ya nani anayeweza kujiunga na mtandao. Fabric peers hupitisha transactions katika hatua za endorsement, ordering, validation na ledger commitment, huku chaincode ikitekeleza mantiki ya rekodi za kiwango cha share na mchakato wa aggregation.
Mfumo una entities tano kuu: clients wanaofanya mafunzo kwa data za ndani; Fabric peers walioidhinishwa; chaincode inayotekeleza kazi ya smart contract; huduma ya membership inayotegemea vyeti; na kamati iliyoidhinishwa ya recovery inayowezesha vekta za muda za kuficha kurejeshwa kwa utaratibu wa threshold inapohitajika.
Kamati ya recovery inafafanuliwa kwa seti
\[ C_{\mathrm{rec}}=\{c_1,c_2,\ldots,c_h\} \]
na threshold inayohitajika kwa
\[ \tau_{\mathrm{rec}}\in\{1,2,\ldots,h\} \]
. Mchango wa vekta ya nasibu unaokosekana hauwezi kujengwa upya isipokuwa angalau \(\tau_{\mathrm{rec}}\) recovery shares halali zipatikane. Jukumu la kamati si kushiriki katika mafunzo ya modeli ya ndani, bali kuweza kutengeneza jumla ya vekta ya nasibu inayohitajika kwa global aggregation ndani ya wigo unaoaminika wa recovery.
Dynamic grouping inafanyaje kazi?
Dynamic grouping ni utaratibu wa hatua mbili wa kuunda makundi ambao katika kila raundi ya mawasiliano kwanza hupanga watumiaji kwa sifa, huunda core groups za watumiaji wawili kwa kutumia scores za uoanifu wa pande mbili, na ikiwa expansion score inatosha huongeza kundi hadi watumiaji watatu; watumiaji wanaobaki bila pairing hupewa makundi kwa utaratibu kwa kutumia scores zao za sifa.
Katika raundi ya mawasiliano \(t\), matrix inayoonyesha utayari wa watumiaji kufanya kazi wawili wawili imefafanuliwa kama
\[ \Omega^{(t)} = \left(w_{ij}^{(t)}\right)_{m\times m} \]
. Katika chanzo
\[ w_{ij}^{(t)}\in\{0,1,2\} \]
ambapo 2 inawakilisha utayari mkubwa, 1 wa kati na 0 mdogo. Uoanifu wa pande mbili kati ya watumiaji wawili huhesabiwa kwa
\[ s_{ij}^{(t)} = w_{ij}^{(t)}+w_{ji}^{(t)} \]
.
Mwanzoni mwa kila raundi, watumiaji ambao bado hawajapangiwa kundi hupangwa kwa scores za sifa kutoka kubwa kwenda ndogo. Mtumiaji mwenye sifa ya juu zaidi huwa initiator na huchagua mtumiaji ambaye hajaoanishwa anayetoa score ya juu zaidi ya \(s_{ij}^{(t)}\) pamoja naye. Ikiwa kuna tie, kwanza sifa ya juu zaidi na kisha mpangilio wa kudumu wa user ID hutumika kuamua.
Baada ya kuunda core group ya wanachama wawili \(\{u_i,u_j\}\), expansion score kwa mgombea wa tatu \(u_k\) huhesabiwa kama
\[ c_{ij,k}^{(t)} = s_{ik}^{(t)}+s_{jk}^{(t)} \]
. Ikiwa
\[ \max_{u_k} c_{ij,k}^{(t)}\geq\tau_3 \]
basi mgombea mwenye score ya juu zaidi huongezwa kwenye kundi na kundi la watumiaji watatu hutengenezwa. Vinginevyo kundi hubaki na watu wawili.
Watumiaji wanaobaki bila pairing hushughulikiwaje?
Baada ya hatua ya voluntary grouping, seti ya watumiaji waliobaki huonyeshwa kwa \(R\). Ikiwa angalau watumiaji watatu wamebaki, watumiaji watatu wa kwanza katika mpangilio wa sifa huwekwa pamoja kwa kurudia. Ikiwa wamebaki watumiaji wawili hasa, kundi la watu wawili huundwa moja kwa moja. Ikiwa amebaki mtumiaji mmoja, mfumo hutafuta kundi la mtumiaji mwenye sifa ya chini zaidi miongoni mwa watumiaji waliokwisha pangiwa. Ikiwa kundi hilo lina watu wawili, mtumiaji aliyebaki huwa mwanachama wa tatu. Ikiwa kundi tayari lina watu watatu, watumiaji wanne huwekwa pamoja kwa muda, hupangwa kwa sifa na kugawanywa tena katika makundi mawili ya watu wawili.
Kwa hiyo willingness matrix hutumika tu katika voluntary matching. Uwekaji wa watumiaji waliosalia katika kiwango cha mfumo huamuliwa na scores za sifa. Waandishi hawadai kwamba kikomo cha makundi ya watumiaji wawili na watatu ni optimal kwa nadharia; chaguo hili ni muundo wa protocol uliofanywa kwa sababu ya urahisi wa utekelezaji na ufanisi wa mawasiliano.
Reputation score inapima nini?
Utaratibu wa reputation hulinganisha utendaji wa update iliyowasilishwa na mtumiaji kwenye seti ya uthibitishaji ya pamoja na thabiti dhidi ya washiriki wengine na kutengeneza signal ya kupanga itakayotumika katika raundi zinazofuata za grouping. Chanzo kinafafanua hii si kama kipimo cha jumla au cha formal optimal cha thamani ya mtumiaji, bali kama heuristic coordination mechanism inayotumika ndani ya mfumo wenye ruhusa.
Kwa reputation ya client \(u_i\) katika raundi \(t\), \(B_i^{(t)}\in(0,1)\), muundo wa update uliotolewa kwenye chanzo ni:
\[ B_i^{(t+1)} = \frac{1}{ 1+ \exp\left[ -\alpha B_i^{(t)} \left( 1+ \frac{1}{|M^{(t)}|-1} \sum_{n\in M^{(t)}\setminus\{i\}} \left( Acc_i^{(t)}-Acc_n^{(t)} \right) \right) \right] }. \]
Hapa \(M^{(t)}\) ni seti ya clients wanaoshiriki katika raundi hiyo. \(Acc_i^{(t)}\) ni thamani ya accuracy kwenye seti thabiti ya validation \(D_{\mathrm{val}}\) ambayo miundombinu iliyoidhinishwa hushikilia kwa pamoja kwa watumiaji wote. Neno la summation linawakilisha wastani wa ubora wa accuracy wa \(u_i\) dhidi ya washiriki wengine. Muundo wa Sigmoid huweka output ndani ya \((0,1)\).
Kikomo cha notation: Chanzo kinafafanua \(\alpha\) hapa kama parameter inayodhibiti sensitivity ya reputation update. Alama hiyo hiyo ilitumika awali kwa learning rate katika local model update. Kwa kuwa chanzo hakisemi kwamba hizi lazima ziwe hyperparameter ileile, majukumu haya mawili yanapaswa kutathminiwa katika contexts tofauti.
Additive sharing na temporary masking hufanya kazi pamoja vipi?
Gradient ya ndani kwanza hugawanywa kuwa additive shares kadhaa kwenye finite field; kila mwanachama wa kundi hubeba tu thamani ya kiwango cha share inayotokana na mchanganyiko wa shares, na thamani hii itakayotumwa kwenye chain hufichwa zaidi kwa kuongezwa vekta huru ya nasibu, hivyo kuzuia gradient binafsi au jumla ya kiwango cha share isiyofichwa kuandikwa moja kwa moja kwenye ledger.
Encoding kutoka namba halisi kwenda finite field
Gradient za ndani kwa asili ziko katika nafasi
\[ g_i^{(t)}\in\mathbb{R}^{p} \]
. Kwa additive sharing, chanzo huzibadilisha kwa kutumia fixed-point encoding map
\[ Q_q:\mathbb{R}^{p}\rightarrow\mathbb{F}_q^{p} \]
kuwa vekta
\[ \bar g_i^{(t)}\in\mathbb{F}_q^{p} \]
. Katika mwelekeo wa kurudi, decoding map
\[ D_q:\mathbb{F}_q^{p}\rightarrow\mathbb{R}^{p} \]
hutumika.
Dhana muhimu ya chanzo ni kwamba modulus \(q\) iliyochaguliwa na fixed-point precision viwe vikubwa vya kutosha kuwakilisha gradient, shares, masking vectors na intermediate sums katika raundi moja. Kwa maneno mengine, modular overflow, yaani wrap-around, haipaswi kutokea wakati wa hesabu. Chini ya sharti hili, jumla ya finite field ni exact; wakati wa kurudi kwenye real-number field, quantization error inaweza kuwepo kwa sababu ya fixed-point encoding.
Gradient moja hugawanywaje kuwa shares?
Tuchukulie kundi
\[ G=\{u_{a_1},u_{a_2},\ldots,u_{a_s}\}, \qquad s\in\{2,3\} \]
. Client \(u_{a_r}\) hugawanya gradient yake iliyosimbwa kuwa shares \(s\):
\[ \bar g_{a_r}^{(t)} = \sum_{\ell=1}^{s} [\bar g_{a_r}^{(t)}]_{\ell} \qquad \text{in }\mathbb{F}_q^{p}. \]
Shares za kwanza \(s-1\) huchaguliwa kwa nasibu, kwa kujitegemea na kwa usambazaji sawia, kutoka \(\mathbb{F}_q^p\). Share ya mwisho huamuliwa ili jumla irudishe gradient asilia:
\[ [\bar g_{a_r}^{(t)}]_s = \bar g_{a_r}^{(t)} - \sum_{\ell=1}^{s-1} [\bar g_{a_r}^{(t)}]_{\ell} \]
.
Baada ya kila mwanachama wa kundi kupokea share moja kutoka kwa kila mshiriki, thamani ya kiwango cha share inayobebwa na mwanachama wa \(j\) huwa
\[ s_j^{(t)} = \sum_{r=1}^{s} [\bar g_{a_r}^{(t)}]_j \]
. Muundo huu huhifadhi usawa
\[ \sum_{j=1}^{s}s_j^{(t)} = \sum_{r=1}^{s}\bar g_{a_r}^{(t)} \]
. Kwa hiyo, shares zote zinapojumlishwa tena kwa usahihi, jumla iliyosimbwa ya gradient za kundi hupatikana; hata hivyo, gradient binafsi zilizofanyiwa encoding hazitumwi kwenye blockchain kama plaintext.
Kwa nini temporary masking inaongeza safu ya pili?
Ili kuzuia jumla ya kiwango cha share kupatikana mapema kabla uploads zote kukamilika, kila client hutengeneza vekta ya nasibu
\[ r_i^{(t)}\in\mathbb{F}_q^p \]
. Kwanza, kwa vekta hii huandikwa
\[ C_i^{(t)} = H\left(t\parallel i\parallel r_i^{(t)}\right) \]
hash commitment. Kisha thamani inayokwenda kwenye blockchain huwa
\[ z_i^{(t)} = s_i^{(t)}+r_i^{(t)} \]
.
\(H(\cdot)\) inaonyesha cryptographic hash function, na \(\parallel\) inaonyesha operation ya kuunganisha. Vekta ya nasibu yenyewe haisambazwi kwa upana. Taarifa inayohitajika ya recovery hutumwa tu kwenye trusted recovery scope.
Mtumiaji akiondoka, masking huondolewaje?
Kila vekta \(r_i^{(t)}\) hukabidhiwa kwa recovery committee kwa threshold sharing. Mtumiaji asipotoa taarifa inayohitajika ya recovery, committee inaweza kujenga upya mchango unaokosekana ikiwa angalau \(\tau_{\mathrm{rec}}\) recovery shares halali zinapatikana. Lengo si kufichua individual random vectors kwa ujumla, bali kuunda tu total random vector inayohitajika kwa aggregation, yaani
\[ R^{(t)} = \sum_{i=1}^{m}r_i^{(t)} \]
.
Kila mchango uliorejeshwa au uliotolewa na mtumiaji kwanza huthibitishwa dhidi ya commitment iliyorekodiwa awali kwa kutumia usawa
\[ H\left(t\parallel i\parallel r_i^{(t)}\right) = C_i^{(t)} \]
. Ikiwa mchango unaohitajika haupiti validation, raundi ya sasa ya mawasiliano hufutwa; mchango batili huondolewa na utekelezaji unaofuata huanza tena kutoka hatua ya grouping.
Safu ya Blockchain hufanya nini na haifanyi nini katika protocol hii?
Hyperledger Fabric si mekanismi inayoficha gradient kwa cryptography peke yake katika mfumo huu; hutoa safu ya coordination na integrity kwa ajili ya kuchakata authenticated transactions kupitia chaincode, kuzipanga, kuzithibitisha na kuzirekodi kwenye ledger inayoweza kukaguliwa, huku operesheni halisi ya kuficha update ikitekelezwa na additive sharing pamoja na temporary masking.
Clients hutuma transaction proposals kwenye mtandao wa Fabric. Endorsing peers huendesha chaincode na kutoa endorsement; ordering service huweka mpangilio wa jumla kwa transactions zilizoidhinishwa; committing peers huzithibitisha na kuziongeza kwenye ledger. Hakuna mining wala ushindani wa Proof-of-Work katika mfumo huu.
Hisabati ya aggregation mwishoni mwa raundi
Upande wa blockchain, jumla ya thamani zote zilizofichwa huhesabiwa kama
\[ Z^{(t)} = \sum_{i=1}^{m}z_i^{(t)} \]
. Jumla ya michango ya nasibu iliyothibitishwa \(R^{(t)}\) ikiondolewa, hupatikana
\[ S^{(t)} = Z^{(t)}-R^{(t)} = \sum_{i=1}^{m}s_i^{(t)} \]
.
Kutokana na muundo wa additive sharing, thamani hii pia ni jumla ya gradient za ndani zilizofanyiwa encoding:
\[ \bar G^{(t)} = S^{(t)} = \sum_{i=1}^{m}\bar g_i^{(t)} \qquad \text{in }\mathbb{F}_q^p . \]
Kisha kwa
\[ G^{(t)} = D_q(\bar G^{(t)}) \in\mathbb{R}^{p} \]
hurudiwa kwenye real-number field na average gradient huhesabiwa kama
\[ g_{\mathrm{avg}}^{(t)} = \frac{1}{m}G^{(t)} \]
. Global model update huwa
\[ W^{(t+1)} = W^{(t)}-\alpha g_{\mathrm{avg}}^{(t)} \]
.
Matokeo ya correctness katika chanzo yanapaswa kufasiriwa katika viwango viwili. Kwenye encoded field \(\mathbb{F}_q^p\), aggregation ni exact kialjebra. Inaporudishwa kwenye \(\mathbb{R}^p\), matokeo hulingana na jumla inayolengwa katika real field hadi kiwango cha quantization error kinachotokana na fixed-point encoding/decoding. Tafsiri hii pia inategemea dhana kwamba modular wrap-around haitokei.
Security model haijumuishi mashambulizi gani?
Utafiti unadai, chini ya assumptions za semi-honest na bounded collusion, kwamba data ghafi hubaki kwenye kifaa na uploads zilizofichwa za kiwango cha share kwenye ledger hazionyeshi moja kwa moja individual gradient kama plaintext; hautoi proof kamili ya usalama dhidi ya Byzantine model poisoning, arbitrary collusion inayozidi threshold, side-channel leakage na advanced adaptive inference attacks.
Inakubaliwa kwamba clients hutekeleza protocol kwa usahihi lakini wanaweza kujaribu kutoa taarifa za ziada kutoka shares wanazoona au rekodi za ledger. Fabric peers huigwa kama honest-but-curious: wanaendesha Fabric protocol kwa usahihi lakini wanaweza kujaribu kujifunza taarifa za ziada kutoka kile kinachoonekana kwao.
Chanzo kinajadili matokeo matatu makuu ya usalama. Kwanza, datasets ghafi \(D_i\) hubaki upande wa mtumiaji na hazipakuliwi kwenye blockchain. Pili, chini ya assumptions zilizobainishwa, thamani zilizofichwa za kiwango cha share kwenye chain si plaintext values zinazolingana moja kwa moja na raw local gradient ya client yeyote. Tatu, mchakato wa endorsement, ordering na validation wa Fabric huhakikisha kwamba accepted transaction records zinahifadhiwa kama rekodi zilizothibitishwa utambulisho, zinazoweza kuonyesha mabadiliko na zinazoweza kukaguliwa.
Hata hivyo, waandishi hawawasilishi hili kama simulation-based complete cryptographic proof. Hasa, inadhaniwa kwamba recovery process huunda tu total random vector inayohitajika na haisambazi individual masking vectors nje ya trusted scope. Aidha, final global aggregate inaweza kuendelea kubeba taarifa zinazoweza kutumiwa kwa inference attacks chini ya makundi madogo au raundi nyingi za mawasiliano zinazorudiwa.
Mbinu na Matokeo ya Utafiti
Tathmini ya majaribio ilifanywaje na nini kilipatikana?
Prototype ilitathminiwa kwenye Windows 11, Ryzen 7 5800H, RTX 3060 na 32 GB RAM; ikitumia picha 60.000 za mafunzo na picha 10.000 za test za MNIST, fully connected neural network na Hyperledger Fabric v2.0.0; matokeo yaliripotiwa kwa grouping cost, muda wa additive sharing ndani ya kundi, Fabric transaction cost/throughput na accuracy ya classification ya MNIST.
Mazingira ya jaribio na dataset
| Kipengele | Hali iliyoripotiwa katika chanzo |
|---|---|
| Mfumo wa uendeshaji | 64-bit Windows 11 |
| Processor | AMD Ryzen 7 5800H |
| GPU | NVIDIA GeForce RTX 3060 |
| Kumbukumbu | 32 GB RAM |
| Dataset | MNIST |
| Picha za mafunzo | 60.000 |
| Picha za test | 10.000 |
| Modeli | Fully connected neural network |
| Jukwaa la Blockchain | Hyperledger Fabric v2.0.0 |
| Kiasi cha transactions cha Fabric | Hadi transactions 500 |
Modeli ilifundishwa kwanza katika mazingira ya plaintext kwa picha 60.000 za mafunzo na kutathminiwa kwenye picha 10.000 za test. Chanzo kinaripoti accuracy ya takribani %98 kwa modeli hii ya kwanza ya plaintext. Kisha parameter za modeli zilibadilishwa ili kuunda viwango vitano tofauti vya initial accuracy na raundi kadhaa za aggregation ziliendeshwa juu ya modeli hizi za mwanzo. Lengo lilikuwa kuangalia tabia ya accuracy ya scheme iliyopendekezwa kwenye MNIST baada ya aggregation.
Katika prototype hii dataset iliyotumika kwa mafunzo na test ni MNIST. Kwa hiyo, ingawa data za afya na faragha ya kitabibu zinajadiliwa kwenye utangulizi wa utafiti kama motisha muhimu ya matumizi, majaribio hayakufanywa kwa data za wagonjwa, rekodi za kliniki au mtandao halisi wa federated learning kati ya taasisi za afya.
Gharama ya dynamic grouping
Kwa kuwa gharama halisi ya mawasiliano ya voluntary grouping inategemea negotiation kati ya watumiaji, chanzo hakitoi thamani ya exact communication overhead kwa sehemu hii. Badala yake, muda uliopimwa wa kuunda makundi ya nasibu ya watu wawili na watatu upande wa mfumo unalinganishwa katika Kielelezo 6.
Kielelezo 6 kwenye ukurasa wa 19 wa PDF kinaonyesha kwamba kadiri idadi ya watumiaji inavyoongezeka, execution time ya aina zote mbili za grouping huongezeka. Kulingana na maandishi ya chanzo, completely random grouping ya watu wawili ina gharama ya muda iliyo juu kidogo kuliko grouping ya watu watatu katika implementation iliyopo. Waandishi wanachukulia completely random grouping ya watu wawili kama aina ya upper-bound reference miongoni mwa hali za grouping zilizochunguzwa.
Gharama ya additive sharing
| Muundo wa kundi | Muda wa takriban wa utekelezaji | Maelezo |
|---|---|---|
| Additive sharing ya watumiaji 2 | 12,6 ms | Kipimo cha kiwango cha implementation ya prototype |
| Additive sharing ya watumiaji 3 | 16,9 ms | Kipimo cha kiwango cha implementation ya prototype |
Sharing ya watu watatu huchukua muda mrefu kuliko muundo wa watu wawili. Chanzo kinatoa thamani hizi kama indicator ya kiwango cha implementation kuhusu computational cost ya group-based sharing protocol; hakiziwasilishi kama universal latency values zinazoweza kuhamishwa moja kwa moja kwenda hali za kawaida za hardware au network.
Utendaji wa Hyperledger Fabric
Chanzo kinachunguza execution cost hadi transactions 500 kwenye Fabric v2.0.0 na throughput kama idadi ya successful transactions kwa sekunde. Katika Kielelezo 7 kwenye ukurasa wa 20 wa PDF, curves za execution time na throughput za invoke na query operations zinaonyeshwa kwa loads za transactions 100, 200, 300, 400 na 500.
Chanzo hakitoi raw numerical points za grafu katika table tofauti. Kwa hiyo, exact values mpya hazijatolewa kutoka curves za grafu. Jukumu la kisayansi la Kielelezo 7 ni kuonyesha tabia ya execution cost na throughput ya prototype Fabric layer katika loads tofauti za transactions katika kiwango cha implementation.
Ulinganisho wa functional coverage
| Mbinu | Ulinzi wa faragha | Blockchain | Robustness | Utaratibu wa reputation/incentive | Dynamic grouping |
|---|---|---|---|---|---|
| PDLM | Ndiyo | Hapana | Hapana | Hapana | Hapana |
| SPDDL | Ndiyo | Hapana | Ndiyo | Hapana | Hapana |
| SPPFL | Ndiyo | Hapana | Ndiyo | Ndiyo | Hapana |
| chain-PPFL | Ndiyo | Ndiyo | Hapana | Hapana | Hapana |
| FL-CGAN-LSTM | Ndiyo | Ndiyo | Hapana | Hapana | Hapana |
| DPPFL | Ndiyo | Ndiyo | Ndiyo | Ndiyo | Ndiyo |
Jedwali hili si performance comparison inayothibitisha moja kwa moja ubora wa model accuracy. Waandishi wanatumia jedwali kuonyesha ni functional components zipi zinazojumuishwa na kila mbinu. Ukweli kwamba DPPFL inatimiza visanduku vyote hauonyeshi peke yake kwamba kila security property ni yenye nguvu zaidi kimahesabu kuliko mbinu nyingine.
Ulinganisho wa accuracy ya MNIST
Thamani zilizoandikwa kwenye grafu katika Kielelezo 8 cha ukurasa wa 21 wa PDF ni:
| Mbinu | Usahihi |
|---|---|
| FL-Blockchain Dynamic Grouping | %99,56 |
| SVM | %95,60 |
| CNN | %98,50 |
| RNN | %98,25 |
Maandishi ya makala yanazungusha matokeo ya mbinu iliyopendekezwa na kuyatoa kama %99,6. Tofauti iliyoripotiwa katika mpangilio huu ni kati ya pointi za asilimia 1,06 na 3,96 ikilinganishwa na mbinu zilizolinganishwa. Ulinganisho huu unapaswa kufasiriwa tu kwa hali za proof-of-concept za sasa zinazotegemea MNIST.
Onyesho la robustness lenye nodes ishirini
Kielelezo 9 kinalinganisha matoleo ya FL yenye dynamic grouping yanayotumia blockchain na yasiyotumia blockchain katika mazingira ya simulation yenye jumla ya nodes 20. Kadiri idadi ya nodes zilizoainishwa kama “malicious” inavyoongezeka katika simulation, accuracy ya toleo lisilo na blockchain hupungua kwa kiasi kikubwa, huku series inayoungwa mkono na blockchain ikionekana kuwa imara zaidi.
Kikomo cha tafsiri cha waandishi wenyewe ni muhimu hapa: Kielelezo 9 ni onyesho la empirical prototype robustness; si dhamana rasmi ya cryptographic security dhidi ya Byzantine attacks au malicious participants. Grafu hii haibadilishi semi-honest threat model iliyofafanuliwa kwenye chanzo kuwa malicious-security model.
Ulinganisho wa blockchain, dynamic grouping na centralized approach
Thamani zilizoonyeshwa katika Kielelezo 10 cha ukurasa wa 21 wa PDF ni:
| Mkabala | Usahihi |
|---|---|
| FL Blockchain Dynamic Grouping | %99,56 |
| Blockchain Algorithms | %98,60 |
| Centralized Algorithms | %97,62 |
Katika jaribio hili maalumu, toleo linalotumia dynamic grouping na blockchain coordination kwa pamoja lina lebo ya accuracy ya juu zaidi kati ya mikabala mitatu. Hata hivyo, hii haimaanishi dhamana ya jumla ya performance iliyo juu ya centralized learning katika datasets zote, modeli zote au mitandao halisi iliyosambazwa.
Mtiririko wa end-to-end wa usanifu wa chanzo
- Kila client hufanya local training kwenye dataset yake \(D_i\) na huhesabu gradient \(g_i^{(t)}\).
- Clients hugawanywa katika makundi ya wanachama wawili au watatu kwa kutumia taarifa za reputation na willingness.
- Gradient ya real field husimbwa kwenye \(\mathbb{F}_q^p\) na kugawanywa kuwa additive shares ndani ya kundi.
- Kila client huongeza vekta ya nasibu \(r_i^{(t)}\) kwenye thamani ya kiwango cha share iliyo nayo na kutengeneza thamani iliyofichwa \(z_i^{(t)}\).
- Hash commitment ya masking vector hurekodiwa kwenye chain na threshold-based recovery information hukabidhiwa kwenye trusted recovery scope.
- Michango ya nasibu inayohitajika huthibitishwa kwa commitment values.
- Fabric chaincode na ledger operations huchakata na kujumlisha uploads zilizofichwa za kiwango cha share.
- Total random vector \(R^{(t)}\) huondolewa ili kurejesha encoded global gradient sum.
- Finite-field sum hufanyiwa decoding kwenda real-number field, average gradient huhesabiwa na global model husawazishwa.
- Reputation values husasishwa na mfumo huingia kwenye raundi inayofuata ya mawasiliano.
Kielelezo 4 kwenye ukurasa wa 10 wa PDF kinaonyesha hasa mwonekano wa usanifu wa muundo huu: closed processing chain kutoka clients kwenda dynamic grouping, additive sharing na temporary masking; kutoka hapo kwenda Hyperledger Fabric endorsement/ordering/commitment flow, ledger records, aggregate recovery process, na kurudi tena kwenye model synchronization.
Hitimisho zinazoungwa mkono na utafiti
Chanzo kinaonyesha kwamba chini ya assumptions za semi-honest na bounded-collusion, protocol iliyopendekezwa huweka raw datasets upande wa client; hutumia masked share-level values kwenye chain badala ya direct plaintext individual gradient; encoded finite-field aggregation ni correct; wakati wa kurudi real field hubaki tu encoding–decoding quantization error; na Hyperledger Fabric huongeza integrity/auditability layer kwenye accepted transaction records.
Majaribio ya MNIST proof-of-concept yanaonyesha kwamba mfumo unaweza kuendeshwa katika prototype environment iliyotathminiwa, group-based additive sharing inaweza kutekelezwa kwa kiwango cha milliseconds, execution/throughput behavior hadi transactions 500 inaweza kupimwa upande wa Fabric, na model accuracy inaweza kuhifadhiwa katika comparison iliyopo.
Hitimisho ambazo utafiti hauungi mkono
Utafiti hautoi general security protocol inayotatua mashambulizi yote ya federated learning. Hakuna proof kamili ya malicious-security wala simulation-based privacy. Byzantine model poisoning, unlimited collusion, side-channel attacks na advanced adaptive inference attacks ziko nje ya scope. Final aggregate yenyewe inaweza kutumika kwa information leakage katika hali fulani. Haijathibitishwa kwamba makundi ya watu wawili na watatu ni optimal. Reputation mechanism si trust-free wala optimal contribution oracle. Majaribio ya MNIST hayakufanywa kwenye data halisi za afya na utafiti hautoi clinical au large-scale real-world deployment proof.
Maelezo ya Chanzo na Mbinu
Utafiti asilia: Blockchain-Enabled Federated Learning: A Dynamic-Grouping Privacy-Preserving Framework
Waandishi: Senmao Wei; Xiaochao Wei; Tingting Pang; Dian Li.
Corresponding authors: Xiaochao Wei na Tingting Pang.
Taasisi: School of Computer Science and Artificial Intelligence, Shandong Normal University, Jinan, China; Department of Informatics, University of Bergen, Bergen, Norway.
Jarida: Mathematics.
Mchapishaji: MDPI.
Rekodi ya bibliografia: Mathematics 2026, 14(9), 1534.
DOI: 10.3390/math14091534.
Mchakato wa makala: Ilipokelewa 31 Machi 2026; marekebisho 24 Aprili 2026; ilikubaliwa 25 Aprili 2026; ilichapishwa 1 Mei 2026.
Aina ya chanzo: Makala ya utafiti wa kitaaluma iliyopitiwa na wataalamu; inajumuisha protocol design, mjadala wa mathematical correctness, limited security analysis na MNIST-based proof-of-concept experimental evaluation.
Leseni: Creative Commons Attribution (CC BY).
Ufadhili: Utafiti uliungwa mkono kwa sehemu na ruzuku ya National Natural Science Foundation of China namba 12201356 na programu ya Shandong Provincial Key Research and Development Program namba 2025TSGCCZZB0016.
Upatikanaji wa data: Waandishi wanaeleza kwamba michango asilia imo ndani ya makala na kwamba maswali ya ziada yanaweza kuelekezwa kwa corresponding authors.
Mgongano wa maslahi: Waandishi hawakuripoti mgongano wa maslahi.
Michango ya waandishi: Conceptualization Xiaochao Wei na Tingting Pang; methodology Senmao Wei na Xiaochao Wei; software na validation Senmao Wei na Dian Li; first draft Senmao Wei; review na editing Xiaochao Wei na Tingting Pang; funding acquisition ilifanywa na Tingting Pang na Xiaochao Wei.
Kikomo kikuu cha kimethodolojia: Security analysis imewekewa mipaka na assumptions za semi-honest na bounded-collusion; si full simulation-based cryptographic proof. Experiment ni proof-of-concept evaluation iliyofanywa kwenye MNIST. Hakuna medical data wala clinical deployment validation. Kurudi kutoka finite-field encoding kwenda real field kuna quantization error. Modulus na fixed-point precision lazima zichaguliwe ili wrap-around isitokee.
Kuchora upya kwa visual: Architecture katika Kielelezo 4 cha chanzo, grouping overhead katika Kielelezo 6, Fabric execution/throughput behavior katika Kielelezo 7, na comparisons katika Kielelezo 8–10 zinaweza kuchorwa upya kwa Verianla kama graphics na diagrams asilia. Kwa kuwa raw points za Kielelezo 7 hazijatolewa kwenye table, exact new numbers hazipaswi kutolewa kutoka grafu.
Verianla Live / Live Figure: Inafaa. Matumizi salama zaidi ni fixed-parameter source-derived animation ya processing flow: client training → grouping → additive sharing → masking → Fabric validation → aggregate recovery → model synchronization. Mtumiaji hapaswi kuruhusiwa kubadilisha group threshold, idadi ya attackers, learning rate au scientific parameter nyingine ili kuzalisha matokeo mapya.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *