

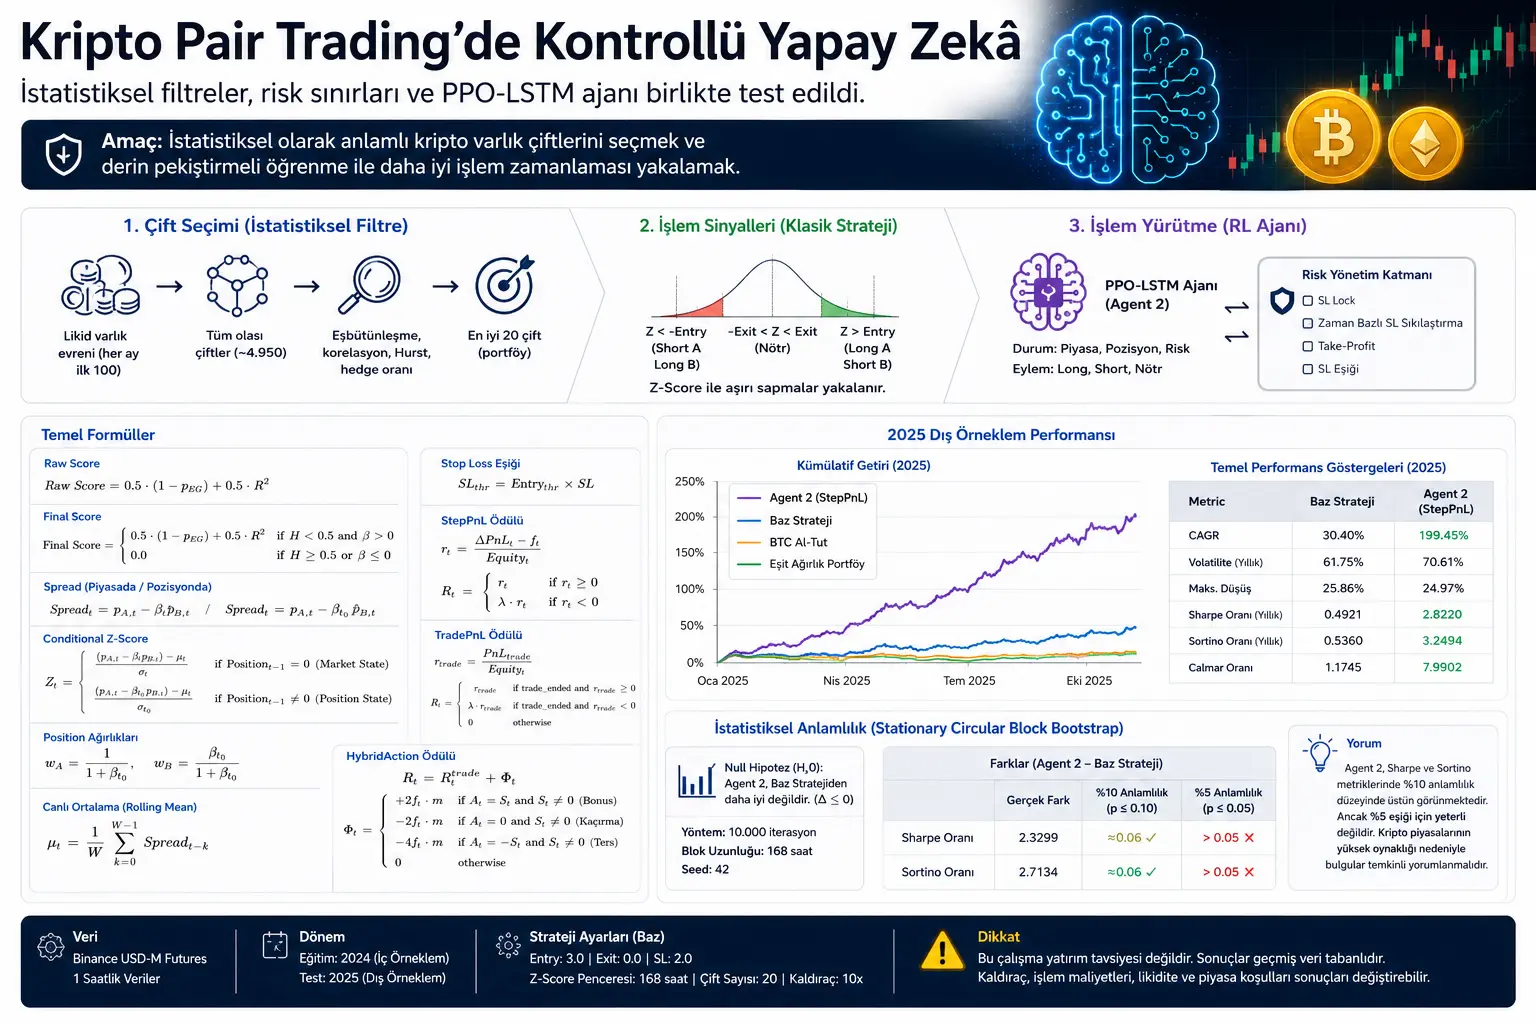
Bu yazı kriptovalyuta bazarlarında statistik arbitraj və dərin möhkəmləndirici öyrənmə üsullarını birlikdə araşdıran akademik tədqiqat əsasında hazırlanıb. Tədqiqat Dynamic Multi-Pair Trading Strategy in Cryptocurrency Markets with Deep Reinforcement Learning başlığını daşıyır və arXiv-də preprint kimi yayımlanıb.
Məqalə kriptovalyuta bazarlarında iki aktiv arasındakı qiymət əlaqəsindən yararlanan pair trading strategiyasını Dərin Möhkəmləndirici Öyrənmə, yəni Deep Reinforcement Learning ilə inkişaf etdirməyi hədəfləyir. Lakin burada vacib bir fərq var: Süni intellekt modeli bazarda tam sərbəst buraxılmayıb. Model statistik olaraq seçilmiş aktiv cütləri və əvvəlcədən müəyyən edilmiş risk sərhədləri daxilində işlədilib.
Buna görə yazıda izah olunan nəticələr investisiya tövsiyəsi kimi oxunmamalıdır. Tədqiqat keçmiş verilənlər üzərində sınaqdan keçirilmiş akademik model təqdim edir. Kripto bazarlarının yüksək volatilliyi, leverec istifadəsi, əməliyyat xərcləri və canlı bazardakı likvidlik şəraiti nəticələri ciddi şəkildə dəyişə bilər.
Yeni akademik tədqiqat kriptovalyuta bazarlarında pair trading strategiyasını dərin möhkəmləndirici öyrənmə ilə birləşdirən hibrid model təklif edir. Tədqiqatda əvvəlcə statistik baxımdan əhəmiyyətli kripto aktiv cütləri seçilir; daha sonra PPO-LSTM əsaslı süni intellekt agentindən yalnız əməliyyat icra qatı kimi istifadə olunur. Modelin ən uğurlu versiyası 2025-ci ilin nümunədənkənar dövründə klassik baza strategiyasına nisbətən daha güclü riskə uyğunlaşdırılmış performans göstərib. Lakin tapıntılar yüksək leverec və kripto bazarlarının dəyişkən quruluşu səbəbilə ehtiyatla şərh edilməlidir.
Problem Nədir?
Pair trading, statistik baxımdan bir-biri ilə bağlı iki aktivin qiymətləri müvəqqəti ayrışdıqda mövqe açmağı, əlaqə normala qayıtdıqda isə mövqeni bağlamağı hədəfləyən strategiyadır. Məsələn, iki kripto aktiv uzun müddət birlikdə hərəkət edirsə, aralarındakı fərq qeyri-adi dərəcədə açıldıqda sistem bu fərqin yenidən bağlana biləcəyini fərz edir.
Bu yanaşma ənənəvi səhm bazarlarında uzun müddətdir araşdırılır. Lakin kriptovalyuta bazarlarında vəziyyət daha çətindir. Çünki kripto aktivlərdə volatillik yüksəkdir, bazar rejimləri sürətlə dəyişə bilər, likvidlik şəraiti pisləşə bilər və keçmişdə birlikdə hərəkət edən iki aktiv bir müddət sonra tamamilə fərqli davranmağa başlaya bilər.
Tədqiqatın əsas sualı budur: Klassik statistik pair trading sistemi dərin möhkəmləndirici öyrənmə ilə dəstəklənsə, kripto kimi səs-küylü və dəyişkən bazarda əməliyyat vaxtlamasını daha yaxşı edə bilərmi?
Tədqiqatçılar burada süni intellekti birbaşa “bazarı proqnozlaşdıran” müstəqil sistem kimi istifadə etməyiblər. Bunun əvəzinə əvvəlcə statistik baxımdan güclü cütlər seçilib, sonra süni intellekt yalnız əməliyyat açma, gözləmə və ya bağlama qərarlarını yaxşılaşdırmağa çalışan nəzarətli qat kimi əlavə edilib.
Metod Nə Təklif Edir?
Tədqiqatın metodu iki əsas hissədən ibarətdir. Birinci hissə əməliyyat aparılacaq kripto aktiv cütlərini seçən statistik sistemdir. İkinci hissə isə bu sistemin üzərinə əlavə edilən süni intellekt əsaslı əməliyyat icra qatıdır.
İlk mərhələdə sistem Binance USD-M Futures bazarındakı likvid kripto aktivləri araşdırır. Hər ay ən likvid aktivlərdən namizəd kainat yaradılır. Bu aktivlər arasındakı mümkün cütlər; kointeqrasiya, korrelyasiya, Hurst eksponenti və hedge nisbəti kimi meyarlarla qiymətləndirilir. Məqsəd yalnız keçmişdə birlikdə hərəkət etmiş cütləri tapmaq deyil, həm də orta qiymətə qayıtma davranışı göstərə biləcək cütləri ayırmaqdır.
İkinci mərhələdə PPO, yəni Proximal Policy Optimization alqoritmi və LSTM arxitekturası istifadə olunur. PPO möhkəmləndirici öyrənmədə qərar siyasətini nəzarətli şəkildə yeniləmək üçün istifadə edilən üsuldur. LSTM isə zaman sıralarında keçmiş məlumatı yadda saxlaya bilən neyron şəbəkə quruluşudur.
Bu quruluş klassik “end-to-end süni intellekt” yanaşmasından fərqlənir. Model bazardan xam verilənləri alıb hər şeyi təkbaşına öyrənməyə çalışmır. Əvvəlcə statistik sərhədlər qurulur, sonra süni intellekt bu sərhədlər daxilində əməliyyat vaxtlamasını yaxşılaşdırmağa çalışır. Buna görə tədqiqat “təhlükəsiz möhkəmləndirici öyrənmə” yanaşmasına yaxın hibrid arxitektura təqdim edir.
Formullar Nəyi İzah Edir?
Tədqiqatdakı formullar sistemin kripto aktiv cütlərini necə seçdiyini, qiymət fərqini necə ölçdüyünü, risk sərhədlərini necə qurduğunu və süni intellekt agentinə necə mükafat verdiyini göstərir.
1. Xam bal: İki aktiv arasındakı statistik əlaqə nə qədər güclüdür?
İlk əsas formul iki aktiv cütünün statistik keyfiyyətini ölçən xam bal formuludur:
Burada \(p_{EG}\) Engle-Granger kointeqrasiya testindən gələn p-dəyəridir. Bu dəyər nə qədər aşağı olsa, iki aktiv arasında uzunmüddətli tarazlıq əlaqəsinin mövcud olma ehtimalı bir o qədər güclənir. \(R^2\) isə iki aktiv arasındakı xətti əlaqənin gücünü göstərir.
Formul iki fərqli məlumatı bərabər çəki ilə birləşdirir: uzunmüddətli tarazlıq əlaqəsi və qısamüddətli birlikdə hərəkət gücü. Beləliklə, yalnız yüksək korrelyasiya deyil, daha davamlı statistik bağ da axtarılır.
2. Yekun bal: Əlaqə həqiqətən əməliyyat üçün yararlıdırmı?
Tədqiqat yalnız xam bala güvənmir. Bir cütün əməliyyat üçün yararlı sayılması üçün iki struktur şərt tələb olunur: Hurst eksponenti \(H \lt 0.5\) olmalı və hedge nisbəti \(\beta \gt 0\) olmalıdır.
Bu formulun əsas mesajı budur: Əgər cüt orta qiymətə qayıtma davranışı göstərmirsə və ya müsbət hedge əlaqəsi qurula bilmirsə, statistik baxımdan yaxşı görünsə belə əməliyyat siyahısından çıxarılır. Yəni sistem yüksək korrelyasiyanın təkbaşına kifayət etmədiyini qəbul edir.
3. Conditional Z-Score: Qiymət fərqi adi səviyyədən nə qədər uzaqlaşıb?
Strategiyanın əməliyyat qərarı üçün istifadə etdiyi əsas ölçü Conditional Z-Score dəyəridir:
Bu formul iki aktiv arasındakı qiymət fərqinin orta qiymətdən neçə standart sapma uzaqlaşdığını ölçür. Mövqe olmadıqda sistem cari beta və cari standart sapmadan istifadə edir. Mövqe açıldıqdan sonra isə hedge nisbəti və standart sapma dondurulur.
Bu fərq vacibdir. Çünki kripto bazarında qəfil volatillik artdıqda standart sapma da sürətlə böyüyə bilər. Sistem bu yeni standart sapmadan davamlı istifadə etsə, qiymət fərqi hələ riskli olduğu halda Z-Score süni şəkildə kiçilə bilər. Buna görə mövqe açıldıqdan sonra risk ölçüsünün dondurulması strategiyanın daha ardıcıl işləməsini təmin edir.
4. Spread: İki aktiv arasındakı fərq necə hesablanır?
Bazar izlənərkən istifadə olunan spread formulu belədir:
Mövqe açıldıqdan sonra istifadə olunan spread formulu isə belədir:
Birinci formul bazarda yeni fürsət axtarılarkən istifadə olunur. İkinci formul isə əməliyyat açıldıqdan sonra mövcud real mövqeni izləmək üçün istifadə edilir. Beləliklə, sistem əməliyyat açıldıqdan sonra davamlı dəyişən beta dəyərləri ilə mövqenin riyazi əsasını pozmur.
5. Mövqe çəkiləri: Hansı aktivə nə qədər çəki verilir?
Tədqiqatda mövqe çəkiləri hedge nisbətinə görə müəyyən edilir:
Bu quruluş iki aktiv arasında daha balanslı long/short konstruksiyası yaratmağı hədəfləyir. Məqsəd daha dəyişkən aktivin portfeli təkbaşına sürükləməsinin qarşısını almaqdır.
6. Canlı orta: Sistem yeni bazar tarazlığına necə uyğunlaşır?
Tədqiqatda orta dəyər tamamilə dondurulmur. Spread-in orta qiyməti canlı şəkildə yenilənir:
Burada \(W\) Z-Score pəncərəsidir. Tədqiqatda standart pəncərə 168 saat, yəni təxminən bir həftədir. Orta canlı qaldığı üçün sistem kripto bazarında yarana biləcək yeni tarazlıq səviyyələrinə tədricən uyğunlaşa bilər.
7. Stop Loss həddi: Risk sərhədi necə sabitlənir?
Strategiyada stop-loss həddi əməliyyat açıldığı andakı ekstremal Z-Score dəyərinə görə deyil, əvvəlcədən müəyyən edilmiş giriş həddinə görə hesablanır:
Bu yanaşma risk sərhədinin qəfil bazar sıçrayışları zamanı sonradan genişlənməsinin qarşısını alır. Məsələn, əməliyyat çox gec və həddindən artıq sapma zamanı açılıbsa, sistem bu səhvi daha geniş zərər sərhədi verməklə mükafatlandırmır.
8. StepPnL mükafatı: Süni intellekt hər addımda necə bal alır?
Süni intellekt agentinin öyrənməsində istifadə olunan mükafat funksiyalarından biri StepPnL mükafatıdır:
Burada \(\Delta PnL_t\) müvafiq zaman addımındakı mənfəət-zərər dəyişməsini; \(f_t\) əməliyyat xərcini; \(\mathrm{Equity}_t\) portfel dəyərini ifadə edir. \(\lambda\) əmsalı isə zərərləri daha sərt cəzalandırmaq üçün istifadə olunur. Tədqiqatda uğurlu hesab edilən Agent 2 konfiqurasiyasında \(\lambda=1.2\) istifadə olunub.
9. TradePnL mükafatı: Yalnız əməliyyat bağlananda bal verən yanaşma
Digər mükafat quruluşu yalnız əməliyyat tamamlandıqda bal verir:
Bu mükafat növü qısamüddətli bazar səs-küyünü azalda bilər. Lakin agent daha seyrək geribildirim aldığı üçün öyrənmə prosesi çətinləşə bilər.
10. HybridAction mükafatı: Klassik siqnala əməl edərsə bonus, əksinə gedərsə cəza
HybridAction mükafatında agent klassik strategiyanın yaratdığı siqnala əməl edərsə bonus alır; siqnalı buraxarsa və ya əks istiqamətdə gedərsə cəza alır:
Bu mükafatın yekun forması belədir:
Bu quruluş agenti klassik strategiyaya daha yaxın davranmağa təşviq edir. Lakin tədqiqat nəticələri həddindən artıq istiqamətləndirilmiş mükafat quruluşlarının hər zaman daha yaxşı nümunədənkənar performans yaratmadığını göstərir. Ən uğurlu quruluş daha sadə müşahidə sahəsi və zərərləri bir qədər daha sərt cəzalandıran StepPnL mükafat quruluşudur.
Qrafik, Cədvəl və Sxemlərin Əsas Mesajı
Tədqiqatdakı qrafik və cədvəllərin əsas mesajı budur ki, klassik pair trading strategiyası kripto bazarında tam yararsız deyil; lakin düzgün şəkildə məhdudlaşdırılmış süni intellekt qatı bəzi hallarda bu baza strategiyasının üzərinə daha yaxşı əməliyyat vaxtlaması əlavə edə bilər.
Xüsusilə Agent 2 adlandırılan konfiqurasiya önə çıxır. Agent 2 StepPnLReward mükafat quruluşundan, Autonomous müşahidə sahəsindən və \(\lambda=1.2\) zərər cəzasından istifadə edir. Bu quruluş 2025-ci ilin nümunədənkənar dövründə baza strategiyasına nisbətən daha yüksək riskə uyğunlaşdırılmış performans göstərib.
Lakin tədqiqatdakı bütün süni intellekt agentləri uğurlu deyil. Bəzi agentlər daha zəif və ya qeyri-sabit nəticələr verib. Bu da vacib məqama işarə edir: Maliyyə bazarlarında “süni intellekt əlavə etmək” təkbaşına uğur demək deyil. Model arxitekturası, mükafat funksiyası, risk sərhədləri və nümunədənkənar test nəticəni müəyyən edən əsas amillərdir.
Təcrübələr Necə Aparılıb?
Tədqiqatda Binance USD-M Futures bazarından 1 saatlıq qiymət verilənləri istifadə olunub. Təlim dövrü 2024-cü il, nümunədənkənar test dövrü isə 2025-ci il kimi ayrılıb. Bu ayrım modelin yalnız keçmiş verilənləri əzbərləyib-əzbərləmədiyini anlamaq üçün vacibdir.
Sistem hər ay yeni aktiv kainatı yaradır. Əvvəlcə əvvəlki iki aylıq dövrə əsasən ən likvid 100 aktiv müəyyən edilir. Daha sonra bu aktivlər arasındakı təxminən 4.950 mümkün cüt statistik olaraq qiymətləndirilir. Yekun balı ən yüksək olan 20 cüt müvafiq ayın əməliyyat səbətinə daxil edilir.
Baza strategiyasında giriş həddi \(3.0\), çıxış həddi \(0.0\), stop-loss əmsalı \(2.0\), Z-Score pəncərəsi 168 saat və cüt sayı 20 olaraq müəyyən edilib. Strategiya 10x leverec ilə sınaqdan keçirilib. Bu leverec seçimi strategiyanın risk profilini daha dəyişkən kripto benchmark-ları ilə müqayisəolunan etmək üçün istifadə olunub. Lakin leverec real bazarda zərər və likvidasiya riskini də böyüdür.
Süni intellekt agentləri 2024-cü ilin nümunədaxili dövründə öyrədilib, 2025-ci ilin nümunədənkənar dövründə sınaqdan keçirilib. Müxtəlif mükafat funksiyaları, müxtəlif müşahidə sahələri və risk idarəetmə qatı sazlamaları müqayisə edilib.
Nəticələr Nəyi Göstərir?
Tədqiqatda baza strategiyası 2025-ci ilin nümunədənkənar dövründə Bitcoin al-tut və bərabər çəkili portfel benchmark-larına qarşı güclü performans göstərib. Bu, statistik pair trading yanaşmasının kripto bazarında müəyyən şərtlər daxilində mənalı siqnallar tuta bildiyini göstərir.
Ən diqqətçəkici nəticə Agent 2 modelində görülür. Tədqiqatda Agent 2 üçün 2025-ci ilin nümunədənkənar dövründə təxminən %199,45 CAGR, 2,8220 Sharpe nisbəti və 3,2494 Sortino nisbəti bildirilib. Eyni dövrdə baza strategiyası üçün təxminən %30,40 CAGR, 0,4921 Sharpe nisbəti və 0,5360 Sortino nisbəti verilib.
Bu fərq ilk baxışda kifayət qədər güclü görünür. Lakin tədqiqatçılar bunun təsadüfi olub-olmadığını qiymətləndirmək üçün stationary circular block bootstrap üsulundan istifadə ediblər. Nəticələr Agent 2-nin Sharpe və Sortino fərqlərinin %10 əhəmiyyətlilik səviyyəsində statistik olaraq dəstəkləndiyini; lakin %5 kimi daha sərt hədd üçün kifayət qədər güclü olmadığını göstərir.
Buna görə nəticə belə oxunmalıdır: Model ümidverici nümunədənkənar üstünlük göstərib; lakin kripto bazarının yüksək səs-küyü və məhdud test dövrü səbəbilə bu tapıntı qəti investisiya nəticəsi kimi şərh edilməməlidir.
Bu Niyə Vacibdir?
Bu tədqiqat maliyyə süni intellekti müzakirələrində vacib fikri önə çıxarır: Süni intellekt maliyyə bazarlarında tam sərbəst buraxıldıqda deyil, sağlam riyazi sərhədlər və risk qaydaları daxilində işlədildikdə daha mənalı nəticələr verə bilər.
Kriptovalyuta bazarları end-to-end öyrənən modellər üçün olduqca çətin mühitdir. Çünki keçmişdə işləyən əlaqə qısa müddətdə pozula bilər. Qiymət sıraları yüksək səs-küy ehtiva edir. Bundan əlavə, əməliyyat xərcləri, leverec və likvidlik riskləri modelin canlı performansına ciddi təsir edə bilər.
Bu tədqiqatdakı hibrid yanaşma əvvəlcə statistik baxımdan mənalı əməliyyat sahəsini daraldır; sonra süni intellektdən bu sahə daxilində əməliyyat vaxtlamasını inkişaf etdirmək üçün istifadə edir. Bu baxımdan tədqiqat süni intellektin maliyyə sistemlərində “qərar verən yeganə hakimiyyət” olmaqdan çox, nəzarətli optimallaşdırma qatı kimi istifadə edilə biləcəyini göstərir.
Diqqət Edilməli Məqamlar
Bu tədqiqat investisiya tövsiyəsi deyil. Nəticələr keçmiş verilənlərə əsaslanır və gələcəkdə eyni performansın əldə ediləcəyi anlamına gəlmir.
Model 10x leverec ilə sınaqdan keçirilib. Leverec gəliri artıra bildiyi kimi zərəri və likvidasiya riskini də böyüdür.
Nümunədənkənar dövr yalnız 2025-ci ildir. Saatlıq verilənlər çox sayda müşahidə təmin etsə də, birillik dövr müxtəlif makro bazar rejimlərini təmsil etmək üçün məhdud ola bilər.
Tədqiqatda əməliyyat haqları nəzərə alınıb. Lakin canlı bazarda slippage, əmr kitabı dərinliyi, likvidliyin kəsilməsi, qəfil spread genişlənməsi və birja mənşəli risklər nəticəni dəyişə bilər.
Süni intellekt agentlərinin performansı istifadə olunan seed, mükafat funksiyası və risk qatı dizaynına həssas ola bilər. Buna görə canlı istifadə üçün çoxlu seed sınaqları, daha uzun nümunədənkənar dövrlər və realistik əməliyyat simulyasiyaları tələb olunur.
Nəticə
Bu akademik tədqiqat kripto pair trading strategiyalarında dərin möhkəmləndirici öyrənmənin potensialını nəzarətli arxitektura ilə araşdırır. Ən vacib tərəfi süni intellekti tam sərbəst buraxmaq əvəzinə statistik filtrlər və deterministik risk sərhədləri ilə qorunan sistem daxilində istifadə etməsidir.
Nəticələr Agent 2 konfiqurasiyasının 2025-ci ilin nümunədənkənar dövründə klassik baza strategiyasına nisbətən daha yaxşı riskə uyğunlaşdırılmış performans yaratdığını göstərir. Lakin bu üstünlük %10 əhəmiyyətlilik səviyyəsində dəstəklənsə də, %5 həddini tam keçmir. Bu da tapıntının ümidverici, lakin ehtiyatla şərh edilməli olduğunu göstərir.
Verianla baxımından bu tədqiqatın əsas mesajı budur: Maliyyə süni intellekti modellərində uğur yalnız daha mürəkkəb neyron şəbəkələri qurmaqla gəlmir. Bəzən ən güclü nəticə yaxşı dizayn edilmiş statistik sərhədlərin, aydın risk qaydalarının və məhdud vəzifə verilmiş süni intellekt qatının birləşməsindən yaranır.
Mənbə və Metod Qeydi
Bu məzmun Dynamic Multi-Pair Trading Strategy in Cryptocurrency Markets with Deep Reinforcement Learning adlı akademik PDF araşdırılaraq hazırlanıb. Mətn sözbəsöz tərcümə deyil. Tədqiqatın məqsədi, metodu, əsas formulları, təcrübə dizaynı, tapıntıları və məhdudiyyətləri Verianla oxucuları üçün sadələşdirilmiş, orijinal və redaksiya Azərbaycan dilində yenidən izah olunub.
Formullar tədqiqatdakı əsas riyazi quruluşa sadiq qalınaraq MathJax uyğun LaTeX formatında verilib. Yazı investisiya tövsiyəsi, al-sat təklifi və ya canlı əməliyyat sistemi tövsiyəsi deyil.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib