

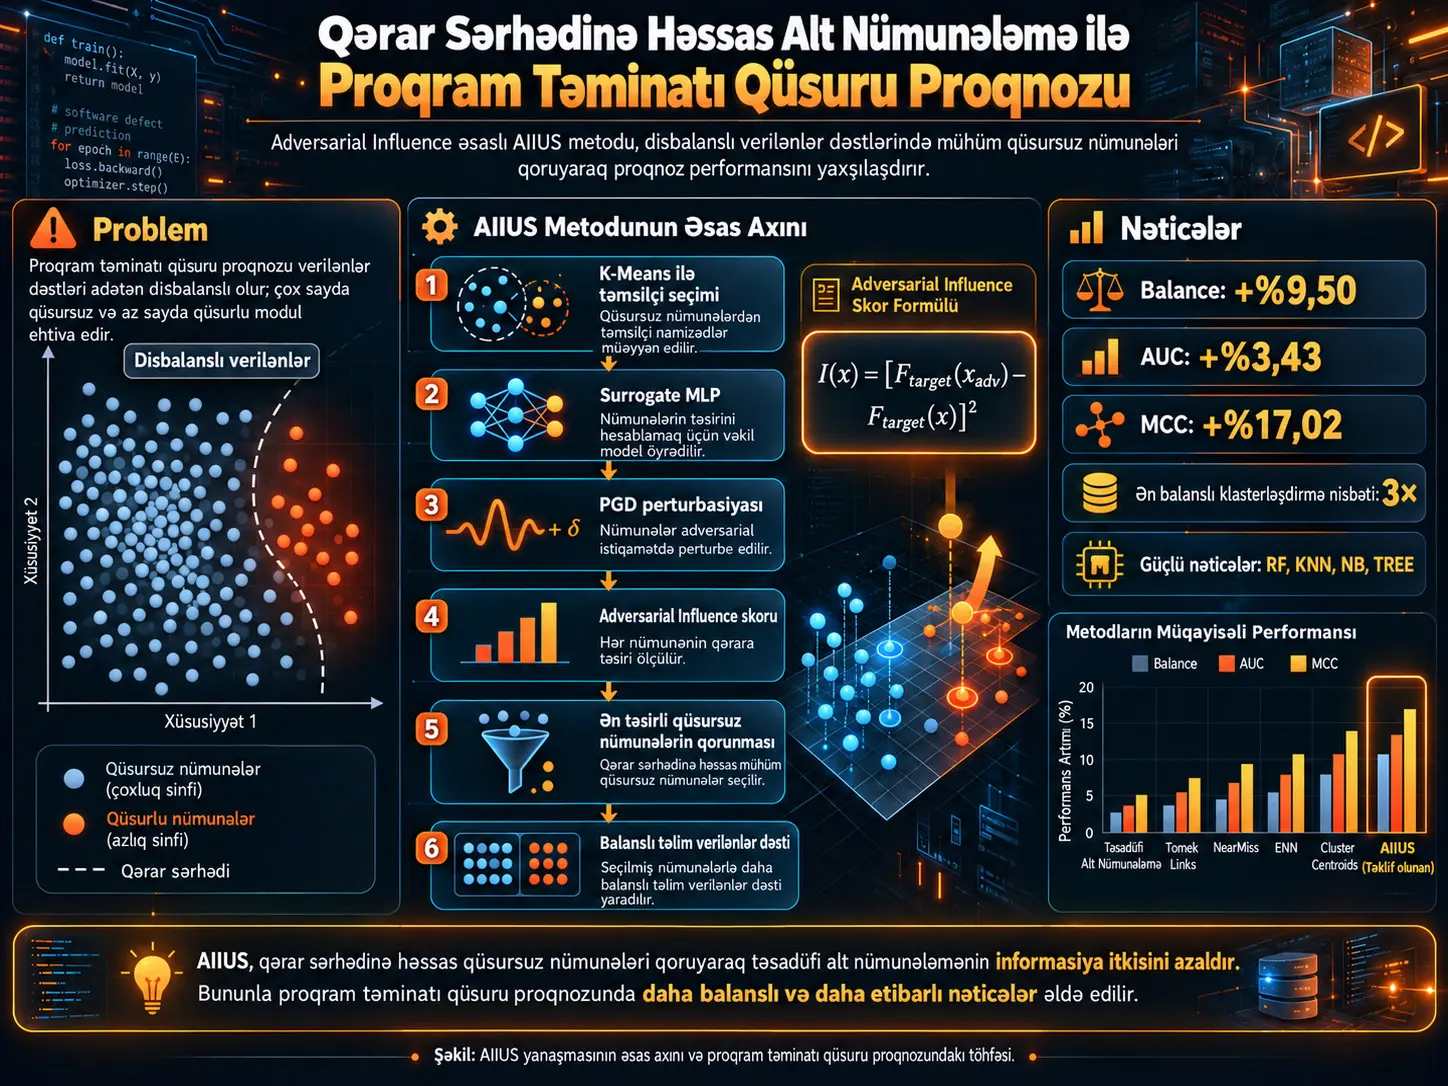
Proqram təminatı qüsurlarının proqnozlaşdırılması sistemləri hansı kod modullarında qüsur olma ehtimalının daha yüksək olduğunu müəyyənləşdirərək test və yoxlama resurslarından daha səmərəli istifadə etməyə kömək edə bilər. Lakin real proqram təminatı verilənlər dəstlərində qüsursuz modullar adətən qüsurlu modullardan xeyli çox olur. Bu sinif disbalansı təsnifatlandırıcının ümumi dəqiqliyi yüksək görünsə belə, qüsurlu nümunələri gözdən qaçırmasına və ya həddən artıq yanlış xəbərdarlıq yaratmasına səbəb ola bilər.
Bu tədqiqat, çoxluq sinfindəki qüsursuz nümunələri təsadüfi azaltmaq əvəzinə qərar sərhədi baxımından daha mühüm görünən nümunələri qorumağı hədəfləyən Adversarial Influence-Based Intelligent Undersampling (AIIUS) metodunu təklif edir. Metodun əsas yeniliyi olan Adversarial Influence, nümunəyə kiçik və hədəflənmiş perturbasiya tətbiq edildikdə hədəf təsnifatlandırıcının qüsur ehtimalı proqnozunun nə qədər dəyişdiyini ölçür. Proqnoz dəyişməsi yüksək olan çoxluq nümunələri modelin qərar davranışı baxımından daha informativ namizədlər kimi prioritetləşdirilir.
AIIUS üç əsas mərhələdən ibarətdir. Əvvəlcə qüsursuz nümunələr K-Means ilə klasterləşdirilərək verilənlərin paylanmasını təmsil edən daha kiçik namizəd hovuzu yaradılır. Daha sonra diferensiallana bilən surrogate MLP üzərində PGD perturbasiyaları yaradılır və bu orijinal/adversarial nümunələr hədəf black-box təsnifatlandırıcıya verilərək Adversarial Influence hesablanır. Son mərhələdə namizədlər influence skoruna görə sıralanır və qüsurlu nümunələrin sayına bərabər sayda ən yüksək təsirli qüsursuz nümunə saxlanılır.
Metod 18 açıq proqram təminatı qüsuru verilənlər dəsti və beş fərqli təsnifatlandırıcı üzərində altı yenidən nümunələmə üsulu ilə müqayisə edilir. Mənbə, təmsilçi baseline-larla müqayisədə orta hesabla Balance üzrə %9,50, AUC üzrə %3,43 və MCC üzrə %17,02 yaxşılaşma bildirir. Bununla belə AIIUS bütün təsnifatlandırıcılarda və bütün metriklərdə ən yüksək nəticəni vermir; üstünlük xüsusilə MCC və Balance kimi sinif disbalansına daha davamlı ölçülərdə nəzərə çarpır.
Proqram təminatı qüsurlarının proqnozlaşdırılmasında sinif disbalansı niyə problem yaradır?
Proqram təminatı layihəsində modulların böyük hissəsi qüsursuz ola bilər. Bu halda təlim verilənlərindəki çoxluq sinfi, yəni qüsursuz nümunələr, qüsurlu nümunələrin sayını bir neçə, hətta onlarla dəfə üstələyə bilər.
Mənbədə araşdırılan verilənlər dəstlərində disbalans nisbəti
\[ IR=\frac{N_{\mathrm{maj}}}{N_{\mathrm{min}}} \]
ilə müəyyən edilir. Burada \(N_{\mathrm{maj}}\) qüsursuz çoxluq nümunələrinin, \(N_{\mathrm{min}}\) isə qüsurlu azlıq nümunələrinin sayıdır.
Tədqiqatdakı 18 verilənlər dəstində bu nisbət təxminən 3,50 ilə 25,08 arasında dəyişir.
Belə paylanmada yalnız ümumi dəqiqliyi optimallaşdıran model çoxluq sinfini həddən artıq tez-tez seçərək zahirən yüksək uğur göstərə bilər. Lakin əməli baxımdan iki xəta vacibdir:
- Qüsurlu modulun qüsursuz qəbul edilməsi, yəni false negative, real qüsurun gözdən qaçmasına səbəb ola bilər.
- Qüsursuz modulun qüsurlu elan edilməsi, yəni false positive, lazımsız test və yoxlama xərci yarada bilər.
Oversampling və undersampling arasındakı fərq
Oversampling azlıq sinfini böyütməyə çalışır. SMOTE kimi üsullar mövcud qüsurlu nümunələrin arasında sintetik nöqtələr yaradır. Bu üsul sinif nisbətini tarazlaşdıra bilər, lakin sintetik nümunələrin səs-küyü və ya siniflərin üst-üstə düşməsini artırması riski var.
Undersampling isə çoxluq sinfindən bəzi nümunələri çıxarır. Üstünlüyü sintetik qüsurlu nümunə yaratmamasıdır; lakin hansı çoxluq nümunələrinin silindiyi kritik olur.
Təsadüfi undersampling qərar sərhədini müəyyənləşdirən mühüm qüsursuz nümunələri də çıxara bilər. AIIUS-un çıxış nöqtəsi məhz budur: çoxluq nümunələrinin hamısı eyni dərəcədə lazımsız deyil.
Adversarial Influence nəyi ölçür?
Adversarial Influence, kiçik və hədəflənmiş perturbasiyadan sonra hədəf təsnifatlandırıcının proqnoz ehtimalının nə qədər dəyişdiyini ölçən, model reaksiyasına əsaslanan nümunə əhəmiyyəti skorudur. Məqsəd yalnız verilənlərin həndəsəsinə və ya təsnifatlandırıcının bir nöqtədəki qeyri-müəyyənliyinə baxmaq əvəzinə modelin lokal dəyişməyə verdiyi reaksiyadan istifadə etməkdir.
Qüsursuz bir \(x\) nümunəsi və onun adversarial qarşılığı \(x_{\mathrm{adv}}\) üçün:
\[ \boxed{ I(x)= \left( F_{\mathrm{target}}(x_{\mathrm{adv}}) - F_{\mathrm{target}}(x) \right)^2 } \]
kimi müəyyən edilir.
Burada:
- \(F_{\mathrm{target}}(x)\): hədəf təsnifatlandırıcının orijinal nümunə üçün yaratdığı qüsur ehtimalı,
- \(F_{\mathrm{target}}(x_{\mathrm{adv}})\): perturbasiya tətbiq edilmiş nümunə üçün yaradılan ehtimal,
- \(I(x)\): proqnoz dəyişməsinin kvadratı ilə müəyyən edilən Adversarial Influence dəyəridir.
Dəyər artdıqca hədəf modelin həmin nümunənin yaxın ətrafındakı perturbasiyaya daha həssas olduğu başa düşülür. Tədqiqat bu həssaslığı qərar sərhədi baxımından nümunə əhəmiyyətinə dair vekil siqnal kimi istifadə edir.
Qeyri-müəyyənlik ölçümündən fərqi nədir?
Standart uncertainty yanaşması çox vaxt təsnifatlandırıcının mövcud proqnozunun 0,5 kimi qərar həddinə nə qədər yaxın olduğuna baxır.
Adversarial Influence isə başqa bir sual verir:
“Bu nöqtəyə kiçik və istiqamətləndirilmiş dəyişiklik etdikdə modelin proqnozu nə qədər hərəkət edir?”
Beləliklə ölçüm statik proqnoz ehtimalından daha çox modelin lokal reaksiya davranışına əsaslanır.
Mühüm şərh sərhədi
Adversarial Influence birbaşa riyazi qərar-sərhədi məsafəsi deyil və nümunə verilənlər dəstindən çıxarıldıqda yenidən öyrədilmiş model sərhədinin nə qədər dəyişəcəyini birbaşa hesablamır. Bu tədqiqat onu qərar davranışına lokal həssaslıqdan törədilmiş instance-importance ölçüsü kimi istifadə edir.
Tədqiqatın Metodu və Nəticələri
AIIUS-un üç mərhələsi
| Mərhələ | Əməliyyat | Məqsəd |
|---|---|---|
| 1 | K-Means ilə təmsilçi seçimi | Çoxluq sinfindəki artıqlığı azaldarkən ümumi paylanmanı qorumağa çalışmaq |
| 2 | Surrogate əsaslı PGD və Adversarial Influence | Hər namizədin hədəf model baxımından lokal qərar həssaslığını ölçmək |
| 3 | Influence-guided undersampling | Ən yüksək influence dəyərinə malik qüsursuz nümunələri saxlayaraq tarazlaşdırılmış verilənlər yaratmaq |
Birinci mərhələ: K-Means ilə namizəd hovuzu
Qüsursuz çoxluq sinfi
\[ S_{\mathrm{maj}} \]
üzərində K-Means tətbiq edilir.
Klasterlərin sayı:
\[ K=\lambda|S_{\mathrm{min}}| \]
kimi müəyyən edilir.
Əsas təcrübələrdə:
\[ \lambda=3 \]
istifadə olunur.
Hər klasterin sentroidinə ən yaxın real qüsursuz nümunə seçilir. Beləliklə təxminən
\[ 3|S_{\mathrm{min}}| \]
ölçüsündə namizəd çoxluq hovuzu əldə edilir.
Bu mərhələnin məqsədi birbaşa yekun undersampling etmək deyil. K-Means burada adversarial qiymətləndirməyə daxil olacaq nümunələrin sayını azaldarkən çoxluq sinfinin müxtəlif bölgələrindən təmsilçilər saxlamağa xidmət edir.
İkinci mərhələ: surrogate model
KNN və Random Forest kimi hədəf modellərdə tələb olunan giriş qradiyentləri birbaşa mövcud olmaya bilər. Buna görə tədqiqat:
\[ F_{\mathrm{surrogate}} \]
ilə göstərilən diferensiallana bilən MLP öyrədir.
Surrogate hədəf modelin qərar davranışını təxmini təmsil etmək və PGD perturbasiyasının hansı istiqamətdə yaradılacağını müəyyən etmək üçün istifadə olunur.
Lakin yekun Adversarial Influence yalnız surrogate çıxışından hesablanmır. Orijinal və adversarial nümunələr yenidən hədəf təsnifatlandırıcıya verilərək real hədəf-model proqnoz dəyişməsi ölçülür.
PGD perturbasiyası
Bir nümunə üçün başlanğıc:
\[ x_0=x \]
kimi götürülür və PGD iterasiyası:
\[ x_{t+1} = \Pi_{\|\delta\|_\infty\leq\epsilon} \left[ x_t+ \alpha\, \mathrm{sign} \left( \nabla_x \mathcal L(F_{\mathrm{surrogate}}(x_t)) \right) \right] \]
şəklində tətbiq edilir.
Burada:
- \(\epsilon\): maksimum perturbasiya ölçüsü,
- \(\alpha\): addım ölçüsü,
- \(T\): PGD iterasiyalarının sayıdır.
Bu üç parametr əl ilə sabitlənmək əvəzinə Differential Evolution ilə seçilir. Optimallaşdırma məqsədi təlim verilənləri üzərində cross-validated MCC-dir.
Üçüncü mərhələ: influence-guided selection
Bütün təmsilçi qüsursuz nümunələrin \(I(x)\) skorları hesablandıqdan sonra nümunələr böyükdən kiçiyə sıralanır.
Ən yüksək influence dəyərinə malik
\[ |S_{\mathrm{min}}| \]
sayda qüsursuz nümunə seçilir:
\[ |\widetilde S_{\mathrm{maj}}| = |S_{\mathrm{min}}|. \]
Yekun tarazlaşdırılmış verilənlər dəsti:
\[ D_{\mathrm{balance}} = \widetilde S_{\mathrm{maj}} \cup S_{\mathrm{min}} \]
şəklində qurulur.
AIIUS alqoritminin xülasəsi
- Verilənləri qüsurlu və qüsursuz siniflərə ayır.
- \(K=\lambda|S_{\mathrm{min}}|\) müəyyən et.
- Qüsursuz nümunələri K-Means ilə \(K\) klasterə böl.
- Hər klasterin sentroidinə ən yaxın real nümunəni seç.
- Surrogate MLP-ni öyrət.
- PGD parametrlərini Differential Evolution ilə müəyyən et.
- Hər təmsilçi üçün adversarial nümunə yarat.
- Target classifier vasitəsilə Adversarial Influence hesabla.
- Nümunələri influence skoruna görə sırala.
- Ən yüksək skorlu \(|S_{\mathrm{min}}|\) qüsursuz nümunəni saxla.
- Qüsurlu nümunələrlə birləşdirərək 1:1 tarazlaşdırılmış təlim dəsti yarat.
Təcrübə verilənlər dəstləri
Tədqiqat dörd açıq verilənlər mənbəyindən 18 verilənlər dəstindən istifadə edir:
- AEEEM: JDT, LC, ML, PDE
- NASA: CM1, MW1, PC1, PC3, PC4
- PROMISE: ant-1.3, camel-1.0, synapse-1.0, xalan-2.4
- SOFTLAB: AR1, AR3, AR4, AR5, AR6
Xüsusiyyətlərin sayı təxminən 20 ilə 61 arasında dəyişir.
Ən yüksək disbalans nisbəti PROMISE camel-1.0 verilənlər dəstində:
\[ IR=25.08 \]
kimi bildirilir.
Beş hədəf təsnifatlandırıcı
- K-Nearest Neighbors (KNN)
- Random Forest (RF)
- Decision Tree (TREE)
- Logistic Regression (LR)
- Naive Bayes (NB)
Mənbə bunlardan scikit-learn-dəki standart parametrlərlə istifadə edir.
Altı baseline
- UFIDSF
- SB-GAN
- Cluster-based undersampling
- Random Undersampling
- Borderline-SMOTE
- SMOTE
Təcrübə protokolu
Əvvəlcə hər ədədi xüsusiyyət:
\[ x_i^{(j)} \leftarrow \log(x_i^{(j)}+1) \]
çevrilməsindən keçirilir.
Daha sonra stratified 5-fold cross-validation tətbiq edilir. Resampling yalnız təlim fold-u üzərində aparılır. Test fold-u orijinal sinif paylanması ilə qiymətləndirilir.
Bütün prosedur 10 fərqli random initialization ilə təkrarlanır və nəticələrin ortası götürülür.
İstifadə olunan performans ölçüləri
Probability of Detection / Recall:
\[ PD= \frac{TP}{TP+FN} \]
Probability of False Alarm:
\[ PF= \frac{FP}{TN+FP} \]
Balance:
\[ Balance = 1- \frac{ \sqrt{ PF^2+(1-PD)^2 } }{ \sqrt2 } \]
Bundan əlavə AUC və MCC istifadə olunur.
MCC xüsusilə disbalanslı təsnifatlandırmada faydalıdır, çünki TP, TN, FP və FN-nin hamısını birlikdə nəzərə alır:
\[ MCC= \frac{ TP\times TN-FP\times FN }{ \sqrt{ (TP+FP)(TP+FN)(TN+FP)(TN+FN) } }. \]
AIIUS digər yenidən nümunələmə üsullarına nisbətən hansı nəticəni verir?
Mənbənin ümumi xülasəsinə görə AIIUS təmsilçi baseline üsulları ilə müqayisədə orta hesabla Balance üzrə %9,50, AUC üzrə %3,43 və MCC üzrə %17,02 qazanc verir. Ən ardıcıl üstünlük MCC və Balance üzrə görünür; lakin metod hər classifier-metric kombinasiyasında birinci deyil.
Balance nəticələri
| Təsnifatlandırıcı | AIIUS Balance | Nəticənin mövqeyi |
|---|---|---|
| KNN | 0,688 | Ən yüksək orta |
| LR | 0,698 | Ən yüksək orta |
| NB | 0,650 | Ən yüksək deyil |
| RF | 0,732 | Ən yüksək orta |
| TREE | 0,662 | Ən yüksək orta |
Məsələn, RF üzərində UFIDSF-nin PD dəyəri yüksək olsa da, PF dəyəri də 0,350-yə yüksəlir. AIIUS isə PD=0,768 və PF=0,189 kombinasiyası ilə daha yüksək Balance=0,732 təmin edir.
Bu nəticə AIIUS-un yalnız daha çox qüsur tapmağı deyil, qüsuru aşkar etmə ilə yanlış xəbərdarlıq arasındakı tarazlığı hədəflədiyini göstərir.
AUC nəticələri
AIIUS-un orta AUC dəyərləri:
- KNN: 0,723
- LR: 0,755
- NB: 0,691
- RF: 0,760
- TREE: 0,689
RF və TREE-də AIIUS ən yüksək orta AUC-ni verir. KNN, LR və NB-də isə bəzi baseline-lar daha yüksək dəyər əldə edir.
MCC nəticələri
AIIUS-un orta MCC dəyərləri:
| Təsnifatlandırıcı | AIIUS MCC |
|---|---|
| KNN | 0,316 |
| LR | 0,330 |
| NB | 0,299 |
| RF | 0,387 |
| TREE | 0,274 |
AIIUS KNN, NB, RF və TREE üzərində ən yüksək orta MCC-ni əldə edir. LR-də ən yüksək nəticə SMOTE-un 0,338 dəyəridir; AIIUS 0,330 ilə bundan bir qədər aşağı qalır.
Random Forest altında diqqətçəkən nəticə
Random Forest üçün orta MCC:
| Üsul | Orta MCC |
|---|---|
| AIIUS | 0,387 |
| UFIDSF | 0,310 |
| SB-GAN | 0,323 |
| Cluster | 0,269 |
| RUS | 0,325 |
| Borderline-SMOTE | 0,335 |
| SMOTE | 0,337 |
AIIUS, UFIDSF ilə aparılan verilənlər-dəsti əsaslı müqayisədə RF altında 18/0/0 Win/Draw/Loss nəticəsi əldə edir.
K-Means mərhələsi niyə lazımdır?
K-Means yalnız hesablama xərcini azaltmaq üçün istifadə edilmir. Tədqiqatın əsaslandırmasına görə, yalnız qərar sərhədinə çox yaxın nümunələri saxlamaq çoxluq sinfinin təhlükəsiz və sıx bölgələrini tamamilə təmsildən kənarda qoya bilər. Əvvəl paylanmanın müxtəlif bölgələrindən təmsilçilər götürmək, sonra onların arasından influence əsaslı seçim etmək bu iki məqsədi birləşdirməyə çalışır.
Clustering-ratio təcrübəsi
Mənbə aşağıdakı sazlamaları müqayisə edir:
- No-cluster
- \(1\times|S_{\mathrm{min}}|\)
- \(2\times|S_{\mathrm{min}}|\)
- \(3\times|S_{\mathrm{min}}|\)
- \(3.5\times|S_{\mathrm{min}}|\)
Ümumi nəticə:
\[ \boxed{\lambda=3} \]
sazlamasının orta performansla verilənlər dəstləri arasındakı sabitlik arasında ən tarazlı seçim olmasıdır.
Bu nəticə bütün classifier-lar üçün monoton deyil. Məsələn, KNN no-cluster vəziyyətində bəzi orta göstəricilərdə daha yaxşı ola bilər; lakin standart sapmanın daha yüksək olması metodun verilənlərin bölünməsinə daha həssas olduğunu göstərir.
PCA vizuallaşdırması
NASA PC4 nümunəsində mənbə üç mərhələli PCA vizuallaşdırması təqdim edir:
- Orijinal disbalanslı verilənlər,
- K-Means-dən sonra təmsilçi qüsursuz nümunələr,
- Adversarial Influence seçimindən sonra tarazlaşdırılmış verilənlər.
Bu vizual AIIUS-un “çoxluq sinfini təsadüfi kəsmək” əvəzinə iki mərhələli paylanma + qərar-həssaslığı yanaşmasından istifadə etdiyini izah edir.
Daha mürəkkəb surrogate model AIIUS-u yaxşılaşdırırmı?
Mənbədə standart MLP Deep-MLP, CNN və ResNet surrogate arxitekturaları ilə müqayisə edilir. Nəticələr daha mürəkkəb surrogate modellərin MCC baxımından ardıcıl və böyük üstünlük təmin etmədiyini göstərir. Bu verilənlər miqyasında standart MLP kifayət qədər qərar-funksiyası yaxınlaşması kimi istifadə olunur.
| Təsnifatlandırıcı | MLP | Deep-MLP | CNN | ResNet |
|---|---|---|---|---|
| KNN | 0,316 | 0,316 | 0,314 | 0,315 |
| LR | 0,330 | 0,298 | 0,316 | 0,311 |
| NB | 0,299 | 0,301 | 0,301 | 0,299 |
| RF | 0,387 | 0,390 | 0,382 | 0,385 |
| TREE | 0,274 | 0,279 | 0,281 | 0,275 |
Burada məqsəd surrogate-ın hədəf modellə tam eyni olması deyil; adversarial perturbasiya yaratmaq üçün hədəf qərar davranışını kifayət qədər yaxın təmsil etməsidir.
AIIUS-un hesablama xərci
İlk mərhələdə K-Means təxminən:
\[ O( |S_{\mathrm{maj}}| K d I_{\mathrm{km}} ) \]
xərcinə malikdir.
Surrogate təlimi:
\[ O(ENd) \]
və PGD hissəsi təxminən:
\[ O(KT) \]
kimi verilir.
Target classifier sorğuları:
\[ O(KC_{\mathrm{target}}) \]
və influence skorlarının sıralanması:
\[ O(K\log K) \]
xərcinə malikdir.
Mənbə K-Means və öyrənmə iterasiyalarını praktikada kiçik sabitlər kimi qəbul edərək ümumi quruluşu təxminən
\[ O\!\left( (|S_{\mathrm{maj}}||S_{\mathrm{min}}|+N)d \right) \]
şəklində xülasə edir.
Tədqiqatın dəstəklədiyi nəticələr
- Qərar sərhədi həssaslığı çoxluq-sinfi nümunələrini seçmək üçün istifadə oluna bilən siqnal kimi işləyə bilər.
- AIIUS 18 SDP verilənlər dəstində çoxsaylı baseline-larla müqayisədə xüsusilə MCC və Balance üzrə güclü nəticələr göstərmişdir.
- K-Means ilə orta ölçülü namizəd hovuzu yaratmaq performansla sabitliyi birlikdə yaxşılaşdıra bilər.
- Mənbədə \(3\times\) clustering nisbəti ümumilikdə ən tarazlı iş nöqtəsidir.
- Standart MLP surrogate bu təcrübələrdə daha mürəkkəb surrogate arxitekturalarından ardıcıl olaraq daha pis deyil.
- Black-box hədəf təsnifatlandırıcılarda surrogate vasitəsilə yaradılan perturbasiyalar instance ranking məqsədilə istifadə oluna bilər.
Tədqiqatın dəstəkləmədiyi şərhlər
- AIIUS hər verilənlər dəsti, classifier və metrikdə ən yaxşı üsul deyil.
- Adversarial Influence qərar sərhədinə dəqiq həndəsi məsafəni ölçmür.
- Yüksək influence bir nümunənin çıxarılmasının yenidən öyrədilmiş qərar sərhədini dəqiq nə qədər dəyişdirəcəyini birbaşa göstərmir.
- Tədqiqat adversarial hücum hazırlamaq məqsədi daşımır; perturbasiyalar nümunə əhəmiyyətini ölçmək üçün istifadə olunur.
- Nəticələr bütün disbalanslı təsnifatlandırma problemlərinə avtomatik ümumiləşdirilə bilməz.
- Daha böyük və ya vaxt-kritik verilənlər mühitlərində əlavə PGD və surrogate xərcinin əhəmiyyətsiz olduğu göstərilməyib.
- Surrogate model hədəf qərar davranışını kifayət qədər təmsil edə bilməzsə influence sıralamasının keyfiyyəti aşağı düşə bilər.
Mənbə və Metod Qeydi
Orijinal başlıq: Decision-Boundary Aware Undersampling via Adversarial Influence for Imbalanced Software Defect Prediction
Müəlliflər: Shuo Feng, Rongping Li, Jacky Keung, Xiao Yu, Yucheng Shi, Mingliang Xu.
Corresponding author: Yucheng Shi.
Qurumlar: School of Computer Science and Artificial Intelligence, Zhengzhou University; Department of Computer Science, City University of Hong Kong; State Key Laboratory of Blockchain and Data Security, Zhejiang University.
Mənbə növü: Proqram mühəndisliyi və maşın öyrənməsi sahəsində eksperimental tədqiqat preprinti.
Platforma: SSRN.
SSRN Abstract ID: 6963912.
DOI: 10.2139/ssrn.6963912.
SSRN nəşr tarixi: 18 iyun 2026.
Rəyçilik statusu: Mənbə PDF açıq şəkildə rəy prosesindən keçməmiş preprint olduğunu bildirir.
Müəllif hüquqları/lisenziya yanaşması: Tədqiqat 2026-cı ilin iyununda SSRN-yə yüklənmişdir. SSRN-in daha sonra yayımladığı lisenziya açıqlaması açıq lisenziya seçimi təqdim edilməzdən əvvəl standart qorumanın all-rights-reserved olduğunu bildirir. Mənbədə açıq CC lisenziyası göstərilmədiyi üçün Verianla mətni qoruyucu təkrar-istifadə yanaşması ilə hazırlanmış; mənbə cümlələri və orijinal fiqur tərtibatları yenidən yayımlanmamışdır.
Verilənlər: 18 açıq software defect prediction verilənlər dəsti; AEEEM, NASA, PROMISE və SOFTLAB.
Təsnifatlandırıcılar: KNN, Random Forest, Decision Tree, Logistic Regression, Naive Bayes.
Baseline üsulları: UFIDSF, SB-GAN, Cluster, Random Undersampling, Borderline-SMOTE ve SMOTE.
Qiymətləndirmə: Stratified 5-fold cross-validation, 10 təkrarlı təcrübə, MCC, AUC, Balance, PD və PF.
Statistika: Wilcoxon signed-rank testi, Cliff's delta və Win/Draw/Loss analizi.
Əsas metodoloji məhdudiyyət: Adversarial Influence surrogate üzərindən yaradılan perturbasiyaların target classifier proqnozunda yaratdığı dəyişməyə əsaslanır. Buna görə surrogate-target qərar funksiyası uyğunluğu metodun əsas fərziyyələrindən biridir.
Vizual yenidənqurma: Çox uyğundur. Tamamilə orijinal Verianla sxemi ilə disbalanslı feature-space, K-Means təmsilçiləri, qərar sərhədi, adversarial perturbasiya oxları, influence ranking və tarazlaşdırılmış son verilənlər dəsti göstərilə bilər.
Verianla Live / Live Figure: Uyğundur. Nümunələrin qərar fəzasında necə azaldıldığı və yalnız yüksək-influence çoxluq nümunələrinin necə saxlandığı sabit konseptual verilənlər dəsti üzərində animasiya ilə izah edilə bilər.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib