

Üretken yapay zekâ sistemleri akademik biçime benzeyen akıcı metinler yazabilir; ancak akademik yazının yalnız dilbilgisel doğruluktan ibaret olmadığı unutulmamalıdır. Bilimsel yazarlar iddialarının ne kadar kesin olduğunu, hangi noktalarda ihtiyatlı davrandıklarını, değerlendirmelerini nasıl ifade ettiklerini ve metinde kendi yazar kimliklerini ne ölçüde görünür kıldıklarını çeşitli dilsel araçlarla düzenler. Bu özellikler birlikte akademik sesin önemli bir bölümünü oluşturur.
Bu çalışma, Applied Linguistics alanındaki 40 doktora tezinin özgün Genel Sonuç bölümlerini, aynı tezlerin sonuç bölümü çıkarıldıktan sonra Google Gemini 3 Flash Preview tarafından üretilen 40 yeni Genel Sonuç metniyle karşılaştırmaktadır. Böylece toplam 40 eşleştirilmiş insan–AI metin çifti oluşturulmuştur.
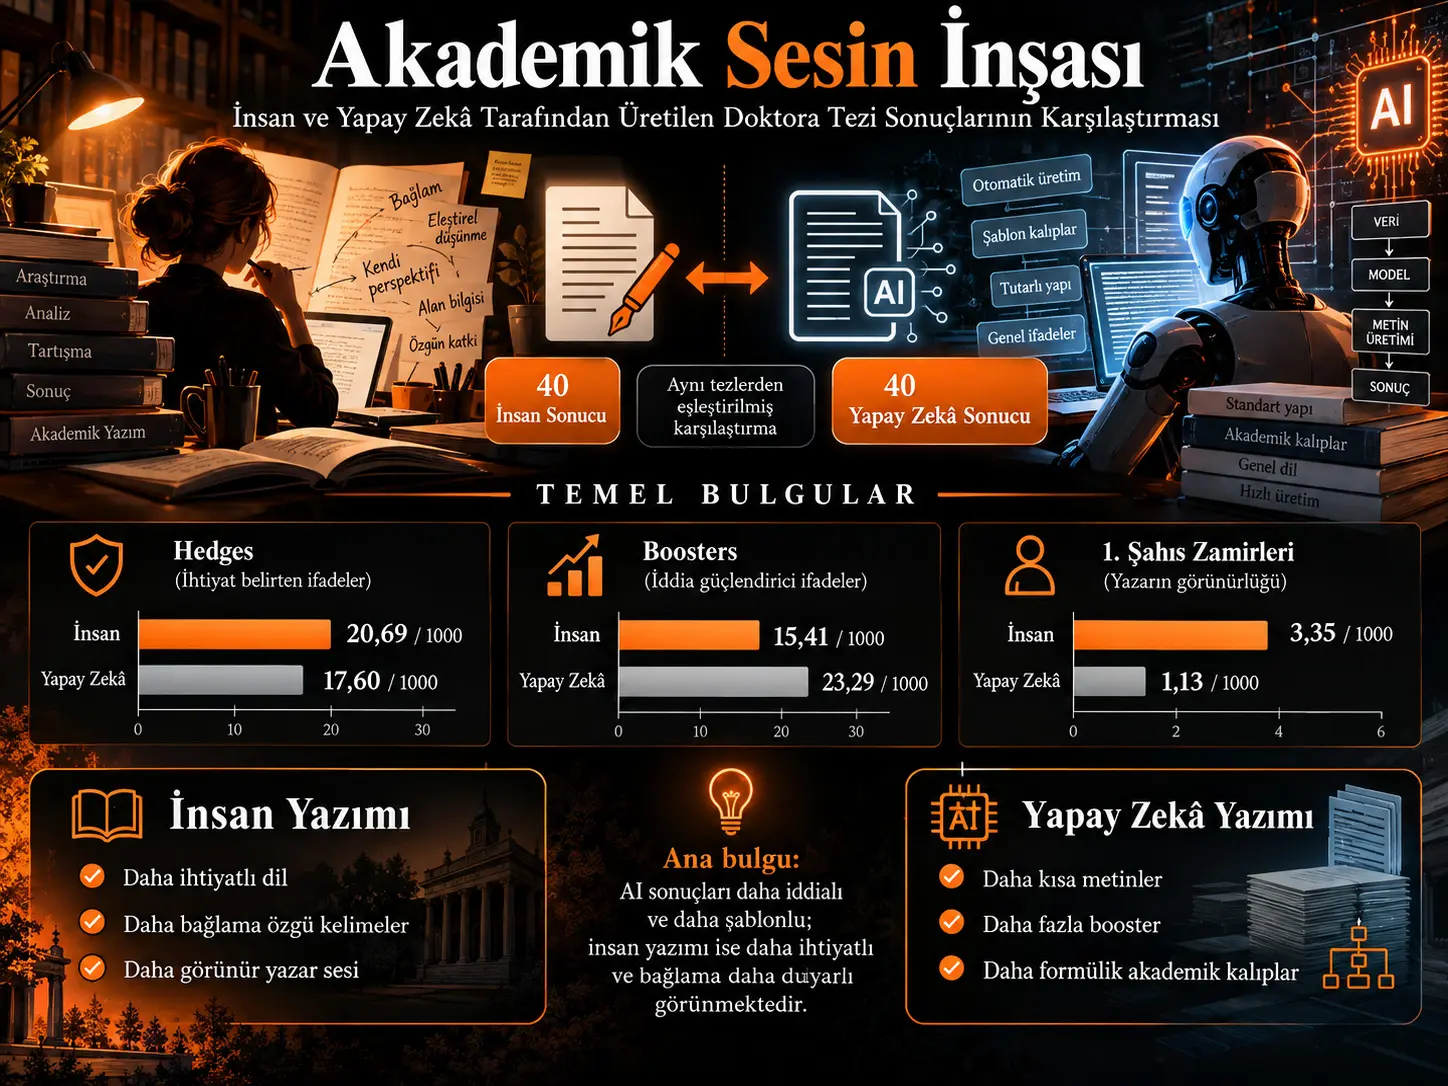
Analiz Hyland'ın stance modelindeki hedges, boosters, attitude markers ve self-mentions kategorilerine odaklanmaktadır. İnsan derleminde hedges 1.000 kelime başına 20,69, AI derleminde 17,60 oranında bulunmuştur. Buna karşılık boosters AI metinlerinde çok daha yüksek görünmektedir: insan derleminde 15,41, AI derleminde 23,29/1.000 kelime.
Attitude markers açısından iki corpus birbirine çok yakındır: 10,77'ye karşı 11,10/1.000 kelime. Birinci şahıs zamirleri ise insan sonuçlarında 3,35/1.000, AI sonuçlarında yalnız 1,13/1.000 oranında görülmüştür. İnsan yazarların “I” ve “we” gibi doğrudan yazar görünürlüğüne daha fazla başvurduğu, AI metinlerinin ise “this study” ve “the present thesis” gibi çalışmayı özne yapan kalıplara daha sık yöneldiği bildirilmiştir.
AI sonuçları ortalama yaklaşık 730 kelime, insan sonuçları yaklaşık 1.351 kelimedir. AI ayrıca “in conclusion”, “this study set out to...” ve “future research” gibi standart akademik kapanış kalıplarına daha sık başvurmuştur. Bu örüntü, kullanılan model ve prompt altında AI metinlerinin daha kısa, daha iddialı ve daha formülik bir akademik ses üretme eğilimini desteklemektedir.
Bununla birlikte kaynakta önemli raporlama ve yöntem sorunları bulunmaktadır. Self-mention kategorisinin 500–600/1.000 kelime gibi olağanüstü yüksek değerleri diğer tablolarla kolayca uzlaştırılamamaktadır. Table 2'nin yön sütununda üç kategorinin işareti ters yazılmıştır. Abstract insanlarda daha fazla lexical diversity iddia ederken makalenin TTR tabloları AI için daha yüksek değerler vermektedir. Ayrıca veri eşleştirilmiş olmasına rağmen kullanılan Mann–Whitney U ve Welch t-testleri bağımsız örneklem testleridir. Bu nedenle bazı sonuçların yeniden analiz edilmesi yararlı olacaktır.
Akademik ses nedir?
Akademik ses, bilimsel bir metnin yalnız ne söylediğini değil, yazarın söylediği bilgiye nasıl konumlandığını da kapsar. Bir araştırmacı bir bulguyu kesin gerçek gibi sunabilir, olasılık olarak çerçeveleyebilir, kişisel değerlendirme ekleyebilir veya doğrudan kendi bilimsel sorumluluğunu görünür hale getirebilir.
Hyland'ın stance yaklaşımı bu işlevleri dört temel grupta inceler: hedges, boosters, attitude markers ve self-mentions.
Hedge ne işe yarar?
Hedge, bilimsel iddianın kesinliğini sınırlar. “May”, “might”, “suggest” ve benzeri yapılar yazarın bir çıkarımı mutlak doğruluk olarak değil, kanıtın izin verdiği ölçüde ileri sürdüğünü gösterir.
Çalışmada insan corpus için 20,69, AI corpus için 17,60 hedge/1.000 kelime bildirilmiştir.
Ancak istatistiksel sonuçlar yönteme göre değişmektedir. Mann–Whitney U ve Welch t-testlerinde fark p<0,05 değildir; aggregate log-likelihood testi ise anlamlı sonuç vermektedir. Bu nedenle insan yazarların daha fazla epistemic caution gösterdiği yönünde frekans farkı vardır fakat istatistiksel kanıt bütün testlerde aynı değildir.
Booster nedir?
Booster, iddianın kesinliğini veya gücünü artıran dilsel işarettir. “Clearly demonstrates”, “reveals” ve “establishes” gibi ifadeler yazarın bir önermeye daha güçlü biçimde bağlı olduğunu gösterir.
AI corpus:
23,29 booster / 1.000 kelime
üretirken insan corpus:
15,41 / 1.000 kelime
üretmiştir.
Bu fark çalışmanın istatistiksel olarak en tutarlı sonuçlarından biridir. Kaynağın üç testi de booster kullanımında anlamlı corpus farkı bildirmektedir.
Bu nedenle çalışma, kullanılan Gemini modeli ve prompt altında AI sonuçlarının insan sonuçlarından daha assertive bir ton oluşturduğunu ileri sürmektedir.
Attitude markers farklı mı?
İki corpus arasında büyük fark yoktur.
İnsan:
10,77 / 1.000
AI:
11,10 / 1.000
ve Welch testi p=0,8352'dir.
Dolayısıyla çalışma, evaluative attitude kullanımında belirgin bir insan–AI ayrımı bulmamıştır.
İnsan Sonuçları ile AI Sonuçları Ne Kadar Farklı Uzunlukta?
| Özellik | İnsan Corpus | AI Corpus |
|---|---|---|
| Metin sayısı | 40 | 40 |
| Toplam kelime | 54.046 | 29.197 |
| Toplam cümle | 2.051 | 1.257 |
| Ortalama kelime | 1.351,2 | 729,9 |
| Ortalama cümle | 51,3 | 31,4 |
İnsan sonuç bölümleri ortalama olarak AI sonuçlarının yaklaşık 1,85 katı uzunluktadır.
Bu fark AI'nın doğal olarak daha özlü olduğunu tek başına kanıtlamaz. Kaynak, prompt tasarımının ve modelin input/output sınırlarının conclusion uzunluğunu etkilemiş olabileceğini açıkça belirtmektedir.
İnsan mı AI mı Daha Fazla Sözcük Çeşitliliği Kullanıyor?
Bu konuda kaynak içinde önemli bir çelişki bulunmaktadır.
Abstract insan yazarların daha fazla lexical diversity gösterdiğini söyler. Buna karşılık Table 1'de Type-Token Ratio:
Human = 0,0854
AI = 0,1262
olarak verilmiştir.
Daha sonraki standardize TTR tablosunda da AI 138,11, insan corpus 91,06 olarak raporlanmıştır. Ayrıca 40 eşleştirilmiş sonucun tamamında AI TTR değeri insan eşleşmesinden daha yüksek verilmiştir.
Dolayısıyla çalışmanın kendi sayısal verileri “insanlar daha fazla lexical diversity gösterdi” sonucunu desteklememektedir.
Kaynağın daha iyi desteklediği ayrım şudur:
AI daha yüksek lexical-variety ölçümleri gösterirken insan yazarlar daha context-specific vocabulary kullanmaktadır.
İnsan corpus'ta “teachers”, “teaching”, “writing” gibi araştırmanın gerçek bağlamına ilişkin kelimeler öne çıkarken AI corpus'ta “doctoral”, “transition”, “landscape” ve “underscores” gibi genel akademik kelimeler daha karakteristiktir.
AI Neden Daha Formülik Görünüyor?
Phraseological analysis AI sonuçlarında belirli academic-summary kalıplarının tekrarlandığını göstermektedir.
Örneğin “in conclusion” insan corpus'ta iki kez, AI corpus'ta 31 kez görülmüştür.
“This study set out to investigate...” kalıbının beş kelimelik biçimi AI corpus'ta 10 kez; “The present doctoral thesis set out to...” benzeri yapı ise sekiz kez görülmüştür.
Bu örüntü AI'nın sonucu organize etmek için yüksek olasılıklı akademik şablonlara daha sık başvurduğunu düşündürmektedir.
Bu formüliklik dilbilgisel bir hata değildir. Metin son derece düzgün olabilir fakat farklı araştırmalar arasında benzer rhetorical packaging kullanabilir.
“Future Research” Kullanımı Neden Dikkat Çekiyor?
“Future research” ifadesi insan corpus'ta dokuz, AI corpus'ta 43 kez bulunmuştur.
AI corpus'un insan corpus'tan çok daha kısa olduğu düşünüldüğünde normalize edilmiş fark daha da büyüktür.
Bu sonuç, AI'nın doktora tezi conclusion türünü sonlandırırken gelecekteki araştırma çağrısını rutin bir genre marker olarak kullanma eğilimiyle uyumludur.
Ancak bütün recommendation sonuçları aynı ölçüde güvenilir değildir. Kaynak bazı recommendation kalıplarını yalnız ham frekanslarla karşılaştırmakta ve corpus büyüklük farkını hesaba katmamaktadır. Bu nedenle hangi corpus'un genel olarak “daha doğrudan tavsiye verdiği” konusunda daha dikkatli olmak gerekir.
Yazarın Kendini Metinde Göstermesi Nasıl Farklı?
Birinci şahıs zamirleri açısından fark oldukça açıktır:
| Gösterge | İnsan | AI |
|---|---|---|
| 1. şahıs zamirleri / 1.000 | 3,35 | 1,13 |
| Passive constructions / 1.000 | 12,84 | 6,23 |
| Ortalama cümle uzunluğu | 26,4 | 23,2 |
İnsan yazarlar “I” ve “we” gibi yapılarla kendi akademik sorumluluklarını doğrudan görünür hale getirmeye daha yatkındır.
AI ise çalışmayı özne yapan “this study” ve “the present thesis” gibi authorial proxy biçimlerine daha fazla yönelmektedir.
Bu nedenle yalnız toplam “self-mention” sayısını değil, authorial presence'ın nasıl kurulduğunu incelemek çok daha bilgilendiricidir.
Self-Mention Sonucunda Neden Sorun Var?
Kaynağın Table 2'sinde insan corpus için 27.171, AI corpus için 17.611 self-mention sayılmaktadır. Normalize oranlar sırasıyla 502,74 ve 603,18/1.000 kelimedir.
Bu, her iki kelimeden yaklaşık birinin self-mention olarak sınıflandırıldığı büyüklükte bir sonuçtur.
Aynı kaynak birinci şahıs zamirlerini yalnız 3,35 ve 1,13/1.000 düzeyinde bildirirken, yaygın “this study/research/thesis/paper” kalıbı da yalnız 128 ve 200 kez sayılmıştır.
Bu nedenle self-mention toplamının nasıl bu kadar yükseldiği makalenin mevcut raporlamasından anlaşılamamaktadır.
Sayım sözlüğü ve Python kodu yayımlanmadan bu kategori bağımsız olarak doğrulanamaz. Bu nedenle self-mention sonucu çalışmanın en güçlü nicel bulguları arasına konmamalıdır.
Table 2'de Bir Raporlama Hatası Var mı?
Evet. “Direction” sütunu bütün kategoriler için HC > AIC yazmaktadır.
Oysa normalize sayılar boosters, attitude markers ve source-defined self-mentions kategorilerinde AIC'nin daha yüksek olduğunu göstermektedir.
Sonraki açıklama metni doğru yönü kullandığı için bunun tablo dizgi veya raporlama hatası olması muhtemeldir.
Eşleştirilmiş Tasarım İstatistiksel Analize Tam Olarak Taşınmış mı?
Hayır. Çalışmanın önemli gücü 40 human–AI metin çiftinin aynı kaynak tezden gelmesidir. Her AI conclusion'ın doğrudan karşılık gelen bir human conclusion'ı bulunmaktadır.
Buna rağmen istatistiksel karşılaştırmada Mann–Whitney U ve Welch t-test kullanılmıştır. Bunlar bağımsız örneklem testleridir ve thesis-level pairing bilgisini doğrudan kullanmaz.
Bu nedenle paired t-test veya Wilcoxon signed-rank gibi eşleştirilmiş testlerle yeniden analiz yapılması sonuçların istatistiksel dayanıklılığını daha iyi değerlendirebilir.
Özellikle hedges için farklı testlerin farklı anlamlılık sonuçları vermesi bu yeniden analizi önemli hale getirmektedir.
Çalışmanın Yöntemi ve Bulguları
Corpus yapısı
Çalışma 40 human-written ve 40 AI-generated General Conclusion'dan oluşan 40 eşleştirilmiş metin çifti kullanmıştır.
İnsan corpus'unun kaynağı
İngilizce yazılmış, Applied Linguistics veya yakın alandaki ve Cezayir üniversitelerinden açık erişimli doktora tezleri seçilmiştir.
AI üretimi
Her tezin özgün General Conclusion bölümü çıkarılmış; giriş, literatür, yöntem, sonuçlar ve discussion gibi diğer bölümler Gemini 3 Flash Preview modeline verilmiştir.
Prompt kontrolü
40 tezin tamamında aynı, kasıtlı olarak basit prompt kullanılmıştır. Prompt, modelin stance veya belirli bir akademik stil kullanmasını özel olarak istememiştir.
Analitik çerçeve
Hyland'ın stance modeline göre hedges, boosters, attitude markers ve self-mentions analiz edilmiştir.
Normalizasyon
Stance-marker frekansları corpus uzunluğundaki farkı azaltmak için 1.000 kelime başına normalize edilmiştir.
İstatistik
Mann–Whitney U, Welch t-test ve log-likelihood kullanılmıştır. Tasarım eşleştirilmiş olmasına rağmen ilk iki test pairing'i doğrudan değerlendirmemektedir.
Temel stance sonuçları
| Kategori | İnsan / 1.000 | AI / 1.000 | En güvenli yorum |
|---|---|---|---|
| Hedges | 20,69 | 17,60 | İnsan daha yüksek; testler anlamlılıkta uyuşmuyor |
| Boosters | 15,41 | 23,29 | AI belirgin biçimde daha yüksek |
| Attitude markers | 10,77 | 11,10 | Belirgin fark yok |
| Self-mentions | 502,74 | 603,18 | Kaynak sayımı doğrulanmadan kullanılmamalı |
Birinci şahıs yazar görünürlüğü
İnsan metinleri 3,35 first-person pronoun/1.000, AI metinleri 1,13/1.000 göstermektedir.
Retorik kalıplar
AI “in conclusion”, “this study...” ve “future research” gibi standardized academic expressions'a daha fazla başvurmuştur.
Lexical sonuç
Kaynak TTR tabloları AI için daha yüksek lexical-variety değerleri verirken keyword ve bundle analizleri insan yazısının daha context-specific olduğunu göstermektedir. Bu iki özellik birbirinden ayrılmalıdır.
Sentence complexity
İnsan sonuçları ortalama 26,4 kelimelik, AI sonuçları 23,2 kelimelik cümleler kullanmıştır.
Passive voice
İnsan corpus'ta passive constructions 12,84/1.000, AI corpus'ta 6,23/1.000 olarak raporlanmıştır.
Çalışmanın desteklediği sonuçlar
Bu veri setinde AI conclusion'ları insan conclusion'larından daha kısadır. AI boosters'ı daha yoğun kullanmaktadır. Attitude-marker kullanımında belirgin fark yoktur. İnsan yazarlar birinci şahıs authorial presence'ı daha fazla kullanmaktadır. AI daha fazla standardized conclusion formula ve generic academic phrasing sergilemektedir. İnsan metinleri ise araştırmanın gerçek bağlamına ilişkin kelimeleri daha sık kullanmaktadır.
Çalışmanın desteklemediği sonuçlar
Bütün yapay zekâ modellerinin insanlardan daha iddialı yazdığı söylenemez. AI'nın evrensel olarak daha düşük lexical diversity'ye sahip olduğu bu çalışmadan çıkarılamaz. Self-mention'ın 603/1.000 düzeyinde olduğu bağımsız olarak doğrulanmamıştır. İnsan ve AI akademik yazma kapasitesinin genel kalite sıralaması yapılmamıştır. Çalışma yalnız tek model, tek standart prompt, belirli bir disiplin ve Cezayir üniversitelerinden alınan 40 tezle sınırlıdır.
Kaynak ve Yöntem Notu
Özgün çalışma:Constructing Academic Voice: A Corpus-Based Comparison of Human- and AI-Generated Doctoral Thesis Conclusions
Yazar: Dhaya Eddine Ayachi.
PDF'deki kurum: Mohammed Seddik Ben Yahia University, Faculty of Letters and Languages, Department of English.
Platform: SSRN.
SSRN yayın tarihi: 10 Haziran 2026.
SSRN DOI: 10.2139/ssrn.6911006.
Kaynak türü: 36 sayfalık preprint research paper.
Hakemlik durumu: Preprint not peer reviewed.
Lisans: All rights reserved; no reuse allowed without permission.
Temel AI modeli: Google Gemini 3 Flash Preview.
Corpus: 40 eşleştirilmiş human–AI General Conclusion çifti.
Kuramsal çerçeve: Hyland'ın stance modeli.
Analiz araçları: Python; NLTK; SciPy; regex tabanlı marker taraması; Mann–Whitney U, Welch t-test ve log-likelihood.
Temel sınırlılıklar: Tek LLM ve tek prompt kullanılması; human corpus'un tek disiplin ve ülke bağlamıyla sınırlı olması; insan ve AI metin uzunluklarının ciddi biçimde farklı olması; eşleştirilmiş tasarıma rağmen bağımsız örneklem testlerinin kullanılması; self-mention kategorisindeki açıklanamayan yüksek frekanslar; bazı rhetorical-move analizlerinin normalize edilmemiş ham sayılara dayanması; Table 2 yön etiketlerindeki hatalar; abstract'taki lexical-diversity yorumuyla TTR sonuçlarının çelişmesi.
Verianla anlatım ilkesi: Bu içerik kaynak preprintin tam metin çevirisi değildir. Corpus tasarımı, stance-marker sonuçları, phraseological bulgular ve kaynak içi metodolojik sorunlar korunarak bağımsız ve eleştirel bir öğretici yapı oluşturulmuştur. Kaynak conclusion metinleri ve tablolar mekanik olarak yeniden kullanılmamıştır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir