

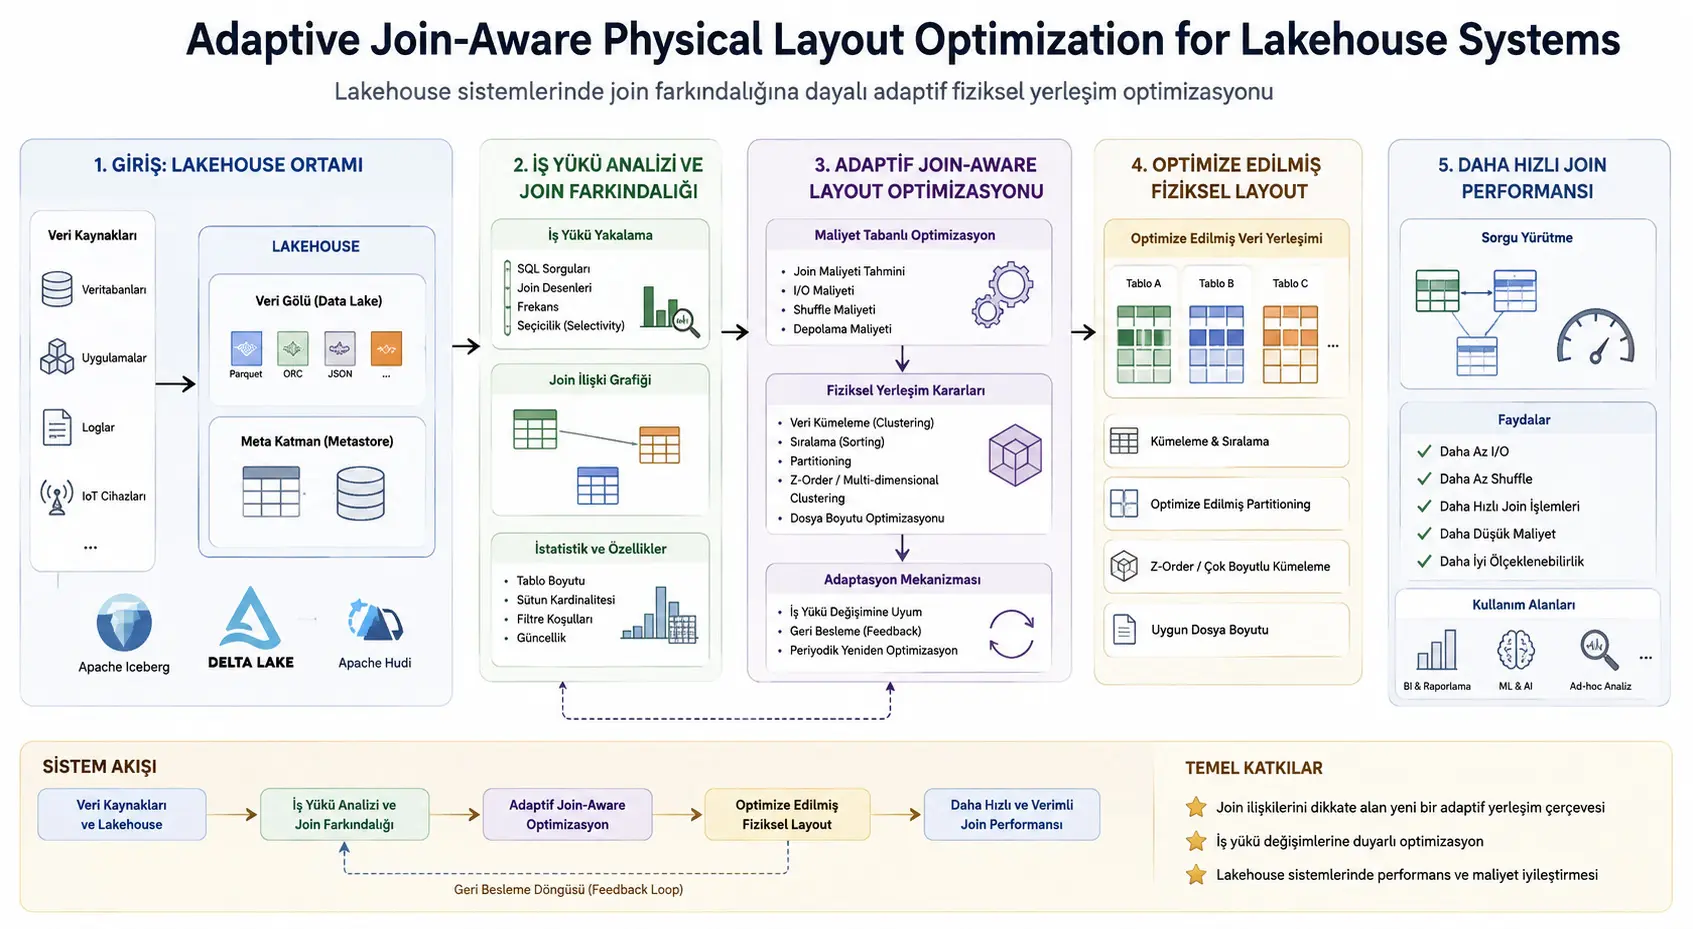
Bu çalışma, açık kaynaklı Delta Lake üzerinde tabloların hangi sütunlara göre fiziksel olarak kümeleneceğini sorgu geçmişinden otomatik biçimde seçen AJLO adlı bir sistem önermektedir. AJLO, belirli bir zaman aralığında çalıştırılan sorguları inceleyerek tablolar arasındaki birleştirme ilişkilerinden ağırlıklı bir grafik oluşturmakta; her ilişkiyi sorgu sıklığı, veri büyüklüğü ve yürütme maliyetini birlikte değerlendiren Birleştirme Önem Puanı ile sıralamaktadır. Ardından sınırlı yeniden yazma bütçesi altında, sık birlikte kullanılan tablolar için uyumlu Liquid Clustering anahtarları seçmektedir.
TPC-H Ölçek Faktörü 1 üzerinde gerçekleştirilen deneylerde AJLO, bütün sorguların ortalamasında sorgu başına taranan veri miktarını 46 MB düzeyine indirmiştir. İşlem uygulanmamış Delta Lake düzeninde bu değer 51 MB, tarih gibi tabloya özgü filtre sütunlarında statik kümelenmiş düzende ise 117 MB olarak bildirilmiştir. Birleştirme ağırlıklı Q01–Q07 sorgularında AJLO, statik filtre sütunu kümelemesine göre taranan bayt miktarını yüzde 86,7 azaltmıştır. Ortalama sorgu gecikmesi AJLO’da 0,6 saniye, statik kümelemede 1,0 saniye ve düzenlenmemiş başlangıç yapısında 1,2 saniyedir.
AJLO’nun temel avantajı, her tabloyu bağımsız olarak düzenlemek yerine aynı birleştirme anahtarını kullanan tabloları birlikte değerlendirmesidir. Bununla birlikte sistem, Spark değiş tokuş veya shuffle işlemini ortadan kaldırmamaktadır. Kazanç, birleştirme başlamadan önce min–maksimum dosya istatistikleri sayesinde daha fazla dosyanın atlanması ve değiş tokuş aşamasına daha az veri ulaşmasından kaynaklanmaktadır. Yaklaşım özellikle büyük iki tablonun Sort-Merge Join ile birleştirildiği sorgulara yöneliktir; küçük bir tablonun bütünüyle yayınlandığı Broadcast Hash Join işlemlerinde aynı yerleşim yararı beklenmemektedir.
Türkiye açısından: AJLO’nun yaklaşımı; açık kaynaklı Apache Spark ve Delta Lake kullanan Türkiye’deki bankacılık, telekomünikasyon, e-ticaret, lojistik, kamu analitiği ve büyük veri platformlarında fiziksel tablo yerleşiminin otomatik değerlendirilmesi için araştırılabilir. Ancak çalışma yaklaşık 1 GB büyüklüğündeki TPC-H verisini tek bir dizüstü bilgisayarda incelemiştir. Türkiye’deki üretim ortamlarına aktarılmadan önce terabayt veya petabayt ölçekli dağıtık kümelerde, kurumun gerçek sorgu geçmişiyle, yeniden yazma maliyetleri ve eş zamanlı veri yükleme süreçleri dâhil edilerek doğrulanması gerekir. Çalışmadan belirli bir Türk kurumunun yüzde 86,7 daha az veri tarayacağı veya sorgularının yüzde 40 hızlanacağı sonucu doğrudan çıkarılamaz.
Lakehouse sistemlerindeki fiziksel yerleşim problemi nedir?
Lakehouse mimarisi, veri göllerinin düşük maliyetli ve açık dosya yapısını veri ambarlarının işlem güvenilirliği ve sorgu özellikleriyle birleştirmeyi amaçlar. Delta Lake bu yapıda çoğunlukla Parquet dosyalarını kullanır ve her dosya için sütunların en düşük ve en yüksek değerleri gibi istatistikler saklar. Bir sorgudaki koşul belirli bir dosyanın değer aralığıyla kesişmiyorsa Spark o dosyayı okumadan atlayabilir. Bu mekanizma file skipping, yani dosya atlama olarak adlandırılır.
Liquid Clustering, benzer anahtar değerlerine sahip satırları Hilbert eğrisi yerelliğinden yararlanarak yakın dosyalarda toplamaya çalışır. Örneğin bir sipariş tablosu sipariş tarihine göre kümelenirse belirli bir tarih aralığını isteyen sorgular çok sayıda dosyayı atlayabilir. Ancak aynı tablo sipariş numarasına göre filtrelenip başka bir tabloyla sipariş numarası üzerinden birleştirildiğinde tarih düzeni yarar sağlamayabilir; aynı sipariş anahtarı aralığı hemen her tarih dosyasına yayılmış olabilir.
Bu nedenle “en sık filtrelenen sütunu seç” yaklaşımı, birleştirme ağırlıklı analitik iş yüklerinde yanlış fiziksel yerleşim üretebilir. Üstelik doğru sütun zaman içinde değişebilir. Bugün sipariş tarihi sorguları baskınken bir sonraki dönemde sipariş–kalem veya müşteri–sipariş birleştirmeleri baskın hâle gelebilir.
Çalışmanın değerlendirdiği açık kaynaklı Delta Lake düzeninde, değişen sorgu örüntülerine göre Liquid Clustering anahtarlarını otomatik ve tablolar arası eşgüdümlü biçimde seçen bir mekanizma bulunmadığı kabul edilmektedir. AJLO bu boşluğu sorgu geçmişinden öğrenilen birleştirme grafiğiyle doldurmayı amaçlamaktadır.
Birleştirme anahtarına göre ortak kümeleme neden önemlidir?
Bir sorgu orders ve lineitem tablolarını orderkey üzerinden birleştiriyor ve aynı anahtarda seçici bir aralık koşulu uyguluyorsa iki tablonun da bu anahtara göre kümelenmesi, her iki tarafta da dosya atlamayı mümkün kılabilir. Yalnızca bir tablonun veya her iki tablonun ilgisiz tarih sütunlarına göre kümelenmesi aynı yararı sağlamaz.
Çalışma, bir ilişkiyi “tarama bakımından hizalanmış” olarak tanımlamak için iki tablonun fiziksel yerleşiminin aynı birleştirme sütununu desteklemesini şart koşmaktadır. Her tablonun yerleşimi aşağıdaki strateji vektörüyle gösterilmektedir:
\[ \lambda(t)=\langle P_t,C_t\rangle \]
- \(P_t\), tablonun dizin temelli bölümleme sütunu veya boş değerdir.
- \(C_t\), Liquid Clustering sütun kümesi veya boş değerdir.
Delta Lake’te PARTITIONED BY ile CLUSTER BY aynı tablo üzerinde eş zamanlı kullanılan iki bağımsız yerleşim biçimi değildir. Planlayıcı bu nedenle mevcut yerleşimi değiştirme maliyetini de hesaba katmak zorundadır.
AJLO mimarisi hangi bileşenlerden oluşmaktadır?
Çalışmanın 6. sayfasındaki Şekil 1, sistemi sürekli geri bildirim döngüsü içinde çalışan altı ana bileşenle göstermektedir:
- Query Log Collector – QLC: SparkListener aracılığıyla tamamlanan sorguların SQL metnini, mantıksal planını, yürütme istatistiklerini ve zaman damgasını toplar. Varsayılan kayan pencere yedi gündür.
- Join Graph Builder – JGB: Sorgu metnini doğrudan ayrıştırmak yerine Spark’ın çözümlenmiş mantıksal planından eşitlik temelli birleştirme ilişkilerini çıkarır.
- Relationship Importance Estimator – RIE: Her birleştirme kenarı için sıklık, veri büyüklüğü ve maliyet ölçülerini normalize ederek Birleştirme Önem Puanını hesaplar.
- Multi-Table Layout Planner – MTLP: Bütçe altında en yüksek beklenen net yararı sağlayan ortak kümeleme veya bölümleme adaylarını seçer.
- Adaptive Reorganization Engine – ARE: Seçilen planı Delta Lake DDL komutlarına ve
OPTIMIZEişlemlerine dönüştürür. - Cost-Based Optimization Layer – CBOL: Yeniden düzenleme sonrasında
ANALYZE TABLEçalıştırarak dosya istatistiklerini yeniler ve sonuçları geri bildirim döngüsüne aktarır.
Bu bileşenlere ek olarak İş Yükü Kayması Algılayıcısı, birleştirme ilişkilerinin göreli öneminde yeterli değişim oluştuğunda planlayıcıyı yeniden çalıştırır. Kayma eşik altında kalırsa mevcut plan korunur.
Birleştirme grafiği nasıl oluşturulmaktadır?
Her tablo grafikte bir düğüm, iki tablo arasındaki birleştirme ilişkisi ise bir kenar olarak gösterilir. Bir kenar için üç temel değer hesaplanır:
- F(i,j): Kayan zaman penceresinde bu birleştirmeyi içeren sorgu sayısı.
- D(i,j): İlgili sorgularda iki tablonun satır sayılarının çarpımının ortalaması.
- C(i,j): Bu birleştirmeyi içeren sorguların ortalama yürütme maliyeti.
Sorgu planlarından sütun kökenini çıkarmak, yalnızca SQL içindeki adları aramaktan daha karmaşıktır. Spark çözümlenmiş planında sütunlar, doğrudan customer_id gibi adlardan çok exprId tanımlayıcılarıyla temsil edilebilir. Bu kimliklerin özgün tablo ve sütunlara geri bağlanması için Project, Alias, Filter ve Subquery düğümleri boyunca soy zinciri izlenmektedir.
Birleştirme Önem Puanı nasıl hesaplanmaktadır?
AJLO, normalleştirilmiş sıklık, veri büyüklüğü ve yürütme maliyetini çarpar:
\[ JIS(i,j)=\widehat{F}(i,j)\times\widehat{D}(i,j)\times\widehat{C}(i,j) \]
Veri büyüklüğü değerleri geniş bir aralığa yayılabileceği için \(D\), normalizasyondan önce logaritmik olarak ölçeklenir:
\[ \widehat{D}(i,j)= \frac{\log_{10}(D(i,j)+1)-\log_{10}(D_{\min}+1)} {\log_{10}(D_{\max}+1)-\log_{10}(D_{\min}+1)+\varepsilon} \]
Sıklık ve maliyet için standart en küçük–en büyük normalizasyonu uygulanır:
\[ \widehat{X}(i,j)= \frac{X(i,j)-X_{\min}} {X_{\max}-X_{\min}+\varepsilon}, \qquad X\in\{F,C\} \]
Çarpımsal yapı, üç boyuttan herhangi biri sıfıra yaklaştığında toplam puanın da sıfıra yaklaşmasını sağlar. Böylece çok sık çalıştırılan fakat küçük ve ucuz bir boyut tablosu birleştirmesi, yalnızca sıklığı yüksek olduğu için yeniden yazma bütçesinin büyük bölümünü alamaz.
Çalışmadaki örnek karşılaştırmada sıklığı yüksek ancak tabloları küçük ve hızlı bir ilişkinin çarpımsal puanı 0,002 olurken, bütün boyutlarda dengeli bir ilişkinin puanı 0,125’tir. Toplamsal formül aynı örneklere sırasıyla 0,333 ve 0,500 vererek ucuz ilişkinin önemini görece fazla büyütmektedir.
JIS doğrudan bayt kazancı değildir. Boyutsuz bir öncelik sıralama işaretidir. Ekonomik optimizasyon hedefi ayrı olarak tahmini tarama azalması, yeniden yazma maliyeti ve depolama maliyeti üzerinden hesaplanmaktadır.
Çok Tablolu Yerleşim Eşgüdümü problemi nasıl tanımlanmaktadır?
Çalışma, fiziksel yerleşim kararını Multi-Table Layout Coordination adı verilen bütçe kısıtlı bir net bugünkü değer problemi olarak formüle etmektedir:
\[ \operatorname{NPV}(L)= \sum_{(i,j)\in E} \operatorname{ScanReduction}(i,j,L) \left( \frac{1-(1+r)^{-H}}{r} \right) -\operatorname{RewriteCost}(L) -\operatorname{StorageCost}(L) \]
Kısıtlar:
\[ \operatorname{RewriteCost}(L)\leq B \]
\[ \operatorname{StorageCost}(L)\leq S \]
- \(L\), seçilen çok tablolu fiziksel yerleşim planıdır.
- \(H\), planlama ufkudur.
- \(r\), pencere başına iskonto oranıdır.
- \(B\), yeniden yazma bütçesidir.
- \(S\), depolama bütçesidir.
Çalışmada maliyet ve yarar terimleri bayt cinsinden ifade edilmektedir. Araştırmacı, problemin Maksimum Ağırlıklı Kapsama probleminden indirgeme yoluyla NP-zor olduğunu savunmaktadır. Bu nedenle bütün olası tablo ve anahtar kombinasyonlarını üretim ölçeğinde eksiksiz taramak yerine açgözlü bir yaklaşım kullanılmaktadır.
Dinamik açgözlü planlayıcı nasıl çalışmaktadır?
Planlayıcı, her birleştirme kenarı için mevcut plan altında en yüksek net bugünkü değeri sağlayan adayı bir öncelik kuyruğuna koyar. En yüksek aday seçildikten sonra yeniden yazma maliyeti kalan bütçeye uygunsa plan uygulanır.
Bir tablo için karar verildiğinde o tabloya bağlı diğer kenarların öncelikleri yeniden hesaplanır. Bu adım önemlidir. Örneğin A tablosu B ile order_id üzerinde kümelendikten sonra A–C ilişkisinin customer_id önerisi artık A tablosunun tekrar baştan yazılmasını gerektirebilir. Eski maliyetle hesaplanmış öncelik korunursa planlayıcı aynı tabloyu art arda çelişkili anahtarlara taşıyabilir.
Çalışmada en kötü durum karmaşıklığı yoğun bir yıldız şeması için yaklaşık olarak:
\[ O(|E|^2\cdot|C|\cdot\log|E|) \]
şeklinde verilmektedir. Düğüm derecesinin düşük olduğu tipik seyrek şemalarda ise:
\[ O(|E|\cdot|C|\cdot\log|E|) \]
düzeyine yaklaşmaktadır.
Yeniden düzenleme işlemi nasıl uygulanmaktadır?
Liquid Clustering anahtarı değiştirileceğinde önerilen işlem sırası şöyledir:
ALTER TABLE tablo CLUSTER BY (sutun);
OPTIMIZE tablo;
ANALYZE TABLE tablo;
Liquid Clustering ile dizin temelli bölümleme arasında geçiş yapılacaksa önce mevcut kümeleme kaldırılmalı, ardından yeni fiziksel düzen tanımlanmalı ve tablo yeniden yazılmalıdır.
Çalışma, OPTIMIZE işlemlerinin eş zamanlı ETL yazıcılarıyla çakışabileceğini vurgulamaktadır. Delta işlem günlüğündeki iyimser eş zamanlılık denetimi, ConcurrentAppendException veya ConcurrentDeleteReadException üretebilir. AJLO, bu durumda artan bekleme süresiyle yeniden deneme, en güncel tablo görüntüsünü okuma ve planı yeniden değerlendirme yaklaşımı önermektedir.
Yeniden kümeleme sonrasında istatistiklerin güncellenmemesi, yeni dosyaların eski sütun istatistikleriyle değerlendirilmesine yol açabilir. Bu nedenle ANALYZE TABLE, dosya atlama mekanizmasının yeni anahtarı kullanabilmesi için sistem döngüsünün zorunlu bir parçası olarak ele alınmaktadır.
AJLO hangi sorgu türlerinde etkili olmayı amaçlamaktadır?
Sistem büyük iki tablonun Sort-Merge Join ile birleştirildiği sorgulara odaklanmaktadır. Bu sorgularda her iki tablodan okunan satırlar değiş tokuş aşamasına girmeden önce fiziksel dosyalardan taranır. Uygun anahtara göre kümeleme daha az dosyanın okunmasını sağlayabilir.
AJLO, Spark’ın ClusteredDistribution gereksinimini karşılamadığı için shuffle işlemini ortadan kaldırmaz. Catalyst yine bir Exchange düğümü ekler. İyileşme, Exchange’e giren veri miktarının azalmasıdır.
Adaptive Query Execution, değiş tokuş aşamalarından sonra gerçek istatistiklere göre yürütme planını değiştirebilir. Ancak AQE devreye girdiğinde kaynak dosyalar zaten okunmuştur. AJLO ve AQE bu nedenle aynı maliyeti hedeflemez:
- AJLO, depolamadan kaynak okuma maliyetini azaltmayı amaçlar.
- AQE, çalışma sırasındaki plan ve değiş tokuş aşamalarını uyarlamayı amaçlar.
Bir sorgu çalışma sırasında Broadcast Hash Join’a dönüştürülürse küçük taraf bütünüyle yayınlanır ve ortak kümeleme aynı dosya tarama yararını sağlamayabilir. Çalışma optimizasyon kapsamını bu nedenle Sort-Merge Join alanında kalan ilişkilerle sınırlandırmıştır.
İş yükü kayması nasıl belirlenmektedir?
Ardışık iki zaman penceresindeki birleştirme grafikleri arasındaki değişim, kenarların JIS değerlerinin normalize edilmiş farklarının ortalamasıyla ölçülmektedir:
\[ \operatorname{Drift}(G_k,G_{k+1})= \frac{1}{|E_k\cup E_{k+1}|} \sum_{(i,j)\in E_k\cup E_{k+1}} \frac{ |JIS_k(i,j)-JIS_{k+1}(i,j)| }{ \max(JIS_k(i,j),JIS_{k+1}(i,j),\varepsilon) } \]
Varsayılan eşik \(\delta=0{,}10\)’dur. Eşik aşılırsa plan yeniden değerlendirilir. Yeni dönemde ilk kez ortaya çıkan birleştirme ilişkilerine doğrudan yüksek yeniden değerlendirme önceliği verilir.
Deney ortamı nasıl hazırlanmıştır?
Bütün deneyler Apple M1 işlemcili ve 8 GB birleşik belleğe sahip tek bir dizüstü bilgisayarda gerçekleştirilmiştir. Kullanılan temel yapılandırma şöyledir:
- Apache Spark 4.0.0, yerel
local[8]çalışma biçimi - Delta Lake 3.2.0
- PySpark 4.0.0
- 6 GB sürücü belleği
- 50 shuffle bölümü
- Adaptive Query Execution etkin
- Broadcast eşiği 10 MB
- Hedef Delta dosya büyüklüğü 2 MB
TPC-H Ölçek Faktörü 1 verileri özel bir Python üreticisiyle hazırlanmıştır. Orders, lineitem, customer, supplier, part, partsupp, nation ve region olmak üzere sekiz tablo kullanılmıştır. Her yapılandırma beş kez çalıştırılmış ve ortanca değerler raporlanmıştır.
Hedef dosya büyüklüğünün 2 MB seçilmesi deney tasarımında önemli bir ayrıntıdır. Varsayılan 128 MB kullanıldığında Ölçek Faktörü 1 tablolarında yalnızca bir veya iki dosya oluşmakta ve dosya atlama oranı anlamlı biçimde ölçülememektedir. İki megabaytlık dosyalar çok daha fazla dosya oluşturarak anahtar seçiminin etkisini görünür kılmıştır. Ancak bu tercih, deney ortamını üretim sistemlerindeki tipik dosya büyüklüklerinden uzaklaştırmaktadır.
Hangi temel düzenler karşılaştırılmıştır?
| Düzen | Açıklama |
|---|---|
| B0 | Herhangi bir fiziksel yerleşim optimizasyonu uygulanmamış ham Delta Lake tabloları |
| B2 | Her tablo için tarih gibi sık filtrelenen sütunlarda bir kez kurulmuş ve değiştirilmemiş statik Liquid Clustering |
| AJLO | Sorgu geçmişindeki baskın birleştirme ilişkilerine göre tablolar arasında eşgüdümlü anahtar seçimi |
Hive tarzı dizin bölümlemesi karşılaştırmadan çıkarılmıştır. Çalışmanın amacı Liquid Clustering ile geleneksel Hive bölümlemesini yeniden karşılaştırmak değil, aynı Liquid Clustering altyapısında seçilen sütunun etkisini ölçmektir.
Taranan veri miktarında ne bulundu?
Şekil 2’de bütün sorgular üzerinden hesaplanan ortalama tarama miktarları şöyledir:
| Fiziksel düzen | Sorgu başına ortalama taranan veri |
|---|---|
| B0 – optimizasyon yok | 51 MB |
| B2 – filtre sütunlarında statik kümeleme | 117 MB |
| AJLO – birleştirme duyarlı kümeleme | 46 MB |
B2’nin düzenlenmemiş B0’dan daha fazla veri taraması dikkat çekicidir. orders tablosunun o_orderdate, lineitem tablosunun ise l_shipdate üzerinde kümelenmesi tarih koşullarına yardımcı olur; fakat orderkey aralığı kullanan birleştirme sorgularında anahtar değerleri tarih dosyalarına yayıldığı için neredeyse bütün dosyalar uygun görünmektedir. Statik düzen, başlangıç verisindeki doğal yerelliği de bozarak bazı sorgularda taramayı artırmıştır.
AJLO’nun JIS sıralamasında lineitem ↔ orders ilişkisi 1,000 puanla birinci, customer ↔ orders ilişkisi 0,404 puanla ikinci sıradadır. Sistem bu baskın ilişkileri ortak anahtarlarda kümelendirmiştir.
Yüzde 86,7’lik azalma bütün sorguların ortalaması değildir. Bu değer, birleştirme ağırlıklı Q01–Q07 sorgularında AJLO’nun B2’ye göre taradığı baytların azalmasını ifade etmektedir. Yalnızca tarih filtresi kullanan Q08–Q10 sorgularında ise B2 avantajlıdır. AJLO bu erişim örüntülerini özellikle optimize etmemiştir.
Sorgu gecikmesi nasıl değişmiştir?
Şekil 5’teki ayrıntılı sonuçlara göre:
| Düzen | Ortalama sorgu gecikmesi |
|---|---|
| B0 | 1,2 saniye |
| B2 | 1,0 saniye |
| AJLO | 0,6 saniye |
AJLO, statik filtre sütunu kümelemesine göre ortalama gecikmeyi yüzde 40 azaltmıştır. Araştırmacı bu kazancı farklı bir sorgu yürütme algoritmasına değil, değiş tokuş öncesinde daha az dosya ve satır okunmasına bağlamaktadır.
Çalışmanın giriş bölümündeki bir cümlede 0,5 ve 0,6 saniyelik farklı değerler bulunmaktadır. Bununla birlikte özet, sonuç metni ve Şekil 5 tutarlı biçimde AJLO için 0,6, B2 için 1,0 saniye bildirdiği için bu değerler esas alınmalıdır.
Dosya atlama oranında ne bulundu?
RQ2 kapsamında raporlanan ortalama dosya atlama oranları şöyledir:
| Düzen | Ortalama dosya atlama oranı |
|---|---|
| B0 | %14,9 |
| B2 | %14,5 |
| AJLO | %54,4 |
Statik tarih sütunu kümelemesinin yüzde 14,5 ile düzenlenmemiş tablonun yüzde 14,9 değerine yakın kalması, birleştirme ağırlıklı sorgular için yanlış anahtar seçiminin dosya atlamaya hemen hiç katkı sağlamadığını göstermektedir.
AJLO planlama modelinde ortak Liquid Clustering için yüzde 30’luk bir tarama azaltma katsayısı kullanılmıştır. Deneyde Q01–Q07 sorgularının ölçülen dosya atlama oranları yüzde 76–79 arasında gerçekleşmiştir. Model bu küçük veri düzeninde yaklaşık 2,5 kat muhafazakâr kalmıştır. Aynı farkın büyük dosya ve veri ölçeklerinde sürüp sürmeyeceği bilinmemektedir.
İş yükü kayması deneyi ne göstermiştir?
Üç farklı iş yükü rejiminde sorgu şablonlarının sıklıkları değiştirilmiş, ancak kullanılan birleştirme sütunları değiştirilmemiştir. W3 penceresindeki kayma puanı 0,249, W4’teki puan 0,107 olarak hesaplanmış ve her ikisi de 0,10 eşiğini aşmıştır. Sistem bu noktalarda yeniden değerlendirmeyi doğru biçimde tetiklemiştir.
W5’te 0,069 ve W6’da 0,091 değerleri eşik altında kalmış, yeniden optimizasyon başlatılmamıştır. Ancak bütün pencerelerde gerçek yeniden yazma maliyeti sıfırdır. Bunun nedeni değişen unsurun birleştirme sütunları değil, mevcut ilişkilerin sıklıkları olmasıdır. Yeniden değerlendirme, mevcut fiziksel düzenin hâlâ yeterli olduğuna karar vermiştir.
Dolayısıyla deney, kayma algılayıcısının eşik davranışını göstermektedir; yeni bir birleştirme sütunu ortaya çıktığında tablonun gerçekten yeniden kümelenmesini ve bunun maliyetini değerlendirmemektedir. Araştırmacı bunu gelecekteki çalışmalar için temel eksiklerden biri olarak kabul etmektedir.
Açgözlü planlayıcı optimum çözüme ne kadar yaklaşmıştır?
Beş ile sekiz tablo, altı ile on iki kenar ve toplam yeniden yazma maliyetinin yüzde 20–50’si arasında bütçe içeren dokuz sentetik grafik yapılandırması oluşturulmuştur. Açgözlü çözümün kesin kaba kuvvet optimumuna oranı hesaplanmıştır.
- Dokuz yapılandırmanın altısında açgözlü çözüm optimumla aynı sonucu vermiştir.
- Dokuz yapılandırmanın sekizi \(1-1/e\approx0{,}632\) sınırını karşılamış veya aşmıştır.
- Bütün yapılandırmaların ortalama yaklaşım oranı 0,913’tür.
- C6 yapılandırması 0,570 oranında kalmıştır.
C6’da sıkı bütçe, algoritmanın erken aşamada yerel olarak çekici bir kenarı seçmesine ve daha yüksek toplam yarar sağlayacak sonraki kombinasyona ulaşamamasına neden olmuştur. Bu sonuç, teorik \(1-1/e\) sınırının yalnızca alt modülerlik ve azalan marjinal getiri koşulları sağlandığında geçerli olduğunu hatırlatmaktadır. Çalışmanın tam yerleşim probleminde bu koşullar her yapılandırmada garanti edilmemiştir.
Çalışmanın güçlü yönleri nelerdir?
- Açık kaynaklı lakehouse yığınına özgü ve açık biçimde tanımlanmış bir fiziksel tasarım problemi ele alınmıştır.
- Tablolar bağımsız değil, birleştirme grafiği üzerinden eşgüdümlü olarak değerlendirilmiştir.
- Matematiksel amaç fonksiyonu, bütçe kısıtları ve algoritmalar açık biçimde sunulmuştur.
- Dosya tarama miktarı, sorgu gecikmesi, dosya atlama oranı, kayma algılama ve yaklaşım kalitesi ayrı deneylerle incelenmiştir.
- Sistemin Spark shuffle işlemini ortadan kaldırmadığı açıkça belirtilmiştir.
- Deney yapılandırmaları, kod, veri üreticisi ve sonuç betikleri için yeniden üretilebilirlik bilgileri verilmiştir.
- Negatif sonuç niteliğindeki C6 başarısızlığı ve üretim ölçeğine ilişkin belirsizlik gizlenmemiştir.
Çalışmanın başlıca sınırlılıkları nelerdir?
- Deneyler tek bir Apple M1 dizüstü bilgisayarda ve yerel Spark kipinde gerçekleştirilmiştir.
- TPC-H Ölçek Faktörü 1 yaklaşık 1 GB büyüklüğündedir ve veriler belleğe sığmaktadır.
- Üretim ortamındaki ağ, dağıtık depolama, yürütücüler arası veri aktarımı ve düğüm arızaları incelenmemiştir.
- İki megabaytlık hedef dosya büyüklüğü, dosya atlama etkisini görünür kılmak için deneysel olarak küçültülmüştür.
- Özel Python TPC-H üreticisi, resmî
dbgendağılımından küçük farklılıklar içerebilir. - Yüzde 86,7’lik tarama azalması yalnızca birleştirme ağırlıklı yedi sorgu ve B2 karşılaştırması için geçerlidir.
- Filtre ağırlıklı sorgularda statik tarih kümelemesi AJLO’dan daha iyi sonuç verebilmiştir.
- Kayma deneyi yeni birleştirme sütunları içermediği için gerçek fiziksel yeniden kümeleme oluşmamıştır.
- OPTIMIZE işlemlerinin terabayt veya petabayt ölçeğindeki gerçek maliyeti ölçülmemiştir.
- Depolama ve yeniden yazma maliyetlerinin bayt tabanlı tahminleri üretim faturaları veya operasyonel kesinti riskiyle doğrulanmamıştır.
- Greedy planlayıcı bir yapılandırmada teorik sınırın altında kalmıştır.
- Çalışma hakem değerlendirmesinden geçmemiştir.
Çalışma hangi sonuçları desteklemektedir?
- Aynı küçük TPC-H ortamında Liquid Clustering anahtarının seçimi, dosya atlama ve taranan veri üzerinde büyük fark oluşturmuştur.
- Birleştirme anahtarına göre eşgüdümlü kümeleme, Q01–Q07 sorgularında tarih sütununa göre statik kümelemeden daha az veri taramıştır.
- Yanlış sütuna göre kümelenmiş fiziksel düzen, bazı iş yüklerinde düzenlenmemiş tablodan daha kötü sonuç verebilmiştir.
- Çarpımsal JIS, çalışmadaki örneklerde yüksek sıklıklı ancak düşük maliyetli ilişkileri geri plana atabilmiştir.
- Kayma ölçütü, test edilen sorgu sıklığı geçişlerinde eşik aşımını belirleyebilmiştir.
- Açgözlü planlayıcı, dokuz küçük sentetik grafikte ortalama 0,913 optimum oranı sağlamıştır.
Çalışma hangi sonuçları kanıtlamamaktadır?
- AJLO’nun bütün açık kaynaklı Delta Lake kurulumlarında daha hızlı olacağını kanıtlamaz.
- Yüzde 86,7 tarama azalmasının terabayt veya petabayt ölçekte korunacağını göstermez.
- AJLO’nun shuffle işlemini veya Sort-Merge Join değiş tokuşunu ortadan kaldırdığını göstermez.
- Broadcast Hash Join kullanan sorguların aynı ölçüde yarar göreceğini göstermez.
- Filtre ağırlıklı sorgularla birleştirme ağırlıklı sorguları aynı anda en iyi şekilde optimize ettiğini göstermez.
- İş yüküne yeni birleştirme sütunları eklendiğinde yeniden kümelenmenin başarıyla ve düşük maliyetle tamamlanacağını göstermez.
- Açgözlü planlayıcının bütün grafik ve bütçe koşullarında \(1-1/e\) sınırını sağlayacağını kanıtlamaz.
- Üretim sisteminde elde edilecek parasal tasarrufu veya hizmet seviyesi iyileşmesini ölçmez.
Çalışmanın Yöntemi ve Bulguları
Yöntem özeti
| Yöntem bileşeni | Çalışmada uygulanan yaklaşım |
|---|---|
| Araştırma türü | Algoritmik sistem tasarımı, küçük ölçekli TPC-H deneyi ve sentetik grafik değerlendirmesi |
| Sistem adı | AJLO – Adaptive Join-aware Layout Optimizer |
| Hedef platform | Açık kaynaklı Apache Spark ve Delta Lake |
| Temel veri yapısı | Sorgu geçmişinden oluşturulan ağırlıklı tablo birleştirme grafiği |
| Önem puanı | Normalize edilmiş sorgu sıklığı × log ölçekli veri büyüklüğü × yürütme maliyeti |
| Optimizasyon amacı | Yeniden yazma ve depolama bütçesi altında beklenen tarama azalmasının net bugünkü değerini yükseltmek |
| Planlayıcı | Öncelikleri her karar sonrasında güncellenen dinamik açgözlü algoritma |
| Uyarlama | JIS dağılımındaki değişim için kayma ölçütü; varsayılan eşik 0,10 |
| Deney verisi | TPC-H Ölçek Faktörü 1; sekiz tablo; özel Python veri üreticisi |
| Deney sorguları | On sorgu; beş tekrar; ortanca sonuçlar |
| Donanım | Apple M1 dizüstü bilgisayar, 8 GB birleşik bellek |
| Yazılım | Spark 4.0.0, Delta Lake 3.2.0, PySpark 4.0.0 |
Ana performans bulguları
| Ölçüt | B0 | B2 | AJLO |
|---|---|---|---|
| Ortalama taranan veri | 51 MB | 117 MB | 46 MB |
| Ortalama sorgu gecikmesi | 1,2 saniye | 1,0 saniye | 0,6 saniye |
| Ortalama dosya atlama oranı | %14,9 | %14,5 | %54,4 |
Sorgu türüne göre sonuçların ayrımı
| Sorgu grubu | Avantajlı düzen | Çalışmadaki gözlem |
|---|---|---|
| Q01–Q07, birleştirme ağırlıklı | AJLO | B2’ye göre taranan baytlarda %86,7 azalma; dosya atlama yaklaşık %76–79 |
| Q08–Q10, filtre ağırlıklı | B2 | Tarih sütunu sorgu koşuluyla doğrudan eşleştiği için statik filtre kümelemesi daha az veri tarayabilmiştir |
Kayma algılama bulguları
| Pencere | Kayma puanı | Eşik durumu | Fiziksel yeniden yazma |
|---|---|---|---|
| W3 | 0,249 | 0,10 üzerinde; yeniden değerlendirme | Yok |
| W4 | 0,107 | 0,10 üzerinde; yeniden değerlendirme | Yok |
| W5 | 0,069 | Eşik altında | Yok |
| W6 | 0,091 | Eşik altında | Yok |
Açgözlü planlayıcı bulguları
| Ölçüm | Sonuç |
|---|---|
| Sentetik yapılandırma sayısı | 9 |
| Optimumla tam eşleşen yapılandırma | 6 |
| 0,632 teorik sınırını karşılayan veya aşan | 8 |
| Ortalama yaklaşım oranı | 0,913 |
| En düşük oran | C6 yapılandırmasında 0,570 |
Şekillerin temel mesajları
- Şekil 1: Sorgu günlüğünden başlayan, planlama, uygulama, istatistik yenileme ve kayma algılama döngüsüne uzanan altı bileşenli AJLO mimarisini göstermektedir.
- Şekil 2: Statik filtre sütunu kümelemesinin ortalama 117 MB ile hem B0 hem AJLO’dan daha fazla veri taradığını göstermektedir.
- Şekil 3:
lineitem–ordersilişkisinin 1,000 JIS ile iş yüküne hâkim olduğunu göstermektedir. - Şekil 4: Birleştirme ağırlıklı sorguların AJLO tarafında, filtre ağırlıklı sorguların B2 tarafında avantaj sağladığını ayırmaktadır.
- Şekil 5: Ayrıntılı gecikme değerlerini B0 için 1,2, B2 için 1,0 ve AJLO için 0,6 saniye olarak göstermektedir.
- Şekil 6: AJLO’nun yüzde 54,4 dosya atlama oranını, B0 ve B2’nin yaklaşık yüzde 14–15 değerleriyle karşılaştırmaktadır.
- Şekil 7: Yüzde 30’luk planlama tahmininin, Q01–Q07’de ölçülen yüzde 76–79 oranlarına göre muhafazakâr kaldığını göstermektedir.
- Şekil 8: W3 ve W4 pencerelerinde kayma eşiğinin aşıldığını göstermektedir.
- Şekil 9: Yeniden değerlendirmelere rağmen test edilen rejimlerde fiziksel yeniden yazma maliyetinin sıfır kaldığını göstermektedir.
- Şekil 10: Dokuz yapılandırmadan yalnızca C6’nın 0,632 sınırının altında kaldığını göstermektedir.
- Şekil 11: Açgözlü ve kesin optimum net bugünkü değerleri karşılaştırmakta, en büyük mutlak farkı C6’da göstermektedir.
Kaynak ve Yöntem Notu
Çalışmanın tam özgün adı: Adaptive Join-Aware Physical Layout Optimization for Lakehouse Systems
Yazar: Nishank Mahore.
Yazar sıralaması: Çalışma tek yazarlıdır.
Eşit katkı bilgisi: Başka bir yazar veya eşit katkı bildirimi bulunmamaktadır.
Sorumlu yazar: Nishank Mahore.
İletişim adresi: nishankmahore@gmail.com
Kurumsal bağlantı: Independent Researcher, Pune, India. Çalışmada bir üniversite, araştırma merkezi veya şirket kurumsal bağlantısı verilmemiştir.
Yayın platformu: SSRN.
Resmî kaynak bağlantısı:SSRN çalışma kaydı
Yayın yılı: 2026.
Dergi: Hakemli bir dergi adı veya dergi kabul bilgisi yer almamaktadır.
Yayınevi: Nihai hakemli yayın için bir yayınevi bilgisi yer almamaktadır.
Kaynak türü: Algoritmik sistem tasarımı ve deneysel bilgisayar sistemleri değerlendirmesi; preprint.
Hakemlik durumu: Çalışma hakem değerlendirmesinden geçmemiştir.
Uygulama ve deney kodları:AJLO GitHub deposu
Veri erişimi: Ham TPC-H verileri ayrıca depolanmamıştır. Çalışmada verilerin tpch_generator.py adlı özel üreticiyle deterministik olarak yeniden oluşturulabildiği belirtilmektedir.
Yazar katkısı: Nishank Mahore; kavramsallaştırma, yöntem, yazılım, doğrulama, biçimsel analiz, araştırma, veri düzenleme, görselleştirme, ilk taslak, gözden geçirme ve düzenleme rollerinin tamamını üstlenmiştir.
Finansman: Çalışma için kamu, ticari veya kâr amacı gütmeyen bir kuruluştan özel finansman alınmadığı belirtilmiştir.
Çıkar çatışması: Yazar mali veya kişisel çıkar çatışması bildirmemiştir.
Üretken yapay zekâ beyanı: Üretken yapay zekâ araçlarının yalnızca yazarın özgün metnini düzenleme, kısaltma ve daha açık hâle getirme amacıyla kullanıldığı; araştırma tasarımı, uygulama, deneysel veriler ve teknik sonuçların yapay zekâ tarafından üretilmediği belirtilmiştir.
Bu Türkçe açıklama yalnızca yüklenen çalışmanın metni, matematiksel ifadeleri, algoritmaları, tabloları, deney sonuçları ve Şekil 1–11’deki görsel bulgular temel alınarak hazırlanmıştır. Dış kaynaklar bilimsel sonuç eklemek amacıyla kullanılmamış; yalnızca çalışmanın bibliyografik kimliği ile resmî kayıtlarının doğrulanmasında değerlendirilmiştir.
Çalışmadaki 0,6 saniyelik gecikme, yüzde 54,4 dosya atlama ve yüzde 86,7 tarama azalması sonuçları yaklaşık 1 GB büyüklüğündeki TPC-H Ölçek Faktörü 1 verisi, iki megabaytlık deneysel hedef dosya büyüklüğü ve tek bilgisayarlı yerel Spark ortamına aittir. Bu değerler üretim ölçeği için performans garantisi olarak yorumlanmamalıdır.
Yazarın “daha önce yayımlanmış hiçbir sistemin açık kaynaklı Delta Lake için birleştirme duyarlı Liquid Clustering anahtar seçimini otomatikleştirmediği” yönündeki yenilik iddiası, çalışmanın kendi literatür taramasına dayanmaktadır. Bu makalede bağımsız ve eksiksiz bir öncelik araştırması yapılmamıştır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir