

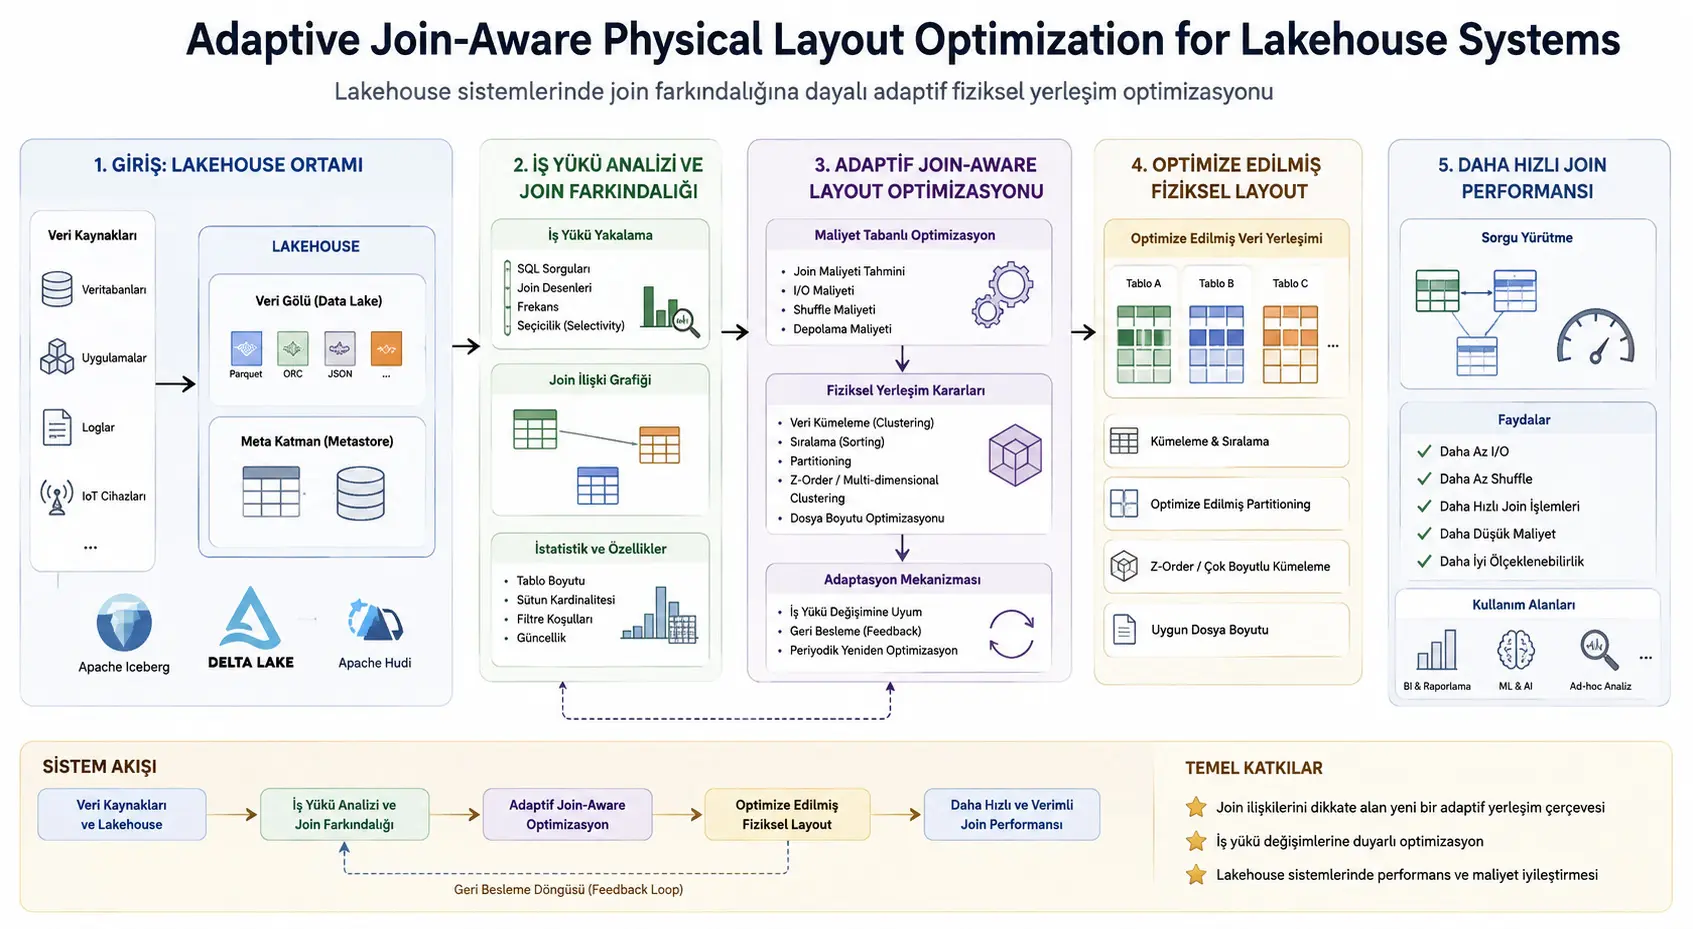
Бул изилдөө ачык булактуу Delta Lake үстүндө таблицаларды кайсы мамычалар боюнча физикалык жактан кластерлөө керектигин суроо тарыхынан автоматтык тандаган AJLO аттуу системаны сунуштайт. AJLO белгилүү убакыт аралыгында аткарылган суроолорду талдап, таблицалар ортосундагы бириктирүү байланыштарынан салмакталган граф түзөт; ар бир байланышты суроо жыштыгын, маалымат көлөмүн жана аткаруу чыгымын чогуу баалаган Бириктирүү Маанилүүлүк Упайы менен иреттейт. Андан кийин чектелген кайра жазуу бюджети шартында көп учурда чогуу колдонулган таблицалар үчүн шайкеш Liquid Clustering ачкычтарын тандайт.
TPC-H Масштаб Фактору 1 боюнча жүргүзүлгөн эксперименттерде AJLO бардык суроолордун орточосунда бир суроого скандалган маалымат көлөмүн 46 MB деңгээлине түшүргөн. Иштетилбеген Delta Lake түзүлүшүндө бул маани 51 MB, дата сыяктуу таблицага мүнөздүү фильтр мамычаларында статикалык кластерленген түзүлүштө 117 MB деп берилген. Бириктирүү басымдуу Q01–Q07 суроолорунда AJLO статикалык фильтр мамыча кластерлөөсүнө салыштырмалуу скандалган байт көлөмүн yüzde 86,7 азайткан. Орточо суроо кечигүүсү AJLOдо 0,6 секунд, статикалык кластерлөөдө 1,0 секунд жана иреттелбеген баштапкы түзүлүштө 1,2 секунд болгон.
AJLOнун негизги артыкчылыгы ар бир таблицаны өз алдынча иреттөөнүн ордуна бир эле бириктирүү ачкычын колдонгон таблицаларды чогуу баалоосу. Бирок система Spark маалымат алмашуу же shuffle операциясын жойбойт. Пайда бириктирүү башталганга чейин минимум–максимум файл статистикасынын жардамы менен көбүрөөк файлды өткөрүп кетүүдөн жана алмашуу этабына азыраак маалымат жетишинен келип чыгат. Ыкма өзгөчө эки чоң таблица Sort-Merge Join менен бириктирилген суроолорго багытталган; кичине таблица толугу менен таратылган Broadcast Hash Join операцияларында ошол эле физикалык жайгашуу пайдасы күтүлбөйт.
Түркия үчүн: AJLO ыкмасы ачык булактуу Apache Spark жана Delta Lake колдонгон Түркиядагы банк, телекоммуникация, электрондук соода, логистика, мамлекеттик аналитика жана чоң маалымат платформаларында физикалык таблица жайгашуусун автоматтык баалоо үчүн изилдениши мүмкүн. Бирок изилдөө болжол менен 1 GB көлөмүндөгү TPC-H маалыматтарын бир ноутбукта караган. Түркиядагы өндүрүш чөйрөлөрүнө өткөрүүдөн мурда терабайт же петабайт масштабындагы бөлүштүрүлгөн кластерлерде, мекеменин чыныгы суроо тарыхы менен, кайра жазуу чыгымдары жана бир убакта жүргөн маалымат жүктөө процесстери кошулуп текшерилиши керек. Изилдөөдөн белгилүү бир түрк мекемеси yüzde 86,7 азыраак маалымат скандайт же суроолору yüzde 40 ылдамдайт деген жыйынтык түз чыгарылбайт.
Lakehouse системаларындагы физикалык жайгашуу көйгөйү эмне?
Lakehouse архитектурасы маалымат көлдөрүнүн төмөн чыгымдуу жана ачык файл түзүлүшүн маалымат кампаларынын транзакциялык ишенимдүүлүгү жана суроо мүмкүнчүлүктөрү менен бириктирүүнү көздөйт. Delta Lake бул түзүлүштө негизинен Parquet файлдарын колдонот жана ар файл үчүн мамычалардын эң төмөнкү жана эң жогорку маанилери сыяктуу статистикаларды сактайт. Эгер суроодогу шарт белгилүү файлдын маанилер диапазону менен кесилишпесе Spark ошол файлды окубай эле өткөрүп кетиши мүмкүн. Бул механизм file skipping, башкача айтканда файлды өткөрүп кетүү деп аталат.
Liquid Clustering окшош ачкыч маанилерине ээ саптарды Hilbert ийри сызыгынын жергиликтүүлүгүн пайдаланып жакын файлдарга топтоого аракет кылат. Мисалы, буйрутмалар таблицасы буйрутма датасы боюнча кластерленсе белгилүү дата диапазонун сураган суроолор көп файлды өткөрүп кете алат. Бирок ошол эле таблица буйрутма номери боюнча фильтрленип, башка таблица менен буйрутма номери аркылуу бириктирилгенде дата түзүлүшү пайда бербеши мүмкүн; бир эле буйрутма ачкычынын диапазону дээрлик бардык дата файлдарына таралышы ыктымал.
Ошондуктан “эң көп фильтрленген мамычаны танда” ыкмасы бириктирүү басымдуу аналитикалык иш жүктөрүндө туура эмес физикалык жайгашуу жаратышы мүмкүн. Мындан тышкары туура мамыча убакыт өтүшү менен өзгөрөт. Бүгүн буйрутма датасы боюнча суроолор үстөм болсо, кийинки мезгилде буйрутма–позиция же кардар–буйрутма бириктирүүлөрү үстөм болушу мүмкүн.
Изилдөө баалаган ачык булактуу Delta Lake түзүлүшүндө өзгөргөн суроо үлгүлөрүнө жараша Liquid Clustering ачкычтарын автоматтык жана таблицалар аралык координацияланган түрдө тандаган механизм жок деп кабыл алынат. AJLO бул боштукту суроо тарыхынан үйрөнүлгөн бириктирүү графы менен толтурууну көздөйт.
Бириктирүү ачкычы боюнча жалпы кластерлөө эмне үчүн маанилүү?
Эгер суроо orders жана lineitem таблицаларын orderkey аркылуу бириктирип, ошол эле ачкычта тандоочу диапазон шартын колдонсо, эки таблицаны тең ушул ачкыч боюнча кластерлөө эки тарапта тең файл өткөрүүнү мүмкүн кылышы мүмкүн. Бир гана таблицаны же эки таблицаны тиешеси жок дата мамычалары боюнча кластерлөө мындай пайданы бербейт.
Изилдөө байланышты “скан жагынан тегизделген” деп эсептөө үчүн эки таблицанын физикалык жайгашуусу ошол эле бириктирүү мамычасын колдоого тийиш деп шарт коёт. Ар бир таблицанын жайгашуусу төмөнкү стратегия вектору менен көрсөтүлөт:
\[ \lambda(t)=\langle P_t,C_t\rangle \]
- \(P_t\), таблицанын каталог негизиндеги бөлүү мамычасы же бош маани.
- \(C_t\), Liquid Clustering мамычалар топтому же бош маани.
Delta Lakeте PARTITIONED BY менен CLUSTER BY бир таблицада бир убакта колдонулган эки көз карандысыз жайгашуу формасы эмес. Ошондуктан пландоочу учурдагы жайгашууну өзгөртүү чыгымын да эске алышы керек.
AJLO архитектурасы кайсы компоненттерден турат?
Изилдөөнүн 6. бетиндеги 1-сүрөт системаны үзгүлтүксүз кайтарым байланыш циклында иштеген алты негизги компонент менен көрсөтөт:
- Query Log Collector – QLC: SparkListener аркылуу бүткөн суроолордун SQL текстин, логикалык планын, аткаруу статистикасын жана убакыт белгисин чогултат. Демейки жылма терезе жети күн.
- Join Graph Builder – JGB: Суроо текстин түз талдоонун ордуна Sparkтын чечилген логикалык планынан теңдикке негизделген бириктирүү байланыштарын чыгарат.
- Relationship Importance Estimator – RIE: Ар бир бириктирүү кыры үчүн жыштык, маалымат көлөмү жана чыгым көрсөткүчтөрүн нормалдаштырып, Бириктирүү Маанилүүлүк Упайын эсептейт.
- Multi-Table Layout Planner – MTLP: Бюджет шартында эң жогорку күтүлгөн таза пайда берген жалпы кластерлөө же бөлүү талапкерлерин тандайт.
- Adaptive Reorganization Engine – ARE: Тандалган планды Delta Lake DDL буйруктарына жана
OPTIMIZEоперацияларына айлантат. - Cost-Based Optimization Layer – CBOL: Кайра иреттөөдөн кийин
ANALYZE TABLEиштетип, файл статистикасын жаңылайт жана натыйжаларды кайтарым байланыш циклына өткөрөт.
Бул компоненттерге кошумча Иш Жүгү Сүрүлүшүн Аныктоочу бириктирүү байланыштарынын салыштырмалуу маанисинде жетиштүү өзгөрүү болгондо пландоочуну кайра иштетет. Сүрүлүш босогодон төмөн болсо учурдагы план сакталат.
Бириктирүү графы кантип түзүлөт?
Ар бир таблица графта түйүн, эки таблица ортосундагы бириктирүү байланышы кыр катары көрсөтүлөт. Ар бир кыр үчүн үч негизги маани эсептелет:
- F(i,j): Жылма убакыт терезесинде ушул бириктирүүнү камтыган суроолордун саны.
- D(i,j): Тиешелүү суроолордогу эки таблицанын сап санынын көбөйтүндүсүнүн орточосу.
- C(i,j): Ушул бириктирүүнү камтыган суроолордун орточо аткаруу чыгымы.
Суроо пландарынан мамычанын келип чыгышын аныктоо SQL ичиндеги аттарды гана издөөдөн татаалыраак. Sparkтын чечилген планында мамычалар түз customer_id сыяктуу аттардан көрө exprId идентификаторлору менен көрсөтүлүшү мүмкүн. Бул идентификаторлорду баштапкы таблица жана мамычаларга кайра байланыштыруу үчүн Project, Alias, Filter жана Subquery түйүндөрү аркылуу келип чыгуу чынжыры көзөмөлдөнөт.
Бириктирүү Маанилүүлүк Упайы кантип эсептелет?
AJLO нормалдаштырылган жыштыкты, маалымат көлөмүн жана аткаруу чыгымын көбөйтөт:
\[ JIS(i,j)=\widehat{F}(i,j)\times\widehat{D}(i,j)\times\widehat{C}(i,j) \]
Маалымат көлөмүнүн маанилери кең диапазонго тарашы мүмкүн болгондуктан \(D\), нормалдаштыруудан мурун логарифмдик масштабга өткөрүлөт:
\[ \widehat{D}(i,j)= \frac{\log_{10}(D(i,j)+1)-\log_{10}(D_{\min}+1)} {\log_{10}(D_{\max}+1)-\log_{10}(D_{\min}+1)+\varepsilon} \]
Жыштык жана чыгым үчүн стандарттык минимум–максимум нормалдаштыруу колдонулат:
\[ \widehat{X}(i,j)= \frac{X(i,j)-X_{\min}} {X_{\max}-X_{\min}+\varepsilon}, \qquad X\in\{F,C\} \]
Көбөйтүү түзүлүшү үч өлчөмдүн бири нөлгө жакындаганда жалпы упай да нөлгө жакындашын камсыз кылат. Ошентип өтө көп аткарылган, бирок кичине жана арзан өлчөм таблицасынын бириктирүүсү жыштыгы жогору болгону үчүн гана кайра жазуу бюджетинин чоң бөлүгүн ала албайт.
Изилдөөдөгү мисал салыштырууда жыштыгы жогору, бирок таблицалары кичине жана тез болгон байланыштын көбөйтүү упайы 0,002 болсо, бардык өлчөмдөрдө тең салмактуу байланыштын упайы 0,125. Кошуу формуласы ошол эле мисалдарга тиешелүүлүгүнө жараша 0,333 жана 0,500 берип, арзан байланыштын маанисин салыштырмалуу ашыкча көбөйтөт.
JIS түздөн-түз байт үнөмдөө эмес. Ал бирдиксиз артыкчылык иреттөө белгиси. Экономикалык оптималдаштыруу максаты өзүнчө болжолдуу скан азайышы, кайра жазуу чыгымы жана сактоо чыгымы боюнча эсептелет.
Көп Таблицалуу Жайгашууну Координациялоо маселеси кантип аныкталат?
Изилдөө физикалык жайгашуу чечимин Multi-Table Layout Coordination деп аталган бюджет чектөөсү бар таза учурдагы нарк маселеси катары формулировкалайт:
\[ \operatorname{NPV}(L)= \sum_{(i,j)\in E} \operatorname{ScanReduction}(i,j,L) \left( \frac{1-(1+r)^{-H}}{r} \right) -\operatorname{RewriteCost}(L) -\operatorname{StorageCost}(L) \]
Чектөөлөр:
\[ \operatorname{RewriteCost}(L)\leq B \]
\[ \operatorname{StorageCost}(L)\leq S \]
- \(L\), тандалган көп таблицалуу физикалык жайгашуу планы.
- \(H\), пландоо горизонту.
- \(r\), ар терезеге дисконт чени.
- \(B\), кайра жазуу бюджети.
- \(S\), сактоо бюджети.
Изилдөөдө чыгым жана пайда мүчөлөрү байт менен берилет. Автор маселе Максималдуу Салмакталган Камтуу маселесинен редукция жолу менен NP-татаал экенин негиздейт. Ошондуктан өндүрүш масштабында бардык мүмкүн болгон таблица жана ачкыч айкалыштарын толук карап чыгуунун ордуна ач көз ыкма колдонулат.
Динамикалык ач көз пландоочу кантип иштейт?
Пландоочу ар бир бириктирүү кыры үчүн учурдагы план шартында эң жогорку таза учурдагы нарк берген талапкерди артыкчылык кезегине жайгаштырат. Эң жогорку талапкер тандалгандан кийин, кайра жазуу чыгымы калган бюджетке туура келсе план колдонулат.
Бир таблица боюнча чечим кабыл алынганда ошол таблицага байланышкан башка кырлардын артыкчылыктары кайра эсептелет. Бул кадам маанилүү. Мисалы, A таблицасы B менен order_id боюнча кластерленгенден кийин A–C байланышынын customer_id сунушу A таблицасын кайра толук жазууну талап кылышы мүмкүн. Эски чыгым менен эсептелген артыкчылык сакталып калса пландоочу бир таблицаны удаалаш карама-каршы ачкычтарга жылдырышы мүмкүн.
Изилдөөдө эң начар учурдун татаалдыгы тыгыз жылдыз схемасы үчүн болжол менен:
\[ O(|E|^2\cdot|C|\cdot\log|E|) \]
деп берилет. Түйүн даражасы төмөн типтүү сейрек схемаларда болсо:
\[ O(|E|\cdot|C|\cdot\log|E|) \]
деңгээлине жакындайт.
Кайра иреттөө операциясы кантип колдонулат?
Liquid Clustering ачкычы өзгөртүлгөндө сунушталган операция ырааты төмөнкүдөй:
ALTER TABLE tablo CLUSTER BY (sutun);
OPTIMIZE tablo;
ANALYZE TABLE tablo;
Liquid Clustering менен каталог негизиндеги бөлүү ортосунда өтүү керек болсо, адегенде учурдагы кластерлөө алып салынат, андан кийин жаңы физикалык түзүлүш аныкталып, таблица кайра жазылышы керек.
Изилдөө OPTIMIZE операциялары бир убакта жазып жаткан ETL процесстери менен кагылышышы мүмкүн экенин баса белгилейт. Delta транзакция журналындагы оптимисттик бир убакта иштөө көзөмөлү ConcurrentAppendException же ConcurrentDeleteReadException чыгарышы мүмкүн. AJLO мындай учурда күтүү убактысын улам көбөйтүп кайра аракет кылууну, эң жаңы таблица көрүнүшүн окууну жана планды кайра баалоону сунуштайт.
Кайра кластерлөөдөн кийин статистика жаңыртылбаса, жаңы файлдар эски мамыча статистикасы менен бааланышы мүмкүн. Ошондуктан ANALYZE TABLE файл өткөрүп кетүү механизми жаңы ачкычты пайдалана алышы үчүн системалык циклдин милдеттүү бөлүгү катары каралат.
AJLO кайсы суроо түрлөрүндө натыйжалуу болууну көздөйт?
Система эки чоң таблица Sort-Merge Join менен бириктирилген суроолорго басым жасайт. Бул суроолордо эки таблицадан окулган саптар алмашуу этабына кирерден мурун физикалык файлдардан скандалат. Ылайыктуу ачкыч боюнча кластерлөө азыраак файл окууга мүмкүндүк берет.
AJLO Sparkтын ClusteredDistribution талабын аткарбагандыктан shuffle операциясын жойбойт. Catalyst дагы эле Exchange түйүнүн кошот. Жакшыртуу — Exchangeге кирген маалымат көлөмүнүн азайышы.
Adaptive Query Execution алмашуу этаптарынан кийин реалдуу статистикага жараша аткаруу планын өзгөртө алат. Бирок AQE ишке кирген учурда булак файлдар мурунтан эле окулган болот. Ошондуктан AJLO менен AQE бир эле чыгымды бутага албайт:
- AJLO сактоодон булак окуу чыгымын азайтууну көздөйт.
- AQE аткаруу учурунда планды жана алмашуу этаптарын ыңгайлаштырууну көздөйт.
Эгер суроо аткаруу учурунда Broadcast Hash Joinга айланса, кичине тарап толугу менен таратылат жана жалпы кластерлөө ошол эле файл скан пайдасын бербеши мүмкүн. Ошондуктан изилдөө оптималдаштыруу чөйрөсүн Sort-Merge Join аймагында калган байланыштар менен чектеген.
Иш жүгү сүрүлүшү кантип аныкталат?
Катар келген эки убакыт терезесиндеги бириктирүү графтарынын өзгөрүүсү кырлардын JIS маанилеринин нормалдаштырылган айырмаларынын орточосу менен өлчөнөт:
\[ \operatorname{Drift}(G_k,G_{k+1})= \frac{1}{|E_k\cup E_{k+1}|} \sum_{(i,j)\in E_k\cup E_{k+1}} \frac{ |JIS_k(i,j)-JIS_{k+1}(i,j)| }{ \max(JIS_k(i,j),JIS_{k+1}(i,j),\varepsilon) } \]
Демейки босого \(\delta=0{,}10\). Босого ашылса план кайра бааланат. Жаңы мезгилде биринчи жолу пайда болгон бириктирүү байланыштарына түздөн-түз жогорку кайра баалоо артыкчылыгы берилет.
Эксперимент чөйрөсү кантип даярдалган?
Бардык эксперименттер Apple M1 процессору жана 8 GB бириктирилген эс тутуму бар бир ноутбукта жүргүзүлгөн. Негизги конфигурация төмөнкүдөй:
- Apache Spark 4.0.0, жергиликтүү
local[8]иштөө режими - Delta Lake 3.2.0
- PySpark 4.0.0
- 6 GB драйвер эс тутуму
- 50 shuffle бөлүгү
- Adaptive Query Execution активдүү
- Broadcast босогосу 10 MB
- Максаттуу Delta файл көлөмү 2 MB
TPC-H Масштаб Фактору 1 маалыматтары атайын Python генератору менен даярдалган. Orders, lineitem, customer, supplier, part, partsupp, nation жана region болуп сегиз таблица колдонулган. Ар бир конфигурация беш жолу иштетилип, медиана маанилери билдирилген.
Максаттуу файл көлөмүнүн 2 MB тандалышы эксперименттик дизайндагы маанилүү детал. Демейки 128 MB колдонулганда Масштаб Фактору 1 таблицаларында болгону бир же эки файл пайда болуп, файл өткөрүп кетүү көрсөткүчүн маанилүү өлчөө мүмкүн болбой калат. Эки мегабайттык файлдар көбүрөөк файл жаратып, ачкыч тандоонун таасирин көрүнүктүү кылган. Бирок бул тандоо эксперимент чөйрөсүн өндүрүш системаларындагы типтүү файл көлөмдөрүнөн алыстатат.
Кайсы негизги түзүлүштөр салыштырылган?
| Түзүлүш | Түшүндүрмө |
|---|---|
| B0 | Эч кандай физикалык жайгашуу оптималдаштыруусу колдонулбаган чийки Delta Lake таблицалары |
| B2 | Ар таблица үчүн дата сыяктуу көп фильтрленген мамычаларда бир жолу орнотулган жана өзгөртүлбөгөн статикалык Liquid Clustering |
| AJLO | Суроо тарыхындагы үстөм бириктирүү байланыштарына жараша таблицалар арасында координацияланган ачкыч тандоо |
Hive түрүндөгү каталог бөлүү салыштыруудан чыгарылган. Изилдөөнүн максаты Liquid Clustering менен салттуу Hive бөлүүнү кайра салыштыруу эмес, ошол эле Liquid Clustering инфраструктурасында тандалган мамычанын таасирин өлчөө.
Скандалган маалымат көлөмүндө эмне табылган?
2-сүрөттө бардык суроолор боюнча эсептелген орточо скан көлөмдөрү төмөнкүдөй:
| Физикалык түзүлүш | Бир суроого орточо скандалган маалымат |
|---|---|
| B0 – оптималдаштыруу жок | 51 MB |
| B2 – фильтр мамычаларында статикалык кластерлөө | 117 MB |
| AJLO – бириктирүүгө сезгич кластерлөө | 46 MB |
B2нин иреттелбеген B0дон көбүрөөк маалымат скандашы көңүл бурууга арзыйт. orders таблицасын o_orderdate, lineitem таблицасын болсо l_shipdate боюнча кластерлөө дата шарттарына жардам берет; бирок orderkey диапазонун колдонгон бириктирүү суроолорунда ачкыч маанилери дата файлдарына тарагандыктан дээрлик бардык файлдар ылайыктуу көрүнөт. Статикалык түзүлүш баштапкы маалыматтагы табигый жергиликтүүлүктү да бузуп, айрым суроолордо сканды көбөйткөн.
AJLOнун JIS рейтингинде lineitem ↔ orders байланышы 1,000 упай менен биринчи, customer ↔ orders байланышы 0,404 упай менен экинчи орунда. Система ушул үстөм байланыштарды жалпы ачкычтарда кластерлеген.
Yüzde 86,7 азайыш бардык суроолордун орточосу эмес. Бул маани бириктирүү басымдуу Q01–Q07 суроолорунда AJLOнун B2ге салыштырмалуу скандаган байттарынын азайышын билдирет. Дата фильтрин гана колдонгон Q08–Q10 суроолорунда болсо B2 артыкчылыктуу. AJLO бул кирүү үлгүлөрүн атайын оптималдаштырган эмес.
Суроо кечигүүсү кантип өзгөргөн?
5-сүрөттөгү кеңири жыйынтыктарга ылайык:
| Түзүлүш | Орточо суроо кечигүүсү |
|---|---|
| B0 | 1,2 секунд |
| B2 | 1,0 секунд |
| AJLO | 0,6 секунд |
AJLO статикалык фильтр мамыча кластерлөөсүнө салыштырмалуу орточо кечигүүнү yüzde 40 азайткан. Автор бул пайданы башка суроо аткаруу алгоритмине эмес, маалымат алмашууга чейин азыраак файл жана сап окулушуна байланыштырат.
Изилдөөнүн кириш бөлүгүндөгү бир сүйлөмдө 0,5 жана 0,6 секунд деген ар башка маанилер бар. Бирок кыскача мазмун, жыйынтык тексти жана 5-сүрөт ырааттуу түрдө AJLO үчүн 0,6, B2 үчүн 1,0 секунд көрсөткөндүктөн ушул маанилер негиз катары алынууга тийиш.
Файл өткөрүп кетүү көрсөткүчүндө эмне табылган?
RQ2 алкагында берилген орточо файл өткөрүп кетүү көрсөткүчтөрү төмөнкүдөй:
| Түзүлүш | Орточо файл өткөрүп кетүү көрсөткүчү |
|---|---|
| B0 | %14,9 |
| B2 | %14,5 |
| AJLO | %54,4 |
Статикалык дата мамыча кластерлөөсүнүн yüzde 14,5 менен иреттелбеген таблицанын yüzde 14,9 маанисине жакын калышы бириктирүү басымдуу суроолор үчүн туура эмес ачкыч тандоо файл өткөрүп кетүүгө дээрлик салым кошпогонун көрсөтөт.
AJLO пландоо моделинде жалпы Liquid Clustering үчүн yüzde 30 скан азайтуу коэффициенти колдонулган. Экспериментте Q01–Q07 суроолорунун өлчөнгөн файл өткөрүп кетүү көрсөткүчтөрү yüzde 76–79 аралыгында чыккан. Модель бул кичине маалымат түзүлүшүндө болжол менен 2,5 эсе консервативдүү болгон. Ушул эле айырма чоң файл жана маалымат масштабында сакталып калары белгисиз.
Иш жүгү сүрүлүшү эксперименти эмнени көрсөткөн?
Үч башка иш жүгү режиминде суроо шаблондорунун жыштыктары өзгөртүлгөн, бирок колдонулган бириктирүү мамычалары өзгөртүлгөн эмес. W3 терезесиндеги сүрүлүш упайы 0,249, W4тө 0,107 болуп эсептелип, экөө тең 0,10 босогосун ашкан. Система бул чекиттерде кайра баалоону туура иштеткен.
W5те 0,069 жана W6да 0,091 маанилери босогодон төмөн болуп, кайра оптималдаштыруу башталган эмес. Бирок бардык терезелерде чыныгы кайра жазуу чыгымы нөлгө барабар. Себеби өзгөргөн нерсе бириктирүү мамычалары эмес, учурдагы байланыштардын жыштыктары. Кайра баалоо учурдагы физикалык түзүлүш дагы эле жетиштүү деп чечкен.
Демек эксперимент сүрүлүш аныктоочунун босого жүрүм-турумун көрсөтөт; жаңы бириктирүү мамычасы пайда болгондо таблицанын чындап кайра кластерленишин жана анын чыгымын баалабайт. Автор муну келечектеги иштер үчүн негизги жетишпестиктердин бири катары кабыл алат.
Ач көз пландоочу оптималдуу чечимге канчалык жакындаган?
Бештен сегизге чейин таблица, алтыдан он экиге чейин кыр жана жалпы кайра жазуу чыгымынын yüzde 20–50 бөлүгүнө барабар бюджет камтыган тогуз синтетикалык граф конфигурациясы түзүлгөн. Ач көз чечимдин так brute-force оптимумуна катышы эсептелген.
- Тогуз конфигурациянын алтоосунда ач көз чечим оптимум менен бирдей натыйжа берген.
- Тогуз конфигурациянын сегизи \(1-1/e\approx0{,}632\) чегине жеткен же андан ашкан.
- Бардык конфигурациялардын орточо жакындашуу катышы 0,913.
- C6 конфигурациясы 0,570 катышында калган.
C6да катуу бюджет алгоритмдин эрте этапта жергиликтүү түрдө жагымдуу кырды тандоосуна жана кийинчерээк жогорку жалпы пайда бере турган айкалышка жете албай калышына себеп болгон. Бул натыйжа теориялык \(1-1/e\) чеги субмодулдуулук жана азайган маржиналдык кайтарым шарттары аткарылганда гана жарактуу экенин эске салат. Изилдөөнүн толук жайгашуу маселесинде бул шарттар ар конфигурацияда кепилденген эмес.
Изилдөөнүн күчтүү жактары кайсылар?
- Ачык булактуу lakehouse стекке мүнөздүү жана так аныкталган физикалык дизайн маселеси каралган.
- Таблицалар өз алдынча эмес, бириктирүү графы аркылуу координацияланган түрдө бааланган.
- Математикалык максат функциясы, бюджет чектөөлөрү жана алгоритмдер ачык берилген.
- Файл скан көлөмү, суроо кечигүүсү, файл өткөрүп кетүү көрсөткүчү, сүрүлүш аныктоо жана жакындашуу сапаты өзүнчө эксперименттер менен изилденген.
- Система Spark shuffle операциясын жойбой турганы ачык айтылган.
- Эксперимент конфигурациялары, код, маалымат генератору жана жыйынтык скрипттери үчүн кайра өндүрүү маалыматы берилген.
- Терс жыйынтык болгон C6 ийгиликсиздиги жана өндүрүш масштабы боюнча белгисиздик жашырылган эмес.
Изилдөөнүн негизги чектөөлөрү кайсылар?
- Эксперименттер бир Apple M1 ноутбукта жана жергиликтүү Spark режиминде жүргүзүлгөн.
- TPC-H Масштаб Фактору 1 болжол менен 1 GB жана маалымат эс тутумга батат.
- Өндүрүш чөйрөсүндөгү тармак, бөлүштүрүлгөн сактоо, аткаруучулар аралык маалымат өткөрүү жана түйүн бузулуулары изилденген эмес.
- Эки мегабайттык максаттуу файл көлөмү файл өткөрүп кетүү таасирин көрсөтүү үчүн эксперименттик түрдө кичирейтилген.
- Атайын Python TPC-H генератору расмий
dbgenбөлүштүрүлүшүнөн майда айырмачылыктарды камтышы мүмкүн. - Yüzde 86,7 скан азайышы бириктирүү басымдуу жети суроо жана B2 салыштыруусу үчүн гана жарактуу.
- Фильтр басымдуу суроолордо статикалык дата кластерлөөсү AJLOдон жакшыраак натыйжа бере алган.
- Сүрүлүш экспериментинде жаңы бириктирүү мамычалары болбогондуктан чыныгы физикалык кайра кластерлөө болгон эмес.
- OPTIMIZE операцияларынын терабайт же петабайт масштабындагы реалдуу чыгымы өлчөнгөн эмес.
- Сактоо жана кайра жазуу чыгымдарынын байт негизиндеги баалары өндүрүш эсептери же операциялык үзгүлтүк коркунучу менен текшерилген эмес.
- Greedy пландоочу бир конфигурацияда теориялык чектен төмөн калган.
- Изилдөө рецензиядан өтө элек.
Изилдөө кайсы жыйынтыктарды колдойт?
- Ошол эле кичине TPC-H чөйрөсүндө Liquid Clustering ачкычын тандоо файл өткөрүп кетүүгө жана скандалган маалыматка чоң таасир берген.
- Бириктирүү ачкычы боюнча координацияланган кластерлөө Q01–Q07 суроолорунда дата мамычасы боюнча статикалык кластерлөөгө караганда азыраак маалымат скандаган.
- Туура эмес мамыча боюнча кластерленген физикалык түзүлүш айрым иш жүктөрүндө иреттелбеген таблицадан да жаман натыйжа бере алган.
- Көбөйтүүчү JIS изилдөөдөгү мисалдарда жыштыгы жогору, бирок чыгымы төмөн байланыштарды артка жылдыра алган.
- Сүрүлүш критерийи сыналган суроо жыштыгы өтүүлөрүндө босого ашуусун аныктай алган.
- Ач көз пландоочу тогуз кичине синтетикалык графта орточо 0,913 оптимум катышын берген.
Изилдөө кайсы жыйынтыктарды далилдебейт?
- AJLO бардык ачык булактуу Delta Lake орнотууларында ылдамыраак болорун далилдебейт.
- Yüzde 86,7 скан азайышы терабайт же петабайт масштабында сакталат деп көрсөтпөйт.
- AJLO shuffle операциясын же Sort-Merge Join алмашуусун жойгонун көрсөтпөйт.
- Broadcast Hash Join колдонгон суроолор ошол эле деңгээлде пайда көрөрүн көрсөтпөйт.
- Фильтр басымдуу жана бириктирүү басымдуу суроолорду бир убакта эң жакшы оптималдаштырарын көрсөтпөйт.
- Иш жүгүнө жаңы бириктирүү мамычалары кошулганда кайра кластерлөө ийгиликтүү жана төмөн чыгым менен бүтөрүн көрсөтпөйт.
- Ач көз пландоочу бардык граф жана бюджет шарттарында \(1-1/e\) чегин камсыздайт деп далилдебейт.
- Өндүрүш системасында алынуучу акчалай үнөмдү же кызмат деңгээлинин жакшыртылышын өлчөбөйт.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Ыкманын кыскача мазмуну
| Ыкма компоненти | Изилдөөдө колдонулган ыкма |
|---|---|
| Изилдөө түрү | Алгоритмдик система дизайны, кичине масштабдагы TPC-H эксперименти жана синтетикалык граф баалоосу |
| Система аты | AJLO – Adaptive Join-aware Layout Optimizer |
| Максаттуу платформа | Ачык булактуу Apache Spark жана Delta Lake |
| Негизги маалымат түзүлүшү | Суроо тарыхынан түзүлгөн салмакталган таблица бириктирүү графы |
| Маанилүүлүк упайы | Нормалдаштырылган суроо жыштыгы × лог масштабдагы маалымат көлөмү × аткаруу чыгымы |
| Оптималдаштыруу максаты | Кайра жазуу жана сактоо бюджети астында күтүлгөн скан азайышынын таза учурдагы наркын жогорулатуу |
| Пландоочу | Ар чечимден кийин артыкчылыктары жаңыланган динамикалык ач көз алгоритм |
| Ыңгайлашуу | JIS бөлүштүрүлүшүндөгү өзгөрүү үчүн сүрүлүш критерийи; демейки босого 0,10 |
| Эксперимент маалыматы | TPC-H Масштаб Фактору 1; сегиз таблица; атайын Python маалымат генератору |
| Эксперимент суроолору | Он суроо; беш кайталоо; медиана жыйынтыктары |
| Аппараттык камсыздоо | Apple M1 ноутбук, 8 GB бириктирилген эс тутум |
| Программалык камсыздоо | Spark 4.0.0, Delta Lake 3.2.0, PySpark 4.0.0 |
Негизги өндүрүмдүүлүк жыйынтыктары
| Көрсөткүч | B0 | B2 | AJLO |
|---|---|---|---|
| Орточо скандалган маалымат | 51 MB | 117 MB | 46 MB |
| Орточо суроо кечигүүсү | 1,2 секунд | 1,0 секунд | 0,6 секунд |
| Орточо файл өткөрүп кетүү көрсөткүчү | %14,9 | %14,5 | %54,4 |
Суроо түрүнө жараша жыйынтыктарды бөлүү
| Суроо тобу | Артыкчылыктуу түзүлүш | Изилдөөдөгү байкоо |
|---|---|---|
| Q01–Q07, бириктирүү басымдуу | AJLO | B2ге салыштырмалуу скандалган байттарда %86,7 азайыш; файл өткөрүп кетүү болжол менен %76–79 |
| Q08–Q10, фильтр басымдуу | B2 | Дата мамычасы суроо шартына түз туура келгендиктен статикалык фильтр кластерлөөсү азыраак маалымат скандай алган |
Сүрүлүш аныктоо жыйынтыктары
| Терезе | Сүрүлүш упайы | Босого абалы | Физикалык кайра жазуу |
|---|---|---|---|
| W3 | 0,249 | 0,10 чегинен жогору; кайра баалоо | Жок |
| W4 | 0,107 | 0,10 чегинен жогору; кайра баалоо | Жок |
| W5 | 0,069 | Босогодон төмөн | Жок |
| W6 | 0,091 | Босогодон төмөн | Жок |
Ач көз пландоочу жыйынтыктары
| Өлчөм | Натыйжа |
|---|---|
| Синтетикалык конфигурациялардын саны | 9 |
| Оптимум менен толук дал келген конфигурация | 6 |
| 0,632 теориялык чегине жеткен же ашкан | 8 |
| Орточо жакындашуу катышы | 0,913 |
| Эң төмөн катыш | C6 конфигурациясында 0,570 |
Сүрөттөрдүн негизги билдирүүлөрү
- 1-сүрөт: Суроо журналынан башталып, пландоо, колдонуу, статистиканы жаңылоо жана сүрүлүш аныктоо циклына чейин жеткен алты компоненттүү AJLO архитектурасын көрсөтөт.
- 2-сүрөт: Статикалык фильтр мамыча кластерлөөсү орточо 117 MB менен B0 жана AJLOдон көбүрөөк маалымат скандаганын көрсөтөт.
- 3-сүрөт:
lineitem–ordersбайланышы 1,000 JIS менен иш жүгүнө үстөм экенин көрсөтөт. - 4-сүрөт: Бириктирүү басымдуу суроолор AJLO тарапта, фильтр басымдуу суроолор B2 тарапта артыкчылык алганын ажыратат.
- 5-сүрөт: Кеңири кечигүү маанилерин B0 үчүн 1,2, B2 үчүн 1,0 жана AJLO үчүн 0,6 секунд деп көрсөтөт.
- 6-сүрөт: AJLOнун yüzde 54,4 файл өткөрүп кетүү көрсөткүчүн B0 жана B2нин болжол менен yüzde 14–15 маанилери менен салыштырат.
- 7-сүрөт: Yüzde 30 пландоо баасы Q01–Q07де өлчөнгөн yüzde 76–79 көрсөткүчтөрүнө салыштырмалуу консервативдүү экенин көрсөтөт.
- 8-сүрөт: W3 жана W4 терезелеринде сүрүлүш босогосу ашылганын көрсөтөт.
- 9-сүрөт: Кайра баалоолорго карабастан сыналган режимдерде физикалык кайра жазуу чыгымы нөл бойдон калганын көрсөтөт.
- 10-сүрөт: Тогуз конфигурациянын ичинен C6 гана 0,632 чегинен төмөн калганын көрсөтөт.
- 11-сүрөт: Ач көз жана так оптималдуу таза учурдагы нарктарды салыштырып, эң чоң абсолюттук айырманы C6да көрсөтөт.
Булак жана Ыкма Жөнүндө Эскертүү
Изилдөөнүн толук оригинал аталышы: Adaptive Join-Aware Physical Layout Optimization for Lakehouse Systems
Автор: Nishank Mahore.
Авторлордун ирети: Изилдөө бир авторлуу.
Тең салым маалыматы: Башка автор же тең салым билдирүүсү жок.
Жооптуу автор: Nishank Mahore.
Байланыш дареги: nishankmahore@gmail.com
Мекемелик байланыш: Independent Researcher, Pune, India. Изилдөөдө университет, изилдөө борбору же компания боюнча мекемелик байланыш берилген эмес.
Жарыялоо платформасы: SSRN.
Расмий булак шилтемеси:SSRN изилдөө каттоосу
Жарыяланган жылы: 2026.
Журнал: Рецензияланган журнал аты же кабыл алуу маалыматы жок.
Басмакана: Акыркы рецензияланган жарыя үчүн басмакана маалыматы жок.
Булактын түрү: Алгоритмдик система дизайны жана эксперименттик компьютер системаларын баалоо; preprint.
Рецензия абалы: Изилдөө рецензиядан өтө элек.
Колдонмо жана эксперимент коддору:AJLO GitHub репозиторийи
Маалыматка жетүү: Чийки TPC-H маалыматтары өзүнчө сакталган эмес. Изилдөөдө маалыматтар tpch_generator.py аттуу атайын генератор менен детерминисттик түрдө кайра түзүлөрү айтылат.
Автордун салымы: Nishank Mahore концептуалдаштыруу, ыкма, программалык камсыздоо, текшерүү, формалдык анализ, изилдөө, маалыматтарды иреттөө, визуалдаштыруу, алгачкы долбоор, кароо жана редакциялоо ролдорунун баарын аткарган.
Каржылоо: Изилдөө үчүн мамлекеттик, коммерциялык же коммерциялык эмес уюмдан атайын каржылоо алынбаганы билдирилген.
Кызыкчылыктардын кагылышы: Автор каржылык же жеке кызыкчылык кагылышын билдирген эмес.
Генеративдик жасалма интеллект билдирүүсү: Генеративдик жасалма интеллект куралдары автордун оригинал текстин редакциялоо, кыскартуу жана түшүнүктүүрөөк кылуу үчүн гана колдонулганы; изилдөө дизайны, ишке ашыруу, эксперименттик маалыматтар жана техникалык жыйынтыктар жасалма интеллект тарабынан түзүлбөгөнү айтылган.
Бул кыргызча түшүндүрмө жүктөлгөн изилдөөнүн тексти, математикалык туюнтмалары, алгоритмдери, таблицалары, эксперимент жыйынтыктары жана 1–11-сүрөттөрдөгү визуалдык табылгалардын негизинде даярдалды. Тышкы булактар илимий жыйынтык кошуу үчүн колдонулган жок; изилдөөнүн библиографиялык идентификациясын жана расмий каттоолорун текшерүү үчүн гана пайдаланылды.
Изилдөөдөгү 0,6 секунд кечигүү, yüzde 54,4 файл өткөрүп кетүү жана yüzde 86,7 скан азайышы болжол менен 1 GB көлөмүндөгү TPC-H Масштаб Фактору 1 маалыматына, эки мегабайттык эксперименттик максаттуу файл көлөмүнө жана бир компьютерлик жергиликтүү Spark чөйрөсүнө тиешелүү. Бул маанилер өндүрүш масштабы үчүн өндүрүмдүүлүк кепилдиги катары чечмеленбеши керек.
Автордун “мурда жарыяланган эч бир система ачык булактуу Delta Lake үчүн бириктирүүгө сезгич Liquid Clustering ачкыч тандоону автоматташтырган эмес” деген жаңылык дооматы изилдөөнүн өз адабият кароосуна негизделет. Бул макалада көз карандысыз жана толук приоритеттик изилдөө жүргүзүлгөн эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген