

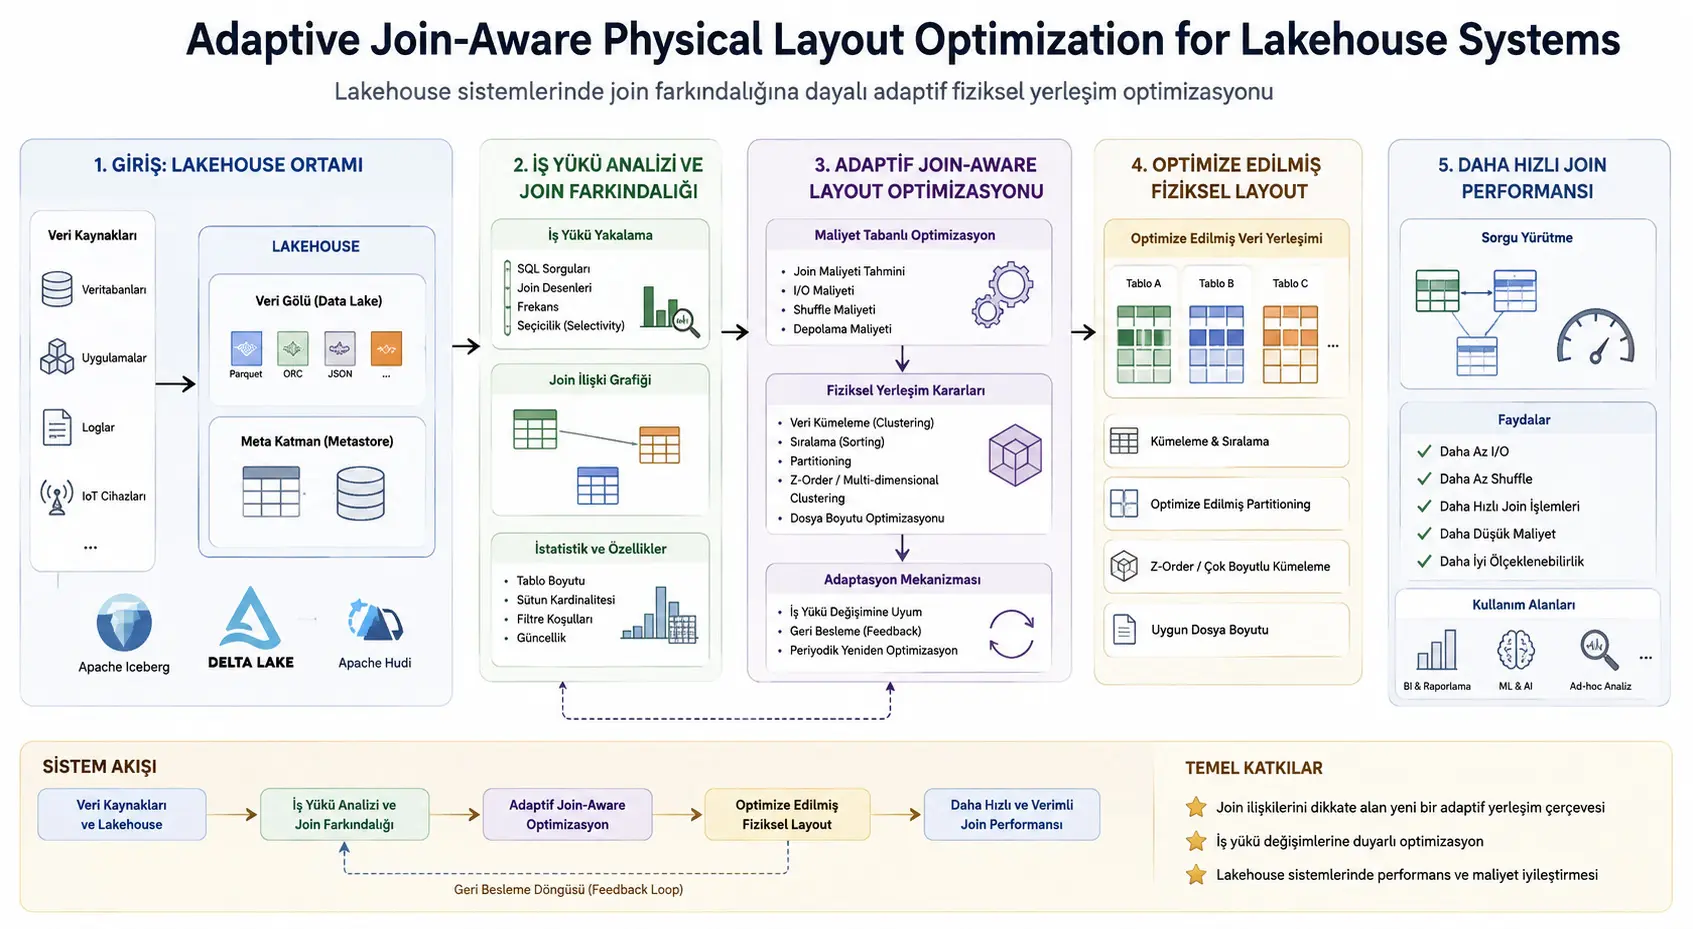
Ин таҳқиқот системаи AJLO-ро пешниҳод мекунад, ки дар Delta Lake-и кушодаасос аз таърихи дархостҳо ба таври худкор интихоб мекунад, ки ҷадвалҳо бояд аз рӯи кадом сутунҳо ҷисман кластер карда шаванд. AJLO дархостҳои иҷрошударо дар як фосилаи муайяни вақт таҳлил карда, аз муносибатҳои join байни ҷадвалҳо графи вазндор месозад; ҳар муносибатро бо Join Importance Score, ки басомади дархост, ҳаҷми маълумот ва арзиши иҷроишро якҷоя арзёбӣ мекунад, дараҷабандӣ менамояд. Сипас, дар доираи буҷети маҳдуди бознависӣ, барои ҷадвалҳое, ки зуд-зуд якҷоя истифода мешаванд, калидҳои мувофиқи Liquid Clustering интихоб мекунад.
Дар озмоишҳое, ки дар TPC-H Scale Factor 1 анҷом дода шуданд, AJLO миқдори миёнаи маълумоти сканшуда барои ҳар дархостро дар ҳамаи дархостҳо то 46 MB коҳиш дод. Дар тарҳбандии Delta Lake, ки ягон оптимизатсия нагирифта буд, ин қимат 51 MB ва дар тарҳбандии статикӣ кластеркардашуда аз рӯи сутунҳои филтрии махсуси ҷадвал, мисли сана, 117 MB гузориш шудааст. Дар дархостҳои Q01–Q07, ки ба join такяи бештар доранд, AJLO нисбат ба кластеркунии статикӣ аз рӯи сутуни филтр ҳаҷми байтҳои сканшударо %86,7 коҳиш додааст. Таъхири миёнаи дархост дар AJLO 0,6 сония, дар кластеркунии статикӣ 1,0 сония ва дар сохтори ибтидоии тартибнадодашуда 1,2 сония буд.
Бартарии асосии AJLO дар он аст, ки ба ҷои тартиб додани ҳар ҷадвал мустақилона, ҷадвалҳоеро, ки як калиди join-ро истифода мебаранд, якҷоя арзёбӣ мекунад. Аммо система амалиёти мубодилаи Spark ё shuffle-ро аз байн намебарад. Фоида аз он ба даст меояд, ки пеш аз оғози join бо истифода аз омори min–max-и файлҳо файлҳои бештар гузаронида мешаванд ва ба марҳилаи мубодила маълумоти камтар мерасад. Равиш махсусан ба дархостҳое нигаронда шудааст, ки ду ҷадвали калон бо Sort-Merge Join якҷоя мешаванд; дар Broadcast Hash Join, ки ҷадвали хурд пурра паҳн мешавад, чунин фоидаи тарҳбандӣ интизор намешавад.
Аз нигоҳи Туркия: Равиши AJLO метавонад барои арзёбии худкори тарҳбандии ҷисмонии ҷадвалҳо дар платформаҳои бонкӣ, телекоммуникатсионӣ, тиҷорати электронӣ, логистика, таҳлили давлатӣ ва маълумоти калони Туркия, ки Apache Spark ва Delta Lake-и кушодаасосро истифода мебаранд, мавриди таҳқиқ қарор гирад. Аммо таҳқиқот маълумоти TPC-H-и тақрибан 1 GB-ро дар як ноутбук санҷидааст. Пеш аз татбиқ дар муҳити истеҳсолии Туркия бояд он дар кластерҳои тақсимшудаи терабайт ё петабайт, бо таърихи воқеии дархостҳои муассиса, хароҷоти бознависӣ ва равандҳои ҳамзамони боркунии маълумот тасдиқ карда шавад. Аз таҳқиқот наметавон мустақиман хулоса кард, ки як муассисаи муайяни Туркия %86,7 камтар маълумот скан мекунад ё дархостҳояш %40 тезтар мешаванд.
Мушкилоти тарҳбандии ҷисмонӣ дар системаҳои Lakehouse чист?
Меъмории Lakehouse мекӯшад сохтори арзон ва кушодаи файлҳои data lake-ро бо эътимоднокии транзаксионӣ ва имкониятҳои дархости data warehouse муттаҳид кунад. Delta Lake дар ин сохтор одатан файлҳои Parquet-ро истифода бурда, барои ҳар файл оморҳое ба мисли қиматҳои ҳадди ақал ва ҳадди аксари сутунҳоро нигоҳ медорад. Агар шарти дархост бо диапазони қиматҳои як файл ҳампӯшӣ надошта бошад, Spark метавонад он файлро бе хондан гузарад. Ин механизм file skipping, яъне гузаронидани файл ном дорад.
Liquid Clustering кӯшиш мекунад сатрҳои дорои қиматҳои монанди калидро бо истифода аз locality-и Hilbert curve дар файлҳои наздик ҷамъ кунад. Масалан, агар ҷадвали фармоишҳо аз рӯи санаи фармоиш кластер шавад, дархостҳое, ки диапазони муайяни санаро мехоҳанд, метавонанд бисёр файлҳоро гузаронанд. Аммо агар ҳамон ҷадвал аз рӯи рақами фармоиш филтр шуда, бо ҷадвали дигар аз рӯи рақами фармоиш join шавад, тартиби сана фоида надорад; диапазони як калиди фармоиш метавонад қариб ба ҳамаи файлҳои сана паҳн шуда бошад.
Аз ин рӯ, равиши “сутуни аз ҳама бештар филтршавандаро интихоб кун” метавонад дар workload-ҳои аналитикии join-heavy тарҳбандии нодурусти ҷисмонӣ ба вуҷуд орад. Илова бар ин, сутуни дуруст метавонад бо вақт тағйир ёбад. Имрӯз дархостҳои санаи фармоиш бартарӣ дошта бошанд, дар давраи дигар join-ҳои order–lineitem ё customer–orders метавонанд бартарӣ гиранд.
Дар тарҳи Delta Lake-и кушодаасос, ки таҳқиқот арзёбӣ кардааст, механизме вуҷуд надорад, ки мувофиқи намунаҳои тағйирёбандаи дархост калидҳои Liquid Clustering-ро ба таври худкор ва ҳамоҳанг байни ҷадвалҳо интихоб кунад. AJLO мехоҳад ин холигиро бо графи join, ки аз таърихи дархостҳо омӯхта шудааст, пур кунад.
Чаро кластеркунии муштарак аз рӯи калиди join муҳим аст?
Агар дархост ҷадвалҳои orders ва lineitem-ро бо orderkey join карда, дар ҳамон калид шарти интихобии диапазон истифода барад, кластер кардани ҳар ду ҷадвал аз рӯи ҳамин калид метавонад дар ҳар ду тараф file skipping-ро имконпазир кунад. Танҳо як ҷадвал ё ҳар ду ҷадвалро аз рӯи сутунҳои санаи номуносиб кластер кардан ҳамин фоидаро намедиҳад.
Таҳқиқот барои он ки як муносибатро “аз нигоҳи скан ҳамоҳангшуда” шуморад, талаб мекунад, ки тарҳбандии ҷисмонии ҳар ду ҷадвал ҳамон сутуни join-ро дастгирӣ кунад. Тарҳбандии ҳар ҷадвал бо вектори стратегии зерин нишон дода мешавад:
\[ \lambda(t)=\langle P_t,C_t\rangle \]
- \(P_t\), сутуни partition-и каталогӣ ё қимати холӣ аст.
- \(C_t\), маҷмӯи сутунҳои Liquid Clustering ё қимати холӣ аст.
Дар Delta Lake PARTITIONED BY ва CLUSTER BY ду шакли мустақили тарҳбандӣ нестанд, ки дар як ҷадвал ҳамзамон истифода шаванд. Аз ин рӯ, planner бояд арзиши тағйир додани тарҳбандии мавҷударо низ ба ҳисоб гирад.
Меъмории AJLO аз кадом ҷузъҳо иборат аст?
Расми 1 дар саҳифаи 6-и таҳқиқот системаро бо шаш ҷузъи асосӣ нишон медиҳад, ки дар як ҳалқаи пайвастаи feedback кор мекунанд:
- Query Log Collector – QLC: Бо SparkListener матни SQL, нақшаи мантиқӣ, омори иҷро ва timestamp-и дархостҳои анҷомёфтаро ҷамъ мекунад. Равзанаи ҳаракаткунандаи пешфарз ҳафт рӯз аст.
- Join Graph Builder – JGB: Ба ҷои парс кардани матни SQL, муносибатҳои join-и баробариро аз resolved logical plan-и Spark хориҷ мекунад.
- Relationship Importance Estimator – RIE: Барои ҳар канори join басомад, ҳаҷми маълумот ва ченакҳои хароҷотро normalise карда, Join Importance Score-ро ҳисоб мекунад.
- Multi-Table Layout Planner – MTLP: Номзадҳои кластеркунии муштарак ё partition-ро, ки дар доираи буҷет баландтарин фоидаи софи интизориро медиҳанд, интихоб мекунад.
- Adaptive Reorganization Engine – ARE: Нақшаи интихобшударо ба фармонҳои Delta Lake DDL ва амалиёти
OPTIMIZEтабдил медиҳад. - Cost-Based Optimization Layer – CBOL: Пас аз бозтартибдиҳӣ
ANALYZE TABLE-ро иҷро карда омори файлҳоро нав мекунад ва натиҷаҳоро ба ҳалқаи feedback мегардонад.
Илова бар ин ҷузъҳо, Workload Drift Detector ҳангоми тағйири кофии аҳамияти нисбии муносибатҳои join planner-ро дубора иҷро мекунад. Агар drift аз threshold паст бошад, нақшаи мавҷуда нигоҳ дошта мешавад.
Графи join чӣ гуна сохта мешавад?
Ҳар ҷадвал ҳамчун node ва муносибати join байни ду ҷадвал ҳамчун edge нишон дода мешавад. Барои ҳар edge се қимати асосӣ ҳисоб мешавад:
- F(i,j): Шумораи дархостҳое, ки дар равзанаи ҳаракаткунандаи вақт ин join-ро дар бар мегиранд.
- D(i,j): Миёнаи ҳосили зарби шумораи сатрҳои ду ҷадвал дар дархостҳои дахлдор.
- C(i,j): Арзиши миёнаи иҷрои дархостҳое, ки ин join-ро доранд.
Баровардани lineage-и сутун аз query plan танҳо ҷустуҷӯи номҳо дар SQL нест. Дар resolved plan-и Spark сутунҳо метавонанд бештар бо identifier-ҳои exprId нишон дода шаванд, на бо номҳое мисли customer_id. Барои пайваст кардани ин identifier-ҳо ба ҷадвал ва сутуни аслӣ, lineage тавассути node-ҳои Project, Alias, Filter ва Subquery пайгирӣ мешавад.
Join Importance Score чӣ гуна ҳисоб мешавад?
AJLO басомади нормалшуда, ҳаҷми маълумот ва арзиши иҷроишро зарб мекунад:
\[ JIS(i,j)=\widehat{F}(i,j)\times\widehat{D}(i,j)\times\widehat{C}(i,j) \]
Азбаски қиматҳои ҳаҷми маълумот метавонанд дар диапазони хеле васеъ бошанд, \(D\) пеш аз нормалсозӣ логарифмӣ масштаб карда мешавад:
\[ \widehat{D}(i,j)= \frac{\log_{10}(D(i,j)+1)-\log_{10}(D_{\min}+1)} {\log_{10}(D_{\max}+1)-\log_{10}(D_{\min}+1)+\varepsilon} \]
Барои басомад ва арзиш нормалсозии стандартии min–max истифода мешавад:
\[ \widehat{X}(i,j)= \frac{X(i,j)-X_{\min}} {X_{\max}-X_{\min}+\varepsilon}, \qquad X\in\{F,C\} \]
Сохтори зарбӣ таъмин мекунад, ки агар яке аз се андоза ба сифр наздик шавад, score-и умумӣ низ ба сифр наздик шавад. Ҳамин тавр, join-и dimension table-и хурд ва арзон, ки хеле зуд иҷро мешавад, танҳо ба сабаби басомади баланд қисми калони буҷети бознависиро намегирад.
Дар мисоли муқоисавии таҳқиқот муносибате, ки басомадаш баланд, вале ҷадвалҳояш хурд ва зуд буд, score-и зарбии 0,002 гирифт, дар ҳоле ки муносибати мутавозин дар ҳамаи андозаҳо 0,125 гирифт. Формулаи ҷамъӣ ба ҳамин мисолҳо мутаносибан 0,333 ва 0,500 дода, аҳамияти муносибати арзонро нисбатан аз ҳад зиёд нишон медиҳад.
JIS сарфаи мустақими байт нест. Он сигнали беандозаи prioritiization мебошад. Ҳадафи иқтисодии optimizatsiya ҷудогона бо коҳиши тахминии скан, арзиши бознависӣ ва арзиши storage ҳисоб мешавад.
Масъалаи Multi-Table Layout Coordination чӣ гуна муайян шудааст?
Таҳқиқот қарори тарҳбандии ҷисмониро ҳамчун масъалаи net present value-и маҳдуд ба буҷет, ки Multi-Table Layout Coordination ном дорад, формула мекунад:
\[ \operatorname{NPV}(L)= \sum_{(i,j)\in E} \operatorname{ScanReduction}(i,j,L) \left( \frac{1-(1+r)^{-H}}{r} \right) -\operatorname{RewriteCost}(L) -\operatorname{StorageCost}(L) \]
Маҳдудиятҳо:
\[ \operatorname{RewriteCost}(L)\leq B \]
\[ \operatorname{StorageCost}(L)\leq S \]
- \(L\), нақшаи интихобшудаи тарҳбандии ҷисмонии бисёрҷадвалӣ аст.
- \(H\), уфуқи planning аст.
- \(r\), rate-и discount барои ҳар равзана аст.
- \(B\), буҷети бознависӣ аст.
- \(S\), буҷети storage аст.
Дар таҳқиқот шартҳои cost ва benefit бо байт ифода мешаванд. Муаллиф иддао мекунад, ки масъала тавассути reduction аз Maximum Weighted Coverage NP-hard аст. Аз ин рӯ, ба ҷои exhaustive search-и ҳамаи комбинатсияҳои ҷадвал ва калид дар миқёси production, равиши greedy истифода мешавад.
Planner-и динамикии greedy чӣ гуна кор мекунад?
Planner барои ҳар edge-и join номзадеро, ки дар нақшаи ҷорӣ баландтарин NPV медиҳад, ба priority queue мегузорад. Пас аз интихоб шудани номзади баландтарин, агар арзиши бознависӣ ба буҷети боқимонда мувофиқ бошад, нақша татбиқ мешавад.
Вақте барои як ҷадвал қарор қабул мешавад, priority-и edge-ҳои дигари ба он ҷадвал вобаста дубора ҳисоб мешавад. Ин муҳим аст. Масалан, пас аз он ки ҷадвали A бо B аз рӯи order_id кластер шуд, пешниҳоди A–C барои customer_id акнун метавонад бознависии пурраи ҷадвали A-ро талаб кунад. Агар priority-и бо арзиши кӯҳна ҳисобшуда нигоҳ дошта шавад, planner метавонад як ҷадвалро пайдарпай ба калидҳои зиддиятнок кӯчонад.
Дар таҳқиқот мураккабии worst-case барои dense star schema тақрибан:
\[ O(|E|^2\cdot|C|\cdot\log|E|) \]
дода шудааст. Дар schema-ҳои одатан sparse бо degree-и пасти node бошад ба:
\[ O(|E|\cdot|C|\cdot\log|E|) \]
наздик мешавад.
Бозтартибдиҳӣ чӣ гуна татбиқ мешавад?
Ҳангоми тағйир додани калиди Liquid Clustering пайдарпаии пешниҳодшудаи амал чунин аст:
ALTER TABLE tablo CLUSTER BY (sutun);
OPTIMIZE tablo;
ANALYZE TABLE tablo;
Агар байни Liquid Clustering ва partition-и каталогӣ гузариш анҷом дода шавад, аввал clustering-и мавҷуда бояд хориҷ, баъд тарҳбандии нави ҷисмонӣ муайян ва ҷадвал дубора навишта шавад.
Таҳқиқот таъкид мекунад, ки амалиётҳои OPTIMIZE метавонанд бо ETL writer-ҳои ҳамзамон бархӯрд кунанд. Optimistic concurrency control дар Delta transaction log метавонад ConcurrentAppendException ё ConcurrentDeleteReadException диҳад. AJLO дар ин ҳолат retry бо вақти интизории афзоянда, хондани snapshot-и охирини ҷадвал ва бозарзёбии нақшаро пешниҳод мекунад.
Нав накардани омор пас аз reclustering метавонад боис шавад, ки файлҳои нав бо омори сутунҳои кӯҳна арзёбӣ шаванд. Аз ин рӯ, ANALYZE TABLE ҳамчун қисми ҳатмии ҳалқаи система баррасӣ мешавад, то механизми file skipping калиди навро истифода барад.
AJLO барои кадом навъи дархостҳо самаранок буданро ҳадаф мегирад?
Система ба дархостҳое нигаронда шудааст, ки ду ҷадвали калон бо Sort-Merge Join якҷоя мешаванд. Дар чунин дархостҳо сатрҳои аз ҳар ду ҷадвал хондашуда пеш аз ворид шудан ба марҳилаи exchange аз файлҳои ҷисмонӣ скан мешаванд. Кластеркунӣ аз рӯи калиди мувофиқ метавонад шумораи файлҳои хондашударо кам кунад.
Азбаски AJLO талаботи ClusteredDistribution-и Spark-ро қонеъ намекунад, амалиёти shuffle-ро аз байн намебарад. Catalyst ҳамоно node-и Exchange илова мекунад. Беҳбудӣ аз кам шудани ҳаҷми маълумоти воридшаванда ба Exchange меояд.
Adaptive Query Execution метавонад баъд аз марҳилаҳои exchange нақшаи иҷроишро мувофиқи омори воқеӣ тағйир диҳад. Аммо вақте AQE фаъол мешавад, файлҳои манбаъ аллакай хонда шудаанд. Аз ин рӯ, AJLO ва AQE як навъи cost-ро ҳадаф намегиранд:
- AJLO мехоҳад арзиши хондани манбаъ аз storage-ро кам кунад.
- AQE мехоҳад plan ва exchange stage-ҳоро ҳангоми execution мутобиқ созад.
Агар дархост ҳангоми execution ба Broadcast Hash Join табдил ёбад, тарафи хурд пурра broadcast мешавад ва clustering-и муштарак ҳамон фоидаи file scan-ро дода наметавонад. Бинобар ин, таҳқиқот optimization scope-ро бо муносибатҳое маҳдуд кардааст, ки дар ҳудуди Sort-Merge Join мемонанд.
Workload drift чӣ гуна муайян мешавад?
Тағйир байни графҳои join дар ду равзанаи пайдарпайи вақт бо миёнаи фарқҳои нормалшудаи қиматҳои JIS-и edge-ҳо чен карда мешавад:
\[ \operatorname{Drift}(G_k,G_{k+1})= \frac{1}{|E_k\cup E_{k+1}|} \sum_{(i,j)\in E_k\cup E_{k+1}} \frac{ |JIS_k(i,j)-JIS_{k+1}(i,j)| }{ \max(JIS_k(i,j),JIS_{k+1}(i,j),\varepsilon) } \]
Threshold-и пешфарз \(\delta=0{,}10\) аст. Агар threshold гузарад, нақша дубора арзёбӣ мешавад. Ба муносибатҳои join, ки дар давраи нав бори аввал пайдо мешаванд, priority-и баланди бозарзёбӣ дода мешавад.
Муҳити озмоиш чӣ гуна омода шудааст?
Ҳамаи озмоишҳо дар як ноутбуки Apple M1 бо 8 GB unified memory анҷом дода шудаанд. Конфигуратсияи асосӣ чунин аст:
- Apache Spark 4.0.0, режими маҳаллии
local[8] - Delta Lake 3.2.0
- PySpark 4.0.0
- 6 GB driver memory
- 50 shuffle partition
- Adaptive Query Execution фаъол
- Broadcast threshold 10 MB
- Ҳаҷми ҳадафии файли Delta 2 MB
Маълумоти TPC-H Scale Factor 1 бо generator-и махсуси Python омода шудааст. Ҳашт ҷадвал: orders, lineitem, customer, supplier, part, partsupp, nation ва region истифода шудаанд. Ҳар конфигуратсия панҷ бор иҷро шуда, қиматҳои median гузориш шудаанд.
Интихоби ҳаҷми ҳадафии файл 2 MB ҷузъиёти муҳими design-и озмоиш аст. Бо 128 MB-и пешфарз дар ҷадвалҳои Scale Factor 1 танҳо як ё ду файл ҳосил мешаванд ва file skipping ба таври маънодор чен намешавад. Файлҳои ду мегабайтӣ файлҳои хеле бештар ба вуҷуд оварда, таъсири интихоби калидро намоён карданд. Аммо ин интихоб муҳити озмоишро аз ҳаҷми маъмулӣ дар системаҳои production дур мекунад.
Кадом тарҳбандии асосӣ муқоиса шуданд?
| Тарҳбандӣ | Шарҳ |
|---|---|
| B0 | Ҷадвалҳои хоми Delta Lake бе ягон optimizatsiya-и тарҳбандии ҷисмонӣ |
| B2 | Liquid Clustering-и статикӣ, ки як бор дар сутунҳои зуд-филтршаванда, мисли сана, барои ҳар ҷадвал сохта шуда ва дигар тағйир намеёбад |
| AJLO | Интихоби ҳамоҳанги калид байни ҷадвалҳо аз рӯи муносибатҳои бартарии join дар таърихи дархостҳо |
Partition-и catalog-style Hive аз муқоиса хориҷ шудааст. Ҳадафи таҳқиқот дубора муқоиса кардани Liquid Clustering бо partition-и анъанавии Hive нест, балки чен кардани таъсири сутуни интихобшуда дар ҳамон инфрасохтори Liquid Clustering аст.
Дар ҳаҷми маълумоти сканшуда чӣ ёфт шуд?
Дар Расми 2 миёнаи ҳаҷми скан барои ҳамаи дархостҳо чунин аст:
| Тарҳбандии ҷисмонӣ | Маълумоти миёнаи сканшуда барои ҳар дархост |
|---|---|
| B0 – optimizatsiya нест | 51 MB |
| B2 – кластеркунии статикӣ дар сутунҳои филтр | 117 MB |
| AJLO – кластеркунии join-aware | 46 MB |
Он ки B2 аз B0-и тартибнадодашуда бештар маълумот скан мекунад, ҷолиб аст. Кластер кардани orders аз рӯи o_orderdate ва lineitem аз рӯи l_shipdate ба шартҳои сана кӯмак мекунад; аммо дар join query-ҳое, ки диапазони orderkey-ро истифода мебаранд, қиматҳои калид ба файлҳои сана паҳн мешаванд ва қариб ҳамаи файлҳо мувофиқ менамоянд. Тарҳбандии статикӣ locality-и табиии маълумоти ибтидоиро низ вайрон карда, дар баъзе дархостҳо сканро зиёд кардааст.
Дар ranking-и JIS-и AJLO муносибати lineitem ↔ orders бо score-и 1,000 аввал ва customer ↔ orders бо 0,404 дувум аст. Система ин муносибатҳои бартариро бо калидҳои муштарак кластер кардааст.
Коҳиши %86,7 миёнаи ҳамаи дархостҳо нест. Ин қимат коҳиши байтҳои сканшудаи AJLO нисбат ба B2 дар дархостҳои join-heavy Q01–Q07 мебошад. Дар Q08–Q10, ки танҳо filter-и сана доранд, B2 бартарӣ дорад. AJLO ин access pattern-ҳоро махсус optimize накардааст.
Таъхири дархост чӣ гуна тағйир ёфт?
Мувофиқи натиҷаҳои муфассали Расми 5:
| Тарҳбандӣ | Таъхири миёнаи дархост |
|---|---|
| B0 | 1,2 сония |
| B2 | 1,0 сония |
| AJLO | 0,6 сония |
AJLO нисбат ба кластеркунии статикӣ аз рӯи сутуни филтр таъхири миёнаро %40 кам кардааст. Муаллиф ин фоидаро на ба алгоритми дигари query execution, балки ба хондани файл ва сатрҳои камтар пеш аз exchange нисбат медиҳад.
Дар як ҷумлаи муқаддима қиматҳои гуногуни 0,5 ва 0,6 сония мавҷуданд. Аммо abstract, матни results ва Расми 5 пайваста барои AJLO 0,6 ва барои B2 1,0 сония медиҳанд, аз ин рӯ ҳамин қиматҳо бояд асос гирифта шаванд.
Дар file skipping rate чӣ ёфт шуд?
Rate-ҳои миёнаи file skipping, ки дар RQ2 гузориш шудаанд, чунинанд:
| Тарҳбандӣ | Rate-и миёнаи file skipping |
|---|---|
| B0 | %14,9 |
| B2 | %14,5 |
| AJLO | %54,4 |
Он ки кластеркунии статикӣ аз рӯи сана бо %14,5 ба қимати %14,9-и ҷадвали тартибнадодашуда наздик мемонад, нишон медиҳад, ки интихоби калиди нодуруст барои join-heavy query-ҳо ба file skipping қариб ҳеҷ саҳм надодааст.
Дар model-и planning AJLO барои shared Liquid Clustering коэффисиенти %30 scan reduction истифода шудааст. Дар озмоиш rate-ҳои ченшудаи file skipping барои Q01–Q07 %76–79 буданд. Model дар ин тарҳбандии хурд тақрибан 2,5 маротиба conservative монд. Маълум нест, ки ҳамин фарқ дар миқёси калонтарини файл ва маълумот нигоҳ дошта мешавад ё не.
Озмоиши workload drift чиро нишон дод?
Дар се режими гуногуни workload басомади шаблонҳои дархост тағйир дода шуд, аммо сутунҳои join истифодашуда тағйир наёфтанд. Score-и drift дар равзанаи W3 0,249 ва дар W4 0,107 ҳисоб шуда, ҳар ду аз threshold-и 0,10 гузаштанд. Система дар ин нуқтаҳо бозарзёбиро дуруст фаъол кард.
Дар W5 қимати 0,069 ва дар W6 қимати 0,091 аз threshold паст монданд ва re-optimization оғоз нашуд. Аммо дар ҳамаи равзанаҳо арзиши воқеии бознависӣ сифр буд. Сабаб дар он буд, ки на сутунҳои join, балки басомади муносибатҳои мавҷуда тағйир ёфтанд. Бозарзёбӣ муайян кард, ки тарҳбандии ҷисмонии мавҷуда ҳанӯз кофӣ аст.
Бинобар ин, озмоиш рафтори threshold-и drift detector-ро нишон медиҳад; аммо ҳангоми пайдо шудани сутуни нави join reclustering-и воқеии ҷадвал ва арзиши онро арзёбӣ намекунад. Муаллиф инро яке аз камбудиҳои асосӣ барои кори оянда мешуморад.
Planner-и greedy то чӣ андоза ба optimum наздик шуд?
Нуҳ конфигуратсияи графи синтетикӣ сохта шуд, ки аз панҷ то ҳашт ҷадвал, аз шаш то дувоздаҳ edge ва буҷети баробар ба %20–50 арзиши умумии бознависиро дар бар мегирифт. Таносуби solution-и greedy ба optimum-и дақиқи brute-force ҳисоб шуд.
- Дар шаш аз нуҳ конфигуратсия solution-и greedy бо optimum яксон буд.
- Ҳашт аз нуҳ конфигуратсия ҳадди \(1-1/e\approx0{,}632\)-ро қонеъ ё аз он зиёд карданд.
- Таносуби миёнаи approximation барои ҳамаи конфигуратсияҳо 0,913 буд.
- Конфигуратсияи C6 дар 0,570 монд.
Дар C6 буҷети сахт боис шуд, ки алгоритм дар марҳилаи аввал edge-и маҳаллӣ ҷолибро интихоб кунад ва ба комбинатсияи баъдӣ, ки фоидаи умумии бештар медод, нарасад. Ин натиҷа хотиррасон мекунад, ки ҳадди назариявии \(1-1/e\) танҳо дар шароити submodularity ва diminishing marginal returns амал мекунад. Дар масъалаи пурраи layout-и таҳқиқот ин шартҳо барои ҳар конфигуратсия кафолат дода нашудаанд.
Нуқтаҳои қавии таҳқиқот кадоманд?
- Масъалаи мушаххас ва возеҳи physical design барои stack-и lakehouse-и кушодаасос баррасӣ шудааст.
- Ҷадвалҳо мустақил не, балки тавассути графи join ба таври ҳамоҳанг арзёбӣ шудаанд.
- Objective function-и математикӣ, budget constraints ва алгоритмҳо возеҳ пешниҳод шудаанд.
- Ҳаҷми file scan, query latency, file skipping rate, drift detection ва approximation quality бо озмоишҳои ҷудогона арзёбӣ шудаанд.
- Возеҳ гуфта шудааст, ки система Spark shuffle-ро аз байн намебарад.
- Барои конфигуратсияи озмоиш, код, data generator ва result scripts маълумоти reproducibility дода шудааст.
- Натиҷаи манфии C6 ва номуайянии миқёси production пинҳон нашудааст.
Маҳдудиятҳои асосии таҳқиқот кадоманд?
- Озмоишҳо дар як ноутбуки Apple M1 ва дар local Spark mode анҷом дода шуданд.
- TPC-H Scale Factor 1 тақрибан 1 GB аст ва маълумот ба memory меғунҷад.
- Network, distributed storage, data transfer байни executors ва node failure-ҳои муҳити production омӯхта нашудаанд.
- Target file size-и ду мегабайтӣ барои намоён кардани таъсири file skipping ба таври таҷрибавӣ хурд карда шудааст.
- Generator-и махсуси Python-и TPC-H метавонад аз distribution-и расмии
dbgenфарқиятҳои хурд дошта бошад. - Коҳиши %86,7 scan танҳо барои ҳафт join-heavy query ва муқоиса бо B2 амал мекунад.
- Дар filter-heavy query-ҳо static date clustering метавонад аз AJLO беҳтар кор кунад.
- Азбаски drift experiment сутунҳои нави join надошт, reclustering-и воқеии ҷисмонӣ рух надод.
- Арзиши воқеии OPTIMIZE дар миқёси терабайт ё петабайт чен нашудааст.
- Тахминҳои byte-based барои storage ва rewrite cost бо production bill ё operational interruption risk тасдиқ нашудаанд.
- Greedy planner дар як конфигуратсия аз ҳадди назариявӣ паст монд.
- Таҳқиқот аз peer review нагузаштааст.
Таҳқиқот кадом натиҷаҳоро дастгирӣ мекунад?
- Дар ҳамин муҳити хурди TPC-H интихоби калиди Liquid Clustering фарқи калон дар file skipping ва маълумоти сканшуда ба вуҷуд овард.
- Кластеркунии ҳамоҳанг аз рӯи калиди join дар Q01–Q07 нисбат ба static clustering аз рӯи сутуни сана маълумоти камтар скан кард.
- Physical layout, ки аз рӯи сутуни нодуруст кластер шудааст, дар баъзе workload-ҳо ҳатто аз ҷадвали тартибнадодашуда бадтар кор кард.
- JIS-и зарбӣ дар мисолҳои таҳқиқот тавонист муносибатҳои high-frequency аммо low-cost-ро ба қафо барад.
- Drift metric дар гузаришҳои санҷидашудаи query frequency аз threshold гузаштанро муайян кард.
- Greedy planner дар нуҳ графи хурди синтетикӣ average optimum ratio-и 0,913 дод.
Таҳқиқот кадом натиҷаҳоро исбот намекунад?
- Исбот намекунад, ки AJLO дар ҳамаи installation-ҳои Delta Lake-и кушодаасос тезтар мешавад.
- Нишон намедиҳад, ки коҳиши %86,7 scan дар миқёси терабайт ё петабайт нигоҳ дошта мешавад.
- Нишон намедиҳад, ки AJLO shuffle ё Sort-Merge Join exchange-ро аз байн мебарад.
- Нишон намедиҳад, ки query-ҳои Broadcast Hash Join ҳамон андоза фоида мегиранд.
- Нишон намедиҳад, ки filter-heavy ва join-heavy query-ҳоро ҳамзамон беҳтарин optimize мекунад.
- Нишон намедиҳад, ки бо пайдо шудани сутунҳои нави join reclustering бомуваффақият ва бо арзиши паст анҷом мешавад.
- Исбот намекунад, ки greedy planner дар ҳамаи graph ва budget condition-ҳо ҳадди \(1-1/e\)-ро таъмин мекунад.
- Сарфаи пулӣ ё беҳбудии service level дар production system-ро чен намекунад.
Усул ва бозёфтҳои таҳқиқот
Хулосаи усул
| Ҷузъи усул | Равиши татбиқшуда дар таҳқиқот |
|---|---|
| Навъи таҳқиқот | Algorithmic system design, озмоиши хурди TPC-H ва synthetic graph evaluation |
| Номи система | AJLO – Adaptive Join-aware Layout Optimizer |
| Платформаи ҳадаф | Apache Spark ва Delta Lake-и кушодаасос |
| Сохтори асосии маълумот | Графи вазндори join-и ҷадвалҳо, ки аз таърихи query сохта шудааст |
| Importance score | Normalized query frequency × log-scaled data size × execution cost |
| Ҳадафи optimizatsiya | Баланд бардоштани NPV-и expected scan reduction дар доираи rewrite ва storage budget |
| Planner | Dynamic greedy algorithm, ки priority-ҳоро пас аз ҳар қарор нав мекунад |
| Adaptation | Drift metric барои тағйири JIS distribution; threshold-и пешфарз 0,10 |
| Маълумоти озмоиш | TPC-H Scale Factor 1; ҳашт ҷадвал; generator-и махсуси Python |
| Query-ҳои озмоиш | Даҳ query; панҷ repeat; median result |
| Hardware | Ноутбуки Apple M1, 8 GB unified memory |
| Software | Spark 4.0.0, Delta Lake 3.2.0, PySpark 4.0.0 |
Бозёфтҳои асосии performance
| Metric | B0 | B2 | AJLO |
|---|---|---|---|
| Маълумоти миёнаи сканшуда | 51 MB | 117 MB | 46 MB |
| Таъхири миёнаи query | 1,2 сония | 1,0 сония | 0,6 сония |
| Rate-и миёнаи file skipping | %14,9 | %14,5 | %54,4 |
Ҷудокунии натиҷаҳо аз рӯи навъи query
| Гурӯҳи query | Layout-и афзал | Мушоҳида дар таҳқиқот |
|---|---|---|
| Q01–Q07, join-heavy | AJLO | Нисбат ба B2 %86,7 кам шудани bytes scanned; file skipping тақрибан %76–79 |
| Q08–Q10, filter-heavy | B2 | Азбаски сутуни сана мустақим ба query condition мувофиқ аст, static filter clustering маълумоти камтар скан кард |
Бозёфтҳои drift detection
| Равзана | Drift score | Ҳолати threshold | Бознависии ҷисмонӣ |
|---|---|---|---|
| W3 | 0,249 | Аз 0,10 боло; бозарзёбӣ | Не |
| W4 | 0,107 | Аз 0,10 боло; бозарзёбӣ | Не |
| W5 | 0,069 | Зери threshold | Не |
| W6 | 0,091 | Зери threshold | Не |
Бозёфтҳои greedy planner
| Андозагирӣ | Натиҷа |
|---|---|
| Шумораи synthetic configuration | 9 |
| Configuration-ҳои пурра баробар ба optimum | 6 |
| Қонеъ ё зиёда аз ҳадди назариявии 0,632 | 8 |
| Average approximation ratio | 0,913 |
| Пасттарин ratio | 0,570 дар configuration C6 |
Паёмҳои асосии расмҳо
- Расми 1: Меъмории шашҷузъии AJLO-ро аз query log то planning, execution, statistics refresh ва drift detection нишон медиҳад.
- Расми 2: Нишон медиҳад, ки static filter-column clustering бо 117 MB миёна нисбат ба B0 ва AJLO маълумоти бештар скан кардааст.
- Расми 3: Нишон медиҳад, ки муносибати
lineitem–ordersбо JIS 1,000 workload-ро ҳукмронӣ мекунад. - Расми 4: Join-heavy query-ҳоро ба тарафи AJLO ва filter-heavy query-ҳоро ба тарафи B2 ҳамчун ҳолатҳои афзал ҷудо мекунад.
- Расми 5: Таъхирҳои муфассалро барои B0 1,2, B2 1,0 ва AJLO 0,6 сония нишон медиҳад.
- Расми 6: File skipping rate-и AJLO %54,4-ро бо тақрибан %14–15 барои B0 ва B2 муқоиса мекунад.
- Расми 7: Нишон медиҳад, ки estimate-и planning-и %30 нисбат ба rate-ҳои ченшудаи %76–79 дар Q01–Q07 conservative будааст.
- Расми 8: Нишон медиҳад, ки threshold-и drift дар W3 ва W4 гузаштааст.
- Расми 9: Нишон медиҳад, ки бо вуҷуди бозарзёбӣ дар regime-ҳои санҷидашуда physical rewrite cost сифр мондааст.
- Расми 10: Нишон медиҳад, ки танҳо C6 аз нуҳ configuration зери ҳадди 0,632 мондааст.
- Расми 11: Greedy ва exact-optimal NPV-ҳоро муқоиса карда, калонтарин absolute gap-ро дар C6 нишон медиҳад.
Ёддошти манбаъ ва усул
Номи пурраи аслии таҳқиқот: Adaptive Join-Aware Physical Layout Optimization for Lakehouse Systems
Муаллиф: Nishank Mahore.
Тартиби муаллиф: Таҳқиқот якмуаллифӣ аст.
Маълумоти саҳми баробар: Муаллифи дигар ё изҳороти саҳми баробар вуҷуд надорад.
Муаллифи масъул: Nishank Mahore.
Суроғаи тамос: nishankmahore@gmail.com
Алоқаи муассисавӣ: Independent Researcher, Pune, India. Дар таҳқиқот университет, маркази тадқиқотӣ ё ширкати вобаста нишон дода нашудааст.
Платформаи нашр: SSRN.
Пайванди расмии манбаъ:Сабти таҳқиқот дар SSRN
Соли нашр: 2026.
Маҷалла: Номи маҷаллаи peer-reviewed ё маълумоти қабул ба маҷалла вуҷуд надорад.
Ношир: Барои нашри ниҳоии peer-reviewed маълумоти ношир вуҷуд надорад.
Навъи манбаъ: Algorithmic system design ва experimental computer systems evaluation; preprint.
Ҳолати peer review: Таҳқиқот аз peer review нагузаштааст.
Кодҳои implementation ва experiment:Репозитории AJLO GitHub
Дастрасии маълумот: Маълумоти хоми TPC-H алоҳида нигоҳ дошта нашудааст. Таҳқиқот мегӯяд, ки маълумотро бо generator-и махсуси tpch_generator.py ба таври deterministic дубора сохтан мумкин аст.
Саҳми муаллиф: Nishank Mahore ҳамаи нақшҳои conceptualization, methodology, software, validation, formal analysis, investigation, data curation, visualization, writing-original draft, review ва editing-ро иҷро кардааст.
Маблағгузорӣ: Гуфта шудааст, ки таҳқиқот аз ягон муассисаи давлатӣ, тиҷоратӣ ё ғайритиҷоратӣ маблағгузории махсус нагирифтааст.
Бархӯрди манфиатҳо: Муаллиф бархӯрди молиявӣ ё шахсии манфиатҳоро гузориш надодааст.
Изҳороти generative AI: Гуфта шудааст, ки воситаҳои generative AI танҳо барои таҳрир, кӯтоҳ кардан ва равшантар кардани матни аслии муаллиф истифода шудаанд; research design, implementation, experimental data ва technical results аз ҷониби AI тавлид нашудаанд.
Ин шарҳи тоҷикӣ танҳо бар асоси матни таҳқиқоти боршуда, ифодаҳои математикӣ, алгоритмҳо, ҷадвалҳо, натиҷаҳои озмоиш ва бозёфтҳои визуалии Расмҳои 1–11 омода шудааст. Манбаъҳои беруна барои илова кардани натиҷаи илмӣ истифода нашудаанд; танҳо барои санҷиши шахсияти библиографии таҳқиқот ва сабтҳои расмии он ба назар гирифта шудаанд.
Натиҷаҳои таъхири 0,6 сония, file skipping-и %54,4 ва коҳиши scan-и %86,7 ба маълумоти TPC-H Scale Factor 1-и тақрибан 1 GB, target file size-и таҷрибавии ду мегабайтӣ ва муҳити local Spark дар як компютер тааллуқ доранд. Ин қиматҳо набояд ҳамчун кафолати performance дар миқёси production тафсир шаванд.
Иддаои навоварии муаллиф, ки “ягон системаи пештар нашршуда интихоби join-aware Liquid Clustering key-ро барои Delta Lake-и кушодаасос автоматӣ накардааст”, ба literature review-и худи таҳқиқот такя мекунад. Дар ин мақола independent ва exhaustive prior-art search анҷом дода нашудааст.
Шарҳ гузоред
Нишонии почтаи электронии шумо нашр намешавад. Майдонҳои ҳатмӣ бо * нишон дода шудаанд