

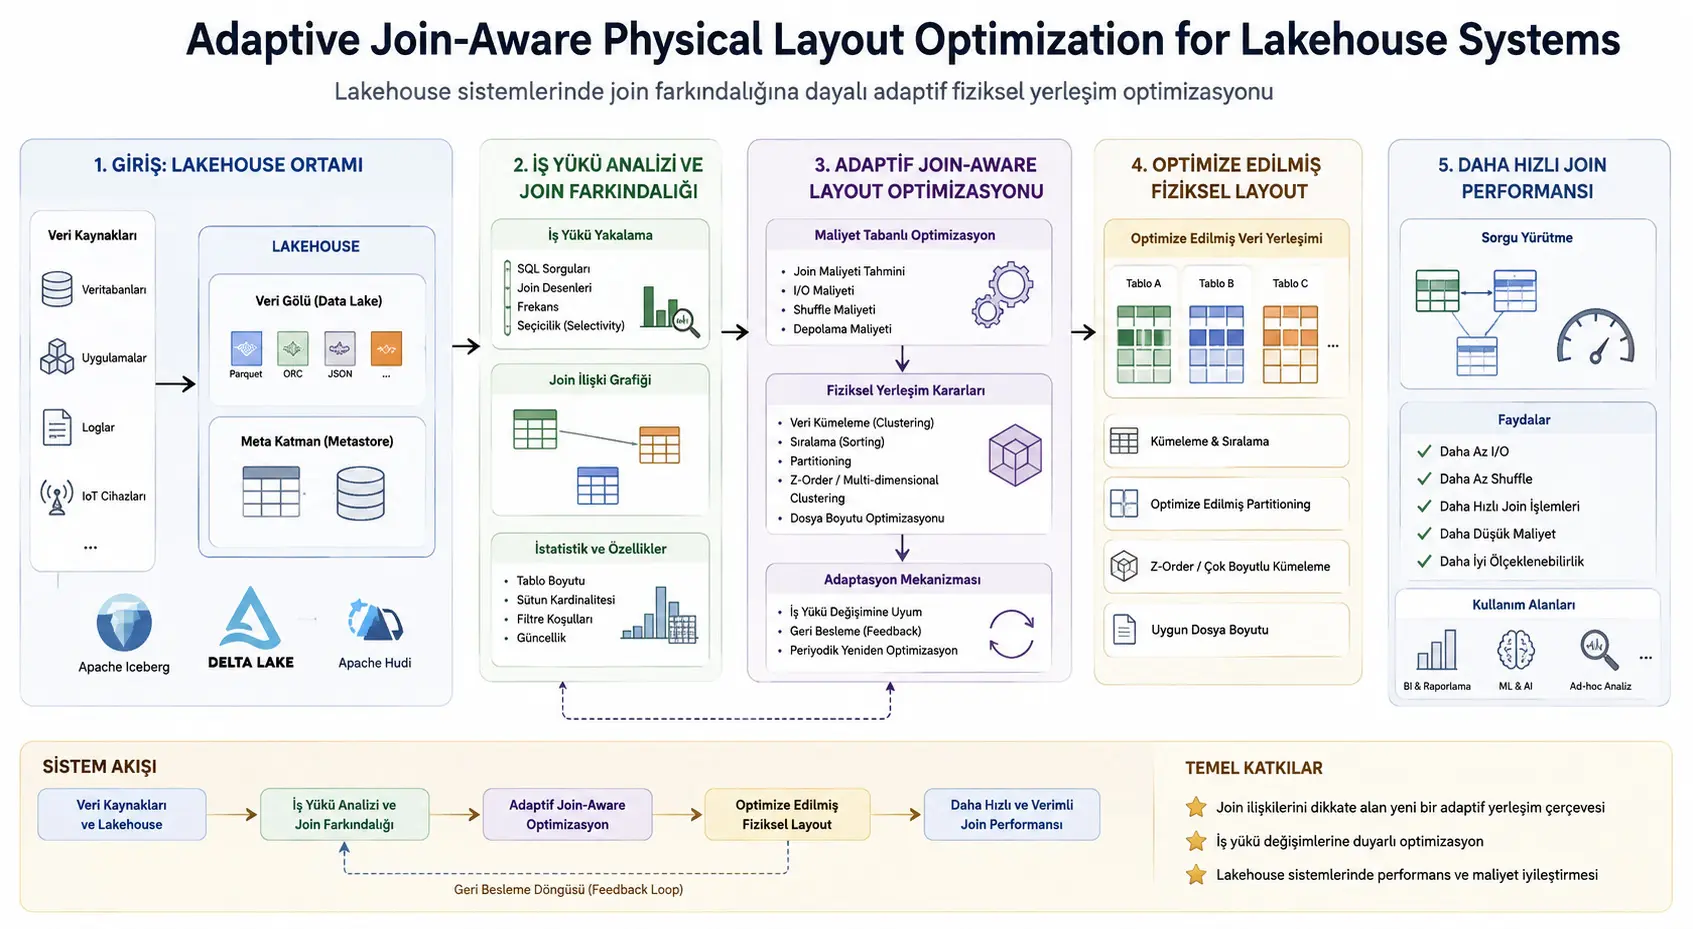
Utafiti huu unapendekeza mfumo unaoitwa AJLO ambao huchagua kiotomatiki, kutoka historia ya hoja, ni safu zipi zinazopaswa kutumiwa kwa physical clustering ya majedwali kwenye Delta Lake ya open source. AJLO huchunguza hoja zilizotekelezwa katika kipindi fulani cha muda na kuunda weighted graph kutokana na mahusiano ya join kati ya majedwali; huweka kila uhusiano katika nafasi kulingana na Join Importance Score inayotathmini kwa pamoja frequency ya hoja, ukubwa wa data na gharama ya utekelezaji. Kisha, chini ya bajeti ndogo ya rewriting, huchagua Liquid Clustering keys zinazolingana kwa majedwali yanayotumiwa pamoja mara kwa mara.
Katika majaribio yaliyofanywa kwenye TPC-H Scale Factor 1, AJLO ilipunguza wastani wa data iliyoskanwa kwa kila hoja hadi 46 MB kwa hoja zote. Katika mpangilio wa Delta Lake ambao haukuwa umeboreshwa, thamani hii ilikuwa 51 MB, huku katika mpangilio wa static clustering kwenye safu za filter maalumu kwa jedwali, kama tarehe, ilikuwa 117 MB. Katika hoja za Q01–Q07 zinazotegemea join kwa kiwango kikubwa, AJLO ilipunguza bytes zilizokuwa zinascanwa kwa %86,7 ikilinganishwa na static filter-column clustering. Wastani wa query latency ulikuwa 0,6 sekunde kwa AJLO, 1,0 sekunde kwa static clustering na 1,2 sekunde katika muundo wa mwanzo ambao haukupangwa.
Faida kuu ya AJLO ni kwamba badala ya kupanga kila jedwali kwa kujitegemea, inatathmini pamoja majedwali yanayotumia join key sawa. Hata hivyo, mfumo hauondoi Spark exchange au mchakato wa shuffle. Faida hutokana na kuruhusu faili nyingi zaidi kurukwa kwa kutumia min–max file statistics kabla join haijaanza, hivyo data kidogo zaidi kufika kwenye hatua ya exchange. Mbinu inalenga hasa hoja ambazo majedwali mawili makubwa yanaunganishwa kwa Sort-Merge Join; katika Broadcast Hash Join ambapo jedwali dogo husambazwa lote, faida sawa ya layout haitarajiwi.
Kwa mtazamo wa Uturuki: Mbinu ya AJLO inaweza kuchunguzwa kwa tathmini ya kiotomatiki ya physical table layout katika benki, mawasiliano, biashara ya mtandaoni, usafirishaji, uchanganuzi wa serikali na majukwaa ya big data nchini Uturuki yanayotumia Apache Spark na Delta Lake za open source. Hata hivyo, utafiti umechunguza data ya TPC-H ya takriban 1 GB kwenye laptop moja. Kabla ya kuhamishwa kwenye mazingira ya production nchini Uturuki, inapaswa kuthibitishwa katika distributed clusters za terabyte au petabyte, kwa kutumia historia halisi ya query ya taasisi na kujumuisha rewriting costs na mchakato wa data loading unaofanyika kwa wakati mmoja. Haiwezi kuhitimishwa moja kwa moja kutokana na utafiti kwamba taasisi fulani ya Uturuki itaskani data chache kwa %86,7 au kwamba hoja zake zitakuwa haraka kwa %40.
Tatizo la physical layout katika mifumo ya Lakehouse ni nini?
Architecture ya Lakehouse inalenga kuunganisha muundo wa faili wa gharama nafuu na wazi wa data lakes na transaction reliability pamoja na query capabilities za data warehouses. Delta Lake kwa kawaida hutumia faili za Parquet katika muundo huu na huhifadhi takwimu kama thamani za chini na za juu za safu kwa kila faili. Ikiwa condition ya query haipishani na range ya thamani za faili fulani, Spark inaweza kuiruka bila kuisoma. Mechanism hii huitwa file skipping, yaani kuruka faili.
Liquid Clustering hujaribu kukusanya rows zenye key values zinazofanana katika faili zilizo karibu kwa kutumia locality ya Hilbert curve. Kwa mfano, ikiwa jedwali la orders limeclusterishwa kwa tarehe ya order, hoja zinazotaka range fulani ya tarehe zinaweza kuruka faili nyingi. Lakini ikiwa jedwali hilo hilo linachujwa kwa order number na kuunganishwa na jedwali jingine kupitia order number, mpangilio wa tarehe unaweza usisaidie; range sawa ya order key inaweza kuwa imesambazwa karibu kwenye faili zote za tarehe.
Kwa hiyo, mbinu ya “chagua safu inayochujwa mara nyingi zaidi” inaweza kutoa physical layout isiyofaa katika analytical workloads zinazotegemea join. Zaidi ya hayo, safu sahihi inaweza kubadilika kwa muda. Leo hoja za order date zinaweza kutawala, lakini katika kipindi kinachofuata joins za order–lineitem au customer–orders zinaweza kutawala.
Katika mpangilio wa Delta Lake wa open source uliotathminiwa na utafiti, inachukuliwa kwamba hakuna mechanism inayochagua kiotomatiki na kwa uratibu kati ya majedwali Liquid Clustering keys kulingana na query patterns zinazobadilika. AJLO inalenga kujaza pengo hili kwa join graph inayojifunzwa kutoka historia ya hoja.
Kwa nini joint clustering kwa join key ni muhimu?
Ikiwa query inaunganisha majedwali orders na lineitem kupitia orderkey na kutumia selective range condition kwenye key hiyo hiyo, kucluster majedwali yote mawili kwa key hii kunaweza kuruhusu file skipping pande zote mbili. Kucluster jedwali moja tu, au majedwali yote mawili kwa unrelated date columns, hakutoi faida sawa.
Utafiti unahitaji physical layout ya majedwali yote mawili kuunga mkono join column hiyo hiyo ili uhusiano uitwe “scan-aligned”. Layout ya kila jedwali inaonyeshwa na strategy vector ifuatayo:
\[ \lambda(t)=\langle P_t,C_t\rangle \]
- \(P_t\) ni directory-based partition column ya jedwali au thamani tupu.
- \(C_t\) ni seti ya Liquid Clustering columns au thamani tupu.
Katika Delta Lake, PARTITIONED BY na CLUSTER BY si aina mbili huru za layout zinazotumiwa kwa wakati mmoja kwenye jedwali moja. Kwa hiyo planner lazima izingatie pia gharama ya kubadilisha layout iliyopo.
Architecture ya AJLO ina vipengele gani?
Kielelezo 1 kwenye ukurasa wa 6 wa utafiti kinaonyesha mfumo ukiwa na vipengele sita vikuu vinavyofanya kazi katika continuous feedback loop:
- Query Log Collector – QLC: Hukusanya SQL text, logical plan, execution statistics na timestamp za query zilizokamilika kupitia SparkListener. Default sliding window ni siku saba.
- Join Graph Builder – JGB: Badala ya kuparse query text moja kwa moja, hutoa equality-based join relationships kutoka kwenye resolved logical plan ya Spark.
- Relationship Importance Estimator – RIE: Hunormalize frequency, data size na cost metrics kwa kila join edge na kuhesabu Join Importance Score.
- Multi-Table Layout Planner – MTLP: Huchagua joint clustering au partitioning candidates zinazotoa expected net benefit kubwa zaidi ndani ya bajeti.
- Adaptive Reorganization Engine – ARE: Hubadilisha plan iliyochaguliwa kuwa Delta Lake DDL commands na operations za
OPTIMIZE. - Cost-Based Optimization Layer – CBOL: Baada ya reorganization huendesha
ANALYZE TABLEkusasisha file statistics na kurudisha matokeo kwenye feedback loop.
Mbali na vipengele hivi, Workload Drift Detector huanzisha planner tena wakati mabadiliko ya kutosha yanatokea katika relative importance ya join relationships. Ikiwa drift iko chini ya threshold, plan iliyopo huhifadhiwa.
Join graph inaundwaje?
Kila jedwali huwakilishwa kama node kwenye graph, na join relationship kati ya majedwali mawili kama edge. Kwa kila edge, thamani tatu kuu huhesabiwa:
- F(i,j): Idadi ya query zilizo na join hii ndani ya sliding time window.
- D(i,j): Wastani wa product ya row counts za majedwali mawili katika query husika.
- C(i,j): Wastani wa execution cost ya query zilizo na join hii.
Kutoa column lineage kutoka query plans ni changamano zaidi kuliko kutafuta majina ndani ya SQL. Katika resolved plan ya Spark, columns zinaweza kuwakilishwa zaidi kwa identifiers za exprId kuliko majina kama customer_id. Ili kuunganisha identifiers hizi na jedwali na column asilia, lineage hufuatiliwa kupitia nodes za Project, Alias, Filter na Subquery.
Join Importance Score inahesabiwaje?
AJLO huzidisha normalized frequency, data size na execution cost:
\[ JIS(i,j)=\widehat{F}(i,j)\times\widehat{D}(i,j)\times\widehat{C}(i,j) \]
Kwa sababu data size values zinaweza kutawanyika katika range pana, \(D\) huscaleiwa logarithmically kabla ya normalization:
\[ \widehat{D}(i,j)= \frac{\log_{10}(D(i,j)+1)-\log_{10}(D_{\min}+1)} {\log_{10}(D_{\max}+1)-\log_{10}(D_{\min}+1)+\varepsilon} \]
Kwa frequency na cost, standard min–max normalization hutumiwa:
\[ \widehat{X}(i,j)= \frac{X(i,j)-X_{\min}} {X_{\max}-X_{\min}+\varepsilon}, \qquad X\in\{F,C\} \]
Muundo wa multiplicative huhakikisha kwamba ikiwa mojawapo ya dimensions tatu inakaribia sifuri, total score nayo inakaribia sifuri. Hivyo join ya dimension table ndogo na ya gharama nafuu haitachukua sehemu kubwa ya rewriting budget kwa sababu tu ina frequency kubwa.
Katika mfano wa ulinganisho wa utafiti, relationship yenye frequency kubwa lakini majedwali madogo na ya haraka ilikuwa na multiplicative score ya 0,002, wakati relationship iliyosawazika katika dimensions zote ilikuwa na score ya 0,125. Additive formula ilitoa 0,333 na 0,500 kwa mifano hiyo hiyo na hivyo kuongeza kwa kiasi importance ya relationship ya gharama nafuu.
JIS si direct byte saving. Ni dimensionless priority-ranking signal. Economic optimization objective huhesabiwa kando kwa kutumia estimated scan reduction, rewriting cost na storage cost.
Tatizo la Multi-Table Layout Coordination linafafanuliwaje?
Utafiti unaformulate physical layout decision kama budget-constrained net present value problem inayoitwa Multi-Table Layout Coordination:
\[ \operatorname{NPV}(L)= \sum_{(i,j)\in E} \operatorname{ScanReduction}(i,j,L) \left( \frac{1-(1+r)^{-H}}{r} \right) -\operatorname{RewriteCost}(L) -\operatorname{StorageCost}(L) \]
Constraints:
\[ \operatorname{RewriteCost}(L)\leq B \]
\[ \operatorname{StorageCost}(L)\leq S \]
- \(L\) ni multi-table physical layout plan iliyochaguliwa.
- \(H\) ni planning horizon.
- \(r\) ni discount rate kwa kila window.
- \(B\) ni rewriting budget.
- \(S\) ni storage budget.
Katika utafiti, cost na benefit terms zimeonyeshwa kwa bytes. Mtafiti anadai kwamba tatizo ni NP-hard kupitia reduction kutoka Maximum Weighted Coverage. Kwa hiyo, greedy approach hutumiwa badala ya kuchunguza exhaustively combinations zote za table na key katika production scale.
Dynamic greedy planner inafanyaje kazi?
Planner huweka kwenye priority queue candidate inayotoa net present value kubwa zaidi chini ya current plan kwa kila join edge. Baada ya highest candidate kuchaguliwa, plan hutekelezwa ikiwa rewriting cost yake inatoshea remaining budget.
Uamuzi unapofanywa kwa jedwali moja, priorities za edges nyingine zinazohusishwa na jedwali hilo huhesabiwa upya. Hatua hii ni muhimu. Kwa mfano, baada ya table A kuclusterishwa na B kwa order_id, proposal ya A–C kwenye customer_id inaweza sasa kuhitaji kuandika upya table A kutoka mwanzo. Ikiwa priority iliyohesabiwa kwa old cost ingehifadhiwa, planner ingeweza kuhamisha jedwali hilo hilo mara kwa mara kati ya conflicting keys.
Katika utafiti, worst-case complexity kwa dense star schema imetolewa takriban kama:
\[ O(|E|^2\cdot|C|\cdot\log|E|) \]
na katika typical sparse schemas zenye low node degree inakaribia:
\[ O(|E|\cdot|C|\cdot\log|E|) \]
na inakaribia kiwango hicho.
Reorganization inatekelezwaje?
Wakati Liquid Clustering key inabadilishwa, mpangilio wa operation uliopendekezwa ni:
ALTER TABLE tablo CLUSTER BY (sutun);
OPTIMIZE tablo;
ANALYZE TABLE tablo;
Ikiwa kuna transition kati ya Liquid Clustering na directory-based partitioning, clustering iliyopo lazima iondolewe kwanza, kisha physical layout mpya ifafanuliwe na table iandikwe upya.
Utafiti unasistiza kwamba operations za OPTIMIZE zinaweza kugongana na concurrent ETL writers. Optimistic concurrency control katika Delta transaction log inaweza kutoa ConcurrentAppendException au ConcurrentDeleteReadException. AJLO inapendekeza retry with increasing backoff, kusoma latest table snapshot na reevaluating plan katika hali hii.
Kutokurefresh statistics baada ya reclustering kunaweza kusababisha faili mpya kutathminiwa kwa old column statistics. Kwa hiyo ANALYZE TABLE inachukuliwa kama sehemu ya lazima ya system loop ili file-skipping mechanism iweze kutumia key mpya.
AJLO inalenga kuwa na ufanisi katika aina gani za query?
Mfumo unalenga query ambazo majedwali mawili makubwa yanaunganishwa kwa Sort-Merge Join. Katika query hizi, rows zinazosomewa kutoka majedwali yote mawili huskanwa kutoka physical files kabla ya kuingia kwenye exchange stage. Clustering kwa key inayofaa inaweza kupunguza idadi ya faili zinazosomewa.
AJLO, kwa sababu haitimizi requirement ya ClusteredDistribution ya Spark, haiondoi shuffle. Catalyst bado huongeza node ya Exchange. Improvement ni kupungua kwa data inayoingia kwenye Exchange.
Adaptive Query Execution inaweza kubadilisha execution plan kwa kutumia real statistics baada ya exchange stages. Lakini AQE inapoanza kutumika, source files tayari zimesomwa. Kwa hiyo AJLO na AQE hazilengi cost ile ile:
- AJLO inalenga kupunguza cost ya kusoma source kutoka storage.
- AQE inalenga kuadapt plan na exchange stages wakati wa runtime.
Ikiwa query inageuzwa kuwa Broadcast Hash Join wakati wa runtime, upande mdogo husambazwa wote na joint clustering inaweza isitolee file-scan benefit ile ile. Kwa hiyo utafiti uliweka optimization scope kwenye relationships zinazobaki katika Sort-Merge Join domain.
Workload drift inabainishwaje?
Mabadiliko kati ya join graphs za time windows mbili zinazofuatana hupimwa kwa wastani wa normalized differences za JIS values za edges:
\[ \operatorname{Drift}(G_k,G_{k+1})= \frac{1}{|E_k\cup E_{k+1}|} \sum_{(i,j)\in E_k\cup E_{k+1}} \frac{ |JIS_k(i,j)-JIS_{k+1}(i,j)| }{ \max(JIS_k(i,j),JIS_{k+1}(i,j),\varepsilon) } \]
Default threshold ni \(\delta=0{,}10\). Threshold ikizidiwa, plan hutathminiwa upya. Join relationships zinazoonekana kwa mara ya kwanza katika kipindi kipya hupewa reevaluation priority kubwa moja kwa moja.
Mazingira ya majaribio yaliandaliwaje?
Majaribio yote yalifanywa kwenye laptop moja yenye processor ya Apple M1 na 8 GB unified memory. Basic configuration ilikuwa:
- Apache Spark 4.0.0, local
local[8]mode - Delta Lake 3.2.0
- PySpark 4.0.0
- 6 GB driver memory
- 50 shuffle partitions
- Adaptive Query Execution enabled
- Broadcast threshold 10 MB
- Target Delta file size 2 MB
Data ya TPC-H Scale Factor 1 ilitengenezwa kwa custom Python generator. Majedwali nane yalitumika: orders, lineitem, customer, supplier, part, partsupp, nation na region. Kila configuration iliendeshwa mara tano na median values zikaripotiwa.
Kuchagua target file size ya 2 MB ni detail muhimu ya experimental design. Wakati default 128 MB inapotumika, Scale Factor 1 tables hutoa faili moja au mbili tu na file-skipping rate haiwezi kupimwa kwa maana. Faili za megabyte mbili zilitengeneza faili nyingi zaidi na kufanya athari ya key selection ionekane. Hata hivyo, uchaguzi huu unaondoa experimental environment kutoka typical file sizes za production systems.
Ni baseline layouts zipi zililinganishwa?
| Layout | Maelezo |
|---|---|
| B0 | Raw Delta Lake tables bila physical layout optimization yoyote |
| B2 | Static Liquid Clustering iliyowekwa mara moja kwa columns zinazochujwa mara nyingi kama date kwa kila table na isiyobadilishwa |
| AJLO | Coordinated key selection kati ya tables kulingana na dominant join relationships katika query history |
Hive-style directory partitioning iliondolewa kwenye comparison. Lengo la utafiti halikuwa kulinganisha tena Liquid Clustering na traditional Hive partitioning, bali kupima athari ya selected column ndani ya same Liquid Clustering infrastructure.
Nini kilipatikana kuhusu kiasi cha data iliyoskanwa?
Katika Kielelezo 2, average scan amounts kwa query zote ni:
| Physical layout | Average data scanned per query |
|---|---|
| B0 – no optimization | 51 MB |
| B2 – static clustering kwenye filter columns | 117 MB |
| AJLO – join-aware clustering | 46 MB |
Ni muhimu kwamba B2 iliscan data nyingi zaidi kuliko B0 ambayo haikupangwa. Kucluster orders kwa o_orderdate na lineitem kwa l_shipdate husaidia date conditions; lakini katika join queries zinazotumia orderkey range, key values zinasambazwa kwenye date files, hivyo karibu faili zote zinaonekana relevant. Static layout pia ilivuruga natural locality katika data ya awali na kuongeza scanning katika baadhi ya queries.
Katika JIS ranking ya AJLO, relationship ya lineitem ↔ orders ilikuwa ya kwanza kwa score 1,000 na customer ↔ orders ya pili kwa 0,404. Mfumo uliweka dominant relationships hizi kwenye shared keys.
Kupungua kwa %86,7 si average ya query zote. Thamani hii inaonyesha kupungua kwa bytes zilizoskaniwa na AJLO dhidi ya B2 katika join-heavy Q01–Q07 queries. Katika Q08–Q10 zinazotumia date filters pekee, B2 ilikuwa na faida. AJLO haikuoptimize access patterns hizi maalumu.
Query latency ilibadilikaje?
Kulingana na detailed results za Kielelezo 5:
| Layout | Average query latency |
|---|---|
| B0 | 1,2 sekunde |
| B2 | 1,0 sekunde |
| AJLO | 0,6 sekunde |
AJLO ilipunguza average latency kwa %40 dhidi ya static filter-column clustering. Mtafiti anahusisha faida hii si na query execution algorithm tofauti, bali na kusoma files na rows chache kabla ya exchange.
Katika sentensi moja ya introduction kuna values tofauti za 0,5 na 0,6 sekunde. Hata hivyo, abstract, results text na Kielelezo 5 zinaripoti kwa uthabiti 0,6 kwa AJLO na 1,0 sekunde kwa B2, kwa hiyo values hizi ndizo zinapaswa kutumiwa.
Nini kilipatikana kuhusu file-skipping rate?
Average file-skipping rates zilizoripotiwa chini ya RQ2 ni:
| Layout | Average file-skipping rate |
|---|---|
| B0 | %14,9 |
| B2 | %14,5 |
| AJLO | %54,4 |
Static date-column clustering kubaki %14,5, karibu na %14,9 ya unorganized table, kunaonyesha kwamba kuchagua key isiyofaa kwa join-heavy queries karibu hakuchangii file skipping.
AJLO planning model ilitumia scan-reduction coefficient ya %30 kwa shared Liquid Clustering. Katika experiment, measured file-skipping rates za Q01–Q07 zilikuwa kati ya %76–79. Model ilikuwa takriban mara 2,5 conservative katika small-data layout hii. Haijulikani kama tofauti sawa itaendelea katika file na data scales kubwa.
Jaribio la workload drift lilionyesha nini?
Katika regimes tatu tofauti za workload, frequencies za query templates zilibadilishwa lakini join columns zilizotumiwa hazikubadilishwa. Drift score katika window W3 ilikuwa 0,249 na katika W4 ilikuwa 0,107; zote mbili zilizidi threshold ya 0,10. Mfumo ulianzisha reevaluation kwa usahihi katika pointi hizi.
Katika W5 thamani ya 0,069 na W6 thamani ya 0,091 zilibaki chini ya threshold na re-optimization haikuanzishwa. Hata hivyo, actual rewriting cost ilikuwa sifuri katika windows zote. Sababu ni kwamba kilichobadilika kilikuwa frequency ya relationships zilizopo, si join columns. Reevaluation iliamua kwamba physical layout iliyopo bado ilikuwa ya kutosha.
Kwa hiyo, experiment inaonyesha threshold behavior ya drift detector; haitathmini reclustering halisi ya table na cost yake wakati join column mpya inapotokea. Mtafiti anakubali hili kama mojawapo ya mapungufu makuu ya kazi ya baadaye.
Greedy planner ilikaribia optimum kwa kiwango gani?
Configurations tisa za synthetic graph ziliundwa zikiwa na tables tano hadi nane, edges sita hadi kumi na mbili na budget ya %20–50 ya total rewriting cost. Ratio ya greedy solution dhidi ya exact brute-force optimum ilihesabiwa.
- Katika configurations sita kati ya tisa, greedy solution ililingana kabisa na optimum.
- Configurations nane kati ya tisa zilikidhi au kuzidi bound ya \(1-1/e\approx0{,}632\).
- Average approximation ratio kwa configurations zote ilikuwa 0,913.
- Configuration C6 ilibaki kwenye ratio ya 0,570.
Katika C6, tight budget ilisababisha algorithm kuchagua mapema edge iliyokuwa locally attractive na kushindwa kufikia combination ya baadaye yenye total benefit kubwa zaidi. Matokeo haya yanakumbusha kwamba theoretical \(1-1/e\) bound hutumika tu ikiwa submodularity na diminishing marginal returns conditions zinashikilia. Katika full layout problem ya utafiti, conditions hizi hazijahakikishwa kwa kila configuration.
Nguvu za utafiti ni zipi?
- Utafiti unashughulikia physical design problem iliyo wazi na maalumu kwa open-source lakehouse stack.
- Tables zimetathminiwa kwa uratibu kupitia join graph badala ya kutazamwa kwa kujitegemea.
- Mathematical objective function, budget constraints na algorithms zimewasilishwa wazi.
- File scan volume, query latency, file-skipping rate, drift detection na approximation quality zimechunguzwa kwa experiments tofauti.
- Imeelezwa wazi kwamba mfumo hauondoi Spark shuffle.
- Reproducibility information imetolewa kwa experiment configurations, code, data generator na result scripts.
- C6 failure kama negative result na uncertainty kuhusu production scale hazijafichwa.
Mapungufu makuu ya utafiti ni yapi?
- Majaribio yalifanywa kwenye laptop moja ya Apple M1 katika local Spark mode.
- TPC-H Scale Factor 1 ni takriban 1 GB na data inatoshea memory.
- Network, distributed storage, inter-executor data transfer na node failures katika production environment hazikuchunguzwa.
- Target file size ya megabyte mbili ilipunguzwa kwa majaribio ili kufanya athari ya file skipping ionekane.
- Custom Python TPC-H generator inaweza kuwa na tofauti ndogo kutoka official
dbgendistribution. - Kupungua kwa scanning kwa %86,7 kunatumika tu kwa join-heavy queries saba na comparison dhidi ya B2.
- Katika filter-heavy queries, static date clustering iliweza kutoa matokeo bora kuliko AJLO.
- Kwa sababu drift experiment haikujumuisha join columns mpya, physical reclustering halisi haikutokea.
- Actual cost ya OPTIMIZE katika terabyte au petabyte scale haikupimwa.
- Byte-based estimates za storage na rewriting costs hazijathibitishwa kwa production bills au operational interruption risk.
- Greedy planner ilibaki chini ya theoretical bound katika configuration moja.
- Utafiti haujapitia peer review.
Utafiti unaunga mkono matokeo gani?
- Katika small TPC-H environment hiyo hiyo, uchaguzi wa Liquid Clustering key uliunda tofauti kubwa katika file skipping na data iliyoskanwa.
- Coordinated clustering kwa join key iliskan data kidogo katika Q01–Q07 kuliko static clustering kwa date column.
- Physical layout iliyoclusterishwa kwa column isiyofaa iliweza kufanya vibaya zaidi kuliko unorganized table katika workloads fulani.
- Multiplicative JIS iliweza kushusha priority ya high-frequency lakini low-cost relationships katika mifano ya utafiti.
- Drift metric iliweza kubaini threshold crossing katika tested query-frequency transitions.
- Greedy planner ilitoa average optimum ratio ya 0,913 katika synthetic graphs tisa ndogo.
Utafiti hauthibitishi matokeo gani?
- Haithibitishi kwamba AJLO itakuwa haraka zaidi katika open-source Delta Lake deployments zote.
- Haionyeshi kwamba scan reduction ya %86,7 itadumu katika terabyte au petabyte scale.
- Haionyeshi kwamba AJLO inaondoa shuffle au Sort-Merge Join exchange.
- Haionyeshi kwamba queries zinazotumia Broadcast Hash Join zitapata faida sawa.
- Haionyeshi kwamba inaoptimize filter-heavy na join-heavy queries kwa ubora zaidi kwa wakati mmoja.
- Haionyeshi kwamba reclustering itakamilika kwa mafanikio na gharama ndogo wakati join columns mpya zinaongezwa kwenye workload.
- Haithibitishi kwamba greedy planner itatimiza \(1-1/e\) bound katika graph na budget conditions zote.
- Haipimi monetary savings au service-level improvement itakayopatikana katika production system.
Mbinu na Matokeo ya Utafiti
Muhtasari wa mbinu
| Kipengele cha mbinu | Mbinu iliyotumika katika utafiti |
|---|---|
| Aina ya utafiti | Algorithmic system design, small-scale TPC-H experiment na synthetic graph evaluation |
| Jina la mfumo | AJLO – Adaptive Join-aware Layout Optimizer |
| Target platform | Open-source Apache Spark na Delta Lake |
| Basic data structure | Weighted table-join graph iliyoundwa kutoka query history |
| Importance score | Normalized query frequency × log-scaled data size × execution cost |
| Optimization objective | Kuongeza net present value ya expected scan reduction chini ya rewriting na storage budgets |
| Planner | Dynamic greedy algorithm inayosasisha priorities baada ya kila decision |
| Adaptation | Drift metric kwa mabadiliko ya JIS distribution; default threshold 0,10 |
| Experiment data | TPC-H Scale Factor 1; tables nane; custom Python data generator |
| Experiment queries | Queries kumi; repeats tano; median results |
| Hardware | Apple M1 laptop, 8 GB unified memory |
| Software | Spark 4.0.0, Delta Lake 3.2.0, PySpark 4.0.0 |
Matokeo makuu ya performance
| Kipimo | B0 | B2 | AJLO |
|---|---|---|---|
| Average data scanned | 51 MB | 117 MB | 46 MB |
| Average query latency | 1,2 sekunde | 1,0 sekunde | 0,6 sekunde |
| Average file-skipping rate | %14,9 | %14,5 | %54,4 |
Mgawanyo wa matokeo kulingana na query type
| Query group | Layout yenye faida | Observation katika utafiti |
|---|---|---|
| Q01–Q07, join-heavy | AJLO | %86,7 reduction katika bytes scanned dhidi ya B2; file skipping takriban %76–79 |
| Q08–Q10, filter-heavy | B2 | Kwa sababu date column ililingana moja kwa moja na query condition, static filter clustering iliweza kuscan data kidogo |
Matokeo ya drift detection
| Window | Drift score | Threshold status | Physical rewrite |
|---|---|---|---|
| W3 | 0,249 | Juu ya 0,10; reevaluation | Hakuna |
| W4 | 0,107 | Juu ya 0,10; reevaluation | Hakuna |
| W5 | 0,069 | Chini ya threshold | Hakuna |
| W6 | 0,091 | Chini ya threshold | Hakuna |
Matokeo ya greedy planner
| Kipimo | Matokeo |
|---|---|
| Idadi ya synthetic configurations | 9 |
| Configurations zilizolingana kabisa na optimum | 6 |
| Zilizotimiza au kuzidi theoretical bound ya 0,632 | 8 |
| Average approximation ratio | 0,913 |
| Lowest ratio | 0,570 katika configuration C6 |
Ujumbe mkuu wa vielelezo
- Kielelezo 1: Kinaonyesha architecture ya AJLO yenye vipengele sita kuanzia query log hadi planning, execution, statistics refresh na drift detection loop.
- Kielelezo 2: Kinaonyesha static filter-column clustering ikiscan wastani wa 117 MB, zaidi ya B0 na AJLO.
- Kielelezo 3: Kinaonyesha relationship ya
lineitem–ordersikitawala workload kwa JIS 1,000. - Kielelezo 4: Kinawatenganisha join-heavy queries kama upande wenye faida kwa AJLO na filter-heavy queries kama upande wenye faida kwa B2.
- Kielelezo 5: Kinaonyesha detailed latencies za 1,2 kwa B0, 1,0 kwa B2 na 0,6 sekunde kwa AJLO.
- Kielelezo 6: Kinalinganisha file-skipping rate ya AJLO ya %54,4 na takriban %14–15 za B0 na B2.
- Kielelezo 7: Kinaonyesha kwamba planning estimate ya %30 ilikuwa conservative dhidi ya measured rates za %76–79 katika Q01–Q07.
- Kielelezo 8: Kinaonyesha drift threshold ikizidiwa katika windows W3 na W4.
- Kielelezo 9: Kinaonyesha kwamba physical rewriting cost ilibaki sifuri katika regimes zilizojaribiwa licha ya reevaluations.
- Kielelezo 10: Kinaonyesha kwamba ni C6 pekee kati ya configurations tisa iliyobaki chini ya 0,632 bound.
- Kielelezo 11: Kinalinganisha greedy na exact optimum net present values na kuonyesha largest absolute gap katika C6.
Dokezo la Chanzo na Mbinu
Jina kamili la awali la utafiti: Adaptive Join-Aware Physical Layout Optimization for Lakehouse Systems
Mwandishi: Nishank Mahore.
Mpangilio wa waandishi: Utafiti una mwandishi mmoja.
Taarifa ya mchango sawa: Hakuna mwandishi mwingine au taarifa ya mchango sawa.
Mwandishi wa mawasiliano: Nishank Mahore.
Anwani ya mawasiliano: nishankmahore@gmail.com
Uhusiano wa taasisi: Independent Researcher, Pune, India. Utafiti haujatoa uhusiano wa chuo kikuu, kituo cha utafiti au kampuni.
Jukwaa la uchapishaji: SSRN.
Kiungo rasmi cha chanzo:Rekodi ya utafiti ya SSRN
Mwaka wa uchapishaji: 2026.
Jarida: Hakuna jina la jarida lililopitia peer review au taarifa ya kukubaliwa na jarida.
Mchapishaji: Hakuna taarifa ya mchapishaji kwa final peer-reviewed publication.
Aina ya chanzo: Algorithmic system design na experimental computer systems evaluation; preprint.
Hali ya peer review: Utafiti haujapitia peer review.
Implementation na experiment code:AJLO GitHub repository
Upatikanaji wa data: Raw TPC-H data haijahifadhiwa kando. Utafiti unaeleza kwamba data inaweza kutengenezwa tena deterministically kwa custom generator inayoitwa tpch_generator.py.
Mchango wa mwandishi: Nishank Mahore alifanya conceptualization, methodology, software, validation, formal analysis, investigation, data curation, visualization, writing-original draft, review na editing zote.
Ufadhili: Imeelezwa kwamba utafiti haukupokea specific funding kutoka taasisi ya umma, biashara au nonprofit.
Mgongano wa maslahi: Mwandishi hakuripoti financial au personal conflict of interest.
Taarifa ya generative AI: Imeelezwa kwamba generative AI tools zilitumika tu kuhariri, kufupisha na kufanya maandishi asilia ya mwandishi yawe wazi zaidi; research design, implementation, experimental data na technical results hazikuzalishwa na AI.
Maelezo haya ya Kiswahili yameandaliwa kwa msingi wa maandishi ya utafiti uliopakiwa, mathematical expressions, algorithms, tables, experimental results na visual findings katika Vielelezo 1–11 pekee. Vyanzo vya nje havikutumika kuongeza scientific results; vilizingatiwa tu kwa uthibitishaji wa bibliographic identity ya utafiti na official records zake.
Matokeo ya latency ya 0,6 sekunde, file skipping ya %54,4 na scan reduction ya %86,7 katika utafiti yanahusu data ya TPC-H Scale Factor 1 ya takriban 1 GB, experimental target file size ya megabyte mbili na local Spark environment ya kompyuta moja. Values hizi hazipaswi kufasiriwa kama performance guarantee ya production scale.
Dai la novelty la mwandishi kwamba “hakuna mfumo uliochapishwa hapo awali uliokuwa umeautomate join-aware Liquid Clustering key selection kwa open-source Delta Lake” linategemea literature review ya utafiti wenyewe. Independent na exhaustive prior-art search haikufanywa katika makala hii.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *