

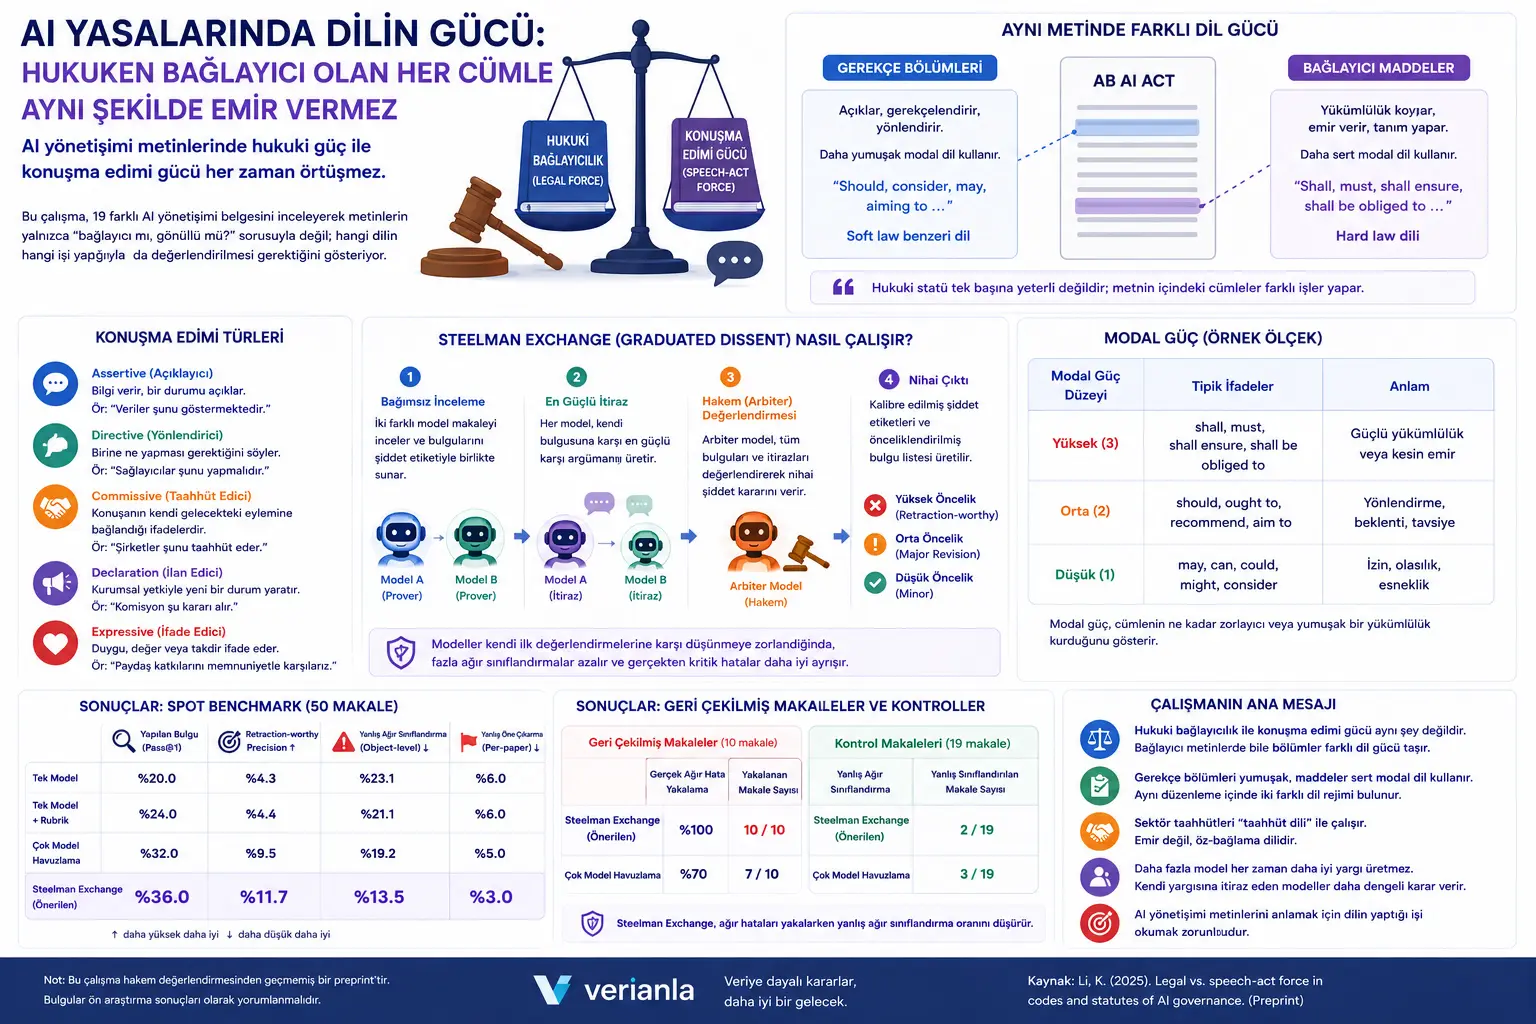
Yapay zekâ yönetişimi tartışmalarında genellikle şu ayrım öne çıkar: Bir metin hukuken bağlayıcı mı, yoksa gönüllü ilke belgesi mi? Bu ayrım önemlidir; fakat çalışma, tek başına yeterli olmadığını gösteriyor. Çünkü bir metnin hukukî statüsü ile cümlelerinin dilsel olarak yaptığı iş aynı şey değildir.
Bir düzenleme hukuken bağlayıcı olabilir; fakat içindeki bazı bölümler emir vermekten çok açıklama, gerekçelendirme veya yönlendirme işlevi görebilir. Tersine, hukuken gönüllü olan bir sektör kodu, şirketlerin “biz şunu yapacağız”, “şuna taahhüt ediyoruz” gibi ifadeleriyle güçlü bir öz-bağlama dili kurabilir. Bu nedenle çalışma, AI yönetişimi metinlerinde “legal force” yani hukuki güç ile “speech-act force” yani konuşma edimi gücü arasındaki farkı inceler.
Ana bulgu şudur: AB düzenlemelerindeki gerekçe bölümleri, bağlayıcı maddelerden daha yumuşak bir modal dil kullanır ve bazı yönleriyle soft law belgelerine yaklaşır. Buna karşılık sektör tarafından imzalanan AI kodları, emir kipinden çok taahhüt diline dayanır. Yani AI yönetişiminde güç yalnızca “shall / zorundadır” gibi emir veren maddelerde değil, “will / yapacağız” ve “commit to / taahhüt ederiz” gibi öz-bağlayıcı ifadelerde de ortaya çıkar.
Problem Ne?
Yapay zekâ yönetişimi hızla çoğalan bir belge evreni üretti. AB AI Act gibi bağlayıcı düzenlemeler, GDPR gibi önceki veri koruma metinleri, ABD başkanlık belgeleri, NIST çerçeveleri, OECD ilkeleri, G7 Hiroshima süreci, sektör gönüllü taahhütleri ve General-Purpose AI Code of Practice gibi karma yapılar aynı alanda yan yana duruyor.
Bu metinleri anlamak için çoğu zaman “hard law” ve “soft law” ayrımı kullanılır. Hard law, hukuken bağlayıcı düzenleme anlamına gelir. Soft law ise doğrudan bağlayıcı olmayan ilke, rehber, çerçeve veya gönüllü taahhüt metinlerini ifade eder. Fakat bu ikili ayrım, metnin içinde dilin nasıl çalıştığını her zaman açıklamaz.
Örneğin bir AB düzenlemesinin maddeleri bağlayıcı yükümlülükler koyabilir. Fakat aynı metnin başındaki gerekçe paragrafları, yükümlülük koymak yerine düzenlemenin mantığını açıklayabilir. Bu bölümler aynı hukuki aracın içinde yer alsa bile, cümlelerin yaptığı iş farklıdır.
Benzer biçimde, sektör şirketlerinin imzaladığı gönüllü AI kodları hukuken klasik anlamda yasa olmayabilir. Fakat şirketler “taahhüt ediyoruz” veya “şunu yapacağız” dediğinde, dilsel olarak kendilerini kamu önünde bağlayan bir konuşma edimi üretirler. Bu, emir almaktan farklıdır; fakat yine de düzenleyici güç üretir.
Çalışmanın temel sorusu bu noktada ortaya çıkar: AI yönetişimi metinlerinde hukuki bağlayıcılık ile dilsel bağlayıcılık ne kadar örtüşür, nerede ayrışır?
Yöntem Ne Öneriyor?
Çalışma, AI yönetişimi belgelerini konuşma edimi kuramı ve modalite analiziyle inceler. Konuşma edimi kuramı, cümlelerin yalnızca bilgi aktarmadığını; aynı zamanda emir verme, taahhüt etme, ilan etme, açıklama veya duygu ifade etme gibi işler yaptığını kabul eder.
Bu çerçevede metindeki cümleler beş ana kategoriyle değerlendirilir: assertive, directive, commissive, expressive ve declaration. Assertive cümleler bir durumu açıklar veya bilgi verir. Directive cümleler birine ne yapması gerektiğini söyler. Commissive cümleler konuşanın kendisini gelecekteki bir eyleme bağladığı taahhütlerdir. Declaration cümleler, kurumsal yetkiyle yeni bir hukuki veya kurumsal durum yaratır. Expressive cümleler ise tanıma, memnuniyet veya değer beyanı gibi ifade edici işlevler taşır.
Çalışmada ayrıca modal güç incelenir. Modal güç, cümlenin ne kadar zorlayıcı veya yumuşak bir yükümlülük kurduğunu gösterir. Örneğin “shall” ve “must” yüksek yükümlülük gücüne; “should” orta düzey yönlendirme gücüne; “may”, “can” ve “could” daha düşük izin veya olasılık gücüne sahiptir.
Yazar, 19 AI yönetişimi belgesinden oluşan bir korpus kurar. Bu korpusta bağlayıcı düzenlemeler, gönüllü sektör taahhütleri, ilke belgeleri, etik rehberler, operasyonel çerçeveler ve yorumlayıcı rehberler bulunur. Metinler cümle düzeyinde işlenir; her cümle konuşma edimi sınıfı ve modal güç açısından kural tabanlı, denetlenebilir bir sınıflandırıcıyla etiketlenir.
Önemli yöntemsel tercih, AB düzenlemelerinin gerekçe bölümleri ile bağlayıcı maddelerinin ayrı ayrı incelenmesidir. Böylece aynı hukuki metnin içinde farklı dilsel bölgelerin olup olmadığı test edilir.
Formüller Ne Anlatıyor?
Çalışmada klasik anlamda matematiksel model veya fiziksel formül bulunmamaktadır. Ancak korpus analizi, oranlar, modal güç ortalamaları ve etki büyüklükleri üzerinden yürütülür. Bu nedenle aşağıdaki MathJax blokları, çalışmadaki ölçüm mantığını sade ve CMS uyumlu biçimde göstermek için hazırlanmıştır.
İlk temel ölçü, belirli bir konuşma edimi türünün 10.000 kelime başına ne kadar yoğunlaştığını gösterir. Bu, farklı uzunluktaki belgeleri karşılaştırılabilir hale getirir.
Modal güç, cümlede kullanılan yükümlülük veya izin belirten modal ifadelerin gücünü ölçmek için düşük, orta ve yüksek bantlarda ele alınır. Çalışmanın mantığı sade biçimde şöyle gösterilebilir:
Bu ölçekle “may / can” gibi daha düşük güçlü ifadeler 1’e, “should” gibi orta düzey yönlendirmeler 2’ye, “shall / must” gibi yüksek zorunluluk ifadeleri 3’e yakın düşünülür.
Çalışmanın ana ayrışma iddiası şu şekilde özetlenebilir:
Bu ifade çalışmada birebir formül olarak verilmez; ana fikri sadeleştirmek için hazırlanmış editoryal bir özetlemedir. Hukuken bağlayıcı bir metin her cümlesinde aynı derecede emir vermez; hukuken gönüllü bir metin de dilsel olarak güçlü taahhütler içerebilir.
AB düzenlemeleri için çalışma mantığı şu ayrımı öne çıkarır:
Bu sade gösterim, gerekçe bölümleri ile bağlayıcı maddelerin aynı hukuki metin içinde farklı dil gücü taşıyabileceğini anlatır.
Sektör tarafından imzalanan AI kodları için temel ilişki ise şöyle özetlenebilir:
Yani bu metinlerde düzenleyici iş çoğunlukla dışarıdan emir verme yoluyla değil, şirketlerin kendilerini kamu önünde belirli eylemlere bağlaması yoluyla görülür.
Grafik, Tablo ve Şema Ana Mesajı
Sonuçların ana mesajı, AI yönetişimi metinlerinin tek bir çizgi üzerinde “yumuşak hukuk”tan “sert hukuk”a doğru sıralanamayacağıdır. Metinler daha çok farklı konuşma edimi profilleriyle kümelenir. Bağlayıcı yasalar, sektör taahhütleri ve ilke belgeleri ayrı dilsel bölgeler oluşturur.
Soft law ve hard law karşılaştırması, beklenen bazı farkları gösterir. Bağlayıcı düzenlemelerde directive ve declaration yoğunluğu daha yüksektir. Yani bu metinler daha fazla yükümlülük koyar ve daha fazla kurumsal durum yaratır. Bağlayıcı olmayan ilke ve rehber metinlerinde ise açıklayıcı, anlatıcı ve gerekçelendirici assertive cümleler daha baskındır.
Ancak en çarpıcı sonuç, AB düzenlemelerinin iç yapısında ortaya çıkar. AB AI Act ve GDPR gibi düzenlemelerde gerekçe bölümleri, bağlayıcı maddelerden çok daha yumuşak modal güç taşır. Gerekçe bölümleri “should” gibi orta düzey yönlendirme diline yaklaşırken, bağlayıcı maddeler “shall” gibi yüksek yükümlülük diliyle çalışır. Bu nedenle aynı düzenleme içinde iki farklı dil rejimi bulunur: açıklayan ve yönlendiren gerekçe dili; emreden ve kurumsal sonuç yaratan madde dili.
Bu ayrım önemlidir çünkü düzenlemenin tamamı için tek bir modal güç ortalaması almak gerçeği bulanıklaştırır. Gerekçe ve madde bölümleri birlikte ortalandığında, bağlayıcı maddelerin sertliği düşük görünür; gerekçelerin yumuşaklığı ise olduğundan daha yüksek görünür. Çalışma, bu yüzden hukuk metinlerinin bölüm düzeyinde ayrıştırılması gerektiğini savunur.
Sektör tarafından imzalanan AI kodlarında farklı bir tablo ortaya çıkar. Bu metinlerde “şirketler şunu yapacaktır” veya “imzacılar şunu taahhüt eder” gibi commissive yapılar çok yoğundur. Buna karşılık doğrudan directive yoğunluğu düşüktür. Bu, gönüllü AI taahhütlerinin klasik emir diliyle değil, öz-bağlama diliyle düzenleyici etki üretmeye çalıştığını gösterir.
Kümeleme görseli, 19 belgenin üç ana bölgede toplandığını gösterir. Bağlayıcı yasalar bir kümeye, sektör imzalı taahhüt metinleri ikinci kümeye, ilke ve operasyonel çerçeve belgeleri ise üçüncü kümeye yerleşir. Bu görünüm, AI yönetişimi metinlerinin yalnızca hukuki statüye göre değil, dilsel işlevlerine göre de ayrıldığını destekler.
Deneyler Nasıl Yapılmış?
Çalışma laboratuvar deneyi yapmaz; korpus tabanlı hukuk-dilbilim analizi yürütür. Korpus, 19 ABD, AB ve hükümetler arası AI yönetişimi belgesinden oluşur. Bunların içinde üç bağlayıcı statute bulunur: EU AI Act, GDPR ve Colorado AI Act. Diğer belgeler ise sektör taahhütleri, ilke belgeleri, etik rehberler, operasyonel çerçeveler ve yorumlayıcı dokümanlardan oluşur.
Metinler cümle düzeyinde ayrıştırılır. Çok kısa veya çok uzun cümleler, tablo ve sayfa kalıntılarını azaltmak için elenir. Son analiz korpusu 8.253 cümle ve 259.624 tokenden oluşur.
Konuşma edimi sınıflandırması için kural tabanlı ve parser destekli bir sistem kullanılır. Bu tercih önemlidir; çünkü çalışma, sınıflandırmanın denetlenebilir ve açıklanabilir olmasını ister. Her cümlenin hangi kuralla hangi sınıfa girdiği izlenebilir. Kullanılan sınıflar assertive, directive, commissive, expressive ve declaration olarak belirlenir.
Sınıflandırıcı, 300 cümlelik insan etiketli altın standart örneklemle doğrulanır. İki bağımsız dilbilimci örneklemi işaretler ve yüksek düzeyde uyum elde edilir. Sınıflandırıcı genel olarak 0,855 macro-F1 değerine ulaşır; commissive sınıfında ise F1 değeri 0,940 olarak raporlanır. Bu, çalışmanın sektör imzalı belgelerdeki taahhüt dili bulgusunun sınıflandırıcı hatasına karşı görece dayanıklı olduğunu gösterir.
İstatistiksel analizde parametrik olmayan yöntemler kullanılır. Bunun nedeni, belge sayısının küçük olması ve bazı konuşma edimi türlerinin birçok belgede sıfıra yakın yoğunluk göstermesidir. Etki büyüklüğü için Cliff’s delta kullanılır; p-değerleri ve Benjamini-Hochberg düzeltmeleri destekleyici olarak raporlanır.
Sonuçlar Ne Gösteriyor?
İlk sonuç, klasik soft law / hard law ayrımının AI yönetişimi belgelerini açıklamak için fazla kaba kalabildiğidir. Bağlayıcı düzenlemeler genel olarak daha fazla emir ve kurumsal tanım içerir; fakat bu fark metnin hangi bölümüne bakıldığına göre değişir.
İkinci sonuç, AB düzenlemelerindeki gerekçe bölümleri ile bağlayıcı maddelerin farklı dilsel güç taşıdığıdır. Gerekçe bölümleri, aynı düzenlemenin maddelerinden çok soft law belgelerine benzer bir modal profil gösterir. Bu, hukuken bağlayıcı bir metnin içinde pragmatik olarak daha yumuşak bir alt tür bulunabileceğini gösterir.
Üçüncü sonuç, sektör tarafından imzalanan AI kodlarının commissive-dominant bir yapı sergilemesidir. Bu metinlerde düzenleyici iş, “şunu yapmalısınız” diyen bir otorite diliyle değil; “biz şunu yapacağız / taahhüt ediyoruz” diyen öz-bağlayıcı bir dille yürür. Bu, gönüllü taahhütlerin dilsel olarak zayıf olmak zorunda olmadığını gösterir.
Dördüncü sonuç, directive ve commissive güçlerin ters yönde ayrışmasıdır. Bağlayıcı yasalarda emir ve yükümlülük dili yoğunlaşırken, sektör imzalı metinlerde doğrudan emir azalır ve taahhüt dili artar. Bu, düzenleyici gücün yalnızca dışsal komuttan değil, kamusal taahhütten de üretilebileceğini düşündürür.
Beşinci sonuç, AI yönetişimi belgelerinin küme yapısıdır. Korpus, basit bir yumuşaktan serte çizgi olmaktan çok, farklı dilsel işlev kümelerine ayrılır. Bağlayıcı yasalar, sektör taahhütleri ve ilke/rehber belgeleri ayrı konuşma edimi profilleriyle tanımlanabilir.
Bu Neden Önemli?
Yapay zekâ yönetişiminde metinlerin yalnızca hukuki statüsüne bakmak yeterli değildir. Bir metnin “bağlayıcı” olması, içindeki her cümlenin aynı düzeyde yükümlülük kurduğu anlamına gelmez. Aynı şekilde bir metnin “gönüllü” olması da onun dilsel olarak zayıf veya önemsiz olduğu anlamına gelmez.
Bu ayrım, AB AI Act gibi büyük düzenlemeleri okurken özellikle önemlidir. Gerekçe bölümleri düzenlemenin mantığını, amaçlarını ve yorum çerçevesini açıklar; ancak bağlayıcı maddelerle aynı dilsel güçte çalışmaz. Bu nedenle düzenleyici metin analizinde gerekçe ve madde ayrımı korunmalıdır.
Sektör taahhütleri bakımından da çalışma önemli bir uyarı sunar. Büyük teknoloji şirketleri “taahhüt ediyoruz” dediğinde, bu ifade klasik yasa dili gibi emir vermese bile kamu önünde bir beklenti ve hesap verebilirlik alanı üretir. Bu tür metinler, düzenleyici ekosistemde yalnızca halkla ilişkiler belgesi olarak değil, öz-bağlayıcı konuşma edimi olarak da incelenmelidir.
Hukuk-dilbilim açısından çalışma, yasal metinlerin ne yaptığı sorusunu daha incelikli hale getirir. Bir cümle yalnızca “bilgi veriyor”, “emir veriyor” veya “tanım yapıyor” değildir; bulunduğu belge türüne, bölümüne ve kurumsal konumuna göre farklı kuvvet kazanır.
Dikkat Noktaları
İlk dikkat noktası, çalışmanın preprint olmasıdır. Hakem değerlendirmesinden geçmediği için yöntem, sınıflandırma ve yorumlar ileride değişebilir. Bulgular kesinleşmiş hukuk-dilbilim standardı gibi değil, güçlü bir araştırma önerisi olarak okunmalıdır.
İkinci dikkat noktası, korpusun İngilizce olmasıdır. AB AI Act ve GDPR gibi metinler birçok dilde hukuken otantiktir. İngilizcedeki “should” ve “shall” ayrımı, Fransızca veya Almanca gibi diğer otantik metinlerde birebir karşılık bulmayabilir. Bu nedenle gerekçe-madde ayrımının genel AB yasama diline ait olup olmadığını anlamak için çok dilli doğrulama gerekir.
Üçüncü dikkat noktası, bağlayıcı düzenleme sayısının sınırlı olmasıdır. Hard law tarafı yalnızca üç statute ile temsil edilir. Daha geniş bir bağlayıcı düzenleme tabanı, bulguların genellenebilirliğini güçlendirebilir.
Dördüncü dikkat noktası, sektör imzalı belgelerin bağımsızlık sınırıdır. General-Purpose AI Code of Practice bölümleri aynı düzenleyici bağlamda hazırlanmıştır. Bu nedenle dört sektör imzalı belge, dört tamamen bağımsız örnek gibi okunmamalıdır. Çalışma bu bulguyu nüfus düzeyinde kesin iddia değil, iki yazım bağlamına dayalı vaka çalışması olarak sunar.
Beşinci dikkat noktası, kural tabanlı sınıflandırmanın sınırlarıdır. Denetlenebilir olması güçlüdür; fakat karma konuşma edimlerini tek etikete indirgemek bazı anlam katmanlarını kaybettirebilir. Özellikle “shall” içeren tanım cümlelerinde directive ve declaration güçleri birlikte bulunabilir.
Son olarak, bu içerik hukuki yorum veya uyum tavsiyesi değildir. AI düzenlemeleri, gönüllü kodlar ve şirket taahhütleri gerçek hukuki bağlam içinde uzman hukukçular tarafından değerlendirilmelidir.
Sonuç
Bu çalışma, AI yönetişimi metinlerini anlamak için önemli bir ayrım öneriyor: Hukuki güç ile konuşma edimi gücü aynı şey değildir. Bir metin hukuken bağlayıcı olabilir; fakat bazı bölümleri açıklayıcı ve yumuşak modal dil kullanabilir. Bir metin hukuken gönüllü olabilir; fakat güçlü taahhüt diliyle kendini bağlayan bir düzenleyici işlev görebilir.
En güçlü bulgu, AB düzenlemelerinde gerekçe bölümleri ile bağlayıcı maddelerin aynı dilsel rejimde çalışmamasıdır. Gerekçeler soft law belgelerine yakın bir modal profil gösterirken, bağlayıcı maddeler yüksek yükümlülük diliyle çalışır. Bu, hukuk metinlerini bölüm düzeyinde okumanın önemini gösterir.
İkinci güçlü bulgu, sektör tarafından imzalanan AI kodlarında emir dilinden çok taahhüt dilinin öne çıkmasıdır. Şirketlerin “yapacağız” ve “taahhüt ediyoruz” ifadeleri, klasik directive yapıya alternatif bir düzenleyici güç biçimi oluşturur.
Verianla açısından çalışmanın ana mesajı şudur: AI yönetişiminde metinlerin etkisini anlamak için yalnızca “bağlayıcı mı, gönüllü mü?” sorusunu sormak yetmez. Metnin hangi bölümünün ne tür konuşma edimi ürettiğine, hangi modal güçle konuştuğuna ve kimin kendisini neye bağladığına da bakmak gerekir.
Kaynak ve Yöntem Notu
Bu içerik, Kunming Li tarafından hazırlanan “Legal vs. speech-act force in codes and statutes of AI governance” başlıklı preprint çalışmaya dayalı olarak hazırlanmıştır. Çalışma; AI yönetişimi belgelerinde konuşma edimi sınıfları, modal güç, soft law / hard law ayrımı, AB düzenlemelerinde gerekçe-madde ayrışması ve sektör imzalı AI kodlarında commissive-dominant taahhüt dili üzerine korpus tabanlı bir analiz sunmaktadır.
Bu içerik birebir çeviri değildir; çalışmanın ana fikri Verianla yayın çizgisine uygun biçimde sadeleştirilmiş ve özgün Türkçe editoryal makaleye dönüştürülmüştür.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir