

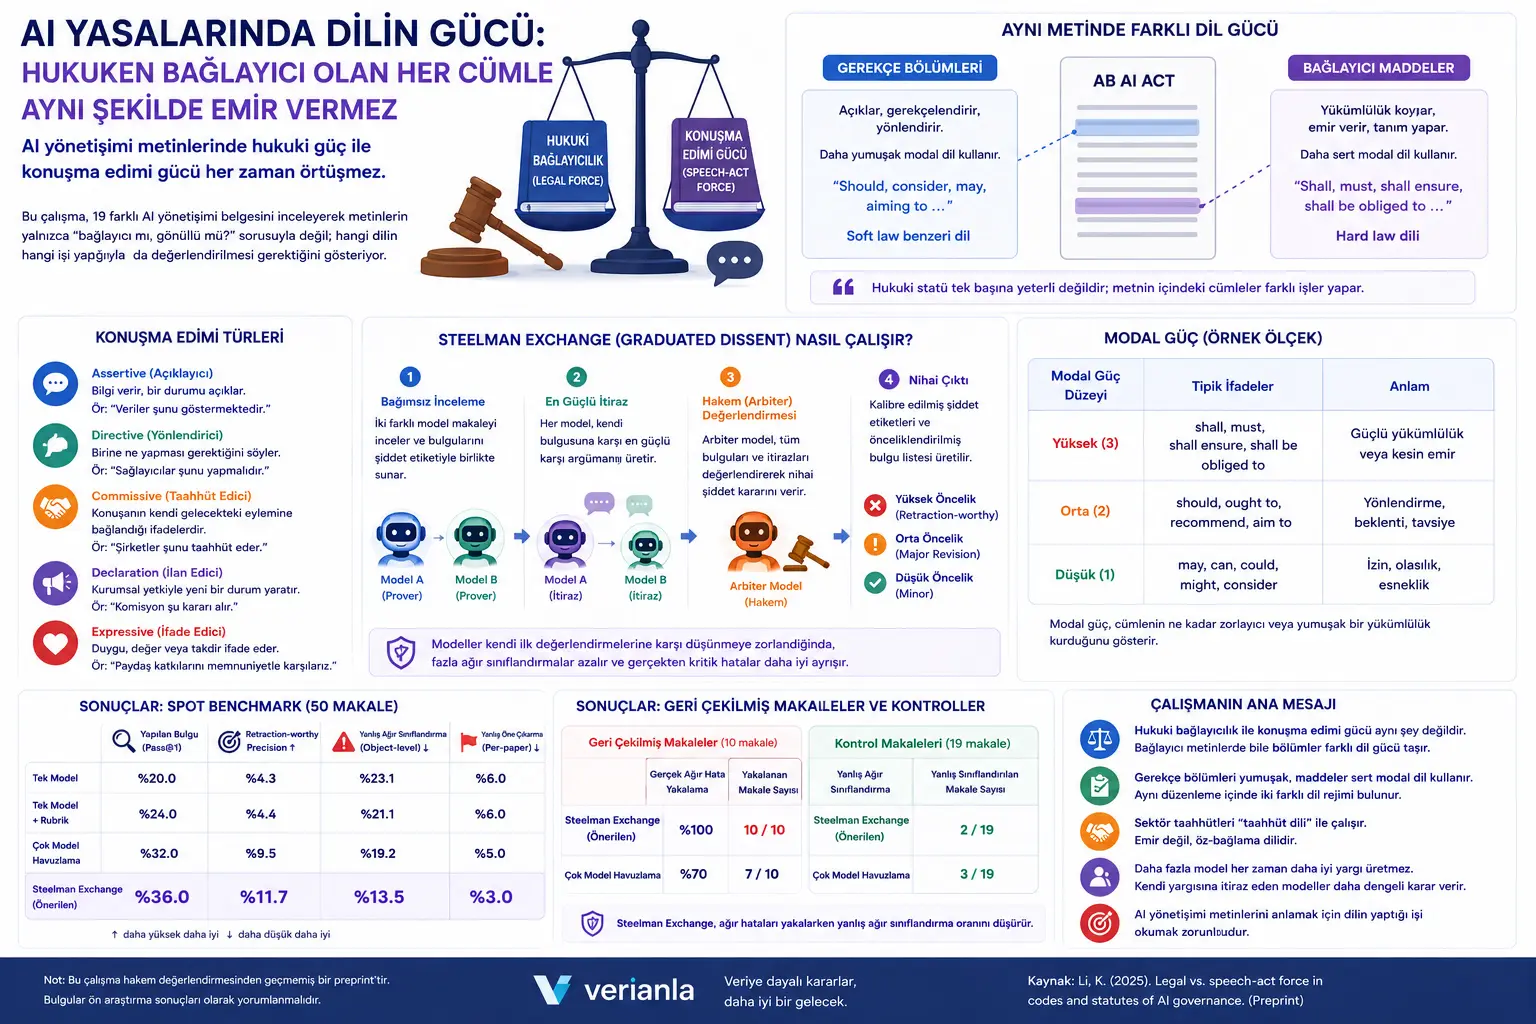
Süni intellekt idarəçiliyi müzakirələrində adətən belə bir fərq ön plana çıxır: Mətn hüquqi baxımdan məcburidirmi, yoxsa könüllü prinsip sənədidir? Bu fərq vacibdir; lakin tədqiqat təkbaşına kifayət etmədiyini göstərir. Çünki mətnin hüquqi statusu ilə cümlələrinin dil baxımından gördüyü iş eyni şey deyil.
Bir tənzimləmə hüquqi baxımdan məcburi ola bilər; lakin onun daxilindəki bəzi bölmələr əmr verməkdən çox izah, əsaslandırma və ya istiqamətləndirmə funksiyası daşıya bilər. Əksinə, hüquqi baxımdan könüllü olan sektor kodeksi şirkətlərin “biz bunu edəcəyik”, “buna öhdəlik götürürük” kimi ifadələri ilə güclü özünübağlayan dil qura bilər. Buna görə tədqiqat AI idarəçiliyi mətnlərində “legal force”, yəni hüquqi qüvvə ilə “speech-act force”, yəni nitq aktı qüvvəsi arasındakı fərqi araşdırır.
Əsas tapıntı budur: Aİ tənzimləmələrindəki əsaslandırma bölmələri məcburi maddələrdən daha yumşaq modal dildən istifadə edir və bəzi cəhətlərinə görə soft law sənədlərinə yaxınlaşır. Bunun əksinə, sektor tərəfindən imzalanan AI kodeksləri əmr kipindən çox öhdəlik dilinə əsaslanır. Yəni AI idarəçiliyində qüvvə yalnız “shall / məcburdur” kimi əmr verən maddələrdə deyil, “will / edəcəyik” və “commit to / öhdəlik götürürük” kimi özünübağlayan ifadələrdə də ortaya çıxır.
Problem Nədir?
Süni intellekt idarəçiliyi sürətlə artan sənədlər aləmi yaradıb. EU AI Act kimi məcburi tənzimləmələr, GDPR kimi əvvəlki məlumatların qorunması mətnləri, ABŞ prezident sənədləri, NIST çərçivələri, OECD prinsipləri, G7 Hiroshima prosesi, sektorun könüllü öhdəlikləri və General-Purpose AI Code of Practice kimi hibrid strukturlar eyni sahədə yanaşı mövcuddur.
Bu mətnləri anlamaq üçün çox vaxt “hard law” və “soft law” fərqindən istifadə olunur. Hard law hüquqi baxımdan məcburi tənzimləmə deməkdir. Soft law isə birbaşa məcburi olmayan prinsip, təlimat, çərçivə və ya könüllü öhdəlik mətnlərini ifadə edir. Lakin bu ikili fərq mətn daxilində dilin necə işlədiyini həmişə izah etmir.
Məsələn, Aİ tənzimləməsinin maddələri məcburi öhdəliklər qoya bilər. Lakin eyni mətnin əvvəlindəki əsaslandırma paraqrafları öhdəlik qoymaq əvəzinə tənzimləmənin məntiqini izah edə bilər. Bu bölmələr eyni hüquqi alətin daxilində yer alsa belə, cümlələrin gördüyü iş fərqlidir.
Eyni şəkildə, sektor şirkətlərinin imzaladığı könüllü AI kodeksləri klassik mənada qanun olmaya bilər. Lakin şirkətlər “öhdəlik götürürük” və ya “bunu edəcəyik” dedikdə, dil baxımından özlərini ictimaiyyət qarşısında bağlayan nitq aktı yaradırlar. Bu, əmr almaqdan fərqlidir; lakin yenə də tənzimləyici qüvvə yaradır.
Tədqiqatın əsas sualı məhz burada ortaya çıxır: AI idarəçiliyi mətnlərində hüquqi məcburilik ilə dilsel məcburilik nə dərəcədə üst-üstə düşür, harada ayrılır?
Metod Nə Təklif Edir?
Tədqiqat AI idarəçiliyi sənədlərini nitq aktı nəzəriyyəsi və modallıq təhlili ilə araşdırır. Nitq aktı nəzəriyyəsi cümlələrin yalnız informasiya ötürmədiyini; eyni zamanda əmr vermək, öhdəlik götürmək, elan etmək, izah etmək və ya hiss bildirmək kimi işlər gördüyünü qəbul edir.
Bu çərçivədə mətndəki cümlələr beş əsas kateqoriya ilə qiymətləndirilir: assertive, directive, commissive, expressive və declaration. Assertive cümlələr vəziyyəti izah edir və ya informasiya verir. Directive cümlələr kiməsə nə etməli olduğunu bildirir. Commissive cümlələr danışanın özünü gələcək hərəkətə bağladığı öhdəliklərdir. Declaration cümlələr institusional səlahiyyətlə yeni hüquqi və ya institusional vəziyyət yaradır. Expressive cümlələr isə tanıma, məmnunluq və ya dəyər bəyanı kimi ifadəedici funksiyalar daşıyır.
Tədqiqatda modal qüvvə də araşdırılır. Modal qüvvə cümlənin nə qədər məcburedici və ya yumşaq öhdəlik yaratdığını göstərir. Məsələn, “shall” və “must” yüksək öhdəlik gücünə; “should” orta səviyyəli istiqamətləndirmə gücünə; “may”, “can” və “could” isə daha aşağı icazə və ya ehtimal gücünə malikdir.
Müəllif 19 AI idarəçiliyi sənədindən ibarət korpus qurur. Bu korpusda məcburi tənzimləmələr, könüllü sektor öhdəlikləri, prinsip sənədləri, etik təlimatlar, əməliyyat çərçivələri və şərhedici bələdçilər yer alır. Mətnlər cümlə səviyyəsində emal edilir; hər cümlə nitq aktı sinfi və modal qüvvə baxımından qayda əsaslı, yoxlanıla bilən təsnifatçı ilə etiketlənir.
Mühüm metodoloji seçim Aİ tənzimləmələrinin əsaslandırma bölmələri ilə məcburi maddələrinin ayrıca araşdırılmasıdır. Beləliklə, eyni hüquqi mətn daxilində fərqli dil zonalarının olub-olmadığı sınaqdan keçirilir.
Formullar Nəyi İzah Edir?
Tədqiqatda klassik mənada riyazi model və ya fiziki formul yoxdur. Lakin korpus təhlili nisbətlər, modal qüvvə ortalamaları və təsir ölçüləri üzərindən aparılır. Buna görə aşağıdakı MathJax blokları tədqiqatdakı ölçmə məntiqini sadə və CMS uyğun şəkildə göstərmək üçün hazırlanıb.
İlk əsas ölçü müəyyən nitq aktı növünün 10.000 sözə düşən sıxlığını göstərir. Bu, fərqli uzunluqdakı sənədləri müqayisə oluna bilən edir.
Modal qüvvə cümlədə istifadə olunan öhdəlik və ya icazəni göstərən modal ifadələrin gücünü ölçmək üçün aşağı, orta və yüksək zolaqlarda nəzərdən keçirilir. Tədqiqatın məntiqi sadə şəkildə belə göstərilə bilər:
Bu şkala ilə “may / can” kimi daha aşağı güclü ifadələr 1-ə, “should” kimi orta səviyyəli istiqamətləndirmələr 2-yə, “shall / must” kimi yüksək məcburilik ifadələri 3-ə yaxın qəbul edilir.
Tədqiqatın əsas ayrışma iddiası belə ümumiləşdirilə bilər:
Bu ifadə tədqiqatda sözbəsöz formul kimi verilməyib; əsas ideyanı sadələşdirmək üçün hazırlanmış redaksiya xülasəsidir. Hüquqi baxımdan məcburi mətn hər cümləsində eyni dərəcədə əmr vermir; hüquqi baxımdan könüllü mətn də dil baxımından güclü öhdəliklər ehtiva edə bilər.
Aİ tənzimləmələri üçün tədqiqat məntiqi aşağıdakı fərqi ön plana çıxarır:
Bu sadə göstərim əsaslandırma bölmələri ilə məcburi maddələrin eyni hüquqi mətn daxilində fərqli dil gücü daşıya biləcəyini göstərir.
Sektor tərəfindən imzalanan AI kodeksləri üçün əsas əlaqə isə belə ümumiləşdirilə bilər:
Yəni bu mətnlərdə tənzimləyici funksiya əsasən kənardan əmr vermək yolu ilə deyil, şirkətlərin özlərini ictimaiyyət qarşısında müəyyən hərəkətlərə bağlaması yolu ilə görünür.
Qrafik, Cədvəl və Sxemin Əsas Mesajı
Nəticələrin əsas mesajı AI idarəçiliyi mətnlərinin tək xətt üzrə “yumşaq hüquq”dan “sərt hüquq”a doğru sıralana bilməməsidir. Mətnlər daha çox fərqli nitq aktı profilləri ilə qruplaşır. Məcburi qanunlar, sektor öhdəlikləri və prinsip sənədləri ayrıca dil zonaları yaradır.
Soft law və hard law müqayisəsi gözlənilən bəzi fərqləri göstərir. Məcburi tənzimləmələrdə directive və declaration sıxlığı daha yüksəkdir. Yəni bu mətnlər daha çox öhdəlik qoyur və daha çox institusional vəziyyət yaradır. Məcburi olmayan prinsip və bələdçi mətnlərində isə izahlı, nəqledici və əsaslandırıcı assertive cümlələr daha dominantdır.
Lakin ən diqqətçəkən nəticə Aİ tənzimləmələrinin daxili strukturunda ortaya çıxır. EU AI Act və GDPR kimi tənzimləmələrdə əsaslandırma bölmələri məcburi maddələrdən xeyli daha yumşaq modal qüvvə daşıyır. Əsaslandırma bölmələri “should” kimi orta səviyyəli istiqamətləndirmə dilinə yaxınlaşdığı halda, məcburi maddələr “shall” kimi yüksək öhdəlik dili ilə işləyir. Buna görə eyni tənzimləmə daxilində iki fərqli dil rejimi var: izah edən və istiqamətləndirən əsaslandırma dili; əmr edən və institusional nəticə yaradan maddə dili.
Bu fərq vacibdir, çünki bütün tənzimləmə üçün tək modal qüvvə ortalaması götürmək reallığı bulanıqlaşdırır. Əsaslandırma və maddə bölmələri birlikdə ortalandıqda məcburi maddələrin sərtliyi olduğundan aşağı, əsaslandırmaların yumşaqlığı isə olduğundan yüksək görünə bilər. Tədqiqat buna görə hüquqi mətnlərin bölmə səviyyəsində ayrışdırılmalı olduğunu müdafiə edir.
Sektor tərəfindən imzalanan AI kodekslərində fərqli mənzərə ortaya çıxır. Bu mətnlərdə “şirkətlər bunu edəcək” və ya “imzalayanlar buna öhdəlik götürür” kimi commissive strukturlar çox sıxdır. Bunun əksinə, birbaşa directive sıxlığı aşağıdır. Bu, könüllü AI öhdəliklərinin klassik əmr dili ilə deyil, özünübağlayan dillə tənzimləyici təsir yaratmağa çalışdığını göstərir.
Qruplaşdırma vizualı 19 sənədin üç əsas bölgədə toplandığını göstərir. Məcburi qanunlar bir qrupa, sektor tərəfindən imzalanmış öhdəlik mətnləri ikinci qrupa, prinsip və əməliyyat çərçivəsi sənədləri isə üçüncü qrupa yerləşir. Bu mənzərə AI idarəçiliyi mətnlərinin yalnız hüquqi statusuna görə deyil, dil funksiyalarına görə də ayrıldığını dəstəkləyir.
Təcrübələr Necə Aparılıb?
Tədqiqat laboratoriya təcrübəsi aparmır; korpus əsaslı hüquq-dilçilik təhlili həyata keçirir. Korpus 19 ABŞ, Aİ və hökumətlərarası AI idarəçiliyi sənədindən ibarətdir. Bunların içində üç məcburi statute var: EU AI Act, GDPR və Colorado AI Act. Digər sənədlər isə sektor öhdəlikləri, prinsip sənədləri, etik təlimatlar, əməliyyat çərçivələri və şərhedici sənədlərdən ibarətdir.
Mətnlər cümlə səviyyəsində ayrılır. Çox qısa və ya çox uzun cümlələr cədvəl və səhifə qalıqlarını azaltmaq üçün xaric edilir. Son təhlil korpusu 8.253 cümlə və 259.624 tokendən ibarətdir.
Nitq aktı təsnifatı üçün qayda əsaslı və parser dəstəkli sistem istifadə olunur. Bu seçim vacibdir; çünki tədqiqat təsnifatın yoxlanıla bilən və izah edilə bilən olmasını istəyir. Hər cümlənin hansı qayda ilə hansı sinfə daxil olduğu izlənilə bilər. İstifadə olunan siniflər assertive, directive, commissive, expressive və declaration kimi müəyyənləşdirilir.
Təsnifatçı 300 cümləlik insan etiketli gold standard nümunə ilə doğrulanır. İki müstəqil dilçi nümunəni işarələyir və yüksək uyğunluq əldə edilir. Təsnifatçı ümumilikdə 0,855 macro-F1 dəyərinə çatır; commissive sinfində isə F1 dəyəri 0,940 kimi bildirilir. Bu, tədqiqatın sektor tərəfindən imzalanan sənədlərdəki öhdəlik dili tapıntısının təsnifatçı səhvinə qarşı nisbətən dayanıqlı olduğunu göstərir.
Statistik təhlildə parametrik olmayan üsullardan istifadə olunur. Bunun səbəbi sənəd sayının az olması və bəzi nitq aktı növlərinin bir çox sənəddə sıfıra yaxın sıxlıq göstərməsidir. Təsir ölçüsü üçün Cliff’s delta istifadə olunur; p-dəyərləri və Benjamini-Hochberg düzəlişləri dəstəkləyici şəkildə bildirilir.
Nəticələr Nəyi Göstərir?
İlk nəticə klassik soft law / hard law fərqinin AI idarəçiliyi sənədlərini izah etmək üçün həddindən artıq kobud qala bilməsidir. Məcburi tənzimləmələr ümumilikdə daha çox əmr və institusional tərif ehtiva edir; lakin bu fərq mətnin hansı bölməsinə baxıldığından asılı olaraq dəyişir.
İkinci nəticə Aİ tənzimləmələrindəki əsaslandırma bölmələri ilə məcburi maddələrin fərqli dil qüvvəsi daşımasıdır. Əsaslandırma bölmələri eyni tənzimləmənin maddələrindən çox soft law sənədlərinə bənzər modal profil göstərir. Bu, hüquqi baxımdan məcburi mətnin daxilində praqmatik baxımdan daha yumşaq alt növ ola biləcəyini göstərir.
Üçüncü nəticə sektor tərəfindən imzalanan AI kodekslərinin commissive-dominant struktur göstərməsidir. Bu mətnlərdə tənzimləyici funksiya “bunu etməlisiniz” deyən səlahiyyət dili ilə deyil; “biz bunu edəcəyik / buna öhdəlik götürürük” deyən özünübağlayan dillə həyata keçirilir. Bu, könüllü öhdəliklərin dil baxımından zəif olmaq məcburiyyətində olmadığını göstərir.
Dördüncü nəticə directive və commissive qüvvələrin əks istiqamətdə ayrışmasıdır. Məcburi qanunlarda əmr və öhdəlik dili sıxlaşdığı halda, sektor tərəfindən imzalanan mətnlərdə birbaşa əmr azalır və öhdəlik dili artır. Bu, tənzimləyici qüvvənin yalnız xarici əmrdən deyil, ictimai öhdəlikdən də yaradıla biləcəyini düşündürür.
Beşinci nəticə AI idarəçiliyi sənədlərinin qruplaşma strukturudur. Korpus sadə yumşaqdan sərtə doğru xətt olmaqdan çox, fərqli dil funksiyası qruplarına ayrılır. Məcburi qanunlar, sektor öhdəlikləri və prinsip/bələdçi sənədləri ayrı nitq aktı profilləri ilə müəyyənləşdirilə bilər.
Bu Niyə Vacibdir?
Süni intellekt idarəçiliyində mətnlərin yalnız hüquqi statusuna baxmaq kifayət deyil. Mətnin “məcburi” olması daxilindəki hər cümlənin eyni səviyyədə öhdəlik yaratdığı demək deyil. Eyni şəkildə mətnin “könüllü” olması da onun dil baxımından zəif və ya əhəmiyyətsiz olduğu demək deyil.
Bu fərq EU AI Act kimi böyük tənzimləmələri oxuyarkən xüsusilə vacibdir. Əsaslandırma bölmələri tənzimləmənin məntiqini, məqsədlərini və şərh çərçivəsini açıqlayır; lakin məcburi maddələrlə eyni dil gücü ilə işləmir. Buna görə tənzimləyici mətn təhlilində əsaslandırma və maddə fərqi qorunmalıdır.
Sektor öhdəlikləri baxımından da tədqiqat mühüm xəbərdarlıq verir. Böyük texnologiya şirkətləri “öhdəlik götürürük” dedikdə bu ifadə klassik qanun dili kimi əmr verməsə belə, ictimaiyyət qarşısında gözlənti və hesabatlılıq sahəsi yaradır. Belə mətnlər tənzimləyici ekosistemdə yalnız ictimaiyyətlə əlaqələr sənədi kimi deyil, özünübağlayan nitq aktı kimi də araşdırılmalıdır.
Hüquq-dilçilik baxımından tədqiqat hüquqi mətnlərin nə etdiyi sualını daha incə edir. Cümlə yalnız “informasiya verir”, “əmr edir” və ya “tərif verir” deyil; olduğu sənəd növünə, bölməsinə və institusional mövqeyinə görə fərqli qüvvə qazanır.
Diqqət Edilməli Məqamlar
İlk diqqət nöqtəsi tədqiqatın preprint olmasıdır. Rəyçi qiymətləndirməsindən keçmədiyi üçün metod, təsnifat və şərhlər gələcəkdə dəyişə bilər. Tapıntılar yekun hüquq-dilçilik standartı kimi deyil, güclü tədqiqat təklifi kimi oxunmalıdır.
İkinci diqqət nöqtəsi korpusun ingilis dilində olmasıdır. EU AI Act və GDPR kimi mətnlər bir çox dildə hüquqi baxımdan autentikdir. İngilis dilindəki “should” və “shall” fərqi fransız və ya alman dili kimi digər autentik mətnlərdə sözbəsöz qarşılıq tapmaya bilər. Buna görə əsaslandırma-maddə fərqinin ümumi Aİ qanunvericilik dilinə aid olub-olmadığını anlamaq üçün çoxdilli doğrulama lazımdır.
Üçüncü diqqət nöqtəsi məcburi tənzimləmə sayının məhdud olmasıdır. Hard law tərəfi yalnız üç statute ilə təmsil olunur. Daha geniş məcburi tənzimləmə bazası tapıntıların ümumiləşdirilə bilməsini gücləndirə bilər.
Dördüncü diqqət nöqtəsi sektor tərəfindən imzalanan sənədlərin müstəqillik sərhədidir. General-Purpose AI Code of Practice bölmələri eyni tənzimləyici kontekstdə hazırlanıb. Buna görə dörd sektor imzalı sənəd dörd tam müstəqil nümunə kimi oxunmamalıdır. Tədqiqat bu tapıntını populyasiya səviyyəsində yekun iddia deyil, iki yazı kontekstinə əsaslanan case study kimi təqdim edir.
Beşinci diqqət nöqtəsi qayda əsaslı təsnifatın məhdudiyyətləridir. Yoxlanıla bilən olması üstünlükdür; lakin qarışıq nitq aktlarını tək etiketə endirmək bəzi məna qatlarını itirə bilər. Xüsusilə “shall” ehtiva edən tərif cümlələrində directive və declaration qüvvələri birlikdə mövcud ola bilər.
Nəhayət, bu məzmun hüquqi şərh və ya uyğunluq tövsiyəsi deyil. AI tənzimləmələri, könüllü kodekslər və şirkət öhdəlikləri real hüquqi kontekst daxilində ekspert hüquqşünaslar tərəfindən qiymətləndirilməlidir.
Nəticə
Bu tədqiqat AI idarəçiliyi mətnlərini anlamaq üçün mühüm fərq təklif edir: Hüquqi qüvvə ilə nitq aktı qüvvəsi eyni şey deyil. Mətn hüquqi baxımdan məcburi ola bilər; lakin bəzi bölmələri izahlı və yumşaq modal dildən istifadə edə bilər. Mətn hüquqi baxımdan könüllü ola bilər; lakin güclü öhdəlik dili ilə özünü bağlayan tənzimləyici funksiya görə bilər.
Ən güclü tapıntı Aİ tənzimləmələrində əsaslandırma bölmələri ilə məcburi maddələrin eyni dil rejimində işləməməsidir. Əsaslandırmalar soft law sənədlərinə yaxın modal profil göstərdiyi halda, məcburi maddələr yüksək öhdəlik dili ilə işləyir. Bu, hüquqi mətnləri bölmə səviyyəsində oxumağın əhəmiyyətini göstərir.
İkinci güclü tapıntı sektor tərəfindən imzalanan AI kodekslərində əmr dilindən çox öhdəlik dilinin ön plana çıxmasıdır. Şirkətlərin “edəcəyik” və “öhdəlik götürürük” ifadələri klassik directive struktura alternativ tənzimləyici qüvvə forması yaradır.
Verianla baxımından tədqiqatın əsas mesajı budur: AI idarəçiliyində mətnlərin təsirini anlamaq üçün yalnız “məcburidirmi, könüllüdürmü?” sualını vermək kifayət deyil. Mətnin hansı bölməsinin hansı növ nitq aktı yaratdığına, hansı modal qüvvə ilə danışdığına və kimin özünü nəyə bağladığına da baxmaq lazımdır.
Mənbə və Metod Qeydi
Bu məzmun Kunming Li tərəfindən hazırlanmış “Legal vs. speech-act force in codes and statutes of AI governance” başlıqlı preprint tədqiqata əsasən hazırlanıb. Tədqiqat AI idarəçiliyi sənədlərində nitq aktı sinifləri, modal qüvvə, soft law / hard law fərqi, Aİ tənzimləmələrində əsaslandırma-maddə ayrışması və sektor tərəfindən imzalanan AI kodekslərində commissive-dominant öhdəlik dili üzrə korpus əsaslı təhlil təqdim edir.
Bu məzmun sözbəsöz tərcümə deyil; tədqiqatın əsas ideyası Verianla nəşr xəttinə uyğun şəkildə sadələşdirilib və orijinal Azərbaycan dilli redaksiya məqaləsinə çevrilib.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib